
425 lines
18 KiB
Markdown
425 lines
18 KiB
Markdown
|
||
|
||
大家好,这里是物联网心球。
|
||
|
||
一直以来,在Linux高性能网络编程中使用最多的网络I/O模型是epoll。epoll除了性能优越,稳定性也很高,似乎epoll成了高并发应用场景的唯一选择。然而随着io_uring的出现,这一局面慢慢被打破。
|
||
|
||
io_uring是异步I/O,同样性能优越,那么epoll和io_uring到底谁更牛呢?今天我们来深入探讨一下。
|
||
|
||
## 1.一张图搞懂epoll
|
||
|
||
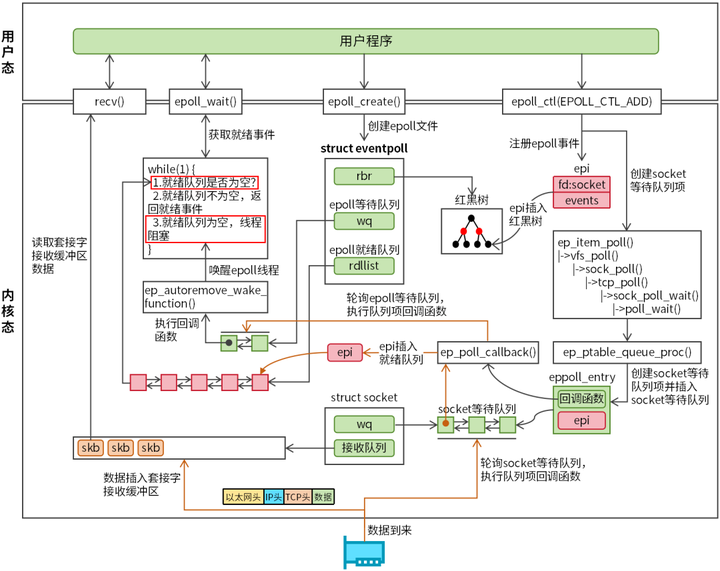
笔者将epoll重要的知识点都汇聚在一张图,如图1所示。
|
||
|
||

|
||
|
||
图1 一张图搞懂epoll
|
||
|
||
epoll_create用来在内核里创建一个eventpoll对象(epoll实例)并返回一个文件描述符(epfd),通过epfd我们能够快速访问eventpoll对象。eventpoll对象内核定义如下:
|
||
|
||
```c
|
||
structeventpoll {
|
||
wait_queue_head_t wq; // 等待队列
|
||
structlist_headrdllist;// 就绪队列
|
||
structrb_rootrbr;// 红黑树
|
||
......
|
||
};
|
||
```
|
||
|
||
- wq:等待队列,内核通过等待队列唤醒epoll线程。
|
||
- rdllist:就绪队列,用于存储就绪事件。
|
||
- rbr:红黑树,用于存储所有通过epoll_ctl注册的I/O事件。
|
||
|
||
epoll_ctl用于向epoll实例中添加、修改或删除需要监控的文件描述符及其事件,内核对于epoll事件的定义为struct epitem结构。
|
||
|
||
```text
|
||
structepitem {
|
||
union {
|
||
structrb_noderbn;/* 红黑树节点*/
|
||
};
|
||
structlist_headrdllink;/* 就绪队列节点*/
|
||
structepoll_filefdffd;/* 文件描述符信息,包含fd和对应的file指针 */
|
||
int nwait;
|
||
structeventpoll *ep;/* 指向所属的eventpoll实例 */
|
||
structepoll_eventevent;/* 通过epoll_ctl设置的epoll_event事件,包含文件描述符和感兴趣的事件类型 */
|
||
......
|
||
};
|
||
```
|
||
|
||
用户程序调用epoll_ctl函数(操作类型指定为EPOLL_CTL_ADD)时,内核会创建epitem对象,然后将用户设置的epoll事件(包含文件描述符和事件类型)复制至epitem对象,再将epitem对象插入红黑树。
|
||
|
||
epitem对象插入红黑树后,内核需要激活事件驱动机制,即当事件就绪后,主动通知epoll。具体做法是创建一个socket等待队列项(struct eppoll_entry结构),eppoll_entry的base成员指向epitem对象,同时epoll_entry中注册一个回调函数ep_poll_callback(用于通知epoll事件就绪),最后将epoll_entry插入socket等待队列。
|
||
|
||
完成epoll事件注册后,用户程序调用epoll_wait函数获取epoll就绪事件,epoll_wait负责把就绪事件从内核搬到用户程序。内核会循环检测epoll就绪队列是否为空。如果就绪队列不为空,内核会将所有就绪事件拷贝至epoll_event数组(epoll_wait函数参数);否则,epoll线程会创建一个epoll等待队列项并注册回调函数ep_autoremove_wake_function(用于唤醒epoll线程),等待队列项将插入epoll等待队列,随后内核切换epoll线程至阻塞状态。
|
||
|
||
数据到来时,数据经网卡->网络设备子系统->网络协议栈,最后存储至套接字接收缓冲区。一旦数据被套接字接收,则epoll读事件就绪。内核会轮询socket等待队列,并执行ep_poll_callback回调函数,该函数有两个作用:
|
||
|
||
- 将socket等待队列项中的epitem对象插入epoll就绪队列。
|
||
- 轮询epoll等待队列,执行ep_autoremove_wake_function回调函数,将epoll线程唤醒。
|
||
|
||
epoll线程被唤醒后,它会将epoll就绪队列中的就绪事件从内核拷贝至用户程序。用户程序检测到就绪事件后,就能够读写数据了。
|
||
|
||
下面,我们简单总结一下epoll的优缺点。
|
||
|
||
epoll的优点如下:
|
||
|
||
- 无文件描述符数量限制,非常适用于高并发场景。
|
||
- 采用事件驱动模型,不需要轮询每个文件描述符状态来获取就绪事件。
|
||
|
||
相对于epoll的优点,笔者更愿意来讨论epoll的缺点,如果我们能够准确地指出epoll的缺点,意味着我们对epoll有了非常深入的理解。
|
||
|
||
epoll的缺点为:epoll处理I/O事件时,伴随着大量的系统调用,并且epoll不能够批量地处理I/O事件。
|
||
|
||
## 2.一张图搞懂io_uring
|
||
|
||
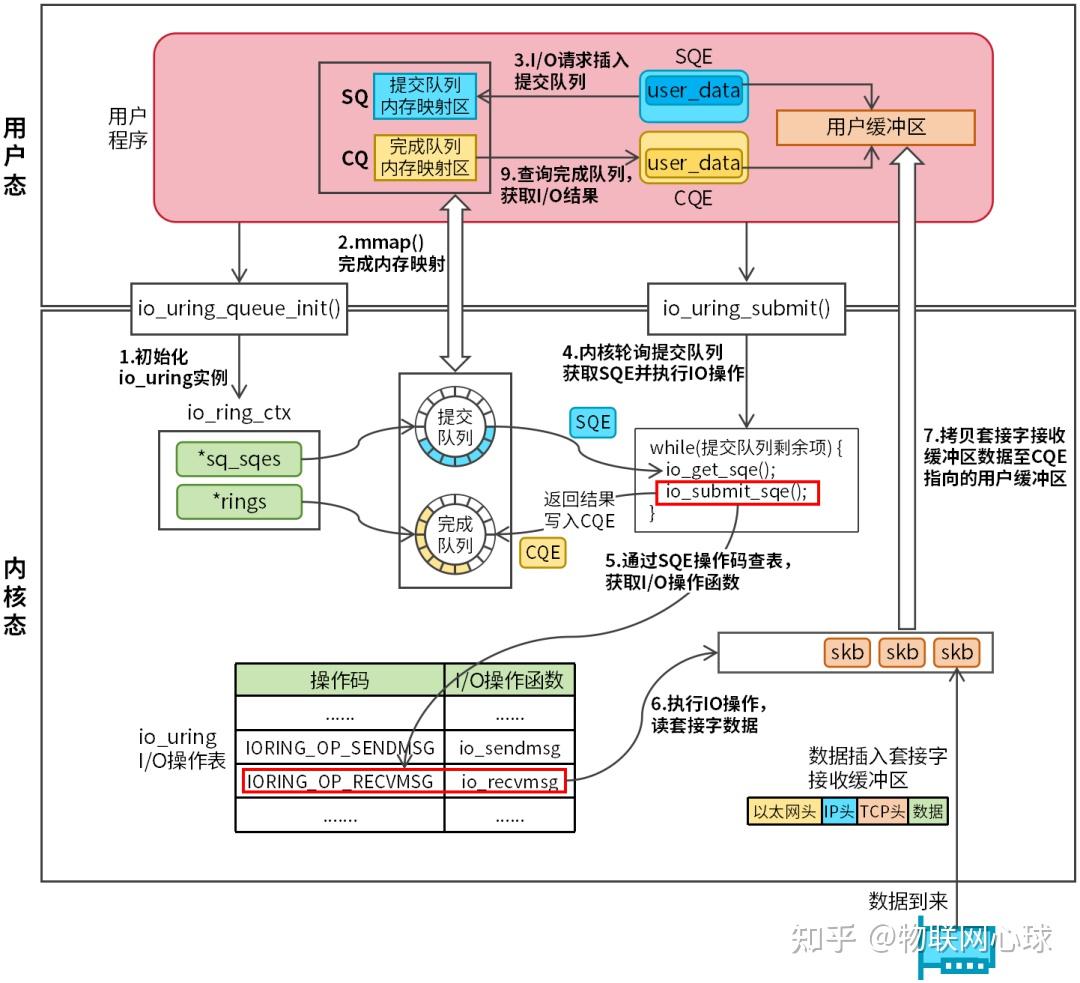
io_uring是异步I/O模型,它的实现原理和同步I/O模型有很大的区别。我们同样通过一张图来学习io_uring,如图2所示。
|
||
|
||
|
||
|
||
图2 一张图搞懂io_uring
|
||
|
||
io_uring同样有三个系统调用:
|
||
|
||
- io_uring_setup:用于创建和初始化io_uring实例。
|
||
- io_uring_enter:负责提交I/O请求和获取完成事件。
|
||
- io_uring_register:用于将文件描述符、缓冲区等资源预先注册到io_uring实例中。
|
||
|
||
图2中并没有出现这三个系统调用,实际开发中,我们会使用liburing库,liburing库将io_uring中的三个系统调用进行了封装,提供了更加丰富和友好的编程接口。
|
||
|
||
用户程序调用io_uring_queue_init函数(内部封装了io_uring_setup系统调用),该函数将创建和初始化一个io_uring实例(struct io_ring_ctx),内核定义如下:
|
||
|
||
```c
|
||
struct io_ring_ctx {
|
||
struct io_rings *rings; /* 指向完成队列CQ */
|
||
struct io_uring_sqe *sq_sqes; /* 指向提交队列SQ */
|
||
......
|
||
};
|
||
```
|
||
|
||
struct io_ring_ctx结构非常复杂,这里不展开讲解,我们需要关注两个重要成员:rings(CQ,完成队列)和sq_sqes(SQ,提交队列)。
|
||
|
||
CQ和SQ都是无锁环形队列。内核初始化io_uring实例时,会从内核直接映射区分配内存作为CQ和SQ。之所以从内核直接映射区分配内存,是为了方便用户程序执行mmap内存映射,确保用户程序和内核能够直接都能够访问这块内存区域。CQ和SQ是用户程序和内核数据传输的通道,借用这个通道,用户程序可以在不使用系统调用的情况下和内核实现数据交换。CQ和SQ采用无锁化编程,在高并发场景下,能够最大程度减少锁的开销。
|
||
|
||
内核维护了一张io_uring I/O操作表,这张表定义了io_uring所有的I/O操作,共50多种操作,定义如下:
|
||
|
||
```c
|
||
/* 内核io_uring I/O操作表 */
|
||
conststructio_issue_def io_issue_defs[] = {
|
||
......
|
||
[IORING_OP_SENDMSG] = {
|
||
.needs_file = 1,
|
||
.unbound_nonreg_file = 1,
|
||
.pollout = 1,
|
||
.ioprio = 1,
|
||
.async_size = sizeof(struct io_async_msghdr),
|
||
.prep = io_sendmsg_prep,
|
||
.issue = io_sendmsg,
|
||
},
|
||
[IORING_OP_RECVMSG] = {
|
||
.needs_file = 1,
|
||
.unbound_nonreg_file = 1,
|
||
.pollin = 1,
|
||
.buffer_select = 1,
|
||
.ioprio = 1,
|
||
.async_size = sizeof(struct io_async_msghdr),
|
||
.prep = io_recvmsg_prep,
|
||
.issue = io_recvmsg,
|
||
},
|
||
......
|
||
}
|
||
```
|
||
|
||
每个I/O操作都有一个操作码,内核根据操作码查找I/O操作表,获取I/O操作函数并执行。
|
||
|
||
io_uring执行一个异步I/O操作的流程为:
|
||
|
||
- 步骤1:用户程序从SQ中申请一个空闲的SQE,然后设置SQE中的I/O操作码和用户数据。
|
||
- 步骤2:用户程序调用io_uring_submit函数(内部封装了io_uring_enter系统调用)提交SQE,内核通过I/O操作码查询I/O操作表获取I/O操作函数并执行。I/O操作成功后,内核从CQ中申请一个CQE,将返回结果存储在CQE。
|
||
- 步骤3:用户程序检测CQ是否为空,如果CQ不为空,用户程序从CQ中获取CQE,并解析I/O操作返回结果。
|
||
|
||
最后,我们同样来看一下io_uring有哪些优缺点。
|
||
|
||
io_uring优点如下:
|
||
|
||
- 用户程序和内核共享内存:SQ/CQ通过mmap映射,避免传统read/write的多次数据拷贝。
|
||
- 批处理:一次提交/收割多个I/O请求,减少系统调用次数。
|
||
- SQPOLL模式:内核线程(SQ线程)主动轮询SQ,进一步减少系统调用。
|
||
|
||
io_uring在设计上并没有很大的缺陷,由于io_uring是一种比较新的网络I/O模型,所以还存在一些bug,需要持续优化。
|
||
|
||
## 3.epoll和io_uring性能对比测试
|
||
|
||
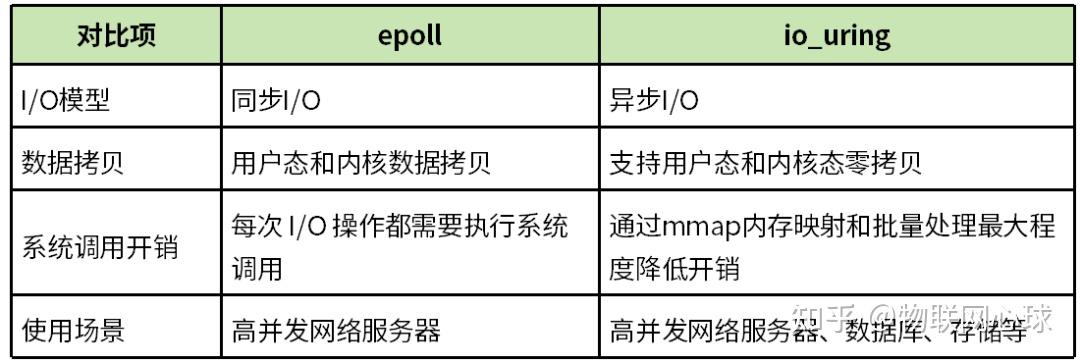
epoll和io_uring性能对比见表1。
|
||
|
||
|
||
|
||
表1 epoll和io_uring对比
|
||
|
||
从表1可以看出,io_uring在数据拷贝和系统调用开销两个方面是优于epoll的,当然,这些只是理论上的分析。下面,我们通过一个测试来验证上述观点。
|
||
|
||
### 3.1 测试环境
|
||
|
||
测试硬件环境如下:
|
||
|
||
客户端主机:AMD Ryzen 7 8845HS,8核16线程,主频3.8GHz,24G内存。
|
||
|
||
服务端主机:12th Gen Intel(R) Core(TM) i5-12500H,8核16线程,16G内存,主频4.1GHz。
|
||
|
||
局域网连接,带宽1Gbps。
|
||
|
||
### 3.2 测试用例
|
||
|
||
TCP客户端程序创建50个线程,每个线程和TCP服务端建立20000个TCP连接,总共百万个TCP连接。每个TCP连接发送和接收100个数据包(数据包长度100字节)。
|
||
|
||
客户端程序代码(只保留主线代码)如下:
|
||
|
||
```text
|
||
/* TCP连接处理线程 */
|
||
void *test_proc(void *arg) {
|
||
int pos = (int)(intptr_t)arg;
|
||
char send_buffer[BUFFER_SIZE] = {0};
|
||
char recv_buffer[BUFFER_SIZE] = {0};
|
||
memset(send_buffer, 'a', sizeof(send_buffer));
|
||
/* 每个线程建立20000个连接 */
|
||
for (int i = 0; i < REQS_THREAD; i++) {
|
||
int sockfd = do_connect(server_ip, server_port, pos);
|
||
if (sockfd == -1) continue;
|
||
/* 每个连接发送和接收100个数据包 */
|
||
for (int j = 0; j < PACKETS_THREAD; j++) {
|
||
int ret = send(sockfd, send_buffer, 100, 0);
|
||
if (ret < 0) break;
|
||
ret = recv(sockfd, recv_buffer, sizeof(recv_buffer), 0);
|
||
if (ret < 0) break;
|
||
}
|
||
close(sockfd);
|
||
}
|
||
returnNULL;
|
||
}
|
||
|
||
int main(int argc, char *argv[]) {
|
||
server_ip = argv[1];
|
||
server_port = atoi(argv[2]);
|
||
int start_pos = atoi(argv[3]);
|
||
|
||
struct timeval start, end;
|
||
gettimeofday(&start, NULL);
|
||
pthread_t th[THREADS];
|
||
/* 创建50个线程 */
|
||
for (int i = 0; i < THREADS; i++) {
|
||
int ret = pthread_create(&th[i], NULL, test_proc, (void *)(intptr_t)(start_pos + i));
|
||
if (ret != 0) {
|
||
perror("pthread_create");
|
||
}
|
||
}
|
||
|
||
for (int i = 0; i < THREADS; i++) {
|
||
pthread_join(th[i], NULL);
|
||
}
|
||
gettimeofday(&end, NULL);
|
||
/* 统计百万连接处理时间 */
|
||
double time_used = (end.tv_sec - start.tv_sec) * 1000.0 + (end.tv_usec - start.tv_usec) / 1000.0;
|
||
int reqs = (REQS_THREAD * THREADS);
|
||
double qps = reqs / (time_used / 1000.0);
|
||
|
||
printf("sucess: %d, time_used: %.0f(ms), qps: %.2f\n",
|
||
reqs, time_used, qps);
|
||
|
||
return0;
|
||
}
|
||
```
|
||
|
||
TCP服务端分为:epoll服务端和io_uring服务端。epoll服务端代码(只保留主线代码)如下:
|
||
|
||
```text
|
||
int main(int argc, char *argv[]) {
|
||
char *local_ip = argv[1];
|
||
unsignedshort local_port = atoi(argv[2]);
|
||
|
||
/* 初始化TCP服务端 */
|
||
int sockfd = init_server(local_ip, local_port);
|
||
/* 创建和初始化epoll实例 */
|
||
int epfd = epoll_create(100);
|
||
/* epoll注册监听套接字事件 */
|
||
epoll_add_event(epfd, sockfd);
|
||
while(1) {
|
||
struct epoll_event events[MAX_EVENTS] = {0};
|
||
int timeout = 2000;
|
||
int nfds = epoll_wait(epfd, events, MAX_EVENTS, timeout);
|
||
if (nfds == 0) {
|
||
continue;
|
||
} elseif (nfds == -1) {
|
||
break;
|
||
}
|
||
for (int i = 0; i < nfds; i++) {
|
||
int fd = events[i].data.fd;
|
||
if (events[i].events & EPOLLIN) {
|
||
if (fd == sockfd) {
|
||
/* 处理连接请求 */
|
||
int new_sockfd = accept(sockfd, NULL, NULL);
|
||
if (new_sockfd == -1) {
|
||
continue;
|
||
}
|
||
set_nonblock(new_sockfd);
|
||
epoll_add_event(epfd, new_sockfd);
|
||
} else {
|
||
char buf[BUF_LEN] = {0};
|
||
int len = 0;
|
||
int pos = 0;
|
||
while (1) {
|
||
/* 接收数据 */
|
||
len = recv(fd, buf+pos, ONCE_LEN, 0);
|
||
if ((len == 0) || ((len == -1) && (errno != EAGAIN))) {
|
||
close(fd);
|
||
epoll_del_event(epfd, fd);
|
||
break;
|
||
} elseif ((len == -1) && (errno == EAGAIN)) {
|
||
break;
|
||
} else {
|
||
pos += (len > 0 ? len : 0);
|
||
break;
|
||
}
|
||
}
|
||
if (pos > 0) {
|
||
/* 发送数据 */
|
||
int slen = send(fd, buf, pos, 0);
|
||
if (slen < 0) {
|
||
close(fd);
|
||
epoll_del_event(epfd, fd);
|
||
continue;
|
||
}
|
||
}
|
||
}
|
||
} else {
|
||
}
|
||
}
|
||
}
|
||
close(epfd);
|
||
close(sockfd);
|
||
return 0;
|
||
}
|
||
```
|
||
|
||
io_uring服务端代码(只保留主线代码)如下:
|
||
|
||
```text
|
||
int main(int argc, char *argv[]) {
|
||
char *server_ip = argv[1];
|
||
unsignedshort server_port = atoi(argv[2]);
|
||
|
||
int listen_fd = init_server(server_ip, server_port);
|
||
|
||
struct io_uring ring;
|
||
#if 1 /* 普通模式 */
|
||
if (io_uring_queue_init(ENTRIES, &ring, 0) < 0) {
|
||
return-1;
|
||
}
|
||
#else /* SQPOLL模式 */
|
||
struct io_uring_params params = {0};
|
||
params.flags = IORING_SETUP_SQPOLL |
|
||
IORING_SETUP_SQ_AFF;
|
||
params.sq_thread_cpu = 1;
|
||
if (io_uring_queue_init_params(ENTRIES, &ring, ¶ms) < 0) {
|
||
return1;
|
||
}
|
||
#endif
|
||
|
||
/* accept I/O请求插入SQ */
|
||
setup_accept(&ring, listen_fd);
|
||
struct io_uring_cqe *cqes[BATCH_SIZE];
|
||
while (1) {
|
||
/* 提交全部SQE */
|
||
io_uring_submit(&ring);
|
||
/* 阻塞等待CQE */
|
||
int ret = io_uring_wait_cqe(&ring, &cqes[0]);
|
||
if (ret < 0) {
|
||
break;
|
||
}
|
||
/* 批处理CQE */
|
||
int ready = io_uring_peek_batch_cqe(&ring, cqes, BATCH_SIZE);
|
||
if (ready == 0) {
|
||
continue;
|
||
}
|
||
for (int i = 0; i < ready; i++) {
|
||
struct io_uring_cqe *cqe = cqes[i];
|
||
io_info* info = (io_info*)io_uring_cqe_get_data(cqe);
|
||
switch (info->type) {
|
||
case ACCEPT:
|
||
if (cqe->res == -1) {
|
||
close(info->client_fd);
|
||
break;
|
||
}
|
||
/* 读数据I/O请求插入SQ */
|
||
setup_read(&ring, cqe->res, &info->client_addr);
|
||
/* accept I/O请求插入SQ */
|
||
setup_accept(&ring, listen_fd);
|
||
break;
|
||
case READ:
|
||
if (cqe->res > 0) {
|
||
info->bytes_read = cqe->res;
|
||
info->buffer[cqe->res] = '\0';
|
||
/* 写数据I/O请求插入SQ */
|
||
setup_write(&ring, info->client_fd,
|
||
info->buffer, info->bytes_read,
|
||
&info->client_addr);
|
||
} elseif (cqe->res <= 0) {
|
||
close(info->client_fd);
|
||
}
|
||
break;
|
||
case WRITE:
|
||
if (cqe->res > 0) {
|
||
/* 读数据I/O请求插入SQ */
|
||
setup_read(&ring, info->client_fd, &info->client_addr);
|
||
} elseif (cqe->res <= 0) {
|
||
close(info->client_fd);
|
||
}
|
||
break;
|
||
}
|
||
free_connection_info(info);
|
||
}
|
||
/* CQ推进 */
|
||
io_uring_cq_advance(&ring, ready);
|
||
}
|
||
|
||
close(listen_fd);
|
||
io_uring_queue_exit(&ring);
|
||
return0;
|
||
}
|
||
```
|
||
|
||
TCP客户端分别和两个TCP服务端建立百万连接,并分别统计处理百万连接所花费的时间。同时通过strace -c命令统计epoll服务端和io_uring服务端系统调用情况。
|
||
|
||
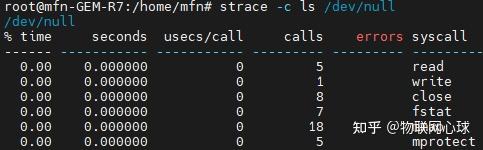
strace -c命令输出示例如下:
|
||
|
||
|
||
|
||
每一列的解析如下:
|
||
|
||
- % time:该系统调用耗时占总时间的百分比。
|
||
- seconds:该系统调用总耗时(秒)。
|
||
- usecs/call:每次调用平均耗时(微妙)。
|
||
- calls:总调用次数。
|
||
- errors:调用失败次数。
|
||
- syscall:系统调用名称。
|
||
|
||
### 3.3 测试结果
|
||
|
||
**(1)epoll服务端测试结果**
|
||
|
||
执行strace -c ./tcp_epoll 192.168.2.2 9999命令统计epoll服务端系统调用情况,统计结果如下:
|
||
|
||

|
||
|
||
epoll服务端总系统调用次数为211828279(超2亿次),除了发送和接收系统调用次数超百万次,其他系统调用(如epoll_wait、epoll_ctl)次数也有几十万次。完成百万连接测试用时632008毫秒。
|
||
|
||
**(2)io_uring服务端测试结果**
|
||
|
||
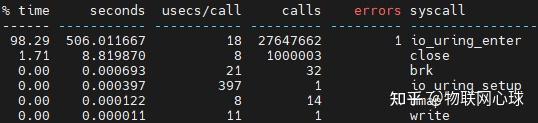
执行strace -c ./io_uring_server 192.168.2.2 9999命令统计io_uring服务端系统调用情况,统计结果如下:
|
||
|
||
|
||
|
||
开启批处理和SQ线程后,io_uring服务端总系统调用次数为28647744次(近3千万次),其中io_uring_enter系统调用次数占比为98%。百万连接测试时间为626473毫秒。
|
||
|
||
从测试结果可以看出,epoll服务端的系统调用次数远远大于io_uring服务端的系统调用次数。如果每次系统调用的处理时间约为1us,1千万次系统调用将耗时10秒,所以io_uring服务端完成百万连接测试用时相对较短。
|
||
|
||
## 总结:
|
||
|
||
文章中涉及到的epoll、io_uring以及百万并发相关的知识在我的新书《图解Linux网络编程》中有详细介绍,如果你想系统性地学习Linux网络编程,成为别人眼中的大佬,欢迎入手我的新书,书籍已经在各大电商平台上线。 |