vault backup: 2026-11-07 16:33:44
This commit is contained in:
 cheney
Vendored
+5
@@ -0,0 +1,5 @@
|
||||
{
|
||||
"promptDelete": false,
|
||||
"alwaysUpdateLinks": true,
|
||||
"attachmentFolderPath": "./attach"
|
||||
}
|
||||
Vendored
+1
@@ -0,0 +1 @@
|
||||
{}
|
||||
Vendored
+5
@@ -0,0 +1,5 @@
|
||||
[
|
||||
"consistent-attachments-and-links",
|
||||
"studio-kanban",
|
||||
"obsidian-git"
|
||||
]
|
||||
Vendored
+33
@@ -0,0 +1,33 @@
|
||||
{
|
||||
"file-explorer": true,
|
||||
"global-search": true,
|
||||
"switcher": true,
|
||||
"graph": true,
|
||||
"backlink": true,
|
||||
"canvas": true,
|
||||
"outgoing-link": true,
|
||||
"tag-pane": true,
|
||||
"properties": false,
|
||||
"page-preview": true,
|
||||
"daily-notes": true,
|
||||
"templates": true,
|
||||
"note-composer": true,
|
||||
"command-palette": true,
|
||||
"slash-command": false,
|
||||
"editor-status": true,
|
||||
"bookmarks": true,
|
||||
"markdown-importer": false,
|
||||
"zk-prefixer": false,
|
||||
"random-note": false,
|
||||
"outline": true,
|
||||
"word-count": true,
|
||||
"slides": false,
|
||||
"audio-recorder": false,
|
||||
"workspaces": false,
|
||||
"file-recovery": true,
|
||||
"publish": false,
|
||||
"sync": true,
|
||||
"webviewer": false,
|
||||
"footnotes": false,
|
||||
"bases": true
|
||||
}
|
||||
Vendored
+4
@@ -0,0 +1,4 @@
|
||||
{
|
||||
"format": "YYYY-MM WW",
|
||||
"folder": "日记"
|
||||
}
|
||||
Vendored
+10
@@ -0,0 +1,10 @@
|
||||
{
|
||||
"editor:download-attachments": [
|
||||
{
|
||||
"modifiers": [
|
||||
"Alt"
|
||||
],
|
||||
"key": "D"
|
||||
}
|
||||
]
|
||||
}
|
||||
+45996
File diff suppressed because one or more lines are too long
+10
@@ -0,0 +1,10 @@
|
||||
{
|
||||
"id": "clippermaster",
|
||||
"name": "ClipperMaster",
|
||||
"version": "0.1.10",
|
||||
"minAppVersion": "0.15.0",
|
||||
"description": "Works with the ClipperMaster Chrome extension to clip structured content from the web and save it to your vault as Markdown files.",
|
||||
"author": "ClipperMaster Team",
|
||||
"authorUrl": "https://clippermaster.com/",
|
||||
"isDesktopOnly": true
|
||||
}
|
||||
+8
@@ -0,0 +1,8 @@
|
||||
/*
|
||||
|
||||
This CSS file will be included with your plugin, and
|
||||
available in the app when your plugin is enabled.
|
||||
|
||||
If your plugin does not need CSS, delete this file.
|
||||
|
||||
*/
|
||||
@@ -0,0 +1,19 @@
|
||||
{
|
||||
"collectAttachmentUsedByMultipleNotesMode": "Skip",
|
||||
"consistencyReportFile": "consistency-report.md",
|
||||
"emptyFolderBehavior": "DeleteWithEmptyParents",
|
||||
"excludePaths": [],
|
||||
"excludePathsFromAttachmentCollecting": [],
|
||||
"includePaths": [],
|
||||
"moveAttachmentToProperFolderUsedByMultipleNotesMode": "CopyAll",
|
||||
"shouldChangeNoteBacklinksDisplayText": true,
|
||||
"shouldCollectAttachmentsAutomatically": false,
|
||||
"shouldDeleteAttachmentsWithNote": true,
|
||||
"shouldDeleteExistingFilesWhenMovingNote": false,
|
||||
"shouldMoveAttachmentsWithNote": true,
|
||||
"shouldShowBackupWarning": false,
|
||||
"shouldUpdateLinks": true,
|
||||
"treatAsAttachmentExtensions": [
|
||||
".excalidraw.md"
|
||||
]
|
||||
}
|
||||
File diff suppressed because one or more lines are too long
@@ -0,0 +1,11 @@
|
||||
{
|
||||
"id": "consistent-attachments-and-links",
|
||||
"name": "Consistent Attachments and Links",
|
||||
"version": "3.33.4",
|
||||
"minAppVersion": "1.12.4",
|
||||
"description": "This plugin ensures the consistency of attachments and links",
|
||||
"author": "Dmitry Savosh",
|
||||
"authorUrl": "https://github.com/dy-sh/",
|
||||
"isDesktopOnly": false,
|
||||
"fundingUrl": "https://www.buymeacoffee.com/mnaoumov"
|
||||
}
|
||||
@@ -0,0 +1 @@
|
||||
.consistent-attachments-and-links.obsidian-dev-utils.multiple-text-component textarea{height:6em;width:20em}
|
||||
+10951
File diff suppressed because one or more lines are too long
@@ -0,0 +1,11 @@
|
||||
{
|
||||
"id": "obsidian-clipper",
|
||||
"name": "Clipper",
|
||||
"version": "0.2.9",
|
||||
"minAppVersion": "0.15.0",
|
||||
"description": "This plugin helps you capture highlights from the web.",
|
||||
"author": "John Christopher",
|
||||
"authorUrl": "https://github.com/jgchristopher/",
|
||||
"fundingUrl": "https://www.buymeacoffee.com/jgchristopher",
|
||||
"isDesktopOnly": false
|
||||
}
|
||||
+127
@@ -0,0 +1,127 @@
|
||||
.my-4 {
|
||||
margin-top: 1rem;
|
||||
margin-bottom: 1rem;
|
||||
}
|
||||
|
||||
.ml-3 {
|
||||
margin-left: 0.75rem;
|
||||
}
|
||||
|
||||
.mt-3 {
|
||||
margin-top: 0.75rem;
|
||||
}
|
||||
|
||||
.block {
|
||||
display: block;
|
||||
}
|
||||
|
||||
.flex {
|
||||
display: flex;
|
||||
}
|
||||
|
||||
.h-5 {
|
||||
height: 1.25rem;
|
||||
}
|
||||
|
||||
.w-5 {
|
||||
width: 1.25rem;
|
||||
}
|
||||
|
||||
.flex-1 {
|
||||
flex: 1 1 0%;
|
||||
}
|
||||
|
||||
.flex-shrink-0 {
|
||||
flex-shrink: 0;
|
||||
}
|
||||
|
||||
.basis-0 {
|
||||
flex-basis: 0px;
|
||||
}
|
||||
|
||||
.flex-row {
|
||||
flex-direction: row;
|
||||
}
|
||||
|
||||
.flex-wrap {
|
||||
flex-wrap: wrap;
|
||||
}
|
||||
|
||||
.whitespace-nowrap {
|
||||
white-space: nowrap;
|
||||
}
|
||||
|
||||
.rounded-md {
|
||||
border-radius: 0.375rem;
|
||||
}
|
||||
|
||||
.border {
|
||||
border-width: 1px;
|
||||
}
|
||||
|
||||
.bg-blue-50 {
|
||||
--tw-bg-opacity: 1;
|
||||
background-color: rgb(239 246 255 / var(--tw-bg-opacity));
|
||||
}
|
||||
|
||||
.p-4 {
|
||||
padding: 1rem;
|
||||
}
|
||||
|
||||
.text-sm {
|
||||
font-size: 0.875rem;
|
||||
line-height: 1.25rem;
|
||||
}
|
||||
|
||||
.font-extrabold {
|
||||
font-weight: 800;
|
||||
}
|
||||
|
||||
.font-medium {
|
||||
font-weight: 500;
|
||||
}
|
||||
|
||||
.text-blue-400 {
|
||||
--tw-text-opacity: 1;
|
||||
color: rgb(96 165 250 / var(--tw-text-opacity));
|
||||
}
|
||||
|
||||
.text-blue-700 {
|
||||
--tw-text-opacity: 1;
|
||||
color: rgb(29 78 216 / var(--tw-text-opacity));
|
||||
}
|
||||
|
||||
a {
|
||||
color: var(--link-color);
|
||||
}
|
||||
|
||||
div.clp_section_margin {
|
||||
margin: 0 0 20px 0 !important;
|
||||
}
|
||||
|
||||
.internal-embed[alt="clipped"] h1 {
|
||||
display: none;
|
||||
}
|
||||
|
||||
.hover\:text-blue-600:hover {
|
||||
--tw-text-opacity: 1;
|
||||
color: rgb(37 99 235 / var(--tw-text-opacity));
|
||||
}
|
||||
|
||||
@media (min-width: 768px) {
|
||||
.md\:ml-6 {
|
||||
margin-left: 1.5rem;
|
||||
}
|
||||
|
||||
.md\:mt-0 {
|
||||
margin-top: 0px;
|
||||
}
|
||||
|
||||
.md\:flex {
|
||||
display: flex;
|
||||
}
|
||||
|
||||
.md\:justify-between {
|
||||
justify-content: space-between;
|
||||
}
|
||||
}
|
||||
+415
File diff suppressed because one or more lines are too long
+11
@@ -0,0 +1,11 @@
|
||||
{
|
||||
"author": "Vinzent",
|
||||
"authorUrl": "https://github.com/Vinzent03",
|
||||
"id": "obsidian-git",
|
||||
"name": "Git",
|
||||
"description": "Integrate Git version control with automatic backup and other advanced features.",
|
||||
"isDesktopOnly": false,
|
||||
"fundingUrl": "https://ko-fi.com/vinzent",
|
||||
"version": "2.43.0",
|
||||
"minAppVersion": "1.13.0"
|
||||
}
|
||||
+937
@@ -0,0 +1,937 @@
|
||||
@keyframes loading {
|
||||
0% {
|
||||
transform: rotate(0deg);
|
||||
}
|
||||
|
||||
100% {
|
||||
transform: rotate(360deg);
|
||||
}
|
||||
}
|
||||
|
||||
.workspace-leaf-content[data-type="git-view"] .button-border {
|
||||
border: 2px solid var(--interactive-accent);
|
||||
border-radius: var(--radius-s);
|
||||
}
|
||||
|
||||
.workspace-leaf-content[data-type="git-view"] .view-content {
|
||||
padding-left: 0;
|
||||
padding-top: 0;
|
||||
padding-right: 0;
|
||||
}
|
||||
|
||||
.workspace-leaf-content[data-type="git-history-view"] .view-content {
|
||||
padding-left: 0;
|
||||
padding-top: 0;
|
||||
padding-right: 0;
|
||||
}
|
||||
|
||||
.loading {
|
||||
overflow: hidden;
|
||||
}
|
||||
|
||||
.loading > svg {
|
||||
animation: 2s linear infinite loading;
|
||||
transform-origin: 50% 50%;
|
||||
display: inline-block;
|
||||
}
|
||||
|
||||
.obsidian-git-center {
|
||||
margin: auto;
|
||||
text-align: center;
|
||||
width: 50%;
|
||||
}
|
||||
|
||||
.obsidian-git-textarea {
|
||||
display: block;
|
||||
margin-left: auto;
|
||||
margin-right: auto;
|
||||
}
|
||||
|
||||
.obsidian-git-disabled {
|
||||
opacity: 0.5;
|
||||
}
|
||||
|
||||
.obsidian-git-center-button {
|
||||
display: block;
|
||||
margin: 20px auto;
|
||||
}
|
||||
|
||||
.tooltip.mod-left {
|
||||
overflow-wrap: break-word;
|
||||
}
|
||||
|
||||
.tooltip.mod-right {
|
||||
overflow-wrap: break-word;
|
||||
}
|
||||
|
||||
.tooltip.obsidian-git-commit-tooltip {
|
||||
text-align: start;
|
||||
white-space: pre-wrap;
|
||||
max-width: min(480px, 90vw);
|
||||
}
|
||||
|
||||
.obsidian-git-statusbar-conflict-indicator,
|
||||
.obsidian-git-statusbar-paused-indicator,
|
||||
.obsidian-git-statusbar-icon {
|
||||
float: left;
|
||||
}
|
||||
|
||||
.obsidian-git-statusbar-text {
|
||||
float: right;
|
||||
margin-left: 5px;
|
||||
}
|
||||
|
||||
.obsidian-git-statusbar-conflict {
|
||||
cursor: pointer;
|
||||
margin-right: 5px;
|
||||
}
|
||||
|
||||
.obsidian-git-statusbar-paused {
|
||||
margin-right: 5px;
|
||||
}
|
||||
|
||||
/* Limits the scrollbar to the view body */
|
||||
.git-view {
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
position: relative;
|
||||
height: 100%;
|
||||
}
|
||||
|
||||
/* Re-enable wrapping of nav buttns to prevent overflow on smaller screens #*/
|
||||
.workspace-drawer .git-view .nav-buttons-container {
|
||||
flex-wrap: wrap;
|
||||
}
|
||||
|
||||
.git-tools {
|
||||
display: flex;
|
||||
margin-left: auto;
|
||||
}
|
||||
.git-tools .type {
|
||||
padding-left: var(--size-2-1);
|
||||
display: flex;
|
||||
align-items: center;
|
||||
justify-content: center;
|
||||
width: 11px;
|
||||
}
|
||||
|
||||
.git-tools .type[data-type="M"] {
|
||||
color: orange;
|
||||
}
|
||||
.git-tools .type[data-type="D"] {
|
||||
color: red;
|
||||
}
|
||||
.git-tools .buttons {
|
||||
display: flex;
|
||||
}
|
||||
.git-tools .buttons > * {
|
||||
padding: 0;
|
||||
height: auto;
|
||||
}
|
||||
|
||||
.workspace-leaf-content[data-type="git-view"] .tree-item-self,
|
||||
.workspace-leaf-content[data-type="git-history-view"] .tree-item-self {
|
||||
align-items: center;
|
||||
}
|
||||
|
||||
.workspace-leaf-content[data-type="git-view"]
|
||||
.tree-item-self:hover
|
||||
.clickable-icon,
|
||||
.workspace-leaf-content[data-type="git-history-view"]
|
||||
.tree-item-self:hover
|
||||
.clickable-icon {
|
||||
color: var(--icon-color-hover);
|
||||
}
|
||||
|
||||
/* Highlight an item as active if it's diff is currently opened */
|
||||
.is-active .git-tools .buttons > * {
|
||||
color: var(--nav-item-color-active);
|
||||
}
|
||||
|
||||
.git-author {
|
||||
color: var(--text-accent);
|
||||
}
|
||||
|
||||
.git-date {
|
||||
color: var(--text-accent);
|
||||
}
|
||||
|
||||
.git-ref {
|
||||
color: var(--text-accent);
|
||||
}
|
||||
|
||||
.obsidian-git-merge-help ol {
|
||||
padding-inline-start: var(--size-4-6);
|
||||
}
|
||||
|
||||
.obsidian-git-merge-help-resolved {
|
||||
padding: var(--size-4-3);
|
||||
border-inline-start: 2px solid var(--color-green);
|
||||
background-color: var(--background-secondary);
|
||||
}
|
||||
|
||||
/* ====== diff2html ======
|
||||
The following styles are adapted from the obsidian-version-history plugin by
|
||||
@kometenstaub https://github.com/kometenstaub/obsidian-version-history-diff/blob/main/src/styles.scss
|
||||
which itself is adapted from the diff2html library with the following original license:
|
||||
|
||||
https://github.com/rtfpessoa/diff2html/blob/master/LICENSE.md
|
||||
|
||||
Copyright 2014-2016 Rodrigo Fernandes https://rtfpessoa.github.io/
|
||||
|
||||
Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated
|
||||
documentation files (the "Software"), to deal in the Software without restriction, including without limitation the
|
||||
rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit
|
||||
persons to whom the Software is furnished to do so, subject to the following conditions:
|
||||
|
||||
The above copyright notice and this permission notice shall be included in all copies or substantial portions of the
|
||||
Software.
|
||||
|
||||
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE
|
||||
WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR
|
||||
COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR
|
||||
OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.
|
||||
*/
|
||||
|
||||
.theme-dark,
|
||||
.theme-light {
|
||||
--git-delete-bg: #ff475040;
|
||||
--git-delete-hl: #96050a75;
|
||||
--git-insert-bg: #68d36840;
|
||||
--git-insert-hl: #23c02350;
|
||||
--git-change-bg: #ffd55840;
|
||||
--git-selected: #3572b0;
|
||||
|
||||
--git-delete: #cc3333;
|
||||
--git-insert: #399839;
|
||||
--git-change: #d0b44c;
|
||||
--git-move: #3572b0;
|
||||
|
||||
--git-conflict-ours: var(--color-cyan);
|
||||
--git-conflict-theirs: var(--color-blue);
|
||||
--git-conflict-ours-bg: color-mix(
|
||||
in oklch,
|
||||
var(--git-conflict-ours) 10%,
|
||||
transparent
|
||||
);
|
||||
--git-conflict-theirs-bg: color-mix(
|
||||
in oklch,
|
||||
var(--git-conflict-theirs) 10%,
|
||||
transparent
|
||||
);
|
||||
--git-conflict-ours-header-bg: color-mix(
|
||||
in oklch,
|
||||
var(--git-conflict-ours) 25%,
|
||||
transparent
|
||||
);
|
||||
--git-conflict-theirs-header-bg: color-mix(
|
||||
in oklch,
|
||||
var(--git-conflict-theirs) 25%,
|
||||
transparent
|
||||
);
|
||||
--git-conflict-ours-button-bg: color-mix(
|
||||
in oklab,
|
||||
var(--git-conflict-ours) 25%,
|
||||
var(--interactive-normal)
|
||||
);
|
||||
--git-conflict-theirs-button-bg: color-mix(
|
||||
in oklab,
|
||||
var(--git-conflict-theirs) 25%,
|
||||
var(--interactive-normal)
|
||||
);
|
||||
--git-conflict-base-button-bg: color-mix(
|
||||
in oklab,
|
||||
var(--color-purple) 15%,
|
||||
var(--interactive-normal)
|
||||
);
|
||||
--git-conflict-base-bg: color-mix(
|
||||
in oklch,
|
||||
var(--color-purple) 4%,
|
||||
transparent
|
||||
);
|
||||
}
|
||||
|
||||
.git-diff {
|
||||
.d2h-d-none {
|
||||
display: none;
|
||||
}
|
||||
.d2h-wrapper {
|
||||
text-align: left;
|
||||
border-radius: 0.25em;
|
||||
overflow: auto;
|
||||
}
|
||||
.d2h-file-header.d2h-file-header {
|
||||
background-color: var(--background-secondary);
|
||||
border-bottom: 1px solid var(--background-modifier-border);
|
||||
font-family:
|
||||
Source Sans Pro,
|
||||
Helvetica Neue,
|
||||
Helvetica,
|
||||
Arial,
|
||||
sans-serif;
|
||||
height: 35px;
|
||||
padding: 5px 10px;
|
||||
}
|
||||
.d2h-file-header,
|
||||
.d2h-file-stats {
|
||||
display: -webkit-box;
|
||||
display: -ms-flexbox;
|
||||
display: flex;
|
||||
}
|
||||
.d2h-file-header {
|
||||
display: none;
|
||||
}
|
||||
.d2h-file-stats {
|
||||
font-size: 14px;
|
||||
margin-left: auto;
|
||||
}
|
||||
.d2h-lines-added {
|
||||
border: 1px solid var(--color-green);
|
||||
border-radius: 5px 0 0 5px;
|
||||
color: var(--color-green);
|
||||
padding: 2px;
|
||||
text-align: right;
|
||||
vertical-align: middle;
|
||||
}
|
||||
.d2h-lines-deleted {
|
||||
border: 1px solid var(--color-red);
|
||||
border-radius: 0 5px 5px 0;
|
||||
color: var(--color-red);
|
||||
margin-left: 1px;
|
||||
padding: 2px;
|
||||
text-align: left;
|
||||
vertical-align: middle;
|
||||
}
|
||||
.d2h-file-name-wrapper {
|
||||
-webkit-box-align: center;
|
||||
-ms-flex-align: center;
|
||||
align-items: center;
|
||||
display: -webkit-box;
|
||||
display: -ms-flexbox;
|
||||
display: flex;
|
||||
font-size: 15px;
|
||||
width: 100%;
|
||||
}
|
||||
.d2h-file-name {
|
||||
overflow: hidden;
|
||||
text-overflow: ellipsis;
|
||||
white-space: nowrap;
|
||||
color: var(--text-normal);
|
||||
font-size: var(--h5-size);
|
||||
}
|
||||
.d2h-file-wrapper {
|
||||
border: 1px solid var(--background-secondary-alt);
|
||||
border-radius: 3px;
|
||||
margin-bottom: 1em;
|
||||
max-height: 100%;
|
||||
}
|
||||
.d2h-file-collapse {
|
||||
-webkit-box-pack: end;
|
||||
-ms-flex-pack: end;
|
||||
-webkit-box-align: center;
|
||||
-ms-flex-align: center;
|
||||
align-items: center;
|
||||
border: 1px solid var(--background-secondary-alt);
|
||||
border-radius: 3px;
|
||||
cursor: pointer;
|
||||
display: none;
|
||||
font-size: 12px;
|
||||
justify-content: flex-end;
|
||||
padding: 4px 8px;
|
||||
}
|
||||
.d2h-file-collapse.d2h-selected {
|
||||
background-color: var(--git-selected);
|
||||
}
|
||||
.d2h-file-collapse-input {
|
||||
margin: 0 4px 0 0;
|
||||
}
|
||||
.d2h-diff-table {
|
||||
border-collapse: collapse;
|
||||
font-family: var(--font-monospace);
|
||||
font-size: var(--code-size);
|
||||
width: 100%;
|
||||
}
|
||||
.d2h-files-diff {
|
||||
width: 100%;
|
||||
}
|
||||
.d2h-file-diff {
|
||||
/*
|
||||
overflow-y: scroll;
|
||||
*/
|
||||
border-radius: 5px;
|
||||
font-size: var(--font-text-size);
|
||||
line-height: var(--line-height-normal);
|
||||
}
|
||||
.d2h-file-side-diff {
|
||||
display: inline-block;
|
||||
margin-bottom: -8px;
|
||||
margin-right: -4px;
|
||||
overflow-x: scroll;
|
||||
overflow-y: hidden;
|
||||
width: 50%;
|
||||
}
|
||||
.d2h-code-line {
|
||||
padding-left: 6em;
|
||||
padding-right: 1.5em;
|
||||
}
|
||||
.d2h-code-line,
|
||||
.d2h-code-side-line {
|
||||
display: inline-block;
|
||||
-webkit-user-select: none;
|
||||
-moz-user-select: none;
|
||||
-ms-user-select: none;
|
||||
user-select: none;
|
||||
white-space: nowrap;
|
||||
width: 100%;
|
||||
}
|
||||
.d2h-code-side-line {
|
||||
/* needed to be changed */
|
||||
padding-left: 0.5em;
|
||||
padding-right: 0.5em;
|
||||
}
|
||||
.d2h-code-line-ctn {
|
||||
word-wrap: normal;
|
||||
background: none;
|
||||
display: inline-block;
|
||||
padding: 0;
|
||||
-webkit-user-select: text;
|
||||
-moz-user-select: text;
|
||||
-ms-user-select: text;
|
||||
user-select: text;
|
||||
vertical-align: middle;
|
||||
width: 100%;
|
||||
/* only works for line-by-line */
|
||||
white-space: pre-wrap;
|
||||
}
|
||||
.d2h-code-line del,
|
||||
.d2h-code-side-line del {
|
||||
background-color: var(--git-delete-hl);
|
||||
color: var(--text-normal);
|
||||
}
|
||||
.d2h-code-line del,
|
||||
.d2h-code-line ins,
|
||||
.d2h-code-side-line del,
|
||||
.d2h-code-side-line ins {
|
||||
border-radius: 0.2em;
|
||||
display: inline-block;
|
||||
margin-top: -1px;
|
||||
text-decoration: none;
|
||||
vertical-align: middle;
|
||||
}
|
||||
.d2h-code-line ins,
|
||||
.d2h-code-side-line ins {
|
||||
background-color: var(--git-insert-hl);
|
||||
text-align: left;
|
||||
}
|
||||
.d2h-code-line-prefix {
|
||||
word-wrap: normal;
|
||||
background: none;
|
||||
display: inline;
|
||||
padding: 0;
|
||||
white-space: pre;
|
||||
}
|
||||
.line-num1 {
|
||||
float: left;
|
||||
}
|
||||
.line-num1,
|
||||
.line-num2 {
|
||||
-webkit-box-sizing: border-box;
|
||||
box-sizing: border-box;
|
||||
overflow: hidden;
|
||||
/*
|
||||
padding: 0 0.5em;
|
||||
*/
|
||||
text-overflow: ellipsis;
|
||||
width: 2.5em;
|
||||
padding-left: 0;
|
||||
}
|
||||
.line-num2 {
|
||||
float: right;
|
||||
}
|
||||
.d2h-code-linenumber {
|
||||
background-color: var(--background-primary);
|
||||
border: solid var(--background-modifier-border);
|
||||
border-width: 0 1px;
|
||||
-webkit-box-sizing: border-box;
|
||||
box-sizing: border-box;
|
||||
color: var(--text-faint);
|
||||
cursor: pointer;
|
||||
display: inline-block;
|
||||
position: absolute;
|
||||
text-align: right;
|
||||
width: 5.5em;
|
||||
}
|
||||
.d2h-code-linenumber:after {
|
||||
content: "\200b";
|
||||
}
|
||||
.d2h-code-side-linenumber {
|
||||
background-color: var(--background-primary);
|
||||
border: solid var(--background-modifier-border);
|
||||
border-width: 0 1px;
|
||||
-webkit-box-sizing: border-box;
|
||||
box-sizing: border-box;
|
||||
color: var(--text-faint);
|
||||
cursor: pointer;
|
||||
overflow: hidden;
|
||||
padding: 0 0.5em;
|
||||
text-align: right;
|
||||
text-overflow: ellipsis;
|
||||
width: 4em;
|
||||
/* needed to be changed */
|
||||
display: table-cell;
|
||||
position: relative;
|
||||
}
|
||||
.d2h-code-side-linenumber:after {
|
||||
content: "\200b";
|
||||
}
|
||||
.d2h-code-side-emptyplaceholder,
|
||||
.d2h-emptyplaceholder {
|
||||
background-color: var(--background-primary);
|
||||
border-color: var(--background-modifier-border);
|
||||
}
|
||||
.d2h-code-line-prefix,
|
||||
.d2h-code-linenumber,
|
||||
.d2h-code-side-linenumber,
|
||||
.d2h-emptyplaceholder {
|
||||
-webkit-user-select: none;
|
||||
-moz-user-select: none;
|
||||
-ms-user-select: none;
|
||||
user-select: none;
|
||||
}
|
||||
.d2h-code-linenumber,
|
||||
.d2h-code-side-linenumber {
|
||||
direction: rtl;
|
||||
}
|
||||
.d2h-del {
|
||||
background-color: var(--git-delete-bg);
|
||||
border-color: var(--git-delete-hl);
|
||||
}
|
||||
.d2h-ins {
|
||||
background-color: var(--git-insert-bg);
|
||||
border-color: var(--git-insert-hl);
|
||||
}
|
||||
.d2h-info {
|
||||
background-color: var(--background-primary);
|
||||
border-color: var(--background-modifier-border);
|
||||
color: var(--text-faint);
|
||||
}
|
||||
.d2h-del,
|
||||
.d2h-ins,
|
||||
.d2h-file-diff .d2h-change {
|
||||
color: var(--text-normal);
|
||||
}
|
||||
.d2h-file-diff .d2h-del.d2h-change {
|
||||
background-color: var(--git-change-bg);
|
||||
}
|
||||
.d2h-file-diff .d2h-ins.d2h-change {
|
||||
background-color: var(--git-insert-bg);
|
||||
}
|
||||
.d2h-file-list-wrapper {
|
||||
a {
|
||||
text-decoration: none;
|
||||
cursor: default;
|
||||
-webkit-user-drag: none;
|
||||
}
|
||||
|
||||
svg {
|
||||
display: none;
|
||||
}
|
||||
}
|
||||
.d2h-file-list-header {
|
||||
text-align: left;
|
||||
}
|
||||
.d2h-file-list-title {
|
||||
display: none;
|
||||
}
|
||||
.d2h-file-list-line {
|
||||
display: -webkit-box;
|
||||
display: -ms-flexbox;
|
||||
display: flex;
|
||||
text-align: left;
|
||||
}
|
||||
.d2h-file-list {
|
||||
}
|
||||
.d2h-file-list > li {
|
||||
border-bottom: 1px solid var(--background-modifier-border);
|
||||
margin: 0;
|
||||
padding: 5px 10px;
|
||||
}
|
||||
.d2h-file-list > li:last-child {
|
||||
border-bottom: none;
|
||||
}
|
||||
.d2h-file-switch {
|
||||
cursor: pointer;
|
||||
display: none;
|
||||
font-size: 10px;
|
||||
}
|
||||
.d2h-icon {
|
||||
fill: currentColor;
|
||||
margin-right: 10px;
|
||||
vertical-align: middle;
|
||||
}
|
||||
.d2h-deleted {
|
||||
color: var(--git-delete);
|
||||
}
|
||||
.d2h-added {
|
||||
color: var(--git-insert);
|
||||
}
|
||||
.d2h-changed {
|
||||
color: var(--git-change);
|
||||
}
|
||||
.d2h-moved {
|
||||
color: var(--git-move);
|
||||
}
|
||||
.d2h-tag {
|
||||
background-color: var(--background-secondary);
|
||||
display: -webkit-box;
|
||||
display: -ms-flexbox;
|
||||
display: flex;
|
||||
font-size: 10px;
|
||||
margin-left: 5px;
|
||||
padding: 0 2px;
|
||||
}
|
||||
.d2h-deleted-tag {
|
||||
border: 1px solid var(--git-delete);
|
||||
}
|
||||
.d2h-added-tag {
|
||||
border: 1px solid var(--git-insert);
|
||||
}
|
||||
.d2h-changed-tag {
|
||||
border: 1px solid var(--git-change);
|
||||
}
|
||||
.d2h-moved-tag {
|
||||
border: 1px solid var(--git-move);
|
||||
}
|
||||
|
||||
/* needed for line-by-line*/
|
||||
|
||||
.d2h-diff-tbody {
|
||||
position: relative;
|
||||
}
|
||||
|
||||
/* My additions */
|
||||
.cm-merge-revert {
|
||||
width: 4em;
|
||||
}
|
||||
/* Ensure that merge revert markers are positioned correctly */
|
||||
.cm-merge-revert > * {
|
||||
position: absolute;
|
||||
background-color: var(--background-secondary);
|
||||
display: flex;
|
||||
}
|
||||
}
|
||||
|
||||
/* ====================== Line Authoring Information ====================== */
|
||||
|
||||
.markdown-source-view.mod-cm6 .cm-gutters.obsidian-git-line-author-gutters {
|
||||
margin-left: unset;
|
||||
}
|
||||
|
||||
.cm-gutterElement.obs-git-blame-gutter {
|
||||
/* Add background color to spacing inbetween and around the gutter for better aesthetics */
|
||||
border-width: 0px 2px 0.2px;
|
||||
border-style: solid;
|
||||
border-color: var(--background-secondary);
|
||||
background-color: var(--background-secondary);
|
||||
}
|
||||
|
||||
.cm-gutterElement.obs-git-blame-gutter > div,
|
||||
.line-author-settings-preview {
|
||||
/* delegate text color to settings */
|
||||
color: var(--obs-git-gutter-text);
|
||||
font-family: monospace;
|
||||
height: 100%; /* ensure, that age-based background color occupies entire parent */
|
||||
text-align: right;
|
||||
padding: 0px 6px;
|
||||
white-space: pre; /* Keep spaces and do not collapse them. */
|
||||
}
|
||||
|
||||
@media (max-width: 800px) {
|
||||
/* hide git blame gutter not to superpose text */
|
||||
.cm-gutterElement.obs-git-blame-gutter {
|
||||
display: none;
|
||||
}
|
||||
}
|
||||
|
||||
.git-unified-diff-view,
|
||||
.git-split-diff-view .cm-deletedLine .cm-changedText {
|
||||
background-color: #ee443330;
|
||||
}
|
||||
|
||||
.git-unified-diff-view,
|
||||
.git-split-diff-view .cm-insertedLine .cm-changedText {
|
||||
background-color: #22bb2230;
|
||||
}
|
||||
|
||||
.git-obscure-prompt .git-show-password {
|
||||
margin-right: 32px;
|
||||
}
|
||||
|
||||
.git-obscure-prompt[git-is-obscured="true"] #git-show-password:after {
|
||||
-webkit-mask-image: url('data:image/svg+xml,<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2" stroke-linecap="round" stroke-linejoin="round" class="svg-icon lucide-eye"><path d="M2.062 12.348a1 1 0 0 1 0-.696 10.75 10.75 0 0 1 19.876 0 1 1 0 0 1 0 .696 10.75 10.75 0 0 1-19.876 0"></path><circle cx="12" cy="12" r="3"></circle></svg>');
|
||||
}
|
||||
|
||||
.git-obscure-prompt[git-is-obscured="false"] #git-show-password:after {
|
||||
-webkit-mask-image: url('data:image/svg+xml,<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 24 24" fill="none" stroke="currentColor" stroke-width="2" stroke-linecap="round" stroke-linejoin="round" class="svg-icon lucide-eye-off"><path d="M10.733 5.076a10.744 10.744 0 0 1 11.205 6.575 1 1 0 0 1 0 .696 10.747 10.747 0 0 1-1.444 2.49"></path><path d="M14.084 14.158a3 3 0 0 1-4.242-4.242"></path><path d="M17.479 17.499a10.75 10.75 0 0 1-15.417-5.151 1 1 0 0 1 0-.696 10.75 10.75 0 0 1 4.446-5.143"></path><path d="m2 2 20 20"></path></svg>');
|
||||
}
|
||||
|
||||
/* Override styling of Codemirror merge view "collapsed lines" indicator */
|
||||
.git-split-diff-view .ͼ2 .cm-collapsedLines {
|
||||
background: var(--interactive-normal);
|
||||
border-radius: var(--radius-m);
|
||||
color: var(--text-accent);
|
||||
font-size: var(--font-small);
|
||||
padding: var(--size-4-1) var(--size-4-1);
|
||||
}
|
||||
.git-split-diff-view .ͼ2 .cm-collapsedLines:hover {
|
||||
background: var(--interactive-hover);
|
||||
color: var(--text-accent-hover);
|
||||
}
|
||||
|
||||
.git-signs-gutter {
|
||||
.cm-gutterElement {
|
||||
display: grid;
|
||||
|
||||
/* Needed to align the sign properly for different line heigts. Such as
|
||||
* when having a heading or list item.
|
||||
*/
|
||||
padding-top: 0 !important;
|
||||
}
|
||||
}
|
||||
|
||||
.git-gutter-marker:hover {
|
||||
border-radius: 2px;
|
||||
}
|
||||
|
||||
.git-gutter-marker.git-add {
|
||||
background-color: var(--color-green);
|
||||
justify-self: center;
|
||||
height: inherit;
|
||||
width: 0.2rem;
|
||||
}
|
||||
|
||||
.git-gutter-marker.git-change {
|
||||
background-color: var(--color-yellow);
|
||||
justify-self: center;
|
||||
height: inherit;
|
||||
width: 0.2rem;
|
||||
}
|
||||
|
||||
.git-gutter-marker.git-changedelete {
|
||||
color: var(--color-yellow);
|
||||
font-weight: var(--font-bold);
|
||||
font-size: 1rem;
|
||||
justify-self: center;
|
||||
height: inherit;
|
||||
}
|
||||
|
||||
.git-gutter-marker.git-delete {
|
||||
background-color: var(--color-red);
|
||||
height: 0.2rem;
|
||||
width: 0.8rem;
|
||||
align-self: end;
|
||||
}
|
||||
|
||||
.git-gutter-marker.git-topdelete {
|
||||
background-color: var(--color-red);
|
||||
height: 0.2rem;
|
||||
width: 0.8rem;
|
||||
align-self: start;
|
||||
}
|
||||
|
||||
div:hover > .git-gutter-marker.git-change {
|
||||
width: 0.6rem;
|
||||
}
|
||||
|
||||
div:hover > .git-gutter-marker.git-add {
|
||||
width: 0.6rem;
|
||||
}
|
||||
|
||||
div:hover > .git-gutter-marker.git-delete {
|
||||
height: 0.6rem;
|
||||
}
|
||||
|
||||
div:hover > .git-gutter-marker.git-topdelete {
|
||||
height: 0.6rem;
|
||||
}
|
||||
|
||||
div:hover > .git-gutter-marker.git-changedelete {
|
||||
font-weight: var(--font-bold);
|
||||
}
|
||||
|
||||
.git-gutter-marker.staged {
|
||||
opacity: 0.5;
|
||||
}
|
||||
|
||||
/* Prevent shifting of the editor when git signs gutter is the only gutter present */
|
||||
.cm-gutters.cm-gutters-before:has(> .git-signs-gutter:only-child) {
|
||||
margin-inline-end: 0;
|
||||
.git-signs-gutter {
|
||||
margin-inline-start: -1rem;
|
||||
}
|
||||
}
|
||||
|
||||
.git-changes-status-bar-colored {
|
||||
.git-add {
|
||||
color: var(--color-green);
|
||||
}
|
||||
.git-change {
|
||||
color: var(--color-yellow);
|
||||
}
|
||||
.git-delete {
|
||||
color: var(--color-red);
|
||||
}
|
||||
}
|
||||
|
||||
.git-changes-status-bar .git-add {
|
||||
margin-right: 0.3em;
|
||||
}
|
||||
|
||||
.git-changes-status-bar .git-change {
|
||||
margin-right: 0.3em;
|
||||
}
|
||||
|
||||
.cm-line.git-conflict-marker-line {
|
||||
display: flex !important;
|
||||
align-items: center;
|
||||
background-color: var(--background-modifier-hover);
|
||||
}
|
||||
|
||||
.cm-line.git-conflict-marker-line.HyperMD-quote {
|
||||
/* The closing Git marker (`>>>>>>>`) is parsed by Live Preview as nested
|
||||
* Markdown blockquotes. Obsidian marks these layout rules as important, so
|
||||
* the conflict marker must use important as well to undo that styling. */
|
||||
text-indent: 0 !important;
|
||||
padding-inline-start: 0 !important;
|
||||
border-inline-start: none !important;
|
||||
}
|
||||
|
||||
.git-conflict-marker {
|
||||
background-color: transparent;
|
||||
}
|
||||
|
||||
.markdown-source-view.mod-cm6
|
||||
.cm-line.git-conflict-marker-line.git-conflict-marker-ours {
|
||||
background-color: var(--git-conflict-ours-header-bg);
|
||||
}
|
||||
|
||||
.markdown-source-view.mod-cm6
|
||||
.cm-line.git-conflict-marker-line.git-conflict-marker-theirs {
|
||||
background-color: var(--git-conflict-theirs-header-bg);
|
||||
}
|
||||
|
||||
.git-conflict-panel {
|
||||
display: flex;
|
||||
align-items: center;
|
||||
gap: var(--size-2-2);
|
||||
padding: var(--size-2-2) var(--size-4-2);
|
||||
background-color: var(--background-secondary);
|
||||
border-bottom: 1px solid var(--background-modifier-border);
|
||||
}
|
||||
|
||||
.git-conflict-panel-label {
|
||||
color: var(--text-muted);
|
||||
font-size: var(--font-ui-smaller);
|
||||
margin-inline-end: auto;
|
||||
}
|
||||
|
||||
.is-mobile .git-conflict-panel {
|
||||
flex-direction: column;
|
||||
align-items: stretch;
|
||||
}
|
||||
|
||||
.is-mobile .git-conflict-panel .git-conflict-actions-group {
|
||||
flex-wrap: wrap;
|
||||
}
|
||||
|
||||
.is-mobile .git-conflict-panel .nav-action-button {
|
||||
flex: 1 1 auto;
|
||||
}
|
||||
|
||||
.git-conflict-actions-group {
|
||||
display: inline-flex;
|
||||
gap: 0;
|
||||
overflow: hidden;
|
||||
border: 1px solid var(--background-modifier-border);
|
||||
border-radius: var(--radius-s);
|
||||
|
||||
.nav-action-button {
|
||||
margin: 0;
|
||||
border-radius: 0;
|
||||
font-weight: bold;
|
||||
padding: var(--size-2-3);
|
||||
}
|
||||
|
||||
.nav-action-button + .nav-action-button {
|
||||
border-left: 1px solid var(--background-modifier-border);
|
||||
}
|
||||
}
|
||||
|
||||
.git-conflict-actions-group .git-conflict-choose-ours {
|
||||
background-color: var(--git-conflict-ours-button-bg);
|
||||
color: var(--text-normal);
|
||||
}
|
||||
|
||||
.git-conflict-actions-group .git-conflict-choose-theirs {
|
||||
background-color: var(--git-conflict-theirs-button-bg);
|
||||
color: var(--text-normal);
|
||||
}
|
||||
|
||||
.git-conflict-actions-group .git-conflict-choose-base {
|
||||
background-color: var(--git-conflict-base-button-bg);
|
||||
color: var(--text-normal);
|
||||
}
|
||||
|
||||
.git-conflict-actions-group .git-conflict-choose-both {
|
||||
background-color: var(--interactive-normal);
|
||||
color: var(--text-normal);
|
||||
}
|
||||
|
||||
.git-conflict-actions-widget {
|
||||
flex: none;
|
||||
margin-left: var(--size-2-2);
|
||||
border-radius: 0;
|
||||
}
|
||||
|
||||
.cm-line.git-conflict-ours-line {
|
||||
background-color: var(--git-conflict-ours-bg);
|
||||
}
|
||||
|
||||
.cm-line.git-conflict-theirs-line {
|
||||
background-color: var(--git-conflict-theirs-bg);
|
||||
}
|
||||
|
||||
.cm-line.git-conflict-base-line {
|
||||
background-color: var(--git-conflict-base-bg);
|
||||
}
|
||||
|
||||
.cm-line.git-conflict-marker-line::after {
|
||||
content: "";
|
||||
flex: 1;
|
||||
margin-left: var(--size-2-2);
|
||||
}
|
||||
|
||||
.cm-line.git-conflict-marker-line .git-conflict-actions-widget {
|
||||
order: 2;
|
||||
}
|
||||
|
||||
.is-mobile .cm-line.git-conflict-marker-line {
|
||||
flex-wrap: wrap;
|
||||
}
|
||||
|
||||
.is-mobile .cm-line.git-conflict-marker-line::after {
|
||||
display: none;
|
||||
}
|
||||
|
||||
.is-mobile .cm-line.git-conflict-marker-line .git-conflict-actions-widget {
|
||||
flex: 0 0 100%;
|
||||
margin: var(--size-2-1) 0 0;
|
||||
}
|
||||
|
||||
.is-mobile .git-conflict-actions-widget {
|
||||
flex-wrap: wrap;
|
||||
}
|
||||
|
||||
.is-mobile .git-conflict-actions-widget .nav-action-button {
|
||||
flex: 1 1 auto;
|
||||
}
|
||||
+28
@@ -0,0 +1,28 @@
|
||||
{
|
||||
"foldMode": "auto",
|
||||
"cardLimit": 4,
|
||||
"currency": "¥",
|
||||
"accent": "#D7F25C",
|
||||
"showSidebar": true,
|
||||
"newBoardFolder": "",
|
||||
"fontSize": "s",
|
||||
"language": "auto",
|
||||
"show": {
|
||||
"priority": true,
|
||||
"date": true,
|
||||
"assignee": true,
|
||||
"value": true,
|
||||
"description": true,
|
||||
"tags": true,
|
||||
"images": true,
|
||||
"headerStats": true,
|
||||
"headerPeople": true,
|
||||
"sideTags": true,
|
||||
"sidePeople": true
|
||||
},
|
||||
"image": {
|
||||
"layout": "cover",
|
||||
"height": "m",
|
||||
"fit": "cover"
|
||||
}
|
||||
}
|
||||
+19
File diff suppressed because one or more lines are too long
@@ -0,0 +1,9 @@
|
||||
{
|
||||
"id": "studio-kanban",
|
||||
"name": "Kanban Studio",
|
||||
"version": "0.4.1",
|
||||
"minAppVersion": "1.8.7",
|
||||
"description": "干净、现代的看板:优先级、日期、负责人、标签、图片、拖拽,数据就是普通的 Markdown.",
|
||||
"author": "Adrian",
|
||||
"isDesktopOnly": false
|
||||
}
|
||||
+679
@@ -0,0 +1,679 @@
|
||||
/* Kanban Studio — 样式
|
||||
* 所有颜色都是 .sk-root 上的变量,想调配色只改这一段即可。
|
||||
*/
|
||||
|
||||
.sk-root {
|
||||
--sk-bg: #FFFFFF;
|
||||
--sk-panel: #F4F4F2;
|
||||
--sk-panel-2: #ECECEA;
|
||||
--sk-card: #FFFFFF;
|
||||
--sk-chip: #F3F3F1;
|
||||
--sk-line: #E8E8E5;
|
||||
--sk-text: #18191B;
|
||||
--sk-text-2: #4F5257;
|
||||
--sk-text-3: #74777C;
|
||||
--sk-ink: #1C1D1F;
|
||||
--sk-ink-text: #FFFFFF;
|
||||
--sk-danger: #C9401F;
|
||||
--sk-danger-bg: #FCE9E3;
|
||||
--sk-ok: #3F7A3A;
|
||||
--sk-accent: var(--sk-accent-global, #D7F25C);
|
||||
--sk-accent-ink: var(--sk-accent-ink-global, #18191B);
|
||||
--sk-shadow: 0 1px 2px rgba(24, 25, 27, .05), 0 0 0 1px rgba(24, 25, 27, .025);
|
||||
--sk-shadow-lift: 0 12px 28px rgba(24, 25, 27, .12), 0 2px 6px rgba(24, 25, 27, .06);
|
||||
--sk-r-xl: 24px;
|
||||
--sk-r-lg: 16px;
|
||||
--sk-r-md: 12px;
|
||||
--sk-fs: 1;
|
||||
--sk-font: var(--font-interface, -apple-system, "PingFang SC", "Microsoft YaHei", sans-serif);
|
||||
}
|
||||
|
||||
.theme-dark .sk-root {
|
||||
--sk-bg: #131416;
|
||||
--sk-panel: #1B1C1F;
|
||||
--sk-panel-2: #232428;
|
||||
--sk-card: #24252A;
|
||||
--sk-chip: #2F3036;
|
||||
--sk-line: #2E2F34;
|
||||
--sk-text: #EDEDEB;
|
||||
--sk-text-2: #C2C4C8;
|
||||
--sk-text-3: #9B9EA3;
|
||||
--sk-ink: #EDEDEB;
|
||||
--sk-ink-text: #131416;
|
||||
--sk-danger: #FF8F75;
|
||||
--sk-danger-bg: rgba(255, 128, 100, .14);
|
||||
--sk-ok: #A8D69F;
|
||||
--sk-shadow: 0 0 0 1px rgba(255, 255, 255, .04);
|
||||
--sk-shadow-lift: 0 14px 32px rgba(0, 0, 0, .45), 0 0 0 1px rgba(255, 255, 255, .06);
|
||||
}
|
||||
|
||||
.workspace-leaf-content[data-type="studio-kanban-view"] .view-content.sk-view-content {
|
||||
padding: 0;
|
||||
overflow: hidden;
|
||||
}
|
||||
|
||||
/* ---------- 字号档位 ---------- */
|
||||
.sk-root.sk-size-s { --sk-fs: .9; }
|
||||
.sk-root.sk-size-m { --sk-fs: 1; }
|
||||
.sk-root.sk-size-l { --sk-fs: 1.14; }
|
||||
|
||||
/* ---------- 布局 ---------- */
|
||||
|
||||
.sk-root {
|
||||
display: flex;
|
||||
gap: 20px;
|
||||
height: 100%;
|
||||
padding: 16px;
|
||||
box-sizing: border-box;
|
||||
background: var(--sk-bg);
|
||||
color: var(--sk-text);
|
||||
font-family: var(--sk-font);
|
||||
font-size: calc(14px * var(--sk-fs, 1));
|
||||
-webkit-font-smoothing: antialiased;
|
||||
}
|
||||
.sk-root * { box-sizing: border-box; }
|
||||
.sk-root .sk-spacer { flex: 1 1 auto; }
|
||||
.sk-root .sk-ico { display: inline-flex; align-items: center; justify-content: center; flex: none; }
|
||||
.sk-root .sk-ico svg { width: 16px; height: 16px; stroke-width: 1.75; }
|
||||
|
||||
/* 重置 Obsidian 的按钮样式 */
|
||||
.sk-root button.sk-btn {
|
||||
appearance: none;
|
||||
border: 0;
|
||||
background: none;
|
||||
box-shadow: none;
|
||||
margin: 0;
|
||||
padding: 0;
|
||||
height: auto;
|
||||
font: inherit;
|
||||
color: inherit;
|
||||
cursor: pointer;
|
||||
display: inline-flex;
|
||||
align-items: center;
|
||||
gap: 8px;
|
||||
transition: background-color .15s ease, color .15s ease, box-shadow .15s ease, transform .15s ease;
|
||||
}
|
||||
.sk-root button.sk-btn:focus-visible,
|
||||
.sk-root .sk-card:focus-visible {
|
||||
outline: 2px solid var(--sk-text);
|
||||
outline-offset: 2px;
|
||||
}
|
||||
|
||||
/* ---------- 侧栏 ---------- */
|
||||
|
||||
.sk-root .sk-side {
|
||||
flex: 0 0 264px;
|
||||
width: 264px;
|
||||
transition: flex-basis .28s ease, width .28s ease, padding .28s ease, margin .28s ease, opacity .2s ease;
|
||||
display: flex;
|
||||
flex-direction: column;
|
||||
gap: 14px;
|
||||
padding: 22px 16px 16px;
|
||||
background: var(--sk-panel);
|
||||
border-radius: var(--sk-r-xl);
|
||||
overflow-y: auto;
|
||||
}
|
||||
/* 内容超出高度时让侧栏滚动,而不是把搜索框等子元素压扁 */
|
||||
.sk-root .sk-side > * { flex-shrink: 0; }
|
||||
.sk-root .sk-side-head { display: flex; align-items: center; justify-content: space-between; gap: 8px; padding: 0 4px; }
|
||||
.sk-root button.sk-round {
|
||||
width: 40px; height: 40px; justify-content: center;
|
||||
border-radius: 999px; background: var(--sk-card); box-shadow: var(--sk-shadow);
|
||||
}
|
||||
.sk-root button.sk-round:hover { transform: rotate(90deg); }
|
||||
|
||||
.sk-root .sk-seg {
|
||||
display: grid; grid-template-columns: 1fr 1fr; gap: 4px;
|
||||
padding: 4px; border-radius: 999px; background: var(--sk-panel-2);
|
||||
}
|
||||
.sk-root button.sk-seg-btn {
|
||||
justify-content: center; height: 36px; border-radius: 999px;
|
||||
color: var(--sk-text-3); font-size: calc(13.5px * var(--sk-fs, 1));
|
||||
}
|
||||
.sk-root button.sk-seg-btn.is-active { background: var(--sk-card); color: var(--sk-text); box-shadow: var(--sk-shadow); font-weight: 500; }
|
||||
|
||||
.sk-root .sk-search {
|
||||
display: flex; align-items: center; gap: 8px;
|
||||
height: 44px; padding: 0 8px 0 14px;
|
||||
border-radius: 999px; background: var(--sk-card); box-shadow: var(--sk-shadow);
|
||||
color: var(--sk-text-3);
|
||||
}
|
||||
.sk-root .sk-search input[type="text"] {
|
||||
flex: 1; min-width: 0; height: 100%;
|
||||
border: 0; background: transparent; box-shadow: none; padding: 0;
|
||||
color: var(--sk-text); font: inherit; font-size: calc(13.5px * var(--sk-fs, 1));
|
||||
}
|
||||
.sk-root .sk-search input::placeholder { color: var(--sk-text-3); }
|
||||
.sk-root .sk-kbd {
|
||||
font-size: calc(11px * var(--sk-fs, 1)); padding: 2px 8px; border-radius: 8px;
|
||||
background: var(--sk-chip); color: var(--sk-text-3);
|
||||
}
|
||||
|
||||
.sk-root .sk-nav { display: flex; flex-direction: column; gap: 2px; }
|
||||
.sk-root button.sk-nav-item,
|
||||
.sk-root button.sk-group-head {
|
||||
width: 100%; height: 40px; padding: 0 10px 0 12px;
|
||||
border-radius: var(--sk-r-md); color: var(--sk-text-2); font-size: calc(13.5px * var(--sk-fs, 1));
|
||||
}
|
||||
.sk-root button.sk-nav-item:hover,
|
||||
.sk-root button.sk-group-head:hover { background: rgba(127, 127, 127, .08); color: var(--sk-text); }
|
||||
.sk-root button.sk-nav-item.is-active { background: var(--sk-card); color: var(--sk-text); box-shadow: var(--sk-shadow); font-weight: 500; }
|
||||
.sk-root .sk-nav-label { flex: 1; min-width: 0; text-align: left; white-space: nowrap; overflow: hidden; text-overflow: ellipsis; }
|
||||
.sk-root .sk-count {
|
||||
min-width: 26px; height: 22px; padding: 0 7px;
|
||||
display: inline-flex; align-items: center; justify-content: center;
|
||||
border-radius: 999px; background: var(--sk-card); color: var(--sk-text-2);
|
||||
font-size: calc(11.5px * var(--sk-fs, 1)); font-variant-numeric: tabular-nums;
|
||||
}
|
||||
.sk-root button.sk-nav-item.is-active .sk-count { background: var(--sk-accent); color: var(--sk-accent-ink); font-weight: 600; }
|
||||
.sk-root .sk-count.is-alert { background: var(--sk-danger-bg); color: var(--sk-danger); }
|
||||
|
||||
.sk-root .sk-group { display: flex; flex-direction: column; }
|
||||
.sk-root .sk-chev { color: var(--sk-text-3); transition: transform .2s ease; }
|
||||
.sk-root .sk-chev.is-collapsed { transform: rotate(-90deg); }
|
||||
|
||||
/* 树形连接线 */
|
||||
.sk-root .sk-tree { position: relative; display: flex; flex-direction: column; gap: 2px; padding-left: 28px; margin-top: 2px; }
|
||||
.sk-root .sk-tree::before {
|
||||
content: ""; position: absolute; left: 20px; top: 0; bottom: 20px;
|
||||
width: 1px; background: var(--sk-line);
|
||||
}
|
||||
.sk-root .sk-tree > button.sk-nav-item { position: relative; overflow: visible; }
|
||||
.sk-root .sk-tree > button.sk-nav-item::before {
|
||||
content: ""; position: absolute; left: -8px; top: 50%;
|
||||
width: 10px; height: 14px; margin-top: -14px;
|
||||
border-left: 1px solid var(--sk-line); border-bottom: 1px solid var(--sk-line);
|
||||
border-bottom-left-radius: 8px;
|
||||
}
|
||||
.sk-root .sk-side-foot { padding-top: 8px; border-top: 1px solid var(--sk-line); }
|
||||
|
||||
/* 隐藏侧栏 */
|
||||
.sk-root.sk-side-hidden .sk-side {
|
||||
flex-basis: 0; width: 0; padding-left: 0; padding-right: 0;
|
||||
margin-right: -20px; opacity: 0; overflow: hidden; pointer-events: none;
|
||||
}
|
||||
.sk-root.sk-side-hidden .sk-side > * { min-width: 232px; }
|
||||
/* 侧栏开关:显示时在侧栏顶部(收起),隐藏时在看板标题左边(展开) */
|
||||
.sk-root button.sk-side-close { flex: none; width: 40px; height: 40px; border-radius: 999px; }
|
||||
.sk-root .sk-title-row { display: flex; align-items: center; gap: 12px; min-width: 0; }
|
||||
.sk-root button.sk-side-open { display: none; flex: none; width: 40px; height: 40px; margin-left: -6px; border-radius: 999px; }
|
||||
.sk-root.sk-side-hidden button.sk-side-open { display: inline-flex; }
|
||||
|
||||
/* ---------- 主区域 ---------- */
|
||||
|
||||
.sk-root .sk-main { flex: 1 1 auto; min-width: 0; display: flex; flex-direction: column; gap: 22px; padding: 6px 4px 0; }
|
||||
|
||||
.sk-root .sk-top { display: flex; flex-wrap: wrap; align-items: flex-end; justify-content: space-between; gap: 16px 24px; }
|
||||
.sk-root .sk-top-left { display: flex; flex-direction: column; gap: 6px; min-width: 0; }
|
||||
.sk-root button.sk-icon-btn {
|
||||
width: 30px; height: 30px; justify-content: center; border-radius: 10px; color: var(--sk-text-3);
|
||||
}
|
||||
.sk-root button.sk-icon-btn:hover { background: var(--sk-chip); color: var(--sk-text); }
|
||||
|
||||
.sk-root .sk-title {
|
||||
margin: 4px 0 0; font-size: calc(40px * var(--sk-fs, 1)); line-height: 1.1; font-weight: 600; letter-spacing: -.035em;
|
||||
color: var(--sk-text);
|
||||
}
|
||||
/* 标题可点击编辑:左右各留 8px 给悬停底色,用负 margin 抵消,文字位置不变 */
|
||||
.sk-root .sk-title[contenteditable] {
|
||||
margin-left: -8px; margin-right: -8px; padding: 0 8px; border-radius: 12px;
|
||||
cursor: text; outline: none; transition: background .15s ease, box-shadow .15s ease;
|
||||
}
|
||||
.sk-root .sk-title[contenteditable]:hover { background: var(--sk-panel); }
|
||||
.sk-root .sk-title[contenteditable]:focus { background: var(--sk-panel); box-shadow: 0 0 0 1px var(--sk-line); }
|
||||
.sk-root .sk-meta { color: var(--sk-text-3); font-size: calc(15px * var(--sk-fs, 1)); font-variant-numeric: tabular-nums; }
|
||||
|
||||
.sk-root .sk-people { display: flex; align-items: center; gap: 12px; margin-top: 8px; }
|
||||
.sk-root .sk-avatars { display: flex; }
|
||||
.sk-root .sk-avatars .sk-avatar { margin-left: -6px; border: 2px solid var(--sk-bg); }
|
||||
.sk-root .sk-avatars .sk-avatar:first-child { margin-left: 0; }
|
||||
.sk-root .sk-people-label { font-size: calc(13.5px * var(--sk-fs, 1)); font-weight: 500; color: var(--sk-text-2); }
|
||||
|
||||
.sk-root .sk-avatar {
|
||||
width: 32px; height: 32px; flex: none;
|
||||
display: inline-flex; align-items: center; justify-content: center;
|
||||
border-radius: 999px; background: var(--sk-chip); color: var(--sk-text-2);
|
||||
font-size: calc(11px * var(--sk-fs, 1)); font-weight: 600; letter-spacing: .02em;
|
||||
}
|
||||
.sk-root .sk-avatar-sm { width: 26px; height: 26px; font-size: calc(10px * var(--sk-fs, 1)); }
|
||||
|
||||
.sk-root .sk-actions { display: flex; flex-wrap: wrap; align-items: center; gap: 10px; }
|
||||
|
||||
.sk-root .sk-toggle-pill {
|
||||
display: inline-flex; align-items: center; gap: 12px;
|
||||
height: 48px; padding: 0 12px 0 18px;
|
||||
border-radius: 999px; background: var(--sk-panel); color: var(--sk-text-2); font-size: calc(13.5px * var(--sk-fs, 1));
|
||||
cursor: pointer; user-select: none;
|
||||
}
|
||||
.sk-root .sk-toggle-pill input { position: absolute; opacity: 0; width: 1px; height: 1px; pointer-events: none; }
|
||||
.sk-root .sk-switch {
|
||||
position: relative; width: 44px; height: 26px; border-radius: 999px;
|
||||
background: var(--sk-panel-2); box-shadow: inset 0 0 0 1px var(--sk-line); transition: background .2s ease;
|
||||
}
|
||||
.sk-root .sk-switch::after {
|
||||
content: ""; position: absolute; top: 3px; left: 3px; width: 20px; height: 20px;
|
||||
border-radius: 999px; background: var(--sk-card); box-shadow: 0 1px 3px rgba(0, 0, 0, .18);
|
||||
transition: transform .2s ease;
|
||||
}
|
||||
.sk-root .sk-toggle-pill input:checked + .sk-switch { background: var(--sk-accent); box-shadow: none; }
|
||||
.sk-root .sk-toggle-pill input:checked + .sk-switch::after { transform: translateX(18px); background: var(--sk-accent-ink); }
|
||||
.sk-root .sk-toggle-pill input:focus-visible + .sk-switch { outline: 2px solid var(--sk-text); outline-offset: 2px; }
|
||||
|
||||
.sk-root .sk-modes { display: flex; gap: 4px; padding: 4px; border-radius: 999px; background: var(--sk-panel); }
|
||||
.sk-root button.sk-mode { width: 40px; height: 40px; justify-content: center; border-radius: 999px; color: var(--sk-text-3); }
|
||||
.sk-root button.sk-mode.is-active { background: var(--sk-card); color: var(--sk-text); box-shadow: var(--sk-shadow); }
|
||||
.sk-root button.sk-mode .sk-ico svg { width: 18px; height: 18px; }
|
||||
|
||||
.sk-root button.sk-primary {
|
||||
height: 48px; padding: 0 22px 0 18px; border-radius: 999px;
|
||||
background: var(--sk-ink); color: var(--sk-ink-text); font-weight: 500; font-size: calc(14.5px * var(--sk-fs, 1));
|
||||
}
|
||||
.sk-root button.sk-primary:hover { transform: translateY(-1px); box-shadow: 0 8px 18px rgba(0, 0, 0, .16); }
|
||||
.sk-root button.sk-primary-sm { height: 42px; font-size: calc(13.5px * var(--sk-fs, 1)); padding: 0 18px 0 14px; }
|
||||
|
||||
.sk-root .sk-sizes { display: flex; gap: 2px; padding: 4px; border-radius: 999px; background: var(--sk-panel); }
|
||||
.sk-root button.sk-size {
|
||||
width: 40px; height: 40px; justify-content: center; border-radius: 999px;
|
||||
color: var(--sk-text-3); line-height: 1; font-weight: 500;
|
||||
}
|
||||
.sk-root button.sk-size[data-size="s"] { font-size: 12px; }
|
||||
.sk-root button.sk-size[data-size="m"] { font-size: 14.5px; }
|
||||
.sk-root button.sk-size[data-size="l"] { font-size: 17px; }
|
||||
.sk-root button.sk-size:hover { color: var(--sk-text); }
|
||||
.sk-root button.sk-size.is-active { background: var(--sk-card); color: var(--sk-text); box-shadow: var(--sk-shadow); }
|
||||
|
||||
/* 删除卡片后提示条里的「撤销」按钮 */
|
||||
.notice .sk-undo { margin-left: 8px; }
|
||||
|
||||
/* 卡片弹窗里隐藏的文件选择框(由“上传图片”按钮触发) */
|
||||
.sk-file-input { display: none; }
|
||||
|
||||
/* ---------- 分段按钮滑块(view/segmented.ts) ---------- */
|
||||
/* 选中底色由一块滑块承担,按钮本身透明;文字颜色按滑块覆盖程度(--sk-seg-mix 0~1)渐变 */
|
||||
.sk-root .sk-seg-anim { position: relative; isolation: isolate; touch-action: pan-y; user-select: none; }
|
||||
.sk-root .sk-seg-thumb {
|
||||
position: absolute; left: 0; top: 0; z-index: 0; pointer-events: none;
|
||||
border-radius: 999px; background: var(--sk-card); box-shadow: var(--sk-shadow);
|
||||
will-change: transform, width;
|
||||
}
|
||||
.sk-root .sk-seg-anim > button.sk-btn,
|
||||
.sk-root .sk-seg-anim > button.sk-btn.is-active {
|
||||
position: relative; z-index: 1; background: transparent; box-shadow: none;
|
||||
color: color-mix(in srgb, var(--sk-text) calc(var(--sk-seg-mix, 0) * 100%), var(--sk-text-3));
|
||||
transition: transform .15s ease;
|
||||
}
|
||||
.sk-root .sk-sizes.sk-seg-anim > button.sk-size:hover { color: var(--sk-text); }
|
||||
.sk-root .sk-seg-anim.is-dragging { cursor: grabbing; }
|
||||
.sk-root .sk-seg-anim.is-dragging > button.sk-btn { cursor: grabbing; }
|
||||
|
||||
/* ---------- 看板 ---------- */
|
||||
|
||||
.sk-root .sk-board {
|
||||
flex: 1 1 auto; min-height: 0;
|
||||
display: flex; gap: 14px; align-items: stretch;
|
||||
overflow-x: auto; overflow-y: hidden; padding-bottom: 14px;
|
||||
scroll-behavior: auto; /* 横向滚轮由 view/scroll.ts 直接写 scrollLeft,不要被主题的平滑滚动拖慢 */
|
||||
}
|
||||
.sk-root .sk-col {
|
||||
flex: 0 0 292px; display: flex; flex-direction: column; gap: 10px; min-height: 0;
|
||||
padding: 14px 12px 12px; border-radius: var(--sk-r-xl); background: var(--sk-panel);
|
||||
transition: box-shadow .15s ease, background-color .15s ease;
|
||||
}
|
||||
.sk-root .sk-col.is-over { box-shadow: inset 0 0 0 2px var(--sk-accent), inset 0 0 0 3px rgba(24, 25, 27, .08); }
|
||||
.sk-root .sk-col-head { display: flex; align-items: center; gap: 8px; padding: 2px 4px 4px 10px; }
|
||||
.sk-root .sk-col-title { font-size: calc(16px * var(--sk-fs, 1)); font-weight: 500; letter-spacing: -.01em; }
|
||||
.sk-root .sk-col-count {
|
||||
min-width: 24px; height: 24px; padding: 0 7px; display: inline-flex; align-items: center; justify-content: center;
|
||||
border-radius: 999px; background: var(--sk-card); font-size: calc(12px * var(--sk-fs, 1)); color: var(--sk-text-2);
|
||||
}
|
||||
.sk-root .sk-done-mark { width: 22px; height: 22px; border-radius: 999px; background: var(--sk-accent); color: var(--sk-accent-ink); }
|
||||
.sk-root .sk-done-mark svg { width: 13px; height: 13px; stroke-width: 2.5; }
|
||||
.sk-root button.sk-col-more { background: var(--sk-card); border-radius: 999px; width: 32px; height: 32px; box-shadow: var(--sk-shadow); }
|
||||
|
||||
.sk-root .sk-col-list {
|
||||
display: flex; flex-direction: column; gap: 10px;
|
||||
flex: 1 1 auto; min-height: 60px; overflow-y: auto;
|
||||
margin: 0 -4px; padding: 2px 4px 4px;
|
||||
}
|
||||
.sk-root .sk-col-nomatch { padding: 18px 8px; text-align: center; color: var(--sk-text-3); font-size: calc(13px * var(--sk-fs, 1)); }
|
||||
|
||||
/* ---------- 卡片 ---------- */
|
||||
|
||||
.sk-root .sk-card {
|
||||
display: flex; flex-direction: column; gap: 6px;
|
||||
padding: 14px 16px 14px; border-radius: var(--sk-r-lg);
|
||||
background: var(--sk-card); box-shadow: var(--sk-shadow);
|
||||
cursor: grab; outline: none;
|
||||
transition: transform .15s ease, box-shadow .15s ease, opacity .15s ease;
|
||||
}
|
||||
.sk-root .sk-card:hover { transform: translateY(-1px); box-shadow: var(--sk-shadow-lift); }
|
||||
.sk-root .sk-card.is-dragging { opacity: .35; transform: scale(.98); }
|
||||
|
||||
/* 只动变化的那张卡:新建 / 换列时轻轻浮现;删除时收起,下面的卡片自然补位 */
|
||||
@keyframes sk-card-in {
|
||||
from { opacity: 0; transform: translateY(6px) scale(.98); }
|
||||
to { opacity: 1; transform: none; }
|
||||
}
|
||||
.sk-root .sk-card.is-entering { animation: sk-card-in .24s cubic-bezier(.2, .7, .2, 1); }
|
||||
.sk-root .sk-card.is-leaving {
|
||||
max-height: var(--sk-leave-h); overflow: hidden; pointer-events: none;
|
||||
transition: max-height .2s ease, opacity .16s ease, transform .2s ease, margin .2s ease, padding .2s ease;
|
||||
}
|
||||
.sk-root .sk-card.is-leaving.is-gone {
|
||||
max-height: 0; opacity: 0; transform: scale(.97);
|
||||
margin-bottom: -10px; padding-top: 0; padding-bottom: 0; /* -10px 抵消列表的 gap */
|
||||
}
|
||||
@media (prefers-reduced-motion: reduce) {
|
||||
.sk-root .sk-card.is-entering { animation: none; }
|
||||
.sk-root .sk-card.is-leaving { transition: none; }
|
||||
}
|
||||
.sk-root .sk-card.is-done .sk-card-title { color: var(--sk-text-3); text-decoration-line: line-through; text-decoration-color: var(--sk-line); }
|
||||
|
||||
.sk-root .sk-chips { display: flex; flex-wrap: wrap; gap: 6px; margin-bottom: 6px; }
|
||||
.sk-root .sk-chip {
|
||||
display: inline-flex; align-items: center; gap: 6px;
|
||||
height: 28px; padding: 0 11px 0 10px; border-radius: 999px;
|
||||
background: var(--sk-chip); color: var(--sk-text-2); font-size: calc(12.5px * var(--sk-fs, 1)); white-space: nowrap;
|
||||
}
|
||||
.sk-root .sk-chip .sk-ico svg { width: 14px; height: 14px; }
|
||||
.sk-root .sk-chip.is-overdue { background: var(--sk-danger-bg); color: var(--sk-danger); }
|
||||
.sk-root .sk-donechip { background: var(--sk-accent); color: var(--sk-accent-ink); }
|
||||
|
||||
/* 优先级信号条 */
|
||||
.sk-root .sk-bars { display: inline-flex; align-items: flex-end; gap: 2px; height: 12px; }
|
||||
.sk-root .sk-bars span { width: 2.5px; border-radius: 2px; background: currentColor; opacity: .22; }
|
||||
.sk-root .sk-bars span:nth-child(1) { height: 4px; }
|
||||
.sk-root .sk-bars span:nth-child(2) { height: 7px; }
|
||||
.sk-root .sk-bars span:nth-child(3) { height: 10px; }
|
||||
.sk-root .sk-bars span:nth-child(4) { height: 12px; }
|
||||
.sk-root .sk-bars span.on { opacity: 1; }
|
||||
.sk-root .sk-prio-critical { background: var(--sk-danger-bg); color: var(--sk-danger); }
|
||||
|
||||
.sk-root .sk-card-title { font-size: calc(16px * var(--sk-fs, 1)); font-weight: 500; line-height: 1.35; letter-spacing: -.01em; color: var(--sk-text); word-break: break-word; }
|
||||
.sk-root .sk-card-sub { font-size: calc(13px * var(--sk-fs, 1)); line-height: 1.45; color: var(--sk-text-3); word-break: break-word; }
|
||||
.sk-root .sk-card-foot { display: flex; align-items: center; gap: 10px; margin-top: 8px; }
|
||||
.sk-root .sk-card-person { font-size: calc(13px * var(--sk-fs, 1)); color: var(--sk-text-2); white-space: nowrap; overflow: hidden; text-overflow: ellipsis; }
|
||||
.sk-root .sk-card-value { font-size: calc(14.5px * var(--sk-fs, 1)); font-weight: 500; color: var(--sk-text); font-variant-numeric: tabular-nums; }
|
||||
|
||||
.sk-root .sk-placeholder {
|
||||
flex: none; height: 56px; border-radius: var(--sk-r-lg);
|
||||
border: 1.5px dashed var(--sk-text-3); background: rgba(127, 127, 127, .06);
|
||||
}
|
||||
|
||||
/* 紧凑模式 */
|
||||
.sk-root.is-compact .sk-card { padding: 10px 14px; gap: 4px; }
|
||||
.sk-root.is-compact .sk-card-sub,
|
||||
.sk-root.is-compact .sk-card-person { display: none; }
|
||||
.sk-root.is-compact .sk-card-foot { margin-top: 2px; }
|
||||
.sk-root.is-compact .sk-chips { margin-bottom: 2px; }
|
||||
.sk-root.is-compact .sk-chip { height: 24px; }
|
||||
.sk-root.is-compact .sk-card-title { font-size: calc(14.5px * var(--sk-fs, 1)); }
|
||||
|
||||
/* 更多 / 添加 */
|
||||
.sk-root button.sk-more,
|
||||
.sk-root button.sk-add-card {
|
||||
justify-content: center; width: 100%; height: 46px; flex: none;
|
||||
border-radius: var(--sk-r-lg); color: var(--sk-text-2); font-size: calc(13.5px * var(--sk-fs, 1));
|
||||
}
|
||||
.sk-root button.sk-more { background: var(--sk-panel-2); }
|
||||
.sk-root button.sk-more:hover { background: var(--sk-card); box-shadow: var(--sk-shadow); color: var(--sk-text); }
|
||||
.sk-root button.sk-add-card { color: var(--sk-text-3); }
|
||||
.sk-root button.sk-add-card:hover { background: var(--sk-panel-2); color: var(--sk-text); }
|
||||
|
||||
.sk-root .sk-col-add { flex: 0 0 220px; }
|
||||
.sk-root button.sk-add-col {
|
||||
width: 100%; height: 56px; justify-content: center; border-radius: var(--sk-r-xl);
|
||||
border: 1.5px dashed var(--sk-line); color: var(--sk-text-3);
|
||||
}
|
||||
.sk-root button.sk-add-col:hover { border-color: var(--sk-text-3); color: var(--sk-text); }
|
||||
|
||||
/* ---------- 空状态 ---------- */
|
||||
|
||||
.sk-root .sk-empty {
|
||||
display: flex; flex-direction: column; align-items: flex-start; gap: 6px;
|
||||
padding: 18px 18px 20px; border-radius: var(--sk-r-lg); background: var(--sk-card); box-shadow: var(--sk-shadow);
|
||||
}
|
||||
.sk-root .sk-empty-art { position: relative; width: 100%; height: 132px; margin-bottom: 14px; }
|
||||
.sk-root .sk-empty-win {
|
||||
position: absolute; inset: 0 6px 0 12px; padding: 10px 12px;
|
||||
border-radius: 14px; background: var(--sk-panel);
|
||||
}
|
||||
.sk-root .sk-empty-dots { display: flex; gap: 4px; margin-bottom: 10px; }
|
||||
.sk-root .sk-empty-dots span { width: 5px; height: 5px; border-radius: 999px; background: var(--sk-text-3); opacity: .4; }
|
||||
.sk-root .sk-empty-grid { display: grid; grid-template-columns: 1fr 1.2fr 1fr; gap: 8px; height: 82px; }
|
||||
.sk-root .sk-empty-tile { border-radius: 9px; background: var(--sk-card); }
|
||||
.sk-root .sk-empty-tile:nth-child(1) { height: 30px; }
|
||||
.sk-root .sk-empty-tile:nth-child(3) { height: 30px; }
|
||||
.sk-root .sk-empty-pill {
|
||||
position: absolute; right: 22px; top: 74px; width: 50px; height: 26px;
|
||||
display: flex; align-items: center; justify-content: center;
|
||||
border-radius: 999px; background: var(--sk-accent); color: var(--sk-accent-ink);
|
||||
box-shadow: 0 4px 12px rgba(0, 0, 0, .10);
|
||||
}
|
||||
.sk-root .sk-empty-pill svg { width: 15px; height: 15px; stroke-width: 2.5; }
|
||||
.sk-root .sk-empty-float {
|
||||
position: absolute; left: 0; bottom: 4px; width: 64px; height: 42px; padding: 12px 10px;
|
||||
display: flex; flex-direction: column; gap: 5px;
|
||||
border-radius: 10px; background: var(--sk-card); box-shadow: var(--sk-shadow-lift); transform: rotate(-6deg);
|
||||
}
|
||||
.sk-root .sk-empty-float span { height: 3px; border-radius: 3px; background: var(--sk-text); }
|
||||
.sk-root .sk-empty-float span:last-child { width: 70%; opacity: .25; }
|
||||
.sk-root .sk-empty-title { font-size: calc(16px * var(--sk-fs, 1)); font-weight: 500; }
|
||||
.sk-root .sk-empty-desc { font-size: calc(13px * var(--sk-fs, 1)); line-height: 1.5; color: var(--sk-text-3); margin-bottom: 10px; }
|
||||
|
||||
/* ---------- 列表视图 ---------- */
|
||||
|
||||
.sk-root .sk-listwrap { flex: 1 1 auto; overflow: auto; border-radius: var(--sk-r-xl); background: var(--sk-panel); padding: 8px; }
|
||||
.sk-root .sk-table { width: 100%; border-collapse: separate; border-spacing: 0 6px; }
|
||||
.sk-root .sk-table th {
|
||||
text-align: left; font-weight: 500; font-size: calc(12px * var(--sk-fs, 1)); color: var(--sk-text-3);
|
||||
padding: 6px 14px; white-space: nowrap;
|
||||
}
|
||||
.sk-root .sk-table td { padding: 12px 14px; background: var(--sk-card); vertical-align: middle; white-space: nowrap; }
|
||||
.sk-root .sk-table td:first-child { border-radius: 14px 0 0 14px; white-space: normal; min-width: 220px; }
|
||||
.sk-root .sk-table td:last-child { border-radius: 0 14px 14px 0; text-align: right; }
|
||||
.sk-root .sk-table tbody tr { cursor: pointer; }
|
||||
.sk-root .sk-table tbody tr:hover td { background: var(--sk-panel-2); }
|
||||
.sk-root .sk-table tr.is-done .sk-card-title { color: var(--sk-text-3); text-decoration-line: line-through; }
|
||||
.sk-root .sk-table .sk-avatar { vertical-align: middle; }
|
||||
|
||||
/* ---------- 弹窗 ---------- */
|
||||
|
||||
.modal.sk-modal { border-radius: 22px; max-width: 520px; }
|
||||
.modal.sk-modal h3 { margin: 0 0 8px; font-size: calc(20px * var(--sk-fs, 1)); font-weight: 600; letter-spacing: -.02em; }
|
||||
.modal.sk-modal .setting-item { padding: 10px 0; border-top: 1px solid var(--background-modifier-border); }
|
||||
.modal.sk-modal .setting-item:first-of-type { border-top: 0; }
|
||||
.modal.sk-modal input[type="text"],
|
||||
.modal.sk-modal input[type="date"],
|
||||
.modal.sk-modal textarea,
|
||||
.modal.sk-modal select { border-radius: 10px; min-width: 220px; }
|
||||
.modal.sk-modal textarea { width: 100%; resize: vertical; }
|
||||
.modal.sk-modal button { border-radius: 999px; padding: 0 18px; }
|
||||
.modal.sk-modal .sk-modal-actions { border-top: 0; padding-top: 16px; }
|
||||
.modal.sk-modal .sk-modal-actions .setting-item-control { justify-content: flex-end; gap: 8px; }
|
||||
|
||||
/* ---------- 窄屏 ---------- */
|
||||
|
||||
@media (max-width: 760px) {
|
||||
.sk-root { padding: 10px; gap: 10px; flex-direction: column; overflow-y: auto; }
|
||||
.sk-root .sk-side { flex: none; width: auto; max-height: none; }
|
||||
.sk-root.sk-side-hidden .sk-side { display: none; }
|
||||
.sk-root .sk-title { font-size: calc(30px * var(--sk-fs, 1)); }
|
||||
.sk-root .sk-col { flex-basis: 84vw; }
|
||||
}
|
||||
|
||||
/* ---------- 顶部“显示”按钮 ---------- */
|
||||
|
||||
.sk-root button.sk-ghost-pill {
|
||||
height: 48px; padding: 0 18px 0 16px; border-radius: 999px;
|
||||
background: var(--sk-panel); color: var(--sk-text-2); font-size: calc(13.5px * var(--sk-fs, 1));
|
||||
}
|
||||
.sk-root button.sk-ghost-pill:hover { background: var(--sk-panel-2); color: var(--sk-text); }
|
||||
|
||||
/* ---------- 卡片图片 ---------- */
|
||||
|
||||
.sk-root { --sk-cover-h: 168px; }
|
||||
.sk-root.sk-img-h-s { --sk-cover-h: 120px; }
|
||||
.sk-root.sk-img-h-m { --sk-cover-h: 168px; }
|
||||
.sk-root.sk-img-h-l { --sk-cover-h: 240px; }
|
||||
|
||||
/* 封面:在卡片内留 8px 边框,圆角与卡片同心 */
|
||||
.sk-root .sk-cover {
|
||||
position: relative;
|
||||
height: var(--sk-cover-h);
|
||||
margin: -6px -8px 8px;
|
||||
border-radius: 10px;
|
||||
overflow: hidden;
|
||||
background: var(--sk-chip);
|
||||
cursor: zoom-in;
|
||||
isolation: isolate;
|
||||
}
|
||||
.sk-root .sk-cover::after {
|
||||
/* 细内描边,避免白底图片和卡片糊在一起 */
|
||||
content: ""; position: absolute; inset: 0; border-radius: inherit;
|
||||
box-shadow: inset 0 0 0 1px rgba(24, 25, 27, .06); pointer-events: none;
|
||||
}
|
||||
.theme-dark .sk-root .sk-cover::after { box-shadow: inset 0 0 0 1px rgba(255, 255, 255, .06); }
|
||||
|
||||
.sk-root .sk-cover img,
|
||||
.sk-root .sk-thumb img {
|
||||
display: block; width: 100%; height: 100%;
|
||||
object-fit: cover; object-position: center;
|
||||
opacity: 0;
|
||||
transition: opacity .35s ease, transform .45s cubic-bezier(.2, .7, .2, 1);
|
||||
}
|
||||
.sk-root .sk-cover.is-loaded img,
|
||||
.sk-root .sk-thumb.is-loaded img { opacity: 1; }
|
||||
/* 重绘时已加载过的图片:直接显示,只保留悬停放大的过渡 */
|
||||
.sk-root .sk-cover.no-fade img,
|
||||
.sk-root .sk-thumb.no-fade img { transition: transform .45s cubic-bezier(.2, .7, .2, 1); }
|
||||
.sk-root .sk-card:hover .sk-cover img { transform: scale(1.035); }
|
||||
|
||||
/* 完整显示(适合图纸、截图) */
|
||||
.sk-root.sk-img-contain .sk-cover { background: var(--sk-panel); }
|
||||
.sk-root.sk-img-contain .sk-cover img { object-fit: contain; padding: 6px; }
|
||||
.sk-root.sk-img-contain .sk-card:hover .sk-cover img { transform: none; }
|
||||
|
||||
/* 多图角标 */
|
||||
.sk-root .sk-img-count {
|
||||
position: absolute; right: 8px; bottom: 8px; z-index: 1;
|
||||
display: inline-flex; align-items: center; gap: 4px;
|
||||
height: 24px; padding: 0 9px 0 7px; border-radius: 999px;
|
||||
background: rgba(20, 20, 22, .58); color: #FFFFFF;
|
||||
font-size: calc(11.5px * var(--sk-fs, 1)); font-weight: 500;
|
||||
-webkit-backdrop-filter: blur(8px); backdrop-filter: blur(8px);
|
||||
}
|
||||
.sk-root .sk-img-count .sk-ico svg { width: 13px; height: 13px; }
|
||||
|
||||
/* 加载失败 / 找不到文件 */
|
||||
.sk-root .sk-cover.is-broken,
|
||||
.sk-root .sk-thumb.is-broken {
|
||||
display: flex; align-items: center; justify-content: center;
|
||||
color: var(--sk-text-3); cursor: default;
|
||||
}
|
||||
.sk-root .sk-cover.is-broken { height: 64px; }
|
||||
|
||||
/* 缩略图布局 */
|
||||
.sk-root .sk-card-row { display: flex; align-items: flex-start; gap: 12px; }
|
||||
.sk-root .sk-card-main { flex: 1 1 auto; min-width: 0; display: flex; flex-direction: column; gap: 6px; }
|
||||
.sk-root .sk-thumb {
|
||||
position: relative; flex: none;
|
||||
width: 64px; height: 64px; border-radius: 12px; overflow: hidden;
|
||||
background: var(--sk-chip); cursor: zoom-in;
|
||||
box-shadow: inset 0 0 0 1px rgba(24, 25, 27, .06);
|
||||
}
|
||||
.sk-root .sk-thumb .sk-img-count { right: 4px; bottom: 4px; height: 18px; padding: 0 6px 0 5px; font-size: 10px; }
|
||||
.sk-root .sk-thumb .sk-img-count .sk-ico { display: none; }
|
||||
.sk-root.is-compact .sk-thumb { width: 44px; height: 44px; border-radius: 10px; }
|
||||
.sk-root .sk-thumb-sm { width: 40px; height: 40px; border-radius: 10px; }
|
||||
.sk-root .sk-list-cell { display: flex; align-items: center; gap: 12px; }
|
||||
|
||||
/* 把图片文件拖到卡片上时 */
|
||||
.sk-root .sk-card.is-file-over {
|
||||
box-shadow: 0 0 0 2px var(--sk-accent), 0 0 0 4px rgba(24, 25, 27, .08), var(--sk-shadow-lift);
|
||||
transform: translateY(-1px);
|
||||
}
|
||||
|
||||
/* ---------- 弹窗里的图片区 ---------- */
|
||||
|
||||
.modal.sk-modal .sk-img-setting { padding-bottom: 4px; }
|
||||
.modal.sk-modal .sk-img-zone {
|
||||
display: grid; grid-template-columns: repeat(auto-fill, minmax(104px, 1fr)); gap: 10px;
|
||||
padding: 4px 0 14px; border-radius: 14px;
|
||||
transition: background-color .15s ease, box-shadow .15s ease;
|
||||
}
|
||||
.modal.sk-modal .sk-img-zone.is-over { background: var(--background-secondary); box-shadow: 0 0 0 2px var(--interactive-accent); }
|
||||
.modal.sk-modal .sk-img-tile {
|
||||
position: relative; aspect-ratio: 4 / 3; border-radius: 12px; overflow: hidden;
|
||||
background: var(--background-secondary); cursor: zoom-in;
|
||||
display: flex; align-items: center; justify-content: center; color: var(--text-muted);
|
||||
box-shadow: inset 0 0 0 1px var(--background-modifier-border);
|
||||
}
|
||||
.modal.sk-modal .sk-img-tile img { width: 100%; height: 100%; object-fit: cover; display: block; }
|
||||
.modal.sk-modal .sk-img-tile.is-cover { box-shadow: 0 0 0 2px var(--text-normal); }
|
||||
.modal.sk-modal .sk-img-badge {
|
||||
position: absolute; left: 6px; top: 6px; height: 20px; padding: 0 8px;
|
||||
display: inline-flex; align-items: center; border-radius: 999px;
|
||||
background: var(--sk-accent-global, #D7F25C); color: var(--sk-accent-ink-global, #18191B); font-size: 11px; font-weight: 600;
|
||||
}
|
||||
.modal.sk-modal button.sk-img-act {
|
||||
position: absolute; top: 6px; width: 26px; height: 26px; padding: 0;
|
||||
display: flex; align-items: center; justify-content: center;
|
||||
border: 0; border-radius: 999px; box-shadow: none;
|
||||
background: rgba(20, 20, 22, .6); color: #FFFFFF; cursor: pointer;
|
||||
opacity: 0; transition: opacity .15s ease;
|
||||
-webkit-backdrop-filter: blur(6px); backdrop-filter: blur(6px);
|
||||
}
|
||||
.modal.sk-modal button.sk-img-act svg { width: 14px; height: 14px; }
|
||||
.modal.sk-modal button.sk-img-del { right: 6px; }
|
||||
.modal.sk-modal button.sk-img-star { right: 38px; }
|
||||
.modal.sk-modal .sk-img-tile:hover button.sk-img-act,
|
||||
.modal.sk-modal button.sk-img-act:focus-visible { opacity: 1; }
|
||||
@media (hover: none) { .modal.sk-modal button.sk-img-act { opacity: 1; } }
|
||||
.modal.sk-modal button.sk-img-add {
|
||||
aspect-ratio: 4 / 3; height: auto; padding: 0;
|
||||
display: flex; flex-direction: column; align-items: center; justify-content: center; gap: 6px;
|
||||
border-radius: 12px; border: 1.5px dashed var(--background-modifier-border-hover, var(--background-modifier-border));
|
||||
background: transparent; box-shadow: none; color: var(--text-muted); font-size: 12px; cursor: pointer;
|
||||
}
|
||||
.modal.sk-modal button.sk-img-add:hover { border-color: var(--text-muted); color: var(--text-normal); background: var(--background-secondary); }
|
||||
|
||||
/* ---------- 图片大图预览 ---------- */
|
||||
|
||||
/* 背景用纯深色,透明度沿用 Obsidian 自己的遮罩设置(约 85%),不再用 !important 覆盖 */
|
||||
.modal-container.sk-lightbox-container .modal-bg { background: #0B0B0C; }
|
||||
.modal.sk-lightbox {
|
||||
width: auto; max-width: 94vw; max-height: 94vh; padding: 10px;
|
||||
border-radius: 20px; border: 0; background: var(--background-primary);
|
||||
box-shadow: 0 30px 80px rgba(0, 0, 0, .45);
|
||||
}
|
||||
.modal.sk-lightbox .modal-close-button { top: 14px; right: 14px; color: #FFFFFF; background: rgba(20, 20, 22, .55); border-radius: 999px; }
|
||||
.sk-lightbox .sk-lb-stage { display: flex; justify-content: center; border-radius: 12px; overflow: hidden; background: var(--background-secondary); }
|
||||
.sk-lightbox .sk-lb-stage img {
|
||||
display: block; max-width: calc(94vw - 20px); max-height: calc(94vh - 72px);
|
||||
object-fit: contain; opacity: 0; transition: opacity .25s ease;
|
||||
}
|
||||
.sk-lightbox .sk-lb-stage.is-loaded img { opacity: 1; }
|
||||
.sk-lightbox .sk-lb-bar { display: flex; align-items: center; gap: 10px; padding: 10px 6px 2px; font-size: 13px; color: var(--text-muted); }
|
||||
.sk-lightbox .sk-lb-name { flex: 1; min-width: 0; white-space: nowrap; overflow: hidden; text-overflow: ellipsis; }
|
||||
.sk-lightbox .sk-lb-count { font-variant-numeric: tabular-nums; }
|
||||
.sk-lightbox button.sk-lb-nav { width: 34px; height: 34px; padding: 0; border-radius: 999px; display: flex; align-items: center; justify-content: center; }
|
||||
|
||||
/* ---------- 设置页:强调色色板 ---------- */
|
||||
|
||||
.sk-swatches { display: flex; flex-wrap: wrap; align-items: center; justify-content: flex-end; gap: 8px; }
|
||||
.sk-swatches button.sk-swatch {
|
||||
width: 28px; height: 28px; padding: 0; border-radius: 999px; border: 0; cursor: pointer;
|
||||
box-shadow: inset 0 0 0 1px rgba(0, 0, 0, .12);
|
||||
transition: transform .12s ease, box-shadow .12s ease;
|
||||
}
|
||||
.sk-swatches button.sk-swatch:hover { transform: scale(1.1); }
|
||||
.sk-swatches button.sk-swatch.is-active { box-shadow: 0 0 0 2px var(--background-primary), 0 0 0 4px var(--text-normal); }
|
||||
.sk-swatches .sk-swatch-sep { width: 1px; height: 22px; margin: 0 4px; background: var(--background-modifier-border); }
|
||||
.sk-accent-preview {
|
||||
display: flex; align-items: center; gap: 10px; margin-top: 8px;
|
||||
}
|
||||
.sk-accent-preview .sk-pv-chip {
|
||||
display: inline-flex; align-items: center; height: 24px; padding: 0 10px; border-radius: 999px;
|
||||
background: var(--sk-accent-global, #D7F25C); color: var(--sk-accent-ink-global, #18191B); font-size: 12px; font-weight: 600;
|
||||
}
|
||||
Vendored
+235
@@ -0,0 +1,235 @@
|
||||
{
|
||||
"main": {
|
||||
"id": "72628acbd22d92f4",
|
||||
"type": "split",
|
||||
"children": [
|
||||
{
|
||||
"id": "895d491d16dc1a79",
|
||||
"type": "tabs",
|
||||
"children": [
|
||||
{
|
||||
"id": "788e9f9f8d48018e",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "markdown",
|
||||
"state": {
|
||||
"file": "环境清单/对外服务.md",
|
||||
"mode": "source",
|
||||
"source": false
|
||||
},
|
||||
"icon": "lucide-file",
|
||||
"title": "对外服务"
|
||||
}
|
||||
}
|
||||
]
|
||||
}
|
||||
],
|
||||
"direction": "vertical"
|
||||
},
|
||||
"left": {
|
||||
"id": "c7cb115332657a14",
|
||||
"type": "split",
|
||||
"children": [
|
||||
{
|
||||
"id": "f3db18085b3622a4",
|
||||
"type": "tabs",
|
||||
"children": [
|
||||
{
|
||||
"id": "405f544c502fd482",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "file-explorer",
|
||||
"state": {
|
||||
"sortOrder": "alphabetical",
|
||||
"autoReveal": true,
|
||||
"showSearch": false,
|
||||
"searchQuery": ""
|
||||
},
|
||||
"icon": "lucide-folder-closed",
|
||||
"title": "文件列表"
|
||||
}
|
||||
},
|
||||
{
|
||||
"id": "51972874f3b64ab1",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "search",
|
||||
"state": {
|
||||
"query": "",
|
||||
"matchingCase": false,
|
||||
"explainSearch": false,
|
||||
"collapseAll": false,
|
||||
"extraContext": false,
|
||||
"sortOrder": "alphabetical"
|
||||
},
|
||||
"icon": "lucide-search",
|
||||
"title": "搜索"
|
||||
}
|
||||
},
|
||||
{
|
||||
"id": "7f740a5e1c83b1cc",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "bookmarks",
|
||||
"state": {},
|
||||
"icon": "lucide-bookmark",
|
||||
"title": "Bookmarks"
|
||||
}
|
||||
}
|
||||
]
|
||||
}
|
||||
],
|
||||
"direction": "horizontal",
|
||||
"width": 226.30001831054688
|
||||
},
|
||||
"right": {
|
||||
"id": "4888b7af2cbe8a43",
|
||||
"type": "split",
|
||||
"children": [
|
||||
{
|
||||
"id": "3d9e1dae10677018",
|
||||
"type": "tabs",
|
||||
"children": [
|
||||
{
|
||||
"id": "6fa6de46ab10115c",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "backlink",
|
||||
"state": {
|
||||
"collapseAll": false,
|
||||
"extraContext": false,
|
||||
"sortOrder": "alphabetical",
|
||||
"showSearch": false,
|
||||
"searchQuery": "",
|
||||
"backlinkCollapsed": false,
|
||||
"unlinkedCollapsed": true
|
||||
},
|
||||
"icon": "links-coming-in",
|
||||
"title": "Backlinks"
|
||||
}
|
||||
},
|
||||
{
|
||||
"id": "4f6bc585964deb22",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "outgoing-link",
|
||||
"state": {
|
||||
"linksCollapsed": false,
|
||||
"unlinkedCollapsed": true
|
||||
},
|
||||
"icon": "links-going-out",
|
||||
"title": "Outgoing links"
|
||||
}
|
||||
},
|
||||
{
|
||||
"id": "76621f49d426e818",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "tag",
|
||||
"state": {
|
||||
"sortOrder": "frequency",
|
||||
"useHierarchy": true,
|
||||
"showSearch": false,
|
||||
"searchQuery": ""
|
||||
},
|
||||
"icon": "lucide-tags",
|
||||
"title": "Tags"
|
||||
}
|
||||
},
|
||||
{
|
||||
"id": "6679b08573856ac0",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "outline",
|
||||
"state": {
|
||||
"followCursor": false,
|
||||
"showSearch": false,
|
||||
"searchQuery": ""
|
||||
},
|
||||
"icon": "lucide-list",
|
||||
"title": "Outline"
|
||||
}
|
||||
},
|
||||
{
|
||||
"id": "7ea3370367ba3f81",
|
||||
"type": "leaf",
|
||||
"state": {
|
||||
"type": "git-view",
|
||||
"state": {},
|
||||
"icon": "git-pull-request",
|
||||
"title": "Source Control"
|
||||
}
|
||||
}
|
||||
],
|
||||
"currentTab": 4
|
||||
}
|
||||
],
|
||||
"direction": "horizontal",
|
||||
"width": 300
|
||||
},
|
||||
"left-ribbon": {
|
||||
"hiddenItems": {
|
||||
"bases:新建数据库": true,
|
||||
"switcher:打开快速切换": false,
|
||||
"graph:查看关系图谱": false,
|
||||
"canvas:新建白板": false,
|
||||
"templates:插入模板": false,
|
||||
"command-palette:打开命令面板": false,
|
||||
"daily-notes:打开/创建今天的日记": false,
|
||||
"studio-kanban:新建看板": false,
|
||||
"obsidian-git:Open Git source control": false
|
||||
}
|
||||
},
|
||||
"active": "405f544c502fd482",
|
||||
"lastOpenFiles": [
|
||||
"Clippings/attach/Image.webp",
|
||||
"Clippings/attach/Image.png",
|
||||
"Clippings/attach/Image 8.jpg",
|
||||
"Clippings/attach/Image.jpg",
|
||||
"Clippings/attach/Image 9.jpg",
|
||||
"Clippings/attach/Image 4.jpg",
|
||||
"Clippings/attach/Image 5.jpg",
|
||||
"Clippings/attach/Image 6.jpg",
|
||||
"Clippings/attach/Image 7.jpg",
|
||||
"Clippings/attach/Image 2.jpg",
|
||||
"Clippings/attach/Image 1.jpg",
|
||||
"Clippings/attach",
|
||||
"日记/2026-11 45.md",
|
||||
"日记/2026-10 44.md",
|
||||
"1 使用/服务器初始化.md",
|
||||
"日记/归档/2026年11月.md",
|
||||
"日记/归档/2026/2026-10 43.md",
|
||||
"日记/归档/2026/2026-10 44.md",
|
||||
"日记/归档/2026/2026-10 42.md",
|
||||
"日记/归档/2026/2026-10 41.md",
|
||||
"日记/归档/2026/2026年10月.md",
|
||||
"日记/归档/2026/2026年9月.md",
|
||||
"日记/2026年9月.md",
|
||||
"日记/归档/2026年10月.md",
|
||||
"3 札记/杭州房屋维护.md",
|
||||
"日记/归档/2026-10 43.md",
|
||||
"日记/归档/2026-10 42.md",
|
||||
"日记/归档/2026-10 41.md",
|
||||
"日记/归档/2026-10 44.md",
|
||||
"sunyard/丢失密码机仅剩密码卡.md",
|
||||
"Quant/天天/2026年11月.md",
|
||||
"Quant/知识库/美林时钟.md",
|
||||
"1 使用/git/git 初始化 gitinit.md",
|
||||
"项目/awesome 牛!软件.md",
|
||||
"项目/Plan.md",
|
||||
"3 札记/维修记录.md",
|
||||
"3 札记/万荣房屋维护.md",
|
||||
"日记/未命名.base",
|
||||
"Quant/知识库/attach",
|
||||
"Quant/知识库",
|
||||
"项目/归档/attach",
|
||||
"其他/obsidian/attach",
|
||||
"未命名.base",
|
||||
"项目/归档",
|
||||
"未命名 2.canvas",
|
||||
"未命名 1.canvas",
|
||||
"未命名.canvas",
|
||||
"3 札记/高项",
|
||||
"3 札记/音乐"
|
||||
]
|
||||
}
|
||||
File diff suppressed because one or more lines are too long
@@ -0,0 +1,215 @@
|
||||
这篇文章是为已经有一些编程基础,打算将Golang作为第二编程语言进行学习的同学准备的,希望能够为你的学习提供一些方向。
|
||||
|
||||

|
||||
|
||||
**Go语言的吉祥物是Gopher(地鼠),Go语言爱好者也会自称Gopher 图/Renee French**
|
||||
|
||||
# 概述
|
||||
|
||||
Go语言问世于2009年,由Google支持,Robert Griesemer, Rob Pike和Ken Thompson三位计算机大牛设计,是一个静态强类型、编译型,跨平台,语言原语支持并发,具有垃圾收集功能的类C风格编程语言。
|
||||
|
||||

|
||||
|
||||
**左起,Robert Griesemer(V8 Javascript engine, Java HotSpot VM), Rob Pike(UNIX, Plan9, UTF-8)和Ken Thompson(B, Unix, UTF-8, grep) 视频截图/Youtube: Google I/O 2012 - Meet the Go Team**
|
||||
|
||||
由于go(v. 出发; n. 围棋)这个单词太过常见,容易引发歧义,社区常用`Golang`称呼Go语言,一般搜索Golang返回的结果会有更好的相关性。
|
||||
|
||||
Golang目前处于v1大版本,一般每6个月发布一个小版本(1.x),每隔数日到数周发布修复和安全更新版本(1.x.y),大版本范围内保证向前兼容,你可以安心升级。
|
||||
|
||||
Golang是一门相对稳定、约束、保守的语言,语言的特性很少,新特性的引入往往至少花费一年,因此不用担心学不动(滑稽)。
|
||||
|
||||
Golang是云原生的主场语言,这里列举一些应用广泛的项目:
|
||||
|
||||
- [Golang](https://github.com/golang/go):Go语言是自举的(先有鸡还是先有蛋?[Go 1.5及以上,2015年起](https://golang.org/doc/go1.5))。
|
||||
- [Kubernetes](https://github.com/kubernetes/kubernetes):企业级容器调度不二之选。
|
||||
- [Docker](https://github.com/moby/moby):容器化开山鼻祖,市场占有率第一。
|
||||
- [Istio](https://github.com/istio/istio):容器化网络服务网格。
|
||||
- [Prometheus](https://github.com/prometheus/prometheus):应用指标监控事实行业标准。
|
||||
- [InfluxDB](https://github.com/influxdata/influxdb):时序数据库。
|
||||
- [TiDB](https://github.com/pingcap/tidb):国人牵头的分布式SQL数据库,一个流行而健康的开源项目。
|
||||
|
||||
国内外优秀团队广泛地使用Golang,例如[七牛](https://github.com/qiniu)、[Google](https://go.dev/solutions/google/)、[Cloudflare](https://blog.cloudflare.com/graceful-upgrades-in-go/)、[微软](https://cloudblogs.microsoft.com/opensource/2018/02/21/go-lang-brian-ketelsen-explains-fast-growth/)、[Paypal](https://go.dev/solutions/paypal/)、[DropBox](https://blogs.dropbox.com/tech/2014/07/open-sourcing-our-go-libraries/)、[Twitter](https://blog.twitter.com/engineering/en_us/a/2015/handling-five-billion-sessions-a-day-in-real-time.html)、[Uber](https://github.com/uber-go)、[Netflix](https://medium.com/netflix-techblog/application-data-caching-using-ssds-5bf25df851ef)、[HashiCorp](https://github.com/hashicorp)、[阿里巴巴](https://github.com/alibaba?language=go)、[腾讯](https://github.com/TencentCloud)、[百度](https://goproxy.baidu.com/)、[PingCAP](https://github.com/pingcap)、[拳头游戏](https://technology.riotgames.com/news/leveraging-golang-game-development-and-operations)。
|
||||
|
||||
# 学习路径
|
||||
|
||||
比较有效的学习方式是在理解语言基础后实际地写几个项目,做中学,学中做。
|
||||
|
||||
## 语言基础
|
||||
|
||||
- 先访问[Golang官网](https://golang.org/)(大陆可以访问[官方镜像](https://golang.google.cn/))进行语言环境的安装;
|
||||
- 在PC上过一遍需要动手做的[官方教程](https://tour.golang.org/),这里有[社区提供的中文版](https://tour.go-zh.org/)。教程会让你熟悉Golang的大部分特性,大约需要2个小时完成;
|
||||
- 将[Go by Example](https://gobyexample.com/)或者[它的社区中文版](https://gobyexample-cn.github.io/)加入浏览器书签,在你不确定怎么使用某个特性时它会很称手的;
|
||||
- 开始实际地写几个项目。
|
||||
|
||||
## IDE
|
||||
|
||||
常见的IDE选择有:
|
||||
|
||||
- Visual Studio Code + [Golang扩展](https://marketplace.visualstudio.com/items?itemName=golang.go):免费,插件由Golang官方提供支持。
|
||||
- [GoLand](https://www.jetbrains.com/go?from=ORLY-cover-generator):付费,JetBrains家的,IDEA、PhpStorm、WebStorm的同门。
|
||||
- vim + [vim-go](https://github.com/fatih/vim-go):免费。
|
||||
- Atom + [Go-Plus](https://atom.io/packages/go-plus):免费。
|
||||
|
||||
如果你没有在上面找到喜欢的IDE,官方wiki里有一份[更全的列表](https://github.com/golang/go/wiki/IDEsAndTextEditorPlugins)。
|
||||
|
||||
## 依赖库和文档
|
||||
|
||||
Golang的标准库非常务实,大部分功能都可以仅依赖标准库实现。标准库的列表见[这里](https://pkg.go.dev/std)。
|
||||
|
||||
典型常用的标准库:
|
||||
|
||||
- [net/http](https://pkg.go.dev/net/http):HTTP客户端和服务端。
|
||||
- [encoding/json](https://pkg.go.dev/encoding/json):JSON编码解码。
|
||||
- [crypto](https://pkg.go.dev/crypto):一众加解密、哈希、签名方法。
|
||||
- [database/sql](https://pkg.go.dev/database/sql):对各类SQL数据库访问的规范。
|
||||
|
||||
Go不需要中心化的库托管服务,所有满足一定规则的代码仓库都是合法的第三方库拉取源。你可以在Github或者搜索引擎中搜索第三方库,并且在官方提供的[Go Dev站点](https://pkg.go.dev/)查询其文档。Go的文档基于按特定规则书写的代码注释生成。例如,我自家养大的HTTP gzip压缩中间件`github.com/nanmu42/gzip`的文档位于: [https://pkg.go.dev/github.com/nanmu42/gzip](https://pkg.go.dev/github.com/nanmu42/gzip)
|
||||
|
||||
一些常用第三方库:
|
||||
|
||||
- [github.com/gin-gonic/gin](https://github.com/gin-gonic/gin):HTTP服务框架,含路由、中间件、请求绑定和验证等。
|
||||
- [go.uber.org/zap](https://github.com/uber-go/zap):结构化日志。
|
||||
- [github.com/go-gorm/gorm](https://github.com/go-gorm/gorm):多种SQL数据库的ORM.
|
||||
- [github.com/go-pg/pg/v10](https://github.com/go-pg/pg):PostgreSQL客户端。
|
||||
- [github.com/go-sql-driver/mysql](https://github.com/go-sql-driver/mysql):MySQL驱动。
|
||||
- [github.com/go-redis/redis/v8](https://github.com/go-redis/redis):Redis客户端。
|
||||
- [github.com/segmentio/kafka-go](https://github.com/segmentio/kafka-go/):Kafka客户端。
|
||||
- [github.com/elastic/go-elasticsearch](https://github.com/elastic/go-elasticsearch):Elasticsearch客户端。
|
||||
- [github.com/mongodb/mongo-go-driver](https://github.com/mongodb/mongo-go-driver):MongoDB客户端。
|
||||
|
||||
大陆的开发者可以使用[由七牛云提供的镜像服务](https://github.com/goproxy/goproxy.cn)以极大提升第三方库的拉取体验。
|
||||
|
||||
## 深入学习
|
||||
|
||||
- [《Go程序设计语言》](https://book.douban.com/subject/27044219/):作者来自Golang团队。
|
||||
- [官方推荐的学习资源](https://golang.org/doc/)
|
||||
- [官方博客的精选文章](https://golang.org/doc/#articles)
|
||||
- [语言规范](https://golang.org/ref/spec)
|
||||
|
||||
# 最佳实践
|
||||
|
||||
## 语言风格
|
||||
|
||||
> 编程是一个创造可能性的过程,同时是一个消去可能性的过程。
|
||||
|
||||
[Golang倡导的语言风格](https://golang.org/doc/)是追求简洁明确和秩序的:
|
||||
|
||||
- 简洁明确:关键词少,API精练;
|
||||
- 秩序(约束):[CSP](https://blog.golang.org/codelab-share), gofmt,静态分析。
|
||||
|
||||
消去可能性让答案变得明显,秩序可以提升团队整体产率。
|
||||
|
||||
## gofmt/goimports
|
||||
|
||||
> 一些小问题容易引发大争论:使用空格还是tab?数组末尾的元素要添加逗号吗?函数的大括号需要先换行吗?……?
|
||||
|
||||
Golang具有完善的静态代码辅助和分析工具,[gofmt](https://golang.org/cmd/gofmt/)/[goimports](https://pkg.go.dev/golang.org/x/tools/cmd/goimports)就是一个很重要的例子。
|
||||
|
||||
在大多编程语言中,代码文本的格式都难以统一——每个人对格式的看法不一,缺乏统一格式的工具(或者工具提供了太多选项让每个人都有机会设定得不一样),软件工程一般都需要团队协作,格式的争论给团队风格统一和代码评审(想想那些因为空格回车或者逗号带来的git diff)带来了困难。
|
||||
|
||||
gofmt会格式化Golang代码,这个过程非常迅速,你可以放心地将其添加到你的IDE的保存时钩子(on-save hook)中。gofmt没有提供任何格式上的选项,只要团队中每个人都使用gofmt,每个人的代码格式都是一样的。
|
||||
|
||||
没人喜欢golang/gofmt的格式,但是人人都喜欢gofmt.
|
||||
|
||||
goimports是gofmt的增强版,格式化代码的同时对依赖进行排序,以保证代码格式上的更高一致性,实际生产中常用于替代gofmt.
|
||||
|
||||
## 静态分析
|
||||
|
||||
> Golang的编译为代码的正确性提供了基本保障,但这还不够。
|
||||
|
||||
静态分析意味着在代码编译前找到错误、可疑问题或优化点。
|
||||
|
||||
Golang的自举意味者其标准库中提供了大量用于解析代码文本和AST语法树的工具,这为Golang代码静态分析的繁荣生态提供了可能。
|
||||
|
||||
[golangci-linter](https://golangci-lint.run/)是近几年崭露头角的静态分析新秀,它集成了大量主题的linter,例如Golang官方提供的检查代码中可疑错误的govet,检查变量(再)赋值后但没有使用的ineffassign,检查忘记处理错误的errcheck,提出代码简化意见的gosimple等等。
|
||||
|
||||
和gofmt/goimports一样,我推荐你将golangci-linter添加到你的IDE的保存时钩子(on-save hook)中,在你编码过程中,它会在第一时间第一现场发现问题并提醒你。
|
||||
|
||||
## 注释和文档
|
||||
|
||||
官方指南[Effective Go](https://golang.org/doc/effective_go.html#commentary)中阐述了编写代码注释以生成文档的最佳实践。
|
||||
|
||||
文档并不是越多越好,下面这些位置可能适合写文档:
|
||||
|
||||
- 依赖库(package)描述。
|
||||
- 公开的(导出的)函数、结构体及其方法、变量、常量。
|
||||
- 业务或算法复杂的过程。
|
||||
- 排期进行的工作(TODO)。
|
||||
|
||||
下面这些位置尤其适合写文档:
|
||||
|
||||
- 由于业务、算法或技术需要,高自由度,多可能性的API,这些地方常常有`interface{}`或者访问者模式(visitor mode),调用者或者实现者需要文档来提供更明确的信息和要求以避免误用API.
|
||||
- 临时的解决方案,需要说明目的和预期的永久方案。
|
||||
|
||||
下面这些位置可能不适合写文档:
|
||||
|
||||
- 作用范围有限的私有(未导出)变量、结构体、方法;
|
||||
- 名称、入参、出参和它们的类型已经能明确表征其用途和非用途的函数和方法;
|
||||
- 一目了然的过程。
|
||||
|
||||
## 测试
|
||||
|
||||
测试可以侦测实现错误、回归错误和意外更改,提升交付效率和信心。如果你已经反复多次手工测试过某个特性,我推荐你考虑为它写个测试。
|
||||
|
||||
Golang原生支持测试,官方提供了清晰的[教程](https://golang.org/doc/tutorial/add-a-test)和[文档](https://golang.org/pkg/testing/).
|
||||
|
||||
部分IDE(如goland和Visual Studio Code)可以快速地生成测试代码所需的格式文本,你可以善用这个特性以提升效率。
|
||||
|
||||
如果你的测试需要数据库或者外部资源,除了自己部署这些资源并固定运行测试的环境以外,你还可以考虑使用[github.com/ory/dockertest/v3](https://github.com/ory/dockertest)在测试时启动一个即用即丟的容器化资源实例以支撑测试,这可以明显降低测试代码对环境的依赖。
|
||||
|
||||
## 编译和部署
|
||||
|
||||
### 二进制
|
||||
|
||||
Golang支持在Linux、Windows和Mac上编译二进制,二进制可执行文件包含完整的Golang运行时和你的程序功能,拷贝到相同系统相同架构的设备中可直接执行。
|
||||
|
||||
根据你的代码规模和依赖多寡,二进制的大小一般会在数MB到数十MB之间变动。
|
||||
|
||||
如果你的代码中不含[cgo](https://golang.org/cmd/cgo/),你还可以在上述任意一个平台交叉编译另外两个平台的二进制。像[Gox](https://github.com/mitchellh/gox)这样的工具可以让你的交叉编译工作更容易,但是它不是必须的。如果你的代码中含有cgo而你确实需要交叉编译,你可以考察[xgo](https://github.com/karalabe/xgo)能不能满足你的需求,它提供了二进制命令行工具和容器化的依赖环境来支撑交叉编译。
|
||||
|
||||
如果你的二进制中需要嵌入静态文件(比如将前端工程打包到二进制中),你可以考虑使用Go 1.16引入的特性[embed](https://tip.golang.org/pkg/embed/).
|
||||
|
||||
### 容器化
|
||||
|
||||
由于Golang本身就产出二进制可执行文件,镜像可以做得非常地薄,甚至[`from scratch`](https://hub.docker.com/_/scratch/),[这里](https://gist.github.com/nanmu42/90bf2d3870b64aec20b68ec3c104a610)提供一个参考的Dockerfile:
|
||||
|
||||
实际在生产中我推荐[使用Alpine做底包](https://github.com/nanmu42/go-web-scaffold/blob/master/Dockerfile),为调试和排错留个口子,同时也更容易管理时区信息和CA证书:
|
||||
# 工程化
|
||||
|
||||
## HTTP服务
|
||||
|
||||
我推荐使用[github.com/gin-gonic/gin](https://github.com/gin-gonic/gin)这个HTTP服务框架来处理路由、中间件、请求绑定和验证。这里有一个[脚手架工程作为例子](https://github.com/nanmu42/go-web-scaffold)。
|
||||
|
||||
你也可以直接依赖标准库`net/http`,但是这些工作就需要自己做了。
|
||||
|
||||
绝大部分Golang的HTTP服务框架(包括gin)都是基于`net/http`开发的,官方库采用的策略是“goroutine per connection”,即对每个连接分配一个goroutine. 这个方案的好处就是你可以以阻塞的思路进行controller开发,并且这个模型在一般负载下能够很好地发挥。
|
||||
|
||||
如果你确定你的服务负载极高,在依赖服务、IO、内存、GPU、CPU上很可能遇到瓶颈,我推荐你考虑做服务限流/熔断/goroutine池,同时考虑换用[gnet](https://github.com/panjf2000/gnet)承载你的业务,这么做的缺点是会让服务更加复杂。
|
||||
|
||||
这里有一个[使用goroutine池以规避内存和IO压力的例子](https://github.com/nanmu42/orly/blob/master/cmd/rly/workerpool.go#L48),它支撑的服务是这个[娱乐性的动物书封面生成器](https://orly.nanmu.me/)。
|
||||
|
||||
## 命令行程序
|
||||
|
||||
[github.com/spf13/cobra](https://github.com/spf13/cobra)提供了一个二进制工具和一套组织代码的方式让你构建命令行程序的过程更加容易,它提供了解析命令行子命令和参数的便利方法。
|
||||
|
||||
## 其他
|
||||
|
||||
- Golang支持[在一定条件下编译到WebAssembly](https://github.com/golang/go/wiki/WebAssembly),从而在浏览器或者node.js上运行;
|
||||
- 虽然不是主流,但是Golang可以用来开发GUI程序,[Fyne](https://github.com/fyne-io/fyne)是一个可供考虑的框架;
|
||||
- 偶然地你可能会有在Android或者iOS移动设备上调用由Golang编写的依赖库的需求,Golang官方的[Go Mobile](https://pkg.go.dev/golang.org/x/mobile)项目也许能帮到你。
|
||||
|
||||
# 工具推荐
|
||||
|
||||
下面这些工具不是必须的,但是可以极大地提升你的编码幸福度:
|
||||
|
||||
- [JSON-to-go](https://mholt.github.io/json-to-go/):即时自动生成和JSON对应的结构体;
|
||||
- [Gopherize.me](https://gopherize.me/):为你的项目定制一个Gopher logo.
|
||||
|
||||
# 资源推荐
|
||||
Uber Go 语言编码规范中文版 https://github.com/xxjwxc/uber_go_guide_cn?tab=readme-ov-file
|
||||
|
||||
- [mzh/blog](https://mzh.io/)
|
||||
- [Ardan Labs Blog](https://www.ardanlabs.com/blog/)
|
||||
- [美团技术工程](https://tech.meituan.com/)
|
||||
- [腾讯技术工程](https://www.zhihu.com/column/tencent-TEG)
|
||||
- [本站](https://nanmu.me/)(逃)
|
||||
@@ -0,0 +1,27 @@
|
||||
|
||||
**IPv6 设置**中选择一种设置类型:
|
||||
|
||||
- **自动**:Synology NAS 会根据 LAN 路由器通告 (RA) 自动生成 IPv6 地址。
|
||||
|
||||
- **无状态模式**:允许连接到路由器的设备自动配置 IPv6 地址而无需设置 IPv6 DNS 服务器。
|
||||
- **无状态 DHCPv6 模式**:允许连接到路由器的设备通过 DHCPv6 自动配置 IPv6 地址并获取 DNS 信息。
|
||||
- **全状态模式**:允许连接到路由器的设备通过 DHCPv6 获取 IPv6 地址和 DNS 信息。在此模式中,您必须启用 DHCPv6 服务器并设置其**起始 IP 地址**和**结束 IP 地址**。
|
||||
|
||||
- **手动**:输入 **IPv6 地址**、**前缀长度**和**默认网关**等信息来手动设置 IPv6。
|
||||
- **关闭**:禁用 IPv6 支持。
|
||||
|
||||
|
||||
### IPv6 有无状态区分
|
||||
- 有状态
|
||||
可控、可管理。有 IP 地址管理者,能够识别客户端。根据不同客户端分配对应v6地址,客户端和服务器存在租期及续约。
|
||||
- 无状态
|
||||
无控、难管理。无IP地址管理者,没人识别客户端。客户端根据网关发送的相同的RA报文内容,自行配置地址
|
||||
|
||||
在 IPv6 完全取代 IPv4 之前,您需通过 IPv6 转换机制来让拥有 IPv4 地址的主机连接到 IPv6 服务。请从以下不同的 IPv6 转换机制中进行选择:
|
||||
|
||||
|
||||
|
||||
- **6in4**:通过隧道代理连接到 IPv6 网络。您需填入 **IPv6 地址**、**前缀长度**、**前缀**和**隧道代理 IPv4 地址**。此操作需要公共 IPv4 地址。
|
||||
- **6to4**:通过使用任意传播的隧道代理连接到 IPv6 网络。此操作需要公共 IPv4 地址。
|
||||
- **DHCP-PD**:通过 LAN 中的前缀授权从 DHCP 服务器获取 IPv6 前缀。此操作需要 ISP 支持,且仅在路由器模式中工作。
|
||||
- **IPv6 隧道 (TSP)**:请进入**控制面板** > **网络** > **常规**配置此选项。
|
||||
@@ -0,0 +1,217 @@
|
||||
**一、调用wasm中导出方法的函数**
|
||||
在js中,我们可以通过以下五种方式调用wasm中导出的方法:
|
||||
|
||||
1、**_函数名**
|
||||
2、**Module.ccall**
|
||||
|
||||
| | |
|
||||
| --- | -------------------------------------------------------------- |
|
||||
| 1 | `const ret = Module.ccall(ident, returnType, argTypes, args);` |
|
||||
|
||||
参数释义如下:
|
||||
|
||||
`ident`:C导出函数的函数名(不含“_”下划线前缀);
|
||||
|
||||
`returnType`:C导出函数的返回值类型,可以为'`boolean`'、'`number`'、'`string`'、'`null`',分别表示函数返回值为布尔值、数值、字符串、无返回值;
|
||||
|
||||
`argTypes`:C导出函数的参数类型的数组。参数类型可以为'`number`'、'`string`'、'`array`',分别代表数值、字符串、数组;
|
||||
|
||||
`args`:参数数组;
|
||||
|
||||
使用方式:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1|`const ret = Module.ccall('add', 'number', ['number', 'number'], [1, 2]);`|
|
||||
|
||||
**Emscripten从**`v1.38`**开始,**`ccall/cwrap`**辅助函数默认没有导出,在编译时需要通过**`-s EXPORTED_RUNTIME_METHODS="['ccall', 'cwrap']"`**选项显式导出。**
|
||||
|
||||
3、**Module.cwrap**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const func = Module.cwrap(ident, returnType, argTypes);`<br><br>`const ret = func(args);`|
|
||||
|
||||
参数释义如下:
|
||||
|
||||
`ident`:C导出函数的函数名(不含“_”下划线前缀);
|
||||
|
||||
`returnType`:C导出函数的返回值类型,可以为'`boolean`'、'`number`'、'`string`'、'`null`',分别表示函数返回值为布尔值、数值、字符串、无返回值;
|
||||
|
||||
`argTypes`:C导出函数的参数类型的数组。参数类型可以为'`number`'、'`string`'、'`array`',分别代表数值、字符串、数组;
|
||||
|
||||
返回值:函数
|
||||
|
||||
使用方式:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const func = Module.cwrap('add', 'number', ['number', 'number']);`<br><br>`const ret = func(1, 2);`|
|
||||
|
||||
**Emscripten从**`v1.38`**开始,**`ccall/cwrap`**辅助函数默认没有导出,在编译时需要通过**``-s `EXPORTED_RUNTIME_METHODS`="['ccall', 'cwrap']"``**选项显式导出。**
|
||||
|
||||
4、**Module._函数名**
|
||||
|
||||
5、**Module.asm.函数名**
|
||||
|
||||
上面我们了解了js调用wasm导出方法的5种方式,接下来我们开始介绍js和wasm间各种数据类型的传递。
|
||||
|
||||
|
||||
|
||||
**二、数字类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4|`int add(int n1, int n2) {`<br><br> `int ret = n1 + n2;`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向**C函数**传递数字:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4|`const r1 = _add(1, 2); // 3`<br><br>`const r2 = Module._add(1, 2); // 3`<br><br>`const r3 = Module.ccall('add', 'number', ['number', 'number'], [1, 2]); // 3`<br><br>`const r4 = Module.cwrap('add', 'number', ['number', 'number'])(1, 2); // 3`|
|
||||
|
||||
**获取**C函数**返回的数字:**
|
||||
|
||||
由于返回的数字是默认支持的类型,`r1`,`r2`,`r3`,`r4`即为结果。
|
||||
|
||||
**三、字符串类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9|`#include <string.h>`<br><br>`#include <malloc.h>`<br><br>`char * concat_str(char *s1, char *s2) {`<br><br> `char *ret = (char *)malloc((strlen(s1) + strlen(s2)) * sizeof(char));`<br><br> `strcat(ret, s1);`<br><br> `strcat(ret, s2);`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向C函数内传递**字符串**:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const r1 = Module.ccall('concat_str', 'string', ['string', 'string'], ['Hello ', 'World']); // Hello World`<br><br>`const r2 = Module.cwrap('concat_str', 'string', ['string', 'string'])('Hello ', 'World'); // Hello World`|
|
||||
|
||||
**获取**C函数**返回的字符串:**
|
||||
|
||||
由于返回的数字是`ccall`,`cwrap`默认支持的类型,`r1`,`r2`即为结果。
|
||||
|
||||
上面没有直接使用函数名去调用C函数,因为不支持将字符串通过函数调用的方式直接传递给C函数,和我们预期是不一样的,感兴趣的可以去试一下,但是该如何使用函数名调用C函数呢,这里简单演示一下,作为后面数组传递的基础。
|
||||
|
||||
**向**C函数**传递**字符串**:**
|
||||
|
||||
| | |
|
||||
| ------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
|
||||
| 1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9 | `const s1 = 'Hello ';`<br><br>`const s2 = 'World';`<br><br>`const s1Arr = new TextEncoder().encode(s1);`<br><br>`const buf1 = Module._malloc(s1Arr.byteLength);`<br><br>`Module.HEAPU8.set(s1Arr, buf1);`<br><br>`const s2Arr = new TextEncoder().encode(s2);`<br><br>`const buf2 = Module._malloc(s2Arr.byteLength);`<br><br>`Module.HEAPU8.set(s2Arr, buf2);`<br><br>`const r1 = _concat_str(buf1, buf2); // 地址` |
|
||||
|
||||
这里我们将字符串`s1`和`s2`转为类型化数组`Uint8Array`,然后通过wasm提供的内存分配函数申请了内存,并放入了内存中,数据放到内存后将分配内存后得到的地址传递给C函数`_concat_str`即可。
|
||||
|
||||
**获取C函数返回的字符串:**
|
||||
|
||||
这里需要注意的是返回结果`r1`并不是预期的字符串而是一个内存地址,我们需要根据内存地址去获取返回结果:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9|`const memoryView = new Uint8Array(Module.asm.memory.buffer);`<br><br>`const arr = [];`<br><br>`let i = r1;`<br><br>`while (memoryView[i] !== 0) {`<br><br> `arr.push(memoryView[i]);`<br><br> `i ++;`<br><br>`}`<br><br>`const ret = new TextDecoder().decode(new Uint8Array(arr));`<br><br>`console.log(ret); // Hello World`|
|
||||
|
||||
**四、一维纯数字数组类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7|`int * mapArray(uint8_t *arr, int arrSize) {`<br><br> `int *ret = (int *)malloc(arrSize * sizeof(int));`<br><br> `for (int i=0; i<arrSize; i++) {`<br><br> `ret[i] = arr[i] * 2;`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向**C函数**传递一维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3|`const arr = [1, 3, 2, 5, 4];`<br><br>`const r1 = Module.ccall('mapArray', 'number', ['array', 'number'], [arr, arr.length]); // 地址`<br><br>`const r2 = Module.cwrap('mapArray', 'number', ['array', 'number'])(arr, arr.length); // 地址`|
|
||||
|
||||
如果想通过函数名直接向C函数传递数据,可以参考上面通过函数名直接向C函数传递字符串的方法。
|
||||
|
||||
**获取C函数返回的一维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5|`const { BYTES_PER_ELEMENT } = Float32Array;`<br><br>`const pointer = r1;`<br><br>`const data = new Float32Array(Module.asm.memory.buffer, pointer, arr.length);`<br><br>`const ret = Array.from(data);`<br><br>`console.log(ret); // [2, 6, 4, 10, 8]`|
|
||||
|
||||
这里的做法和上面获取直接调用函数名返回的字符串基本类似,但是没有字符串灵活,我们通过`\0`字符来判断字符串的结束进而拿到整个字符串而不需要提前知道返回字符串的长度,但是对于数组的话我们需要提前知道返回的数组的大小,才能准确的从内存中拿到返回结果。
|
||||
|
||||
**注意:**C语言中`int`类型数组对应`Uint32Array`,`float`类型数组对应`Float32Array`,`double`类型数组对应`Float64Array`,在获取结果时一定要使用正确的类型化数组,否则获取的结果将是错误的。
|
||||
|
||||
**五、二维纯数字数组类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12|`double ** mapArray2(uint8_t *arr, int row, int col) {`<br><br> `static double **ret;`<br><br> `ret = (double **)malloc(row * col * sizeof(double *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (double *)malloc(col * sizeof(double));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[i * row + j] * 2;`<br><br> `printf("%d:%d=%f\n", i, j, ret[i][j]);`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向C函数传递二维数组:**
|
||||
|
||||
由于 C 编写的 WASM 模块只能接受一维数组,因此需要将二维数组转换为一维数组然后再传递。
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7|`const arr = [`<br><br> `[1, 2, 3],`<br><br> `[4, 5, 6],`<br><br> `[7, 8, 9]`<br><br>`];`<br><br>`const r1 = Module.ccall('mapArray2', 'number', ['array', 'number', 'number'], [arr.flat(), arr.length, arr[0].length]); // 地址`<br><br>`const r2 = Module.cwrap('mapArray2', 'number', ['array', 'number', 'number'])(arr.flat(), arr.length, arr[0].length); // 地址`|
|
||||
|
||||
**获取C函数返回的二维数组:**
|
||||
|
||||
这里就会麻烦一点,因为二维数组每一行对应的数据都存在一片单独的内存上,而且不一定是连续的,所以我们需要将每一行的起始内存地址返回,我们稍微修改一下C代码:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16|`double **ret;`<br><br>`double * getLineAddress(int row) {`<br><br> `return ret[row];`<br><br>`}`<br><br>`double ** mapArray2(uint8_t *arr, int row, int col) {`<br><br> `ret = (double **)malloc(row * col * sizeof(double *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (double *)malloc(col * sizeof(double));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[i * row + j] * 2;`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
在全局定义结果变量,然后提供一个获取每行地址的方法:`getLineAddress`。
|
||||
|
||||
然后使用js获取C函数返回的结果:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8|`const { BYTES_PER_ELEMENT } = Float64Array;`<br><br>`const ret = [];`<br><br>`for (let i=0; i<arr.length; i++) {`<br><br> `const pointer = _getLineAddress(i);`<br><br> `const row = new Float64Array(Module.asm.memory.buffer, pointer, arr[0].length);`<br><br> `ret.push(Array.from(row));`<br><br>`}`<br><br>`console.log(ret); // [[2, 4, 6], [,8, 10, 12],[14, 16, 18]]`|
|
||||
|
||||
**六、字符串数组的传递**
|
||||
|
||||
**C函数定义**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6|`char ** mapStringArray(char **strings, int length) {`<br><br> `for (int i = 0; i < length; i++) {`<br><br> `printf("%s\n", strings[i]);`<br><br> `}`<br><br> `return strings;`<br><br>`}`|
|
||||
|
||||
**向C函数传递二维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17|`const strings = ['Hello', 'world', '!'];`<br><br>`// 将字符串存到内存中并获得字符串指针`<br><br>`const pointers = strings.map((str) => {`<br><br> `const buf = Module._malloc(str.length + 1);`<br><br> `Module.writeStringToMemory(str, buf);`<br><br> `return buf;`<br><br>`});`<br><br>`// 非常重要,将内存中存储的字符串重新存储到连续的内存`<br><br>`const STRING_BYTE = 4;`<br><br>`const ptr = Module._malloc(pointers.length * STRING_BYTE);`<br><br>`for (let i = 0; i < pointers.length; i++) {`<br><br> `Module.setValue(ptr + i * STRING_BYTE, pointers[i], 'i32');`<br><br>`}`<br><br>`const pointer = Module.ccall('mapStringArray', 'null', ['number', 'number'], [ptr, strings.length]);`|
|
||||
|
||||
在上面的方法中,我们首先将字符串存到内存中并得到了`字符串指针数组`,然后将字符串重新存储到了`连续的内存`中,这一步非常重要,直接影响C函数是否能正常取到字符串的值,需要注意C语言存储字符串时每个字符占4字节。
|
||||
|
||||
**获取C函数返回的字符串数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10|`const ret = [];`<br><br>`for (let i=0; i<strings.length; i++) {`<br><br> `const ptr = Module.getValue(pointer + i * 4, 'i32');`<br><br> `if (ptr === 0) {`<br><br> `break;`<br><br> `}`<br><br> `const str = Module.UTF8ToString(ptr);`<br><br> `ret.push(str);`<br><br>`}`<br><br>`console.log(ret); // ['Hello', 'world', '!']`|
|
||||
|
||||
**注意:**上面使用的`writeStringToMemory`,`setValue`,`getValue`,`UTF8ToString`需要通过`-s EXPORTED_RUNTIME_METHODS='["ccall", "cwrap", "writeAsciiToMemory", "writeStringToMemory", "setValue", "getValue", "UTF8ToString"]'` 导出。
|
||||
|
||||
不管是一维数组还是多位数组我们都需要提前知道返回数组的大小才能正确取得数据,如果输入的数组大小和输出的数组大小不一致时就很难正确的去除数据,所以我感觉C函数直接使用数组结构返回结果不是太灵活,其实我们可以换一种思路,比如将二维数组转换成字符串传递,接收到数据后再解析,类似下面这样:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1|`2,3,1,2,3,4,5,6`|
|
||||
|
||||
通过上面的字符串描述一个`2 * 3`的二维数组,然后我们将其转换成真实的数组即可。
|
||||
|
||||
js的转换方法:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17|`function str2Arr(str) {`<br><br> `const arr = str.split(',')`<br><br> `.map(m => Number(m));`<br><br> `const ret = [];`<br><br> `const row = arr[0];`<br><br> `const col = arr[1];`<br><br> `let index = 2;`<br><br> `for (let i=0; i<row; i++) {`<br><br> `ret[i] = [];`<br><br> `for(let j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[index++];`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`str2Arr('2,3,1,2,3,4,5,6');`|
|
||||
|
||||
C语言的转换方法:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17<br><br>18<br><br>19<br><br>20<br><br>21<br><br>22<br><br>23<br><br>24<br><br>25<br><br>26<br><br>27<br><br>28<br><br>29<br><br>30<br><br>31<br><br>32<br><br>33<br><br>34<br><br>35<br><br>36<br><br>37<br><br>38<br><br>39<br><br>40<br><br>41<br><br>42<br><br>43<br><br>44<br><br>45<br><br>46<br><br>47<br><br>48<br><br>49<br><br>50|`#include <stdio.h>`<br><br>`#include <string.h>`<br><br>`#include <stdlib.h>`<br><br>`int * split_int(char *str, char *sep) {`<br><br> `static int ret[100];`<br><br> `char *token;`<br><br> `token = strtok(str, sep);`<br><br> `int i = 0;`<br><br> `while (token != NULL) {`<br><br> `ret[i++] = atoi(token);`<br><br> `token = strtok(NULL, sep);`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`int ** str_2_matrix(char *str, int *r, int *c) {`<br><br> `int *arr = split_int(str, ",");`<br><br> `int row = arr[0];`<br><br> `int col = arr[1];`<br><br> `if (r != NULL) {`<br><br> `*r = row;`<br><br> `}`<br><br> `if (c != NULL) {`<br><br> `*c = col;`<br><br> `}`<br><br> `int index = 2;`<br><br> `static int **ret;`<br><br> `ret = (int **)malloc(row * sizeof(int *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (int *)malloc(col * sizeof(int));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[index++];`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`int main() {`<br><br> `char s[] = "2,3,1,2,3,4,5,6";`<br><br> `int r, c;`<br><br> `int **ret = str_2_matrix(s, &r, &c);`<br><br> `for (int i=0; i<r; i++) {`<br><br> `for (int j=0; j<c; j++) {`<br><br> `printf("%6d", ret[i][j]);`<br><br> `}`<br><br> `printf("\n");`<br><br> `}`<br><br> `return 0;`<br><br>`}`|
|
||||
|
||||
本文到此就结束了,希望大家在对接wasm应用的过程中不再迷茫。
|
||||
@@ -0,0 +1,217 @@
|
||||
**一、调用wasm中导出方法的函数**
|
||||
在js中,我们可以通过以下五种方式调用wasm中导出的方法:
|
||||
|
||||
1、**_函数名**
|
||||
2、**Module.ccall**
|
||||
|
||||
| | |
|
||||
| --- | -------------------------------------------------------------- |
|
||||
| 1 | `const ret = Module.ccall(ident, returnType, argTypes, args);` |
|
||||
|
||||
参数释义如下:
|
||||
|
||||
`ident`:C导出函数的函数名(不含“_”下划线前缀);
|
||||
|
||||
`returnType`:C导出函数的返回值类型,可以为'`boolean`'、'`number`'、'`string`'、'`null`',分别表示函数返回值为布尔值、数值、字符串、无返回值;
|
||||
|
||||
`argTypes`:C导出函数的参数类型的数组。参数类型可以为'`number`'、'`string`'、'`array`',分别代表数值、字符串、数组;
|
||||
|
||||
`args`:参数数组;
|
||||
|
||||
使用方式:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1|`const ret = Module.ccall('add', 'number', ['number', 'number'], [1, 2]);`|
|
||||
|
||||
**Emscripten从**`v1.38`**开始,**`ccall/cwrap`**辅助函数默认没有导出,在编译时需要通过**`-s EXPORTED_RUNTIME_METHODS="['ccall', 'cwrap']"`**选项显式导出。**
|
||||
|
||||
3、**Module.cwrap**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const func = Module.cwrap(ident, returnType, argTypes);`<br><br>`const ret = func(args);`|
|
||||
|
||||
参数释义如下:
|
||||
|
||||
`ident`:C导出函数的函数名(不含“_”下划线前缀);
|
||||
|
||||
`returnType`:C导出函数的返回值类型,可以为'`boolean`'、'`number`'、'`string`'、'`null`',分别表示函数返回值为布尔值、数值、字符串、无返回值;
|
||||
|
||||
`argTypes`:C导出函数的参数类型的数组。参数类型可以为'`number`'、'`string`'、'`array`',分别代表数值、字符串、数组;
|
||||
|
||||
返回值:函数
|
||||
|
||||
使用方式:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const func = Module.cwrap('add', 'number', ['number', 'number']);`<br><br>`const ret = func(1, 2);`|
|
||||
|
||||
**Emscripten从**`v1.38`**开始,**`ccall/cwrap`**辅助函数默认没有导出,在编译时需要通过**``-s `EXPORTED_RUNTIME_METHODS`="['ccall', 'cwrap']"``**选项显式导出。**
|
||||
|
||||
4、**Module._函数名**
|
||||
|
||||
5、**Module.asm.函数名**
|
||||
|
||||
上面我们了解了js调用wasm导出方法的5种方式,接下来我们开始介绍js和wasm间各种数据类型的传递。
|
||||
|
||||
|
||||
|
||||
**二、数字类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4|`int add(int n1, int n2) {`<br><br> `int ret = n1 + n2;`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向**C函数**传递数字:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4|`const r1 = _add(1, 2); // 3`<br><br>`const r2 = Module._add(1, 2); // 3`<br><br>`const r3 = Module.ccall('add', 'number', ['number', 'number'], [1, 2]); // 3`<br><br>`const r4 = Module.cwrap('add', 'number', ['number', 'number'])(1, 2); // 3`|
|
||||
|
||||
**获取**C函数**返回的数字:**
|
||||
|
||||
由于返回的数字是默认支持的类型,`r1`,`r2`,`r3`,`r4`即为结果。
|
||||
|
||||
**三、字符串类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9|`#include <string.h>`<br><br>`#include <malloc.h>`<br><br>`char * concat_str(char *s1, char *s2) {`<br><br> `char *ret = (char *)malloc((strlen(s1) + strlen(s2)) * sizeof(char));`<br><br> `strcat(ret, s1);`<br><br> `strcat(ret, s2);`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向C函数内传递**字符串**:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const r1 = Module.ccall('concat_str', 'string', ['string', 'string'], ['Hello ', 'World']); // Hello World`<br><br>`const r2 = Module.cwrap('concat_str', 'string', ['string', 'string'])('Hello ', 'World'); // Hello World`|
|
||||
|
||||
**获取**C函数**返回的字符串:**
|
||||
|
||||
由于返回的数字是`ccall`,`cwrap`默认支持的类型,`r1`,`r2`即为结果。
|
||||
|
||||
上面没有直接使用函数名去调用C函数,因为不支持将字符串通过函数调用的方式直接传递给C函数,和我们预期是不一样的,感兴趣的可以去试一下,但是该如何使用函数名调用C函数呢,这里简单演示一下,作为后面数组传递的基础。
|
||||
|
||||
**向**C函数**传递**字符串**:**
|
||||
|
||||
| | |
|
||||
| ------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
|
||||
| 1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9 | `const s1 = 'Hello ';`<br><br>`const s2 = 'World';`<br><br>`const s1Arr = new TextEncoder().encode(s1);`<br><br>`const buf1 = Module._malloc(s1Arr.byteLength);`<br><br>`Module.HEAPU8.set(s1Arr, buf1);`<br><br>`const s2Arr = new TextEncoder().encode(s2);`<br><br>`const buf2 = Module._malloc(s2Arr.byteLength);`<br><br>`Module.HEAPU8.set(s2Arr, buf2);`<br><br>`const r1 = _concat_str(buf1, buf2); // 地址` |
|
||||
|
||||
这里我们将字符串`s1`和`s2`转为类型化数组`Uint8Array`,然后通过wasm提供的内存分配函数申请了内存,并放入了内存中,数据放到内存后将分配内存后得到的地址传递给C函数`_concat_str`即可。
|
||||
|
||||
**获取C函数返回的字符串:**
|
||||
|
||||
这里需要注意的是返回结果`r1`并不是预期的字符串而是一个内存地址,我们需要根据内存地址去获取返回结果:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9|`const memoryView = new Uint8Array(Module.asm.memory.buffer);`<br><br>`const arr = [];`<br><br>`let i = r1;`<br><br>`while (memoryView[i] !== 0) {`<br><br> `arr.push(memoryView[i]);`<br><br> `i ++;`<br><br>`}`<br><br>`const ret = new TextDecoder().decode(new Uint8Array(arr));`<br><br>`console.log(ret); // Hello World`|
|
||||
|
||||
**四、一维纯数字数组类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7|`int * mapArray(uint8_t *arr, int arrSize) {`<br><br> `int *ret = (int *)malloc(arrSize * sizeof(int));`<br><br> `for (int i=0; i<arrSize; i++) {`<br><br> `ret[i] = arr[i] * 2;`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向**C函数**传递一维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3|`const arr = [1, 3, 2, 5, 4];`<br><br>`const r1 = Module.ccall('mapArray', 'number', ['array', 'number'], [arr, arr.length]); // 地址`<br><br>`const r2 = Module.cwrap('mapArray', 'number', ['array', 'number'])(arr, arr.length); // 地址`|
|
||||
|
||||
如果想通过函数名直接向C函数传递数据,可以参考上面通过函数名直接向C函数传递字符串的方法。
|
||||
|
||||
**获取C函数返回的一维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5|`const { BYTES_PER_ELEMENT } = Float32Array;`<br><br>`const pointer = r1;`<br><br>`const data = new Float32Array(Module.asm.memory.buffer, pointer, arr.length);`<br><br>`const ret = Array.from(data);`<br><br>`console.log(ret); // [2, 6, 4, 10, 8]`|
|
||||
|
||||
这里的做法和上面获取直接调用函数名返回的字符串基本类似,但是没有字符串灵活,我们通过`\0`字符来判断字符串的结束进而拿到整个字符串而不需要提前知道返回字符串的长度,但是对于数组的话我们需要提前知道返回的数组的大小,才能准确的从内存中拿到返回结果。
|
||||
|
||||
**注意:**C语言中`int`类型数组对应`Uint32Array`,`float`类型数组对应`Float32Array`,`double`类型数组对应`Float64Array`,在获取结果时一定要使用正确的类型化数组,否则获取的结果将是错误的。
|
||||
|
||||
**五、二维纯数字数组类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12|`double ** mapArray2(uint8_t *arr, int row, int col) {`<br><br> `static double **ret;`<br><br> `ret = (double **)malloc(row * col * sizeof(double *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (double *)malloc(col * sizeof(double));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[i * row + j] * 2;`<br><br> `printf("%d:%d=%f\n", i, j, ret[i][j]);`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向C函数传递二维数组:**
|
||||
|
||||
由于 C 编写的 WASM 模块只能接受一维数组,因此需要将二维数组转换为一维数组然后再传递。
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7|`const arr = [`<br><br> `[1, 2, 3],`<br><br> `[4, 5, 6],`<br><br> `[7, 8, 9]`<br><br>`];`<br><br>`const r1 = Module.ccall('mapArray2', 'number', ['array', 'number', 'number'], [arr.flat(), arr.length, arr[0].length]); // 地址`<br><br>`const r2 = Module.cwrap('mapArray2', 'number', ['array', 'number', 'number'])(arr.flat(), arr.length, arr[0].length); // 地址`|
|
||||
|
||||
**获取C函数返回的二维数组:**
|
||||
|
||||
这里就会麻烦一点,因为二维数组每一行对应的数据都存在一片单独的内存上,而且不一定是连续的,所以我们需要将每一行的起始内存地址返回,我们稍微修改一下C代码:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16|`double **ret;`<br><br>`double * getLineAddress(int row) {`<br><br> `return ret[row];`<br><br>`}`<br><br>`double ** mapArray2(uint8_t *arr, int row, int col) {`<br><br> `ret = (double **)malloc(row * col * sizeof(double *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (double *)malloc(col * sizeof(double));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[i * row + j] * 2;`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
在全局定义结果变量,然后提供一个获取每行地址的方法:`getLineAddress`。
|
||||
|
||||
然后使用js获取C函数返回的结果:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8|`const { BYTES_PER_ELEMENT } = Float64Array;`<br><br>`const ret = [];`<br><br>`for (let i=0; i<arr.length; i++) {`<br><br> `const pointer = _getLineAddress(i);`<br><br> `const row = new Float64Array(Module.asm.memory.buffer, pointer, arr[0].length);`<br><br> `ret.push(Array.from(row));`<br><br>`}`<br><br>`console.log(ret); // [[2, 4, 6], [,8, 10, 12],[14, 16, 18]]`|
|
||||
|
||||
**六、字符串数组的传递**
|
||||
|
||||
**C函数定义**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6|`char ** mapStringArray(char **strings, int length) {`<br><br> `for (int i = 0; i < length; i++) {`<br><br> `printf("%s\n", strings[i]);`<br><br> `}`<br><br> `return strings;`<br><br>`}`|
|
||||
|
||||
**向C函数传递二维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17|`const strings = ['Hello', 'world', '!'];`<br><br>`// 将字符串存到内存中并获得字符串指针`<br><br>`const pointers = strings.map((str) => {`<br><br> `const buf = Module._malloc(str.length + 1);`<br><br> `Module.writeStringToMemory(str, buf);`<br><br> `return buf;`<br><br>`});`<br><br>`// 非常重要,将内存中存储的字符串重新存储到连续的内存`<br><br>`const STRING_BYTE = 4;`<br><br>`const ptr = Module._malloc(pointers.length * STRING_BYTE);`<br><br>`for (let i = 0; i < pointers.length; i++) {`<br><br> `Module.setValue(ptr + i * STRING_BYTE, pointers[i], 'i32');`<br><br>`}`<br><br>`const pointer = Module.ccall('mapStringArray', 'null', ['number', 'number'], [ptr, strings.length]);`|
|
||||
|
||||
在上面的方法中,我们首先将字符串存到内存中并得到了`字符串指针数组`,然后将字符串重新存储到了`连续的内存`中,这一步非常重要,直接影响C函数是否能正常取到字符串的值,需要注意C语言存储字符串时每个字符占4字节。
|
||||
|
||||
**获取C函数返回的字符串数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10|`const ret = [];`<br><br>`for (let i=0; i<strings.length; i++) {`<br><br> `const ptr = Module.getValue(pointer + i * 4, 'i32');`<br><br> `if (ptr === 0) {`<br><br> `break;`<br><br> `}`<br><br> `const str = Module.UTF8ToString(ptr);`<br><br> `ret.push(str);`<br><br>`}`<br><br>`console.log(ret); // ['Hello', 'world', '!']`|
|
||||
|
||||
**注意:**上面使用的`writeStringToMemory`,`setValue`,`getValue`,`UTF8ToString`需要通过`-s EXPORTED_RUNTIME_METHODS='["ccall", "cwrap", "writeAsciiToMemory", "writeStringToMemory", "setValue", "getValue", "UTF8ToString"]'` 导出。
|
||||
|
||||
不管是一维数组还是多位数组我们都需要提前知道返回数组的大小才能正确取得数据,如果输入的数组大小和输出的数组大小不一致时就很难正确的去除数据,所以我感觉C函数直接使用数组结构返回结果不是太灵活,其实我们可以换一种思路,比如将二维数组转换成字符串传递,接收到数据后再解析,类似下面这样:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1|`2,3,1,2,3,4,5,6`|
|
||||
|
||||
通过上面的字符串描述一个`2 * 3`的二维数组,然后我们将其转换成真实的数组即可。
|
||||
|
||||
js的转换方法:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17|`function str2Arr(str) {`<br><br> `const arr = str.split(',')`<br><br> `.map(m => Number(m));`<br><br> `const ret = [];`<br><br> `const row = arr[0];`<br><br> `const col = arr[1];`<br><br> `let index = 2;`<br><br> `for (let i=0; i<row; i++) {`<br><br> `ret[i] = [];`<br><br> `for(let j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[index++];`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`str2Arr('2,3,1,2,3,4,5,6');`|
|
||||
|
||||
C语言的转换方法:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17<br><br>18<br><br>19<br><br>20<br><br>21<br><br>22<br><br>23<br><br>24<br><br>25<br><br>26<br><br>27<br><br>28<br><br>29<br><br>30<br><br>31<br><br>32<br><br>33<br><br>34<br><br>35<br><br>36<br><br>37<br><br>38<br><br>39<br><br>40<br><br>41<br><br>42<br><br>43<br><br>44<br><br>45<br><br>46<br><br>47<br><br>48<br><br>49<br><br>50|`#include <stdio.h>`<br><br>`#include <string.h>`<br><br>`#include <stdlib.h>`<br><br>`int * split_int(char *str, char *sep) {`<br><br> `static int ret[100];`<br><br> `char *token;`<br><br> `token = strtok(str, sep);`<br><br> `int i = 0;`<br><br> `while (token != NULL) {`<br><br> `ret[i++] = atoi(token);`<br><br> `token = strtok(NULL, sep);`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`int ** str_2_matrix(char *str, int *r, int *c) {`<br><br> `int *arr = split_int(str, ",");`<br><br> `int row = arr[0];`<br><br> `int col = arr[1];`<br><br> `if (r != NULL) {`<br><br> `*r = row;`<br><br> `}`<br><br> `if (c != NULL) {`<br><br> `*c = col;`<br><br> `}`<br><br> `int index = 2;`<br><br> `static int **ret;`<br><br> `ret = (int **)malloc(row * sizeof(int *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (int *)malloc(col * sizeof(int));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[index++];`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`int main() {`<br><br> `char s[] = "2,3,1,2,3,4,5,6";`<br><br> `int r, c;`<br><br> `int **ret = str_2_matrix(s, &r, &c);`<br><br> `for (int i=0; i<r; i++) {`<br><br> `for (int j=0; j<c; j++) {`<br><br> `printf("%6d", ret[i][j]);`<br><br> `}`<br><br> `printf("\n");`<br><br> `}`<br><br> `return 0;`<br><br>`}`|
|
||||
|
||||
本文到此就结束了,希望大家在对接wasm应用的过程中不再迷茫。
|
||||
@@ -0,0 +1,27 @@
|
||||
1. **GIL(全局解释器锁)的本质:**
|
||||
- GIL是CPython解释器中的一个互斥锁
|
||||
- 同一时间只允许一个线程执行Python字节码
|
||||
- 目的是保护解释器内部数据结构,防止竞争条件
|
||||
|
||||
2. **GIL对多线程的影响:**
|
||||
|
||||
- **CPU密集型任务**:多线程无法利用多核优势,性能提升有限甚至更差
|
||||
- **I/O密集型任务**:线程在等待I/O时会释放GIL,多线程可以有效提高性能
|
||||
- 线程切换和GIL争抢会带来额外开销
|
||||
|
||||
3. **多线程 vs 多进程选择:**
|
||||
|
||||
| 场景 | 推荐 | 原因 |
|
||||
| -------- | --- | -------------- |
|
||||
| CPU密集型计算 | 多进程 | 避免GIL限制,充分利用多核 |
|
||||
| I/O密集型任务 | 多线程 | 轻量级,切换成本低 |
|
||||
| 需要共享大量数据 | 多线程 | 进程间通信成本高 |
|
||||
| 需要高稳定性 | 多进程 | 进程崩溃不影响其他进程 |
|
||||
| 需要启动大量并发 | 协程 | 更轻量,支持更高并发 |
|
||||
|
||||
4. **解决方案:**
|
||||
|
||||
- 使用`multiprocessing`模块进行多进程编程
|
||||
- 使用`concurrent.futures`线程/进程池
|
||||
- 使用Jython、IronPython等无GIL的解释器
|
||||
- 将CPU密集型代码用C扩展实现
|
||||
@@ -0,0 +1,390 @@
|
||||
## 一、select 模式相关函数
|
||||
|
||||
### 核心函数
|
||||
```python
|
||||
import select
|
||||
|
||||
# 1. 主要的 select 函数
|
||||
select.select(rlist, wlist, xlist[, timeout])
|
||||
# rlist: 等待读就绪的socket列表
|
||||
# wlist: 等待写就绪的socket列表
|
||||
# xlist: 等待异常条件的socket列表
|
||||
# timeout: 超时时间(秒),None表示阻塞,0表示立即返回
|
||||
|
||||
# 2. 在 Windows 上使用
|
||||
select.win32_select(rlist, wlist, xlist[, timeout])
|
||||
```
|
||||
|
||||
### select 模块常量
|
||||
```python
|
||||
# 错误常量
|
||||
select.error # 异常类
|
||||
select.EINTR # 中断错误
|
||||
select.EBADF # 错误的文件描述符
|
||||
|
||||
# 跨平台常量
|
||||
select.PIPE_BUF # 管道缓冲区大小
|
||||
```
|
||||
|
||||
### 示例代码
|
||||
```python
|
||||
import select
|
||||
import socket
|
||||
|
||||
# 创建服务器
|
||||
server = socket.socket()
|
||||
server.bind(('localhost', 8888))
|
||||
server.listen(5)
|
||||
|
||||
# 要监视的socket列表
|
||||
read_list = [server]
|
||||
write_list = []
|
||||
error_list = []
|
||||
|
||||
while True:
|
||||
# 调用 select
|
||||
readable, writable, exceptional = select.select(
|
||||
read_list, write_list, error_list, 1.0
|
||||
)
|
||||
|
||||
for s in readable:
|
||||
if s is server:
|
||||
# 新连接
|
||||
client, addr = server.accept()
|
||||
read_list.append(client)
|
||||
else:
|
||||
# 可读数据
|
||||
data = s.recv(1024)
|
||||
if data:
|
||||
# 处理数据
|
||||
write_list.append(s) # 准备回写
|
||||
else:
|
||||
# 连接关闭
|
||||
read_list.remove(s)
|
||||
s.close()
|
||||
|
||||
for s in writable:
|
||||
s.send(b"Response")
|
||||
write_list.remove(s)
|
||||
```
|
||||
|
||||
## 二、epoll 模式相关函数(仅限Linux)
|
||||
|
||||
### 核心类和方法
|
||||
```python
|
||||
import select
|
||||
|
||||
# 1. 创建 epoll 对象
|
||||
epoll = select.epoll([sizehint=-1])
|
||||
|
||||
# 2. epoll 对象的方法
|
||||
epoll.register(fd[, eventmask])
|
||||
# fd: 文件描述符
|
||||
# eventmask: 事件掩码,可以是以下组合:
|
||||
# select.EPOLLIN - 可读
|
||||
# select.EPOLLOUT - 可写
|
||||
# select.EPOLLPRI - 紧急数据可读
|
||||
# select.EPOLLERR - 错误
|
||||
# select.EPOLLHUP - 挂起
|
||||
# select.EPOLLET - 边缘触发模式
|
||||
# select.EPOLLONESHOT - 一次性事件
|
||||
|
||||
epoll.unregister(fd) # 注销文件描述符
|
||||
epoll.modify(fd, eventmask) # 修改事件掩码
|
||||
|
||||
epoll.poll([timeout=-1[, maxevents=-1]])
|
||||
# 返回 [(fd, events), ...] 列表
|
||||
# timeout: 超时秒数,-1表示阻塞,0表示立即返回
|
||||
|
||||
epoll.close() # 关闭 epoll 对象
|
||||
epoll.fileno() # 获取 epoll 文件描述符
|
||||
```
|
||||
|
||||
### epoll 常量
|
||||
```python
|
||||
select.EPOLLIN # 1 可读
|
||||
select.EPOLLPRI # 2 紧急数据可读
|
||||
select.EPOLLOUT # 4 可写
|
||||
select.EPOLLERR # 8 错误
|
||||
select.EPOLLHUP # 16 挂起
|
||||
select.EPOLLRDNORM # 64 普通数据可读
|
||||
select.EPOLLRDBAND # 128 优先带数据可读
|
||||
select.EPOLLWRNORM # 256 普通数据可写
|
||||
select.EPOLLWRBAND # 512 优先带数据可写
|
||||
select.EPOLLMSG # 1024
|
||||
select.EPOLLRDHUP # 8192 对端关闭连接或半关闭
|
||||
select.EPOLLEXCLUSIVE # 1<<28 独占唤醒
|
||||
select.EPOLLWAKEUP # 1<<29
|
||||
select.EPOLLONESHOT # 1<<30 一次性事件
|
||||
select.EPOLLET # 1<<31 边缘触发模式
|
||||
```
|
||||
|
||||
### 示例代码
|
||||
```python
|
||||
import select
|
||||
import socket
|
||||
|
||||
# 创建 epoll 对象
|
||||
epoller = select.epoll()
|
||||
|
||||
# 创建服务器socket
|
||||
server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
|
||||
server.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
|
||||
server.bind(('0.0.0.0', 8888))
|
||||
server.listen(128)
|
||||
server.setblocking(False)
|
||||
|
||||
# 注册服务器socket,监听可读事件
|
||||
epoller.register(server.fileno(), select.EPOLLIN)
|
||||
|
||||
# 文件描述符到socket的映射
|
||||
fd_to_socket = {server.fileno(): server}
|
||||
|
||||
try:
|
||||
while True:
|
||||
# 等待事件,超时1秒
|
||||
events = epoller.poll(1)
|
||||
|
||||
if not events:
|
||||
continue # 超时,继续等待
|
||||
|
||||
for fd, event in events:
|
||||
sock = fd_to_socket[fd]
|
||||
|
||||
# 服务器socket可读,表示有新连接
|
||||
if sock is server:
|
||||
client, addr = server.accept()
|
||||
client.setblocking(False)
|
||||
epoller.register(client.fileno(),
|
||||
select.EPOLLIN | select.EPOLLET) # 边缘触发
|
||||
fd_to_socket[client.fileno()] = client
|
||||
print(f"New connection: {addr}")
|
||||
|
||||
# 可读事件
|
||||
elif event & select.EPOLLIN:
|
||||
data = sock.recv(1024)
|
||||
if data:
|
||||
print(f"Received: {data}")
|
||||
# 修改为监听可写事件
|
||||
epoller.modify(fd, select.EPOLLOUT)
|
||||
else:
|
||||
# 连接关闭
|
||||
epoller.unregister(fd)
|
||||
sock.close()
|
||||
del fd_to_socket[fd]
|
||||
|
||||
# 可写事件
|
||||
elif event & select.EPOLLOUT:
|
||||
sock.send(b"HTTP/1.1 200 OK\r\n\r\nHello")
|
||||
# 发送完后继续监听可读事件
|
||||
epoller.modify(fd, select.EPOLLIN)
|
||||
|
||||
# 错误事件
|
||||
elif event & select.EPOLLERR:
|
||||
epoller.unregister(fd)
|
||||
sock.close()
|
||||
del fd_to_socket[fd]
|
||||
|
||||
finally:
|
||||
epoller.unregister(server.fileno())
|
||||
epoller.close()
|
||||
server.close()
|
||||
```
|
||||
|
||||
## 三、poll 模式相关函数
|
||||
|
||||
### 核心类和方法
|
||||
```python
|
||||
import select
|
||||
|
||||
# 1. 创建 poll 对象
|
||||
poller = select.poll()
|
||||
|
||||
# 2. poll 对象的方法
|
||||
poller.register(fd[, eventmask])
|
||||
# eventmask 可以是以下组合:
|
||||
# select.POLLIN - 可读
|
||||
# select.POLLPRI - 紧急数据可读
|
||||
# select.POLLOUT - 可写
|
||||
# select.POLLERR - 错误
|
||||
# select.POLLHUP - 挂起
|
||||
# select.POLLNVAL - 无效请求
|
||||
|
||||
poller.unregister(fd) # 注销文件描述符
|
||||
poller.modify(fd, eventmask) # 修改事件掩码
|
||||
|
||||
poller.poll([timeout])
|
||||
# 返回 [(fd, events), ...] 列表
|
||||
# timeout: 超时毫秒数,None表示阻塞,0表示立即返回,负值也表示阻塞
|
||||
```
|
||||
|
||||
### poll 常量
|
||||
```python
|
||||
select.POLLIN # 1 可读
|
||||
select.POLLPRI # 2 紧急数据可读
|
||||
select.POLLOUT # 4 可写
|
||||
select.POLLERR # 8 错误
|
||||
select.POLLHUP # 16 挂起
|
||||
select.POLLNVAL # 32 无效请求
|
||||
```
|
||||
|
||||
### 示例代码
|
||||
```python
|
||||
import select
|
||||
import socket
|
||||
|
||||
# 创建 poll 对象
|
||||
poller = select.poll()
|
||||
|
||||
# 创建服务器socket
|
||||
server = socket.socket()
|
||||
server.bind(('localhost', 8888))
|
||||
server.listen(5)
|
||||
|
||||
# 注册服务器socket
|
||||
poller.register(server, select.POLLIN)
|
||||
|
||||
# socket到事件掩码的映射(用于跟踪)
|
||||
socket_to_mask = {server: select.POLLIN}
|
||||
|
||||
try:
|
||||
while True:
|
||||
# 等待事件,超时1000毫秒
|
||||
events = poller.poll(1000)
|
||||
|
||||
for fd_event in events:
|
||||
sock = fd_event[0]
|
||||
event = fd_event[1]
|
||||
|
||||
# 新连接
|
||||
if sock is server:
|
||||
if event & select.POLLIN:
|
||||
client, addr = server.accept()
|
||||
poller.register(client, select.POLLIN)
|
||||
socket_to_mask[client] = select.POLLIN
|
||||
|
||||
# 可读事件
|
||||
elif event & select.POLLIN:
|
||||
data = sock.recv(1024)
|
||||
if data:
|
||||
print(f"Received: {data}")
|
||||
# 修改为监听可写事件
|
||||
poller.modify(sock, select.POLLOUT)
|
||||
socket_to_mask[sock] = select.POLLOUT
|
||||
else:
|
||||
# 连接关闭
|
||||
poller.unregister(sock)
|
||||
sock.close()
|
||||
del socket_to_mask[sock]
|
||||
|
||||
# 可写事件
|
||||
elif event & select.POLLOUT:
|
||||
sock.send(b"Response")
|
||||
# 改回监听可读事件
|
||||
poller.modify(sock, select.POLLIN)
|
||||
socket_to_mask[sock] = select.POLLIN
|
||||
|
||||
finally:
|
||||
poller.unregister(server)
|
||||
server.close()
|
||||
```
|
||||
|
||||
## 四、选择指南
|
||||
|
||||
| 特性 | select | poll | epoll |
|
||||
|------|--------|------|-------|
|
||||
| **跨平台** | ✓ 所有平台 | ✗ 仅Unix | ✗ 仅Linux |
|
||||
| **最大描述符数** | 通常1024 | 无限制 | 无限制 |
|
||||
| **效率** | O(n) 每次遍历 | O(n) 每次遍历 | O(1) 事件通知 |
|
||||
| **触发模式** | 水平触发 | 水平触发 | 水平/边缘触发 |
|
||||
| **内存使用** | 固定大小位图 | 动态数组 | 红黑树+就绪链表 |
|
||||
|
||||
### 性能对比代码示例
|
||||
```python
|
||||
import select
|
||||
import time
|
||||
|
||||
def benchmark(io_method='select', num_fds=100):
|
||||
"""测试不同I/O多路复用方法的性能"""
|
||||
|
||||
if io_method == 'select':
|
||||
# select 测试
|
||||
rlist = list(range(num_fds))
|
||||
start = time.perf_counter()
|
||||
for _ in range(1000):
|
||||
select.select([], rlist, [], 0.001)
|
||||
return time.perf_counter() - start
|
||||
|
||||
elif io_method == 'poll':
|
||||
# poll 测试
|
||||
poller = select.poll()
|
||||
start = time.perf_counter()
|
||||
for _ in range(1000):
|
||||
poller.poll(1) # 1ms timeout
|
||||
return time.perf_counter() - start
|
||||
```
|
||||
|
||||
### 通用封装示例
|
||||
```python
|
||||
import select
|
||||
import sys
|
||||
|
||||
class Multiplexer:
|
||||
"""多路复用器的通用封装"""
|
||||
|
||||
def __init__(self, backend='auto'):
|
||||
if backend == 'auto':
|
||||
if hasattr(select, 'epoll'):
|
||||
self.backend = 'epoll'
|
||||
self._impl = select.epoll()
|
||||
elif hasattr(select, 'poll'):
|
||||
self.backend = 'poll'
|
||||
self._impl = select.poll()
|
||||
else:
|
||||
self.backend = 'select'
|
||||
self._impl = None
|
||||
else:
|
||||
self.backend = backend
|
||||
if backend == 'epoll':
|
||||
self._impl = select.epoll()
|
||||
elif backend == 'poll':
|
||||
self._impl = select.poll()
|
||||
else:
|
||||
self._impl = None
|
||||
|
||||
def register(self, sock, events):
|
||||
"""注册socket"""
|
||||
if self.backend == 'select':
|
||||
# select需要手动管理列表
|
||||
pass
|
||||
elif self.backend == 'poll':
|
||||
self._impl.register(sock, events)
|
||||
elif self.backend == 'epoll':
|
||||
self._impl.register(sock.fileno(), events)
|
||||
```
|
||||
|
||||
## 五、注意事项
|
||||
|
||||
1. **平台兼容性**:
|
||||
- Windows只支持select
|
||||
- macOS/BSD支持select和kqueue(通过select.kqueue)
|
||||
- Linux支持所有三种
|
||||
|
||||
2. **边缘触发(ET) vs 水平触发(LT)**:
|
||||
- epoll支持两种模式
|
||||
- ET模式需要一次读取所有数据
|
||||
- LT模式是默认的,select和poll只支持LT
|
||||
|
||||
3. **文件描述符限制**:
|
||||
```python
|
||||
import resource
|
||||
|
||||
# 查看和设置文件描述符限制
|
||||
soft, hard = resource.getrlimit(resource.RLIMIT_NOFILE)
|
||||
resource.setrlimit(resource.RLIMIT_NOFILE, (hard, hard))
|
||||
```
|
||||
|
||||
选择建议:
|
||||
- 小规模连接(<1000):使用select或poll
|
||||
- Linux高并发:使用epoll边缘触发
|
||||
- 跨平台需求:使用select或第三方库(如asyncio)
|
||||
@@ -0,0 +1,8 @@
|
||||
|
||||
|
||||
[获取屏幕大小](aardio+1cf54f33-16b4-4fe3-8338-9de8c7613f37/%E8%8E%B7%E5%8F%96%E5%B1%8F%E5%B9%95%E5%A4%A7%E5%B0%8F%20da0c23fd-d5f1-49b1-b7f0-525603a6b853.md)
|
||||
|
||||
[获取程序自身路径](aardio+1cf54f33-16b4-4fe3-8338-9de8c7613f37/%E8%8E%B7%E5%8F%96%E7%A8%8B%E5%BA%8F%E8%87%AA%E8%BA%AB%E8%B7%AF%E5%BE%84%20cf59b227-c5e1-4429-b191-57311fcf1baa.md)
|
||||
|
||||
[aardio 常用语句整合](aardio+1cf54f33-16b4-4fe3-8338-9de8c7613f37/aardio+%E5%B8%B8%E7%94%A8%E8%AF%AD%E5%8F%A5%E6%95%B4%E5%90%88%20f6cfd42e-9468-4119-a289-d86331e1eac1.md)
|
||||
|
||||
@@ -0,0 +1,95 @@
|
||||
## 系统基本操作
|
||||
|
||||
整合一些常用系统基本操作:[环境变量](https://so.csdn.net/so/search?q=%E7%8E%AF%E5%A2%83%E5%8F%98%E9%87%8F&spm=1001.2101.3001.7020),剪贴板,系统音量设置,播放声音文件,系统关机,重启等操作
|
||||
|
||||
```Java
|
||||
import win
|
||||
|
||||
//环境变量操作
|
||||
var $sEnv = win.getenv("TEMP") //获取环境变量TEMP值
|
||||
win.msgbox($sEnv)
|
||||
|
||||
win.setenv("MYVAR","这是一些文本!") //设置环境变量MYVAR的值
|
||||
win.msgbox(win.getenv("MYVAR"))
|
||||
|
||||
//剪贴板操作
|
||||
import win.clip
|
||||
|
||||
var $sData = win.clip.read() //读取剪贴板文本
|
||||
win.msgbox($sData)
|
||||
|
||||
win.clip.write("一个新写符串写入到剪贴板") //写入新文本
|
||||
win.msgbox(win.clip.read())
|
||||
//播放本地声音文件,.wav或.mp3文件等
|
||||
import fsys.media
|
||||
//播放声音文件,0同步播放,等待直到声音完成才执行下一句代码
|
||||
fsys.media.playSound("C:\Windows\Media\tada.wav",0) //默认第二参数是异步
|
||||
win.msgbox("同步播放会等待完成后运行msgbox")
|
||||
|
||||
//重复播放,第二个参数指定重复播放次数
|
||||
fsys.media.playRepeat("C:\Windows\Media\tada.wav",3)
|
||||
win.msgbox("异步播放不会等待,会立刻运行msgbox")
|
||||
|
||||
|
||||
//系统音量控制
|
||||
import sys.audioVolume
|
||||
var $audio = sys.audioVolume()
|
||||
//设置系统音量为0,静音
|
||||
$audio.volume=0
|
||||
win.msgbox($audio.volume,"当前音量值")
|
||||
|
||||
//设置系统音量为100,最大音量
|
||||
$audio.volume=100
|
||||
win.msgbox($audio.volume,"当前音量值")
|
||||
|
||||
//以下系统命令慎用,代码注释掉,测试可取消注释
|
||||
import sys
|
||||
// sys.shutdown() 关机
|
||||
// sys.sleep() 休眠
|
||||
// sys.lock() 锁定
|
||||
// sys.restart() 重启
|
||||
```
|
||||
|
||||
通常在与用户交互的时,我们会弹出一些对话框。除了msgbox之外整合一些常用的弹出窗口。inputbox,托盘提示,信息框。
|
||||
|
||||
```Java
|
||||
//弹出输入框
|
||||
import win.inputBox
|
||||
//返回输入框对象
|
||||
var $input = win.inputBox()
|
||||
$input.text = "你好"
|
||||
$input.info.text ="请输入你的名字:"
|
||||
$input.input.text = "输入框默认文本设置"
|
||||
|
||||
//初始化窗口设置选区
|
||||
$input.onInitDialog = function(hwnd,message,wParam,lParam){
|
||||
$input.center() //居中显示
|
||||
$input.input.selectAll() //输入框文本全选
|
||||
}
|
||||
|
||||
var $value = $input.doModal() //点取消返回null
|
||||
if ($value) {
|
||||
win.msgbox($value)
|
||||
}
|
||||
|
||||
|
||||
//弹出托盘提示
|
||||
import win.util.tray
|
||||
$tray = win.util.tray($input) //参数1为窗口对象不能忽略
|
||||
$tray.pop("我是托盘提示","你好")
|
||||
$tray.delete()
|
||||
|
||||
//弹出一个信息框
|
||||
import win.dlg.message
|
||||
//参数二为true则显示确定,取消按钮
|
||||
win.dlg.message($input).doModal("我是一个弹出信息框")
|
||||
|
||||
```
|
||||
|
||||
|
||||
|
||||
[获取屏幕大小](aardio+1cf54f33-16b4-4fe3-8338-9de8c7613f37/%E8%8E%B7%E5%8F%96%E5%B1%8F%E5%B9%95%E5%A4%A7%E5%B0%8F%20da0c23fd-d5f1-49b1-b7f0-525603a6b853.md)
|
||||
|
||||
[获取程序自身路径](aardio+1cf54f33-16b4-4fe3-8338-9de8c7613f37/%E8%8E%B7%E5%8F%96%E7%A8%8B%E5%BA%8F%E8%87%AA%E8%BA%AB%E8%B7%AF%E5%BE%84%20cf59b227-c5e1-4429-b191-57311fcf1baa.md)
|
||||
|
||||
[aardio 常用语句整合](aardio+1cf54f33-16b4-4fe3-8338-9de8c7613f37/aardio+%E5%B8%B8%E7%94%A8%E8%AF%AD%E5%8F%A5%E6%95%B4%E5%90%88%20f6cfd42e-9468-4119-a289-d86331e1eac1.md)
|
||||
@@ -0,0 +1,88 @@
|
||||
## 系统基本操作
|
||||
|
||||
整合一些常用系统基本操作:[环境变量](https://so.csdn.net/so/search?q=%E7%8E%AF%E5%A2%83%E5%8F%98%E9%87%8F&spm=1001.2101.3001.7020),剪贴板,系统音量设置,播放声音文件,系统关机,重启等操作
|
||||
|
||||
```Java
|
||||
import win
|
||||
|
||||
//环境变量操作
|
||||
var $sEnv = win.getenv("TEMP") //获取环境变量TEMP值
|
||||
win.msgbox($sEnv)
|
||||
|
||||
win.setenv("MYVAR","这是一些文本!") //设置环境变量MYVAR的值
|
||||
win.msgbox(win.getenv("MYVAR"))
|
||||
|
||||
//剪贴板操作
|
||||
import win.clip
|
||||
|
||||
var $sData = win.clip.read() //读取剪贴板文本
|
||||
win.msgbox($sData)
|
||||
|
||||
win.clip.write("一个新写符串写入到剪贴板") //写入新文本
|
||||
win.msgbox(win.clip.read())
|
||||
//播放本地声音文件,.wav或.mp3文件等
|
||||
import fsys.media
|
||||
//播放声音文件,0同步播放,等待直到声音完成才执行下一句代码
|
||||
fsys.media.playSound("C:\Windows\Media\tada.wav",0) //默认第二参数是异步
|
||||
win.msgbox("同步播放会等待完成后运行msgbox")
|
||||
|
||||
//重复播放,第二个参数指定重复播放次数
|
||||
fsys.media.playRepeat("C:\Windows\Media\tada.wav",3)
|
||||
win.msgbox("异步播放不会等待,会立刻运行msgbox")
|
||||
|
||||
|
||||
//系统音量控制
|
||||
import sys.audioVolume
|
||||
var $audio = sys.audioVolume()
|
||||
//设置系统音量为0,静音
|
||||
$audio.volume=0
|
||||
win.msgbox($audio.volume,"当前音量值")
|
||||
|
||||
//设置系统音量为100,最大音量
|
||||
$audio.volume=100
|
||||
win.msgbox($audio.volume,"当前音量值")
|
||||
|
||||
//以下系统命令慎用,代码注释掉,测试可取消注释
|
||||
import sys
|
||||
// sys.shutdown() 关机
|
||||
// sys.sleep() 休眠
|
||||
// sys.lock() 锁定
|
||||
// sys.restart() 重启
|
||||
```
|
||||
|
||||
通常在与用户交互的时,我们会弹出一些对话框。除了msgbox之外整合一些常用的弹出窗口。inputbox,托盘提示,信息框。
|
||||
|
||||
```Java
|
||||
//弹出输入框
|
||||
import win.inputBox
|
||||
//返回输入框对象
|
||||
var $input = win.inputBox()
|
||||
$input.text = "你好"
|
||||
$input.info.text ="请输入你的名字:"
|
||||
$input.input.text = "输入框默认文本设置"
|
||||
|
||||
//初始化窗口设置选区
|
||||
$input.onInitDialog = function(hwnd,message,wParam,lParam){
|
||||
$input.center() //居中显示
|
||||
$input.input.selectAll() //输入框文本全选
|
||||
}
|
||||
|
||||
var $value = $input.doModal() //点取消返回null
|
||||
if ($value) {
|
||||
win.msgbox($value)
|
||||
}
|
||||
|
||||
|
||||
//弹出托盘提示
|
||||
import win.util.tray
|
||||
$tray = win.util.tray($input) //参数1为窗口对象不能忽略
|
||||
$tray.pop("我是托盘提示","你好")
|
||||
$tray.delete()
|
||||
|
||||
//弹出一个信息框
|
||||
import win.dlg.message
|
||||
//参数二为true则显示确定,取消按钮
|
||||
win.dlg.message($input).doModal("我是一个弹出信息框")
|
||||
|
||||
```
|
||||
|
||||
@@ -0,0 +1,3 @@
|
||||
win.setPos(hwnd, 0, 0)
|
||||
win.getScreen()
|
||||
|
||||
@@ -0,0 +1,2 @@
|
||||
io._exepath
|
||||
|
||||
@@ -0,0 +1,20 @@
|
||||
[Maven 使用maven-assembly-plugin打包可执行jar,No auto configuration classes found in META-INF/spring.factori](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/Maven+%E4%BD%BF%E7%94%A8maven-assembly-plugin%E6%89%93%E5%8C%85%E5%8F%AF%E6%89%A7%E8%A1%8Cjar%EF%BC%8CNo+auto+configuration+classes+found+in+META-INF+spring.factori%2077ad44f2-5c03-4b2f-b594-d02a92d5c447.md)
|
||||
|
||||
[Enum 与 int 互转](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/Enum+%E4%B8%8E+int+%E4%BA%92%E8%BD%AC%20d3067cb7-19fe-4b28-917c-dc27f7b54923.md)
|
||||
|
||||
[JunitPerf](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/JunitPerf%206171e04e-5f16-4199-9736-82c869589c5e.md)
|
||||
|
||||
[Java中ArrayList、Integer[]和int[]的相互转换](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/Java%E4%B8%ADArrayList%E3%80%81Integer%5B%5D%E5%92%8Cint%5B%5D%E7%9A%84%E7%9B%B8%E4%BA%92%E8%BD%AC%E6%8D%A2%2042a39c68-1566-4a76-bfa8-bfa279d36a9c.md)
|
||||
|
||||
[关于@GetMapping与@PostMapping与@RequestHeader](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/%E5%85%B3%E4%BA%8E@GetMapping%E4%B8%8E@PostMapping%E4%B8%8E@RequestHeader%20fc05da31-1a6d-444c-ab7b-98ffe56e9b11.md)
|
||||
|
||||
[SpringBoot 如何统一后端返回格式](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/SpringBoot+%E5%A6%82%E4%BD%95%E7%BB%9F%E4%B8%80%E5%90%8E%E7%AB%AF%E8%BF%94%E5%9B%9E%E6%A0%BC%E5%BC%8F%2097c8a167-9787-418c-9259-ff8fa3a39a6d.md)
|
||||
|
||||
[springboot启动时候自动创建数据库表解决方案](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/springboot%E5%90%AF%E5%8A%A8%E6%97%B6%E5%80%99%E8%87%AA%E5%8A%A8%E5%88%9B%E5%BB%BA%E6%95%B0%E6%8D%AE%E5%BA%93%E8%A1%A8%E8%A7%A3%E5%86%B3%E6%96%B9%E6%A1%88%20c0e900b0-325d-4df2-85e5-1108ff0cb9d3.md)
|
||||
|
||||
[手动调整slf4j的日志等级](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/%E6%89%8B%E5%8A%A8%E8%B0%83%E6%95%B4slf4j%E7%9A%84%E6%97%A5%E5%BF%97%E7%AD%89%E7%BA%A7%20ff0758bc-7da0-4f75-872f-dc6630048a95.md)
|
||||
|
||||
[maven](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/maven%20115c1360-b0fc-4003-8d60-177812857f31.md)
|
||||
|
||||
[lombok常用注解](java+0ce5e104-3e6a-49e6-b02a-ca0867bd96ac/lombok%E5%B8%B8%E7%94%A8%E6%B3%A8%E8%A7%A3%2065e85a26-7c15-48ca-bf93-551479e7b9a2.md)
|
||||
|
||||
@@ -0,0 +1,636 @@
|
||||
---
|
||||
page-title: "47个经典Spring面试题详解(附带答案)"
|
||||
url: https://mp.weixin.qq.com/s?__biz=MzU5OTc3NDM2Mw==&mid=2247483928&idx=1&sn=a7dd0674a661402975f7d13a2c3f2095&chksm=feae87ecc9d90efa3a8b642314c9b40ce136201fdfe55534d70e0fc984f3eff861774fa9cb17&scene=27
|
||||
web-message:
|
||||
web-badge-color: ""
|
||||
web-badge-message:
|
||||
date: "2024-03-18 15:55:59"
|
||||
---
|
||||
> **这篇文章主要分享了47个Spring经典面试题,现在分享给大家,也给大家做个参考。正好现在金三银四,希望对大家有所帮助,有用的话点赞支持!**
|
||||
>
|
||||
> **1\. 不同版本的 Spring Framework 有哪些主要功能?**
|
||||
>
|
||||
> **Version**
|
||||
>
|
||||
> **Feature**
|
||||
>
|
||||
> Spring2.5
|
||||
>
|
||||
> 发布于2007年。这是第一-个支持注解的版本。
|
||||
>
|
||||
> Spring3.0
|
||||
>
|
||||
> 发布于2009年。它完全利用了Java5中的改进,并为JEE6提供了支持。
|
||||
>
|
||||
> Spring4.0
|
||||
>
|
||||
> 发布于2013年。这是第一个完全支持JAVA8的版本。
|
||||
>
|
||||
> spring5.0
|
||||
>
|
||||
> 发布于2017年。使用JDK 8特性,支持响应式编程,函数式Web框架,对Kotlin支持。
|
||||
>
|
||||
> **2\. 什么是 Spring Framework?**
|
||||
>
|
||||
> - Spring 是一个开源应用框架,旨在降低应用程序开发的复杂度。
|
||||
>
|
||||
> - 它是轻量级、松散耦合的。
|
||||
>
|
||||
> - 它具有分层体系结构,允许用户选择组件,同时还为 J2EE 应用程序开发提供了一个有凝聚力的框架。
|
||||
>
|
||||
> - 它可以集成其他框架,如 Structs、Hibernate、EJB 等,所以又称为框架的框架。
|
||||
>
|
||||
>
|
||||
> **3. 列举 Spring Framework 的优点。**
|
||||
>
|
||||
> - 由于 Spring Frameworks 的分层架构,用户可以自由选择自己需要的组件。
|
||||
>
|
||||
> - Spring Framework 支持 POJO(Plain Old Java Object) 编程,从而具备持续集成和可测试性。
|
||||
>
|
||||
> - 由于依赖注入和控制反转,JDBC 得以简化。
|
||||
>
|
||||
> - 它是开源免费的。
|
||||
>
|
||||
>
|
||||
> **4\. Spring Framework 有哪些不同的功能?**
|
||||
>
|
||||
> - 轻量级 - Spring 在代码量和透明度方面都很轻便。
|
||||
>
|
||||
> - IOC - 控制反转
|
||||
>
|
||||
> - AOP - 面向切面编程可以将应用业务逻辑和系统服务分离,以实现高内聚。
|
||||
>
|
||||
> - 容器 - Spring 负责创建和管理对象(Bean)的生命周期和配置。
|
||||
>
|
||||
> - MVC - 对 web 应用提供了高度可配置性,其他框架的集成也十分方便。
|
||||
>
|
||||
> - 事务管理 - 提供了用于事务管理的通用抽象层。Spring 的事务支持也可用于容器较少的环境。
|
||||
>
|
||||
> - JDBC 异常 - Spring 的 JDBC 抽象层提供了一个异常层次结构,简化了错误处理策略。
|
||||
>
|
||||
>
|
||||
> **5\. Spring Framework 中有多少个模块,它们分别是什么?**
|
||||
>
|
||||
> 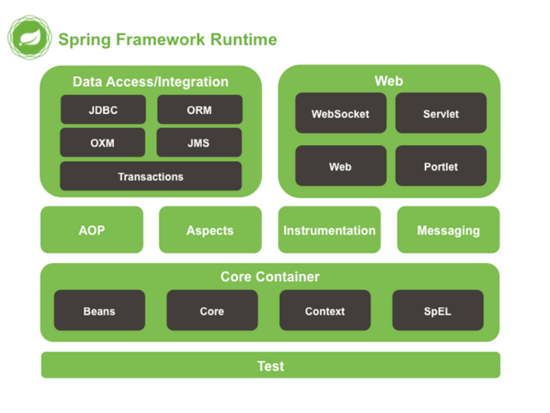
|
||||
>
|
||||
> Spring 核心容器 – 该层基本上是 Spring Framework 的核心。它包含以下模块:
|
||||
>
|
||||
> - Spring Core
|
||||
>
|
||||
> - Spring Bean
|
||||
>
|
||||
> - SpEL (Spring Expression Language)
|
||||
>
|
||||
> - Spring Context
|
||||
>
|
||||
>
|
||||
> 数据访问/集成 – 该层提供与数据库交互的支持。它包含以下模块:
|
||||
>
|
||||
> - JDBC (Java DataBase Connectivity)
|
||||
>
|
||||
> - ORM (Object Relational Mapping)
|
||||
>
|
||||
> - OXM (Object XML Mappers)
|
||||
>
|
||||
> - JMS (Java Messaging Service)
|
||||
>
|
||||
> - Transaction
|
||||
>
|
||||
>
|
||||
> Web – 该层提供了创建 Web 应用程序的支持。它包含以下模块:AOP – 该层支持面向切面编程
|
||||
>
|
||||
> - Web
|
||||
>
|
||||
> - Web – Servlet
|
||||
>
|
||||
> - Web – Socket
|
||||
>
|
||||
> - Web – Portlet
|
||||
>
|
||||
>
|
||||
> Instrumentation – 该层为类检测和类加载器实现提供支持。
|
||||
>
|
||||
> Test – 该层为使用 JUnit 和 TestNG 进行测试提供支持。
|
||||
>
|
||||
> 几个杂项模块:
|
||||
>
|
||||
> - Messaging – 该模块为 STOMP 提供支持。它还支持注解编程模型,该模型用于从 WebSocket 客户端路由和处理 STOMP 消息。
|
||||
>
|
||||
> - Aspects – 该模块为与 AspectJ 的集成提供支持。
|
||||
>
|
||||
>
|
||||
> **6. 什么是 Spring 配置文件?**
|
||||
>
|
||||
> Spring 配置文件是 XML 文件。该文件主要包含类信息。它描述了这些类是如何配置以及相互引入的。但是,XML 配置文件冗长且更加干净。如果没有正确规划和编写,那么在大项目中管理变得非常困难。
|
||||
>
|
||||
> **7\. Spring 应用程序有哪些不同组件?**
|
||||
>
|
||||
> Spring 应用一般有以下组件:
|
||||
>
|
||||
> - 接口 - 定义功能。
|
||||
>
|
||||
> - Bean 类 - 它包含属性,setter 和 getter 方法,函数等。
|
||||
>
|
||||
> - Spring 面向切面编程(AOP) - 提供面向切面编程的功能。
|
||||
>
|
||||
> - Bean 配置文件 - 包含类的信息以及如何配置它们。
|
||||
>
|
||||
> - 用户程序 - 它使用接口。
|
||||
>
|
||||
>
|
||||
> **8\. 使用 Spring 有哪些方式?**
|
||||
>
|
||||
> 使用 Spring 有以下方式:
|
||||
>
|
||||
> - 作为作为一个成熟的 Spring Web 应用程序。
|
||||
>
|
||||
> - 作为第三方 Web 框架,使用 Spring Frameworks 中间层。
|
||||
>
|
||||
> - 用于远程使用。
|
||||
>
|
||||
> - 作为企业级 Java Bean,它可以包装现有的 POJO(Plain Old Java Objects)。Bean,它可以包装现有的 POJO(Plain Old Java Objects)。
|
||||
>
|
||||
>
|
||||
> **9. 什么是 Spring IOC 容器?**
|
||||
>
|
||||
> Spring 框架的核心是 Spring 容器。容器创建对象,将它们装配在一起,配置它们并管理它们的完整生命周期。Spring 容器使用依赖注入来管理组成应用程序的组件。容器通过读取提供的配置元数据来接收对象进行实例化,配置和组装的指令。该元数据可以通过 XML,Java 注解或 Java 代码提供。
|
||||
>
|
||||
> 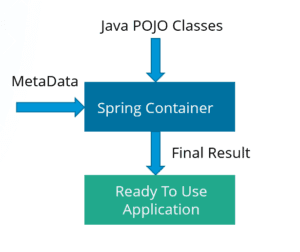
|
||||
>
|
||||
> **10\. 什么是依赖注入?**
|
||||
>
|
||||
> 在依赖注入中,您不必创建对象,但必须描述如何创建它们。您不是直接在代码中将组件和服务连接在一起,而是描述配置文件中哪些组件需要哪些服务。由 IoC 容器将它们装配在一起。
|
||||
>
|
||||
> **11\. 可以通过多少种方式完成依赖注入?**
|
||||
>
|
||||
> 通常,依赖注入可以通过三种方式完成,即:
|
||||
>
|
||||
> - 构造函数注入
|
||||
>
|
||||
> - setter 注入
|
||||
>
|
||||
> - 接口注入
|
||||
>
|
||||
>
|
||||
> 在 Spring Framework 中,仅使用构造函数和 setter 注入。
|
||||
>
|
||||
> **12\. 区分构造函数注入和 setter 注入**
|
||||
>
|
||||
> **构造函数注入**
|
||||
>
|
||||
> **setter注入**
|
||||
>
|
||||
> 没有部分注入
|
||||
>
|
||||
> 有部分注入
|
||||
>
|
||||
> 不会覆盖setter属性
|
||||
>
|
||||
> 会覆盖setter属性
|
||||
>
|
||||
> 任意修改都会创建一个新实例
|
||||
>
|
||||
> 任意修改不会创建一个新实例
|
||||
>
|
||||
> 适用于设置很多属性
|
||||
>
|
||||
> 适用于设置少量属性
|
||||
>
|
||||
> **13\. spring 中有多少种 IOC 容器?**
|
||||
>
|
||||
> BeanFactory - BeanFactory 就像一个包含 bean 集合的工厂类。它会在客户端要求时实例化 bean。
|
||||
>
|
||||
> ApplicationContext - ApplicationContext 接口扩展了 BeanFactory 接口。它在 BeanFactory 基础上提供了一些额外的功能。
|
||||
>
|
||||
> **14\. 区分 BeanFactory 和 ApplicationContext。**
|
||||
>
|
||||
> **BeanFactory**
|
||||
>
|
||||
> **ApplicationContext**
|
||||
>
|
||||
> 它使用懒加载
|
||||
>
|
||||
> 它使用即时加载
|
||||
>
|
||||
> 它使用语法显式提供资源对象
|
||||
>
|
||||
> 它自己创建和管理资源对象
|
||||
>
|
||||
> 不支持国际化
|
||||
>
|
||||
> 支持国际化
|
||||
>
|
||||
> 不支持基于依赖的注解
|
||||
>
|
||||
> 支持基于依赖的注解
|
||||
>
|
||||
> **15\. 列举 IoC 的一些好处。**
|
||||
>
|
||||
> IoC 的一些好处是:
|
||||
>
|
||||
> - 它将最小化应用程序中的代码量。
|
||||
>
|
||||
> - 它将使您的应用程序易于测试,因为它不需要单元测试用例中的任何单例或 JNDI 查找机制。
|
||||
>
|
||||
> - 它以最小的影响和最少的侵入机制促进松耦合。
|
||||
>
|
||||
> - 它支持即时的实例化和延迟加载服务。
|
||||
>
|
||||
>
|
||||
> **16\. Spring IoC 的实现机制。**
|
||||
>
|
||||
> Spring 中的 IoC 的实现原理就是工厂模式加反射机制。
|
||||
>
|
||||
> 示例:
|
||||
>
|
||||
> ```
|
||||
> interface Fruit {
|
||||
> ```
|
||||
>
|
||||
> **17\. 什么是 spring bean?**
|
||||
>
|
||||
> - 它们是构成用户应用程序主干的对象。
|
||||
>
|
||||
> - Bean 由 Spring IoC 容器管理。
|
||||
>
|
||||
> - 它们由 Spring IoC 容器实例化,配置,装配和管理。
|
||||
>
|
||||
> - Bean 是基于用户提供给容器的配置元数据创建。
|
||||
>
|
||||
>
|
||||
> **18\. spring 提供了哪些配置方式?**
|
||||
>
|
||||
> 基于 xml 配置
|
||||
>
|
||||
> bean 所需的依赖项和服务在 XML 格式的配置文件中指定。这些配置文件通常包含许多 bean 定义和特定于应用程序的配置选项。它们通常以 bean 标签开头。例如:
|
||||
>
|
||||
> ```
|
||||
> <bean id="studentbean" class="org.edureka.firstSpring.StudentBean">
|
||||
> ```
|
||||
>
|
||||
> 基于注解配置
|
||||
>
|
||||
> 您可以通过在相关的类,方法或字段声明上使用注解,将 bean 配置为组件类本身,而不是使用 XML 来描述 bean 装配。默认情况下,Spring 容器中未打开注解装配。因此,您需要在使用它之前在 Spring 配置文件中启用它。例如:
|
||||
>
|
||||
> ```
|
||||
> <beans>
|
||||
> ```
|
||||
>
|
||||
> 基于 Java API 配置
|
||||
>
|
||||
> Spring 的 Java 配置是通过使用@Bean 和 @Configuration 来实现。
|
||||
>
|
||||
> - @Bean 注解扮演与 <bean /> 元素相同的角色。
|
||||
>
|
||||
> - @Configuration 类允许通过简单地调用同一个类中的其他@Bean 方法来定义 bean 间依赖关系。
|
||||
>
|
||||
>
|
||||
> 例如:
|
||||
>
|
||||
> ```
|
||||
> @Bean
|
||||
> ```
|
||||
>
|
||||
> **19\. spring 支持集中 bean scope?**
|
||||
>
|
||||
> Spring bean 支持 5 种 scope:
|
||||
>
|
||||
> - Singleton - 每个 Spring IoC 容器仅有一个单实例。
|
||||
>
|
||||
> - Prototype - 每次请求都会产生一个新的实例。
|
||||
>
|
||||
> - Request - 每一次 HTTP 请求都会产生一个新的实例,并且该 bean 仅在当前 HTTP 请求内有效。
|
||||
>
|
||||
> - Session - 每一次 HTTP 请求都会产生一个新的 bean,同时该 bean 仅在当前 HTTP session 内有效。
|
||||
>
|
||||
> - Global-session - 类似于标准的 HTTP Session 作用域,不过它仅仅在基于 portlet 的 web 应用中才有意义。Portlet 规范定义了全局 Session 的概念,它被所有构成某个 portlet web 应用的各种不同的 portlet 所共享。在 global session 作用域中定义的 bean 被限定于全局 portlet Session 的生命周期范围内。如果你在 web 中使用 global session 作用域来标识 bean,那么 web 会自动当成 session 类型来使用。
|
||||
>
|
||||
>
|
||||
> 仅当用户使用支持 Web 的 ApplicationContext 时,最后三个才可用。
|
||||
>
|
||||
> **20\. spring bean 容器的生命周期是什么样的?**
|
||||
>
|
||||
> spring bean 容器的生命周期流程如下:
|
||||
>
|
||||
> - Spring 容器根据配置中的 bean 定义中实例化 bean。
|
||||
>
|
||||
> - Spring 使用依赖注入填充所有属性,如 bean 中所定义的配置。
|
||||
>
|
||||
> - 如果 bean 实现 BeanNameAware 接口,则工厂通过传递 bean 的 ID 来调用 setBeanName()。
|
||||
>
|
||||
> - 如果 bean 实现 BeanFactoryAware 接口,工厂通过传递自身的实例来调用 setBeanFactory()。
|
||||
>
|
||||
> - 如果存在与 bean 关联的任何 BeanPostProcessors,则调用 preProcessBeforeInitialization() 方法。
|
||||
>
|
||||
> - 如果为 bean 指定了 init 方法( <bean> 的 init-method 属性),那么将调用它。
|
||||
>
|
||||
> - 最后,如果存在与 bean 关联的任何 BeanPostProcessors,则将调用 postProcessAfterInitialization() 方法。
|
||||
>
|
||||
> - 如果 bean 实现 DisposableBean 接口,当 spring 容器关闭时,会调用 destory()。
|
||||
>
|
||||
> - 如果为 bean 指定了 destroy 方法( <bean> 的 destroy-method 属性),那么将调用它。
|
||||
>
|
||||
>
|
||||
> 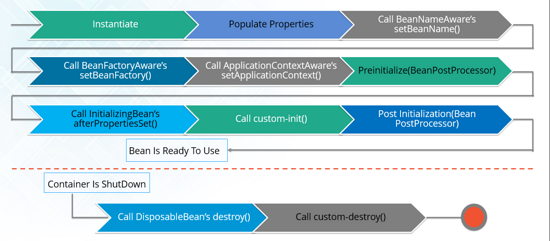
|
||||
>
|
||||
> **21\. 什么是 spring 的内部 bean?**
|
||||
>
|
||||
> 只有将 bean 用作另一个 bean 的属性时,才能将 bean 声明为内部 bean。为了定义 bean,Spring 的基于 XML 的配置元数据在 <property> 或 <constructor-arg> 中提供了 <bean> 元素的使用。内部 bean 总是匿名的,它们总是作为原型。
|
||||
>
|
||||
> 例如,假设我们有一个 Student 类,其中引用了 Person 类。这里我们将只创建一个 Person 类实例并在 Student 中使用它。
|
||||
>
|
||||
> Student.java
|
||||
>
|
||||
> ```
|
||||
> public class Student {
|
||||
> ```
|
||||
>
|
||||
> bean.xml
|
||||
>
|
||||
> ```
|
||||
> <bean id=“StudentBean" class="com.edureka.Student">
|
||||
> ```
|
||||
>
|
||||
> **22\. 什么是 spring 装配**
|
||||
>
|
||||
> 当 bean 在 Spring 容器中组合在一起时,它被称为装配或 bean 装配。 Spring 容器需要知道需要什么 bean 以及容器应该如何使用依赖注入来将 bean 绑定在一起,同时装配 bean。
|
||||
>
|
||||
> **23\. 自动装配有哪些方式?**
|
||||
>
|
||||
> Spring 容器能够自动装配 bean。也就是说,可以通过检查 BeanFactory 的内容让 Spring 自动解析 bean 的协作者。
|
||||
>
|
||||
> 自动装配的不同模式:
|
||||
>
|
||||
> - no - 这是默认设置,表示没有自动装配。应使用显式 bean 引用进行装配。
|
||||
>
|
||||
> - byName - 它根据 bean 的名称注入对象依赖项。它匹配并装配其属性与 XML 文件中由相同名称定义的 bean。
|
||||
>
|
||||
> - byType - 它根据类型注入对象依赖项。如果属性的类型与 XML 文件中的一个 bean 名称匹配,则匹配并装配属性。
|
||||
>
|
||||
> - 构造函数 - 它通过调用类的构造函数来注入依赖项。它有大量的参数。
|
||||
>
|
||||
> - autodetect - 首先容器尝试通过构造函数使用 autowire 装配,如果不能,则尝试通过 byType 自动装配。
|
||||
>
|
||||
>
|
||||
> **24\. 自动装配有什么局限?**
|
||||
>
|
||||
> - 覆盖的可能性 - 您始终可以使用 <constructor-arg> 和 <property> 设置指定依赖项,这将覆盖自动装配。
|
||||
>
|
||||
> - 基本元数据类型 - 简单属性(如原数据类型,字符串和类)无法自动装配。
|
||||
>
|
||||
> - 令人困惑的性质 - 总是喜欢使用明确的装配,因为自动装配不太精确。
|
||||
>
|
||||
>
|
||||
> **25. 你用过哪些重要的 Spring 注解?**
|
||||
>
|
||||
> - @Controller - 用于 Spring MVC 项目中的控制器类。
|
||||
>
|
||||
> - @Service - 用于服务类。
|
||||
>
|
||||
> - @RequestMapping - 用于在控制器处理程序方法中配置 URI 映射。
|
||||
>
|
||||
> - @ResponseBody - 用于发送 Object 作为响应,通常用于发送 XML 或 JSON 数据作为响应。
|
||||
>
|
||||
> - @PathVariable - 用于将动态值从 URI 映射到处理程序方法参数。
|
||||
>
|
||||
> - @Autowired - 用于在 spring bean 中自动装配依赖项。
|
||||
>
|
||||
> - @Qualifier - 使用 @Autowired 注解,以避免在存在多个 bean 类型实例时出现混淆。
|
||||
>
|
||||
> - @Scope - 用于配置 spring bean 的范围。
|
||||
>
|
||||
> - @Configuration,@ComponentScan 和 @Bean - 用于基于 java 的配置。
|
||||
>
|
||||
> - @Aspect,@Before,@After,@Around,@Pointcut - 用于切面编程(AOP)。
|
||||
>
|
||||
>
|
||||
> **26\. 如何在 spring 中启动注解装配?**
|
||||
>
|
||||
> 默认情况下,Spring 容器中未打开注解装配。因此,要使用基于注解装配,我们必须通过配置 <context:annotation-config /> 元素在 Spring 配置文件中启用它。
|
||||
>
|
||||
> **27\. @Component, @Controller, @Repository, @Service 有何区别?**
|
||||
>
|
||||
> - @Component:这将 java 类标记为 bean。它是任何 Spring 管理组件的通用构造型。spring 的组件扫描机制现在可以将其拾取并将其拉入应用程序环境中。
|
||||
>
|
||||
> - @Controller:这将一个类标记为 Spring Web MVC 控制器。标有它的 Bean 会自动导入到 IoC 容器中。
|
||||
>
|
||||
> - @Service:此注解是组件注解的特化。它不会对 @Component 注解提供任何其他行为。您可以在服务层类中使用 @Service 而不是 @Component,因为它以更好的方式指定了意图。
|
||||
>
|
||||
> - @Repository:这个注解是具有类似用途和功能的 @Component 注解的特化。它为 DAO 提供了额外的好处。它将 DAO 导入 IoC 容器,并使未经检查的异常有资格转换为 Spring DataAccessException。
|
||||
>
|
||||
>
|
||||
> **28. @Required 注解有什么用?**
|
||||
>
|
||||
> @Required 应用于 bean 属性 setter 方法。此注解仅指示必须在配置时使用 bean 定义中的显式属性值或使用自动装配填充受影响的 bean 属性。如果尚未填充受影响的 bean 属性,则容器将抛出 BeanInitializationException。
|
||||
>
|
||||
> 示例:
|
||||
>
|
||||
> ```
|
||||
> public class Employee {
|
||||
> ```
|
||||
>
|
||||
> **29.@Autowired 注解有什么用?**
|
||||
>
|
||||
> @Autowired 可以更准确地控制应该在何处以及如何进行自动装配。此注解用于在 setter 方法,构造函数,具有任意名称或多个参数的属性或方法上自动装配 bean。默认情况下,它是类型驱动的注入。
|
||||
>
|
||||
> ```
|
||||
> public class Employee {
|
||||
> ```
|
||||
>
|
||||
> **30. **@Qualifier 注解有什么用?****
|
||||
>
|
||||
> 当您创建多个相同类型的 bean 并希望仅使用属性装配其中一个 bean 时,您可以使用@Qualifier 注解和 @Autowired 通过指定应该装配哪个确切的 bean 来消除歧义。
|
||||
>
|
||||
> 例如,这里我们分别有两个类,Employee 和 EmpAccount。在 EmpAccount 中,使用@Qualifier 指定了必须装配 id 为 emp1 的 bean。
|
||||
>
|
||||
> Employee.java
|
||||
>
|
||||
> ```
|
||||
> public class Employee {
|
||||
> ```
|
||||
>
|
||||
> EmpAccount.java
|
||||
>
|
||||
> ```
|
||||
> public class EmpAccount {
|
||||
> ```
|
||||
>
|
||||
> **31.@RequestMapping 注解有什么用?**
|
||||
>
|
||||
> @RequestMapping 注解用于将特定 HTTP 请求方法映射到将处理相应请求的控制器中的特定类/方法。此注解可应用于两个级别:
|
||||
>
|
||||
> - 类级别:映射请求的 URL
|
||||
>
|
||||
> - 方法级别:映射 URL 以及 HTTP 请求方法
|
||||
>
|
||||
>
|
||||
> **32\. spring DAO 有什么用?**
|
||||
>
|
||||
> Spring DAO 使得 JDBC,Hibernate 或 JDO 这样的数据访问技术更容易以一种统一的方式工作。这使得用户容易在持久性技术之间切换。它还允许您在编写代码时,无需考虑捕获每种技术不同的异常。
|
||||
>
|
||||
> **33\. 列举 Spring DAO 抛出的异常。**
|
||||
>
|
||||
> 
|
||||
>
|
||||
> **34\. spring JDBC API 中存在哪些类?**
|
||||
>
|
||||
> - JdbcTemplate
|
||||
>
|
||||
> - SimpleJdbcTemplate
|
||||
>
|
||||
> - NamedParameterJdbcTemplate
|
||||
>
|
||||
> - SimpleJdbcInsert
|
||||
>
|
||||
> - SimpleJdbcCall
|
||||
>
|
||||
>
|
||||
> **35\. 使用 Spring 访问 Hibernate 的方法有哪些?**
|
||||
>
|
||||
> 我们可以通过两种方式使用 Spring 访问 Hibernate:
|
||||
>
|
||||
> - 使用 Hibernate 模板和回调进行控制反转
|
||||
>
|
||||
> - 扩展 HibernateDAOSupport 并应用 AOP 拦截器节点
|
||||
>
|
||||
>
|
||||
> **36\. 列举 spring 支持的事务管理类型**
|
||||
>
|
||||
> Spring 支持两种类型的事务管理:
|
||||
>
|
||||
> - 程序化事务管理:在此过程中,在编程的帮助下管理事务。它为您提供极大的灵活性,但维护起来非常困难。
|
||||
>
|
||||
> - 声明式事务管理:在此,事务管理与业务代码分离。仅使用注解或基于 XML 的配置来管理事务。
|
||||
>
|
||||
>
|
||||
> spring 支持哪些 ORM 框架
|
||||
>
|
||||
> - Hibernate
|
||||
>
|
||||
> - iBatis
|
||||
>
|
||||
> - JPA
|
||||
>
|
||||
> - JDO
|
||||
>
|
||||
> - OJB
|
||||
>
|
||||
>
|
||||
> **37.什么是 AOP?**
|
||||
>
|
||||
> AOP(Aspect-Oriented Programming), 即 面向切面编程, 它与 OOP( Object-Oriented Programming, 面向对象编程) 相辅相成, 提供了与 OOP 不同的抽象软件结构的视角. 在 OOP 中, 我们以类(class)作为我们的基本单元, 而 AOP 中的基本单元是 Aspect(切面)
|
||||
>
|
||||
> **38\. AOP 中的 Aspect、Advice、Pointcut、JointPoint 和 Advice 参数分别是什么?**
|
||||
>
|
||||
> 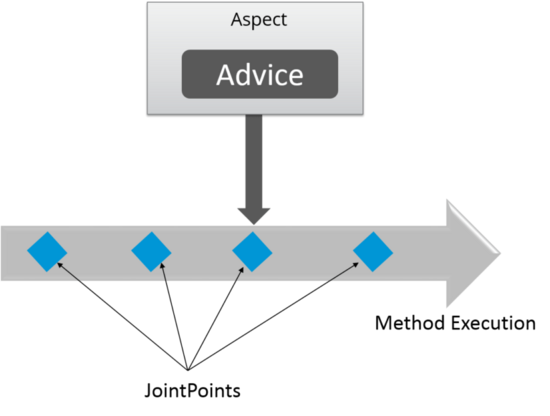
|
||||
>
|
||||
> - Aspect - Aspect 是一个实现交叉问题的类,例如事务管理。方面可以是配置的普通类,然后在 Spring Bean 配置文件中配置,或者我们可以使用 Spring AspectJ 支持使用 @Aspect 注解将类声明为 Aspect。
|
||||
>
|
||||
> - Advice - Advice 是针对特定 JoinPoint 采取的操作。在编程方面,它们是在应用程序中达到具有匹配切入点的特定 JoinPoint 时执行的方法。您可以将 Advice 视为 Spring 拦截器(Interceptor)或 Servlet 过滤器(filter)。
|
||||
>
|
||||
> - Advice Arguments - 我们可以在 advice 方法中传递参数。我们可以在切入点中使用 args() 表达式来应用于与参数模式匹配的任何方法。如果我们使用它,那么我们需要在确定参数类型的 advice 方法中使用相同的名称。
|
||||
>
|
||||
> - Pointcut - Pointcut 是与 JoinPoint 匹配的正则表达式,用于确定是否需要执行 Advice。 Pointcut 使用与 JoinPoint 匹配的不同类型的表达式。Spring 框架使用 AspectJ Pointcut 表达式语言来确定将应用通知方法的 JoinPoint。
|
||||
>
|
||||
> - JoinPoint - JoinPoint 是应用程序中的特定点,例如方法执行,异常处理,更改对象变量值等。在 Spring AOP 中,JoinPoint 始终是方法的执行器。
|
||||
>
|
||||
>
|
||||
> **39\. 什么是通知(Advice)?**
|
||||
>
|
||||
> 特定 JoinPoint 处的 Aspect 所采取的动作称为 Advice。Spring AOP 使用一个 Advice 作为拦截器,在 JoinPoint “周围”维护一系列的拦截器。
|
||||
>
|
||||
> **40\. 有哪些类型的通知(Advice)?**
|
||||
>
|
||||
> - Before - 这些类型的 Advice 在 joinpoint 方法之前执行,并使用 @Before 注解标记进行配置。
|
||||
>
|
||||
> - After Returning - 这些类型的 Advice 在连接点方法正常执行后执行,并使用@AfterReturning 注解标记进行配置。
|
||||
>
|
||||
> - After Throwing - 这些类型的 Advice 仅在 joinpoint 方法通过抛出异常退出并使用 @AfterThrowing 注解标记配置时执行。
|
||||
>
|
||||
> - After (finally) - 这些类型的 Advice 在连接点方法之后执行,无论方法退出是正常还是异常返回,并使用 @After 注解标记进行配置。
|
||||
>
|
||||
> - Around - 这些类型的 Advice 在连接点之前和之后执行,并使用 @Around 注解标记进行配置。
|
||||
>
|
||||
>
|
||||
> **41\. 指出在 spring aop 中 concern 和 cross-cutting concern 的不同之处。**
|
||||
>
|
||||
> concern 是我们想要在应用程序的特定模块中定义的行为。它可以定义为我们想要实现的功能。
|
||||
>
|
||||
> cross-cutting concern 是一个适用于整个应用的行为,这会影响整个应用程序。例如,日志记录,安全性和数据传输是应用程序几乎每个模块都需要关注的问题,因此它们是跨领域的问题。
|
||||
>
|
||||
> **41\. AOP 有哪些实现方式?**
|
||||
>
|
||||
> 实现 AOP 的技术,主要分为两大类:
|
||||
>
|
||||
> - 静态代理 - 指使用 AOP 框架提供的命令进行编译,从而在编译阶段就可生成 AOP 代理类,因此也称为编译时增强;
|
||||
>
|
||||
>
|
||||
> - 编译时编织(特殊编译器实现)
|
||||
>
|
||||
> - 类加载时编织(特殊的类加载器实现)。
|
||||
>
|
||||
>
|
||||
> - 动态代理 - 在运行时在内存中“临时”生成 AOP 动态代理类,因此也被称为运行时增强。
|
||||
>
|
||||
>
|
||||
> - JDK 动态代理
|
||||
>
|
||||
> - CGLIB
|
||||
>
|
||||
>
|
||||
> **42\. Spring AOP and AspectJ AOP 有什么区别?**
|
||||
>
|
||||
> Spring AOP 基于动态代理方式实现;AspectJ 基于静态代理方式实现。 Spring AOP 仅支持方法级别的 PointCut;提供了完全的 AOP 支持,它还支持属性级别的 PointCut。
|
||||
>
|
||||
> **43\. 如何理解 Spring 中的代理?**
|
||||
>
|
||||
> 将 Advice 应用于目标对象后创建的对象称为代理。在客户端对象的情况下,目标对象和代理对象是相同的
|
||||
>
|
||||
> ```
|
||||
> `Advice + Target Object = Proxy`
|
||||
> ```
|
||||
>
|
||||
> **44. 什么是编织(Weaving)?**
|
||||
>
|
||||
> 为了创建一个 advice 对象而链接一个 aspect 和其它应用类型或对象,称为编织(Weaving)。在 Spring AOP 中,编织在运行时执行。请参考下图:
|
||||
>
|
||||
> 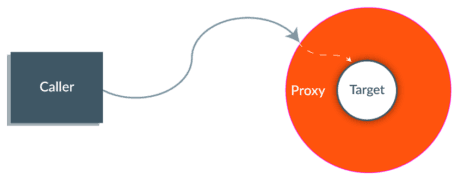
|
||||
>
|
||||
> **45\. Spring MVC 框架有什么用?**
|
||||
>
|
||||
> Spring Web MVC 框架提供 模型-视图-控制器 架构和随时可用的组件,用于开发灵活且松散耦合的 Web 应用程序。 MVC 模式有助于分离应用程序的不同方面,如输入逻辑,业务逻辑和 UI 逻辑,同时在所有这些元素之间提供松散耦合。
|
||||
>
|
||||
> **46\. 描述一下 DispatcherServlet 的工作流程**
|
||||
>
|
||||
> DispatcherServlet 的工作流程可以用一幅图来说明:
|
||||
>
|
||||
> 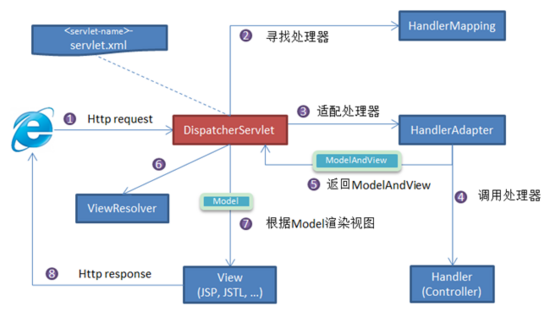
|
||||
>
|
||||
> 1\. 向服务器发送 HTTP 请求,请求被前端控制器 DispatcherServlet 捕获。
|
||||
>
|
||||
> 2. DispatcherServlet 根据 -servlet.xml 中的配置对请求的 URL 进行解析,得到请求资源标识符(URI)。然后根据该 URI,调用 HandlerMapping 获得该 Handler 配置的所有相关的对象(包括 Handler 对象以及 Handler 对象对应的拦截器),最后以 HandlerExecutionChain 对象的形式返回。
|
||||
>
|
||||
> 3. DispatcherServlet 根据获得的 Handler ,选择一个合适的 HandlerAdapter 。(附注:如果成功获得 HandlerAdapter 后,此时将开始执行拦截器的 preHandler(...)方法)。
|
||||
>
|
||||
> 4\. 提取 Request 中的模型数据,填充 Handler 入参,开始执行 Handler ( Controller )。 在填充 Handler 的入参过程中,根据你的配置,Spring 将帮你做一些额外的工作:Handler(Controller)执行完成后,向 DispatcherServlet 返回一个 ModelAndView 对象;
|
||||
>
|
||||
> - HttpMessageConveter : 将请求消息(如 Json、xml 等数据)转换成一个对象,将对象转换为指定的响应信息。
|
||||
>
|
||||
> - 数据转换 :对请求消息进行数据转换。如 String 转换成 Integer 、 Double 等。
|
||||
>
|
||||
> - 数据根式化 :对请求消息进行数据格式化。 如将字符串转换成格式化数字或格式化日期等。
|
||||
>
|
||||
> - 数据验证 : 验证数据的有效性(长度、格式等),验证结果存储到 BindingResult 或 Error 中。
|
||||
>
|
||||
>
|
||||
> 5\. 根据返回的 ModelAndView ,选择一个适合的 ViewResolver (必须是已经注册到 Spring 容器中的 ViewResolver )返回给 DispatcherServlet 。
|
||||
>
|
||||
> 6. ViewResolver 结合 Model 和 View ,来渲染视图。
|
||||
>
|
||||
> 7\. 视图负责将渲染结果返回给客户端。
|
||||
>
|
||||
> **47\. 介绍一下 WebApplicationContext**
|
||||
>
|
||||
> WebApplicationContext 是 ApplicationContext 的扩展。它具有 Web 应用程序所需的一些额外功能。它与普通的 ApplicationContext 在解析主题和决定与哪个 servlet 关联的能力方面有所不同。
|
||||
>
|
||||
> 
|
||||
@@ -0,0 +1,25 @@
|
||||
## Enum 转 int
|
||||
|
||||
`C.ordinal()`
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## int 转 Enum
|
||||
|
||||
只能遍历
|
||||
|
||||
```Plain Text
|
||||
for (MyEnum type : values()) {
|
||||
if (type.getId() == id) {
|
||||
return type;
|
||||
}
|
||||
}
|
||||
return null;
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,666 @@
|
||||
|
||||
## 一、简介
|
||||
|
||||
Java Cryptography Extension(JCE)是一组包,它们提供用于加密、[密钥](https://cloud.tencent.com/developer/tools/blog-entry?target=http%3A%2F%2Fbaike.baidu.com%2Fview%2F934.htm&source=article&objectId=2040606)生成和协商以及 Message Authentication Code(MAC)算法的框架和实现。它提供对对称、不对称、块和流密码的加密支持,它还支持安全流和密封的对象。它不对外出口,用它开发完成封装后将无法调用。
|
||||
|
||||
在早期JDK版本中,由于受美国的密码出口条例约束,Java中涉及加解密功能的API被限制出口,所以Java中安全组件被分成了两部分: 不含加密功能的JCA(Java Cryptography Architecture )和含加密功能的JCE(Java Cryptography Extension)。
|
||||
|
||||
在JDK1.1-1.3版本期间,JCE属于扩展包,仅供美国和加拿大的用户下载,JDK1.4+版本后,随JDK核心包一起分发。
|
||||
|
||||
- [Java加密体系结构(JCA)参考指南](https://cloud.tencent.com/developer/tools/blog-entry?target=http%3A%2F%2Fdocs.oracle.com%2Fjavase%2F7%2Fdocs%2Ftechnotes%2Fguides%2Fsecurity%2Fcrypto%2FCryptoSpec.html&source=article&objectId=2040606)
|
||||
- [**Java密体系结构标准算法的名字的文档**](https://cloud.tencent.com/developer/tools/blog-entry?target=http%3A%2F%2Fdocs.oracle.com%2Fjavase%2F7%2Fdocs%2Ftechnotes%2Fguides%2Fsecurity%2FStandardNames.html&source=article&objectId=2040606)
|
||||
|
||||
## 二、加解密
|
||||
|
||||
JCE的API都在 javax.crypto 包下,核心功能包括:加解密、密钥生成(对称)、MAC生成、密钥协商。
|
||||
|
||||
### 1. Cipher
|
||||
|
||||
加解密功能由Cipher组件提供,其也是JCE中最核心的组件。 Cipher的几个知识点:
|
||||
|
||||
1. Cipher在使用时需以参数方式指定transformation
|
||||
2. transformation的格式为algorithm/mode/padding(_算法/模式/填充_),其中algorithm(算法)为必输项,如: DES/CBC/PKCS5Padding
|
||||
3. 缺省的mode为ECB,缺省的padding为PKCS5Padding
|
||||
4. 在block算法与流加密模式组合时, 需在mode后面指定每次处理的bit数, 如DES/CFB8/NoPadding, 如未指定则使用缺省值, SunJCE缺省值为64bits
|
||||
5. Cipher有4种操作模式: ENCRYPT_MODE(加密), DECRYPT_MODE(解密), WRAP_MODE(导出Key), UNWRAP_MODE(导入Key),初始化时需指定某种操作模式(都是静态参数)。
|
||||
|
||||
### 2. 对称加密的算法与密钥长度选择
|
||||
|
||||
| 算法名称 | 密钥长 | 块长 | 速度 | 说明 |
|
||||
| -------- | ------------- | --- | --- | -------------------- |
|
||||
| DES | 56 | 64 | 慢 | 不安全, 不要使用 |
|
||||
| 3DES | 112/168 | 64 | 很慢 | 中等安全, 适合加密较小的数据 |
|
||||
| AES | 128, 192, 256 | 128 | 快 | 安全 |
|
||||
| Blowfish | (4至56)*8 | 64 | 快 | 应该安全, 在安全界尚未被充分分析、论证 |
|
||||
| RC4 | 40-1024 | 64 | 很快 | 安全性不明确 |
|
||||
|
||||
一般情况下,不要选择DES算法,推荐使用AES算法。一般认为128bits的密钥已足够安全,如果可以请选择256bits的密钥。
|
||||
|
||||
<1>密钥长度是在生成密钥时指定的。如:
|
||||
|
||||
```javascript
|
||||
KeyGenerator generator = KeyGenerator.getInstance("AES/CBC/PKCS5PADDING");
|
||||
generator.init(256);
|
||||
SecretKey key = generator.generateKey();
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
<2>生成长度超128bits的密钥,需单独从Oracle官网下载对应JDK版本的Java Cryptography Extension (JCE) Unlimited Strength Jurisdiction Policy Files文件《详见: [java加密——Jasypt开源工具包](https://cloud.tencent.com/developer/tools/blog-entry?target=http%3A%2F%2Fblog.csdn.net%2Ffanxiaobin577328725%2Farticle%2Fdetails%2F51707882&source=article&objectId=2040606)》,例如[JDK7对应的jurisdiction policy files。](https://cloud.tencent.com/developer/tools/blog-entry?target=http%3A%2F%2Fwww.oracle.com%2Ftechnetwork%2Fjava%2Fjavase%2Fdownloads%2Fjce-7-download-432124.html&source=article&objectId=2040606)
|
||||
|
||||
### 3.加密示例代码
|
||||
|
||||
```javascript
|
||||
/**
|
||||
* 根据密钥{@link #getKey()}对指定的明文
|
||||
plainText
|
||||
进行加密.
|
||||
*
|
||||
* @param plainText 明文
|
||||
* @return 加密后的密文.
|
||||
*/
|
||||
public static final String encrypt(String plainText) {
|
||||
Key secretKey = getKey();
|
||||
try {
|
||||
Cipher cipher = Cipher.getInstance("DES/ECB/PKCS5Padding");
|
||||
cipher.init(Cipher.ENCRYPT_MODE, secretKey);
|
||||
byte[] p = plainText.getBytes("UTF-8");
|
||||
byte[] result = cipher.doFinal(p);
|
||||
BASE64Encoder encoder = new BASE64Encoder();
|
||||
String encoded = encoder.encode(result);
|
||||
return encoded;
|
||||
} catch (Exception e) {
|
||||
throw new RuntimeException(e);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
### 4.解密示例代码
|
||||
|
||||
```javascript
|
||||
/**
|
||||
* 根据密钥{@link #getKey()}对指定的密文
|
||||
cipherText
|
||||
进行解密.
|
||||
*
|
||||
* @param cipherText 密文
|
||||
* @return 解密后的明文.
|
||||
*/
|
||||
public static final String decrypt(String cipherText) {
|
||||
Key secretKey = getKey();
|
||||
try {
|
||||
Cipher cipher = Cipher.getInstance("DES/ECB/PKCS5Padding");
|
||||
cipher.init(Cipher.DECRYPT_MODE, secretKey);
|
||||
BASE64Decoder decoder = new BASE64Decoder();
|
||||
byte[] c = decoder.decodeBuffer(cipherText);
|
||||
byte[] result = cipher.doFinal(c);
|
||||
String plainText = new String(result, "UTF-8");
|
||||
return plainText;
|
||||
} catch (Exception e) {
|
||||
throw new RuntimeException(e);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
### 5.带算法参数的加解密
|
||||
|
||||
Cipher可能用到算法参数(AlgorithmParameterSpec或AlgorithmParameters)的情形:
|
||||
|
||||
- a. DES, DES-EDE, and Blowfish使用feedback模式时(如CBC, CFB, OFB或PCBC), 将用到IV
|
||||
- b. PBEWithMD5AndDES将用到salt和iteration count
|
||||
|
||||
下面是采用PBE算法进行加解密的示例:
|
||||
|
||||
```javascript
|
||||
/**
|
||||
* 提供基于口令的加密功能.
|
||||
*
|
||||
* @param plainText 明文
|
||||
* @return 加密后的密文.
|
||||
*/
|
||||
public static final String pbeEncrypt(String plainText) {
|
||||
Key pbeSecretKey = getPBEKey();
|
||||
PBEParameterSpec pbeParamSpec = getParamSpec();
|
||||
try {
|
||||
Cipher cipher = Cipher.getInstance("PBEWithMD5AndDES");
|
||||
cipher.init(Cipher.ENCRYPT_MODE, pbeSecretKey, pbeParamSpec);
|
||||
byte[] p = plainText.getBytes("UTF-8");
|
||||
byte[] result = cipher.doFinal(p);
|
||||
BASE64Encoder encoder = new BASE64Encoder();
|
||||
String encoded = encoder.encode(result);
|
||||
return encoded;
|
||||
} catch (Exception e) {
|
||||
throw new RuntimeException(e);
|
||||
}
|
||||
}
|
||||
|
||||
/**
|
||||
* 提供基于口令的解密功能.
|
||||
*
|
||||
* @param cipherText 密文
|
||||
* @return 解密后的明文.
|
||||
*/
|
||||
public static final String pbeDecrypt(String cipherText) {
|
||||
Key pbeSecretKey = getPBEKey();
|
||||
PBEParameterSpec pbeParamSpec = getParamSpec();
|
||||
try {
|
||||
Cipher cipher = Cipher.getInstance("PBEWithMD5AndDES");
|
||||
cipher.init(Cipher.DECRYPT_MODE, pbeSecretKey, pbeParamSpec);
|
||||
BASE64Decoder decoder = new BASE64Decoder();
|
||||
byte[] c = decoder.decodeBuffer(cipherText);
|
||||
byte[] result = cipher.doFinal(c);
|
||||
String plainText = new String(result, "UTF-8");
|
||||
return plainText;
|
||||
} catch (Exception e) {
|
||||
throw new RuntimeException(e);
|
||||
}
|
||||
}
|
||||
|
||||
/**
|
||||
* 获取PBE算法的密钥. 注意PBE密钥由用户提供的口令构造出来的,
|
||||
* 用户提供的口令务必使用char数组, 而不能使用字符串, 字符数
|
||||
* 组用完即清空.
|
||||
*
|
||||
* @return PBE算法的密钥.
|
||||
*/
|
||||
private static final Key getPBEKey() {
|
||||
// TODO come from db or System.in, NOTE: MUST be char array, not java.lang.String
|
||||
char[] pwd = {'%', '_', 'A', 's', '9', 'K'};
|
||||
SecretKey pbeKey = null;
|
||||
PBEKeySpec pbeKeySpec = new PBEKeySpec(pwd);
|
||||
try {
|
||||
SecretKeyFactory keyFac = SecretKeyFactory.getInstance("PBEWithMD5AndDES");
|
||||
pbeKey = keyFac.generateSecret(pbeKeySpec);
|
||||
return pbeKey;
|
||||
} catch (Exception e) {
|
||||
throw new RuntimeException(e);
|
||||
} finally {
|
||||
Arrays.fill(pwd, ' ');
|
||||
}
|
||||
}
|
||||
|
||||
/**
|
||||
* 获取PBE的算法参数, 涉及salt和iterate count两个参数.
|
||||
*
|
||||
* @return PBE的算法参数.
|
||||
*/
|
||||
private static final PBEParameterSpec getParamSpec() {
|
||||
byte[] salt = { (byte) 0xab, (byte) 0x58, (byte) 0xa1, (byte) 0x8c,
|
||||
(byte) 0x3e, (byte) 0xc8, (byte) 0x9d, (byte) 0x7a };
|
||||
int count = 20;
|
||||
PBEParameterSpec paramSpec = new PBEParameterSpec(salt, count);
|
||||
return paramSpec;
|
||||
}
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
测试代码:
|
||||
|
||||
```javascript
|
||||
String pbePlainText = "127Kjk$%2^";
|
||||
String pbeCipherText = pbeEncrypt(pbePlainText);
|
||||
String pbePlainText2 = pbeDecrypt(pbeCipherText);
|
||||
if (!pbePlainText.equals(pbePlainText2)) {
|
||||
System.out.println("PBE Something wrong");
|
||||
}
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
## 三、密钥生成
|
||||
|
||||
非对称密钥的生成请参考java.security.KeyPairGenerator,样例代码请参考[JCA](https://cloud.tencent.com/developer/tools/blog-entry?target=http%3A%2F%2Fjloser.com%2Fjava%25E5%25AE%2589%25E5%2585%25A8jca%25E7%25BB%2584%25E4%25BB%25B6%2F&source=article&objectId=2040606)中的示例,对称密钥生成的示例代码如下
|
||||
|
||||
```javascript
|
||||
KeyGenerator gen = KeyGenerator.getInstance("DES");
|
||||
gen.init(56, new SecureRandom());
|
||||
Key key= gen.generateKey();
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
## 四、MAC生成
|
||||
|
||||
MAC技术用于确认数据的完整性,Mac要求通讯双方共享一个secret key,示例代码如下:
|
||||
|
||||
```javascript
|
||||
Key key = KeyGeneratorDemo.generateMac();
|
||||
Mac mac = Mac.getInstance("HmacSHA256");
|
||||
mac.init(key);
|
||||
String msg = "新庄杨渡10#";
|
||||
byte[] result = mac.doFinal(msg.getBytes("UTF-8"));
|
||||
BASE64Encoder encoder = new BASE64Encoder();
|
||||
System.out.println(encoder.encode(result));
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
MAC优于数据摘要的地方在于:MAC双方要共享一个密钥,所以其也有互相认证的功能,可有效防止数据摘要中明文和数据摘要被同时替换而无法发现的问题。
|
||||
|
||||
## 五、密钥协商
|
||||
|
||||
密钥协商就是在通讯多方间不直接交换通讯密钥的情况下而选择一个大家达成一致的密钥(session key),这个session key是对称密钥。
|
||||
|
||||
### 1. 密钥协商可以通过2种途径实现
|
||||
|
||||
1. 通过KeyAgreement组件完成,常用算法包括DH(Diffie-Hellman),ECDH(Elliptic Curve Diffie-Hellman),ECMQV(Elliptic Curve Menezes-Qu-Vanstone)等。
|
||||
2. 通过数字信封完成,常用算法包括RSA等。
|
||||
|
||||
### 2. 通过KeyAgreement使用DH算法协商密钥
|
||||
|
||||
a. DH算法由PKCS#3定义,DH算法需在多方间交换公钥,大素数p,私钥的基数g,和私钥的长度l。设协商密钥的双方为Alice和Bob,则协商共涉及5个阶段:
|
||||
|
||||
- i. Alice生成DH公私密钥对
|
||||
- ii. Alice将公钥和算法参数p,g和l发送给Bob
|
||||
- iii. Bob根据算法参数生成自己的公私密钥对,并将公钥发送给Alice
|
||||
- iv. Alice使用自己的私钥和Bob的公钥通过KeyAgreement得到通讯密钥
|
||||
- v. Bob使用自己的私钥和Alice的公钥通过KeyAgreement得到与Alice相同的通讯密钥
|
||||
|
||||
b. 下面的代码演示了使用DH算法实现密钥协商,设通讯一方为Alice,另一方为Bob,分别由两个线程模拟,实际数据交换由共享内存模拟:
|
||||
|
||||
```javascript
|
||||
/*
|
||||
* @(#)KeyAgreementDemo.java 1.0 2012-4-24
|
||||
*
|
||||
* Copyright 2010 Richard Chen(utopia_rabbi@sse.buaa.edu.cn) All Rights Reserved.
|
||||
* PROPRIETARY/CONFIDENTIAL. Use is subject to license terms.
|
||||
*/
|
||||
package charpter.security.keyagreement;
|
||||
|
||||
import java.math.BigInteger;
|
||||
import java.security.KeyFactory;
|
||||
import java.security.KeyPair;
|
||||
import java.security.KeyPairGenerator;
|
||||
import java.security.PublicKey;
|
||||
import java.security.spec.X509EncodedKeySpec;
|
||||
|
||||
import javax.crypto.Cipher;
|
||||
import javax.crypto.KeyAgreement;
|
||||
import javax.crypto.SecretKey;
|
||||
import javax.crypto.SecretKeyFactory;
|
||||
import javax.crypto.interfaces.DHPublicKey;
|
||||
import javax.crypto.spec.DESKeySpec;
|
||||
import javax.crypto.spec.DHParameterSpec;
|
||||
|
||||
/**
|
||||
* 演示Deffie-Hellman密钥交换组件的用法.
|
||||
*
|
||||
* 密钥交换就是在通讯多方间不直接交换通讯密钥的情况下而选择一个大家达成一致的密钥.
|
||||
*
|
||||
* @author Rich, 2012-4-24.
|
||||
* @version 1.0
|
||||
* @since 1.0
|
||||
*/
|
||||
public class KeyAgreementDemo implements Runnable {
|
||||
/** bob和alice的公钥内容. */
|
||||
byte bob[], alice[];
|
||||
/** alice侧是交换的发起方, 是否已启动. */
|
||||
boolean doneAlice = false;
|
||||
/** 使用计算出来的交换密钥加密过的报文. */
|
||||
byte[] ciphertext;
|
||||
/** DH算法涉及的算法参数, alice侧的大素数p, alice侧的私钥基数g. */
|
||||
BigInteger aliceP, aliceG;
|
||||
/** DH算法涉及的算法参数, alice的私钥长度l. */
|
||||
int aliceL;
|
||||
|
||||
public synchronized void run() {
|
||||
if (!doneAlice) {
|
||||
doAlice();
|
||||
doneAlice = true;
|
||||
} else
|
||||
doBob();
|
||||
}
|
||||
|
||||
public synchronized void doAlice() {
|
||||
try {
|
||||
// Step 1: Alice generates a key pair
|
||||
KeyPairGenerator kpg = KeyPairGenerator.getInstance("DH");
|
||||
kpg.initialize(1024);
|
||||
KeyPair kp = kpg.generateKeyPair();
|
||||
// Step 2: Alice sends the public key and the
|
||||
// Diffie-Hellman key parameters to Bob
|
||||
Class dhClass = Class.forName("javax.crypto.spec.DHParameterSpec");
|
||||
DHParameterSpec dhSpec = ((DHPublicKey) kp.getPublic()).getParams();
|
||||
aliceG = dhSpec.getG();
|
||||
aliceP = dhSpec.getP();
|
||||
aliceL = dhSpec.getL();
|
||||
alice = kp.getPublic().getEncoded();
|
||||
notify();
|
||||
// Step 4 part 1: Alice performs the first phase of the
|
||||
// protocol with her private key
|
||||
KeyAgreement ka = KeyAgreement.getInstance("DH");
|
||||
ka.init(kp.getPrivate());
|
||||
// Step 4 part 2: Alice performs the second phase of the
|
||||
// protocol with Bob's public key
|
||||
while (bob == null) {
|
||||
wait();
|
||||
}
|
||||
KeyFactory kf = KeyFactory.getInstance("DH");
|
||||
X509EncodedKeySpec x509Spec = new X509EncodedKeySpec(bob);
|
||||
PublicKey pk = kf.generatePublic(x509Spec);
|
||||
ka.doPhase(pk, true);
|
||||
// Step 4 part 3: Alice can generate the secret key
|
||||
byte secret[] = ka.generateSecret();
|
||||
// Step 6: Alice converts a secret key
|
||||
SecretKeyFactory skf = SecretKeyFactory.getInstance("DES");
|
||||
DESKeySpec desSpec = new DESKeySpec(secret);
|
||||
SecretKey key = skf.generateSecret(desSpec);
|
||||
// Step 7: Alice encrypts data with the key and sends
|
||||
// the encrypted data to Bob
|
||||
Cipher c = Cipher.getInstance("DES/ECB/PKCS5Padding");
|
||||
c.init(Cipher.ENCRYPT_MODE, key);
|
||||
ciphertext = c.doFinal("Stand and unfold yourself".getBytes());
|
||||
notify();
|
||||
} catch (Exception e) {
|
||||
e.printStackTrace();
|
||||
}
|
||||
}
|
||||
|
||||
public synchronized void doBob() {
|
||||
try {
|
||||
// Step 3: Bob uses the parameters supplied by Alice
|
||||
// to generate a key pair and sends the public key
|
||||
while (alice == null) {
|
||||
wait();
|
||||
}
|
||||
KeyPairGenerator kpg = KeyPairGenerator.getInstance("DH");
|
||||
DHParameterSpec dhSpec = new DHParameterSpec(aliceP, aliceG, aliceL);
|
||||
kpg.initialize(dhSpec);
|
||||
KeyPair kp = kpg.generateKeyPair();
|
||||
bob = kp.getPublic().getEncoded();
|
||||
notify();
|
||||
// Step 5 part 1: Bob uses his private key to perform the
|
||||
// first phase of the protocol
|
||||
KeyAgreement ka = KeyAgreement.getInstance("DH");
|
||||
ka.init(kp.getPrivate());
|
||||
// Step 5 part 2: Bob uses Alice's public key to perform
|
||||
// the second phase of the protocol.
|
||||
KeyFactory kf = KeyFactory.getInstance("DH");
|
||||
X509EncodedKeySpec x509Spec = new X509EncodedKeySpec(alice);
|
||||
PublicKey pk = kf.generatePublic(x509Spec);
|
||||
ka.doPhase(pk, true);
|
||||
// Step 5 part 3: Bob generates the secret key
|
||||
byte secret[] = ka.generateSecret();
|
||||
// Step 6: Bob generates a DES key
|
||||
SecretKeyFactory skf = SecretKeyFactory.getInstance("DES");
|
||||
DESKeySpec desSpec = new DESKeySpec(secret);
|
||||
SecretKey key = skf.generateSecret(desSpec);
|
||||
// Step 8: Bob receives the encrypted text and decrypts it
|
||||
Cipher c = Cipher.getInstance("DES/ECB/PKCS5Padding");
|
||||
c.init(Cipher.DECRYPT_MODE, key);
|
||||
while (ciphertext == null) {
|
||||
wait();
|
||||
}
|
||||
byte plaintext[] = c.doFinal(ciphertext);
|
||||
System.out.println("Bob got the string " + new String(plaintext));
|
||||
} catch (Exception e) {
|
||||
e.printStackTrace();
|
||||
}
|
||||
}
|
||||
|
||||
public static void main(String args[]) {
|
||||
KeyAgreementDemo test = new KeyAgreementDemo();
|
||||
new Thread(test).start(); // Starts Alice
|
||||
new Thread(test).start(); // Starts Bob
|
||||
}
|
||||
|
||||
}
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
以上代码参考了Java Cryptography Extension (JCE) Reference Guide(JDK5.0)中Appendix F的例子。
|
||||
|
||||
### 3. 通过数字信封使用RSA算法协商密钥
|
||||
|
||||
数字信封的原理就是利用通讯对方的公钥加密目标密钥(session key,对称密钥),使用目标密钥对报文进行加密,然后将密钥密文与报文密文一起发送给接收方。接收方首先使用自己的私钥对密钥报文进行解密,这样就得到了协商后的密钥,再使用解密后的密钥解密报文,这样就得到了业务数据。过程图示如下:
|
||||
|
||||
代码示例如下,密钥协商双方由两个线程模拟:
|
||||
|
||||
```javascript
|
||||
/*
|
||||
* @(#)DigitalEnvelopeDemo.java 1.0 2012-6-14
|
||||
*
|
||||
* Copyright 2010 Richard Chen(utopia_rabbi@sse.buaa.edu.cn) All Rights Reserved.
|
||||
* PROPRIETARY/CONFIDENTIAL. Use is subject to license terms.
|
||||
*/
|
||||
package charpter.security.keyagreement;
|
||||
|
||||
import java.io.UnsupportedEncodingException;
|
||||
import java.security.InvalidKeyException;
|
||||
import java.security.Key;
|
||||
import java.security.KeyPair;
|
||||
import java.security.KeyPairGenerator;
|
||||
import java.security.NoSuchAlgorithmException;
|
||||
import java.security.PrivateKey;
|
||||
import java.security.PublicKey;
|
||||
import java.security.SecureRandom;
|
||||
import java.security.spec.InvalidKeySpecException;
|
||||
import java.security.spec.KeySpec;
|
||||
import java.util.HashMap;
|
||||
import java.util.Map;
|
||||
import java.util.concurrent.BlockingQueue;
|
||||
import java.util.concurrent.LinkedBlockingQueue;
|
||||
|
||||
import javax.crypto.BadPaddingException;
|
||||
import javax.crypto.Cipher;
|
||||
import javax.crypto.IllegalBlockSizeException;
|
||||
import javax.crypto.NoSuchPaddingException;
|
||||
import javax.crypto.SecretKeyFactory;
|
||||
import javax.crypto.spec.DESKeySpec;
|
||||
|
||||
import charpter.security.key.KeyGeneratorDemo;
|
||||
|
||||
/**
|
||||
* 演示使用Digital envelope技术进行密钥交换.
|
||||
*
|
||||
|
||||
|
||||
* 服务器端与客户端分别由两个独立的线程模拟, 双方指间的通讯由共享内存实现.
|
||||
*
|
||||
* @author Rich, 2012-6-14.
|
||||
* @version 1.0
|
||||
* @since 1.0
|
||||
*/
|
||||
public final class DigitalEnvelopeDemo {
|
||||
|
||||
/**
|
||||
* @param args
|
||||
*/
|
||||
public static void main(String[] args) {
|
||||
KeyPair pair = generatorKeyPair();
|
||||
Thread client = new Client(pair);
|
||||
Thread server = new Server(pair.getPublic());
|
||||
server.start();
|
||||
client.start();
|
||||
}
|
||||
|
||||
/**
|
||||
* 生成RSA算法的公私密钥对.
|
||||
*
|
||||
* @return 生成RSA算法的公私密钥对.
|
||||
*/
|
||||
public static final KeyPair generatorKeyPair() {
|
||||
KeyPairGenerator keyGen = null;
|
||||
try {
|
||||
keyGen = KeyPairGenerator.getInstance("RSA");
|
||||
} catch (NoSuchAlgorithmException e) {
|
||||
throw new RuntimeException(e);
|
||||
}
|
||||
SecureRandom random = null;
|
||||
try {
|
||||
random = SecureRandom.getInstance("SHA1PRNG");
|
||||
} catch (Exception e) {
|
||||
throw new RuntimeException(e);
|
||||
}
|
||||
random.setSeed(53);
|
||||
keyGen.initialize(1024, random);
|
||||
KeyPair pair = keyGen.generateKeyPair();
|
||||
return pair;
|
||||
}
|
||||
|
||||
/**
|
||||
* 模拟密钥交换的服务器端, 服务器端与客户端通过共享内存来交换Digital Envelope.
|
||||
*
|
||||
* @author Rich, 2012-6-14.
|
||||
* @version 1.0
|
||||
* @since 1.0
|
||||
*/
|
||||
static class Server extends Thread {
|
||||
|
||||
/**
|
||||
* 实际中有可能是客户端在请求服务器端时上送了自己的公钥, 也有可能是在注册
|
||||
* 时就在服务器端登记了公钥.
|
||||
*
|
||||
* @param clientPublicKey 客户端的公钥.
|
||||
*/
|
||||
public Server(PublicKey clientPublicKey) {
|
||||
this.clientPublicKey = clientPublicKey;
|
||||
}
|
||||
|
||||
/* (non-Javadoc)
|
||||
* @see java.lang.Thread#run()
|
||||
*/
|
||||
@Override
|
||||
public void run() {
|
||||
try {
|
||||
String msg = "Legend of AK47";
|
||||
Key sessionKey = KeyGeneratorDemo.generatePlainDES();
|
||||
Cipher cipher = Cipher.getInstance("DES/ECB/PKCS5Padding");
|
||||
cipher.init(Cipher.ENCRYPT_MODE, sessionKey);
|
||||
byte[] p = msg.getBytes("UTF-8");
|
||||
byte[] msgCipher = cipher.doFinal(p);
|
||||
cipher = Cipher.getInstance("RSA");
|
||||
cipher.init(Cipher.ENCRYPT_MODE, clientPublicKey);
|
||||
byte[] keyCipher = cipher.doFinal(sessionKey.getEncoded());
|
||||
Map result = new HashMap();
|
||||
result.put("msg", msgCipher);
|
||||
result.put("key", keyCipher);
|
||||
CHANNEL.offer(result);
|
||||
} catch (KeyException e) {
|
||||
// TODO Exception handling...
|
||||
}
|
||||
}
|
||||
|
||||
/** 客户端的公钥. */
|
||||
private final PublicKey clientPublicKey;
|
||||
|
||||
}
|
||||
|
||||
/**
|
||||
* 模拟密钥交换的客户端, 服务器端与客户端通过共享内存来交换Digital Envelope.
|
||||
*
|
||||
* @author Rich, 2012-6-14.
|
||||
* @version 1.0
|
||||
* @since 1.0
|
||||
*/
|
||||
static class Client extends Thread {
|
||||
|
||||
/**
|
||||
* 密钥对应该在客户端内部产生, 然后客户端在请求服务器端时上送了自己的公钥, 也有可能是在注册时就在服务器端登记了公钥.
|
||||
*
|
||||
* @param keyPair 客户端的公私密钥对.
|
||||
*/
|
||||
public Client(KeyPair keyPair) {
|
||||
this.keyPair = keyPair;
|
||||
}
|
||||
|
||||
/*
|
||||
* (non-Javadoc)
|
||||
*
|
||||
* @see java.lang.Thread#run()
|
||||
*/
|
||||
@Override
|
||||
public void run() {
|
||||
try {
|
||||
Map received = CHANNEL.take();
|
||||
byte[] msgCipher = received.get("msg");
|
||||
byte[] keyCipher = received.get("key");
|
||||
PrivateKey privateKey = keyPair.getPrivate();
|
||||
Cipher cipher = Cipher.getInstance("RSA");
|
||||
cipher.init(Cipher.DECRYPT_MODE, privateKey);
|
||||
byte[] encoded = cipher.doFinal(keyCipher);
|
||||
KeySpec keySpec = new DESKeySpec(encoded);
|
||||
SecretKeyFactory fac = SecretKeyFactory.getInstance("DES");
|
||||
Key key = fac.generateSecret(keySpec);
|
||||
cipher = Cipher.getInstance("DES/ECB/PKCS5Padding");
|
||||
cipher.init(Cipher.DECRYPT_MODE, key);
|
||||
byte[] msg = cipher.doFinal(msgCipher);
|
||||
String plainText = new String(msg, "UTF-8");
|
||||
System.out.println(plainText);
|
||||
} catch (Exception e) {
|
||||
// TODO Exception handling...
|
||||
}
|
||||
}
|
||||
/** 客户端的公私密钥对. */
|
||||
private final KeyPair keyPair;
|
||||
}
|
||||
|
||||
/** Client端与Server端交换数据的队列, 模拟两者之间通讯的通道, 现实中两者可能是通过Socket通讯的. */
|
||||
private static final BlockingQueue> CHANNEL = new LinkedBlockingQueue>(1);
|
||||
}
|
||||
```
|
||||
|
||||
复制
|
||||
|
||||
**KeyAgreement的DH与数字信封的RSA比较:**
|
||||
|
||||
- a. DH仅限于交换共享密钥,而无法对交换双方的身份进行认证,易受中间人攻击
|
||||
- b. RSA可以用于交换共享密钥也可以用于[身份认证](https://cloud.tencent.com/solution/tb-digitalid?from_column=20065&from=20065)
|
||||
- c. 建议:在双方都有数字证书时,使用RSA,一方或两方都没有数字证书则使用Diffie-Hellman,SSL3.0就是采用的此策略
|
||||
|
||||
## 六、总结
|
||||
|
||||
JCE中最常用和最核心的功能就是加解密,此功能由Cipher组件提供,在使用Cipher前需对加密算法及参数先做出选择:
|
||||
|
||||
### 1. 算法选择
|
||||
|
||||
对称算法一般速度较快,非对称算法速度较慢;对称算法的密钥管理比较困难,非对称算法密钥管理简单;非对称算法一般用于认证和加密会话密钥,通讯双方大部分也就是在开启会话时使用一次,对称算法一般用来加密双方之间的报文/交换的数据,使用频度较高。
|
||||
|
||||
### 2. 块/流模式选择
|
||||
|
||||
块(Block)模式加密以块为基本单位,适用于明文长度已知的情形;流(Stream)模式以bit或byte为加解密单位, 适用于明文长度未知、内容较大的情形,如加密一个套接字管道或文件读写流等,一般仅适用于硬件实现。块模式下不同算法的块大小可能不一样,一般都是2的次方数,大部分长度为64bits,整个明文长度不是块长度整倍数时,需在最后一个Block进行补长(Padding)
|
||||
|
||||
### 3. 反馈模式选择
|
||||
|
||||
使用块算法加密,如果明文有大量重复的内容,则对块加密后得到的密文也会存在大量的重复,这对密文分析、破解提供了极大的便利,为消除这方面的威胁,有个思路就是对不同块密文再进行运算,这样就极大去除了块密文与块明文几间的特征关联,这种做法称为块反馈模式。常见的反馈模式有:ECB、CBC、CFB、OFB等。对于第1个block,因没有其它块密文可供运算,有的模式引入了初始矢量(Initialization Vector,IV,由用户指定)作为第1个block内容,这样就进一步解决了第1个block密文的脆弱性。注意:尽量不要使用ECB模式。
|
||||
|
||||
### 4. 补长方案选择
|
||||
|
||||
下面是一些常见的补长(Padding)方案,以DES算法加密明文for为例,因for不足8bytes,所以需补长5bytes(for ?? ?? ?? ?? ??),则这5bytes可能选择(16进制):
|
||||
|
||||
- i. 所有Padding以长度为值:66 6F 72 05 05 05 05 05
|
||||
- ii. Padding以0×80开始后面全部为0×00:66 6F 72 80 00 00 00 00
|
||||
- iii. 最后一个字节为Padding长度, 其它为0×00:66 6f 72 00 00 00 00 05
|
||||
- iv. 全部Padding为0×00:66 6f 72 00 00 00 00 00
|
||||
- v. 全部Padding为0×20(空格):66 6f 72 20 20 20 20 20
|
||||
|
||||
JCE中支持的补长方案包括:NoPadding、PKCS5Padding、ISO10126Padding、OAEPWithAndPadding和SSL3Padding,NoPadding即不补长,其中最常用的就是PKCS5Padding和ISO10126Padding。
|
||||
|
||||
简单的说PKCS5Padding就2个规则:
|
||||
|
||||
- i. 补长的内容为待补长字节数
|
||||
- ii. 补长的字节数为:8 – 明文长度 % 8,即补长长度在1至8bytes之间
|
||||
|
||||
如前述的明文for将补长为:66 6F 72 05 05 05 05 05ISO10126Padding,具体规范请参考[ISO10126](https://cloud.tencent.com/developer/tools/blog-entry?target=http%3A%2F%2Fwww.iso.org%2Fiso%2Fiso_catalogue%2Fcatalogue_tc%2Fcatalogue_detail.htm%3Fcsnumber%3D18114&source=article&objectId=2040606)。简单的说ISO10126Padding就是补长的长度作为补长内容的最后一个byte,之前的补长内容为随机数。
|
||||
|
||||
如前述的明文for可能补长为:66 6F 72 2A 75 EF F8 05
|
||||
|
||||
### 5. 密钥的选择
|
||||
|
||||
密钥可以使用KeyGenerator/KeyPairGenerator生成,也可以由外部导入,还可以有密钥参数构造KeySpec再转换为Key。
|
||||
|
||||
### 6. 密钥长度选择
|
||||
|
||||
对于对称加密算法,128bits的密钥足够安全,条件许可请选择256bits,注意密钥长度大于128bits需单独下载并安装jurisdiction policy files;对于非对称加密算法,1024bits的密钥足够安全。
|
||||
|
||||
最后,如选用基于口令的算法或在用户输入密码时,请避免使用String来引用,使用char[],用完立刻置空char[],避免内存攻击,如heap dump分析等。
|
||||
|
||||
参考资料:
|
||||
|
||||
- [Java安全 – JCE](https://cloud.tencent.com/developer/tools/blog-entry?target=http%3A%2F%2F87426628.blog.163.com%2Fblog%2Fstatic%2F606936182013104883902%2F&source=article&objectId=2040606)
|
||||
@@ -0,0 +1,5 @@
|
||||
java -Dcom.sun.management.jmxremote \
|
||||
-Dcom.sun.management.jmxremote.port=12345 \ # 选择一个未被占用的端口,例如 12345
|
||||
-Dcom.sun.management.jmxremote.authenticate=false \ # 关闭认证
|
||||
-Dcom.sun.management.jmxremote.ssl=false \ # 关闭SSL
|
||||
-jar your_application.jar
|
||||
@@ -0,0 +1,18 @@
|
||||
|
||||
| JDK | class file version | 16 |
|
||||
| ------ | ------------------ | --- |
|
||||
| 19 | 63 | 3F |
|
||||
| 18 | 62 | 3E |
|
||||
| **17** | 61 | 3D |
|
||||
| 16 | 60 | 3C |
|
||||
| **15** | 59 | 3B |
|
||||
| 14 | 58 | 3A |
|
||||
| 13 | 57 | 39 |
|
||||
| 12 | 56 | 38 |
|
||||
| **11** | 55 | 37 |
|
||||
| 10 | 54 | 36 |
|
||||
| 9 | 53 | 35 |
|
||||
| 8 | 52 | 34 |
|
||||
| 7 | 51 | 33 |
|
||||
| 6 | 50 | 32 |
|
||||
| 5 | 49 | 31 |
|
||||
@@ -0,0 +1,18 @@
|
||||
|
||||
| JDK | class file version | 16 |
|
||||
| ------ | ------------------ | --- |
|
||||
| 19 | 63 | 3F |
|
||||
| 18 | 62 | 3E |
|
||||
| **17** | 61 | 3D |
|
||||
| 16 | 60 | 3C |
|
||||
| **15** | 59 | 3B |
|
||||
| 14 | 58 | 3A |
|
||||
| 13 | 57 | 39 |
|
||||
| 12 | 56 | 38 |
|
||||
| **11** | 55 | 37 |
|
||||
| 10 | 54 | 36 |
|
||||
| 9 | 53 | 35 |
|
||||
| 8 | 52 | 34 |
|
||||
| 7 | 51 | 33 |
|
||||
| 6 | 50 | 32 |
|
||||
| 5 | 49 | 31 |
|
||||
@@ -0,0 +1,16 @@
|
||||
可以放在几个位置:
|
||||
|
||||
1. 放在自定义的一个目录,通过[虚拟机](https://so.csdn.net/so/search?q=%E8%99%9A%E6%8B%9F%E6%9C%BA&spm=1001.2101.3001.7020)参数jna.library.path指定路径
|
||||
-Djna.library.path=/xxx
|
||||
|
||||
2. 操作系统的动态链接库的位置
|
||||
|
||||
3. 放在 resources 目录。在编译之后,会在target/classes路径下。
|
||||
|
||||
并且当这几个目录同时存在的情况下,优先级从第一项到第三项依次递减。
|
||||
|
||||
使用编程方式指定路径:
|
||||
NativeLibrary.addSearchPath()
|
||||
|
||||
|
||||
window平台上则是win32-x86子目录,linux平台上则是linux-x86子目录;
|
||||
@@ -0,0 +1,167 @@
|
||||
NA的全称是Java Native Access,它为我们提供了一种更加简单的方式来访问本地的共享库资源,如果你使用JNA,那么你只需要编写相应的java代码即可,不需要编写JNI或者本地代码,非常的方便。
|
||||
|
||||
本质上JNA使用的是一个小的JNI library stub,从而能够动态调用本地方法。
|
||||
|
||||
JNA就是一个jar包,目前最新的版本是5.10.0,我们可以像下面这样引用它:
|
||||
|
||||
```xml
|
||||
<dependency>
|
||||
<groupId>net.java.dev.jna</groupId>
|
||||
<artifactId>jna</artifactId>
|
||||
<version>5.10.0</version>
|
||||
</dependency>
|
||||
```
|
||||
|
||||
一个具体使用JNA的例子:
|
||||
|
||||
```typescript
|
||||
public class JNAUsage {
|
||||
|
||||
public interface CLibrary extends Library {
|
||||
CLibrary INSTANCE = (CLibrary)
|
||||
Native.load((Platform.isWindows() ? "msvcrt" : "c"),
|
||||
CLibrary.class);
|
||||
|
||||
void printf(String format, Object... args);
|
||||
}
|
||||
|
||||
public static void main(String[] args) {
|
||||
CLibrary.INSTANCE.printf("Hello, World\n");
|
||||
for (int i=0;i < args.length;i++) {
|
||||
CLibrary.INSTANCE.printf("Argument %d: %s\n", i, args[i]);
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
这个例子中,我们想要加载系统的c lib,从而使用c lib中的printf方法。
|
||||
|
||||
具体做法就是创建一个CLibrary interface,这个interface继承自Library,然后使用Native.load方法来加载c lib,最后在这个interface中定义要使用的lib中的方法即可。
|
||||
|
||||
那么JNA到底是怎么加载native lib的呢?我们一起来看看。
|
||||
|
||||
# JNA加载native lib的流程
|
||||
|
||||
在讲解JNA加载native lib之前,我们先回顾一下JNI是怎么加载native lib的呢?
|
||||
|
||||
在JNI中,我们首先在java代码中定义要调用的native方法,然后使用javah命令,创建C的头文件,然后再使用C或者C++来对这个头文件进行实现。
|
||||
|
||||
接下来最重要的一步就是将生成的动态链接库添加到JAVA的classpath中,从而在JAVA调用native方法的时候,能够加载到对应的库文件。
|
||||
|
||||
对于上面的JNA的例子来说,直接运行可以得到下面的结果:
|
||||
|
||||
```undefined
|
||||
Hello, World
|
||||
```
|
||||
|
||||
我们可以向程序添加JVM参数:-Djna.debug_load=true,从而让程序能够输出一些调试信息,再次运行结果如下所示:
|
||||
|
||||
```bash
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.Native extractFromResourcePath
|
||||
信息: Looking in classpath from jdk.internal.loader.ClassLoaders$AppClassLoader@251a69d7 for /com/sun/jna/darwin-aarch64/libjnidispatch.jnilib
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.Native extractFromResourcePath
|
||||
信息: Found library resource at jar:file:/Users/flydean/.m2/repository/net/java/dev/jna/jna/5.10.0/jna-5.10.0.jar!/com/sun/jna/darwin-aarch64/libjnidispatch.jnilib
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.Native extractFromResourcePath
|
||||
信息: Extracting library to /Users/flydean/Library/Caches/JNA/temp/jna17752159487359796115.tmp
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.NativeLibrary loadLibrary
|
||||
信息: Looking for library 'c'
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.NativeLibrary loadLibrary
|
||||
信息: Adding paths from jna.library.path: null
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.NativeLibrary loadLibrary
|
||||
信息: Trying libc.dylib
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.NativeLibrary loadLibrary
|
||||
信息: Found library 'c' at libc.dylib
|
||||
Hello, World
|
||||
```
|
||||
|
||||
仔细观察上面的输出结果,我们可以大概了解JNA的工作流程。JNA的工作流程可以分为两部分,第一部分是Library Loading,第二部分是Native Library Loading。
|
||||
|
||||
两个部分分别对应的类是com.sun.jna.Native和com.sun.jna.NativeLibrary。
|
||||
|
||||
第一部分的Library Loading意思是将jnidispatch这个共享的lib文件加载到System中,加载的顺序是这样的:
|
||||
|
||||
1. jna.boot.library.path.
|
||||
2. 使用System.loadLibrary(java.lang.String)从系统的library path中查找。如果不想从系统libary path中查找,则可以设置jna.nosys=true。
|
||||
3. 如果从上述路径中没有找到,则会调用loadNativeDispatchLibrary将jna.jar中的jnidispatch解压到本地,然后进行加载。如果不想从classpath中查找,则可以设置jna.noclasspath=true。 如果不想从jna.jar文件中解压,则可以设置jna.nounpack=true。
|
||||
4. 如果你的系统对于从jar文件中解压文件有安全方面的限制,比如SELinux,那么你需要手动将jnidispatch安装在一个可以访问的地址,然后使用1或者2的方式来设置加载方式和路径。
|
||||
|
||||
当jnidispatch被加载之后,会设置系统变量 jna.loaded=true,表示jna的lib已经加载完毕。
|
||||
|
||||
> 默认情况下我们加载的lib文件名字叫jnidispatch,你也可以通过设置jna.boot.library.name来对他进行修改。
|
||||
|
||||
我们看一下loadNativeDispatchLibrary的核心代码:
|
||||
|
||||
```java
|
||||
String libName = "/com/sun/jna/" + Platform.RESOURCE_PREFIX + "/" + mappedName;
|
||||
File lib = extractFromResourcePath(libName, Native.class.getClassLoader());
|
||||
if (lib == null) {
|
||||
if (lib == null) {
|
||||
throw new UnsatisfiedLinkError("Could not find JNA native support");
|
||||
}
|
||||
}
|
||||
|
||||
LOG.log(DEBUG_JNA_LOAD_LEVEL, "Trying {0}", lib.getAbsolutePath());
|
||||
System.setProperty("jnidispatch.path", lib.getAbsolutePath());
|
||||
System.load(lib.getAbsolutePath());
|
||||
jnidispatchPath = lib.getAbsolutePath();
|
||||
```
|
||||
|
||||
首先是查找stub lib文件:/com/sun/jna/darwin-aarch64/libjnidispatch.jnilib, 默认情况下这个lib文件是在jna.jar包中的,所以需要调用extractFromResourcePath方法将jar包中的lib文件拷贝到临时文件中,然后调用System.load方法将其加载。
|
||||
|
||||
第二部分就是调用com.sun.jna.NativeLibrary中的loadLibrary方法来加载JAVA代码中要加载的lib。
|
||||
|
||||
在loadLibrary的时候有一些搜索路径的规则如下:
|
||||
|
||||
1. jna.library.path,用户自定义的jna lib的路径,优先从用户自定义的路径中开始查找。
|
||||
2. jna.platform.library.path, 和platform相关的lib路径。
|
||||
3. 如果是在OSX操作系统上,则会去搜索 ~/Library/Frameworks, /Library/Frameworks, 和 /System/Library/Frameworks ,去查询对应的Frameworks。
|
||||
4. 最后会去查找Context class loader classpath(classpath或者resource path),具体的格式是${os-prefix}/LIBRARY_FILENAME。如果内容是在jar包中,则会将文件解压缩至 jna.tmpdir,然后进行加载。
|
||||
|
||||
所有的搜索逻辑都放在NativeLibrary的方法loadLibrary中实现的,方法体太长了,这里就不一一列举了,感兴趣的朋友可以自行去探索。
|
||||
|
||||
# 本地方法中的结构体参数
|
||||
|
||||
如果本地方法传入的参数是基本类型的话,在JNA中定义该native方法就用基本类型即可。
|
||||
|
||||
但是有时候,本地方法本身的参数是一个结构体类型,这种情况下我们该如何进行处理呢?
|
||||
|
||||
以Windows中的kernel32 library为例,这个lib中有一个GetSystemTime方法,传入的是一个time结构体。
|
||||
|
||||
我们通过继承Structure来定义参数的结构体:
|
||||
|
||||
```cpp
|
||||
@FieldOrder({ "wYear", "wMonth", "wDayOfWeek", "wDay", "wHour", "wMinute", "wSecond", "wMilliseconds" })
|
||||
public static class SYSTEMTIME extends Structure {
|
||||
public short wYear;
|
||||
public short wMonth;
|
||||
public short wDayOfWeek;
|
||||
public short wDay;
|
||||
public short wHour;
|
||||
public short wMinute;
|
||||
public short wSecond;
|
||||
public short wMilliseconds;
|
||||
}
|
||||
```
|
||||
|
||||
然后定义一个Kernel32的interface:
|
||||
|
||||
```java
|
||||
public interface Kernel32 extends StdCallLibrary {
|
||||
Kernel32 INSTANCE = (Kernel32)
|
||||
Native.load("kernel32", Kernel32.class);
|
||||
Kernel32 SYNC_INSTANCE = (Kernel32)
|
||||
Native.synchronizedLibrary(INSTANCE);
|
||||
|
||||
void GetSystemTime(SYSTEMTIME result);
|
||||
}
|
||||
```
|
||||
|
||||
最后这样调用:
|
||||
|
||||
```vhdl
|
||||
Kernel32 lib = Kernel32.INSTANCE;
|
||||
SYSTEMTIME time = new SYSTEMTIME();
|
||||
lib.GetSystemTime(time);
|
||||
|
||||
System.out.println("Today's integer value is " + time.wDay);
|
||||
```
|
||||
@@ -0,0 +1,167 @@
|
||||
NA的全称是Java Native Access,它为我们提供了一种更加简单的方式来访问本地的共享库资源,如果你使用JNA,那么你只需要编写相应的java代码即可,不需要编写JNI或者本地代码,非常的方便。
|
||||
|
||||
本质上JNA使用的是一个小的JNI library stub,从而能够动态调用本地方法。
|
||||
|
||||
JNA就是一个jar包,目前最新的版本是5.10.0,我们可以像下面这样引用它:
|
||||
|
||||
```xml
|
||||
<dependency>
|
||||
<groupId>net.java.dev.jna</groupId>
|
||||
<artifactId>jna</artifactId>
|
||||
<version>5.10.0</version>
|
||||
</dependency>
|
||||
```
|
||||
|
||||
一个具体使用JNA的例子:
|
||||
|
||||
```typescript
|
||||
public class JNAUsage {
|
||||
|
||||
public interface CLibrary extends Library {
|
||||
CLibrary INSTANCE = (CLibrary)
|
||||
Native.load((Platform.isWindows() ? "msvcrt" : "c"),
|
||||
CLibrary.class);
|
||||
|
||||
void printf(String format, Object... args);
|
||||
}
|
||||
|
||||
public static void main(String[] args) {
|
||||
CLibrary.INSTANCE.printf("Hello, World\n");
|
||||
for (int i=0;i < args.length;i++) {
|
||||
CLibrary.INSTANCE.printf("Argument %d: %s\n", i, args[i]);
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
这个例子中,我们想要加载系统的c lib,从而使用c lib中的printf方法。
|
||||
|
||||
具体做法就是创建一个CLibrary interface,这个interface继承自Library,然后使用Native.load方法来加载c lib,最后在这个interface中定义要使用的lib中的方法即可。
|
||||
|
||||
那么JNA到底是怎么加载native lib的呢?我们一起来看看。
|
||||
|
||||
# JNA加载native lib的流程
|
||||
|
||||
在讲解JNA加载native lib之前,我们先回顾一下JNI是怎么加载native lib的呢?
|
||||
|
||||
在JNI中,我们首先在java代码中定义要调用的native方法,然后使用javah命令,创建C的头文件,然后再使用C或者C++来对这个头文件进行实现。
|
||||
|
||||
接下来最重要的一步就是将生成的动态链接库添加到JAVA的classpath中,从而在JAVA调用native方法的时候,能够加载到对应的库文件。
|
||||
|
||||
对于上面的JNA的例子来说,直接运行可以得到下面的结果:
|
||||
|
||||
```undefined
|
||||
Hello, World
|
||||
```
|
||||
|
||||
我们可以向程序添加JVM参数:-Djna.debug_load=true,从而让程序能够输出一些调试信息,再次运行结果如下所示:
|
||||
|
||||
```bash
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.Native extractFromResourcePath
|
||||
信息: Looking in classpath from jdk.internal.loader.ClassLoaders$AppClassLoader@251a69d7 for /com/sun/jna/darwin-aarch64/libjnidispatch.jnilib
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.Native extractFromResourcePath
|
||||
信息: Found library resource at jar:file:/Users/flydean/.m2/repository/net/java/dev/jna/jna/5.10.0/jna-5.10.0.jar!/com/sun/jna/darwin-aarch64/libjnidispatch.jnilib
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.Native extractFromResourcePath
|
||||
信息: Extracting library to /Users/flydean/Library/Caches/JNA/temp/jna17752159487359796115.tmp
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.NativeLibrary loadLibrary
|
||||
信息: Looking for library 'c'
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.NativeLibrary loadLibrary
|
||||
信息: Adding paths from jna.library.path: null
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.NativeLibrary loadLibrary
|
||||
信息: Trying libc.dylib
|
||||
12月 24, 2021 9:16:05 下午 com.sun.jna.NativeLibrary loadLibrary
|
||||
信息: Found library 'c' at libc.dylib
|
||||
Hello, World
|
||||
```
|
||||
|
||||
仔细观察上面的输出结果,我们可以大概了解JNA的工作流程。JNA的工作流程可以分为两部分,第一部分是Library Loading,第二部分是Native Library Loading。
|
||||
|
||||
两个部分分别对应的类是com.sun.jna.Native和com.sun.jna.NativeLibrary。
|
||||
|
||||
第一部分的Library Loading意思是将jnidispatch这个共享的lib文件加载到System中,加载的顺序是这样的:
|
||||
|
||||
1. jna.boot.library.path.
|
||||
2. 使用System.loadLibrary(java.lang.String)从系统的library path中查找。如果不想从系统libary path中查找,则可以设置jna.nosys=true。
|
||||
3. 如果从上述路径中没有找到,则会调用loadNativeDispatchLibrary将jna.jar中的jnidispatch解压到本地,然后进行加载。如果不想从classpath中查找,则可以设置jna.noclasspath=true。 如果不想从jna.jar文件中解压,则可以设置jna.nounpack=true。
|
||||
4. 如果你的系统对于从jar文件中解压文件有安全方面的限制,比如SELinux,那么你需要手动将jnidispatch安装在一个可以访问的地址,然后使用1或者2的方式来设置加载方式和路径。
|
||||
|
||||
当jnidispatch被加载之后,会设置系统变量 jna.loaded=true,表示jna的lib已经加载完毕。
|
||||
|
||||
> 默认情况下我们加载的lib文件名字叫jnidispatch,你也可以通过设置jna.boot.library.name来对他进行修改。
|
||||
|
||||
我们看一下loadNativeDispatchLibrary的核心代码:
|
||||
|
||||
```java
|
||||
String libName = "/com/sun/jna/" + Platform.RESOURCE_PREFIX + "/" + mappedName;
|
||||
File lib = extractFromResourcePath(libName, Native.class.getClassLoader());
|
||||
if (lib == null) {
|
||||
if (lib == null) {
|
||||
throw new UnsatisfiedLinkError("Could not find JNA native support");
|
||||
}
|
||||
}
|
||||
|
||||
LOG.log(DEBUG_JNA_LOAD_LEVEL, "Trying {0}", lib.getAbsolutePath());
|
||||
System.setProperty("jnidispatch.path", lib.getAbsolutePath());
|
||||
System.load(lib.getAbsolutePath());
|
||||
jnidispatchPath = lib.getAbsolutePath();
|
||||
```
|
||||
|
||||
首先是查找stub lib文件:/com/sun/jna/darwin-aarch64/libjnidispatch.jnilib, 默认情况下这个lib文件是在jna.jar包中的,所以需要调用extractFromResourcePath方法将jar包中的lib文件拷贝到临时文件中,然后调用System.load方法将其加载。
|
||||
|
||||
第二部分就是调用com.sun.jna.NativeLibrary中的loadLibrary方法来加载JAVA代码中要加载的lib。
|
||||
|
||||
在loadLibrary的时候有一些搜索路径的规则如下:
|
||||
|
||||
1. jna.library.path,用户自定义的jna lib的路径,优先从用户自定义的路径中开始查找。
|
||||
2. jna.platform.library.path, 和platform相关的lib路径。
|
||||
3. 如果是在OSX操作系统上,则会去搜索 ~/Library/Frameworks, /Library/Frameworks, 和 /System/Library/Frameworks ,去查询对应的Frameworks。
|
||||
4. 最后会去查找Context class loader classpath(classpath或者resource path),具体的格式是${os-prefix}/LIBRARY_FILENAME。如果内容是在jar包中,则会将文件解压缩至 jna.tmpdir,然后进行加载。
|
||||
|
||||
所有的搜索逻辑都放在NativeLibrary的方法loadLibrary中实现的,方法体太长了,这里就不一一列举了,感兴趣的朋友可以自行去探索。
|
||||
|
||||
# 本地方法中的结构体参数
|
||||
|
||||
如果本地方法传入的参数是基本类型的话,在JNA中定义该native方法就用基本类型即可。
|
||||
|
||||
但是有时候,本地方法本身的参数是一个结构体类型,这种情况下我们该如何进行处理呢?
|
||||
|
||||
以Windows中的kernel32 library为例,这个lib中有一个GetSystemTime方法,传入的是一个time结构体。
|
||||
|
||||
我们通过继承Structure来定义参数的结构体:
|
||||
|
||||
```cpp
|
||||
@FieldOrder({ "wYear", "wMonth", "wDayOfWeek", "wDay", "wHour", "wMinute", "wSecond", "wMilliseconds" })
|
||||
public static class SYSTEMTIME extends Structure {
|
||||
public short wYear;
|
||||
public short wMonth;
|
||||
public short wDayOfWeek;
|
||||
public short wDay;
|
||||
public short wHour;
|
||||
public short wMinute;
|
||||
public short wSecond;
|
||||
public short wMilliseconds;
|
||||
}
|
||||
```
|
||||
|
||||
然后定义一个Kernel32的interface:
|
||||
|
||||
```java
|
||||
public interface Kernel32 extends StdCallLibrary {
|
||||
Kernel32 INSTANCE = (Kernel32)
|
||||
Native.load("kernel32", Kernel32.class);
|
||||
Kernel32 SYNC_INSTANCE = (Kernel32)
|
||||
Native.synchronizedLibrary(INSTANCE);
|
||||
|
||||
void GetSystemTime(SYSTEMTIME result);
|
||||
}
|
||||
```
|
||||
|
||||
最后这样调用:
|
||||
|
||||
```vhdl
|
||||
Kernel32 lib = Kernel32.INSTANCE;
|
||||
SYSTEMTIME time = new SYSTEMTIME();
|
||||
lib.GetSystemTime(time);
|
||||
|
||||
System.out.println("Today's integer value is " + time.wDay);
|
||||
```
|
||||
@@ -0,0 +1,28 @@
|
||||
JUC 是 `java.util.concurrent` 包的简称,是 Java 官方提供的用于简化并发编程的工具包。它从 Java 5 开始引入,随后在 Java 7、8 等版本中持续增强,旨在帮助开发者更容易地编写正确、高性能的多线程程序。
|
||||
|
||||
### 主要包含的组件:
|
||||
|
||||
1. **原子类(Atomic Variables)**
|
||||
如 `AtomicInteger`、`AtomicLong`、`AtomicReference` 等。利用 CAS(Compare-And-Swap)机制提供线程安全的原子操作,避免了使用重量级锁。
|
||||
|
||||
2. **锁(Locks)**
|
||||
如 `ReentrantLock`、`ReentrantReadWriteLock`、`StampedLock`。相比 `synchronized`,它们提供更灵活的锁获取与释放方式(如可中断、尝试加锁、超时等),并且支持公平锁、条件变量等。
|
||||
|
||||
3. **线程池(Executors & Thread Pools)**
|
||||
包括 `ThreadPoolExecutor`、`ScheduledThreadPoolExecutor` 以及 `Executors` 工厂类。通过复用线程来降低频繁创建/销毁线程的开销,并提供任务队列、拒绝策略等管理能力。
|
||||
|
||||
4. **并发集合(Concurrent Collections)**
|
||||
如 `ConcurrentHashMap`、`CopyOnWriteArrayList`、`BlockingQueue`(`ArrayBlockingQueue`、`LinkedBlockingQueue` 等)。这些集合内部实现了高效的线程同步,避免了外部手动加锁。
|
||||
|
||||
5. **同步工具(Synchronizers)**
|
||||
如 `CountDownLatch`(等待一组线程完成)、`CyclicBarrier`(循环屏障,让多个线程互相等待)、`Semaphore`(信号量,控制并发数量)、`Exchanger`(两个线程交换数据)等。用于协调多个线程之间的协作。
|
||||
|
||||
6. **Fork/Join 框架**
|
||||
用于递归分解大任务,利用工作窃取(work-stealing)算法提高并行计算效率。`ForkJoinPool` 是其核心实现。
|
||||
|
||||
### 为什么需要 JUC?
|
||||
- 传统的 `synchronized`、`wait/notify` 等低层机制使用复杂,容易出错(死锁、性能差等)。
|
||||
- JUC 提供了经过充分测试、高性能的并发组件,开发者只需关注业务逻辑,无需重复造轮子。
|
||||
- 极大地提升了高并发场景下的开发效率和程序稳定性。
|
||||
|
||||
简单说:**JUC 是 Java 并发编程的“武器库”,让你安全、高效地编写多线程代码。**
|
||||
@@ -0,0 +1,710 @@
|
||||
|
||||
|
||||

|
||||
|
||||
> 大家好,我是 V 哥。今天看了阿里云开发者社区关于 Java 的灵魂拷问,一线大厂在用 Java 时,都会考虑哪些问题呢,对于工作多年,又没有大厂经历的小伙伴不妨看看,V 哥总结的这13个为什么,你都会哪些?先赞后看,绝不摆烂。
|
||||
|
||||
## 1. 为什么禁止使用 BigDecimal 的 equals 方法做等值比较?
|
||||
|
||||
`BigDecimal` 的 `equals` 方法在等值比较时存在一些问题,通常不建议直接使用它来判断数值的相等性。下面是主要原因以及推荐的替代方案:
|
||||
|
||||
### 1. `equals` 方法比较严格,包含了精度和符号的比较
|
||||
|
||||
`BigDecimal.equals` 不仅比较数值本身,还会比较精度和符号。例如,`BigDecimal` 的 `equals` 方法会认为 `1.0` 和 `1.00` 是不同的值,因为它们的 `scale` 不同(即小数位数不同)。例如:
|
||||
|
||||
BigDecimal a = new BigDecimal("1.0");
|
||||
BigDecimal b = new BigDecimal("1.00");
|
||||
|
||||
System.out.println(a.equals(b)); // 输出 false
|
||||
|
||||
尽管 `1.0` 和 `1.00` 数值上是相等的,但 `equals` 方法会因为精度不同返回 `false`。
|
||||
|
||||
### 2. `equals` 方法会区分正负零
|
||||
|
||||
在 `BigDecimal` 中,正零 (`0.0`) 和负零 (`-0.0`) 是不相等的,而使用 `equals` 会导致 `0.0` 和 `-0.0` 被视为不相等。例如:
|
||||
|
||||
BigDecimal zero1 = new BigDecimal("0.0");
|
||||
BigDecimal zero2 = new BigDecimal("-0.0");
|
||||
|
||||
System.out.println(zero1.equals(zero2)); // 输出 false
|
||||
|
||||
这可能会导致误判,因为在大多数业务逻辑中,我们认为 `0.0` 和 `-0.0` 是等值的。
|
||||
|
||||
### 推荐的替代方案:使用 `compareTo` 方法
|
||||
|
||||
为了避免这些问题,建议使用 `BigDecimal.compareTo` 方法。`compareTo` 方法仅比较数值的大小,不关注精度和符号。因此,在需要判断两个 `BigDecimal` 是否等值时,使用 `compareTo` 更为合理:
|
||||
|
||||
BigDecimal a = new BigDecimal("1.0");
|
||||
BigDecimal b = new BigDecimal("1.00");
|
||||
|
||||
System.out.println(a.compareTo(b) == 0); // 输出 true
|
||||
|
||||
在这种情况下,`1.0` 和 `1.00` 被视为相等,即使它们的精度不同,`compareTo` 也会返回 `0`。
|
||||
|
||||
### 小结
|
||||
|
||||
- **不要使用 `equals` 方法**:它会考虑精度和符号,容易导致误判。
|
||||
- **推荐使用 `compareTo` 方法**:只比较数值,忽略精度和正负零的差异,可以实现更符合业务需求的等值比较。
|
||||
|
||||
## 2. 为什么禁止使用double直接构造BigDecimal?
|
||||
|
||||
在使用 `BigDecimal` 时,不建议直接使用 `double` 作为构造参数。这是因为 `double` 类型在 Java 中的表示是基于二进制浮点数的,会引入精度误差,从而导致不准确的结果。例如:
|
||||
|
||||
double d = 0.1;
|
||||
BigDecimal bd = new BigDecimal(d);
|
||||
System.out.println(bd); // 输出 0.1000000000000000055511151231257827021181583404541015625
|
||||
|
||||
### 原因解析
|
||||
|
||||
1. **二进制浮点数的精度问题**
|
||||
`double` 使用 IEEE 754 标准表示小数,在二进制系统中,像 `0.1` 这样的小数无法精确表示,导致它在存储时会变成一个近似值。这个近似值会直接传递给 `BigDecimal` 的构造方法,从而生成带有误差的 `BigDecimal` 值。
|
||||
2. **结果不准确,影响业务计算**
|
||||
在一些金融计算或其他对精度要求高的场景中,直接使用 `double` 构造 `BigDecimal` 会带来潜在的误差积累,从而影响最终的结果。例如,在多次计算或累加时,误差可能不断放大。
|
||||
|
||||
### 推荐的替代方案
|
||||
|
||||
- **使用字符串或精确值构造 `BigDecimal`**
|
||||
通过传入字符串形式的数字,可以避免精度误差,因为字符串构造器不会引入任何二进制的近似计算。
|
||||
|
||||
BigDecimal bd = new BigDecimal("0.1");
|
||||
System.out.println(bd); // 输出 0.1
|
||||
|
||||
- **使用 `BigDecimal.valueOf(double)` 方法**
|
||||
另一个安全的方式是使用 `BigDecimal.valueOf(double)`,该方法会将 `double` 转换为 `String` 表示,然后构造 `BigDecimal`,从而避免精度损失。
|
||||
|
||||
BigDecimal bd = BigDecimal.valueOf(0.1);
|
||||
System.out.println(bd); // 输出 0.1
|
||||
|
||||
### 小结
|
||||
|
||||
- **避免直接使用 `double` 构造 `BigDecimal`**,以免引入二进制浮点数的精度误差。
|
||||
- **优先使用字符串构造器**,或使用 `BigDecimal.valueOf(double)` 以确保精度。
|
||||
|
||||
## 3. 为什么禁止使用 Apache Beanutils 进行属性的 copy ?
|
||||
|
||||
`Apache BeanUtils` 是一个早期用于 Java Bean 属性复制的工具库,但在现代 Java 开发中通常不推荐使用它来进行属性的拷贝,尤其在性能敏感的场景中。原因主要包括以下几点:
|
||||
|
||||
### 1. **性能问题**
|
||||
|
||||
`Apache BeanUtils.copyProperties()` 使用了大量的反射操作,且每次拷贝都需要对字段、方法进行查找和反射调用。反射机制虽然灵活,但性能较低,尤其是在大量对象或频繁拷贝的场景中,会产生显著的性能瓶颈。
|
||||
|
||||
相比之下,`Spring BeanUtils` 或 `Apache Commons Lang` 的 `FieldUtils` 等工具经过优化,使用了更高效的方式进行属性复制。在性能要求较高的场合,`MapStruct` 或 `Dozer` 等编译期代码生成的方式则可以完全避免运行时反射。
|
||||
|
||||
### 2. **类型转换问题**
|
||||
|
||||
`BeanUtils.copyProperties` 在属性类型不匹配时会隐式地进行类型转换。例如,将 `String` 类型的 `"123"` 转换为 `Integer`,如果转换失败,会抛出异常。这种隐式转换在处理数据时,可能带来不易察觉的错误,而且并不总是适合应用场景。
|
||||
|
||||
在精确的属性复制需求下,通常希望类型不匹配时直接跳过拷贝,或明确抛出错误,而不是隐式转换。例如,`Spring BeanUtils.copyProperties` 不会进行隐式转换,适合严格的属性匹配场景。
|
||||
|
||||
### 3. **潜在的安全问题**
|
||||
|
||||
`Apache BeanUtils` 的 `PropertyUtils` 组件在执行反射操作时存在一定的安全隐患。历史上,`BeanUtils` 的 `PropertyUtils` 曾有安全漏洞,使恶意用户可以通过精心构造的输入利用反射机制执行系统命令或加载恶意类。尽管这些漏洞在现代版本中已得到修复,但该库的架构和实现仍较为陈旧,难以应对更高的安全需求。
|
||||
|
||||
### 4. **缺乏对嵌套对象的深拷贝支持**
|
||||
|
||||
`BeanUtils.copyProperties` 仅支持浅拷贝,即只能复制对象的一级属性,无法递归地对嵌套对象进行复制。如果对象包含了复杂的嵌套结构,使用 `BeanUtils.copyProperties` 很容易出现意外行为或数据丢失。像 `MapStruct` 或 `Dozer` 这样的工具则提供对嵌套对象的深层复制能力,更适合复杂对象的深度拷贝需求。
|
||||
|
||||
### 推荐的替代方案
|
||||
|
||||
1. **Spring `BeanUtils.copyProperties()`**
|
||||
Spring 的 `BeanUtils.copyProperties()` 提供了更优的性能和更好的类型安全性。它不做类型转换,且提供了方便的过滤器用于选择性拷贝属性。
|
||||
2. **MapStruct**
|
||||
`MapStruct` 是基于注解的对象映射框架,支持编译期生成代码,完全避免了反射的性能开销,且支持复杂对象、嵌套属性的深度拷贝,是性能要求较高的首选。
|
||||
3. **Dozer**
|
||||
`Dozer` 支持更灵活的映射配置和深拷贝,适合对象结构复杂的情况。它可以处理嵌套属性映射、类型转换,且具有较好的自定义能力。
|
||||
|
||||
### 小结
|
||||
|
||||
`Apache BeanUtils.copyProperties` 不适合现代 Java 开发的性能、安全性和灵活性要求,推荐使用更高效、安全、灵活的框架(如 Spring `BeanUtils`、`MapStruct` 等)来代替。
|
||||
|
||||
## 4. 为什么要求日期格式化时必须有使用 y 表示年,而不能用 Y ?
|
||||
|
||||
在日期格式化中,必须使用 `y` 而不是 `Y` 来表示年份,这是因为 `y` 和 `Y` 在 Java 和其他日期格式化工具中代表不同的含义:
|
||||
|
||||
1. **`y` 表示日历年(Calendar Year)**
|
||||
`y` 是标准的表示年份的字符,表示的是通常意义上的公历年,比如 `2024` 表示的就是这一年的年份。使用 `y` 时,日期格式化工具会准确地格式化出对应的年份数值:
|
||||
|
||||
SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd");
|
||||
System.out.println(sdf.format(new Date())); // 输出: 2024-11-10
|
||||
|
||||
2. **`Y` 表示星期年(Week Year)**
|
||||
`Y` 表示的是“星期年”或称“ISO周年”(ISO week-numbering year),它是一种基于ISO周数的年份表示方式。这种表示法根据每年的第一个星期一所在的周来计算年份,如果某天属于新一年的第一个完整星期,则会归为新年的星期年。
|
||||
|
||||
例如,如果某年的最后几天在下一年开始的第一个星期中,它们可能会被归入下一年的 `week year`。同理,如果新年的前几天在上一年的最后一个完整星期内,这些天的星期年可能会归属上一年。这在日期和时间处理中可能导致意外的年份差异。
|
||||
|
||||
|
||||
SimpleDateFormat sdf = new SimpleDateFormat("YYYY-MM-dd");
|
||||
System.out.println(sdf.format(new Date())); // 可能输出与实际年份不同的值
|
||||
|
||||
### 使用 `Y` 的潜在问题
|
||||
|
||||
使用 `Y` 表示年份会引发一些日期计算的错误,因为它依赖于周数的计算方式,不是每次都与实际的公历年份一致。例如:
|
||||
|
||||
- 2024年12月31日会被视作 `2025` 的 `week year`,导致使用 `YYYY` 格式化时得到 `2025-12-31`。
|
||||
- 在跨年计算或特定日期逻辑中使用 `Y` 表示年份可能会出现错误,因为 `week year` 与通常理解的日历年并不总是相符。
|
||||
|
||||
### 什么时候使用 `Y`
|
||||
|
||||
`Y` 一般仅用于需要符合 ISO 8601 标准的日期格式,特别是包含 ISO 周数(如“2024-W01-1”表示2024年的第一个星期一)的情况,而在一般情况下,我们都应使用 `y` 来表示日历年份。
|
||||
|
||||
### 小结
|
||||
|
||||
- **使用 `y` 来表示常规年份**,避免日期格式化错误。
|
||||
- **避免使用 `Y` 来表示年份**,除非确实需要按照 ISO 周年的格式来解析和显示年份。
|
||||
|
||||
## 5. 为什么使用三目运算符时必需要注意类型对齐?
|
||||
|
||||
在使用三目运算符时,类型对齐非常重要,因为三目运算符的两个分支会被类型推断成一个共同的类型。若两者类型不同,Java 编译器会进行类型提升或自动转换,这可能导致意外的类型变化和潜在的错误。以下是需要注意的原因和细节:
|
||||
|
||||
### 1. 三目运算符会自动进行类型提升
|
||||
|
||||
三目运算符的返回值类型是根据 `true` 和 `false` 分支的类型推断出来的。为了得到一致的结果,Java 会自动将不同的类型提升为更高精度的类型。例如,若一个分支返回 `int` 而另一个分支返回 `double`,Java 会将 `int` 提升为 `double`:
|
||||
|
||||
int x = 5;
|
||||
double y = 10.5;
|
||||
double result = (x > 0) ? x : y; // 返回 double 类型
|
||||
System.out.println(result); // 输出 5.0
|
||||
|
||||
这里返回值 `5` 被提升为 `5.0`。虽然代码在这个例子中不会出错,但在某些情况下,这种自动提升会导致意外的精度损失或类型不匹配的问题。
|
||||
|
||||
### 2. 自动拆箱和装箱可能引发 `NullPointerException`
|
||||
|
||||
在 Java 中,基本类型和包装类型的对齐需要特别小心。三目运算符会尝试将包装类型和基本类型对齐成相同类型,这会导致自动装箱和拆箱,如果某个分支为 `null` 且需要拆箱,可能会引发 `NullPointerException`:
|
||||
|
||||
Integer a = null;
|
||||
int b = 10;
|
||||
int result = (a != null) ? a : b; // 如果 a 为 null,结果会发生自动拆箱,引发 NullPointerException
|
||||
|
||||
由于 `a` 为 `null`,Java 会尝试将其拆箱为 `int`,从而抛出 `NullPointerException`。为避免这种情况,可以确保类型对齐,或避免对可能为 `null` 的对象进行拆箱。
|
||||
|
||||
### 3. 返回值类型不一致可能导致编译错误
|
||||
|
||||
如果三目运算符的两种返回类型无法被编译器自动转换为一个兼容类型,代码会直接报错。例如:
|
||||
|
||||
int x = 5;
|
||||
String y = "10";
|
||||
Object result = (x > 0) ? x : y; // 编译错误:int 和 String 不兼容
|
||||
|
||||
在这种情况下,`int` 和 `String` 无法被提升到相同类型,因此会引发编译错误。若确实希望返回不同类型的值,可以手动指定共同的超类型,例如将结果定义为 `Object` 类型:
|
||||
|
||||
Object result = (x > 0) ? Integer.valueOf(x) : y; // 这里 result 为 Object
|
||||
|
||||
### 4. 类型对齐可以提升代码的可读性
|
||||
|
||||
保持三目运算符返回的类型一致,能让代码更加清晰,便于理解和维护。类型对齐可以避免类型转换和自动提升带来的混乱,使代码更容易预测和理解:
|
||||
|
||||
double result = (condition) ? 1.0 : 0.0; // 返回 double
|
||||
|
||||
### 小结
|
||||
|
||||
- **保持类型一致性**,确保 `true` 和 `false` 分支的类型相同,避免意外的类型提升。
|
||||
- **小心自动装箱和拆箱**,避免 `null` 参与三目运算符计算。
|
||||
- **在返回不同类型时选择合适的公共类型**,如使用 `Object` 或显式转换。
|
||||
|
||||
## 6. 为什么建议初始化 HashMap 的容量大小?
|
||||
|
||||
初始化 `HashMap` 的容量大小是为了提高性能和减少内存浪费。通过设置合适的初始容量,可以减少 `HashMap` 的扩容次数,提高程序运行效率。以下是详细原因和建议:
|
||||
|
||||
### 1. 减少扩容次数,提高性能
|
||||
|
||||
`HashMap` 默认的初始容量为 16,当超过负载因子阈值(默认是 0.75,即达到容量的 75%)时,`HashMap` 会自动进行扩容操作,将容量扩大为原来的两倍。扩容涉及到重新计算哈希并将数据重新分布到新的桶中,这个过程非常耗时,尤其在元素较多时,扩容会显著影响性能。
|
||||
|
||||
通过设置合适的初始容量,可以避免或减少扩容操作,提高 `HashMap` 的存取效率。
|
||||
|
||||
### 2. 节省内存,避免不必要的内存开销
|
||||
|
||||
如果预计要存储大量数据但没有指定容量,`HashMap` 可能会多次扩容,每次扩容会分配新的内存空间,并将原有数据复制到新空间中,造成内存浪费。如果在创建 `HashMap` 时能合理估算其容量,则可以一次性分配足够的空间,从而避免重复分配内存带来的资源浪费。
|
||||
|
||||
### 3. 避免扩容带来的线程安全问题
|
||||
|
||||
在并发环境下,频繁扩容可能导致线程不安全,即使是 `ConcurrentHashMap` 也不能完全避免扩容带来的性能和一致性问题。初始化合适的容量可以减少并发环境下扩容带来的风险。
|
||||
|
||||
### 如何估算合适的容量
|
||||
|
||||
1. **预估数据量**:如果预计 `HashMap` 将存储 `n` 个元素,可以将初始容量设置为 `(n / 0.75)`,再向上取整为最接近的 2 的幂次方。
|
||||
|
||||
int initialCapacity = (int) Math.ceil(n / 0.75);
|
||||
Map<String, String> map = new HashMap<>(initialCapacity);
|
||||
|
||||
2. **取 2 的幂次方**:`HashMap` 的容量总是以 2 的幂次方增长,因为在进行哈希运算时,可以高效利用按位与操作来计算哈希桶索引。因此,初始容量设为 2 的幂次方会使哈希分布更均匀。
|
||||
|
||||
### 示例代码
|
||||
|
||||
int expectedSize = 1000; // 预估需要存储的键值对数量
|
||||
int initialCapacity = (int) Math.ceil(expectedSize / 0.75);
|
||||
HashMap<String, Integer> map = new HashMap<>(initialCapacity);
|
||||
|
||||
### 小结
|
||||
|
||||
初始化 `HashMap` 的容量大小有以下好处:
|
||||
|
||||
- **提高性能**:减少扩容次数,优化存取效率。
|
||||
- **节省内存**:避免多次扩容引起的内存浪费。
|
||||
- **提升线程安全**:在并发环境下减少扩容带来的线程不安全风险。
|
||||
|
||||
合理初始化 `HashMap` 容量对于高性能应用尤为重要,尤其在存储大量数据时可以显著提升程序的运行效率。
|
||||
|
||||
## 7. 为什么禁止使用 Executors 创建线程池?
|
||||
|
||||
在 Java 中创建线程池时,不推荐直接使用 `Executors` 提供的快捷方法(例如 `Executors.newFixedThreadPool()`、`Executors.newCachedThreadPool()` 等),而推荐使用 `ThreadPoolExecutor` 构造方法来手动配置线程池。这种做法主要是为了避免 `Executors` 创建线程池时隐藏的风险,确保线程池配置符合需求。具体原因如下:
|
||||
|
||||
### 1. **不透明的任务队列长度导致OOM风险**
|
||||
|
||||
- **`newFixedThreadPool()` 和 `newSingleThreadExecutor()`** 使用的是**无界队列** `LinkedBlockingQueue`。无界队列可以存放无限数量的任务,一旦任务量非常大,队列会迅速占用大量内存,导致 **OutOfMemoryError**(OOM)。
|
||||
- **`newCachedThreadPool()`** 使用的是 **SynchronousQueue**,该队列没有存储任务的能力,每个任务到来时必须立即有一个空闲线程来处理任务,否则将创建一个新线程。当任务到达速度超过线程销毁速度时,线程数量会快速增加,导致 **OOM**。
|
||||
|
||||
### 2. **线程数无法控制,导致资源耗尽**
|
||||
|
||||
在 `newCachedThreadPool()` 创建的线程池中,线程数没有上限,短时间内大量请求会导致线程数暴增,耗尽系统资源。`newFixedThreadPool()` 和 `newSingleThreadExecutor()` 虽然限制了核心线程数,但未限制任务队列长度,依然可能耗尽内存。
|
||||
|
||||
在业务需求不确定或任务激增的场景下,建议明确限制线程池的最大线程数和队列长度,以更好地控制系统资源的使用,避免因线程数无法控制导致的性能问题。
|
||||
|
||||
### 3. **缺乏合理的拒绝策略控制**
|
||||
|
||||
- `Executors` 创建的线程池默认使用 `AbortPolicy` 拒绝策略,即当线程池达到饱和时会抛出 `RejectedExecutionException` 异常。
|
||||
- 不同的业务场景可能需要不同的拒绝策略,例如可以使用 `CallerRunsPolicy`(让提交任务的线程执行任务)或 `DiscardOldestPolicy`(丢弃最旧的任务)来平衡任务处理。
|
||||
|
||||
手动创建 `ThreadPoolExecutor` 时,可以指定适合业务需求的拒绝策略,从而更灵活地处理线程池满载的情况,避免异常或系统性能下降。
|
||||
|
||||
### 4. **灵活配置核心参数**
|
||||
|
||||
使用 `ThreadPoolExecutor` 的构造方法可以手动设置以下参数,以便根据业务需求灵活配置线程池:
|
||||
|
||||
- **corePoolSize**:核心线程数,避免空闲线程被频繁销毁和重建。
|
||||
- **maximumPoolSize**:最大线程数,控制线程池能使用的最大资源。
|
||||
- **keepAliveTime**:非核心线程的存活时间,适合控制线程销毁频率。
|
||||
- **workQueue**:任务队列类型和长度,便于管理任务积压的情况。
|
||||
|
||||
这些参数的合理配置可以有效平衡线程池的性能、资源占用和任务处理能力,避免使用默认配置时不符合需求的情况。
|
||||
|
||||
### 推荐的线程池创建方式
|
||||
|
||||
建议直接使用 `ThreadPoolExecutor` 构造方法配置线程池,例如:
|
||||
|
||||
int corePoolSize = 10;
|
||||
int maximumPoolSize = 20;
|
||||
long keepAliveTime = 60L;
|
||||
BlockingQueue<Runnable> workQueue = new ArrayBlockingQueue<>(100);
|
||||
|
||||
ThreadPoolExecutor executor = new ThreadPoolExecutor(
|
||||
corePoolSize,
|
||||
maximumPoolSize,
|
||||
keepAliveTime,
|
||||
TimeUnit.SECONDS,
|
||||
workQueue,
|
||||
new ThreadPoolExecutor.CallerRunsPolicy() // 拒绝策略
|
||||
);
|
||||
|
||||
### 小结
|
||||
|
||||
使用 `Executors` 创建线程池会带来不易察觉的风险,可能导致系统资源耗尽或任务堆积,手动配置 `ThreadPoolExecutor` 可以更好地控制线程池的行为,使其符合实际业务需求和资源限制。因此,为了系统的健壮性和可控性,建议避免使用 `Executors` 快捷方法来创建线程池。
|
||||
|
||||
## 8. 为什么要求谨慎使用 ArrayList 中的 subList 方法?
|
||||
|
||||
在使用 `ArrayList` 的 `subList` 方法时需要谨慎,因为它有一些潜在的陷阱,容易导致意外的错误和难以排查的异常。以下是 `subList` 需要小心使用的原因和注意事项:
|
||||
|
||||
### 1. `subList` 返回的是视图,而不是独立副本
|
||||
|
||||
`ArrayList` 的 `subList` 方法返回的是原列表的一部分视图(`view`),而不是一个独立的副本。对 `subList` 的修改会直接影响原列表,反之亦然:
|
||||
|
||||
ArrayList<Integer> list = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));
|
||||
List<Integer> subList = list.subList(1, 4);
|
||||
subList.set(0, 10); // 修改 subList
|
||||
System.out.println(list); // 原列表也受到影响:[1, 10, 3, 4, 5]
|
||||
|
||||
这种共享视图的机制在某些场景中可能引发意外的修改,导致数据被意外改变,从而影响到原始数据结构的完整性和正确性。
|
||||
|
||||
### 2. `subList` 的结构性修改限制
|
||||
|
||||
当对 `ArrayList` 本身(而非 `subList` 视图)进行结构性修改(`add`、`remove` 等改变列表大小的操作)后,再操作 `subList` 会导致 `ConcurrentModificationException` 异常。这是因为 `subList` 和原 `ArrayList` 之间共享结构性修改的状态,一旦其中一个发生修改,另一方就会失效:
|
||||
|
||||
ArrayList<Integer> list = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));
|
||||
List<Integer> subList = list.subList(1, 4);
|
||||
list.add(6); // 修改原列表的结构
|
||||
subList.get(0); // 抛出 ConcurrentModificationException
|
||||
|
||||
这种限制意味着 `subList` 不适合在列表频繁变化的场景中使用,否则很容易引发并发修改异常。
|
||||
|
||||
### 3. `subList` 和 `ArrayList` 的 removeAll 等操作可能导致错误
|
||||
|
||||
`subList` 生成的视图列表可能会在批量删除操作中出现问题,例如调用 `removeAll` 方法时,`subList` 的行为不一致或发生异常。对于 `ArrayList` 的 `subList`,一些批量修改方法(如 `removeAll`、`retainAll`)可能会在删除视图元素后,导致 `ArrayList` 产生不可预料的状态,甚至引发 `IndexOutOfBoundsException` 等异常。
|
||||
|
||||
### 4. 推荐的安全使用方式
|
||||
|
||||
如果需要一个独立的子列表,可以通过 `new ArrayList<>(originalList.subList(start, end))` 来创建一个子列表的副本,从而避免 `subList` 的共享视图问题:
|
||||
|
||||
ArrayList<Integer> list = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));
|
||||
ArrayList<Integer> subListCopy = new ArrayList<>(list.subList(1, 4)); // 创建副本
|
||||
list.add(6); // 修改原列表
|
||||
subListCopy.get(0); // 安全,不会受到影响
|
||||
|
||||
### 小结
|
||||
|
||||
使用 `ArrayList` 的 `subList` 方法需要注意以下几点:
|
||||
|
||||
- **视图机制**:`subList` 只是原列表的视图,修改其中一个会影响另一个。
|
||||
- **结构性修改限制**:结构性修改原列表后再访问 `subList` 会抛出 `ConcurrentModificationException`。
|
||||
- **批量操作问题**:`subList` 的批量操作可能引发不可预料的错误。
|
||||
- **建议创建副本**:如需独立操作子列表,最好创建 `subList` 的副本以避免潜在问题。
|
||||
|
||||
谨慎使用 `subList` 可以避免意外的错误,提高代码的健壮性。
|
||||
|
||||
## 9. 为什么禁止在 foreach 循环里进行元素的 remove/add 操作?
|
||||
|
||||
在 Java 中,禁止在 `foreach` 循环中进行元素的 `remove` 或 `add` 操作,主要是因为这种操作可能导致 `ConcurrentModificationException` 异常,或者导致循环行为不符合预期。具体原因如下:
|
||||
|
||||
### 1. **`ConcurrentModificationException` 异常**
|
||||
|
||||
当你在 `foreach` 循环中直接修改集合(例如 `remove` 或 `add` 元素),会导致并发修改问题。`foreach` 循环底层使用了集合的 `Iterator` 来遍历元素。大多数集合类(如 `ArrayList`、`HashSet` 等)都会维护一个 `modCount` 计数器,表示集合的结构变更次数。当你在遍历时修改集合的结构(如删除或添加元素),`modCount` 会发生变化,而 `Iterator` 会检测到这种结构性修改,从而抛出 `ConcurrentModificationException` 异常,防止程序在多线程环境中出现意外行为。
|
||||
|
||||
例如:
|
||||
|
||||
List<String> list = new ArrayList<>(Arrays.asList("a", "b", "c", "d"));
|
||||
for (String s : list) {
|
||||
if (s.equals("b")) {
|
||||
list.remove(s); // 会抛出 ConcurrentModificationException
|
||||
}
|
||||
}
|
||||
|
||||
在上面的代码中,`foreach` 循环遍历 `list` 时,如果删除了元素 `b`,它会修改 `list` 的结构,从而导致 `Iterator` 检测到并发修改,抛出异常。
|
||||
|
||||
### 2. **不可预测的行为**
|
||||
|
||||
即使没有抛出 `ConcurrentModificationException`,在 `foreach` 循环中修改集合也会导致不可预测的行为。例如,`remove` 或 `add` 操作会改变集合的大小和内容,可能会影响迭代的顺序或导致遗漏某些元素,甚至造成死循环或跳过某些元素。
|
||||
|
||||
例如:
|
||||
|
||||
List<String> list = new ArrayList<>(Arrays.asList("a", "b", "c", "d"));
|
||||
for (String s : list) {
|
||||
if (s.equals("b")) {
|
||||
list.add("e"); // 修改集合的大小
|
||||
}
|
||||
System.out.println(s);
|
||||
}
|
||||
|
||||
在这个例子中,`add` 操作会向 `list` 中添加一个新元素 `"e"`,从而修改了集合的结构。因为 `foreach` 循环的内部实现使用了迭代器,它可能不会考虑到修改后的新元素,导致输出顺序或遍历结果与预期不同。
|
||||
|
||||
### 3. **迭代器的 `remove()` 方法**
|
||||
|
||||
如果需要在循环中删除元素,推荐使用 `Iterator` 显式地进行删除操作。`Iterator` 提供了一个安全的 `remove()` 方法,可以在遍历时安全地删除元素,而不会引发 `ConcurrentModificationException`。
|
||||
|
||||
例如:
|
||||
|
||||
List<String> list = new ArrayList<>(Arrays.asList("a", "b", "c", "d"));
|
||||
Iterator<String> iterator = list.iterator();
|
||||
while (iterator.hasNext()) {
|
||||
String s = iterator.next();
|
||||
if (s.equals("b")) {
|
||||
iterator.remove(); // 使用 Iterator 的 remove() 方法
|
||||
}
|
||||
}
|
||||
|
||||
使用 `Iterator.remove()` 可以安全地在遍历时删除元素,而不会抛出并发修改异常。
|
||||
|
||||
### 小结
|
||||
|
||||
在 `foreach` 循环中直接进行 `remove` 或 `add` 操作是不安全的,主要有以下原因:
|
||||
|
||||
- **`ConcurrentModificationException`**:直接修改集合会触发迭代器的并发修改检测,导致异常。
|
||||
- **不可预测的行为**:修改集合的结构可能导致元素遗漏、顺序错乱或程序逻辑出错。
|
||||
- **使用 `Iterator` 替代**:使用 `Iterator` 的 `remove()` 方法可以避免这些问题,实现安全的元素删除操作。
|
||||
|
||||
因此,正确的做法是使用 `Iterator` 显式地处理元素的删除或修改,而不是直接在 `foreach` 循环中进行修改。
|
||||
|
||||
## 10. 为什么禁止工程师直接使用日志系统 (Log4j、Logback) 中的 API ?
|
||||
|
||||
在很多工程实践中,**禁止工程师直接使用日志系统(如 Log4j、Logback)中的 API**,主要是出于以下几个原因:
|
||||
|
||||
### 1. **日志配置与实现的分离**
|
||||
|
||||
直接使用日志系统的 API 可能会导致日志记录逻辑与应用的业务逻辑紧密耦合,使得日志配置和实现的分离变得困难。现代的日志框架(如 Log4j、Logback)允许通过外部配置文件(如 `log4j.xml` 或 `logback.xml`)灵活配置日志级别、输出格式、输出位置等,而不是硬编码到应用代码中。直接使用日志 API 会导致日志的配置与业务代码绑定在一起,不易修改和维护。
|
||||
|
||||
**建议的做法**:通过使用日志框架的日志抽象接口(如 `org.slf4j.Logger`)来记录日志,而不是直接依赖具体的日志实现。这种方式提供了更大的灵活性,日志实现可以在运行时通过配置文件更换而无需修改代码。
|
||||
|
||||
### 2. **灵活性与可扩展性问题**
|
||||
|
||||
如果工程师直接使用日志库的 API,项目在需要切换日志框架(比如从 Log4j 转换到 Logback 或其他框架)时,需要修改大量的代码,增加了系统的耦合度和维护难度。另一方面,使用日志抽象层(如 SLF4J)可以避免这一问题,因为 SLF4J 是一个日志抽象层,底层可以切换具体的日志实现而无需改变业务代码。
|
||||
|
||||
**示例**:
|
||||
|
||||
// 不推荐:直接使用 Log4j 的 API
|
||||
import org.apache.log4j.Logger;
|
||||
Logger logger = Logger.getLogger(MyClass.class);
|
||||
logger.info("This is a log message");
|
||||
|
||||
// 推荐:通过 SLF4J 接口来记录日志
|
||||
import org.slf4j.Logger;
|
||||
import org.slf4j.LoggerFactory;
|
||||
Logger logger = LoggerFactory.getLogger(MyClass.class);
|
||||
logger.info("This is a log message");
|
||||
|
||||
使用 SLF4J 可以在不同的环境中灵活切换日志实现,而无需修改代码。
|
||||
|
||||
### 3. **日志记录与调试不一致**
|
||||
|
||||
如果工程师直接使用日志框架的 API,可能会在日志记录时不遵循一致的日志策略。例如,日志的级别、格式、日志输出的内容等可能不统一,导致日志信息混乱、不易追踪。通过统一的日志抽象接口(如 SLF4J)和规范的日志记录策略(通过 AOP 或日志框架自带的特性)可以保持日志的一致性和规范性。
|
||||
|
||||
**最佳实践**:
|
||||
|
||||
- 通过统一的日志管理类或工具类来封装日志记录方法,确保所有日志记录都遵循统一的格式和规范。
|
||||
- 在日志中统一使用适当的日志级别(如 `DEBUG`、`INFO`、`WARN`、`ERROR`)和标准格式。
|
||||
|
||||
### 4. **日志的性能影响**
|
||||
|
||||
日志记录可能对应用的性能产生一定的影响,尤其是在日志记录过于频繁或日志输出内容过多的情况下。通过直接使用日志框架的 API,可能无法灵活控制日志输出的频率、内容或过滤策略,从而造成性能问题。很多日志框架(如 Log4j 和 Logback)提供了高级的配置选项,如异步日志、日志缓存等特性,可以显著提高性能。
|
||||
|
||||
**推荐做法**:
|
||||
|
||||
- 使用日志框架提供的异步日志功能来提高性能。
|
||||
- 配置适当的日志级别,避免在生产环境中输出过多的调试信息。
|
||||
|
||||
### 5. **日志管理的统一性与规范**
|
||||
|
||||
在团队开发中,直接使用日志框架的 API 会导致不同开发人员在不同模块中记录日志时不遵循统一规范,导致日志格式不统一、信息不一致,甚至产生重复的日志记录。通过日志管理工具类或封装类,可以确保所有开发人员遵循统一的日志记录策略。
|
||||
|
||||
**示例**:
|
||||
|
||||
- 创建一个统一的 `LoggerFactory` 工厂类来生成日志记录对象。
|
||||
- 统一定义日志级别和输出格式,确保日志输出一致。
|
||||
|
||||
### 小结
|
||||
|
||||
禁止工程师直接使用日志系统(如 Log4j、Logback)中的 API,主要是为了:
|
||||
|
||||
1. **解耦日志实现与业务逻辑**:通过使用日志抽象层(如 SLF4J),可以更轻松地切换日志框架,避免硬编码。
|
||||
2. **提高灵活性与可维护性**:避免在应用中重复使用框架 API,提高日志配置的灵活性和一致性。
|
||||
3. **规范日志记录行为**:通过封装日志记录,确保日志级别、格式和内容的统一,增强可读性和可追踪性。
|
||||
4. **优化性能**:通过配置日志框架的高级功能(如异步日志),提高日志系统的性能,减少对应用的影响。
|
||||
5. **统一日志管理**:避免团队成员在不同模块中使用不一致的日志记录方式,确保日志输出的标准化。
|
||||
|
||||
最好的做法是通过日志抽象层(如 SLF4J)进行日志记录,同时通过日志管理工具类进行统一的配置和调用,确保日志的高效、规范和灵活性。
|
||||
|
||||
## 11. 为什么建议开发者谨慎使用继承?
|
||||
|
||||
在面向对象编程(OOP)中,**继承**是一种常见的代码复用方式,它允许一个类继承另一个类的属性和行为。然而,虽然继承可以提高代码的复用性,但过度或不当使用继承可能会导致代码的复杂性增加,进而带来一些潜在的问题。因此,建议开发者在使用继承时要谨慎,以下是一些关键原因:
|
||||
|
||||
### 1. **增加了类之间的耦合性**
|
||||
|
||||
继承会导致子类和父类之间形成紧密的耦合关系。子类依赖于父类的实现,这意味着如果父类发生变化,可能会影响到所有继承自该父类的子类,导致修改和维护变得更加困难。这种紧密耦合关系也限制了子类的灵活性,因为它必须遵循父类的接口和实现。
|
||||
|
||||
**例子**:
|
||||
|
||||
class Animal {
|
||||
void eat() {
|
||||
System.out.println("Animal is eating");
|
||||
}
|
||||
}
|
||||
|
||||
class Dog extends Animal {
|
||||
@Override
|
||||
void eat() {
|
||||
System.out.println("Dog is eating");
|
||||
}
|
||||
}
|
||||
|
||||
如果父类 `Animal` 做了改动(如修改 `eat()` 方法的实现),`Dog` 类也会受到影响。这样的耦合会增加后期维护的复杂度。
|
||||
|
||||
### 2. **破坏了封装性(Encapsulation)**
|
||||
|
||||
继承可能破坏封装性,因为子类可以直接访问父类的成员(字段和方法),尤其是当父类成员被设置为 `protected` 或 `public` 时。这种情况可能导致子类暴露不应被外界访问的细节,破坏了数据的封装性。
|
||||
|
||||
**例子**:
|
||||
|
||||
class Vehicle {
|
||||
protected int speed;
|
||||
}
|
||||
|
||||
class Car extends Vehicle {
|
||||
void accelerate() {
|
||||
speed += 10; // 直接访问父类的 protected 字段
|
||||
}
|
||||
}
|
||||
|
||||
在这种情况下,`Car` 类直接访问了父类 `Vehicle` 的 `speed` 字段,而不是通过公共接口来修改它,导致封装性降低。
|
||||
|
||||
### 3. **继承可能会导致类的层次结构不合理**
|
||||
|
||||
继承往往会导致不合理的类层次结构,特别是在试图通过继承来表达“是一个”(`is-a`)关系时,实际情况可能并不符合这种逻辑。滥用继承可能会使类之间的关系变得复杂和不直观,导致代码结构混乱。
|
||||
|
||||
**例子**:
|
||||
假设我们有一个 `Car` 类和一个 `Truck` 类,都继承自 `Vehicle` 类。如果 `Car` 和 `Truck` 共享很多方法和属性,这样的设计可能是合适的。但是,如果 `Car` 和 `Truck` 之间差异很大,仅通过继承来构建它们的关系,可能会导致继承层次过于复杂,代码阅读和理解变得困难。
|
||||
|
||||
### 4. **继承可能导致不易发现的错误**
|
||||
|
||||
由于子类继承了父类的行为,任何对父类的修改都有可能影响到子类的行为。更糟糕的是,错误或不一致的修改可能在父类中发生,而这些错误可能不会立即暴露出来,直到程序运行到某个特定的地方,才会显现出错误。
|
||||
|
||||
**例子**:
|
||||
假设你修改了父类的某个方法,但忘记更新或调整子类中相应的重写方法,这可能会导致难以发现的错误。
|
||||
|
||||
### 5. **继承限制了灵活性(不可重用性问题)**
|
||||
|
||||
继承创建了一个父类与子类之间的固定关系,这意味着如果你想在一个完全不同的上下文中重用一个类,你可能不能通过继承来实现。在某些情况下,组合比继承更为灵活,允许你将多个行为组合到一个类中,而不是通过继承来强行构建类的层次结构。
|
||||
|
||||
**例子**:
|
||||
|
||||
// 组合而非继承
|
||||
class Engine {
|
||||
void start() {
|
||||
System.out.println("Engine started");
|
||||
}
|
||||
}
|
||||
|
||||
class Car {
|
||||
private Engine engine = new Engine(); // 通过组合来使用 Engine
|
||||
void start() {
|
||||
engine.start();
|
||||
}
|
||||
}
|
||||
|
||||
通过组合,可以灵活地使用不同的组件,而不需要继承整个类。这样做的优点是更具扩展性和灵活性。
|
||||
|
||||
### 6. **继承限制了方法的重用(可维护性差)**
|
||||
|
||||
如果你过度依赖继承,你的代码会容易受到父类实现的限制,难以灵活地添加新功能或进行扩展。例如,在继承链中添加新的功能可能会导致一大堆方法的修改和重写,而不通过继承,可以更轻松地将功能作为独立模块来重用。
|
||||
|
||||
### 7. **使用接口和组合更优**
|
||||
|
||||
相比继承,**接口(Interface)** 和 **组合(Composition)** 更符合面向对象设计的原则。接口允许类只暴露所需的功能,而不暴露实现细节,组合则允许你将多个不同的行为组合在一起,使得系统更加灵活和可扩展。通过接口和组合,可以避免继承的许多问题。
|
||||
|
||||
**推荐设计模式**:
|
||||
|
||||
- **策略模式(Strategy Pattern)**:通过接口和组合来替代继承。
|
||||
- **装饰器模式(Decorator Pattern)**:使用组合和代理来扩展行为,而非通过继承。
|
||||
|
||||
### 小结
|
||||
|
||||
尽管继承是面向对象编程中的一个重要特性,但滥用继承可能带来许多问题,特别是在以下几个方面:
|
||||
|
||||
- 增加类之间的耦合,降低灵活性;
|
||||
- 破坏封装性,暴露不应访问的内部实现;
|
||||
- 可能导致类层次结构复杂,增加理解和维护的难度;
|
||||
- 限制代码的重用和扩展性。
|
||||
|
||||
因此,**推荐优先使用组合而非继承**,并尽可能使用接口来实现灵活的扩展。如果必须使用继承,确保它能够清晰地表达“是一个”的关系,并避免过深的继承层次。
|
||||
|
||||
## 12. 为什么禁止开发人员修改 serialVersionUID 字段的值?
|
||||
|
||||
`serialVersionUID` 是 Java 中用来标识序列化版本的一个静态字段。它的作用是确保在反序列化时,JVM 可以验证序列化的类与当前类的兼容性,以避免版本不兼容导致的错误。尽管 `serialVersionUID` 可以由开发人员手动定义,**禁止开发人员修改 `serialVersionUID` 字段的值** 的原因如下:
|
||||
|
||||
### 1. **序列化与反序列化兼容性**
|
||||
|
||||
`serialVersionUID` 的主要作用是保证在序列化和反序列化过程中,类的版本兼容性。它是用来标识类的版本的,如果序列化和反序列化过程中使用的类的 `serialVersionUID` 不匹配,就会抛出 `InvalidClassException`。
|
||||
|
||||
- **不匹配的 `serialVersionUID`** 会导致序列化的数据与当前类不兼容,导致反序列化失败。
|
||||
- **修改 `serialVersionUID`** 的值会改变类的版本标识,导致已序列化的数据在反序列化时不能成功读取,特别是在类结构发生改变(例如添加或删除字段)时。
|
||||
|
||||
**例如:**
|
||||
|
||||
// 类的第一次版本
|
||||
public class MyClass implements Serializable {
|
||||
private static final long serialVersionUID = 1L;
|
||||
private String name;
|
||||
// 其他字段和方法
|
||||
}
|
||||
|
||||
// 类的第二次修改版本
|
||||
public class MyClass implements Serializable {
|
||||
private static final long serialVersionUID = 2L; // 修改了 serialVersionUID
|
||||
private String name;
|
||||
private int age; // 新增字段
|
||||
// 其他字段和方法
|
||||
}
|
||||
|
||||
如果修改了 `serialVersionUID`,而之前序列化的数据是使用版本 1 的类进行序列化的,反序列化时会因为 `serialVersionUID` 不匹配而导致失败。
|
||||
|
||||
### 2. **避免不必要的版本冲突**
|
||||
|
||||
Java 会根据类的字段、方法等信息自动生成 `serialVersionUID`,这个值是基于类的结构计算出来的。如果开发人员修改了 `serialVersionUID`,可能会破坏 Java 自动生成的版本控制机制,从而导致版本控制不一致,增加了维护复杂性。
|
||||
|
||||
如果手动修改 `serialVersionUID`,容易出现以下几种问题:
|
||||
|
||||
- 由于类结构没有变化,修改 `serialVersionUID` 可能会导致已序列化的数据无法恢复。
|
||||
- 如果不同的开发人员修改了 `serialVersionUID`,可能会在不同的机器或系统间引起序列化不一致。
|
||||
|
||||
### 3. **影响序列化兼容性**
|
||||
|
||||
Java 提供了两种主要的兼容性规则:
|
||||
|
||||
- **兼容性向前**:如果类的字段或方法发生改变,但没有改变 `serialVersionUID`,则反序列化是可以工作的。
|
||||
- **兼容性向后**:如果你修改了类的结构(如字段变动、方法签名改变等),并且保持相同的 `serialVersionUID`,反序列化仍然可以工作。
|
||||
|
||||
如果不小心修改了 `serialVersionUID`,可能导致以下情况:
|
||||
|
||||
- **向前兼容性**:新版本的类不能兼容老版本的对象,导致反序列化失败。
|
||||
- **向后兼容性**:老版本的类无法反序列化新版本的对象。
|
||||
|
||||
### 4. **自动生成 vs 手动指定**
|
||||
|
||||
- **自动生成的 `serialVersionUID`**:Java 会根据类的结构自动生成 `serialVersionUID`,这样如果类的结构发生变化,`serialVersionUID` 会自动变化,确保不兼容的版本之间不会出现意外的反序列化行为。
|
||||
- **手动指定 `serialVersionUID`**:手动修改 `serialVersionUID` 可能导致版本控制不一致,特别是在多人开发、分布式部署的环境中,容易出现反序列化失败的问题。
|
||||
|
||||
### 5. **避免非预期的反序列化问题**
|
||||
|
||||
手动修改 `serialVersionUID` 可能会导致数据丢失或反序列化时抛出异常。例如,如果开发人员错误地修改了 `serialVersionUID`,系统在尝试反序列化时可能会因为 `serialVersionUID` 不匹配而无法成功加载对象,导致异常的发生。
|
||||
|
||||
### 小结
|
||||
|
||||
**禁止开发人员修改 `serialVersionUID` 字段的值,主要是为了:**
|
||||
|
||||
- **确保序列化与反序列化的兼容性**,避免版本不匹配导致反序列化失败。
|
||||
- **避免不必要的版本冲突和数据丢失**,特别是在类结构修改时。
|
||||
- **保持 Java 自动管理 `serialVersionUID` 的优势**,保证类的版本一致性和可维护性。
|
||||
|
||||
如果确实需要修改 `serialVersionUID`,应确保修改后的版本与已经序列化的数据兼容,并遵循合理的版本管理策略。
|
||||
|
||||
## 13. 为什么禁止开发人员使用 isSuccess 作为变量名?
|
||||
|
||||
禁止开发人员使用 `isSuccess` 作为变量名,主要是为了遵循更好的编程规范和提高代码的可读性、可维护性。这个变量名问题的核心在于其容易引起歧义和混淆。具体原因如下:
|
||||
|
||||
### 1. **不符合布尔值命名约定**
|
||||
|
||||
在 Java 中,通常使用 `is` 或 `has` 开头的变量名来表示布尔值(`boolean` 类型)。这类命名通常遵循特定的语义约定,表示某个条件是否成立。例如:
|
||||
|
||||
- `isEnabled` 表示某个功能是否启用;
|
||||
- `hasPermission` 表示是否有权限。
|
||||
|
||||
**问题**:
|
||||
|
||||
- `isSuccess` 看起来像一个布尔值(`boolean` 类型),但它实际上可能并不直接表示一个布尔值,而是一个状态或结果。这种命名可能会导致混淆,开发者可能误以为它是布尔类型的变量,而实际上它可能是一个描述状态的对象、字符串或者其他类型的数据。
|
||||
|
||||
### 2. **语义不明确**
|
||||
|
||||
`isSuccess` 这个名字表面上表示“是否成功”,但是它缺少具体的上下文,导致语义不够明确。真正表示是否成功的布尔值应该直接使用 `boolean` 类型的变量,并且使用清晰明确的命名。
|
||||
|
||||
例如:
|
||||
|
||||
- `isCompleted`:表示某个任务是否完成。
|
||||
- `isSuccessful`:表示某个操作是否成功。
|
||||
|
||||
这些命名能更明确地表达布尔变量的含义,避免理解上的歧义。
|
||||
|
||||
### 3. **与标准的 `is` 前缀混淆**
|
||||
|
||||
`is` 前缀通常用来表示“是否”某个条件成立,适用于返回布尔值的方法或者变量。`isSuccess` 这样的命名会让开发人员误以为它是一个布尔值,或者一个 `boolean` 类型的值,但实际上它可能是一个复杂类型或者其他非布尔类型,造成不必要的混淆。
|
||||
|
||||
例如:
|
||||
|
||||
boolean isSuccess = someMethod(); // 看起来是布尔值,但实际类型可能不同
|
||||
|
||||
这种情况可能导致开发人员产生误解,认为 `isSuccess` 代表的是布尔值,但它可能是某个表示成功的对象、枚举或者其他数据类型。
|
||||
|
||||
### 4. **更好的命名建议**
|
||||
|
||||
为了避免歧义和混淆,开发人员应使用更加明确且符合命名规范的名称。以下是一些命名的改进建议:
|
||||
|
||||
- 如果是布尔值,命名为 `isSuccessful` 或 `wasSuccessful`。
|
||||
- 如果是表示结果的对象,使用更具体的名称,例如 `operationResult` 或 `statusCode`,以表明它是一个描述操作结果的变量。
|
||||
|
||||
### 5. **提升代码的可读性和可维护性**
|
||||
|
||||
清晰且具有意义的命名能够帮助团队成员或未来的开发者更快地理解代码的意图。如果变量名过于模糊(如 `isSuccess`),就可能让人对其实际含义产生疑问,尤其是在阅读较大或复杂的代码时。良好的命名能够提升代码的可读性和可维护性。
|
||||
|
||||
### 小结
|
||||
|
||||
- **`isSuccess`** 这样的命名不清晰,容易与布尔类型的变量产生混淆,进而影响代码的可读性。
|
||||
- **命名应尽量明确**,避免使用容易引起歧义的名称,特别是在布尔值类型的命名时。
|
||||
- 建议使用更具描述性的名称,如 **`isSuccessful`** 或 **`wasSuccessful`**,更清晰地表达变量的意义。
|
||||
|
||||
## 最后
|
||||
|
||||
以上是 V 哥精心总结的13个 Java 编程中的小小编码问题,也是V 哥日常编码中总结的学习笔记,分享给大家,如果内容对你有帮助,请不要吝啬来个小赞呗,关注威哥爱编程,Java 路上,你我相伴前行。
|
||||
@@ -0,0 +1,710 @@
|
||||
|
||||
|
||||

|
||||
|
||||
> 大家好,我是 V 哥。今天看了阿里云开发者社区关于 Java 的灵魂拷问,一线大厂在用 Java 时,都会考虑哪些问题呢,对于工作多年,又没有大厂经历的小伙伴不妨看看,V 哥总结的这13个为什么,你都会哪些?先赞后看,绝不摆烂。
|
||||
|
||||
## 1. 为什么禁止使用 BigDecimal 的 equals 方法做等值比较?
|
||||
|
||||
`BigDecimal` 的 `equals` 方法在等值比较时存在一些问题,通常不建议直接使用它来判断数值的相等性。下面是主要原因以及推荐的替代方案:
|
||||
|
||||
### 1. `equals` 方法比较严格,包含了精度和符号的比较
|
||||
|
||||
`BigDecimal.equals` 不仅比较数值本身,还会比较精度和符号。例如,`BigDecimal` 的 `equals` 方法会认为 `1.0` 和 `1.00` 是不同的值,因为它们的 `scale` 不同(即小数位数不同)。例如:
|
||||
|
||||
BigDecimal a = new BigDecimal("1.0");
|
||||
BigDecimal b = new BigDecimal("1.00");
|
||||
|
||||
System.out.println(a.equals(b)); // 输出 false
|
||||
|
||||
尽管 `1.0` 和 `1.00` 数值上是相等的,但 `equals` 方法会因为精度不同返回 `false`。
|
||||
|
||||
### 2. `equals` 方法会区分正负零
|
||||
|
||||
在 `BigDecimal` 中,正零 (`0.0`) 和负零 (`-0.0`) 是不相等的,而使用 `equals` 会导致 `0.0` 和 `-0.0` 被视为不相等。例如:
|
||||
|
||||
BigDecimal zero1 = new BigDecimal("0.0");
|
||||
BigDecimal zero2 = new BigDecimal("-0.0");
|
||||
|
||||
System.out.println(zero1.equals(zero2)); // 输出 false
|
||||
|
||||
这可能会导致误判,因为在大多数业务逻辑中,我们认为 `0.0` 和 `-0.0` 是等值的。
|
||||
|
||||
### 推荐的替代方案:使用 `compareTo` 方法
|
||||
|
||||
为了避免这些问题,建议使用 `BigDecimal.compareTo` 方法。`compareTo` 方法仅比较数值的大小,不关注精度和符号。因此,在需要判断两个 `BigDecimal` 是否等值时,使用 `compareTo` 更为合理:
|
||||
|
||||
BigDecimal a = new BigDecimal("1.0");
|
||||
BigDecimal b = new BigDecimal("1.00");
|
||||
|
||||
System.out.println(a.compareTo(b) == 0); // 输出 true
|
||||
|
||||
在这种情况下,`1.0` 和 `1.00` 被视为相等,即使它们的精度不同,`compareTo` 也会返回 `0`。
|
||||
|
||||
### 小结
|
||||
|
||||
- **不要使用 `equals` 方法**:它会考虑精度和符号,容易导致误判。
|
||||
- **推荐使用 `compareTo` 方法**:只比较数值,忽略精度和正负零的差异,可以实现更符合业务需求的等值比较。
|
||||
|
||||
## 2. 为什么禁止使用double直接构造BigDecimal?
|
||||
|
||||
在使用 `BigDecimal` 时,不建议直接使用 `double` 作为构造参数。这是因为 `double` 类型在 Java 中的表示是基于二进制浮点数的,会引入精度误差,从而导致不准确的结果。例如:
|
||||
|
||||
double d = 0.1;
|
||||
BigDecimal bd = new BigDecimal(d);
|
||||
System.out.println(bd); // 输出 0.1000000000000000055511151231257827021181583404541015625
|
||||
|
||||
### 原因解析
|
||||
|
||||
1. **二进制浮点数的精度问题**
|
||||
`double` 使用 IEEE 754 标准表示小数,在二进制系统中,像 `0.1` 这样的小数无法精确表示,导致它在存储时会变成一个近似值。这个近似值会直接传递给 `BigDecimal` 的构造方法,从而生成带有误差的 `BigDecimal` 值。
|
||||
2. **结果不准确,影响业务计算**
|
||||
在一些金融计算或其他对精度要求高的场景中,直接使用 `double` 构造 `BigDecimal` 会带来潜在的误差积累,从而影响最终的结果。例如,在多次计算或累加时,误差可能不断放大。
|
||||
|
||||
### 推荐的替代方案
|
||||
|
||||
- **使用字符串或精确值构造 `BigDecimal`**
|
||||
通过传入字符串形式的数字,可以避免精度误差,因为字符串构造器不会引入任何二进制的近似计算。
|
||||
|
||||
BigDecimal bd = new BigDecimal("0.1");
|
||||
System.out.println(bd); // 输出 0.1
|
||||
|
||||
- **使用 `BigDecimal.valueOf(double)` 方法**
|
||||
另一个安全的方式是使用 `BigDecimal.valueOf(double)`,该方法会将 `double` 转换为 `String` 表示,然后构造 `BigDecimal`,从而避免精度损失。
|
||||
|
||||
BigDecimal bd = BigDecimal.valueOf(0.1);
|
||||
System.out.println(bd); // 输出 0.1
|
||||
|
||||
### 小结
|
||||
|
||||
- **避免直接使用 `double` 构造 `BigDecimal`**,以免引入二进制浮点数的精度误差。
|
||||
- **优先使用字符串构造器**,或使用 `BigDecimal.valueOf(double)` 以确保精度。
|
||||
|
||||
## 3. 为什么禁止使用 Apache Beanutils 进行属性的 copy ?
|
||||
|
||||
`Apache BeanUtils` 是一个早期用于 Java Bean 属性复制的工具库,但在现代 Java 开发中通常不推荐使用它来进行属性的拷贝,尤其在性能敏感的场景中。原因主要包括以下几点:
|
||||
|
||||
### 1. **性能问题**
|
||||
|
||||
`Apache BeanUtils.copyProperties()` 使用了大量的反射操作,且每次拷贝都需要对字段、方法进行查找和反射调用。反射机制虽然灵活,但性能较低,尤其是在大量对象或频繁拷贝的场景中,会产生显著的性能瓶颈。
|
||||
|
||||
相比之下,`Spring BeanUtils` 或 `Apache Commons Lang` 的 `FieldUtils` 等工具经过优化,使用了更高效的方式进行属性复制。在性能要求较高的场合,`MapStruct` 或 `Dozer` 等编译期代码生成的方式则可以完全避免运行时反射。
|
||||
|
||||
### 2. **类型转换问题**
|
||||
|
||||
`BeanUtils.copyProperties` 在属性类型不匹配时会隐式地进行类型转换。例如,将 `String` 类型的 `"123"` 转换为 `Integer`,如果转换失败,会抛出异常。这种隐式转换在处理数据时,可能带来不易察觉的错误,而且并不总是适合应用场景。
|
||||
|
||||
在精确的属性复制需求下,通常希望类型不匹配时直接跳过拷贝,或明确抛出错误,而不是隐式转换。例如,`Spring BeanUtils.copyProperties` 不会进行隐式转换,适合严格的属性匹配场景。
|
||||
|
||||
### 3. **潜在的安全问题**
|
||||
|
||||
`Apache BeanUtils` 的 `PropertyUtils` 组件在执行反射操作时存在一定的安全隐患。历史上,`BeanUtils` 的 `PropertyUtils` 曾有安全漏洞,使恶意用户可以通过精心构造的输入利用反射机制执行系统命令或加载恶意类。尽管这些漏洞在现代版本中已得到修复,但该库的架构和实现仍较为陈旧,难以应对更高的安全需求。
|
||||
|
||||
### 4. **缺乏对嵌套对象的深拷贝支持**
|
||||
|
||||
`BeanUtils.copyProperties` 仅支持浅拷贝,即只能复制对象的一级属性,无法递归地对嵌套对象进行复制。如果对象包含了复杂的嵌套结构,使用 `BeanUtils.copyProperties` 很容易出现意外行为或数据丢失。像 `MapStruct` 或 `Dozer` 这样的工具则提供对嵌套对象的深层复制能力,更适合复杂对象的深度拷贝需求。
|
||||
|
||||
### 推荐的替代方案
|
||||
|
||||
1. **Spring `BeanUtils.copyProperties()`**
|
||||
Spring 的 `BeanUtils.copyProperties()` 提供了更优的性能和更好的类型安全性。它不做类型转换,且提供了方便的过滤器用于选择性拷贝属性。
|
||||
2. **MapStruct**
|
||||
`MapStruct` 是基于注解的对象映射框架,支持编译期生成代码,完全避免了反射的性能开销,且支持复杂对象、嵌套属性的深度拷贝,是性能要求较高的首选。
|
||||
3. **Dozer**
|
||||
`Dozer` 支持更灵活的映射配置和深拷贝,适合对象结构复杂的情况。它可以处理嵌套属性映射、类型转换,且具有较好的自定义能力。
|
||||
|
||||
### 小结
|
||||
|
||||
`Apache BeanUtils.copyProperties` 不适合现代 Java 开发的性能、安全性和灵活性要求,推荐使用更高效、安全、灵活的框架(如 Spring `BeanUtils`、`MapStruct` 等)来代替。
|
||||
|
||||
## 4. 为什么要求日期格式化时必须有使用 y 表示年,而不能用 Y ?
|
||||
|
||||
在日期格式化中,必须使用 `y` 而不是 `Y` 来表示年份,这是因为 `y` 和 `Y` 在 Java 和其他日期格式化工具中代表不同的含义:
|
||||
|
||||
1. **`y` 表示日历年(Calendar Year)**
|
||||
`y` 是标准的表示年份的字符,表示的是通常意义上的公历年,比如 `2024` 表示的就是这一年的年份。使用 `y` 时,日期格式化工具会准确地格式化出对应的年份数值:
|
||||
|
||||
SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd");
|
||||
System.out.println(sdf.format(new Date())); // 输出: 2024-11-10
|
||||
|
||||
2. **`Y` 表示星期年(Week Year)**
|
||||
`Y` 表示的是“星期年”或称“ISO周年”(ISO week-numbering year),它是一种基于ISO周数的年份表示方式。这种表示法根据每年的第一个星期一所在的周来计算年份,如果某天属于新一年的第一个完整星期,则会归为新年的星期年。
|
||||
|
||||
例如,如果某年的最后几天在下一年开始的第一个星期中,它们可能会被归入下一年的 `week year`。同理,如果新年的前几天在上一年的最后一个完整星期内,这些天的星期年可能会归属上一年。这在日期和时间处理中可能导致意外的年份差异。
|
||||
|
||||
|
||||
SimpleDateFormat sdf = new SimpleDateFormat("YYYY-MM-dd");
|
||||
System.out.println(sdf.format(new Date())); // 可能输出与实际年份不同的值
|
||||
|
||||
### 使用 `Y` 的潜在问题
|
||||
|
||||
使用 `Y` 表示年份会引发一些日期计算的错误,因为它依赖于周数的计算方式,不是每次都与实际的公历年份一致。例如:
|
||||
|
||||
- 2024年12月31日会被视作 `2025` 的 `week year`,导致使用 `YYYY` 格式化时得到 `2025-12-31`。
|
||||
- 在跨年计算或特定日期逻辑中使用 `Y` 表示年份可能会出现错误,因为 `week year` 与通常理解的日历年并不总是相符。
|
||||
|
||||
### 什么时候使用 `Y`
|
||||
|
||||
`Y` 一般仅用于需要符合 ISO 8601 标准的日期格式,特别是包含 ISO 周数(如“2024-W01-1”表示2024年的第一个星期一)的情况,而在一般情况下,我们都应使用 `y` 来表示日历年份。
|
||||
|
||||
### 小结
|
||||
|
||||
- **使用 `y` 来表示常规年份**,避免日期格式化错误。
|
||||
- **避免使用 `Y` 来表示年份**,除非确实需要按照 ISO 周年的格式来解析和显示年份。
|
||||
|
||||
## 5. 为什么使用三目运算符时必需要注意类型对齐?
|
||||
|
||||
在使用三目运算符时,类型对齐非常重要,因为三目运算符的两个分支会被类型推断成一个共同的类型。若两者类型不同,Java 编译器会进行类型提升或自动转换,这可能导致意外的类型变化和潜在的错误。以下是需要注意的原因和细节:
|
||||
|
||||
### 1. 三目运算符会自动进行类型提升
|
||||
|
||||
三目运算符的返回值类型是根据 `true` 和 `false` 分支的类型推断出来的。为了得到一致的结果,Java 会自动将不同的类型提升为更高精度的类型。例如,若一个分支返回 `int` 而另一个分支返回 `double`,Java 会将 `int` 提升为 `double`:
|
||||
|
||||
int x = 5;
|
||||
double y = 10.5;
|
||||
double result = (x > 0) ? x : y; // 返回 double 类型
|
||||
System.out.println(result); // 输出 5.0
|
||||
|
||||
这里返回值 `5` 被提升为 `5.0`。虽然代码在这个例子中不会出错,但在某些情况下,这种自动提升会导致意外的精度损失或类型不匹配的问题。
|
||||
|
||||
### 2. 自动拆箱和装箱可能引发 `NullPointerException`
|
||||
|
||||
在 Java 中,基本类型和包装类型的对齐需要特别小心。三目运算符会尝试将包装类型和基本类型对齐成相同类型,这会导致自动装箱和拆箱,如果某个分支为 `null` 且需要拆箱,可能会引发 `NullPointerException`:
|
||||
|
||||
Integer a = null;
|
||||
int b = 10;
|
||||
int result = (a != null) ? a : b; // 如果 a 为 null,结果会发生自动拆箱,引发 NullPointerException
|
||||
|
||||
由于 `a` 为 `null`,Java 会尝试将其拆箱为 `int`,从而抛出 `NullPointerException`。为避免这种情况,可以确保类型对齐,或避免对可能为 `null` 的对象进行拆箱。
|
||||
|
||||
### 3. 返回值类型不一致可能导致编译错误
|
||||
|
||||
如果三目运算符的两种返回类型无法被编译器自动转换为一个兼容类型,代码会直接报错。例如:
|
||||
|
||||
int x = 5;
|
||||
String y = "10";
|
||||
Object result = (x > 0) ? x : y; // 编译错误:int 和 String 不兼容
|
||||
|
||||
在这种情况下,`int` 和 `String` 无法被提升到相同类型,因此会引发编译错误。若确实希望返回不同类型的值,可以手动指定共同的超类型,例如将结果定义为 `Object` 类型:
|
||||
|
||||
Object result = (x > 0) ? Integer.valueOf(x) : y; // 这里 result 为 Object
|
||||
|
||||
### 4. 类型对齐可以提升代码的可读性
|
||||
|
||||
保持三目运算符返回的类型一致,能让代码更加清晰,便于理解和维护。类型对齐可以避免类型转换和自动提升带来的混乱,使代码更容易预测和理解:
|
||||
|
||||
double result = (condition) ? 1.0 : 0.0; // 返回 double
|
||||
|
||||
### 小结
|
||||
|
||||
- **保持类型一致性**,确保 `true` 和 `false` 分支的类型相同,避免意外的类型提升。
|
||||
- **小心自动装箱和拆箱**,避免 `null` 参与三目运算符计算。
|
||||
- **在返回不同类型时选择合适的公共类型**,如使用 `Object` 或显式转换。
|
||||
|
||||
## 6. 为什么建议初始化 HashMap 的容量大小?
|
||||
|
||||
初始化 `HashMap` 的容量大小是为了提高性能和减少内存浪费。通过设置合适的初始容量,可以减少 `HashMap` 的扩容次数,提高程序运行效率。以下是详细原因和建议:
|
||||
|
||||
### 1. 减少扩容次数,提高性能
|
||||
|
||||
`HashMap` 默认的初始容量为 16,当超过负载因子阈值(默认是 0.75,即达到容量的 75%)时,`HashMap` 会自动进行扩容操作,将容量扩大为原来的两倍。扩容涉及到重新计算哈希并将数据重新分布到新的桶中,这个过程非常耗时,尤其在元素较多时,扩容会显著影响性能。
|
||||
|
||||
通过设置合适的初始容量,可以避免或减少扩容操作,提高 `HashMap` 的存取效率。
|
||||
|
||||
### 2. 节省内存,避免不必要的内存开销
|
||||
|
||||
如果预计要存储大量数据但没有指定容量,`HashMap` 可能会多次扩容,每次扩容会分配新的内存空间,并将原有数据复制到新空间中,造成内存浪费。如果在创建 `HashMap` 时能合理估算其容量,则可以一次性分配足够的空间,从而避免重复分配内存带来的资源浪费。
|
||||
|
||||
### 3. 避免扩容带来的线程安全问题
|
||||
|
||||
在并发环境下,频繁扩容可能导致线程不安全,即使是 `ConcurrentHashMap` 也不能完全避免扩容带来的性能和一致性问题。初始化合适的容量可以减少并发环境下扩容带来的风险。
|
||||
|
||||
### 如何估算合适的容量
|
||||
|
||||
1. **预估数据量**:如果预计 `HashMap` 将存储 `n` 个元素,可以将初始容量设置为 `(n / 0.75)`,再向上取整为最接近的 2 的幂次方。
|
||||
|
||||
int initialCapacity = (int) Math.ceil(n / 0.75);
|
||||
Map<String, String> map = new HashMap<>(initialCapacity);
|
||||
|
||||
2. **取 2 的幂次方**:`HashMap` 的容量总是以 2 的幂次方增长,因为在进行哈希运算时,可以高效利用按位与操作来计算哈希桶索引。因此,初始容量设为 2 的幂次方会使哈希分布更均匀。
|
||||
|
||||
### 示例代码
|
||||
|
||||
int expectedSize = 1000; // 预估需要存储的键值对数量
|
||||
int initialCapacity = (int) Math.ceil(expectedSize / 0.75);
|
||||
HashMap<String, Integer> map = new HashMap<>(initialCapacity);
|
||||
|
||||
### 小结
|
||||
|
||||
初始化 `HashMap` 的容量大小有以下好处:
|
||||
|
||||
- **提高性能**:减少扩容次数,优化存取效率。
|
||||
- **节省内存**:避免多次扩容引起的内存浪费。
|
||||
- **提升线程安全**:在并发环境下减少扩容带来的线程不安全风险。
|
||||
|
||||
合理初始化 `HashMap` 容量对于高性能应用尤为重要,尤其在存储大量数据时可以显著提升程序的运行效率。
|
||||
|
||||
## 7. 为什么禁止使用 Executors 创建线程池?
|
||||
|
||||
在 Java 中创建线程池时,不推荐直接使用 `Executors` 提供的快捷方法(例如 `Executors.newFixedThreadPool()`、`Executors.newCachedThreadPool()` 等),而推荐使用 `ThreadPoolExecutor` 构造方法来手动配置线程池。这种做法主要是为了避免 `Executors` 创建线程池时隐藏的风险,确保线程池配置符合需求。具体原因如下:
|
||||
|
||||
### 1. **不透明的任务队列长度导致OOM风险**
|
||||
|
||||
- **`newFixedThreadPool()` 和 `newSingleThreadExecutor()`** 使用的是**无界队列** `LinkedBlockingQueue`。无界队列可以存放无限数量的任务,一旦任务量非常大,队列会迅速占用大量内存,导致 **OutOfMemoryError**(OOM)。
|
||||
- **`newCachedThreadPool()`** 使用的是 **SynchronousQueue**,该队列没有存储任务的能力,每个任务到来时必须立即有一个空闲线程来处理任务,否则将创建一个新线程。当任务到达速度超过线程销毁速度时,线程数量会快速增加,导致 **OOM**。
|
||||
|
||||
### 2. **线程数无法控制,导致资源耗尽**
|
||||
|
||||
在 `newCachedThreadPool()` 创建的线程池中,线程数没有上限,短时间内大量请求会导致线程数暴增,耗尽系统资源。`newFixedThreadPool()` 和 `newSingleThreadExecutor()` 虽然限制了核心线程数,但未限制任务队列长度,依然可能耗尽内存。
|
||||
|
||||
在业务需求不确定或任务激增的场景下,建议明确限制线程池的最大线程数和队列长度,以更好地控制系统资源的使用,避免因线程数无法控制导致的性能问题。
|
||||
|
||||
### 3. **缺乏合理的拒绝策略控制**
|
||||
|
||||
- `Executors` 创建的线程池默认使用 `AbortPolicy` 拒绝策略,即当线程池达到饱和时会抛出 `RejectedExecutionException` 异常。
|
||||
- 不同的业务场景可能需要不同的拒绝策略,例如可以使用 `CallerRunsPolicy`(让提交任务的线程执行任务)或 `DiscardOldestPolicy`(丢弃最旧的任务)来平衡任务处理。
|
||||
|
||||
手动创建 `ThreadPoolExecutor` 时,可以指定适合业务需求的拒绝策略,从而更灵活地处理线程池满载的情况,避免异常或系统性能下降。
|
||||
|
||||
### 4. **灵活配置核心参数**
|
||||
|
||||
使用 `ThreadPoolExecutor` 的构造方法可以手动设置以下参数,以便根据业务需求灵活配置线程池:
|
||||
|
||||
- **corePoolSize**:核心线程数,避免空闲线程被频繁销毁和重建。
|
||||
- **maximumPoolSize**:最大线程数,控制线程池能使用的最大资源。
|
||||
- **keepAliveTime**:非核心线程的存活时间,适合控制线程销毁频率。
|
||||
- **workQueue**:任务队列类型和长度,便于管理任务积压的情况。
|
||||
|
||||
这些参数的合理配置可以有效平衡线程池的性能、资源占用和任务处理能力,避免使用默认配置时不符合需求的情况。
|
||||
|
||||
### 推荐的线程池创建方式
|
||||
|
||||
建议直接使用 `ThreadPoolExecutor` 构造方法配置线程池,例如:
|
||||
|
||||
int corePoolSize = 10;
|
||||
int maximumPoolSize = 20;
|
||||
long keepAliveTime = 60L;
|
||||
BlockingQueue<Runnable> workQueue = new ArrayBlockingQueue<>(100);
|
||||
|
||||
ThreadPoolExecutor executor = new ThreadPoolExecutor(
|
||||
corePoolSize,
|
||||
maximumPoolSize,
|
||||
keepAliveTime,
|
||||
TimeUnit.SECONDS,
|
||||
workQueue,
|
||||
new ThreadPoolExecutor.CallerRunsPolicy() // 拒绝策略
|
||||
);
|
||||
|
||||
### 小结
|
||||
|
||||
使用 `Executors` 创建线程池会带来不易察觉的风险,可能导致系统资源耗尽或任务堆积,手动配置 `ThreadPoolExecutor` 可以更好地控制线程池的行为,使其符合实际业务需求和资源限制。因此,为了系统的健壮性和可控性,建议避免使用 `Executors` 快捷方法来创建线程池。
|
||||
|
||||
## 8. 为什么要求谨慎使用 ArrayList 中的 subList 方法?
|
||||
|
||||
在使用 `ArrayList` 的 `subList` 方法时需要谨慎,因为它有一些潜在的陷阱,容易导致意外的错误和难以排查的异常。以下是 `subList` 需要小心使用的原因和注意事项:
|
||||
|
||||
### 1. `subList` 返回的是视图,而不是独立副本
|
||||
|
||||
`ArrayList` 的 `subList` 方法返回的是原列表的一部分视图(`view`),而不是一个独立的副本。对 `subList` 的修改会直接影响原列表,反之亦然:
|
||||
|
||||
ArrayList<Integer> list = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));
|
||||
List<Integer> subList = list.subList(1, 4);
|
||||
subList.set(0, 10); // 修改 subList
|
||||
System.out.println(list); // 原列表也受到影响:[1, 10, 3, 4, 5]
|
||||
|
||||
这种共享视图的机制在某些场景中可能引发意外的修改,导致数据被意外改变,从而影响到原始数据结构的完整性和正确性。
|
||||
|
||||
### 2. `subList` 的结构性修改限制
|
||||
|
||||
当对 `ArrayList` 本身(而非 `subList` 视图)进行结构性修改(`add`、`remove` 等改变列表大小的操作)后,再操作 `subList` 会导致 `ConcurrentModificationException` 异常。这是因为 `subList` 和原 `ArrayList` 之间共享结构性修改的状态,一旦其中一个发生修改,另一方就会失效:
|
||||
|
||||
ArrayList<Integer> list = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));
|
||||
List<Integer> subList = list.subList(1, 4);
|
||||
list.add(6); // 修改原列表的结构
|
||||
subList.get(0); // 抛出 ConcurrentModificationException
|
||||
|
||||
这种限制意味着 `subList` 不适合在列表频繁变化的场景中使用,否则很容易引发并发修改异常。
|
||||
|
||||
### 3. `subList` 和 `ArrayList` 的 removeAll 等操作可能导致错误
|
||||
|
||||
`subList` 生成的视图列表可能会在批量删除操作中出现问题,例如调用 `removeAll` 方法时,`subList` 的行为不一致或发生异常。对于 `ArrayList` 的 `subList`,一些批量修改方法(如 `removeAll`、`retainAll`)可能会在删除视图元素后,导致 `ArrayList` 产生不可预料的状态,甚至引发 `IndexOutOfBoundsException` 等异常。
|
||||
|
||||
### 4. 推荐的安全使用方式
|
||||
|
||||
如果需要一个独立的子列表,可以通过 `new ArrayList<>(originalList.subList(start, end))` 来创建一个子列表的副本,从而避免 `subList` 的共享视图问题:
|
||||
|
||||
ArrayList<Integer> list = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));
|
||||
ArrayList<Integer> subListCopy = new ArrayList<>(list.subList(1, 4)); // 创建副本
|
||||
list.add(6); // 修改原列表
|
||||
subListCopy.get(0); // 安全,不会受到影响
|
||||
|
||||
### 小结
|
||||
|
||||
使用 `ArrayList` 的 `subList` 方法需要注意以下几点:
|
||||
|
||||
- **视图机制**:`subList` 只是原列表的视图,修改其中一个会影响另一个。
|
||||
- **结构性修改限制**:结构性修改原列表后再访问 `subList` 会抛出 `ConcurrentModificationException`。
|
||||
- **批量操作问题**:`subList` 的批量操作可能引发不可预料的错误。
|
||||
- **建议创建副本**:如需独立操作子列表,最好创建 `subList` 的副本以避免潜在问题。
|
||||
|
||||
谨慎使用 `subList` 可以避免意外的错误,提高代码的健壮性。
|
||||
|
||||
## 9. 为什么禁止在 foreach 循环里进行元素的 remove/add 操作?
|
||||
|
||||
在 Java 中,禁止在 `foreach` 循环中进行元素的 `remove` 或 `add` 操作,主要是因为这种操作可能导致 `ConcurrentModificationException` 异常,或者导致循环行为不符合预期。具体原因如下:
|
||||
|
||||
### 1. **`ConcurrentModificationException` 异常**
|
||||
|
||||
当你在 `foreach` 循环中直接修改集合(例如 `remove` 或 `add` 元素),会导致并发修改问题。`foreach` 循环底层使用了集合的 `Iterator` 来遍历元素。大多数集合类(如 `ArrayList`、`HashSet` 等)都会维护一个 `modCount` 计数器,表示集合的结构变更次数。当你在遍历时修改集合的结构(如删除或添加元素),`modCount` 会发生变化,而 `Iterator` 会检测到这种结构性修改,从而抛出 `ConcurrentModificationException` 异常,防止程序在多线程环境中出现意外行为。
|
||||
|
||||
例如:
|
||||
|
||||
List<String> list = new ArrayList<>(Arrays.asList("a", "b", "c", "d"));
|
||||
for (String s : list) {
|
||||
if (s.equals("b")) {
|
||||
list.remove(s); // 会抛出 ConcurrentModificationException
|
||||
}
|
||||
}
|
||||
|
||||
在上面的代码中,`foreach` 循环遍历 `list` 时,如果删除了元素 `b`,它会修改 `list` 的结构,从而导致 `Iterator` 检测到并发修改,抛出异常。
|
||||
|
||||
### 2. **不可预测的行为**
|
||||
|
||||
即使没有抛出 `ConcurrentModificationException`,在 `foreach` 循环中修改集合也会导致不可预测的行为。例如,`remove` 或 `add` 操作会改变集合的大小和内容,可能会影响迭代的顺序或导致遗漏某些元素,甚至造成死循环或跳过某些元素。
|
||||
|
||||
例如:
|
||||
|
||||
List<String> list = new ArrayList<>(Arrays.asList("a", "b", "c", "d"));
|
||||
for (String s : list) {
|
||||
if (s.equals("b")) {
|
||||
list.add("e"); // 修改集合的大小
|
||||
}
|
||||
System.out.println(s);
|
||||
}
|
||||
|
||||
在这个例子中,`add` 操作会向 `list` 中添加一个新元素 `"e"`,从而修改了集合的结构。因为 `foreach` 循环的内部实现使用了迭代器,它可能不会考虑到修改后的新元素,导致输出顺序或遍历结果与预期不同。
|
||||
|
||||
### 3. **迭代器的 `remove()` 方法**
|
||||
|
||||
如果需要在循环中删除元素,推荐使用 `Iterator` 显式地进行删除操作。`Iterator` 提供了一个安全的 `remove()` 方法,可以在遍历时安全地删除元素,而不会引发 `ConcurrentModificationException`。
|
||||
|
||||
例如:
|
||||
|
||||
List<String> list = new ArrayList<>(Arrays.asList("a", "b", "c", "d"));
|
||||
Iterator<String> iterator = list.iterator();
|
||||
while (iterator.hasNext()) {
|
||||
String s = iterator.next();
|
||||
if (s.equals("b")) {
|
||||
iterator.remove(); // 使用 Iterator 的 remove() 方法
|
||||
}
|
||||
}
|
||||
|
||||
使用 `Iterator.remove()` 可以安全地在遍历时删除元素,而不会抛出并发修改异常。
|
||||
|
||||
### 小结
|
||||
|
||||
在 `foreach` 循环中直接进行 `remove` 或 `add` 操作是不安全的,主要有以下原因:
|
||||
|
||||
- **`ConcurrentModificationException`**:直接修改集合会触发迭代器的并发修改检测,导致异常。
|
||||
- **不可预测的行为**:修改集合的结构可能导致元素遗漏、顺序错乱或程序逻辑出错。
|
||||
- **使用 `Iterator` 替代**:使用 `Iterator` 的 `remove()` 方法可以避免这些问题,实现安全的元素删除操作。
|
||||
|
||||
因此,正确的做法是使用 `Iterator` 显式地处理元素的删除或修改,而不是直接在 `foreach` 循环中进行修改。
|
||||
|
||||
## 10. 为什么禁止工程师直接使用日志系统 (Log4j、Logback) 中的 API ?
|
||||
|
||||
在很多工程实践中,**禁止工程师直接使用日志系统(如 Log4j、Logback)中的 API**,主要是出于以下几个原因:
|
||||
|
||||
### 1. **日志配置与实现的分离**
|
||||
|
||||
直接使用日志系统的 API 可能会导致日志记录逻辑与应用的业务逻辑紧密耦合,使得日志配置和实现的分离变得困难。现代的日志框架(如 Log4j、Logback)允许通过外部配置文件(如 `log4j.xml` 或 `logback.xml`)灵活配置日志级别、输出格式、输出位置等,而不是硬编码到应用代码中。直接使用日志 API 会导致日志的配置与业务代码绑定在一起,不易修改和维护。
|
||||
|
||||
**建议的做法**:通过使用日志框架的日志抽象接口(如 `org.slf4j.Logger`)来记录日志,而不是直接依赖具体的日志实现。这种方式提供了更大的灵活性,日志实现可以在运行时通过配置文件更换而无需修改代码。
|
||||
|
||||
### 2. **灵活性与可扩展性问题**
|
||||
|
||||
如果工程师直接使用日志库的 API,项目在需要切换日志框架(比如从 Log4j 转换到 Logback 或其他框架)时,需要修改大量的代码,增加了系统的耦合度和维护难度。另一方面,使用日志抽象层(如 SLF4J)可以避免这一问题,因为 SLF4J 是一个日志抽象层,底层可以切换具体的日志实现而无需改变业务代码。
|
||||
|
||||
**示例**:
|
||||
|
||||
// 不推荐:直接使用 Log4j 的 API
|
||||
import org.apache.log4j.Logger;
|
||||
Logger logger = Logger.getLogger(MyClass.class);
|
||||
logger.info("This is a log message");
|
||||
|
||||
// 推荐:通过 SLF4J 接口来记录日志
|
||||
import org.slf4j.Logger;
|
||||
import org.slf4j.LoggerFactory;
|
||||
Logger logger = LoggerFactory.getLogger(MyClass.class);
|
||||
logger.info("This is a log message");
|
||||
|
||||
使用 SLF4J 可以在不同的环境中灵活切换日志实现,而无需修改代码。
|
||||
|
||||
### 3. **日志记录与调试不一致**
|
||||
|
||||
如果工程师直接使用日志框架的 API,可能会在日志记录时不遵循一致的日志策略。例如,日志的级别、格式、日志输出的内容等可能不统一,导致日志信息混乱、不易追踪。通过统一的日志抽象接口(如 SLF4J)和规范的日志记录策略(通过 AOP 或日志框架自带的特性)可以保持日志的一致性和规范性。
|
||||
|
||||
**最佳实践**:
|
||||
|
||||
- 通过统一的日志管理类或工具类来封装日志记录方法,确保所有日志记录都遵循统一的格式和规范。
|
||||
- 在日志中统一使用适当的日志级别(如 `DEBUG`、`INFO`、`WARN`、`ERROR`)和标准格式。
|
||||
|
||||
### 4. **日志的性能影响**
|
||||
|
||||
日志记录可能对应用的性能产生一定的影响,尤其是在日志记录过于频繁或日志输出内容过多的情况下。通过直接使用日志框架的 API,可能无法灵活控制日志输出的频率、内容或过滤策略,从而造成性能问题。很多日志框架(如 Log4j 和 Logback)提供了高级的配置选项,如异步日志、日志缓存等特性,可以显著提高性能。
|
||||
|
||||
**推荐做法**:
|
||||
|
||||
- 使用日志框架提供的异步日志功能来提高性能。
|
||||
- 配置适当的日志级别,避免在生产环境中输出过多的调试信息。
|
||||
|
||||
### 5. **日志管理的统一性与规范**
|
||||
|
||||
在团队开发中,直接使用日志框架的 API 会导致不同开发人员在不同模块中记录日志时不遵循统一规范,导致日志格式不统一、信息不一致,甚至产生重复的日志记录。通过日志管理工具类或封装类,可以确保所有开发人员遵循统一的日志记录策略。
|
||||
|
||||
**示例**:
|
||||
|
||||
- 创建一个统一的 `LoggerFactory` 工厂类来生成日志记录对象。
|
||||
- 统一定义日志级别和输出格式,确保日志输出一致。
|
||||
|
||||
### 小结
|
||||
|
||||
禁止工程师直接使用日志系统(如 Log4j、Logback)中的 API,主要是为了:
|
||||
|
||||
1. **解耦日志实现与业务逻辑**:通过使用日志抽象层(如 SLF4J),可以更轻松地切换日志框架,避免硬编码。
|
||||
2. **提高灵活性与可维护性**:避免在应用中重复使用框架 API,提高日志配置的灵活性和一致性。
|
||||
3. **规范日志记录行为**:通过封装日志记录,确保日志级别、格式和内容的统一,增强可读性和可追踪性。
|
||||
4. **优化性能**:通过配置日志框架的高级功能(如异步日志),提高日志系统的性能,减少对应用的影响。
|
||||
5. **统一日志管理**:避免团队成员在不同模块中使用不一致的日志记录方式,确保日志输出的标准化。
|
||||
|
||||
最好的做法是通过日志抽象层(如 SLF4J)进行日志记录,同时通过日志管理工具类进行统一的配置和调用,确保日志的高效、规范和灵活性。
|
||||
|
||||
## 11. 为什么建议开发者谨慎使用继承?
|
||||
|
||||
在面向对象编程(OOP)中,**继承**是一种常见的代码复用方式,它允许一个类继承另一个类的属性和行为。然而,虽然继承可以提高代码的复用性,但过度或不当使用继承可能会导致代码的复杂性增加,进而带来一些潜在的问题。因此,建议开发者在使用继承时要谨慎,以下是一些关键原因:
|
||||
|
||||
### 1. **增加了类之间的耦合性**
|
||||
|
||||
继承会导致子类和父类之间形成紧密的耦合关系。子类依赖于父类的实现,这意味着如果父类发生变化,可能会影响到所有继承自该父类的子类,导致修改和维护变得更加困难。这种紧密耦合关系也限制了子类的灵活性,因为它必须遵循父类的接口和实现。
|
||||
|
||||
**例子**:
|
||||
|
||||
class Animal {
|
||||
void eat() {
|
||||
System.out.println("Animal is eating");
|
||||
}
|
||||
}
|
||||
|
||||
class Dog extends Animal {
|
||||
@Override
|
||||
void eat() {
|
||||
System.out.println("Dog is eating");
|
||||
}
|
||||
}
|
||||
|
||||
如果父类 `Animal` 做了改动(如修改 `eat()` 方法的实现),`Dog` 类也会受到影响。这样的耦合会增加后期维护的复杂度。
|
||||
|
||||
### 2. **破坏了封装性(Encapsulation)**
|
||||
|
||||
继承可能破坏封装性,因为子类可以直接访问父类的成员(字段和方法),尤其是当父类成员被设置为 `protected` 或 `public` 时。这种情况可能导致子类暴露不应被外界访问的细节,破坏了数据的封装性。
|
||||
|
||||
**例子**:
|
||||
|
||||
class Vehicle {
|
||||
protected int speed;
|
||||
}
|
||||
|
||||
class Car extends Vehicle {
|
||||
void accelerate() {
|
||||
speed += 10; // 直接访问父类的 protected 字段
|
||||
}
|
||||
}
|
||||
|
||||
在这种情况下,`Car` 类直接访问了父类 `Vehicle` 的 `speed` 字段,而不是通过公共接口来修改它,导致封装性降低。
|
||||
|
||||
### 3. **继承可能会导致类的层次结构不合理**
|
||||
|
||||
继承往往会导致不合理的类层次结构,特别是在试图通过继承来表达“是一个”(`is-a`)关系时,实际情况可能并不符合这种逻辑。滥用继承可能会使类之间的关系变得复杂和不直观,导致代码结构混乱。
|
||||
|
||||
**例子**:
|
||||
假设我们有一个 `Car` 类和一个 `Truck` 类,都继承自 `Vehicle` 类。如果 `Car` 和 `Truck` 共享很多方法和属性,这样的设计可能是合适的。但是,如果 `Car` 和 `Truck` 之间差异很大,仅通过继承来构建它们的关系,可能会导致继承层次过于复杂,代码阅读和理解变得困难。
|
||||
|
||||
### 4. **继承可能导致不易发现的错误**
|
||||
|
||||
由于子类继承了父类的行为,任何对父类的修改都有可能影响到子类的行为。更糟糕的是,错误或不一致的修改可能在父类中发生,而这些错误可能不会立即暴露出来,直到程序运行到某个特定的地方,才会显现出错误。
|
||||
|
||||
**例子**:
|
||||
假设你修改了父类的某个方法,但忘记更新或调整子类中相应的重写方法,这可能会导致难以发现的错误。
|
||||
|
||||
### 5. **继承限制了灵活性(不可重用性问题)**
|
||||
|
||||
继承创建了一个父类与子类之间的固定关系,这意味着如果你想在一个完全不同的上下文中重用一个类,你可能不能通过继承来实现。在某些情况下,组合比继承更为灵活,允许你将多个行为组合到一个类中,而不是通过继承来强行构建类的层次结构。
|
||||
|
||||
**例子**:
|
||||
|
||||
// 组合而非继承
|
||||
class Engine {
|
||||
void start() {
|
||||
System.out.println("Engine started");
|
||||
}
|
||||
}
|
||||
|
||||
class Car {
|
||||
private Engine engine = new Engine(); // 通过组合来使用 Engine
|
||||
void start() {
|
||||
engine.start();
|
||||
}
|
||||
}
|
||||
|
||||
通过组合,可以灵活地使用不同的组件,而不需要继承整个类。这样做的优点是更具扩展性和灵活性。
|
||||
|
||||
### 6. **继承限制了方法的重用(可维护性差)**
|
||||
|
||||
如果你过度依赖继承,你的代码会容易受到父类实现的限制,难以灵活地添加新功能或进行扩展。例如,在继承链中添加新的功能可能会导致一大堆方法的修改和重写,而不通过继承,可以更轻松地将功能作为独立模块来重用。
|
||||
|
||||
### 7. **使用接口和组合更优**
|
||||
|
||||
相比继承,**接口(Interface)** 和 **组合(Composition)** 更符合面向对象设计的原则。接口允许类只暴露所需的功能,而不暴露实现细节,组合则允许你将多个不同的行为组合在一起,使得系统更加灵活和可扩展。通过接口和组合,可以避免继承的许多问题。
|
||||
|
||||
**推荐设计模式**:
|
||||
|
||||
- **策略模式(Strategy Pattern)**:通过接口和组合来替代继承。
|
||||
- **装饰器模式(Decorator Pattern)**:使用组合和代理来扩展行为,而非通过继承。
|
||||
|
||||
### 小结
|
||||
|
||||
尽管继承是面向对象编程中的一个重要特性,但滥用继承可能带来许多问题,特别是在以下几个方面:
|
||||
|
||||
- 增加类之间的耦合,降低灵活性;
|
||||
- 破坏封装性,暴露不应访问的内部实现;
|
||||
- 可能导致类层次结构复杂,增加理解和维护的难度;
|
||||
- 限制代码的重用和扩展性。
|
||||
|
||||
因此,**推荐优先使用组合而非继承**,并尽可能使用接口来实现灵活的扩展。如果必须使用继承,确保它能够清晰地表达“是一个”的关系,并避免过深的继承层次。
|
||||
|
||||
## 12. 为什么禁止开发人员修改 serialVersionUID 字段的值?
|
||||
|
||||
`serialVersionUID` 是 Java 中用来标识序列化版本的一个静态字段。它的作用是确保在反序列化时,JVM 可以验证序列化的类与当前类的兼容性,以避免版本不兼容导致的错误。尽管 `serialVersionUID` 可以由开发人员手动定义,**禁止开发人员修改 `serialVersionUID` 字段的值** 的原因如下:
|
||||
|
||||
### 1. **序列化与反序列化兼容性**
|
||||
|
||||
`serialVersionUID` 的主要作用是保证在序列化和反序列化过程中,类的版本兼容性。它是用来标识类的版本的,如果序列化和反序列化过程中使用的类的 `serialVersionUID` 不匹配,就会抛出 `InvalidClassException`。
|
||||
|
||||
- **不匹配的 `serialVersionUID`** 会导致序列化的数据与当前类不兼容,导致反序列化失败。
|
||||
- **修改 `serialVersionUID`** 的值会改变类的版本标识,导致已序列化的数据在反序列化时不能成功读取,特别是在类结构发生改变(例如添加或删除字段)时。
|
||||
|
||||
**例如:**
|
||||
|
||||
// 类的第一次版本
|
||||
public class MyClass implements Serializable {
|
||||
private static final long serialVersionUID = 1L;
|
||||
private String name;
|
||||
// 其他字段和方法
|
||||
}
|
||||
|
||||
// 类的第二次修改版本
|
||||
public class MyClass implements Serializable {
|
||||
private static final long serialVersionUID = 2L; // 修改了 serialVersionUID
|
||||
private String name;
|
||||
private int age; // 新增字段
|
||||
// 其他字段和方法
|
||||
}
|
||||
|
||||
如果修改了 `serialVersionUID`,而之前序列化的数据是使用版本 1 的类进行序列化的,反序列化时会因为 `serialVersionUID` 不匹配而导致失败。
|
||||
|
||||
### 2. **避免不必要的版本冲突**
|
||||
|
||||
Java 会根据类的字段、方法等信息自动生成 `serialVersionUID`,这个值是基于类的结构计算出来的。如果开发人员修改了 `serialVersionUID`,可能会破坏 Java 自动生成的版本控制机制,从而导致版本控制不一致,增加了维护复杂性。
|
||||
|
||||
如果手动修改 `serialVersionUID`,容易出现以下几种问题:
|
||||
|
||||
- 由于类结构没有变化,修改 `serialVersionUID` 可能会导致已序列化的数据无法恢复。
|
||||
- 如果不同的开发人员修改了 `serialVersionUID`,可能会在不同的机器或系统间引起序列化不一致。
|
||||
|
||||
### 3. **影响序列化兼容性**
|
||||
|
||||
Java 提供了两种主要的兼容性规则:
|
||||
|
||||
- **兼容性向前**:如果类的字段或方法发生改变,但没有改变 `serialVersionUID`,则反序列化是可以工作的。
|
||||
- **兼容性向后**:如果你修改了类的结构(如字段变动、方法签名改变等),并且保持相同的 `serialVersionUID`,反序列化仍然可以工作。
|
||||
|
||||
如果不小心修改了 `serialVersionUID`,可能导致以下情况:
|
||||
|
||||
- **向前兼容性**:新版本的类不能兼容老版本的对象,导致反序列化失败。
|
||||
- **向后兼容性**:老版本的类无法反序列化新版本的对象。
|
||||
|
||||
### 4. **自动生成 vs 手动指定**
|
||||
|
||||
- **自动生成的 `serialVersionUID`**:Java 会根据类的结构自动生成 `serialVersionUID`,这样如果类的结构发生变化,`serialVersionUID` 会自动变化,确保不兼容的版本之间不会出现意外的反序列化行为。
|
||||
- **手动指定 `serialVersionUID`**:手动修改 `serialVersionUID` 可能导致版本控制不一致,特别是在多人开发、分布式部署的环境中,容易出现反序列化失败的问题。
|
||||
|
||||
### 5. **避免非预期的反序列化问题**
|
||||
|
||||
手动修改 `serialVersionUID` 可能会导致数据丢失或反序列化时抛出异常。例如,如果开发人员错误地修改了 `serialVersionUID`,系统在尝试反序列化时可能会因为 `serialVersionUID` 不匹配而无法成功加载对象,导致异常的发生。
|
||||
|
||||
### 小结
|
||||
|
||||
**禁止开发人员修改 `serialVersionUID` 字段的值,主要是为了:**
|
||||
|
||||
- **确保序列化与反序列化的兼容性**,避免版本不匹配导致反序列化失败。
|
||||
- **避免不必要的版本冲突和数据丢失**,特别是在类结构修改时。
|
||||
- **保持 Java 自动管理 `serialVersionUID` 的优势**,保证类的版本一致性和可维护性。
|
||||
|
||||
如果确实需要修改 `serialVersionUID`,应确保修改后的版本与已经序列化的数据兼容,并遵循合理的版本管理策略。
|
||||
|
||||
## 13. 为什么禁止开发人员使用 isSuccess 作为变量名?
|
||||
|
||||
禁止开发人员使用 `isSuccess` 作为变量名,主要是为了遵循更好的编程规范和提高代码的可读性、可维护性。这个变量名问题的核心在于其容易引起歧义和混淆。具体原因如下:
|
||||
|
||||
### 1. **不符合布尔值命名约定**
|
||||
|
||||
在 Java 中,通常使用 `is` 或 `has` 开头的变量名来表示布尔值(`boolean` 类型)。这类命名通常遵循特定的语义约定,表示某个条件是否成立。例如:
|
||||
|
||||
- `isEnabled` 表示某个功能是否启用;
|
||||
- `hasPermission` 表示是否有权限。
|
||||
|
||||
**问题**:
|
||||
|
||||
- `isSuccess` 看起来像一个布尔值(`boolean` 类型),但它实际上可能并不直接表示一个布尔值,而是一个状态或结果。这种命名可能会导致混淆,开发者可能误以为它是布尔类型的变量,而实际上它可能是一个描述状态的对象、字符串或者其他类型的数据。
|
||||
|
||||
### 2. **语义不明确**
|
||||
|
||||
`isSuccess` 这个名字表面上表示“是否成功”,但是它缺少具体的上下文,导致语义不够明确。真正表示是否成功的布尔值应该直接使用 `boolean` 类型的变量,并且使用清晰明确的命名。
|
||||
|
||||
例如:
|
||||
|
||||
- `isCompleted`:表示某个任务是否完成。
|
||||
- `isSuccessful`:表示某个操作是否成功。
|
||||
|
||||
这些命名能更明确地表达布尔变量的含义,避免理解上的歧义。
|
||||
|
||||
### 3. **与标准的 `is` 前缀混淆**
|
||||
|
||||
`is` 前缀通常用来表示“是否”某个条件成立,适用于返回布尔值的方法或者变量。`isSuccess` 这样的命名会让开发人员误以为它是一个布尔值,或者一个 `boolean` 类型的值,但实际上它可能是一个复杂类型或者其他非布尔类型,造成不必要的混淆。
|
||||
|
||||
例如:
|
||||
|
||||
boolean isSuccess = someMethod(); // 看起来是布尔值,但实际类型可能不同
|
||||
|
||||
这种情况可能导致开发人员产生误解,认为 `isSuccess` 代表的是布尔值,但它可能是某个表示成功的对象、枚举或者其他数据类型。
|
||||
|
||||
### 4. **更好的命名建议**
|
||||
|
||||
为了避免歧义和混淆,开发人员应使用更加明确且符合命名规范的名称。以下是一些命名的改进建议:
|
||||
|
||||
- 如果是布尔值,命名为 `isSuccessful` 或 `wasSuccessful`。
|
||||
- 如果是表示结果的对象,使用更具体的名称,例如 `operationResult` 或 `statusCode`,以表明它是一个描述操作结果的变量。
|
||||
|
||||
### 5. **提升代码的可读性和可维护性**
|
||||
|
||||
清晰且具有意义的命名能够帮助团队成员或未来的开发者更快地理解代码的意图。如果变量名过于模糊(如 `isSuccess`),就可能让人对其实际含义产生疑问,尤其是在阅读较大或复杂的代码时。良好的命名能够提升代码的可读性和可维护性。
|
||||
|
||||
### 小结
|
||||
|
||||
- **`isSuccess`** 这样的命名不清晰,容易与布尔类型的变量产生混淆,进而影响代码的可读性。
|
||||
- **命名应尽量明确**,避免使用容易引起歧义的名称,特别是在布尔值类型的命名时。
|
||||
- 建议使用更具描述性的名称,如 **`isSuccessful`** 或 **`wasSuccessful`**,更清晰地表达变量的意义。
|
||||
|
||||
## 最后
|
||||
|
||||
以上是 V 哥精心总结的13个 Java 编程中的小小编码问题,也是V 哥日常编码中总结的学习笔记,分享给大家,如果内容对你有帮助,请不要吝啬来个小赞呗,关注威哥爱编程,Java 路上,你我相伴前行。
|
||||
+112
@@ -0,0 +1,112 @@
|
||||
###### 1. Integer[]转[ArrayList](https://so.csdn.net/so/search?q=ArrayList&spm=1001.2101.3001.7020)
|
||||
|
||||
(1) 方法一:
|
||||
|
||||
利用[Arrays工具类](https://blog.csdn.net/k909397116/article/details/107308897)中的`asList`方法
|
||||
|
||||
```Java
|
||||
Integer[] arr = {1,2,3};
|
||||
ArrayList<Integer> list = new ArrayList<>(Arrays.asList(arr));
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
(2) 方法二:
|
||||
|
||||
利用Collections工具类中的`addAll`方法
|
||||
|
||||
```Java
|
||||
Integer[] arr = {1,2,3};
|
||||
ArrayList<Integer> list = new ArrayList<>(array.length);
|
||||
Collections.addAll(list, arr);
|
||||
|
||||
|
||||
|
||||
123
|
||||
123
|
||||
```
|
||||
|
||||
(3) 注意:
|
||||
Java中集合只能存放引用数据类型,在使用`asList`或`addAll`方法时,被转换的[数组](https://so.csdn.net/so/search?q=%E6%95%B0%E7%BB%84&spm=1001.2101.3001.7020)必须是存放引用数据类型的数组,如果是基本数据类型数组请在转换前先把其转换为对应的[包装类型](https://blog.csdn.net/k909397116/article/details/107323121)数组,下面会介绍。
|
||||
|
||||
|
||||
|
||||
###### 2. ArrayList转Integer[]
|
||||
|
||||
```Java
|
||||
ArrayList<Integer> list = new ArrayList<>();
|
||||
Integer[] arr = list.toArray(new Integer[0]);
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
|
||||
|
||||
## 二、Integer[]与int[]互转
|
||||
|
||||
---
|
||||
|
||||
###### 1. Integer[]转int[]
|
||||
|
||||
```Java
|
||||
Integer[] arr1 = {1,2,3};
|
||||
int[] arr2 = Arrays.stream(arr1).mapToInt(Integer::valueOf).toArray();
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
|
||||
|
||||
###### 2. int[]转Integer[]
|
||||
|
||||
```Java
|
||||
int[] arr1 = {1,2,3};
|
||||
Integer[] arr2 = Arrays.stream(arr1).boxed().toArray(Integer[]::new);
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
|
||||
|
||||
## 三、int[]与ArrayList的互转
|
||||
|
||||
---
|
||||
|
||||
###### 1. int[]转ArrayList
|
||||
|
||||
```Java
|
||||
int[] arr = {1,2,3};
|
||||
List<Integer> list = Arrays.stream(arr).boxed().collect(Collectors.toList());
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
|
||||
|
||||
###### 2. ArrayList转int[]
|
||||
|
||||
```Java
|
||||
ArrayList<Integer> list = new ArrayList<>();
|
||||
int[] arr = list.stream().mapToInt(Integer::valueOf).toArray();
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
```
|
||||
|
||||
+112
@@ -0,0 +1,112 @@
|
||||
###### 1. Integer[]转[ArrayList](https://so.csdn.net/so/search?q=ArrayList&spm=1001.2101.3001.7020)
|
||||
|
||||
(1) 方法一:
|
||||
|
||||
利用[Arrays工具类](https://blog.csdn.net/k909397116/article/details/107308897)中的`asList`方法
|
||||
|
||||
```Java
|
||||
Integer[] arr = {1,2,3};
|
||||
ArrayList<Integer> list = new ArrayList<>(Arrays.asList(arr));
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
(2) 方法二:
|
||||
|
||||
利用Collections工具类中的`addAll`方法
|
||||
|
||||
```Java
|
||||
Integer[] arr = {1,2,3};
|
||||
ArrayList<Integer> list = new ArrayList<>(array.length);
|
||||
Collections.addAll(list, arr);
|
||||
|
||||
|
||||
|
||||
123
|
||||
123
|
||||
```
|
||||
|
||||
(3) 注意:
|
||||
Java中集合只能存放引用数据类型,在使用`asList`或`addAll`方法时,被转换的[数组](https://so.csdn.net/so/search?q=%E6%95%B0%E7%BB%84&spm=1001.2101.3001.7020)必须是存放引用数据类型的数组,如果是基本数据类型数组请在转换前先把其转换为对应的[包装类型](https://blog.csdn.net/k909397116/article/details/107323121)数组,下面会介绍。
|
||||
|
||||
|
||||
|
||||
###### 2. ArrayList转Integer[]
|
||||
|
||||
```Java
|
||||
ArrayList<Integer> list = new ArrayList<>();
|
||||
Integer[] arr = list.toArray(new Integer[0]);
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
|
||||
|
||||
## 二、Integer[]与int[]互转
|
||||
|
||||
---
|
||||
|
||||
###### 1. Integer[]转int[]
|
||||
|
||||
```Java
|
||||
Integer[] arr1 = {1,2,3};
|
||||
int[] arr2 = Arrays.stream(arr1).mapToInt(Integer::valueOf).toArray();
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
|
||||
|
||||
###### 2. int[]转Integer[]
|
||||
|
||||
```Java
|
||||
int[] arr1 = {1,2,3};
|
||||
Integer[] arr2 = Arrays.stream(arr1).boxed().toArray(Integer[]::new);
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
|
||||
|
||||
## 三、int[]与ArrayList的互转
|
||||
|
||||
---
|
||||
|
||||
###### 1. int[]转ArrayList
|
||||
|
||||
```Java
|
||||
int[] arr = {1,2,3};
|
||||
List<Integer> list = Arrays.stream(arr).boxed().collect(Collectors.toList());
|
||||
|
||||
|
||||
|
||||
12
|
||||
12
|
||||
```
|
||||
|
||||
|
||||
|
||||
###### 2. ArrayList转int[]
|
||||
|
||||
```Java
|
||||
ArrayList<Integer> list = new ArrayList<>();
|
||||
int[] arr = list.stream().mapToInt(Integer::valueOf).toArray();
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
```
|
||||
|
||||
@@ -0,0 +1,99 @@
|
||||
## Maven 依赖
|
||||
|
||||
```Plain Text
|
||||
<dependency>
|
||||
<groupId>junit</groupId>
|
||||
<artifactId>junit</artifactId>
|
||||
<version>4.12</version>
|
||||
<scope>test</scope>
|
||||
</dependency>
|
||||
```
|
||||
|
||||
```Plain Text
|
||||
<dependency>
|
||||
<groupId>com.github.houbb</groupId>
|
||||
<artifactId>junitperf</artifactId>
|
||||
<version>1.0.3</version>
|
||||
</dependency>
|
||||
```
|
||||
|
||||
|
||||
|
||||
## Maven 插件
|
||||
|
||||
```Plain Text
|
||||
<plugin>
|
||||
<artifactId>maven-assembly-plugin</artifactId>
|
||||
<configuration>
|
||||
<descriptor>assembly.xml</descriptor>
|
||||
<archive>
|
||||
<manifest>
|
||||
<mainClass>racal.sunyard.main.Version</mainClass>
|
||||
</manifest>
|
||||
</archive>
|
||||
<descriptorRefs>
|
||||
<descriptorRef>jar-with-dependencies</descriptorRef>
|
||||
</descriptorRefs>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<phase>package</phase>
|
||||
<goals>
|
||||
<goal>single</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
```
|
||||
|
||||
|
||||
|
||||
```Plain Text
|
||||
<assembly
|
||||
xmlns="http://maven.apache.org/plugins/maven-assembly-plugin/assembly/1.1.3"
|
||||
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
|
||||
xsi:schemaLocation="http://maven.apache.org/plugins/maven-assembly-plugin/assembly/1.1.3 http://maven.apache.org/xsd/assembly-1.1.3.xsd">
|
||||
<id>fat-tests</id>
|
||||
<formats>
|
||||
<format>jar</format>
|
||||
</formats>
|
||||
<includeBaseDirectory>false</includeBaseDirectory>
|
||||
<dependencySets>
|
||||
<dependencySet>
|
||||
<outputDirectory>/</outputDirectory>
|
||||
<useProjectArtifact>true</useProjectArtifact>
|
||||
<unpack>true</unpack>
|
||||
<scope>test</scope>
|
||||
</dependencySet>
|
||||
</dependencySets>
|
||||
<fileSets>
|
||||
<fileSet>
|
||||
<directory>${project.build.directory}/test-classes</directory>
|
||||
<outputDirectory>/</outputDirectory>
|
||||
<includes>
|
||||
<include>**/*.class</include>
|
||||
</includes>
|
||||
<useDefaultExcludes>true</useDefaultExcludes>
|
||||
</fileSet>
|
||||
</fileSets>
|
||||
</assembly>
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## 使用
|
||||
|
||||
使用 `xxx-fat-tests.jar` 测试类 `TestCIPSPref0`
|
||||
|
||||
|
||||
|
||||
执行脚本
|
||||
|
||||
```Plain Text
|
||||
timeout /nobreak /t 5
|
||||
C:\j2sdk-image\bin\java -Dip=192.168.5.8 -Dfile.encoding=utf-8 -cp .\xxx-fat-tests.jar org.junit.runner.JUnitCore TestCIPSPref0
|
||||
@pause
|
||||
```
|
||||
|
||||
+99
@@ -0,0 +1,99 @@
|
||||
## Maven 依赖
|
||||
|
||||
```Plain Text
|
||||
<dependency>
|
||||
<groupId>junit</groupId>
|
||||
<artifactId>junit</artifactId>
|
||||
<version>4.12</version>
|
||||
<scope>test</scope>
|
||||
</dependency>
|
||||
```
|
||||
|
||||
```Plain Text
|
||||
<dependency>
|
||||
<groupId>com.github.houbb</groupId>
|
||||
<artifactId>junitperf</artifactId>
|
||||
<version>1.0.3</version>
|
||||
</dependency>
|
||||
```
|
||||
|
||||
|
||||
|
||||
## Maven 插件
|
||||
|
||||
```Plain Text
|
||||
<plugin>
|
||||
<artifactId>maven-assembly-plugin</artifactId>
|
||||
<configuration>
|
||||
<descriptor>assembly.xml</descriptor>
|
||||
<archive>
|
||||
<manifest>
|
||||
<mainClass>racal.sunyard.main.Version</mainClass>
|
||||
</manifest>
|
||||
</archive>
|
||||
<descriptorRefs>
|
||||
<descriptorRef>jar-with-dependencies</descriptorRef>
|
||||
</descriptorRefs>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<phase>package</phase>
|
||||
<goals>
|
||||
<goal>single</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
```
|
||||
|
||||
|
||||
|
||||
```Plain Text
|
||||
<assembly
|
||||
xmlns="http://maven.apache.org/plugins/maven-assembly-plugin/assembly/1.1.3"
|
||||
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
|
||||
xsi:schemaLocation="http://maven.apache.org/plugins/maven-assembly-plugin/assembly/1.1.3 http://maven.apache.org/xsd/assembly-1.1.3.xsd">
|
||||
<id>fat-tests</id>
|
||||
<formats>
|
||||
<format>jar</format>
|
||||
</formats>
|
||||
<includeBaseDirectory>false</includeBaseDirectory>
|
||||
<dependencySets>
|
||||
<dependencySet>
|
||||
<outputDirectory>/</outputDirectory>
|
||||
<useProjectArtifact>true</useProjectArtifact>
|
||||
<unpack>true</unpack>
|
||||
<scope>test</scope>
|
||||
</dependencySet>
|
||||
</dependencySets>
|
||||
<fileSets>
|
||||
<fileSet>
|
||||
<directory>${project.build.directory}/test-classes</directory>
|
||||
<outputDirectory>/</outputDirectory>
|
||||
<includes>
|
||||
<include>**/*.class</include>
|
||||
</includes>
|
||||
<useDefaultExcludes>true</useDefaultExcludes>
|
||||
</fileSet>
|
||||
</fileSets>
|
||||
</assembly>
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## 使用
|
||||
|
||||
使用 `xxx-fat-tests.jar` 测试类 `TestCIPSPref0`
|
||||
|
||||
|
||||
|
||||
执行脚本
|
||||
|
||||
```Plain Text
|
||||
timeout /nobreak /t 5
|
||||
C:\j2sdk-image\bin\java -Dip=192.168.5.8 -Dfile.encoding=utf-8 -cp .\xxx-fat-tests.jar org.junit.runner.JUnitCore TestCIPSPref0
|
||||
@pause
|
||||
```
|
||||
|
||||
@@ -0,0 +1,101 @@
|
||||
### 前言
|
||||
|
||||
> 最近几天从零接触LSPosed(xposed),需要自己开发模块进行使用,做一下学习笔记。
|
||||
>
|
||||
> 本篇内容在已经root并且成功刷入了Magisk的基础上进行。
|
||||
>
|
||||
> 注意:LSPosed只支持安卓版本8.x+的设备。如果在8.0以下需要使用xposed。他们的模块开发接口也是一样的。
|
||||
|
||||
|
||||
### 什么是Magisk
|
||||
|
||||
> 我理解它是需要[root权限](https://so.csdn.net/so/search?q=root%E6%9D%83%E9%99%90&spm=1001.2101.3001.7020)的工具类软件的载体,通过它来获取root权限(现在的安卓手机都不能直接获取root权限),同时也起到一种“隐身”的作用,防止被应用程序知道被有root权限的工具操作了。(有用过手游外挂或者gg修改器的人应该懂什么意思🤪)
|
||||
>
|
||||
> 引用AI的回答:
|
||||
>
|
||||
> Magisk是一个非常流行的Android系统修改工具,由XDA开发者开发。它的核心功能是提供一个系统级的界面,允许用户在不改变系统分区的情况下,以模块化的方式对Android系统进行修改和定制。Magisk的主要特点和作用包括:
|
||||
>
|
||||
> 系统分区保护:Magisk通过在系统启动过程中注入代码,实现了对系统分区的无损修改。这意味着用户可以在享受定制化功能的同时,保持系统的纯净状态,便于官方系统更新。
|
||||
>
|
||||
> Root权限管理:Magisk提供了一个灵活的SU(SuperUser)管理机制,允许用户控制哪些应用程序可以获得root权限,提高了安全性。
|
||||
>
|
||||
> 模块支持:Magisk的一个关键特性是支持各种模块,这些模块可以是功能增强、界面美化、系统优化等。用户可以根据需求安装不同的Magisk模块来扩展或修改系统功能,LSPosed就是其中之一。
|
||||
>
|
||||
> 隐藏特性:Magisk还具有“隐身”功能,能够隐藏系统被修改的事实,这对于某些需要安全验证的应用(如银行应用)特别有用。
|
||||
>
|
||||
> 至于为什么LSPosed需要使用Magisk,这是因为:
|
||||
>
|
||||
> 安全性和便利性:Magisk为LSPosed这样的系统级修改框架提供了一个安全可靠的安装环境。通过Magisk管理器,用户可以轻松安装、更新或卸载LSPosed,而不会影响到系统的完整性。
|
||||
> 权限管理:LSPosed需要root权限来执行其核心的Hook功能,Magisk提供的SU管理机制正好满足了这一需求,同时允许用户精细控制权限分配,确保安全。
|
||||
>
|
||||
> 模块化集成:作为Magisk的一个模块,LSPosed可以无缝集成到Magisk生态系统中,与其他模块共存,共同为用户提供一个高度可定制的Android体验。
|
||||
|
||||
|
||||
### 什么是LSPosed(xposed)
|
||||
|
||||
> 简单说就是可以在不修改应用程序的情况下Hook应用程序。类似于使用frida进行hook app。LSPosed的作用就是你可以自己开发一个安卓Hook应用,然后使用LSPosed加载它,并且指定对某个app进行hook。
|
||||
>
|
||||
> 引用AI回答:
|
||||
>
|
||||
> LSPosed是一种针对Android系统的高级定制和修改框架,它是Edxposed的一个分支项目。LSPosed的设计目标是在不修改任何应用和系统组件的情况下,通过hook技术实现在运行时修改应用程序行为的能力,类似于知名的Xposed框架。这一框架为Android用户和开发者提供了强大的功能,允许他们定制系统和应用程序,比如修改系统设置、视觉效果、或者增强应用功能等,而无需触及原始的应用程序代码或重新编译系统。
|
||||
>
|
||||
> LSPosed的关键特性包括:
|
||||
>
|
||||
> 基于Riru的ART Hook框架:LSPosed建立在Riru的基础上,Riru是一个低层次的Hook框架,能够在Android系统的ART(Android Runtime)层面上工作,支持从Android 8.0到11的版本。
|
||||
>
|
||||
> 与Xposed兼容的API:它提供了与原版Xposed相同的API,这意味着许多为Xposed开发的模块可以直接在LSPosed上运行,降低了迁移成本。
|
||||
>
|
||||
> 更高的效率和稳定性:相比其前身Edxposed,LSPosed被设计得更加简洁、高效且稳定,减少了潜在的崩溃和性能问题。
|
||||
>
|
||||
> 长期更新和支持:由于Edxposed面临着停更的风险和稳定性问题,LSPosed作为一个活跃维护的项目,承诺提供长期的更新支持,不断集成新功能并保持与最新Android版本的兼容性。
|
||||
> 使用YAHFA或SandHook进行Hook:这两种技术帮助LSPosed在应用启动时动态插入代码,实现无痕且高效的Hook操作,无需重启手机即可使Hook模块生效。
|
||||
>
|
||||
> 对于希望深度定制自己Android设备体验的高级用户和开发者而言,LSPosed是一个强大且灵活的工具。不过,使用此类框架通常需要root权限,并且涉及系统级别的修改,因此也伴随着一定的风险和挑战。
|
||||
|
||||
private static void HookLocation(ClassLoader classLoader) throws ClassNotFoundException {
|
||||
//坐标拾取系统 [https://lbs.qq.com/getPoint/](https://lbs.qq.com/getPoint/)
|
||||
double latitude = 0.0;
|
||||
double longitude = 0.0;
|
||||
|
||||
Class clazz = classLoader.loadClass(
|
||||
"com.tencent.map.geolocation.sapp.TencentLocationManager");
|
||||
XposedHelpers.findAndHookMethod(clazz, "requestLocationUpdates",
|
||||
"com.tencent.map.geolocation.sapp.TencentLocationRequest",
|
||||
"com.tencent.map.geolocation.sapp.TencentLocationListener", new XC_MethodHook() {
|
||||
@[Override](https://www.v2ex.com/member/Override)
|
||||
protected void beforeHookedMethod(MethodHookParam param) throws Throwable {
|
||||
XposedBridge.log("requestLocationUpdates");
|
||||
Class tencentLocationListenerClass = param.args[1].getClass();
|
||||
XposedHelpers.findAndHookMethod(tencentLocationListenerClass,
|
||||
"onLocationChanged",
|
||||
"com.tencent.map.geolocation.sapp.TencentLocation",
|
||||
int.class, String.class, new XC_MethodHook() {
|
||||
@[Override](https://www.v2ex.com/member/Override)
|
||||
protected void beforeHookedMethod(MethodHookParam param) throws Throwable {
|
||||
Class tencentLocation = param.args[0].getClass();
|
||||
XposedHelpers.findAndHookMethod(tencentLocation,
|
||||
"getLatitude",
|
||||
new XC_MethodHook() {
|
||||
@[Override](https://www.v2ex.com/member/Override)
|
||||
protected void afterHookedMethod(MethodHookParam param) throws Throwable {
|
||||
XposedBridge.log("requestLocationUpdates.getLatitude:"+ param.getResult());
|
||||
param.setResult(latitude);
|
||||
}
|
||||
});
|
||||
XposedHelpers.findAndHookMethod(tencentLocation,
|
||||
"getLongitude",
|
||||
new XC_MethodHook() {
|
||||
@[Override](https://www.v2ex.com/member/Override)
|
||||
protected void afterHookedMethod(MethodHookParam param) throws Throwable {
|
||||
XposedBridge.log("requestLocationUpdates.getLongitude:"+ param.getResult());
|
||||
param.setResult(longitude);
|
||||
}
|
||||
});
|
||||
|
||||
|
||||
}
|
||||
});
|
||||
}
|
||||
}
|
||||
);
|
||||
}
|
||||
+237
@@ -0,0 +1,237 @@
|
||||
想把[maven](https://so.csdn.net/so/search?q=maven&spm=1001.2101.3001.7020)项目打包成可执行jar包,按照网上使用maven-assembly-plugin配置,打包后,运行报错。
|
||||
报错信息:
|
||||
java.lang.IllegalArgumentException:No auto [configuration](https://so.csdn.net/so/search?q=configuration&spm=1001.2101.3001.7020) classes found in META-INF/spring.factories.If you are using a custom packaging,make sure that file is correct.
|
||||
|
||||
一、
|
||||
|
||||
解决办法:
|
||||
我是springboot项目,直接使用spring-boot-maven-plugin,删除了maven-assembly-plugin配置
|
||||
配置信息如下
|
||||
|
||||
```Plain Text
|
||||
<properties>
|
||||
<start-class>com.xxx.yyy.MainClass</start-class>
|
||||
</properties>
|
||||
|
||||
<build>
|
||||
<plugins>
|
||||
<plugin>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-maven-plugin</artifactId>
|
||||
<configuration>
|
||||
<fork>true</fork>
|
||||
<mainClass>${start-class}</mainClass>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<goals>
|
||||
<goal>repackage</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
</plugins>
|
||||
</build>
|
||||
```
|
||||
|
||||
配置好后,在项目目录下执行 `mvn clean package`
|
||||
执行完成后,cd 进入target目录,运行jar(jar中包含了所有依赖)
|
||||
`java -jar my-service-0.0.1-SNAPSHOT.jar`
|
||||
|
||||
|
||||
|
||||
二、
|
||||
|
||||
### **修改前的pom配置**
|
||||
|
||||
```Plain Text
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<project xmlns="http://maven.apache.org/POM/4.0.0"
|
||||
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
|
||||
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
|
||||
<modelVersion>4.0.0</modelVersion>
|
||||
<parent>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-starter-parent</artifactId>
|
||||
<version>2.4.5</version>
|
||||
<relativePath/> <!-- lookup parent from repository -->
|
||||
</parent>
|
||||
|
||||
<groupId>org.task</groupId>
|
||||
<artifactId>task-server-api</artifactId>
|
||||
<version>1.0-SNAPSHOT</version>
|
||||
<packaging>jar</packaging>
|
||||
|
||||
<properties>
|
||||
<maven.compiler.source>8</maven.compiler.source>
|
||||
<maven.compiler.target>8</maven.compiler.target>
|
||||
<!-- 文件拷贝时的编码 -->
|
||||
<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
|
||||
<project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>
|
||||
<!-- 编译时的编码 -->
|
||||
<maven.compiler.encoding>UTF-8</maven.compiler.encoding>
|
||||
</properties>
|
||||
|
||||
<dependencies>
|
||||
......
|
||||
</dependencies>
|
||||
|
||||
<build>
|
||||
<plugins>
|
||||
<plugin>
|
||||
<artifactId>maven-assembly-plugin</artifactId>
|
||||
<configuration>
|
||||
<archive>
|
||||
<manifest>
|
||||
<!--这里要替换成jar包main方法所在类 -->
|
||||
<mainClass>com.task.TaskApplicationStart</mainClass>
|
||||
</manifest>
|
||||
<manifestEntries>
|
||||
<Class-Path>.</Class-Path>
|
||||
</manifestEntries>
|
||||
</archive>
|
||||
<descriptorRefs>
|
||||
<descriptorRef>jar-with-dependencies</descriptorRef>
|
||||
</descriptorRefs>
|
||||
<appendAssemblyId>false</appendAssemblyId>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<id>make-assembly</id> <!-- this is used for inheritance merges -->
|
||||
<phase>package</phase> <!-- 指定在打包节点执行jar包合并操作 -->
|
||||
<goals>
|
||||
<goal>single</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
<plugin>
|
||||
<groupId>org.apache.maven.plugins</groupId>
|
||||
<artifactId>maven-compiler-plugin</artifactId>
|
||||
<configuration>
|
||||
<source>8</source>
|
||||
<target>8</target>
|
||||
</configuration>
|
||||
</plugin>
|
||||
</plugins>
|
||||
</build>
|
||||
|
||||
</project>
|
||||
|
||||
</project>
|
||||
```
|
||||
|
||||
|
||||
|
||||
### **新增如下插件**
|
||||
|
||||
```Plain Text
|
||||
<plugin>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-maven-plugin</artifactId>
|
||||
<configuration>
|
||||
<fork>true</fork>
|
||||
<mainClass>com.task.TaskApplicationStart</mainClass>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<goals>
|
||||
<goal>repackage</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
```
|
||||
|
||||
### **修改后**
|
||||
|
||||
```Plain Text
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<project xmlns="http://maven.apache.org/POM/4.0.0"
|
||||
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
|
||||
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
|
||||
<modelVersion>4.0.0</modelVersion>
|
||||
<parent>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-starter-parent</artifactId>
|
||||
<version>2.4.5</version>
|
||||
<relativePath/> <!-- lookup parent from repository -->
|
||||
</parent>
|
||||
|
||||
<groupId>org.task</groupId>
|
||||
<artifactId>task-server-api</artifactId>
|
||||
<version>1.0-SNAPSHOT</version>
|
||||
<packaging>jar</packaging>
|
||||
|
||||
<properties>
|
||||
<maven.compiler.source>8</maven.compiler.source>
|
||||
<maven.compiler.target>8</maven.compiler.target>
|
||||
<!-- 文件拷贝时的编码 -->
|
||||
<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
|
||||
<project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>
|
||||
<!-- 编译时的编码 -->
|
||||
<maven.compiler.encoding>UTF-8</maven.compiler.encoding>
|
||||
</properties>
|
||||
|
||||
<dependencies>
|
||||
......
|
||||
</dependencies>
|
||||
|
||||
<build>
|
||||
<plugins>
|
||||
<plugin>
|
||||
<artifactId>maven-assembly-plugin</artifactId>
|
||||
<configuration>
|
||||
<archive>
|
||||
<manifest>
|
||||
<!--这里要替换成jar包main方法所在类 -->
|
||||
<mainClass>com.task.TaskApplicationStart</mainClass>
|
||||
</manifest>
|
||||
<manifestEntries>
|
||||
<Class-Path>.</Class-Path>
|
||||
</manifestEntries>
|
||||
</archive>
|
||||
<descriptorRefs>
|
||||
<descriptorRef>jar-with-dependencies</descriptorRef>
|
||||
</descriptorRefs>
|
||||
<appendAssemblyId>false</appendAssemblyId>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<id>make-assembly</id> <!-- this is used for inheritance merges -->
|
||||
<phase>package</phase> <!-- 指定在打包节点执行jar包合并操作 -->
|
||||
<goals>
|
||||
<goal>single</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
<plugin>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-maven-plugin</artifactId>
|
||||
<configuration>
|
||||
<fork>true</fork>
|
||||
<mainClass>com.task.TaskApplicationStart</mainClass>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<goals>
|
||||
<goal>repackage</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
<plugin>
|
||||
<groupId>org.apache.maven.plugins</groupId>
|
||||
<artifactId>maven-compiler-plugin</artifactId>
|
||||
<configuration>
|
||||
<source>8</source>
|
||||
<target>8</target>
|
||||
</configuration>
|
||||
</plugin>
|
||||
</plugins>
|
||||
</build>
|
||||
|
||||
</project>
|
||||
```
|
||||
|
||||
+237
@@ -0,0 +1,237 @@
|
||||
想把[maven](https://so.csdn.net/so/search?q=maven&spm=1001.2101.3001.7020)项目打包成可执行jar包,按照网上使用maven-assembly-plugin配置,打包后,运行报错。
|
||||
报错信息:
|
||||
java.lang.IllegalArgumentException:No auto [configuration](https://so.csdn.net/so/search?q=configuration&spm=1001.2101.3001.7020) classes found in META-INF/spring.factories.If you are using a custom packaging,make sure that file is correct.
|
||||
|
||||
一、
|
||||
|
||||
解决办法:
|
||||
我是springboot项目,直接使用spring-boot-maven-plugin,删除了maven-assembly-plugin配置
|
||||
配置信息如下
|
||||
|
||||
```Plain Text
|
||||
<properties>
|
||||
<start-class>com.xxx.yyy.MainClass</start-class>
|
||||
</properties>
|
||||
|
||||
<build>
|
||||
<plugins>
|
||||
<plugin>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-maven-plugin</artifactId>
|
||||
<configuration>
|
||||
<fork>true</fork>
|
||||
<mainClass>${start-class}</mainClass>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<goals>
|
||||
<goal>repackage</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
</plugins>
|
||||
</build>
|
||||
```
|
||||
|
||||
配置好后,在项目目录下执行 `mvn clean package`
|
||||
执行完成后,cd 进入target目录,运行jar(jar中包含了所有依赖)
|
||||
`java -jar my-service-0.0.1-SNAPSHOT.jar`
|
||||
|
||||
|
||||
|
||||
二、
|
||||
|
||||
### **修改前的pom配置**
|
||||
|
||||
```Plain Text
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<project xmlns="http://maven.apache.org/POM/4.0.0"
|
||||
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
|
||||
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
|
||||
<modelVersion>4.0.0</modelVersion>
|
||||
<parent>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-starter-parent</artifactId>
|
||||
<version>2.4.5</version>
|
||||
<relativePath/> <!-- lookup parent from repository -->
|
||||
</parent>
|
||||
|
||||
<groupId>org.task</groupId>
|
||||
<artifactId>task-server-api</artifactId>
|
||||
<version>1.0-SNAPSHOT</version>
|
||||
<packaging>jar</packaging>
|
||||
|
||||
<properties>
|
||||
<maven.compiler.source>8</maven.compiler.source>
|
||||
<maven.compiler.target>8</maven.compiler.target>
|
||||
<!-- 文件拷贝时的编码 -->
|
||||
<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
|
||||
<project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>
|
||||
<!-- 编译时的编码 -->
|
||||
<maven.compiler.encoding>UTF-8</maven.compiler.encoding>
|
||||
</properties>
|
||||
|
||||
<dependencies>
|
||||
......
|
||||
</dependencies>
|
||||
|
||||
<build>
|
||||
<plugins>
|
||||
<plugin>
|
||||
<artifactId>maven-assembly-plugin</artifactId>
|
||||
<configuration>
|
||||
<archive>
|
||||
<manifest>
|
||||
<!--这里要替换成jar包main方法所在类 -->
|
||||
<mainClass>com.task.TaskApplicationStart</mainClass>
|
||||
</manifest>
|
||||
<manifestEntries>
|
||||
<Class-Path>.</Class-Path>
|
||||
</manifestEntries>
|
||||
</archive>
|
||||
<descriptorRefs>
|
||||
<descriptorRef>jar-with-dependencies</descriptorRef>
|
||||
</descriptorRefs>
|
||||
<appendAssemblyId>false</appendAssemblyId>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<id>make-assembly</id> <!-- this is used for inheritance merges -->
|
||||
<phase>package</phase> <!-- 指定在打包节点执行jar包合并操作 -->
|
||||
<goals>
|
||||
<goal>single</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
<plugin>
|
||||
<groupId>org.apache.maven.plugins</groupId>
|
||||
<artifactId>maven-compiler-plugin</artifactId>
|
||||
<configuration>
|
||||
<source>8</source>
|
||||
<target>8</target>
|
||||
</configuration>
|
||||
</plugin>
|
||||
</plugins>
|
||||
</build>
|
||||
|
||||
</project>
|
||||
|
||||
</project>
|
||||
```
|
||||
|
||||
|
||||
|
||||
### **新增如下插件**
|
||||
|
||||
```Plain Text
|
||||
<plugin>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-maven-plugin</artifactId>
|
||||
<configuration>
|
||||
<fork>true</fork>
|
||||
<mainClass>com.task.TaskApplicationStart</mainClass>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<goals>
|
||||
<goal>repackage</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
```
|
||||
|
||||
### **修改后**
|
||||
|
||||
```Plain Text
|
||||
<?xml version="1.0" encoding="UTF-8"?>
|
||||
<project xmlns="http://maven.apache.org/POM/4.0.0"
|
||||
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
|
||||
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
|
||||
<modelVersion>4.0.0</modelVersion>
|
||||
<parent>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-starter-parent</artifactId>
|
||||
<version>2.4.5</version>
|
||||
<relativePath/> <!-- lookup parent from repository -->
|
||||
</parent>
|
||||
|
||||
<groupId>org.task</groupId>
|
||||
<artifactId>task-server-api</artifactId>
|
||||
<version>1.0-SNAPSHOT</version>
|
||||
<packaging>jar</packaging>
|
||||
|
||||
<properties>
|
||||
<maven.compiler.source>8</maven.compiler.source>
|
||||
<maven.compiler.target>8</maven.compiler.target>
|
||||
<!-- 文件拷贝时的编码 -->
|
||||
<project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
|
||||
<project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>
|
||||
<!-- 编译时的编码 -->
|
||||
<maven.compiler.encoding>UTF-8</maven.compiler.encoding>
|
||||
</properties>
|
||||
|
||||
<dependencies>
|
||||
......
|
||||
</dependencies>
|
||||
|
||||
<build>
|
||||
<plugins>
|
||||
<plugin>
|
||||
<artifactId>maven-assembly-plugin</artifactId>
|
||||
<configuration>
|
||||
<archive>
|
||||
<manifest>
|
||||
<!--这里要替换成jar包main方法所在类 -->
|
||||
<mainClass>com.task.TaskApplicationStart</mainClass>
|
||||
</manifest>
|
||||
<manifestEntries>
|
||||
<Class-Path>.</Class-Path>
|
||||
</manifestEntries>
|
||||
</archive>
|
||||
<descriptorRefs>
|
||||
<descriptorRef>jar-with-dependencies</descriptorRef>
|
||||
</descriptorRefs>
|
||||
<appendAssemblyId>false</appendAssemblyId>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<id>make-assembly</id> <!-- this is used for inheritance merges -->
|
||||
<phase>package</phase> <!-- 指定在打包节点执行jar包合并操作 -->
|
||||
<goals>
|
||||
<goal>single</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
<plugin>
|
||||
<groupId>org.springframework.boot</groupId>
|
||||
<artifactId>spring-boot-maven-plugin</artifactId>
|
||||
<configuration>
|
||||
<fork>true</fork>
|
||||
<mainClass>com.task.TaskApplicationStart</mainClass>
|
||||
</configuration>
|
||||
<executions>
|
||||
<execution>
|
||||
<goals>
|
||||
<goal>repackage</goal>
|
||||
</goals>
|
||||
</execution>
|
||||
</executions>
|
||||
</plugin>
|
||||
<plugin>
|
||||
<groupId>org.apache.maven.plugins</groupId>
|
||||
<artifactId>maven-compiler-plugin</artifactId>
|
||||
<configuration>
|
||||
<source>8</source>
|
||||
<target>8</target>
|
||||
</configuration>
|
||||
</plugin>
|
||||
</plugins>
|
||||
</build>
|
||||
|
||||
</project>
|
||||
```
|
||||
|
||||
@@ -0,0 +1,258 @@
|
||||
`ReentrantLock` 是 Java 并发包中提供的可重入锁,比 `synchronized` 更灵活。以下是其常见用法:
|
||||
|
||||
## 1. 基础锁使用
|
||||
|
||||
```java
|
||||
import java.util.concurrent.locks.ReentrantLock;
|
||||
|
||||
public class BasicUsage {
|
||||
private final ReentrantLock lock = new ReentrantLock();
|
||||
private int count = 0;
|
||||
|
||||
public void increment() {
|
||||
lock.lock(); // 获取锁
|
||||
try {
|
||||
count++;
|
||||
System.out.println("Count: " + count);
|
||||
} finally {
|
||||
lock.unlock(); // 必须放在 finally 中确保释放锁
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## 2. 尝试获取锁(非阻塞)
|
||||
|
||||
```java
|
||||
public class TryLockExample {
|
||||
private final ReentrantLock lock = new ReentrantLock();
|
||||
|
||||
public void tryLockMethod() {
|
||||
if (lock.tryLock()) { // 尝试获取锁,立即返回结果
|
||||
try {
|
||||
// 获取锁成功,执行临界区代码
|
||||
System.out.println("获取锁成功");
|
||||
} finally {
|
||||
lock.unlock();
|
||||
}
|
||||
} else {
|
||||
// 获取锁失败,执行其他逻辑
|
||||
System.out.println("获取锁失败,执行其他操作");
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## 3. 带超时的尝试获取锁
|
||||
|
||||
```java
|
||||
import java.util.concurrent.TimeUnit;
|
||||
|
||||
public class TimeoutLockExample {
|
||||
private final ReentrantLock lock = new ReentrantLock();
|
||||
|
||||
public void timeoutLockMethod() throws InterruptedException {
|
||||
// 尝试在指定时间内获取锁
|
||||
if (lock.tryLock(1, TimeUnit.SECONDS)) {
|
||||
try {
|
||||
System.out.println("在1秒内获取到锁");
|
||||
Thread.sleep(2000); // 模拟业务操作
|
||||
} finally {
|
||||
lock.unlock();
|
||||
}
|
||||
} else {
|
||||
System.out.println("获取锁超时");
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## 4. 可中断的锁获取
|
||||
|
||||
```java
|
||||
public class InterruptibleLockExample {
|
||||
private final ReentrantLock lock = new ReentrantLock();
|
||||
|
||||
public void interruptibleMethod() throws InterruptedException {
|
||||
lock.lockInterruptibly(); // 可响应中断的锁获取
|
||||
try {
|
||||
// 长时间操作
|
||||
while (true) {
|
||||
// 模拟长时间任务
|
||||
if (Thread.currentThread().isInterrupted()) {
|
||||
break;
|
||||
}
|
||||
}
|
||||
} finally {
|
||||
if (lock.isHeldByCurrentThread()) {
|
||||
lock.unlock();
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## 5. 公平锁与非公平锁
|
||||
|
||||
```java
|
||||
public class FairLockExample {
|
||||
// 创建公平锁(按申请顺序获取锁)
|
||||
private final ReentrantLock fairLock = new ReentrantLock(true);
|
||||
|
||||
// 创建非公平锁(默认,性能更高)
|
||||
private final ReentrantLock unfairLock = new ReentrantLock();
|
||||
}
|
||||
```
|
||||
|
||||
## 6. 条件变量(Condition)
|
||||
|
||||
```java
|
||||
import java.util.concurrent.locks.Condition;
|
||||
import java.util.concurrent.locks.ReentrantLock;
|
||||
|
||||
public class ConditionExample {
|
||||
private final ReentrantLock lock = new ReentrantLock();
|
||||
private final Condition condition = lock.newCondition();
|
||||
private boolean conditionMet = false;
|
||||
|
||||
public void awaitCondition() throws InterruptedException {
|
||||
lock.lock();
|
||||
try {
|
||||
while (!conditionMet) {
|
||||
condition.await(); // 释放锁并等待
|
||||
}
|
||||
// 条件满足,执行后续操作
|
||||
System.out.println("条件满足,继续执行");
|
||||
} finally {
|
||||
lock.unlock();
|
||||
}
|
||||
}
|
||||
|
||||
public void signalCondition() {
|
||||
lock.lock();
|
||||
try {
|
||||
conditionMet = true;
|
||||
condition.signalAll(); // 唤醒所有等待线程
|
||||
// 或使用 condition.signal() 唤醒一个线程
|
||||
} finally {
|
||||
lock.unlock();
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## 7. 锁的查询方法
|
||||
|
||||
```java
|
||||
public class LockStatusExample {
|
||||
private final ReentrantLock lock = new ReentrantLock();
|
||||
|
||||
public void checkLockStatus() {
|
||||
System.out.println("是否被当前线程持有: " + lock.isHeldByCurrentThread());
|
||||
System.out.println("是否被锁定: " + lock.isLocked());
|
||||
System.out.println("等待队列长度: " + lock.getQueueLength());
|
||||
System.out.println("当前线程持有锁的次数: " + lock.getHoldCount());
|
||||
|
||||
// 获取锁信息
|
||||
if (lock.isLocked()) {
|
||||
System.out.println("持有锁的线程: " +
|
||||
(lock.getOwner() != null ? lock.getOwner().getName() : "null"));
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## 8. 综合示例:线程安全的队列
|
||||
|
||||
```java
|
||||
import java.util.LinkedList;
|
||||
import java.util.Queue;
|
||||
import java.util.concurrent.locks.Condition;
|
||||
import java.util.concurrent.locks.ReentrantLock;
|
||||
|
||||
public class BlockingQueue<T> {
|
||||
private final Queue<T> queue = new LinkedList<>();
|
||||
private final ReentrantLock lock = new ReentrantLock();
|
||||
private final Condition notEmpty = lock.newCondition();
|
||||
private final Condition notFull = lock.newCondition();
|
||||
private final int capacity;
|
||||
|
||||
public BlockingQueue(int capacity) {
|
||||
this.capacity = capacity;
|
||||
}
|
||||
|
||||
public void put(T item) throws InterruptedException {
|
||||
lock.lock();
|
||||
try {
|
||||
while (queue.size() == capacity) {
|
||||
notFull.await(); // 队列满,等待
|
||||
}
|
||||
queue.offer(item);
|
||||
notEmpty.signal(); // 唤醒等待获取的线程
|
||||
} finally {
|
||||
lock.unlock();
|
||||
}
|
||||
}
|
||||
|
||||
public T take() throws InterruptedException {
|
||||
lock.lock();
|
||||
try {
|
||||
while (queue.isEmpty()) {
|
||||
notEmpty.await(); // 队列空,等待
|
||||
}
|
||||
T item = queue.poll();
|
||||
notFull.signal(); // 唤醒等待放入的线程
|
||||
return item;
|
||||
} finally {
|
||||
lock.unlock();
|
||||
}
|
||||
}
|
||||
|
||||
public int size() {
|
||||
lock.lock();
|
||||
try {
|
||||
return queue.size();
|
||||
} finally {
|
||||
lock.unlock();
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## 9. 与 synchronized 对比
|
||||
|
||||
```java
|
||||
public class Comparison {
|
||||
// synchronized 方式
|
||||
public synchronized void syncMethod() {
|
||||
// 临界区代码
|
||||
}
|
||||
|
||||
// ReentrantLock 方式
|
||||
private final ReentrantLock lock = new ReentrantLock();
|
||||
|
||||
public void lockMethod() {
|
||||
lock.lock();
|
||||
try {
|
||||
// 临界区代码
|
||||
} finally {
|
||||
lock.unlock();
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
## 最佳实践
|
||||
|
||||
1. **始终在 finally 块中释放锁**,防止异常导致锁无法释放
|
||||
2. **不要嵌套过多 tryLock**,避免代码复杂度增加
|
||||
3. **公平锁适用于等待时间差异大的场景**,但性能较低
|
||||
4. **考虑使用 tryLock 避免死锁**
|
||||
5. **合理使用 Condition 替代 Object 的 wait/notify**
|
||||
|
||||
## 选择建议
|
||||
|
||||
- 简单同步场景:优先使用 `synchronized`
|
||||
- 需要高级功能(超时、可中断、公平锁):使用 `ReentrantLock`
|
||||
- 需要多个等待条件:使用 `Condition`
|
||||
- 性能敏感场景:测试后选择(通常 `synchronized` 性能更好)
|
||||
@@ -0,0 +1,10 @@
|
||||
- @Controller - 用于 Spring MVC 项目中的控制器类。
|
||||
- @Service - 用于服务类。
|
||||
- @RequestMapping - 用于在控制器处理程序方法中配置 URI 映射。
|
||||
- @ResponseBody - 用于发送 Object 作为响应,通常用于发送 XML 或 JSON 数据作为响应。
|
||||
- @PathVariable - 用于将动态值从 URI 映射到处理程序方法参数。
|
||||
- @Autowired - 用于在 spring bean 中自动装配依赖项。
|
||||
- @Qualifier - 使用 @Autowired 注解,以避免在存在多个 bean 类型实例时出现混淆。
|
||||
- @Scope - 用于配置 spring bean 的范围。
|
||||
- @Configuration,@ComponentScan 和 @Bean - 用于基于 java 的配置。
|
||||
- @Aspect,@Before,@After,@Around,@Pointcut - 用于切面编程(AOP)。
|
||||
@@ -0,0 +1,104 @@
|
||||
#### **实现方案**
|
||||
|
||||
实现这个很简单,只需要完成下面两步:
|
||||
|
||||
1. 想办法将 Class 加载到 JVM
|
||||
|
||||
2. 使 Spring 扫描到 Class
|
||||
|
||||
|
||||
有时候java中的各种框架以及复杂的概念源码给我们造成了很大理解障碍,特别是Spring家族的所以先想清楚大致实现步骤比较好
|
||||
|
||||
#### **将Class加载到JVM**
|
||||
|
||||
现在我们设定需要加载的 Jar 在 `/user/local/java/plugins` 目录下,对于第 1 步,现在有如下几种实现方式:
|
||||
|
||||
1. 扩大 `-cp` 由 `AppClassLoader` 帮我们加载外部 Jar
|
||||
|
||||
2. 使用 SpringBoot 提供的启动参数 `loader.path` 实现
|
||||
|
||||
3. 自定义 `classloader` 实现加载指定位置的 Jar
|
||||
|
||||
|
||||
其中 1 和 3 是JDK提供的方案,2是 SpringBoot 扩展的方案,毕竟 SpringBoot 也需要自定义加载很多类顺带扩展了一个参数出来
|
||||
|
||||
##### **方案1:扩大 -cp 由 AppClassLoader 帮我们加载外部 Jar**
|
||||
|
||||
可以使用 `classpath` 指定类加载的路径,但 `classpath` 的生效是有条件的,这里其实对应了 Jar 包的两种启动方式:通过Jar包里的Main函数启动或者运行Jar启动
|
||||
|
||||
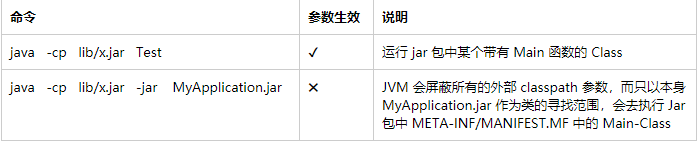
|
||||
|
||||
图片
|
||||
|
||||
SpringBoot 打包后 `MANIFEST.MF` 内容如下:
|
||||
|
||||
`Manifest-Version: 1.0 Created-By: Maven JAR Plugin 3.2.2 Build-Jdk-Spec: 18 Implementation-Title: intelligent-soul Implementation-Version: 0.0.1-SNAPSHOT Main-Class: org.springframework.boot.loader.JarLauncher Start-Class: com.test.MyApplication Spring-Boot-Version: 2.6.15 Spring-Boot-Classes: BOOT-INF/classes/ Spring-Boot-Lib: BOOT-INF/lib/ Spring-Boot-Classpath-Index: BOOT-INF/classpath.idx Spring-Boot-Layers-Index: BOOT-INF/layers.idx `
|
||||
|
||||
所以需要使用 Main 函数启动的方式,不能使用之前的常用的 Jar 包启动方式了。对于 SpringBoot 应用 `Main-Class` 是 `JarLauncher` 所以此时启动命令要改成
|
||||
|
||||
`java -cp /user/local/java/plugins org.springframework.boot.loader.JarLauncher `
|
||||
|
||||
- 优点:实现简单
|
||||
|
||||
- 缺点:每个 Jar 包启动命令都一样了,不好区分
|
||||
|
||||
|
||||
##### **方案2:使用SpringBoot扩展的启动参数,使用java -jar 配合Loader.path参数**
|
||||
|
||||
因为 Spring Boot 程序大多是打成 Jar 包,使用 `java -jar boot.jar` 的方式启动 (此时 `-cp` 无效),可以使用 `loader.path` 指定类加载路径加载其他 Jar,但 `loader.path` 生效也是有条件的:
|
||||
|
||||
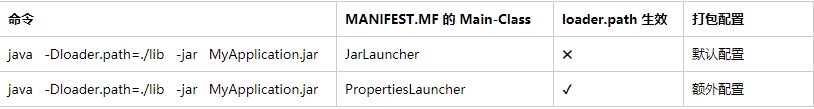
|
||||
|
||||
图片
|
||||
|
||||
SpringBoot 默认打包方式的`Main-Class`是`JarLauncher`
|
||||
|
||||
**配置 Main-Class**
|
||||
|
||||
为了使 `loader.path` 参数生效需要生成 Jar 包的 `Main-Class` 项配置为 `PropertiesLauncher`,在 `maven` 中如下配置,可参考 `Using the PropertiesLauncher`:
|
||||
|
||||
`<build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> <configuration> <!-- 打包时排除scope为system的包 --> <includeSystemScope>false</includeSystemScope> <!-- jvm启动时通过-Dloader.path加载包,必须指定layout为ZIP,否则-Dloader.path无效!!! --> <layout>ZIP</layout> </configuration> <executions> <execution> <goals> <goal>repackage</goal> </goals> </execution> </executions> </plugin> </plugins> <finalName>Test</finalName> </build> `
|
||||
|
||||
其中 layout 可配置值如下:
|
||||
|
||||
1、**JAR**,即通常的可执行 jar
|
||||
|
||||
`Main-Class: org.springframework.boot.loader.JarLauncher `
|
||||
|
||||
2、**WAR**,即通常的可执行war,需要的 servlet 容器依赖位于 `WEB-INF/lib-provided`
|
||||
|
||||
`Main-Class: org.springframework.boot.loader.WarLauncher `
|
||||
|
||||
3、**ZIP**,即DIR,类似于 JAR
|
||||
|
||||
`Main-Class: org.springframework.boot.loader.PropertiesLauncher `
|
||||
|
||||
4、**MODULE**,将所有的依赖库打包(`scope`为`provided`的除外),但是不打包 Spring Boot 的任何`Launcher`
|
||||
|
||||
5、**NONE**,将所有的依赖库打包,但是不打包 Spring Boot 的任何 `Launcher`
|
||||
|
||||
无论启动类是 `JarLauncher` 或者 `PropertiesLauncher`,`loader.path` 引入的 Jar 和 Spring Boot jar 包中 `BOOT-INFO/lib` 包下 Jar 都是使用类加载器 `org.springframework.boot.loader.LaunchedURLClassLoader` 进行加载,也就是说他们使用的是同一个类加载器。这个类加载器主要就是负责加载 Jar 包里的 Jar 的加载,因为JDK没有实现该功能所以 SpringBoot 定义了该类
|
||||
|
||||
注意到同一个程序,打包成不同类型时,`PropertiesLauncher (20s)` 比 `JarLauncher (8s)` 启动慢很多。
|
||||
|
||||
##### **方案3:自定义类加载器,加载固定目录下的jar包或者读取环境变量路径**
|
||||
|
||||
这种方式需要程序启动的某个节点,调用自定义类加载器去加载指定目录下的 Jar 包,时间点不是很好控制。但这个定制化程度比较高。
|
||||
|
||||
`//可以在这里调用自定义类加载 SpringApplication.run(SpringBootDemo.class, args); `
|
||||
|
||||
##### **方案4:通过设置-Xbootclasspath/a或者 Extention ClassLoader通过改变参数java.ext.dirs实现**
|
||||
|
||||
会改变系统类加载器加载行为不安全不推荐!!!
|
||||
|
||||
#### **加载后的类如何扫描进入Spring容器**
|
||||
|
||||
对于业务 Jar 包类,可以预先在SpringBoot中指定好扫描包路径,那么只需要插件包路径是`com.demo`开头即可,如下
|
||||
|
||||
`@SpringBootApplication(scanBasePackages = {"com.demo"}) public class SpringBootDemoApplication { public static void main(String[] args) { SpringApplication.run(SpringBootDemoApplication.class, args); } `
|
||||
|
||||
如不符合包名前缀一致的情况,需要在jar包`META-INF`下的`spring.factories`指定好自动装配的类即可如 mybatis-plus:
|
||||
|
||||
`# Auto Configure org.springframework.boot.env.EnvironmentPostProcessor=\ com.baomidou.mybatisplus.autoconfigure.SafetyEncryptProcessor org.springframework.boot.autoconfigure.EnableAutoConfiguration=\ com.baomidou.mybatisplus.autoconfigure.IdentifierGeneratorAutoConfiguration,\ com.baomidou.mybatisplus.autoconfigure.MybatisPlusLanguageDriverAutoConfiguration,\ com.baomidou.mybatisplus.autoconfigure.MybatisPlusAutoConfiguration `
|
||||
|
||||
👉 欢迎[加入小哈的星球](https://mp.weixin.qq.com/s?__biz=MzU4MDUyMDQyNQ==&mid=2247538511&idx=1&sn=c2f80c1f6143af7bfcaa661951d7bf23&chksm=fd5787c9ca200edf9b861f51dcdc6e15a575488ab6be0f5b721ea27047cf3316e07ea33a9a8d&token=343952052&lang=zh_CN&scene=21#wechat_redirect),你将获得: **专属的项目实战(多个项目) / 1v1 提问 / **Java 学习路线 /** 学习打卡 / 每月赠书 / 社群讨论**
|
||||
@@ -0,0 +1,4 @@
|
||||
[https://blog.51cto.com/u_15659694/5755246](https://blog.51cto.com/u_15659694/5755246)
|
||||
|
||||
|
||||
|
||||
+4
@@ -0,0 +1,4 @@
|
||||
[https://blog.51cto.com/u_15659694/5755246](https://blog.51cto.com/u_15659694/5755246)
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,53 @@
|
||||
Arthas是一款功能强大的Java诊断工具,帮你快速定位线上应用问题。它的核心功能包括**系统状态监控、方法调用追踪、性能热点分析**以及**动态代码修改**等。
|
||||
|
||||
为了让你快速上手,我先用一个表格汇总其最常用的命令、核心功能和应用场景:
|
||||
|
||||
| 命令 | 核心功能与参数 | 典型应用场景 |
|
||||
| :--- | :--- | :--- |
|
||||
| **dashboard** | 实时显示JVM内存、线程、GC、系统负载等信息。 | 快速概览应用整体健康状态,初步判断CPU、内存或线程问题。 |
|
||||
| **thread** | 查看所有线程状态。`thread -n 3`查看最忙的3个线程;`thread id`查看指定线程堆栈。 | 定位CPU飙高、线程死锁、线程卡顿。 |
|
||||
| **trace** | 追踪方法内部调用路径,并统计每个节点的耗时。`trace ClassName methodName`。 | 分析接口或方法响应慢,找出内部调用的性能瓶颈。 |
|
||||
| **watch** | 观察方法的入参、返回值或异常。`watch ClassName methodName "{params, returnObj}"`。 | 动态监测方法调用时的数据,用于排查参数异常或返回值错误。 |
|
||||
| **jad** | 反编译已加载的类到源代码。`jad --source-only ClassName`。 | 确认线上运行的代码是否为预期版本,或在无源码时理解逻辑。 |
|
||||
| **sc** | 查看JVM已加载的类信息。`sc -d *ClassName*`显示类详情(含ClassLoader)。 | 排查类找不到、类冲突,或为`jad`、`mc`等命令提供ClassLoader信息。 |
|
||||
| **heapdump** | 生成JVM堆转储文件(`.hprof`)。 | 转储内存快照,供MAT、VisualVM等工具进行离线内存泄漏分析。 |
|
||||
| **profiler** | 生成CPU/内存火焰图,分析性能热点。`profiler start`/`profiler stop`。 | **深度分析CPU占用过高或内存分配频繁的根本原因**。 |
|
||||
|
||||
### 🔥 如何生成与分析火焰图
|
||||
火焰图能直观展示CPU时间或内存分配在方法调用栈上的分布,是分析性能问题的利器。在Arthas中,主要通过 **`profiler`命令**(基于async-profiler)来实现。
|
||||
|
||||
**1. 生成火焰图**
|
||||
```bash
|
||||
# 1. 启动性能采样(默认采样CPU事件)
|
||||
[arthas@12345]$ profiler start
|
||||
# 可指定采样事件,如分析内存分配:profiler start --event alloc
|
||||
|
||||
# 2. 让应用运行一段时间(如执行某个压测或复现问题场景)
|
||||
|
||||
# 3. 停止采样并生成结果(默认生成HTML格式的火焰图)
|
||||
[arthas@12345]$ profiler stop --format html
|
||||
```
|
||||
停止后,命令行会输出火焰图文件的保存路径,通常位于 `arthas-output/` 目录下。
|
||||
|
||||
**2. 查看火焰图**
|
||||
生成后,你可以直接在浏览器中打开该HTML文件。如果Arthas在本地运行,也可以通过其内置的HTTP服务访问:`http://localhost:3658/arthas-output/`。
|
||||
|
||||
**3. 解读火焰图**
|
||||
- **看布局**:火焰图是**倒置的调用栈**。**每一层代表一个方法调用,下层是上层方法的调用者**。
|
||||
- **找热点**:**横向条块的宽度代表该方法的资源(如CPU时间)占用比例,越宽表示消耗越多**。重点关注最顶部的**“平顶山”**(即一个较宽的方法条块出现在多个调用栈顶部),这通常是性能瓶颈所在。
|
||||
- **分析路径**:结合从下至上的调用链,可以定位到具体是哪条业务执行路径导致了高消耗。
|
||||
|
||||
### 💡 一些实用技巧
|
||||
- **退出与重连**:在Arthas会话中,输入 `stop` 会完全退出Arthas;输入 `quit` 或 `exit` 仅退出当前会话,Attach的进程不受影响。
|
||||
- **条件过滤**:`watch` 和 `trace` 等命令支持条件表达式。例如,`watch ... 'params[0]=="keyword"'` 可以只在第一个参数为特定值时触发观察。
|
||||
- **批处理执行**:可以将多个命令写入脚本文件,通过 `as.sh -f your.as` 一次性执行,适合自动化检查。
|
||||
|
||||
### 🛠️ 典型问题排查流程参考
|
||||
当遇到线上问题时,可以遵循以下步骤使用Arthas:
|
||||
1. **初步定位**:使用 `dashboard` 或 `thread -n 3`,快速判断是CPU、内存还是线程问题。
|
||||
2. **链路追踪**:如果某个接口慢,使用 `trace` 追踪该方法,找到耗时最长的子调用。
|
||||
3. **数据观察**:对疑似有问题的方法使用 `watch`,观察其入参和返回值是否异常。
|
||||
4. **深度分析**:如果发现是某个方法本身消耗大量CPU,使用 `profiler` 生成火焰图,从微观层面分析其内部调用热点。
|
||||
5. **代码确认**:如有必要,使用 `jad` 反编译线上运行的类,确认代码逻辑。
|
||||
|
||||
如果你能告诉我你具体遇到了哪一类性能问题(例如CPU持续过高、接口延迟、内存缓慢增长),我可以为你提供更有针对性的排查思路和命令组合。
|
||||
@@ -0,0 +1,39 @@
|
||||
|
||||
cp参数就是classpath
|
||||
|
||||
```shell
|
||||
java -cp ".;dir/;dir/a.jar;dir/b.jar" Main
|
||||
```
|
||||
|
||||
从java1.6开始,cp参数支持通配符匹配jar文件。需要注意两点:
|
||||
|
||||
1. 用引号`"`
|
||||
2. 用`*`,而不是`*.jar`
|
||||
|
||||
##### Windows:
|
||||
|
||||
```shell
|
||||
java -cp "Test.jar;lib/*" my.package.MainClass
|
||||
```
|
||||
|
||||
##### Linux:
|
||||
|
||||
```shell
|
||||
java -cp "Test.jar:lib/*" my.package.MainClass
|
||||
```
|
||||
|
||||
若不支持通配符,bash shell支持用以下方式:
|
||||
|
||||
```shell
|
||||
java -cp $(echo lib/*.jar | tr ' ' ':')
|
||||
```
|
||||
|
||||
其中先执行`$()`括号中的命令`echo lib/*.jar | tr ' ' ':'`,然后把`$(echo lib/*.jar | tr ' ' ':')`部分替换为命令返回的字符串,再执行替换后的`java`命令。
|
||||
`tr ' ' ':'`会把`空格`替换为`:`
|
||||
|
||||
##### 注意:
|
||||
|
||||
- `-cp "foo/*"`只表示foo目录下的jar,不包括foo下的class,若要包括则用`-cp "foo;foo/*"`或`-cp "foo/*;foo"`,这里的顺序会决定是先加载jar还是class。
|
||||
- `foo/*`不会递归加载foo下子目录的jar。
|
||||
- `foo/*`加载foo目录下的jar顺序不是固定的,所以程序不应该依赖固定的顺序。若需要依赖则用枚举方式而不是通配符方式添加。
|
||||
- manifest.mf中的Class-Path不支持通配符。
|
||||
@@ -0,0 +1,13 @@
|
||||
如果你发送的数据来源于文件(且不需要在应用层修改),可以使用 `transferTo` 直接利用操作系统的 `sendfile` 系统调用,完全避免数据拷贝到用户空间:
|
||||
|
||||
|
||||
FileChannel fileChannel = FileChannel.open(Paths.get("/path/to/file"));
|
||||
SocketChannel socketChannel = SocketChannel.open();
|
||||
socketChannel.connect(address);
|
||||
// 将文件从 offset 开始,共 count 字节直接发往 socket
|
||||
fileChannel.transferTo(offset, count, socketChannel);
|
||||
|
||||
这种情况下,数据直接从文件系统的 page cache 进入 socket 缓冲区,**完全不经过用户空间**,零拷贝。
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,164 @@
|
||||
[Lombok](https://so.csdn.net/so/search?q=Lombok&spm=1001.2101.3001.7020)是一个Java库,它通过注解的方式来简化Java代码的编写。
|
||||
|
||||
## 1、Lombok库中常用的注解
|
||||
|
||||
@Getter:自动生成gette[r方](https://so.csdn.net/so/search?q=r%E6%96%B9&spm=1001.2101.3001.7020)法。
|
||||
|
||||
@Setter:自动生成setter方法。
|
||||
|
||||
@ToString:自动生成[toString方法](https://so.csdn.net/so/search?q=toString%E6%96%B9%E6%B3%95&spm=1001.2101.3001.7020)。
|
||||
|
||||
@EqualsAndHashCode:自动生成equals和hashCode方法。
|
||||
|
||||
@NoArgsConstructor:自动生成无参构造方法。
|
||||
|
||||
@AllArgsConstructor:自动生成全参构造方法。
|
||||
|
||||
@Data:自动生成getter、setter、equals、hashCode和toString方法。
|
||||
|
||||
@Builder:自动生成Builder模式的代码。
|
||||
|
||||
```TypeScript
|
||||
User user = User.builder()
|
||||
.name("Tom")
|
||||
.age(20)
|
||||
.isVip(true)
|
||||
.build();
|
||||
|
||||
12345
|
||||
```
|
||||
|
||||
@Slf4j:自动生成log变量,可以使用log.info()等方法输出日志。
|
||||
|
||||
@NonNull:标注在参数上,生成非空检查代码。
|
||||
|
||||
@Cleanup:自动生成try-finally代码块,用于自动关闭流等资源。
|
||||
|
||||
@Synchronized:自动生成同步代码块。
|
||||
以上是Lombok库中常用的注解,使用这些注解可以大大简化Java代码的编写,减少了代码的冗余。
|
||||
|
||||
@Accessors
|
||||
|
||||
@Accessors(chain=true)
|
||||
链式访问,该注解设置chain=true,生成setter方法返回this(也就是返回的是对象),代替了默认的返回void。
|
||||
|
||||
```TypeScript
|
||||
@Data
|
||||
@Accessors(chain=true)
|
||||
public class User {
|
||||
private Integer id;
|
||||
private String name;
|
||||
private Integer age;
|
||||
|
||||
public static void main(String[] args) {
|
||||
//开起chain=true后可以使用链式的set
|
||||
User user=new User().setAge(31).setName("pollyduan");//返回对象
|
||||
System.out.println(user);
|
||||
}
|
||||
|
||||
}
|
||||
|
||||
1234567891011121314
|
||||
```
|
||||
|
||||
@Accessors(fluent = true)
|
||||
与chain=true类似,区别在于getter和setter不带set和get前缀。
|
||||
|
||||
```TypeScript
|
||||
@Data
|
||||
@Accessors(fluent=true)
|
||||
public class User {
|
||||
private Integer id;
|
||||
private String name;
|
||||
private Integer age;
|
||||
|
||||
public static void main(String[] args) {
|
||||
//fluent=true开启后默认chain=true,故这里也可以使用链式set
|
||||
User user=new User().age(31).name("pollyduan");//不需要写set
|
||||
System.out.println(user);
|
||||
}
|
||||
|
||||
}
|
||||
|
||||
1234567891011121314
|
||||
```
|
||||
|
||||
@Accessors(prefix = “f”)
|
||||
set方法忽略指定的前缀。不推荐大神们这样去命名。
|
||||
|
||||
```TypeScript
|
||||
@Data
|
||||
@Accessors(prefix = "f")
|
||||
public class User {
|
||||
private String fName = "Hello, World!";
|
||||
|
||||
public static void main(String[] args) {
|
||||
User user=new User();
|
||||
user.setName("pollyduan");//注意方法名
|
||||
System.out.println(user);
|
||||
}
|
||||
|
||||
}
|
||||
|
||||
123456789101112
|
||||
```
|
||||
|
||||
## 2、@ToString注解可能引起的问题
|
||||
|
||||
ToString可能会引起堆栈溢出,
|
||||
1、当存在如下两个相互依赖的类时,并且使用了@ToString注解
|
||||
|
||||
```TypeScript
|
||||
@Getter
|
||||
@Setter
|
||||
@ToString
|
||||
public class User implements Serializable {
|
||||
private Person person;
|
||||
}
|
||||
|
||||
123456
|
||||
```
|
||||
|
||||
```TypeScript
|
||||
@Getter
|
||||
@Setter
|
||||
@ToString
|
||||
public class Person implements Serializable {
|
||||
private User user;
|
||||
}
|
||||
|
||||
123456
|
||||
```
|
||||
|
||||
2、两个对象相互依赖的情况下,并且调用了toString()方法。会无限递归调用tostring方法,且创建字符串造成内存溢出。
|
||||
|
||||
```TypeScript
|
||||
public static void main(String[] args) throws InterruptedException {
|
||||
Person person = new Person();
|
||||
User user = new User();
|
||||
person.setUser(user); // 只要任意一个引用为空,就不会内存溢出(例如:person.setUser(null))
|
||||
user.setPerson(person);
|
||||
System.out.println(user.toString()); // 要调用tostring方法才会无限递归
|
||||
}
|
||||
|
||||
1234567
|
||||
```
|
||||
|
||||
因此在使用@ToString和@Data的时候要注意这种情况。
|
||||
可以使用@ToString.Exclude注解来防止无限递归
|
||||
|
||||
```TypeScript
|
||||
@ToString.Exclude
|
||||
private Person person;
|
||||
|
||||
12
|
||||
```
|
||||
|
||||
## 3、@Data注解可能引起的问题
|
||||
|
||||
Lombok中的@Data注解是一个方便的注解,可以自动生成getter、setter、equals、hashCode和toString方法,简化了Java代码的编写。但是,如果使用不当,可能会出现以下问题:
|
||||
|
||||
- toString()方法可能引发无限递归:当一个类中的属性是另一个类的对象时,如果两个类都使用了@Data注解,就会出现toString()方法的无限递归,导致栈溢出。可以通过使用@ToString.Exclude注解来排除不需要在toString()方法中输出的属性。(上面已讲)
|
||||
|
||||
- 可能会降低代码的可读性:虽然@Data注解可以大大简化Java代码的编写,但是有时候自动生成的代码可能会比较复杂,降低了代码的可读性。可以根据实际情况选择使用@Data注解或手动编写getter、setter、equals、hashCode和toString方法。
|
||||
|
||||
+164
@@ -0,0 +1,164 @@
|
||||
[Lombok](https://so.csdn.net/so/search?q=Lombok&spm=1001.2101.3001.7020)是一个Java库,它通过注解的方式来简化Java代码的编写。
|
||||
|
||||
## 1、Lombok库中常用的注解
|
||||
|
||||
@Getter:自动生成gette[r方](https://so.csdn.net/so/search?q=r%E6%96%B9&spm=1001.2101.3001.7020)法。
|
||||
|
||||
@Setter:自动生成setter方法。
|
||||
|
||||
@ToString:自动生成[toString方法](https://so.csdn.net/so/search?q=toString%E6%96%B9%E6%B3%95&spm=1001.2101.3001.7020)。
|
||||
|
||||
@EqualsAndHashCode:自动生成equals和hashCode方法。
|
||||
|
||||
@NoArgsConstructor:自动生成无参构造方法。
|
||||
|
||||
@AllArgsConstructor:自动生成全参构造方法。
|
||||
|
||||
@Data:自动生成getter、setter、equals、hashCode和toString方法。
|
||||
|
||||
@Builder:自动生成Builder模式的代码。
|
||||
|
||||
```TypeScript
|
||||
User user = User.builder()
|
||||
.name("Tom")
|
||||
.age(20)
|
||||
.isVip(true)
|
||||
.build();
|
||||
|
||||
12345
|
||||
```
|
||||
|
||||
@Slf4j:自动生成log变量,可以使用log.info()等方法输出日志。
|
||||
|
||||
@NonNull:标注在参数上,生成非空检查代码。
|
||||
|
||||
@Cleanup:自动生成try-finally代码块,用于自动关闭流等资源。
|
||||
|
||||
@Synchronized:自动生成同步代码块。
|
||||
以上是Lombok库中常用的注解,使用这些注解可以大大简化Java代码的编写,减少了代码的冗余。
|
||||
|
||||
@Accessors
|
||||
|
||||
@Accessors(chain=true)
|
||||
链式访问,该注解设置chain=true,生成setter方法返回this(也就是返回的是对象),代替了默认的返回void。
|
||||
|
||||
```TypeScript
|
||||
@Data
|
||||
@Accessors(chain=true)
|
||||
public class User {
|
||||
private Integer id;
|
||||
private String name;
|
||||
private Integer age;
|
||||
|
||||
public static void main(String[] args) {
|
||||
//开起chain=true后可以使用链式的set
|
||||
User user=new User().setAge(31).setName("pollyduan");//返回对象
|
||||
System.out.println(user);
|
||||
}
|
||||
|
||||
}
|
||||
|
||||
1234567891011121314
|
||||
```
|
||||
|
||||
@Accessors(fluent = true)
|
||||
与chain=true类似,区别在于getter和setter不带set和get前缀。
|
||||
|
||||
```TypeScript
|
||||
@Data
|
||||
@Accessors(fluent=true)
|
||||
public class User {
|
||||
private Integer id;
|
||||
private String name;
|
||||
private Integer age;
|
||||
|
||||
public static void main(String[] args) {
|
||||
//fluent=true开启后默认chain=true,故这里也可以使用链式set
|
||||
User user=new User().age(31).name("pollyduan");//不需要写set
|
||||
System.out.println(user);
|
||||
}
|
||||
|
||||
}
|
||||
|
||||
1234567891011121314
|
||||
```
|
||||
|
||||
@Accessors(prefix = “f”)
|
||||
set方法忽略指定的前缀。不推荐大神们这样去命名。
|
||||
|
||||
```TypeScript
|
||||
@Data
|
||||
@Accessors(prefix = "f")
|
||||
public class User {
|
||||
private String fName = "Hello, World!";
|
||||
|
||||
public static void main(String[] args) {
|
||||
User user=new User();
|
||||
user.setName("pollyduan");//注意方法名
|
||||
System.out.println(user);
|
||||
}
|
||||
|
||||
}
|
||||
|
||||
123456789101112
|
||||
```
|
||||
|
||||
## 2、@ToString注解可能引起的问题
|
||||
|
||||
ToString可能会引起堆栈溢出,
|
||||
1、当存在如下两个相互依赖的类时,并且使用了@ToString注解
|
||||
|
||||
```TypeScript
|
||||
@Getter
|
||||
@Setter
|
||||
@ToString
|
||||
public class User implements Serializable {
|
||||
private Person person;
|
||||
}
|
||||
|
||||
123456
|
||||
```
|
||||
|
||||
```TypeScript
|
||||
@Getter
|
||||
@Setter
|
||||
@ToString
|
||||
public class Person implements Serializable {
|
||||
private User user;
|
||||
}
|
||||
|
||||
123456
|
||||
```
|
||||
|
||||
2、两个对象相互依赖的情况下,并且调用了toString()方法。会无限递归调用tostring方法,且创建字符串造成内存溢出。
|
||||
|
||||
```TypeScript
|
||||
public static void main(String[] args) throws InterruptedException {
|
||||
Person person = new Person();
|
||||
User user = new User();
|
||||
person.setUser(user); // 只要任意一个引用为空,就不会内存溢出(例如:person.setUser(null))
|
||||
user.setPerson(person);
|
||||
System.out.println(user.toString()); // 要调用tostring方法才会无限递归
|
||||
}
|
||||
|
||||
1234567
|
||||
```
|
||||
|
||||
因此在使用@ToString和@Data的时候要注意这种情况。
|
||||
可以使用@ToString.Exclude注解来防止无限递归
|
||||
|
||||
```TypeScript
|
||||
@ToString.Exclude
|
||||
private Person person;
|
||||
|
||||
12
|
||||
```
|
||||
|
||||
## 3、@Data注解可能引起的问题
|
||||
|
||||
Lombok中的@Data注解是一个方便的注解,可以自动生成getter、setter、equals、hashCode和toString方法,简化了Java代码的编写。但是,如果使用不当,可能会出现以下问题:
|
||||
|
||||
- toString()方法可能引发无限递归:当一个类中的属性是另一个类的对象时,如果两个类都使用了@Data注解,就会出现toString()方法的无限递归,导致栈溢出。可以通过使用@ToString.Exclude注解来排除不需要在toString()方法中输出的属性。(上面已讲)
|
||||
|
||||
- 可能会降低代码的可读性:虽然@Data注解可以大大简化Java代码的编写,但是有时候自动生成的代码可能会比较复杂,降低了代码的可读性。可以根据实际情况选择使用@Data注解或手动编写getter、setter、equals、hashCode和toString方法。
|
||||
|
||||
@@ -0,0 +1,4 @@
|
||||
# 依赖范围与 classpath 的关系表
|
||||
|
||||

|
||||
|
||||
BIN

Binary file not shown.
|
After Width: | Height: | Size: 77 KiB |
@@ -0,0 +1,4 @@
|
||||
# 依赖范围与 classpath 的关系表
|
||||
|
||||

|
||||
|
||||
@@ -0,0 +1,110 @@
|
||||
|
||||
|
||||
```Plain Text
|
||||
<dependency>
|
||||
<groupId>mysql</groupId>
|
||||
<artifactId>mysql-connector-java</artifactId>
|
||||
</dependency>
|
||||
<dependency>
|
||||
<groupId>org.mybatis.spring.boot</groupId>
|
||||
<artifactId>mybatis-spring-boot-starter</artifactId>
|
||||
<version>2.1.4</version>
|
||||
</dependency>
|
||||
<dependency>
|
||||
<groupId>com.alibaba</groupId>
|
||||
<artifactId>druid-spring-boot-starter</artifactId>
|
||||
<version>1.1.9</version>
|
||||
</dependency>
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
springboot 2.3.4.Release版本配置文件配置
|
||||
|
||||
```Plain Text
|
||||
spring:
|
||||
datasource:
|
||||
username: root
|
||||
password: root
|
||||
url: jdbc:mysql://localhost:3306/test?useUnicode=true&characterEncoding=utf-8&useSSL=false&serverTimezone=GMT%2B8
|
||||
driver-class-name: com.mysql.cj.jdbc.Driver
|
||||
type: com.alibaba.druid.pool.DruidDataSource
|
||||
#项目启动执行建表语句,classpath指定sql文件的位置
|
||||
schema:
|
||||
- classpath:sql/init.sql
|
||||
initialization-mode: always
|
||||
platform: mysql
|
||||
sql-script-encoding: UTF-8
|
||||
```
|
||||
|
||||
1
|
||||
2
|
||||
3
|
||||
4
|
||||
5
|
||||
6
|
||||
7
|
||||
8
|
||||
9
|
||||
10
|
||||
11
|
||||
12
|
||||
13
|
||||
14
|
||||
15
|
||||
springboot 2.6.4版本配置文件配置(谢谢nreg的指出)
|
||||
|
||||
spring:
|
||||
sql:
|
||||
init:
|
||||
separator: ; #断句分隔符,默认为 ; 号,如果执行语句中有 存储过程 或 游标 这种 则需要更改
|
||||
encoding: UTF-8
|
||||
platform: sqlite #默认值为all 在不同数据库切换的情况下才使用 all 配置,spring boot 会自动检测当前使用的数据库
|
||||
mode: always # 初始化模式,有三个值:always:始终执行初始化、embedded:只初始化内存数据库(默认)、never:不执行初始化
|
||||
schema-locations: #表初始化语句 DDL,默认加载 schema.sql
|
||||
- classpath:sql/schema.sql
|
||||
data-locations: #数据初始化 DQL(数据查询)或 DML(数据操作),默认加载 data.sql,
|
||||
- classpath:sql/data.sql
|
||||
1
|
||||
2
|
||||
3
|
||||
4
|
||||
5
|
||||
6
|
||||
7
|
||||
8
|
||||
9
|
||||
10
|
||||
11
|
||||
sql文件填写
|
||||
|
||||
---
|
||||
|
||||
-- Table structure for t1
|
||||
|
||||
---
|
||||
|
||||
DROP TABLE IF EXISTS `t1`;
|
||||
CREATE TABLE `t1` (
|
||||
`id` int(11) NOT NULL,
|
||||
`name` varchar(10) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
|
||||
PRIMARY KEY (`id`) USING BTREE
|
||||
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Dynamic;
|
||||
|
||||
---
|
||||
|
||||
-- Records of t1
|
||||
|
||||
---
|
||||
|
||||
INSERT INTO `t1` VALUES (1, '1');
|
||||
INSERT INTO `t1` VALUES (2, '2');
|
||||
INSERT INTO `t1` VALUES (3, '3');
|
||||
|
||||
SET FOREIGN_KEY_CHECKS = 1;
|
||||
————————————————
|
||||
版权声明:本文为CSDN博主「知识浅谈」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
|
||||
原文链接:[https://blog.csdn.net/qq_37699336/article/details/119877899](https://blog.csdn.net/qq_37699336/article/details/119877899)
|
||||
|
||||
+110
@@ -0,0 +1,110 @@
|
||||
|
||||
|
||||
```Plain Text
|
||||
<dependency>
|
||||
<groupId>mysql</groupId>
|
||||
<artifactId>mysql-connector-java</artifactId>
|
||||
</dependency>
|
||||
<dependency>
|
||||
<groupId>org.mybatis.spring.boot</groupId>
|
||||
<artifactId>mybatis-spring-boot-starter</artifactId>
|
||||
<version>2.1.4</version>
|
||||
</dependency>
|
||||
<dependency>
|
||||
<groupId>com.alibaba</groupId>
|
||||
<artifactId>druid-spring-boot-starter</artifactId>
|
||||
<version>1.1.9</version>
|
||||
</dependency>
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
springboot 2.3.4.Release版本配置文件配置
|
||||
|
||||
```Plain Text
|
||||
spring:
|
||||
datasource:
|
||||
username: root
|
||||
password: root
|
||||
url: jdbc:mysql://localhost:3306/test?useUnicode=true&characterEncoding=utf-8&useSSL=false&serverTimezone=GMT%2B8
|
||||
driver-class-name: com.mysql.cj.jdbc.Driver
|
||||
type: com.alibaba.druid.pool.DruidDataSource
|
||||
#项目启动执行建表语句,classpath指定sql文件的位置
|
||||
schema:
|
||||
- classpath:sql/init.sql
|
||||
initialization-mode: always
|
||||
platform: mysql
|
||||
sql-script-encoding: UTF-8
|
||||
```
|
||||
|
||||
1
|
||||
2
|
||||
3
|
||||
4
|
||||
5
|
||||
6
|
||||
7
|
||||
8
|
||||
9
|
||||
10
|
||||
11
|
||||
12
|
||||
13
|
||||
14
|
||||
15
|
||||
springboot 2.6.4版本配置文件配置(谢谢nreg的指出)
|
||||
|
||||
spring:
|
||||
sql:
|
||||
init:
|
||||
separator: ; #断句分隔符,默认为 ; 号,如果执行语句中有 存储过程 或 游标 这种 则需要更改
|
||||
encoding: UTF-8
|
||||
platform: sqlite #默认值为all 在不同数据库切换的情况下才使用 all 配置,spring boot 会自动检测当前使用的数据库
|
||||
mode: always # 初始化模式,有三个值:always:始终执行初始化、embedded:只初始化内存数据库(默认)、never:不执行初始化
|
||||
schema-locations: #表初始化语句 DDL,默认加载 schema.sql
|
||||
- classpath:sql/schema.sql
|
||||
data-locations: #数据初始化 DQL(数据查询)或 DML(数据操作),默认加载 data.sql,
|
||||
- classpath:sql/data.sql
|
||||
1
|
||||
2
|
||||
3
|
||||
4
|
||||
5
|
||||
6
|
||||
7
|
||||
8
|
||||
9
|
||||
10
|
||||
11
|
||||
sql文件填写
|
||||
|
||||
---
|
||||
|
||||
-- Table structure for t1
|
||||
|
||||
---
|
||||
|
||||
DROP TABLE IF EXISTS `t1`;
|
||||
CREATE TABLE `t1` (
|
||||
`id` int(11) NOT NULL,
|
||||
`name` varchar(10) CHARACTER SET utf8 COLLATE utf8_general_ci NULL DEFAULT NULL,
|
||||
PRIMARY KEY (`id`) USING BTREE
|
||||
) ENGINE = InnoDB CHARACTER SET = utf8 COLLATE = utf8_general_ci ROW_FORMAT = Dynamic;
|
||||
|
||||
---
|
||||
|
||||
-- Records of t1
|
||||
|
||||
---
|
||||
|
||||
INSERT INTO `t1` VALUES (1, '1');
|
||||
INSERT INTO `t1` VALUES (2, '2');
|
||||
INSERT INTO `t1` VALUES (3, '3');
|
||||
|
||||
SET FOREIGN_KEY_CHECKS = 1;
|
||||
————————————————
|
||||
版权声明:本文为CSDN博主「知识浅谈」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
|
||||
原文链接:[https://blog.csdn.net/qq_37699336/article/details/119877899](https://blog.csdn.net/qq_37699336/article/details/119877899)
|
||||
|
||||
@@ -0,0 +1,13 @@
|
||||
DK 1.5 后推出的 ConcurrentHashMap,是一个高性能的线程安全的哈希表容器。“线程安全”这四个字特别容易让人误解,因为 ConcurrentHashMap 能保证提供的原子性读写操作是线程安全的。
|
||||
|
||||
我们可以举一个形象的例子。ConcurrentHashMap 就像是一个大篮子,现在这个篮子里有 900 个桔子,我们期望把这个篮子装满 1000 个桔子,也就是再装 100 个桔子。有 10 个工人来干这件事儿,大家先后到岗后会计算还需要补多少个桔子进去,最后把桔子装入篮子。
|
||||
|
||||
ConcurrentHashMap 这个篮子本身,可以确保多个工人在装东西进去时,不会相互影响干扰,但无法确保工人 A 看到还需要装 100 个桔子但是还未装的时候,工人 B 就看不到篮子中的桔子数量。更值得注意的是,你往这个篮子装 100 个桔子的操作不是原子性的,在别人看来可能会有一个瞬间篮子里有 964 个桔子,还需要补 36 个桔子。
|
||||
|
||||
回到 ConcurrentHashMap,我们需要注意 ConcurrentHashMap 对外提供的方法或能力的限制:
|
||||
|
||||
1、使用了 ConcurrentHashMap,不代表对它的多个操作之间的状态是一致的,是没有其他线程在操作它的,如果需要确保需要手动加锁。
|
||||
|
||||
2、诸如 size、isEmpty 和 containsValue 等聚合方法,在并发情况下可能会反映 ConcurrentHashMap 的中间状态。因此在并发情况下,这些方法的返回值只能用作参考,而不能用于流程控制。显然,利用 size 方法计算差异值,是一个流程控制。
|
||||
|
||||
3、诸如 putAll 这样的聚合方法也不能确保原子性,在 putAll 的过程中去获取数据可能会获取到部分数据。
|
||||
@@ -0,0 +1,125 @@
|
||||
FastThreadLocal 从字面意义上来看,它是“Fast”+“ThreadLocal”的结合体,寓意为快速的 ThreadLocal。那么,问题来了,Netty 为什么要再造一个 FastThreadLocal?FastThreadLocal 运行快的原因是啥?除了快之外,它还有其他优势吗?
|
||||
|
||||
### 1.先从ThreadLocal说起
|
||||
|
||||
ThreadLocal 线程本地变量,每个线程都拥有一份该变量的独立副本,即使是在多线程环境下,每个线程也只能修改和访问自己的那份副本,从而避免了线程安全问题,实现了线程间的隔离。
|
||||
|
||||
ThreadLocal 底层是使用 ThreadLocalMap 实现的,这点从 JDK 的源码中可以看出,核心源码如下:
|
||||
|
||||
```java
|
||||
private void set(Thread t, T value) {
|
||||
ThreadLocalMap map = getMap(t);
|
||||
if (map != null) {
|
||||
map.set(this, value);
|
||||
} else {
|
||||
createMap(t, value);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
从 ThreadLocal 的 set 方法可以看出,ThreadLocal 是存储在 ThreadLocalMap 中的,咱们继续看 ThreadLocalMap 的源码实现:
|
||||
|
||||
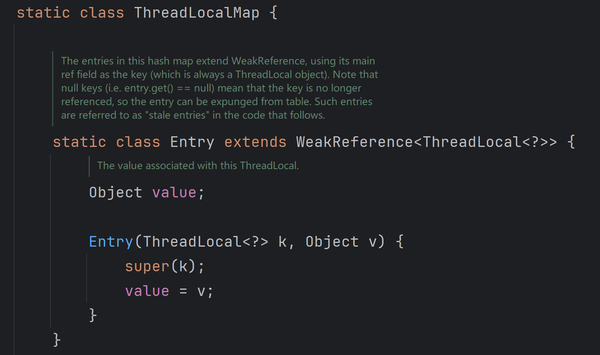
|
||||
|
||||
从上面源码可以看出,ThreadLocalMap 中存放的是 Entry(哈希桶),而 Entry 中的 key 就是 ThreadLocal,而 value 则是要存储的值,所以我们得出 ThreadLocal 的底层实现如下:
|
||||
|
||||
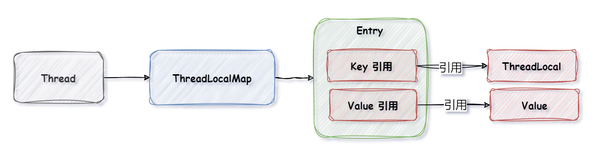
|
||||
|
||||
|
||||
|
||||
### 2.ThreadLocal存在的问题
|
||||
|
||||
### 2.1 性能问题
|
||||
|
||||
因为 ThreadLocal 底层是使用 ThreadLocalMap 实现的,ThreadLocalMap 类似于哈希表。当一个线程是拥有多个 ThreadLocal 时,ThreadLocalMap 很容易发生 Hash 冲突,此时 ThreadLocal 就不得不使用线性探测法来解决哈希冲突了,而在解决 Hash 冲突时需要不停地向下寻找,效率较低,因此 ThreadLocal 存在的第一个问题就是性能较低。
|
||||
|
||||
### 2.2 内存泄漏问题
|
||||
|
||||
ThreadLocal 也存在内存泄漏的问题,具体来说 ThreadLocalMap 使用 ThreadLocal 对象作为键(Key),并且这个键是弱引用(WeakReference)类型。这意味着当没有其他强引用指向 ThreadLocal 对象时,它将会在下次垃圾回收时被回收。然而,Entry 中保存的值(Value)仍然是强引用,这就可能导致以下问题:
|
||||
|
||||
1. **弱引用键的回收**:一旦外部对 ThreadLocal 实例的所有强引用消失,ThreadLocal 对象本身就会变为弱可达状态。在下一次垃圾回收时,由于是弱引用,ThreadLocal 对象会被回收,但 Entry 中的 Value(即实际存储的数据)仍然是强引用,因此不会被回收。
|
||||
2. **Map 引用陷阱**:即使 ThreadLocal 键被回收,Entry 仍然存在于 ThreadLocalMap 中,并且由于 Map 对 Entry 的引用,这些 Entry 所持有的 Value 对象也不会被垃圾回收,从而导致这些对象无法被使用也无法被释放,形成了所谓的“内存泄漏”。
|
||||
3. **线程长期存活**:在一些场景下,特别是使用线程池时,线程的生命周期往往很长,甚至伴随整个应用的生命周期。这意味着 ThreadLocalMap 中的 Entry 可能会长时间不被清理,进一步加剧了内存泄漏问题。
|
||||
|
||||
所以,综合来看,在使用 ThreadLocal 时,如果在使用完之后,未及时调用 remove() 方法的话,就会出现内存泄漏的问题。
|
||||
|
||||
### 3.FastThreadLocal特点
|
||||
|
||||
为了解决 ThreadLocal 存在的这些问题,所以 Netty 创造出了一个 FastThreadLocal,FastThreadLocal 的特点如下。
|
||||
|
||||
### 3.1 效率高
|
||||
|
||||
FastThreadLocal 之所以性能高的原因是因为其存储结构,在 FastThreadLocal 中并没有向 ThreadLocal 那样,使用哈希表来存储元素,而是使用了数组来进行元素存储,它的核心实现源码如下:
|
||||
|
||||
```java
|
||||
public class FastThreadLocal<V> {
|
||||
// FastThreadLocal中的index是记录了该它维护的数据应该存储的位置
|
||||
// InternalThreadLocalMap数组中的下标, 它是在构造函数中确定的
|
||||
private final int index;
|
||||
|
||||
public InternalThreadLocal() {
|
||||
index = InternalThreadLocalMap.nextVariableIndex();
|
||||
}
|
||||
// 省略其他代码
|
||||
}
|
||||
```
|
||||
|
||||
FastThreadLocal 核心类 InternalThreadLocalMap 的实现源码如下:
|
||||
|
||||
```java
|
||||
public final class InternalThreadLocalMap extends UnpaddedInternalThreadLocalMap {
|
||||
// 自增索引, ⽤于计算下次存储到Object数组中的位置
|
||||
private static final AtomicInteger nextIndex = new AtomicInteger();
|
||||
|
||||
private static final int ARRAY_LIST_CAPACITY_MAX_SIZE = Integer.MAX_VALUE - 8;
|
||||
|
||||
public static int nextVariableIndex() {
|
||||
int index = nextIndex.getAndIncrement();
|
||||
if (index >= ARRAY_LIST_CAPACITY_MAX_SIZE || index < 0) {
|
||||
nextIndex.set(ARRAY_LIST_CAPACITY_MAX_SIZE);
|
||||
throw new IllegalStateException("too many thread-local indexed variables");
|
||||
}
|
||||
return index;
|
||||
}
|
||||
// 省略其他代码
|
||||
}
|
||||
```
|
||||
|
||||
从上述源码可以看出,FastThreadLocal 在初始化的时候分配一个数组索引 index,index 的值采用原子类 AtomicInteger 保证顺序递增,通过调用 InternalThreadLocalMap.nextVariableIndex() 方法获得。然后在读写数据的时候通过数组下标 index 直接定位到 FastThreadLocal 的位置,时间复杂度为 O(1)。如果数组下标递增到非常大,那么数组也会比较大,所以 FastThreadLocal 是通过空间换时间的思想提升读写性能。
|
||||
|
||||
因此,在 FastThreadLocal 中并不需要使用线性探测法来解决 Hash 冲突,因为它是使用数组进行存储的,每次使用下标进行查询即可,它的查询时间复杂度也是 O(1) 的,所以它的操作效率很高。
|
||||
|
||||
### 3.2 安全性更高
|
||||
|
||||
JDK 原生的 ThreadLocal 使用不当可能造成内存泄漏,只能等待线程销毁。**然而 FastThreadLocal 却不存在这个问题,在 FastThreadLocal 中不仅提供了 remove() 方法可以主动清除对象,而且它还封装了 FastThreadLocalRunnable,FastThreadLocalRunnable 在最后使用完之后会自动调用 removeAll() 方法将集合中所有对象清理掉,因此 FastThreadLocal 更安全。**
|
||||
|
||||
FastThreadLocalRunnable 自动清除对象的实现核心源码如下:
|
||||
|
||||
```java
|
||||
final class FastThreadLocalRunnable implements Runnable {
|
||||
private final Runnable runnable;
|
||||
@Override
|
||||
public void run() {
|
||||
try {
|
||||
runnable.run();
|
||||
} finally {
|
||||
FastThreadLocal.removeAll();
|
||||
}
|
||||
}
|
||||
static Runnable wrap(Runnable runnable) {
|
||||
return runnable instanceof FastThreadLocalRunnable
|
||||
? runnable : new FastThreadLocalRunnable(runnable);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
### 4.小结
|
||||
|
||||
FastThreadLocal 相比于 ThreadLocal 存在以下两个主要优点:
|
||||
|
||||
1. **性能更高**:FastThreadLocal 使用了数组的方式来存储元素,所以它的查询时间复杂度 O(1) 相比于 ThreadLocal 的哈希表操作效率更高。
|
||||
2. **安全性更高**:FastThreadLocal 中的 FastThreadLocalRunnable 在最后执行完之后会自动调用 removeAll() 将集合中所有对象都清理掉,可以避免内存泄漏的问题,所以它的安全性更高。
|
||||
|
||||
### 课后思考
|
||||
|
||||
FastThreadLocal 有什么缺点?使用 FastThreadLocal 一定比 ThreadLocal 性能高吗?
|
||||
@@ -0,0 +1,125 @@
|
||||
FastThreadLocal 从字面意义上来看,它是“Fast”+“ThreadLocal”的结合体,寓意为快速的 ThreadLocal。那么,问题来了,Netty 为什么要再造一个 FastThreadLocal?FastThreadLocal 运行快的原因是啥?除了快之外,它还有其他优势吗?
|
||||
|
||||
### 1.先从ThreadLocal说起
|
||||
|
||||
ThreadLocal 线程本地变量,每个线程都拥有一份该变量的独立副本,即使是在多线程环境下,每个线程也只能修改和访问自己的那份副本,从而避免了线程安全问题,实现了线程间的隔离。
|
||||
|
||||
ThreadLocal 底层是使用 ThreadLocalMap 实现的,这点从 JDK 的源码中可以看出,核心源码如下:
|
||||
|
||||
```java
|
||||
private void set(Thread t, T value) {
|
||||
ThreadLocalMap map = getMap(t);
|
||||
if (map != null) {
|
||||
map.set(this, value);
|
||||
} else {
|
||||
createMap(t, value);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
从 ThreadLocal 的 set 方法可以看出,ThreadLocal 是存储在 ThreadLocalMap 中的,咱们继续看 ThreadLocalMap 的源码实现:
|
||||
|
||||

|
||||
|
||||
从上面源码可以看出,ThreadLocalMap 中存放的是 Entry(哈希桶),而 Entry 中的 key 就是 ThreadLocal,而 value 则是要存储的值,所以我们得出 ThreadLocal 的底层实现如下:
|
||||
|
||||

|
||||
|
||||
|
||||
|
||||
### 2.ThreadLocal存在的问题
|
||||
|
||||
### 2.1 性能问题
|
||||
|
||||
因为 ThreadLocal 底层是使用 ThreadLocalMap 实现的,ThreadLocalMap 类似于哈希表。当一个线程是拥有多个 ThreadLocal 时,ThreadLocalMap 很容易发生 Hash 冲突,此时 ThreadLocal 就不得不使用线性探测法来解决哈希冲突了,而在解决 Hash 冲突时需要不停地向下寻找,效率较低,因此 ThreadLocal 存在的第一个问题就是性能较低。
|
||||
|
||||
### 2.2 内存泄漏问题
|
||||
|
||||
ThreadLocal 也存在内存泄漏的问题,具体来说 ThreadLocalMap 使用 ThreadLocal 对象作为键(Key),并且这个键是弱引用(WeakReference)类型。这意味着当没有其他强引用指向 ThreadLocal 对象时,它将会在下次垃圾回收时被回收。然而,Entry 中保存的值(Value)仍然是强引用,这就可能导致以下问题:
|
||||
|
||||
1. **弱引用键的回收**:一旦外部对 ThreadLocal 实例的所有强引用消失,ThreadLocal 对象本身就会变为弱可达状态。在下一次垃圾回收时,由于是弱引用,ThreadLocal 对象会被回收,但 Entry 中的 Value(即实际存储的数据)仍然是强引用,因此不会被回收。
|
||||
2. **Map 引用陷阱**:即使 ThreadLocal 键被回收,Entry 仍然存在于 ThreadLocalMap 中,并且由于 Map 对 Entry 的引用,这些 Entry 所持有的 Value 对象也不会被垃圾回收,从而导致这些对象无法被使用也无法被释放,形成了所谓的“内存泄漏”。
|
||||
3. **线程长期存活**:在一些场景下,特别是使用线程池时,线程的生命周期往往很长,甚至伴随整个应用的生命周期。这意味着 ThreadLocalMap 中的 Entry 可能会长时间不被清理,进一步加剧了内存泄漏问题。
|
||||
|
||||
所以,综合来看,在使用 ThreadLocal 时,如果在使用完之后,未及时调用 remove() 方法的话,就会出现内存泄漏的问题。
|
||||
|
||||
### 3.FastThreadLocal特点
|
||||
|
||||
为了解决 ThreadLocal 存在的这些问题,所以 Netty 创造出了一个 FastThreadLocal,FastThreadLocal 的特点如下。
|
||||
|
||||
### 3.1 效率高
|
||||
|
||||
FastThreadLocal 之所以性能高的原因是因为其存储结构,在 FastThreadLocal 中并没有向 ThreadLocal 那样,使用哈希表来存储元素,而是使用了数组来进行元素存储,它的核心实现源码如下:
|
||||
|
||||
```java
|
||||
public class FastThreadLocal<V> {
|
||||
// FastThreadLocal中的index是记录了该它维护的数据应该存储的位置
|
||||
// InternalThreadLocalMap数组中的下标, 它是在构造函数中确定的
|
||||
private final int index;
|
||||
|
||||
public InternalThreadLocal() {
|
||||
index = InternalThreadLocalMap.nextVariableIndex();
|
||||
}
|
||||
// 省略其他代码
|
||||
}
|
||||
```
|
||||
|
||||
FastThreadLocal 核心类 InternalThreadLocalMap 的实现源码如下:
|
||||
|
||||
```java
|
||||
public final class InternalThreadLocalMap extends UnpaddedInternalThreadLocalMap {
|
||||
// 自增索引, ⽤于计算下次存储到Object数组中的位置
|
||||
private static final AtomicInteger nextIndex = new AtomicInteger();
|
||||
|
||||
private static final int ARRAY_LIST_CAPACITY_MAX_SIZE = Integer.MAX_VALUE - 8;
|
||||
|
||||
public static int nextVariableIndex() {
|
||||
int index = nextIndex.getAndIncrement();
|
||||
if (index >= ARRAY_LIST_CAPACITY_MAX_SIZE || index < 0) {
|
||||
nextIndex.set(ARRAY_LIST_CAPACITY_MAX_SIZE);
|
||||
throw new IllegalStateException("too many thread-local indexed variables");
|
||||
}
|
||||
return index;
|
||||
}
|
||||
// 省略其他代码
|
||||
}
|
||||
```
|
||||
|
||||
从上述源码可以看出,FastThreadLocal 在初始化的时候分配一个数组索引 index,index 的值采用原子类 AtomicInteger 保证顺序递增,通过调用 InternalThreadLocalMap.nextVariableIndex() 方法获得。然后在读写数据的时候通过数组下标 index 直接定位到 FastThreadLocal 的位置,时间复杂度为 O(1)。如果数组下标递增到非常大,那么数组也会比较大,所以 FastThreadLocal 是通过空间换时间的思想提升读写性能。
|
||||
|
||||
因此,在 FastThreadLocal 中并不需要使用线性探测法来解决 Hash 冲突,因为它是使用数组进行存储的,每次使用下标进行查询即可,它的查询时间复杂度也是 O(1) 的,所以它的操作效率很高。
|
||||
|
||||
### 3.2 安全性更高
|
||||
|
||||
JDK 原生的 ThreadLocal 使用不当可能造成内存泄漏,只能等待线程销毁。**然而 FastThreadLocal 却不存在这个问题,在 FastThreadLocal 中不仅提供了 remove() 方法可以主动清除对象,而且它还封装了 FastThreadLocalRunnable,FastThreadLocalRunnable 在最后使用完之后会自动调用 removeAll() 方法将集合中所有对象清理掉,因此 FastThreadLocal 更安全。**
|
||||
|
||||
FastThreadLocalRunnable 自动清除对象的实现核心源码如下:
|
||||
|
||||
```java
|
||||
final class FastThreadLocalRunnable implements Runnable {
|
||||
private final Runnable runnable;
|
||||
@Override
|
||||
public void run() {
|
||||
try {
|
||||
runnable.run();
|
||||
} finally {
|
||||
FastThreadLocal.removeAll();
|
||||
}
|
||||
}
|
||||
static Runnable wrap(Runnable runnable) {
|
||||
return runnable instanceof FastThreadLocalRunnable
|
||||
? runnable : new FastThreadLocalRunnable(runnable);
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
### 4.小结
|
||||
|
||||
FastThreadLocal 相比于 ThreadLocal 存在以下两个主要优点:
|
||||
|
||||
1. **性能更高**:FastThreadLocal 使用了数组的方式来存储元素,所以它的查询时间复杂度 O(1) 相比于 ThreadLocal 的哈希表操作效率更高。
|
||||
2. **安全性更高**:FastThreadLocal 中的 FastThreadLocalRunnable 在最后执行完之后会自动调用 removeAll() 将集合中所有对象都清理掉,可以避免内存泄漏的问题,所以它的安全性更高。
|
||||
|
||||
### 课后思考
|
||||
|
||||
FastThreadLocal 有什么缺点?使用 FastThreadLocal 一定比 ThreadLocal 性能高吗?
|
||||
@@ -0,0 +1,73 @@
|
||||
|
||||
|
||||
原创 阿伟的水杯 阿伟的水杯
|
||||
|
||||
_2026年4月15日 17:01_ _广东_
|
||||
|
||||
现在有一个打包好的jar包,如果我想修改jar包里某个类的某段代码,但是我又不会写字节码,那要如何操作呢?
|
||||
|
||||
很简单,主要是利用了javassist库去直接操作打包好的字节码
|
||||
|
||||
先引入:
|
||||
|
||||
```
|
||||
<dependency>
|
||||
```
|
||||
|
||||
然后直接上代码:
|
||||
|
||||
```
|
||||
public static void main(String[] args) throws Exception {
|
||||
```
|
||||
|
||||
运行,就会把那个class单独打包出来了,把class覆盖回jar包就可以了。
|
||||
|
||||
使用命令
|
||||
|
||||
```
|
||||
jar uvf xxxx.jar com/xxx/af/f/e.class
|
||||
```
|
||||
|
||||
就可以直接替换jar包里的类了。
|
||||
|
||||
解析:
|
||||
|
||||
首先是引入包,以及类,这个很简单,使用压缩软件打开jar包就知道对应的类名是什么了:
|
||||
|
||||
```
|
||||
ClassPoolclassPool= ClassPool.getDefault();
|
||||
```
|
||||
|
||||
接着重点就是构造内容:
|
||||
|
||||
```
|
||||
//要改动的方法
|
||||
```
|
||||
|
||||
有多种方法获取对应方法:
|
||||
|
||||
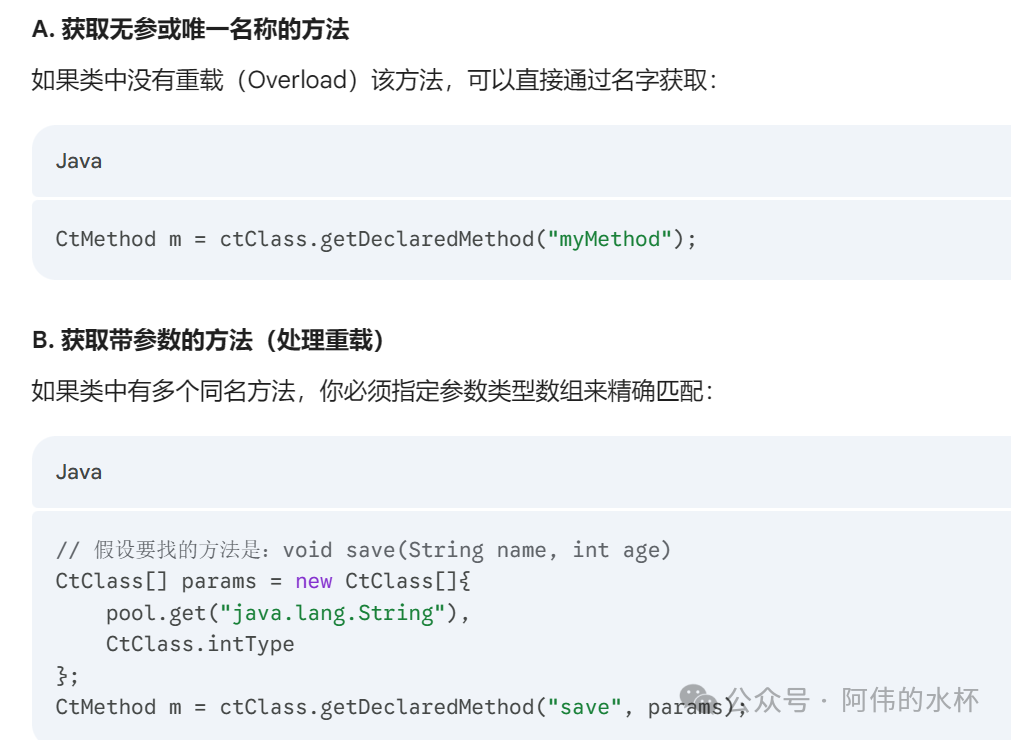
|
||||
|
||||
根据方法的参数情况选择对应的处理方法即可。
|
||||
|
||||
接着是构造方法体的代码:
|
||||
|
||||
javassist不需要写字节码,完全按普通java代码写即可。只要改几个地方:
|
||||
|
||||
1. 类名,因为类名涉及import,所以一般用类的全名,可以有效规避import的问题,不用import类。
|
||||
|
||||
2.入参写法,入参要使用**`$1, $2...`**代表方法的第 1、2... 个参数
|
||||
|
||||
其他的特殊符号还包括:
|
||||
|
||||
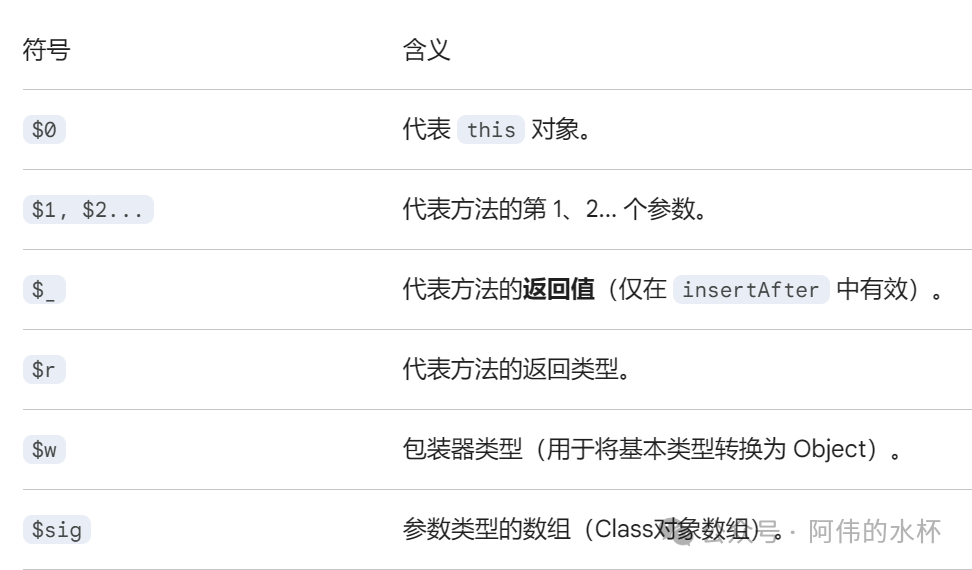
|
||||
|
||||
编写完成后,覆盖方法的时候,有几种常见覆盖方法:
|
||||
|
||||
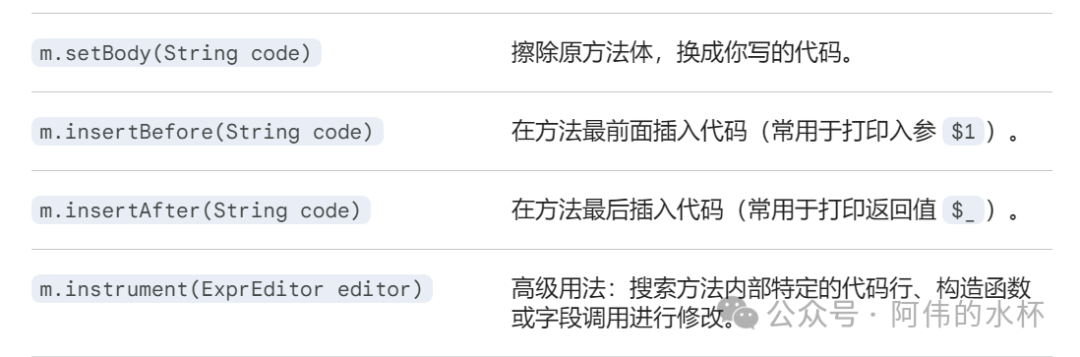
|
||||
|
||||
无论是哪个方法,多行代码的内容前后都要添加大括号
|
||||
|
||||
|
||||
|
||||
总结:简单的修改jar包内容,在缺失源码的情况下想修改某个功能时,可以很好的派上用场
|
||||
+42
@@ -0,0 +1,42 @@
|
||||
1.@GetMapping: 参数可以放置在 header,地址【query string】。
|
||||
|
||||
(1)用来指定web端必须以GET请求方式访问。
|
||||
|
||||
(2)用@GetMapping注解的方法,无论方法参数类型是常用数据类型,还是自定义引用数据类型,
|
||||
|
||||
在没有使用@RequestHeader注解的情况下,参数都是拼接在地址里面去的【query string】。
|
||||
|
||||
(3)使用@RequestHeader注解方法参数时,参数必须放置在请求头【header】里去。
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
2.@RequestHeader:指定方法的参数是从请求的请求头【header】里取的。注意: @RequestHeader只能
|
||||
|
||||
注解常用数据类型【一般是string】,不能注解引用数据类型
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
3.@PostMapping:参数可以放置在地址栏【query string】,header,请求体里。
|
||||
|
||||
(1)用来指定web端必须以POST请求方式访问。
|
||||
|
||||
(2)@PostMapping注解方法时,web端可以从header,地址【query string】,body里向后端传递参数。
|
||||
|
||||
(3)在方法参数里没有指定参数被@RequestHeader,@RequestBody注解时。默认是从地址栏
|
||||
|
||||
取数据,同时:后台可以使用实体对象做方法形参从地址栏取参数。用@RequestHeader,
|
||||
|
||||
@RequestBody注解的参数分别是从请求头,请求体里取参数。
|
||||
|
||||
|
||||
|
||||
+42
@@ -0,0 +1,42 @@
|
||||
1.@GetMapping: 参数可以放置在 header,地址【query string】。
|
||||
|
||||
(1)用来指定web端必须以GET请求方式访问。
|
||||
|
||||
(2)用@GetMapping注解的方法,无论方法参数类型是常用数据类型,还是自定义引用数据类型,
|
||||
|
||||
在没有使用@RequestHeader注解的情况下,参数都是拼接在地址里面去的【query string】。
|
||||
|
||||
(3)使用@RequestHeader注解方法参数时,参数必须放置在请求头【header】里去。
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
2.@RequestHeader:指定方法的参数是从请求的请求头【header】里取的。注意: @RequestHeader只能
|
||||
|
||||
注解常用数据类型【一般是string】,不能注解引用数据类型
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
3.@PostMapping:参数可以放置在地址栏【query string】,header,请求体里。
|
||||
|
||||
(1)用来指定web端必须以POST请求方式访问。
|
||||
|
||||
(2)@PostMapping注解方法时,web端可以从header,地址【query string】,body里向后端传递参数。
|
||||
|
||||
(3)在方法参数里没有指定参数被@RequestHeader,@RequestBody注解时。默认是从地址栏
|
||||
|
||||
取数据,同时:后台可以使用实体对象做方法形参从地址栏取参数。用@RequestHeader,
|
||||
|
||||
@RequestBody注解的参数分别是从请求头,请求体里取参数。
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,31 @@
|
||||
**[LibreSpeed](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=LibreSpeed&zhida_source=entity)** -- 免费开源的在线测速工具;
|
||||
|
||||
**[123APPS](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=123APPS&zhida_source=entity)** -- 免费好用的在线音视频编辑、PDF 处理工具(在线工具箱);
|
||||
|
||||
**[d1tools TTS](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=d1tools+TTS&zhida_source=entity)** -- 免费的在线文字转语音工具,支持74种语言、318个主播声音;
|
||||
|
||||
**[LANDrop](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=LANDrop&zhida_source=entity)** -- 免费、跨平台的局域网文件传输工具;
|
||||
|
||||
**[Caesium](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=Caesium&zhida_source=entity)** -- 支持批量处理,免费开源的图片压缩软件;
|
||||
|
||||
**[洋芋田图像工具箱](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=%E6%B4%8B%E8%8A%8B%E7%94%B0%E5%9B%BE%E5%83%8F%E5%B7%A5%E5%85%B7%E7%AE%B1&zhida_source=entity)** -- 为摄影、设计行业而生,免费开源,图像处理系列工具集;
|
||||
|
||||
**Mp3tag** -- 易用免费、功能强大的音频文件元数据编辑工具,优雅、规范地管理本地音乐文件;
|
||||
|
||||
**[Shot Easy](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=Shot+Easy&zhida_source=entity)** -- 免费好用的轻量级图片编辑 / 美化 / 压缩 / 抠图工具;
|
||||
|
||||
**[妙言](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=%E5%A6%99%E8%A8%80&zhida_source=entity)** -- mac平台,轻量简洁、免费开源的高颜值markdown编辑器;
|
||||
|
||||
**[Readest](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=Readest&zhida_source=entity)** -- 开源免费、界面精美,功能丰富,支持格式众多,且简单易用,支持在线翻译的Windows端电子书阅读器;
|
||||
|
||||
**[RustDesk](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=RustDesk&zhida_source=entity)** -- 免费流畅不限速的远程控制软件;
|
||||
|
||||
**[HEU KMS Activator](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=HEU+KMS+Activator&zhida_source=entity)** -- Windows系统与Office激活工具;
|
||||
|
||||
**[云萌](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=%E4%BA%91%E8%90%8C&zhida_source=entity)** -- Windows系统与Office激活工具;
|
||||
|
||||
**[Cyberduck](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=Cyberduck&zhida_source=entity)** -- 跨平台的开源云存储服务聚合客户端;
|
||||
|
||||
**[ShareX](https://zhida.zhihu.com/search?content_id=708955313&content_type=Answer&match_order=1&q=ShareX&zhida_source=entity)** -- 免费开源截图工具;
|
||||
|
||||
**AnyTXT Searcher** -- 强大的本地文本文件内容搜索工具;
|
||||
@@ -0,0 +1,926 @@
|
||||
|
||||
## **前言**
|
||||
|
||||
前一段时间,有同事使用ThreadLocal踩坑了,正好引起了我的兴趣。
|
||||
|
||||
所以近期,我抽空把ThreadLocal的源码再研究了一下,越看越有意思,发现里面的东西还真不少。
|
||||
|
||||
我把精华浓缩了一下,汇集成了下面11个问题,看看你能顶住第几个?
|
||||
|
||||
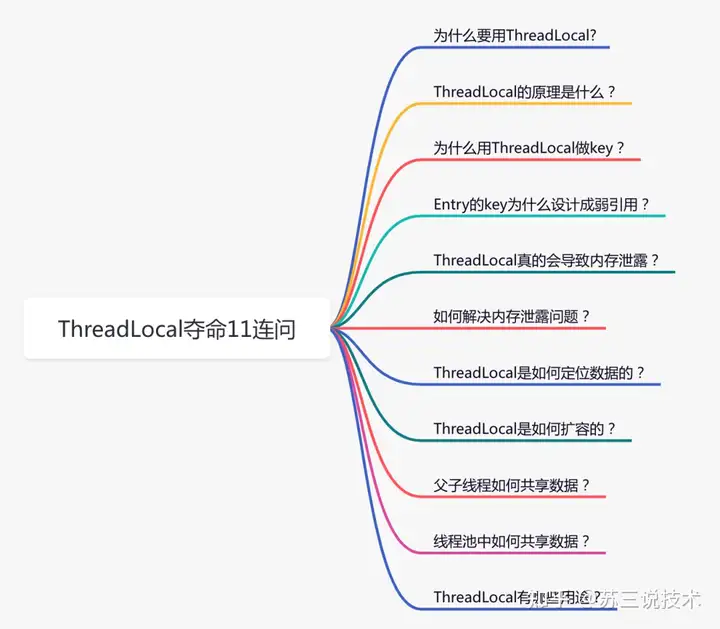
|
||||
|
||||
最近无意间获得一份BAT大厂大佬写的刷题笔记,一下子打通了我的任督二脉,越来越觉得算法没有想象中那么难了。
|
||||
|
||||
|
||||
|
||||
## **1. 为什么要用ThreadLocal?**
|
||||
|
||||
并发编程是一项非常重要的技术,它让我们的程序变得更加高效。
|
||||
|
||||
但在并发的场景中,如果有多个线程同时修改公共变量,可能会出现线程安全问题,即该变量最终结果可能出现异常。
|
||||
|
||||
为了解决线程安全问题,JDK出现了很多技术手段,比如:使用synchronized或Lock,给访问公共资源的代码上锁,保证了代码的原子性。
|
||||
|
||||
但在高并发的场景中,如果多个线程同时竞争一把锁,这时会存在大量的锁等待,可能会浪费很多时间,让系统的响应时间一下子变慢。
|
||||
|
||||
因此,JDK还提供了另外一种用空间换时间的新思路:ThreadLocal。
|
||||
|
||||
它的核心思想是:共享变量在每个线程都有一个副本,每个线程操作的都是自己的副本,对另外的线程没有影响。
|
||||
|
||||
例如:
|
||||
|
||||
```text
|
||||
@Service
|
||||
public class ThreadLocalService {
|
||||
private static final ThreadLocal<Integer> threadLocal = new ThreadLocal<>();
|
||||
|
||||
public void add() {
|
||||
threadLocal.set(1);
|
||||
doSamething();
|
||||
Integer integer = threadLocal.get();
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
## **2. ThreadLocal的原理是什么?**
|
||||
|
||||
为了搞清楚ThreadLocal的底层实现原理,我们不得不扒一下源码。
|
||||
|
||||
ThreadLocal的内部有一个静态的内部类叫:ThreadLocalMap。
|
||||
|
||||
```text
|
||||
public class ThreadLocal<T> {
|
||||
...
|
||||
public T get() {
|
||||
//获取当前线程
|
||||
Thread t = Thread.currentThread();
|
||||
//获取当前线程的成员变量ThreadLocalMap对象
|
||||
ThreadLocalMap map = getMap(t);
|
||||
if (map != null) {
|
||||
//根据threadLocal对象从map中获取Entry对象
|
||||
ThreadLocalMap.Entry e = map.getEntry(this);
|
||||
if (e != null) {
|
||||
@SuppressWarnings("unchecked")
|
||||
//获取保存的数据
|
||||
T result = (T)e.value;
|
||||
return result;
|
||||
}
|
||||
}
|
||||
//初始化数据
|
||||
return setInitialValue();
|
||||
}
|
||||
|
||||
private T setInitialValue() {
|
||||
//获取要初始化的数据
|
||||
T value = initialValue();
|
||||
//获取当前线程
|
||||
Thread t = Thread.currentThread();
|
||||
//获取当前线程的成员变量ThreadLocalMap对象
|
||||
ThreadLocalMap map = getMap(t);
|
||||
//如果map不为空
|
||||
if (map != null)
|
||||
//将初始值设置到map中,key是this,即threadLocal对象,value是初始值
|
||||
map.set(this, value);
|
||||
else
|
||||
//如果map为空,则需要创建新的map对象
|
||||
createMap(t, value);
|
||||
return value;
|
||||
}
|
||||
|
||||
public void set(T value) {
|
||||
//获取当前线程
|
||||
Thread t = Thread.currentThread();
|
||||
//获取当前线程的成员变量ThreadLocalMap对象
|
||||
ThreadLocalMap map = getMap(t);
|
||||
//如果map不为空
|
||||
if (map != null)
|
||||
//将值设置到map中,key是this,即threadLocal对象,value是传入的value值
|
||||
map.set(this, value);
|
||||
else
|
||||
//如果map为空,则需要创建新的map对象
|
||||
createMap(t, value);
|
||||
}
|
||||
|
||||
static class ThreadLocalMap {
|
||||
...
|
||||
}
|
||||
...
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
ThreadLocal的get方法、set方法和setInitialValue方法,其实最终操作的都是ThreadLocalMap类中的数据。
|
||||
|
||||
其中ThreadLocalMap类的内部如下:
|
||||
|
||||
```text
|
||||
static class ThreadLocalMap {
|
||||
static class Entry extends WeakReference<ThreadLocal<?>> {
|
||||
Object value;
|
||||
|
||||
Entry(ThreadLocal<?> k, Object v) {
|
||||
super(k);
|
||||
value = v;
|
||||
}
|
||||
}
|
||||
...
|
||||
private Entry[] table;
|
||||
...
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
ThreadLocalMap里面包含一个静态的内部类Entry,该类继承于WeakReference类,说明Entry是一个弱引用。
|
||||
|
||||
ThreadLocalMap内部还包含了一个Entry数组,其中:Entry = ThreadLocal + value。
|
||||
|
||||
而ThreadLocalMap被定义成了Thread类的成员变量。
|
||||
|
||||
```text
|
||||
public class Thread implements Runnable {
|
||||
...
|
||||
ThreadLocal.ThreadLocalMap threadLocals = null;
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
下面用一张图从宏观上,认识一下ThreadLocal的整体结构:
|
||||
|
||||
|
||||
|
||||
从上图中看出,在每个Thread类中,都有一个ThreadLocalMap的成员变量,该变量包含了一个Entry数组,该数组真正保存了ThreadLocal类set的数据。
|
||||
|
||||
Entry是由threadLocal和value组成,其中threadLocal对象是弱引用,在GC的时候,会被自动回收。而value就是ThreadLocal类set的数据。
|
||||
|
||||
下面用一张图总结一下引用关系:
|
||||
|
||||
|
||||
|
||||
上图中除了Entry的key对ThreadLocal对象是弱引用,其他的引用都是强引用。
|
||||
|
||||
需要特别说明的是,上图中ThreadLocal对象我画到了堆上,其实在实际的业务场景中不一定在堆上。因为如果ThreadLocal被定义成了static的,ThreadLocal的对象是类共用的,可能出现在方法区。
|
||||
|
||||
## **3. 为什么用ThreadLocal做key?**
|
||||
|
||||
不知道你有没有思考过这样一个问题:ThreadLocalMap为什么要用ThreadLocal做key,而不是用Thread做key?
|
||||
|
||||
如果在你的应用中,一个线程中只使用了一个ThreadLocal对象,那么使用Thread做key也未尝不可。
|
||||
|
||||
```text
|
||||
@Service
|
||||
public class ThreadLocalService {
|
||||
private static final ThreadLocal<Integer> threadLocal = new ThreadLocal<>();
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
但实际情况中,你的应用,一个线程中很有可能不只使用了一个ThreadLocal对象。这时使用Thread做key不就出有问题?
|
||||
|
||||
```text
|
||||
@Service
|
||||
public class ThreadLocalService {
|
||||
private static final ThreadLocal<Integer> threadLocal1 = new ThreadLocal<>();
|
||||
private static final ThreadLocal<Integer> threadLocal2 = new ThreadLocal<>();
|
||||
private static final ThreadLocal<Integer> threadLocal3 = new ThreadLocal<>();
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
假如使用Thread做key时,你的代码中定义了3个ThreadLocal对象,那么,通过Thread对象,它怎么知道要获取哪个ThreadLocal对象呢?
|
||||
|
||||
如下图所示:
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
因此,不能使用Thread做key,而应该改成用ThreadLocal对象做key,这样才能通过具体ThreadLocal对象的get方法,轻松获取到你想要的ThreadLocal对象。
|
||||
|
||||
如下图所示:
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## **4. Entry的key为什么设计成弱引用?**
|
||||
|
||||
前面说过,Entry的key,传入的是ThreadLocal对象,使用了WeakReference对象,即被设计成了弱引用。
|
||||
|
||||
那么,为什么要这样设计呢?
|
||||
|
||||
假如key对ThreadLocal对象的弱引用,改为强引用。
|
||||
|
||||
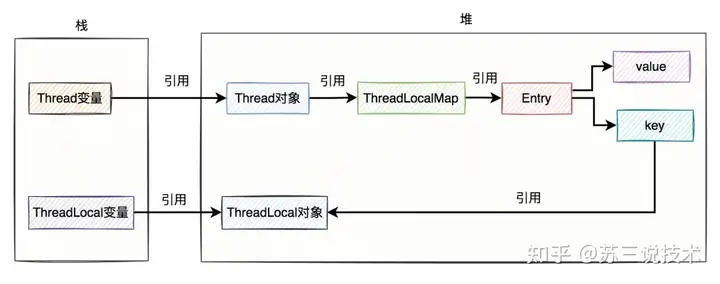
|
||||
|
||||
我们都知道ThreadLocal变量对ThreadLocal对象是有强引用存在的。
|
||||
|
||||
即使ThreadLocal变量生命周期完了,设置成null了,但由于key对ThreadLocal还是强引用。
|
||||
|
||||
此时,如果执行该代码的线程使用了线程池,一直长期存在,不会被销毁。
|
||||
|
||||
就会存在这样的强引用链:Thread变量 -> Thread对象 -> ThreadLocalMap -> Entry -> key -> ThreadLocal对象。
|
||||
|
||||
那么,ThreadLocal对象和ThreadLocalMap都将不会被GC回收,于是产生了内存泄露问题。
|
||||
|
||||
为了解决这个问题,JDK的开发者们把Entry的key设计成了弱引用。
|
||||
|
||||
> 弱引用的对象,在GC做垃圾清理的时候,就会被自动回收了。
|
||||
|
||||
如果key是弱引用,当ThreadLocal变量指向null之后,在GC做垃圾清理的时候,key会被自动回收,其值也被设置成null。
|
||||
|
||||
如下图所示:
|
||||
|
||||
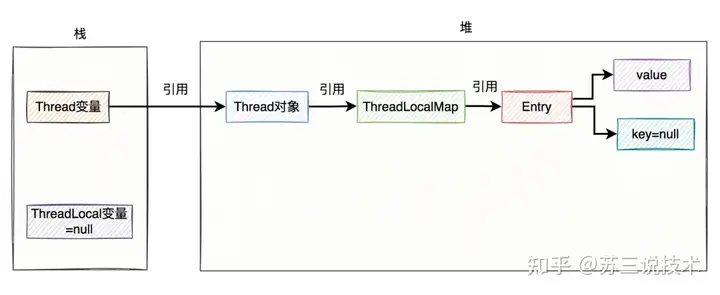
|
||||
|
||||
**接下来,最关键的地方来了。**
|
||||
|
||||
由于当前的ThreadLocal变量已经被指向null了,但如果直接调用它的get、set或remove方法,很显然会出现空指针异常。因为它的生命已经结束了,再调用它的方法也没啥意义。
|
||||
|
||||
此时,如果系统中还定义了另外一个ThreadLocal变量b,调用了它的get、set或remove,三个方法中的任何一个方法,都会自动触发清理机制,将key为null的value值清空。
|
||||
|
||||
如果key和value都是null,那么Entry对象会被GC回收。如果所有的Entry对象都被回收了,ThreadLocalMap也会被回收了。
|
||||
|
||||
这样就能最大程度的解决内存泄露问题。
|
||||
|
||||
需要特别注意的地方是:
|
||||
|
||||
1. key为null的条件是,ThreadLocal变量指向null,并且key是弱引用。如果ThreadLocal变量没有断开对ThreadLocal的强引用,即ThreadLocal变量没有指向null,GC就贸然的把弱引用的key回收了,不就会影响正常用户的使用?
|
||||
2. 如果当前ThreadLocal变量指向null了,并且key也为null了,但如果没有其他ThreadLocal变量触发get、set或remove方法,也会造成内存泄露。
|
||||
|
||||
下面看看弱引用的例子:
|
||||
|
||||
```text
|
||||
public static void main(String[] args) {
|
||||
WeakReference<Object> weakReference0 = new WeakReference<>(new Object());
|
||||
System.out.println(weakReference0.get());
|
||||
System.gc();
|
||||
System.out.println(weakReference0.get());
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
打印结果:
|
||||
|
||||
```text
|
||||
java.lang.Object@1ef7fe8e
|
||||
null
|
||||
|
||||
|
||||
```
|
||||
|
||||
传入WeakReference构造方法的是直接new处理的对象,没有其他引用,在调用gc方法后,弱引用对象会被自动回收。
|
||||
|
||||
但如果出现下面这种情况:
|
||||
|
||||
```text
|
||||
public static void main(String[] args) {
|
||||
Object object = new Object();
|
||||
WeakReference<Object> weakReference1 = new WeakReference<>(object);
|
||||
System.out.println(weakReference1.get());
|
||||
System.gc();
|
||||
System.out.println(weakReference1.get());
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
执行结果:
|
||||
|
||||
```text
|
||||
java.lang.Object@1ef7fe8e
|
||||
java.lang.Object@1ef7fe8e
|
||||
|
||||
|
||||
```
|
||||
|
||||
先定义了一个强引用object对象,在WeakReference构造方法中将object对象的引用作为参数传入。这时,调用gc后,弱引用对象不会被自动回收。
|
||||
|
||||
我们的Entry对象中的key不就是第二种情况吗?在Entry构造方法中传入的是ThreadLocal对象的引用。
|
||||
|
||||
如果将object强引用设置为null:
|
||||
|
||||
```text
|
||||
public static void main(String[] args) {
|
||||
Object object = new Object();
|
||||
WeakReference<Object> weakReference1 = new WeakReference<>(object);
|
||||
System.out.println(weakReference1.get());
|
||||
System.gc();
|
||||
System.out.println(weakReference1.get());
|
||||
|
||||
object=null;
|
||||
System.gc();
|
||||
System.out.println(weakReference1.get());
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
执行结果:
|
||||
|
||||
```text
|
||||
java.lang.Object@6f496d9f
|
||||
java.lang.Object@6f496d9f
|
||||
null
|
||||
|
||||
|
||||
```
|
||||
|
||||
第二次gc之后,弱引用能够被正常回收。
|
||||
|
||||
> 由此可见,如果强引用和弱引用同时关联一个对象,那么这个对象是不会被GC回收。也就是说这种情况下Entry的key,一直都不会为null,除非强引用主动断开关联。
|
||||
|
||||
此外,你可能还会问这样一个问题:**Entry的value为什么不设计成弱引用?**
|
||||
|
||||
答:Entry的value假如只是被Entry引用,有可能没被业务系统中的其他地方引用。如果将value改成了弱引用,被GC贸然回收了(数据突然没了),可能会导致业务系统出现异常。
|
||||
|
||||
而相比之下,Entry的key,管理的地方就非常明确了。
|
||||
|
||||
这就是Entry的key被设计成弱引用,而value没被设计成弱引用的原因。
|
||||
|
||||
## **5. ThreadLocal真的会导致内存泄露?**
|
||||
|
||||
通过上面的Entry对象中的key设置成弱引用,并且使用get、set或remove方法清理key为null的value值,就能彻底解决内存泄露问题?
|
||||
|
||||
答案是否定的。
|
||||
|
||||
如下图所示:
|
||||
|
||||

|
||||
|
||||
假如ThreadLocalMap中存在很多key为null的Entry,但后面的程序,一直都没有调用过有效的ThreadLocal的get、set或remove方法。
|
||||
|
||||
那么,Entry的value值一直都没被清空。
|
||||
|
||||
所以会存在这样一条强引用链:Thread变量 -> Thread对象 -> ThreadLocalMap -> Entry -> value -> Object。
|
||||
|
||||
其结果就是:Entry和ThreadLocalMap将会长期存在下去,会导致内存泄露。
|
||||
|
||||
## **6. 如何解决内存泄露问题?**
|
||||
|
||||
前面说过的ThreadLocal还是会导致内存泄露的问题,我们有没有解决办法呢?
|
||||
|
||||
答:有办法,调用ThreadLocal对象的remove方法。
|
||||
|
||||
不是在一开始就调用remove方法,而是在使用完ThreadLocal对象之后。列如:
|
||||
|
||||
先创建一个CurrentUser类,其中包含了ThreadLocal的逻辑。
|
||||
|
||||
```text
|
||||
public class CurrentUser {
|
||||
private static final ThreadLocal<UserInfo> THREA_LOCAL = new ThreadLocal();
|
||||
|
||||
public static void set(UserInfo userInfo) {
|
||||
THREA_LOCAL.set(userInfo);
|
||||
}
|
||||
|
||||
public static UserInfo get() {
|
||||
THREA_LOCAL.get();
|
||||
}
|
||||
|
||||
public static void remove() {
|
||||
THREA_LOCAL.remove();
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
然后在业务代码中调用相关方法:
|
||||
|
||||
```text
|
||||
public void doSamething(UserDto userDto) {
|
||||
UserInfo userInfo = convert(userDto);
|
||||
|
||||
try{
|
||||
CurrentUser.set(userInfo);
|
||||
...
|
||||
|
||||
//业务代码
|
||||
UserInfo userInfo = CurrentUser.get();
|
||||
...
|
||||
} finally {
|
||||
CurrentUser.remove();
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
需要我们特别注意的地方是:一定要在finally代码块中,调用remove方法清理没用的数据。如果业务代码出现异常,也能及时清理没用的数据。
|
||||
|
||||
remove方法中会把Entry中的key和value都设置成null,这样就能被GC及时回收,无需触发额外的清理机制,所以它能解决内存泄露问题。
|
||||
|
||||
## **7. ThreadLocal是如何定位数据的?**
|
||||
|
||||
前面说过ThreadLocalMap对象底层是用Entry数组保存数据的。
|
||||
|
||||
那么问题来了,ThreadLocal是如何定位Entry数组数据的?
|
||||
|
||||
在ThreadLocal的get、set、remove方法中都有这样一行代码:
|
||||
|
||||
```text
|
||||
int i = key.threadLocalHashCode & (len-1);
|
||||
|
||||
|
||||
```
|
||||
|
||||
通过key的hashCode值,与数组的长度减1。其中key就是ThreadLocal对象,与数组的长度减1,相当于除以数组的长度减1,然后取模。
|
||||
|
||||
这是一种hash算法。
|
||||
|
||||
接下来给大家举个例子:假设len=16,key.threadLocalHashCode=31,
|
||||
|
||||
于是: int i = 31 & 15 = 15
|
||||
|
||||
相当于:int i = 31 % 16 = 15
|
||||
|
||||
计算的结果是一样的,但是使用与运算效率跟高一些。
|
||||
|
||||
为什么与运算效率更高?
|
||||
|
||||
答:因为ThreadLocal的初始大小是16,每次都是按2倍扩容,数组的大小其实一直都是2的n次方。这种数据有个规律就是高位是0,低位都是1。在做与运算时,可以不用考虑高位,因为与运算的结果必定是0。只需考虑低位的与运算,所以效率更高。
|
||||
|
||||
如果使用hash算法定位具体位置的话,就可能会出现hash冲突的情况,即两个不同的hashCode取模后的值相同。
|
||||
|
||||
ThreadLocal是如何解决hash冲突的呢?
|
||||
|
||||
我们看看getEntry是怎么做的:
|
||||
|
||||
```text
|
||||
private Entry getEntry(ThreadLocal<?> key) {
|
||||
//通过hash算法获取下标值
|
||||
int i = key.threadLocalHashCode & (table.length - 1);
|
||||
Entry e = table[i];
|
||||
//如果下标位置上的key正好是我们所需要寻找的key
|
||||
if (e != null && e.get() == key)
|
||||
//说明找到数据了,直接返回
|
||||
return e;
|
||||
else
|
||||
//说明出现hash冲突了,继续往后找
|
||||
return getEntryAfterMiss(key, i, e);
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
再看看getEntryAfterMiss方法:
|
||||
|
||||
```text
|
||||
private Entry getEntryAfterMiss(ThreadLocal<?> key, int i, Entry e) {
|
||||
Entry[] tab = table;
|
||||
int len = tab.length;
|
||||
|
||||
//判断Entry对象如果不为空,则一直循环
|
||||
while (e != null) {
|
||||
ThreadLocal<?> k = e.get();
|
||||
//如果当前Entry的key正好是我们所需要寻找的key
|
||||
if (k == key)
|
||||
//说明这次真的找到数据了
|
||||
return e;
|
||||
if (k == null)
|
||||
//如果key为空,则清理脏数据
|
||||
expungeStaleEntry(i);
|
||||
else
|
||||
//如果还是没找到数据,则继续往后找
|
||||
i = nextIndex(i, len);
|
||||
e = tab[i];
|
||||
}
|
||||
return null;
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
关键看看nextIndex方法:
|
||||
|
||||
```text
|
||||
private static int nextIndex(int i, int len) {
|
||||
return ((i + 1 < len) ? i + 1 : 0);
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
当通过hash算法计算出的下标小于数组大小,则将下标值加1。否则,即下标大于等于数组大小,下标变成0了。下标变成0之后,则循环一次,下标又变成1。。。
|
||||
|
||||
寻找的大致过程如下图所示:
|
||||
|
||||
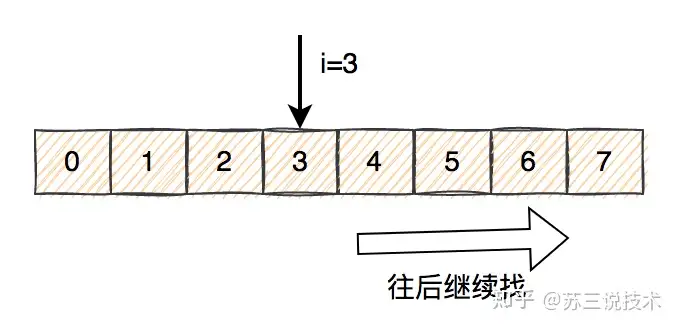
|
||||
|
||||
如果找到最后一个,还是没有找到,则再从头开始找。
|
||||
|
||||
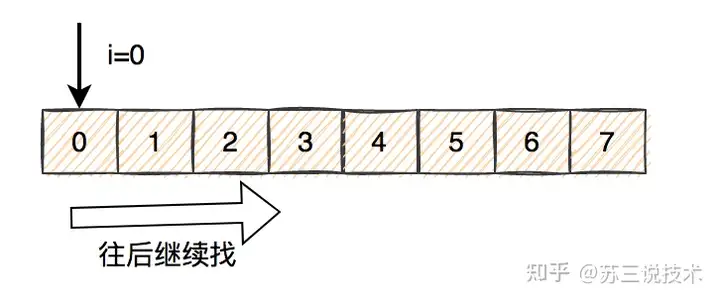
|
||||
|
||||
不知道你有没有发现,它构成了一个:环形。
|
||||
|
||||
ThreadLocal从数组中找数据的过程大致是这样的:
|
||||
|
||||
1. 通过key的hashCode取余计算出一个下标。
|
||||
2. 通过下标,在数组中定位具体Entry,如果key正好是我们所需要的key,说明找到了,则直接返回数据。
|
||||
3. 如果第2步没有找到我们想要的数据,则从数组的下标位置,继续往后面找。
|
||||
4. 如果第3步中找key的正好是我们所需要的key,说明找到了,则直接返回数据。
|
||||
5. 如果还是没有找到数据,再继续往后面找。如果找到最后一个位置,还是没有找到数据,则再从头,即下标为0的位置,继续从前往后找数据。
|
||||
6. 直到找到第一个Entry为空为止。
|
||||
|
||||
## **8. ThreadLocal是如何扩容的?**
|
||||
|
||||
从上面得知,ThreadLocal的初始大小是16。那么问题来了,ThreadLocal是如何扩容的?
|
||||
|
||||
在set方法中会调用rehash方法:
|
||||
|
||||
```text
|
||||
private void set(ThreadLocal<?> key, Object value) {
|
||||
Entry[] tab = table;
|
||||
int len = tab.length;
|
||||
int i = key.threadLocalHashCode & (len-1);
|
||||
|
||||
for (Entry e = tab[i];
|
||||
e != null;
|
||||
e = tab[i = nextIndex(i, len)]) {
|
||||
ThreadLocal<?> k = e.get();
|
||||
|
||||
if (k == key) {
|
||||
e.value = value;
|
||||
return;
|
||||
}
|
||||
|
||||
if (k == null) {
|
||||
replaceStaleEntry(key, value, i);
|
||||
return;
|
||||
}
|
||||
}
|
||||
|
||||
tab[i] = new Entry(key, value);
|
||||
int sz = ++size;
|
||||
if (!cleanSomeSlots(i, sz) && sz >= threshold)
|
||||
rehash();
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
注意一下,其中有个判断条件是:sz(之前的size+1)如果大于或等于threshold的话,则调用rehash方法。
|
||||
|
||||
threshold默认是0,在创建ThreadLocalMap时,调用它的构造方法:
|
||||
|
||||
```text
|
||||
ThreadLocalMap(ThreadLocal<?> firstKey, Object firstValue) {
|
||||
table = new Entry[INITIAL_CAPACITY];
|
||||
int i = firstKey.threadLocalHashCode & (INITIAL_CAPACITY - 1);
|
||||
table[i] = new Entry(firstKey, firstValue);
|
||||
size = 1;
|
||||
setThreshold(INITIAL_CAPACITY);
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
调用setThreshold方法给threshold设置一个值,而这个值INITIAL_CAPACITY是默认的大小16。
|
||||
|
||||
```text
|
||||
private void setThreshold(int len) {
|
||||
threshold = len * 2 / 3;
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
也就是第一次设置的threshold = 16 * 2 / 3, 取整后的值是:10。
|
||||
|
||||
换句话说当sz大于等于10时,就可以考虑扩容了。
|
||||
|
||||
rehash代码如下:
|
||||
|
||||
```text
|
||||
private void rehash() {
|
||||
//先尝试回收一次key为null的值,腾出一些空间
|
||||
expungeStaleEntries();
|
||||
|
||||
if (size >= threshold - threshold / 4)
|
||||
resize();
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
在真正扩容之前,先尝试回收一次key为null的值,腾出一些空间。
|
||||
|
||||
如果回收之后的size大于等于threshold的3/4时,才需要真正的扩容。
|
||||
|
||||
计算公式如下:
|
||||
|
||||
```text
|
||||
16 * 2 * 4 / 3 * 4 - 16 * 2 / 3 * 4 = 8
|
||||
|
||||
|
||||
```
|
||||
|
||||
也就是说添加数据后,新的size大于等于老size的1/2时,才需要扩容。
|
||||
|
||||
```text
|
||||
private void resize() {
|
||||
Entry[] oldTab = table;
|
||||
int oldLen = oldTab.length;
|
||||
//按2倍的大小扩容
|
||||
int newLen = oldLen * 2;
|
||||
Entry[] newTab = new Entry[newLen];
|
||||
int count = 0;
|
||||
|
||||
for (int j = 0; j < oldLen; ++j) {
|
||||
Entry e = oldTab[j];
|
||||
if (e != null) {
|
||||
ThreadLocal<?> k = e.get();
|
||||
if (k == null) {
|
||||
e.value = null; // Help the GC
|
||||
} else {
|
||||
int h = k.threadLocalHashCode & (newLen - 1);
|
||||
while (newTab[h] != null)
|
||||
h = nextIndex(h, newLen);
|
||||
newTab[h] = e;
|
||||
count++;
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
setThreshold(newLen);
|
||||
size = count;
|
||||
table = newTab;
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
resize中每次都是按2倍的大小扩容。
|
||||
|
||||
扩容的过程如下图所示:
|
||||
|
||||
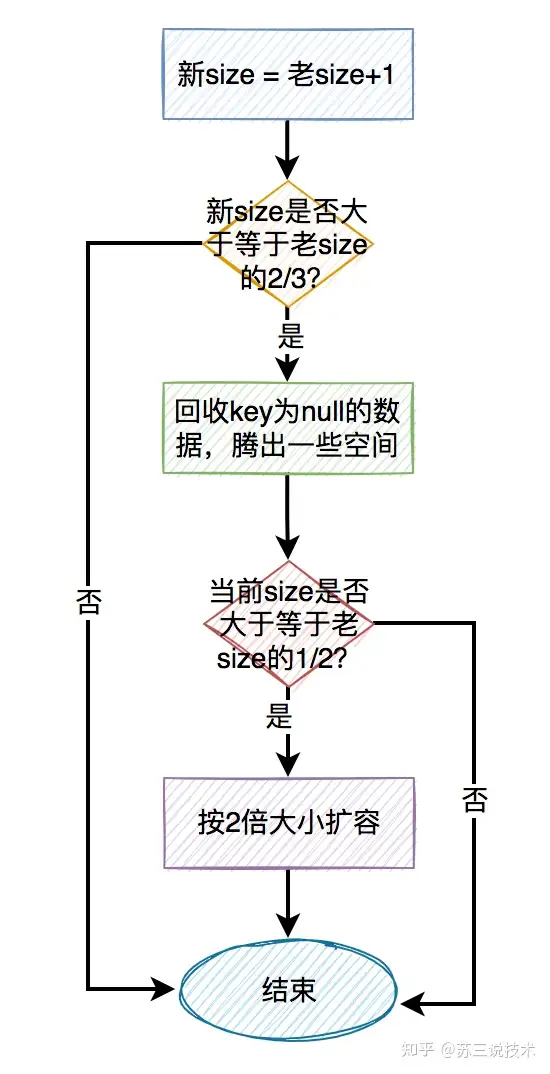
|
||||
|
||||
扩容的关键步骤如下:
|
||||
|
||||
1. 老size + 1 = 新size
|
||||
2. 如果新size大于等于老size的2/3时,需要考虑扩容。
|
||||
3. 扩容前先尝试回收一次key为null的值,腾出一些空间。
|
||||
4. 如果回收之后发现size还是大于等于老size的1/2时,才需要真正的扩容。
|
||||
5. 每次都是按2倍的大小扩容。
|
||||
|
||||
## **9. 父子线程如何共享数据?**
|
||||
|
||||
前面介绍的ThreadLocal都是在一个线程中保存和获取数据的。
|
||||
|
||||
但在实际工作中,有可能是在父子线程中共享数据的。即在父线程中往ThreadLocal设置了值,在子线程中能够获取到。
|
||||
|
||||
例如:
|
||||
|
||||
```text
|
||||
public class ThreadLocalTest {
|
||||
|
||||
public static void main(String[] args) {
|
||||
ThreadLocal<Integer> threadLocal = new ThreadLocal<>();
|
||||
threadLocal.set(6);
|
||||
System.out.println("父线程获取数据:" + threadLocal.get());
|
||||
|
||||
new Thread(() -> {
|
||||
System.out.println("子线程获取数据:" + threadLocal.get());
|
||||
}).start();
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
执行结果:
|
||||
|
||||
```text
|
||||
父线程获取数据:6
|
||||
子线程获取数据:null
|
||||
|
||||
|
||||
```
|
||||
|
||||
你会发现,在这种情况下使用ThreadLocal是行不通的。main方法是在主线程中执行的,相当于父线程。在main方法中开启了另外一个线程,相当于子线程。
|
||||
|
||||
显然通过ThreadLocal,无法在父子线程中共享数据。
|
||||
|
||||
那么,该怎么办呢?
|
||||
|
||||
答:使用InheritableThreadLocal,它是JDK自带的类,继承了ThreadLocal类。
|
||||
|
||||
修改代码之后:
|
||||
|
||||
```text
|
||||
public class ThreadLocalTest {
|
||||
|
||||
public static void main(String[] args) {
|
||||
InheritableThreadLocal<Integer> threadLocal = new InheritableThreadLocal<>();
|
||||
threadLocal.set(6);
|
||||
System.out.println("父线程获取数据:" + threadLocal.get());
|
||||
|
||||
new Thread(() -> {
|
||||
System.out.println("子线程获取数据:" + threadLocal.get());
|
||||
}).start();
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
执行结果:
|
||||
|
||||
```text
|
||||
父线程获取数据:6
|
||||
子线程获取数据:6
|
||||
|
||||
|
||||
```
|
||||
|
||||
果然,在换成InheritableThreadLocal之后,在子线程中能够正常获取父线程中设置的值。
|
||||
|
||||
其实,在Thread类中除了成员变量threadLocals之外,还有另一个成员变量:inheritableThreadLocals。
|
||||
|
||||
Thread类的部分代码如下:
|
||||
|
||||
```text
|
||||
ThreadLocal.ThreadLocalMap threadLocals = null;
|
||||
ThreadLocal.ThreadLocalMap inheritableThreadLocals = null;
|
||||
|
||||
|
||||
```
|
||||
|
||||
最关键的一点是,在它的init方法中会将父线程中往ThreadLocal设置的值,拷贝一份到子线程中。
|
||||
|
||||
感兴趣的小伙伴,可以找我私聊。或者看看我后面的文章,后面还会有专栏。
|
||||
|
||||
## **10. 线程池中如何共享数据?**
|
||||
|
||||
在真实的业务场景中,一般很少用单独的线程,绝大多数,都是用的线程池。
|
||||
|
||||
那么,在线程池中如何共享ThreadLocal对象生成的数据呢?
|
||||
|
||||
因为涉及到不同的线程,如果直接使用ThreadLocal,显然是不合适的。
|
||||
|
||||
我们应该使用InheritableThreadLocal,具体代码如下:
|
||||
|
||||
```text
|
||||
private static void fun1() {
|
||||
InheritableThreadLocal<Integer> threadLocal = new InheritableThreadLocal<>();
|
||||
threadLocal.set(6);
|
||||
System.out.println("父线程获取数据:" + threadLocal.get());
|
||||
|
||||
ExecutorService executorService = Executors.newSingleThreadExecutor();
|
||||
|
||||
threadLocal.set(6);
|
||||
executorService.submit(() -> {
|
||||
System.out.println("第一次从线程池中获取数据:" + threadLocal.get());
|
||||
});
|
||||
|
||||
threadLocal.set(7);
|
||||
executorService.submit(() -> {
|
||||
System.out.println("第二次从线程池中获取数据:" + threadLocal.get());
|
||||
});
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
执行结果:
|
||||
|
||||
```text
|
||||
父线程获取数据:6
|
||||
第一次从线程池中获取数据:6
|
||||
第二次从线程池中获取数据:6
|
||||
|
||||
|
||||
```
|
||||
|
||||
由于这个例子中使用了单例线程池,固定线程数是1。
|
||||
|
||||
第一次submit任务的时候,该线程池会自动创建一个线程。因为使用了InheritableThreadLocal,所以创建线程时,会调用它的init方法,将父线程中的inheritableThreadLocals数据复制到子线程中。所以我们看到,在主线程中将数据设置成6,第一次从线程池中获取了正确的数据6。
|
||||
|
||||
之后,在主线程中又将数据改成7,但在第二次从线程池中获取数据却依然是6。
|
||||
|
||||
因为第二次submit任务的时候,线程池中已经有一个线程了,就直接拿过来复用,不会再重新创建线程了。所以不会再调用线程的init方法,所以第二次其实没有获取到最新的数据7,还是获取的老数据6。
|
||||
|
||||
那么,这该怎么办呢?
|
||||
|
||||
答:使用TransmittableThreadLocal,它并非JDK自带的类,而是阿里巴巴开源jar包中的类。
|
||||
|
||||
可以通过如下pom文件引入该jar包:
|
||||
|
||||
```text
|
||||
<dependency>
|
||||
<groupId>com.alibaba</groupId>
|
||||
<artifactId>transmittable-thread-local</artifactId>
|
||||
<version>2.11.0</version>
|
||||
<scope>compile</scope>
|
||||
</dependency>
|
||||
|
||||
|
||||
```
|
||||
|
||||
代码调整如下:
|
||||
|
||||
```text
|
||||
private static void fun2() throws Exception {
|
||||
TransmittableThreadLocal<Integer> threadLocal = new TransmittableThreadLocal<>();
|
||||
threadLocal.set(6);
|
||||
System.out.println("父线程获取数据:" + threadLocal.get());
|
||||
|
||||
ExecutorService ttlExecutorService = TtlExecutors.getTtlExecutorService(Executors.newFixedThreadPool(1));
|
||||
|
||||
threadLocal.set(6);
|
||||
ttlExecutorService.submit(() -> {
|
||||
System.out.println("第一次从线程池中获取数据:" + threadLocal.get());
|
||||
});
|
||||
|
||||
threadLocal.set(7);
|
||||
ttlExecutorService.submit(() -> {
|
||||
System.out.println("第二次从线程池中获取数据:" + threadLocal.get());
|
||||
});
|
||||
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
执行结果:
|
||||
|
||||
```text
|
||||
父线程获取数据:6
|
||||
第一次从线程池中获取数据:6
|
||||
第二次从线程池中获取数据:7
|
||||
|
||||
|
||||
```
|
||||
|
||||
我们看到,使用了TransmittableThreadLocal之后,第二次从线程中也能正确获取最新的数据7了。
|
||||
|
||||
nice。
|
||||
|
||||
如果你仔细观察这个例子,你可能会发现,代码中除了使用TransmittableThreadLocal类之外,还使用了TtlExecutors.getTtlExecutorService方法,去创建ExecutorService对象。
|
||||
|
||||
这是非常重要的地方,如果没有这一步,TransmittableThreadLocal在线程池中共享数据将不会起作用。
|
||||
|
||||
创建ExecutorService对象,底层的submit方法会TtlRunnable或TtlCallable对象。
|
||||
|
||||
以TtlRunnable类为例,它实现了Runnable接口,同时还实现了它的run方法:
|
||||
|
||||
```text
|
||||
public void run() {
|
||||
Map<TransmittableThreadLocal<?>, Object> copied = (Map)this.copiedRef.get();
|
||||
if (copied != null && (!this.releaseTtlValueReferenceAfterRun || this.copiedRef.compareAndSet(copied, (Object)null))) {
|
||||
Map backup = TransmittableThreadLocal.backupAndSetToCopied(copied);
|
||||
|
||||
try {
|
||||
this.runnable.run();
|
||||
} finally {
|
||||
TransmittableThreadLocal.restoreBackup(backup);
|
||||
}
|
||||
} else {
|
||||
throw new IllegalStateException("TTL value reference is released after run!");
|
||||
}
|
||||
}
|
||||
|
||||
|
||||
```
|
||||
|
||||
这段代码的主要逻辑如下:
|
||||
|
||||
1. 把当时的ThreadLocal做个备份,然后将父类的ThreadLocal拷贝过来。
|
||||
2. 执行真正的run方法,可以获取到父类最新的ThreadLocal数据。
|
||||
3. 从备份的数据中,恢复当时的ThreadLocal数据。
|
||||
|
||||
## **11. ThreadLocal有哪些用途?**
|
||||
|
||||
最后,一起聊聊ThreadLocal有哪些用途?
|
||||
|
||||
老实说,使用ThreadLocal的场景挺多的。
|
||||
|
||||
下面列举几个常见的场景:
|
||||
|
||||
1. 在spring事务中,保证一个线程下,一个事务的多个操作拿到的是一个Connection。
|
||||
2. 在hiberate中管理session。
|
||||
3. 在JDK8之前,为了解决SimpleDateFormat的线程安全问题。
|
||||
4. 获取当前登录用户上下文。
|
||||
5. 临时保存权限数据。
|
||||
6. 使用MDC保存日志信息。
|
||||
|
||||
等等,还有很多业务场景,这里就不一一列举了。
|
||||
|
||||
由于篇幅有限,今天的内容先分享到这里。希望你看了这篇文章,会有所收获。
|
||||
|
||||
接下来留几个问题给大家思考一下:
|
||||
|
||||
1. ThreadLocal变量为什么建议要定义成static的?
|
||||
2. Entry数组为什么要通过hash算法计算下标,即直线寻址法,而不直接使用下标值?
|
||||
3. 强引用和弱引用有什么区别?
|
||||
4. Entry数组大小,为什么是2的N次方?
|
||||
5. 使用InheritableThreadLocal时,如果父线程中重新set值,在子线程中能够正确的获取修改后的新值吗?
|
||||
@@ -0,0 +1,16 @@
|
||||
如果用的logback实现,就用
|
||||
|
||||
ch.qos.logback.classic.Logger root = (ch.qos.logback.classic.Logger) org.slf4j.LoggerFactory
|
||||
.getLogger(ch.qos.logback.classic.Logger.ROOT_LOGGER_NAME);
|
||||
root.setLevel(Level.INFO);
|
||||
1
|
||||
2
|
||||
3
|
||||
如果用的是log4j实现,就用
|
||||
|
||||
```Plain Text
|
||||
org.apache.log4j.Logger.getRootLogger().setLevel(Level.INFO);
|
||||
BasicConfigurator.configure(new ConsoleAppender(
|
||||
new ColorPatternLayout("%d{MM-dd HH:mm:ss} [%-25t] %-5p: %m%n")));
|
||||
```
|
||||
|
||||
+16
@@ -0,0 +1,16 @@
|
||||
如果用的logback实现,就用
|
||||
|
||||
ch.qos.logback.classic.Logger root = (ch.qos.logback.classic.Logger) org.slf4j.LoggerFactory
|
||||
.getLogger(ch.qos.logback.classic.Logger.ROOT_LOGGER_NAME);
|
||||
root.setLevel(Level.INFO);
|
||||
1
|
||||
2
|
||||
3
|
||||
如果用的是log4j实现,就用
|
||||
|
||||
```Plain Text
|
||||
org.apache.log4j.Logger.getRootLogger().setLevel(Level.INFO);
|
||||
BasicConfigurator.configure(new ConsoleAppender(
|
||||
new ColorPatternLayout("%d{MM-dd HH:mm:ss} [%-25t] %-5p: %m%n")));
|
||||
```
|
||||
|
||||
@@ -0,0 +1,7 @@
|
||||
| | | | | | | |
|
||||
| ---- | --------- | ------ | ---------- | ---------- | ---- | ---- |
|
||||
| 任务模式 | Task Name | 工期 | 开始时间 | 完成时间 | 前置任务 | 资源名称 |
|
||||
| 自动计划 | 测试执行 | 5 days | 2025年1月8日 | 2025年1月14日 | | |
|
||||
| 手动计划 | 性能测试 | 1 day | 2025年1月8日 | 2025年1月8日 | | 陆世钰 |
|
||||
| 手动计划 | 云机性能测试 | 1 day | 2025年1月9日 | 2025年1月9日 | | 陆世钰 |
|
||||
| 手动计划 | 稳定性测试 | 3 days | 2025年1月10日 | 2025年1月14日 | | 陆世钰 |
|
||||
@@ -0,0 +1,81 @@
|
||||
项目进度计划管理在项目管理中至关重要,项目进度计划的制定应分为以下四步:
|
||||
|
||||
## 第一步:了解项目目标范围等基本情况
|
||||
>对应禅道中的需求管理、人员安排、阶段规划等
|
||||
|
||||
明确项目成本;
|
||||
明确项目实施范围;
|
||||
明确项目实施周期要求;**就是时间**
|
||||
明确项目投入人员情况;包括设备。**就是资源**
|
||||
明确项目合同中收款及验收情况。
|
||||
|
||||
## 第二步:项目制约因素分析,策划最优项目实施计划
|
||||
>对应禅道中的任务安排、测试管理、问题风险管理等
|
||||
|
||||
分析项目在本年度能否上线及验收;
|
||||
分析项目在本年度能否收 60%的款项(上线款);
|
||||
本年度能收 60%款项(上线款)不能完成验收的项目,验收计划需控制在第二年一季度或上半年;
|
||||
项目本年度必须验收(考虑压缩周期,增加人力,成本是否可控);
|
||||
了解客户在项目上的紧迫程度,需求人员支持情况等;
|
||||
了解项目标准的实施周期,投入人数;
|
||||
考虑上线到验收的时长,即试运行周期;
|
||||
分析项目实施风险、规避方案、解决措施等;
|
||||
了解测试范围,测试轮次,测试严格程度等。
|
||||
|
||||
## 第三步:项目实施计划制定
|
||||
>直接参照模板,在禅道中各个阶段创建关键任务
|
||||
|
||||
基于项目基本情况和制约因素确定项目的实施周期,先初步规划项目重要里程碑,再列出各里程碑阶段的关键事项,最后对关键事项分解形成具体任务,通过合理的排期形成项目实施计划,各阶段关键事项如下:
|
||||
|
||||
## 第四步:项目实施计划评审
|
||||
【对应禅道中的评审——项目计划】
|
||||
邀请项目总监,区域负责人一起评审;
|
||||
针对项目实施计划合理性,成本可控性,人员投入情况进行审核;
|
||||
针对项目实施计划风险,解决措施,规避方案,保障计划有效落地进行审核。
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
产品型项目需要关联产品
|
||||
![[a5ad93c5bc48c150209b4aee3433454.png]]
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
用户在互联网端的应用客户端运行在各种环境里,包括PC端Windows与Mac系统等、移动终端Android与iOS系统等,而传统的数字签名方案一般都是用USBKey或者BluetoothKey等硬件数字证书应用方案,由此带来的问题是不便捷、兼容性差、用户采购成本高。所以传统的数字证书应用方案已经不能适应当前密码安全的发展需求。
|
||||
|
||||
因此在用户无需任何额外硬件介质的条件下,为用户在互联网端提供安全合规的数字签名解决方案,有助于提升信雅达安全产品的综合竞争力,同时也有利于拓展非金融领域的安全产品市场,所以开发一套协同签名安全服务平台有着非常重要的意义。
|
||||
|
||||
支持PC端的Windows、Linux客户端,移动端的Android、 IOS系统的客户端,
|
||||
|
||||
客户端协同签名安全模块SDK:
|
||||
|
||||
1) 客户端协同签名安全模块 SDK 兼容 WEB。
|
||||
|
||||
2) 客户端协同签名安全模块 SDK 兼容文件操作
|
||||
|
||||
3) 客户端协同签名安全模块 SDK 兼容HMAC-SM3
|
||||
|
||||
4) 客户端协同签名安全模块 SDK 兼容HTTPS协议
|
||||
|
||||
协同签名安全服务平台:
|
||||
|
||||
5) 协同签名安全服务平台兼容信创数据库OceanBase?
|
||||
|
||||
6) 协同签名安全服务平台兼容HTTPS协议;
|
||||
|
||||
7) 协同签名安全服务平台web管理新增客户端证书存储、查询、删除
|
||||
|
||||
8) 协同签名安全服务平台web管理新增证书最大下载书配置,证书CA信息配置
|
||||
|
||||
9) 认证模块配置
|
||||
|
||||
10) 协同签名安全服务平台web管理支持非对称密钥的产生、分发、更换、使用、备份、恢复、销毁
|
||||
|
||||
11) 支持SNMP、SYSLOG等标准协议配置
|
||||
|
||||
12) 服务端支持keepalive功能
|
||||
|
||||
@@ -0,0 +1,121 @@
|
||||
由于JS存在数值限制,整数范围是[-2^53, 2^53],在这个范围之外就是失真,看一个例子:
|
||||
|
||||
```javascript
|
||||
console.log(Math.pow(2, 53));//9007199254740992
|
||||
console.log(Math.pow(2,53) + 1);//9007199254740992
|
||||
console.log(-Math.pow(2, 53));//-9007199254740992
|
||||
console.log(-Math.pow(2, 53) - 1);//-9007199254740992
|
||||
```
|
||||
|
||||
可以看到`2^53+1`应该输出的是`9007199254740993`,但是由于数值超过了JS的整数限制,造成了数值溢出。负数也是同样的原因。
|
||||
这种性质无疑会对大数运算带来一定的阻碍,像常见的斐波那契数列和阶乘,随着参数的增大,计算结果在某个阀值就会溢出,因此这就使得JS无法进行金融和科技上的精密计算。
|
||||
ES2020 引入了一种新的数据类型 BigInt(大整数),这是 ECMAScript 的第八种数据类型。BigInt 只用来表示整数,没有位数的限制,任何位数的整数都可以`精确`表示。
|
||||
来看一个实例:
|
||||
|
||||
```javascript
|
||||
var x = 123456789;
|
||||
var y = 987654321;
|
||||
console.log(x*y);//121932631112635260
|
||||
```
|
||||
|
||||
即使不用检验,也可以看出,结果显然不正确,因为x与y个位数相乘得到的是9,而结果的末尾是0。
|
||||
那么使用BigInt后呢?
|
||||
|
||||
```javascript
|
||||
var x = 123456789n;
|
||||
var y = 987654321n;
|
||||
console.log(x*y);//121932631112635269n
|
||||
```
|
||||
|
||||
得到的结果是正确的,感兴趣的话可以用字符串模拟乘法运算法则检验一下。
|
||||
可以看到BigInt与Number的区别在于后缀n,那么在刷题过程中,可以通过toString()的方法,把n去掉。
|
||||
|
||||
```javascript
|
||||
var x = 123456789n;
|
||||
var y = 987654321n;
|
||||
console.log(x*y);//121932631112635269n
|
||||
console.log((x*y).toString());//121932631112635269
|
||||
```
|
||||
|
||||
因此BigInt值与Number值并不是同一类型:
|
||||
|
||||
```javascript
|
||||
var a = 11n;
|
||||
var b = 11;
|
||||
console.log(typeof a);//bigint
|
||||
console.log(typeof b);//number
|
||||
console.log(a === b)//false
|
||||
```
|
||||
|
||||
但是在一些语法上是相似的:
|
||||
|
||||
1. 能够接受其他进制的数值,并转为十进制:
|
||||
|
||||
```javascript
|
||||
console.log(Number(0b11));//3
|
||||
console.log(BigInt(0b11n));//3n
|
||||
console.log(Number(0o71));//57
|
||||
console.log(BigInt(0o71n));//57n
|
||||
console.log(Number(0xA));//10
|
||||
console.log(BigInt(0xAn));//10n
|
||||
```
|
||||
|
||||
当然,使用BigInt进行转换时,也可以省略后缀n,**但是不推荐这样做**。
|
||||
|
||||
```javascript
|
||||
console.log(BigInt(0b11));//3n
|
||||
```
|
||||
|
||||
2. 使用一元运算符进行简单的计算:
|
||||
|
||||
```javascript
|
||||
var x = 6n;
|
||||
var y = 4n;
|
||||
console.log(x + y);//10n
|
||||
console.log(x - y);//2n
|
||||
console.log(x * y);//24n
|
||||
console.log(x / y);//1n
|
||||
console.log(x % y);//2n
|
||||
```
|
||||
|
||||
```javascript
|
||||
var x = 6;
|
||||
var y = 4;
|
||||
console.log(x + y);//10
|
||||
console.log(x - y);//2
|
||||
console.log(x * y);//24
|
||||
console.log(x / y);//1.5
|
||||
console.log(x % y);//2
|
||||
```
|
||||
|
||||
不同之处就是整除了,BigInt会返回整数,像C的整除一样,但是JS的整除返回的是在精度范围内的数字,也可以借助这一点来实现一些需求,例如在获取一个整数每位上的数字运算中,就可以现将这个这个整数转为BigInt类型,然后再计算,这样就省略了过程中借助`parseInt()`的转化了,来看一个例子:
|
||||
|
||||
```javascript
|
||||
var num = 123456789;
|
||||
var sum = 0;
|
||||
while(num){
|
||||
sum += num%10;
|
||||
num = parseInt(num/10);
|
||||
}
|
||||
console.log(sum);
|
||||
```
|
||||
|
||||
```javascript
|
||||
var num = 123456789;
|
||||
num = BigInt(num);
|
||||
var sum = 0n;
|
||||
while(num != 0n){
|
||||
sum += num % 10n;
|
||||
num = num/10n;
|
||||
}
|
||||
console.log(sum);
|
||||
```
|
||||
|
||||
好吧,虽然在这个例子中看起来很蠢,但是在一些条件下,确实可以起到很有效的作用。
|
||||
需要注意的是,BigInt与Number进行运算时,会报错:
|
||||
|
||||
```javascript
|
||||
console.log(1 + 2n);
|
||||
```
|
||||
|
||||
> TypeError: Cannot mix BigInt and other types, use explicit conversions
|
||||
@@ -0,0 +1,121 @@
|
||||
由于JS存在数值限制,整数范围是[-2^53, 2^53],在这个范围之外就是失真,看一个例子:
|
||||
|
||||
```javascript
|
||||
console.log(Math.pow(2, 53));//9007199254740992
|
||||
console.log(Math.pow(2,53) + 1);//9007199254740992
|
||||
console.log(-Math.pow(2, 53));//-9007199254740992
|
||||
console.log(-Math.pow(2, 53) - 1);//-9007199254740992
|
||||
```
|
||||
|
||||
可以看到`2^53+1`应该输出的是`9007199254740993`,但是由于数值超过了JS的整数限制,造成了数值溢出。负数也是同样的原因。
|
||||
这种性质无疑会对大数运算带来一定的阻碍,像常见的斐波那契数列和阶乘,随着参数的增大,计算结果在某个阀值就会溢出,因此这就使得JS无法进行金融和科技上的精密计算。
|
||||
ES2020 引入了一种新的数据类型 BigInt(大整数),这是 ECMAScript 的第八种数据类型。BigInt 只用来表示整数,没有位数的限制,任何位数的整数都可以`精确`表示。
|
||||
来看一个实例:
|
||||
|
||||
```javascript
|
||||
var x = 123456789;
|
||||
var y = 987654321;
|
||||
console.log(x*y);//121932631112635260
|
||||
```
|
||||
|
||||
即使不用检验,也可以看出,结果显然不正确,因为x与y个位数相乘得到的是9,而结果的末尾是0。
|
||||
那么使用BigInt后呢?
|
||||
|
||||
```javascript
|
||||
var x = 123456789n;
|
||||
var y = 987654321n;
|
||||
console.log(x*y);//121932631112635269n
|
||||
```
|
||||
|
||||
得到的结果是正确的,感兴趣的话可以用字符串模拟乘法运算法则检验一下。
|
||||
可以看到BigInt与Number的区别在于后缀n,那么在刷题过程中,可以通过toString()的方法,把n去掉。
|
||||
|
||||
```javascript
|
||||
var x = 123456789n;
|
||||
var y = 987654321n;
|
||||
console.log(x*y);//121932631112635269n
|
||||
console.log((x*y).toString());//121932631112635269
|
||||
```
|
||||
|
||||
因此BigInt值与Number值并不是同一类型:
|
||||
|
||||
```javascript
|
||||
var a = 11n;
|
||||
var b = 11;
|
||||
console.log(typeof a);//bigint
|
||||
console.log(typeof b);//number
|
||||
console.log(a === b)//false
|
||||
```
|
||||
|
||||
但是在一些语法上是相似的:
|
||||
|
||||
1. 能够接受其他进制的数值,并转为十进制:
|
||||
|
||||
```javascript
|
||||
console.log(Number(0b11));//3
|
||||
console.log(BigInt(0b11n));//3n
|
||||
console.log(Number(0o71));//57
|
||||
console.log(BigInt(0o71n));//57n
|
||||
console.log(Number(0xA));//10
|
||||
console.log(BigInt(0xAn));//10n
|
||||
```
|
||||
|
||||
当然,使用BigInt进行转换时,也可以省略后缀n,**但是不推荐这样做**。
|
||||
|
||||
```javascript
|
||||
console.log(BigInt(0b11));//3n
|
||||
```
|
||||
|
||||
2. 使用一元运算符进行简单的计算:
|
||||
|
||||
```javascript
|
||||
var x = 6n;
|
||||
var y = 4n;
|
||||
console.log(x + y);//10n
|
||||
console.log(x - y);//2n
|
||||
console.log(x * y);//24n
|
||||
console.log(x / y);//1n
|
||||
console.log(x % y);//2n
|
||||
```
|
||||
|
||||
```javascript
|
||||
var x = 6;
|
||||
var y = 4;
|
||||
console.log(x + y);//10
|
||||
console.log(x - y);//2
|
||||
console.log(x * y);//24
|
||||
console.log(x / y);//1.5
|
||||
console.log(x % y);//2
|
||||
```
|
||||
|
||||
不同之处就是整除了,BigInt会返回整数,像C的整除一样,但是JS的整除返回的是在精度范围内的数字,也可以借助这一点来实现一些需求,例如在获取一个整数每位上的数字运算中,就可以现将这个这个整数转为BigInt类型,然后再计算,这样就省略了过程中借助`parseInt()`的转化了,来看一个例子:
|
||||
|
||||
```javascript
|
||||
var num = 123456789;
|
||||
var sum = 0;
|
||||
while(num){
|
||||
sum += num%10;
|
||||
num = parseInt(num/10);
|
||||
}
|
||||
console.log(sum);
|
||||
```
|
||||
|
||||
```javascript
|
||||
var num = 123456789;
|
||||
num = BigInt(num);
|
||||
var sum = 0n;
|
||||
while(num != 0n){
|
||||
sum += num % 10n;
|
||||
num = num/10n;
|
||||
}
|
||||
console.log(sum);
|
||||
```
|
||||
|
||||
好吧,虽然在这个例子中看起来很蠢,但是在一些条件下,确实可以起到很有效的作用。
|
||||
需要注意的是,BigInt与Number进行运算时,会报错:
|
||||
|
||||
```javascript
|
||||
console.log(1 + 2n);
|
||||
```
|
||||
|
||||
> TypeError: Cannot mix BigInt and other types, use explicit conversions
|
||||
@@ -0,0 +1,46 @@
|
||||
[https://blog.csdn.net/u013032097/article/details/91385419](https://blog.csdn.net/u013032097/article/details/91385419)
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
[Nginx系列(一):HTTP处理流程概述](nginx+3e02fd85-3843-4c3f-9f36-3163bbcb3dec/Nginx%E7%B3%BB%E5%88%97%EF%BC%88%E4%B8%80%EF%BC%89%EF%BC%9AHTTP%E5%A4%84%E7%90%86%E6%B5%81%E7%A8%8B%E6%A6%82%E8%BF%B0%20ae2e8846-6a53-46f2-94eb-69cfc0a61513.md)
|
||||
|
||||
[Nginx系列(二):HTTP头部处理](nginx+3e02fd85-3843-4c3f-9f36-3163bbcb3dec/Nginx%E7%B3%BB%E5%88%97%EF%BC%88%E4%BA%8C%EF%BC%89%EF%BC%9AHTTP%E5%A4%B4%E9%83%A8%E5%A4%84%E7%90%86%207c17e3de-81c6-4ec2-8284-2a82dd32aab7.md)
|
||||
|
||||
[模块](nginx+3e02fd85-3843-4c3f-9f36-3163bbcb3dec/%E6%A8%A1%E5%9D%97%2022d60fcc-0759-4b90-b500-6d953cdfab84.md)
|
||||
|
||||
[nginx](nginx+3e02fd85-3843-4c3f-9f36-3163bbcb3dec/nginx%200b2a7e15-b00f-4d1a-a012-01b80abbf802.md)
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
- [ ] 文档入库 QA
|
||||
|
||||
|
||||
|
||||
- [ ] 环境整理
|
||||
|
||||
佰wei
|
||||
|
||||
|
||||
|
||||
- [ ] 工行
|
||||
|
||||
1. DM
|
||||
|
||||
2. 文件 时间
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
- 序列号
|
||||
|
||||
- 公钥
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,97 @@
|
||||
**accept 阶段(ngx_http_init_connection):**
|
||||
|
||||
1. 分配ngx_http_connection_t结构体;
|
||||
|
||||
2. 根据 fd 的端口和地址,为hc->addr_conf赋值,以供后续server块查询;
|
||||
|
||||
3. 新的 fd 加入epoll,设置读超时,超时时间为 post_accept_timeout,设置连接可重用。
|
||||
|
||||
|
||||
|
||||
**首次读阶段(ngx_http_wait_request_handler):**
|
||||
|
||||
1. 分配c->buffer(cscf->client_header_buffer_size大小)用于存储客户端包头;
|
||||
|
||||
2. recv调用接收包头;
|
||||
|
||||
3. 创建ngx_http_request_t。
|
||||
|
||||
|
||||
|
||||
**请求行阶段(ngx_http_process_request_line):**
|
||||
|
||||
1. 循环recv,放入r->header_in(c->buffer);
|
||||
|
||||
2. 解析uri,包括r->uri、r->args、r->exten;
|
||||
|
||||
3. 请求行处理结束。
|
||||
|
||||
|
||||
|
||||
**请求头阶段(ngx_http_process_request_headers):**
|
||||
|
||||
1. 循环recv,放入r->header_in(c->buffer);
|
||||
|
||||
2. 解析请求头,保存在r->headers_in.headers;
|
||||
|
||||
3. 解析请求头结束后,调用ngx_http_process_request,进行11阶段和子请求处理。
|
||||
|
||||
|
||||
|
||||
**读触发**
|
||||
|
||||
1. 在r->content_handler存在情况下,调用content_handler。
|
||||
|
||||
**content_handler阶段:(ngx_http_proxy_handler)**
|
||||
|
||||
1. 分配ngx_http_upstream_t结构体,并根据上游的协议类型,为upstream分配不同的回调函数,例如:
|
||||
create_request:创建上游请求
|
||||
process_header:处理上游响应
|
||||
finalize_request:结束上游请求
|
||||
input_filter_init:input_filter初始化
|
||||
input_filter:上游响应的处理函数
|
||||
|
||||
2. 无请求体情况,直接进入上游初始化(ngx_http_upstream_init);
|
||||
|
||||
3. 调用u->create_request将全部请求放入u->request_bufs(ngx_chain_t);
|
||||
|
||||
4. 建立上游连接(ngx_http_upstream_connect)。
|
||||
|
||||
|
||||
|
||||
**request_body_no_buffering=0的情况(缓存请求体):**
|
||||
1.不调用ngx_http_upstream_init建立上游;
|
||||
2.读事件触发请求体接收,直至请求体读取完成;
|
||||
3.回调rb->post_handler,即建立上游。
|
||||
|
||||
|
||||
|
||||
**request_body_no_buffering=1的情况(不缓存请求体):**
|
||||
|
||||
1.第一次读取结束后,设置r->reading_body = 1;
|
||||
2.立即建立上游;
|
||||
3.上游写事件触发时,将判断r->reading_body位,并不断读取请求体并发送至上游,直至请求体读取完成。
|
||||
|
||||
|
||||
|
||||
**上游请求发送阶段:(ngx_http_upstream_send_request)**
|
||||
|
||||
1. 对于首次请求发送(!u->request_sent),调用ngx_output_chain,发送u->request_bufs和r->request_body->bufs中的请求,直到请求发送完毕;
|
||||
|
||||
2. 非首次发送,只需要发送r->request_body->bufs。
|
||||
|
||||
3. 如果request_body_no_buffering = 0,发送一次就结束。否则,将循环读取下游包体,并循环发送。
|
||||
|
||||
**响应头阶段:(ngx_http_upstream_process_header)**
|
||||
1.循环recv,放入u->buffer;
|
||||
2.u->process_header解析响应行和响应头,解析结果保存在u->headers_in;
|
||||
3.将响应头放入r->headers_out;
|
||||
4.ngx_http_send_header发送响应头。
|
||||
|
||||
|
||||
|
||||
**响应体阶段:**
|
||||
即ngx_http_upstream_process_non_buffered_request调用
|
||||
1.循环recv,放入u->buffer;
|
||||
2.调用ngx_http_output_filter过滤及发送。
|
||||
|
||||
@@ -0,0 +1,18 @@
|
||||
《深入剖析Nginx》 by 高群凯
|
||||
《深入理解Nginx ——模块开发与架构解析》 by 陶辉
|
||||
|
||||
|
||||
|
||||
```Plain Text
|
||||
Ngx_http_upstream_zone_module
|
||||
Ngx_stream_upstream_zone_module
|
||||
--without-http_gzip_module \
|
||||
--with-http_ssl_module \
|
||||
--with-http_stub_status_module \
|
||||
--with-http_v2_module \
|
||||
--with-file-aio \
|
||||
--with-openssl="/usr/local/gmssl" \
|
||||
--with-cc-opt="-I/usr/local/gmssl/include" \
|
||||
--with-ld-opt="-lm"
|
||||
```
|
||||
|
||||
@@ -0,0 +1,217 @@
|
||||
**一、调用wasm中导出方法的函数**
|
||||
在js中,我们可以通过以下五种方式调用wasm中导出的方法:
|
||||
|
||||
1、**_函数名**
|
||||
2、**Module.ccall**
|
||||
|
||||
| | |
|
||||
| --- | -------------------------------------------------------------- |
|
||||
| 1 | `const ret = Module.ccall(ident, returnType, argTypes, args);` |
|
||||
|
||||
参数释义如下:
|
||||
|
||||
`ident`:C导出函数的函数名(不含“_”下划线前缀);
|
||||
|
||||
`returnType`:C导出函数的返回值类型,可以为'`boolean`'、'`number`'、'`string`'、'`null`',分别表示函数返回值为布尔值、数值、字符串、无返回值;
|
||||
|
||||
`argTypes`:C导出函数的参数类型的数组。参数类型可以为'`number`'、'`string`'、'`array`',分别代表数值、字符串、数组;
|
||||
|
||||
`args`:参数数组;
|
||||
|
||||
使用方式:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1|`const ret = Module.ccall('add', 'number', ['number', 'number'], [1, 2]);`|
|
||||
|
||||
**Emscripten从**`v1.38`**开始,**`ccall/cwrap`**辅助函数默认没有导出,在编译时需要通过**`-s EXPORTED_RUNTIME_METHODS="['ccall', 'cwrap']"`**选项显式导出。**
|
||||
|
||||
3、**Module.cwrap**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const func = Module.cwrap(ident, returnType, argTypes);`<br><br>`const ret = func(args);`|
|
||||
|
||||
参数释义如下:
|
||||
|
||||
`ident`:C导出函数的函数名(不含“_”下划线前缀);
|
||||
|
||||
`returnType`:C导出函数的返回值类型,可以为'`boolean`'、'`number`'、'`string`'、'`null`',分别表示函数返回值为布尔值、数值、字符串、无返回值;
|
||||
|
||||
`argTypes`:C导出函数的参数类型的数组。参数类型可以为'`number`'、'`string`'、'`array`',分别代表数值、字符串、数组;
|
||||
|
||||
返回值:函数
|
||||
|
||||
使用方式:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const func = Module.cwrap('add', 'number', ['number', 'number']);`<br><br>`const ret = func(1, 2);`|
|
||||
|
||||
**Emscripten从**`v1.38`**开始,**`ccall/cwrap`**辅助函数默认没有导出,在编译时需要通过**``-s `EXPORTED_RUNTIME_METHODS`="['ccall', 'cwrap']"``**选项显式导出。**
|
||||
|
||||
4、**Module._函数名**
|
||||
|
||||
5、**Module.asm.函数名**
|
||||
|
||||
上面我们了解了js调用wasm导出方法的5种方式,接下来我们开始介绍js和wasm间各种数据类型的传递。
|
||||
|
||||
|
||||
|
||||
**二、数字类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4|`int add(int n1, int n2) {`<br><br> `int ret = n1 + n2;`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向**C函数**传递数字:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4|`const r1 = _add(1, 2); // 3`<br><br>`const r2 = Module._add(1, 2); // 3`<br><br>`const r3 = Module.ccall('add', 'number', ['number', 'number'], [1, 2]); // 3`<br><br>`const r4 = Module.cwrap('add', 'number', ['number', 'number'])(1, 2); // 3`|
|
||||
|
||||
**获取**C函数**返回的数字:**
|
||||
|
||||
由于返回的数字是默认支持的类型,`r1`,`r2`,`r3`,`r4`即为结果。
|
||||
|
||||
**三、字符串类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9|`#include <string.h>`<br><br>`#include <malloc.h>`<br><br>`char * concat_str(char *s1, char *s2) {`<br><br> `char *ret = (char *)malloc((strlen(s1) + strlen(s2)) * sizeof(char));`<br><br> `strcat(ret, s1);`<br><br> `strcat(ret, s2);`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向C函数内传递**字符串**:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2|`const r1 = Module.ccall('concat_str', 'string', ['string', 'string'], ['Hello ', 'World']); // Hello World`<br><br>`const r2 = Module.cwrap('concat_str', 'string', ['string', 'string'])('Hello ', 'World'); // Hello World`|
|
||||
|
||||
**获取**C函数**返回的字符串:**
|
||||
|
||||
由于返回的数字是`ccall`,`cwrap`默认支持的类型,`r1`,`r2`即为结果。
|
||||
|
||||
上面没有直接使用函数名去调用C函数,因为不支持将字符串通过函数调用的方式直接传递给C函数,和我们预期是不一样的,感兴趣的可以去试一下,但是该如何使用函数名调用C函数呢,这里简单演示一下,作为后面数组传递的基础。
|
||||
|
||||
**向**C函数**传递**字符串**:**
|
||||
|
||||
| | |
|
||||
| ------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
|
||||
| 1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9 | `const s1 = 'Hello ';`<br><br>`const s2 = 'World';`<br><br>`const s1Arr = new TextEncoder().encode(s1);`<br><br>`const buf1 = Module._malloc(s1Arr.byteLength);`<br><br>`Module.HEAPU8.set(s1Arr, buf1);`<br><br>`const s2Arr = new TextEncoder().encode(s2);`<br><br>`const buf2 = Module._malloc(s2Arr.byteLength);`<br><br>`Module.HEAPU8.set(s2Arr, buf2);`<br><br>`const r1 = _concat_str(buf1, buf2); // 地址` |
|
||||
|
||||
这里我们将字符串`s1`和`s2`转为类型化数组`Uint8Array`,然后通过wasm提供的内存分配函数申请了内存,并放入了内存中,数据放到内存后将分配内存后得到的地址传递给C函数`_concat_str`即可。
|
||||
|
||||
**获取C函数返回的字符串:**
|
||||
|
||||
这里需要注意的是返回结果`r1`并不是预期的字符串而是一个内存地址,我们需要根据内存地址去获取返回结果:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8<br><br>9|`const memoryView = new Uint8Array(Module.asm.memory.buffer);`<br><br>`const arr = [];`<br><br>`let i = r1;`<br><br>`while (memoryView[i] !== 0) {`<br><br> `arr.push(memoryView[i]);`<br><br> `i ++;`<br><br>`}`<br><br>`const ret = new TextDecoder().decode(new Uint8Array(arr));`<br><br>`console.log(ret); // Hello World`|
|
||||
|
||||
**四、一维纯数字数组类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7|`int * mapArray(uint8_t *arr, int arrSize) {`<br><br> `int *ret = (int *)malloc(arrSize * sizeof(int));`<br><br> `for (int i=0; i<arrSize; i++) {`<br><br> `ret[i] = arr[i] * 2;`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向**C函数**传递一维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3|`const arr = [1, 3, 2, 5, 4];`<br><br>`const r1 = Module.ccall('mapArray', 'number', ['array', 'number'], [arr, arr.length]); // 地址`<br><br>`const r2 = Module.cwrap('mapArray', 'number', ['array', 'number'])(arr, arr.length); // 地址`|
|
||||
|
||||
如果想通过函数名直接向C函数传递数据,可以参考上面通过函数名直接向C函数传递字符串的方法。
|
||||
|
||||
**获取C函数返回的一维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5|`const { BYTES_PER_ELEMENT } = Float32Array;`<br><br>`const pointer = r1;`<br><br>`const data = new Float32Array(Module.asm.memory.buffer, pointer, arr.length);`<br><br>`const ret = Array.from(data);`<br><br>`console.log(ret); // [2, 6, 4, 10, 8]`|
|
||||
|
||||
这里的做法和上面获取直接调用函数名返回的字符串基本类似,但是没有字符串灵活,我们通过`\0`字符来判断字符串的结束进而拿到整个字符串而不需要提前知道返回字符串的长度,但是对于数组的话我们需要提前知道返回的数组的大小,才能准确的从内存中拿到返回结果。
|
||||
|
||||
**注意:**C语言中`int`类型数组对应`Uint32Array`,`float`类型数组对应`Float32Array`,`double`类型数组对应`Float64Array`,在获取结果时一定要使用正确的类型化数组,否则获取的结果将是错误的。
|
||||
|
||||
**五、二维纯数字数组类型的传递**
|
||||
|
||||
**C函数定义:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12|`double ** mapArray2(uint8_t *arr, int row, int col) {`<br><br> `static double **ret;`<br><br> `ret = (double **)malloc(row * col * sizeof(double *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (double *)malloc(col * sizeof(double));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[i * row + j] * 2;`<br><br> `printf("%d:%d=%f\n", i, j, ret[i][j]);`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
**向C函数传递二维数组:**
|
||||
|
||||
由于 C 编写的 WASM 模块只能接受一维数组,因此需要将二维数组转换为一维数组然后再传递。
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7|`const arr = [`<br><br> `[1, 2, 3],`<br><br> `[4, 5, 6],`<br><br> `[7, 8, 9]`<br><br>`];`<br><br>`const r1 = Module.ccall('mapArray2', 'number', ['array', 'number', 'number'], [arr.flat(), arr.length, arr[0].length]); // 地址`<br><br>`const r2 = Module.cwrap('mapArray2', 'number', ['array', 'number', 'number'])(arr.flat(), arr.length, arr[0].length); // 地址`|
|
||||
|
||||
**获取C函数返回的二维数组:**
|
||||
|
||||
这里就会麻烦一点,因为二维数组每一行对应的数据都存在一片单独的内存上,而且不一定是连续的,所以我们需要将每一行的起始内存地址返回,我们稍微修改一下C代码:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16|`double **ret;`<br><br>`double * getLineAddress(int row) {`<br><br> `return ret[row];`<br><br>`}`<br><br>`double ** mapArray2(uint8_t *arr, int row, int col) {`<br><br> `ret = (double **)malloc(row * col * sizeof(double *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (double *)malloc(col * sizeof(double));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[i * row + j] * 2;`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`|
|
||||
|
||||
在全局定义结果变量,然后提供一个获取每行地址的方法:`getLineAddress`。
|
||||
|
||||
然后使用js获取C函数返回的结果:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6<br><br>7<br><br>8|`const { BYTES_PER_ELEMENT } = Float64Array;`<br><br>`const ret = [];`<br><br>`for (let i=0; i<arr.length; i++) {`<br><br> `const pointer = _getLineAddress(i);`<br><br> `const row = new Float64Array(Module.asm.memory.buffer, pointer, arr[0].length);`<br><br> `ret.push(Array.from(row));`<br><br>`}`<br><br>`console.log(ret); // [[2, 4, 6], [,8, 10, 12],[14, 16, 18]]`|
|
||||
|
||||
**六、字符串数组的传递**
|
||||
|
||||
**C函数定义**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1<br><br>2<br><br>3<br><br>4<br><br>5<br><br>6|`char ** mapStringArray(char **strings, int length) {`<br><br> `for (int i = 0; i < length; i++) {`<br><br> `printf("%s\n", strings[i]);`<br><br> `}`<br><br> `return strings;`<br><br>`}`|
|
||||
|
||||
**向C函数传递二维数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17|`const strings = ['Hello', 'world', '!'];`<br><br>`// 将字符串存到内存中并获得字符串指针`<br><br>`const pointers = strings.map((str) => {`<br><br> `const buf = Module._malloc(str.length + 1);`<br><br> `Module.writeStringToMemory(str, buf);`<br><br> `return buf;`<br><br>`});`<br><br>`// 非常重要,将内存中存储的字符串重新存储到连续的内存`<br><br>`const STRING_BYTE = 4;`<br><br>`const ptr = Module._malloc(pointers.length * STRING_BYTE);`<br><br>`for (let i = 0; i < pointers.length; i++) {`<br><br> `Module.setValue(ptr + i * STRING_BYTE, pointers[i], 'i32');`<br><br>`}`<br><br>`const pointer = Module.ccall('mapStringArray', 'null', ['number', 'number'], [ptr, strings.length]);`|
|
||||
|
||||
在上面的方法中,我们首先将字符串存到内存中并得到了`字符串指针数组`,然后将字符串重新存储到了`连续的内存`中,这一步非常重要,直接影响C函数是否能正常取到字符串的值,需要注意C语言存储字符串时每个字符占4字节。
|
||||
|
||||
**获取C函数返回的字符串数组:**
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10|`const ret = [];`<br><br>`for (let i=0; i<strings.length; i++) {`<br><br> `const ptr = Module.getValue(pointer + i * 4, 'i32');`<br><br> `if (ptr === 0) {`<br><br> `break;`<br><br> `}`<br><br> `const str = Module.UTF8ToString(ptr);`<br><br> `ret.push(str);`<br><br>`}`<br><br>`console.log(ret); // ['Hello', 'world', '!']`|
|
||||
|
||||
**注意:**上面使用的`writeStringToMemory`,`setValue`,`getValue`,`UTF8ToString`需要通过`-s EXPORTED_RUNTIME_METHODS='["ccall", "cwrap", "writeAsciiToMemory", "writeStringToMemory", "setValue", "getValue", "UTF8ToString"]'` 导出。
|
||||
|
||||
不管是一维数组还是多位数组我们都需要提前知道返回数组的大小才能正确取得数据,如果输入的数组大小和输出的数组大小不一致时就很难正确的去除数据,所以我感觉C函数直接使用数组结构返回结果不是太灵活,其实我们可以换一种思路,比如将二维数组转换成字符串传递,接收到数据后再解析,类似下面这样:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1|`2,3,1,2,3,4,5,6`|
|
||||
|
||||
通过上面的字符串描述一个`2 * 3`的二维数组,然后我们将其转换成真实的数组即可。
|
||||
|
||||
js的转换方法:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17|`function str2Arr(str) {`<br><br> `const arr = str.split(',')`<br><br> `.map(m => Number(m));`<br><br> `const ret = [];`<br><br> `const row = arr[0];`<br><br> `const col = arr[1];`<br><br> `let index = 2;`<br><br> `for (let i=0; i<row; i++) {`<br><br> `ret[i] = [];`<br><br> `for(let j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[index++];`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`str2Arr('2,3,1,2,3,4,5,6');`|
|
||||
|
||||
C语言的转换方法:
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|01<br><br>02<br><br>03<br><br>04<br><br>05<br><br>06<br><br>07<br><br>08<br><br>09<br><br>10<br><br>11<br><br>12<br><br>13<br><br>14<br><br>15<br><br>16<br><br>17<br><br>18<br><br>19<br><br>20<br><br>21<br><br>22<br><br>23<br><br>24<br><br>25<br><br>26<br><br>27<br><br>28<br><br>29<br><br>30<br><br>31<br><br>32<br><br>33<br><br>34<br><br>35<br><br>36<br><br>37<br><br>38<br><br>39<br><br>40<br><br>41<br><br>42<br><br>43<br><br>44<br><br>45<br><br>46<br><br>47<br><br>48<br><br>49<br><br>50|`#include <stdio.h>`<br><br>`#include <string.h>`<br><br>`#include <stdlib.h>`<br><br>`int * split_int(char *str, char *sep) {`<br><br> `static int ret[100];`<br><br> `char *token;`<br><br> `token = strtok(str, sep);`<br><br> `int i = 0;`<br><br> `while (token != NULL) {`<br><br> `ret[i++] = atoi(token);`<br><br> `token = strtok(NULL, sep);`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`int ** str_2_matrix(char *str, int *r, int *c) {`<br><br> `int *arr = split_int(str, ",");`<br><br> `int row = arr[0];`<br><br> `int col = arr[1];`<br><br> `if (r != NULL) {`<br><br> `*r = row;`<br><br> `}`<br><br> `if (c != NULL) {`<br><br> `*c = col;`<br><br> `}`<br><br> `int index = 2;`<br><br> `static int **ret;`<br><br> `ret = (int **)malloc(row * sizeof(int *));`<br><br> `for (int i=0; i<row; i++) {`<br><br> `ret[i] = (int *)malloc(col * sizeof(int));`<br><br> `for (int j=0; j<col; j++) {`<br><br> `ret[i][j] = arr[index++];`<br><br> `}`<br><br> `}`<br><br> `return ret;`<br><br>`}`<br><br>`int main() {`<br><br> `char s[] = "2,3,1,2,3,4,5,6";`<br><br> `int r, c;`<br><br> `int **ret = str_2_matrix(s, &r, &c);`<br><br> `for (int i=0; i<r; i++) {`<br><br> `for (int j=0; j<c; j++) {`<br><br> `printf("%6d", ret[i][j]);`<br><br> `}`<br><br> `printf("\n");`<br><br> `}`<br><br> `return 0;`<br><br>`}`|
|
||||
|
||||
本文到此就结束了,希望大家在对接wasm应用的过程中不再迷茫。
|
||||
@@ -0,0 +1,19 @@
|
||||
|
||||
安装
|
||||
curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.40.0/install.sh | bash
|
||||
|
||||
|
||||
3. **安装指定版本的 Node.js**:
|
||||
nvm install 18.16.0 # 安装具体版本
|
||||
nvm install --lts # 安装最新的LTS版本
|
||||
nvm install node # 安装最新稳定版
|
||||
|
||||
4. **列出所有可用版本**:
|
||||
nvm ls-remote # 查看远程所有版本
|
||||
nvm ls # 查看本地已安装版本
|
||||
|
||||
5. **切换 Node.js 版本**:
|
||||
|
||||
nvm use 18.16.0 # 切换到指定版本
|
||||
nvm use --lts # 切换到LTS版本
|
||||
nvm use node # 切换到最新稳定版
|
||||
@@ -0,0 +1,92 @@
|
||||
Prisma 提供了一系列命令行工具来帮助开发者管理数据库和模型。以下是 Prisma 最常用的基本命令:
|
||||
|
||||
## 初始化与设置
|
||||
|
||||
1. **初始化 Prisma 项目**:
|
||||
npx prisma init
|
||||
创建 `prisma/schema.prisma` 文件和 `.env` 文件
|
||||
|
||||
## 数据库迁移相关
|
||||
|
||||
2. **创建新迁移**:
|
||||
npx prisma migrate dev --name [migration_name]
|
||||
开发环境使用,会自动应用迁移
|
||||
|
||||
|
||||
|
||||
3. **仅创建迁移文件而不应用**:
|
||||
npx prisma migrate dev --create-only
|
||||
|
||||
|
||||
4. **应用未执行的迁移**:
|
||||
npx prisma migrate deploy
|
||||
生产环境使用
|
||||
|
||||
|
||||
5. **重置数据库并重新应用所有迁移**:
|
||||
npx prisma migrate reset
|
||||
|
||||
6. **检查迁移状态**:
|
||||
npx prisma migrate status
|
||||
|
||||
|
||||
|
||||
|
||||
## 模型与数据库同步
|
||||
|
||||
7. **根据 schema 直接推送更改到数据库**:
|
||||
npx prisma db push
|
||||
- 不创建迁移记录,适合开发初期
|
||||
|
||||
8. **生成 Prisma Client**:
|
||||
npx prisma generate
|
||||
|
||||
|
||||
## 数据查看与操作
|
||||
|
||||
9. **启动 Prisma Studio (GUI 界面)**:
|
||||
npx prisma studio
|
||||
- 在浏览器中查看和编辑数据
|
||||
|
||||
10. **执行种子脚本**:
|
||||
npx prisma db seed
|
||||
|
||||
|
||||
## 诊断与维护
|
||||
|
||||
11. **验证 Prisma schema**:
|
||||
npx prisma validate
|
||||
|
||||
12. **格式化 Prisma schema 文件**:
|
||||
npx prisma format
|
||||
|
||||
13. **查看 Prisma 版本信息**:
|
||||
npx prisma --version
|
||||
|
||||
14. **生成数据模型关系图**:
|
||||
npx prisma generate --data-proxy
|
||||
|
||||
|
||||
## 生产环境相关
|
||||
|
||||
15. **创建生产环境的迁移**:
|
||||
npx prisma migrate diff
|
||||
|
||||
16. **检查数据库连接**:
|
||||
npx prisma db execute --file ./script.sql --schema prisma/schema.prisma
|
||||
|
||||
|
||||
## 高级命令
|
||||
|
||||
17. **使用 Prisma CLI 直接查询数据库**:
|
||||
npx prisma db execute --stdin --file=-
|
||||
|
||||
18. **导入现有数据库结构**:
|
||||
npx prisma db pull
|
||||
|
||||
|
||||
19. **导出当前数据库结构**:
|
||||
npx prisma db push --export
|
||||
|
||||
|
||||
这些命令涵盖了 Prisma 日常开发中的大多数使用场景。根据你的具体需求(开发、测试或生产环境),可以选择合适的命令组合来管理你的数据库。
|
||||
@@ -0,0 +1,148 @@
|
||||
流式输入(Stream Input)是一种数据处理方式,其中数据不是一次性全部加载到内存中,而是以连续的数据流形式逐块处理。这种方式特别适用于处理大量数据或实时数据,因为它可以减少内存占用并提高处理效率。
|
||||
|
||||
流式输出(Stream Output)是一种数据处理方式,其中数据不是一次性全部生成并发送,而是以连续的数据流形式逐块生成并发送。这种方式特别适用于处理大量数据或实时数据,因为它可以减少内存占用并提高处理效率。
|
||||
|
||||
关键概念和应用场景:
|
||||
|
||||
## 关键概念
|
||||
|
||||
1. **数据流**:
|
||||
|
||||
- 数据流是指数据以连续的方式传输,而不是一次性传输完整个数据集。
|
||||
- 数据流可以是字节流、字符流、文件流等。
|
||||
|
||||
1. **逐块处理**:
|
||||
|
||||
- 流式输入通常以固定大小的块(例如,几KB或几MB)读取数据,并在读取后立即处理这些块。
|
||||
- 这种方式允许程序在数据到达时就开始处理,而不需要等待所有数据都加载完毕。
|
||||
|
||||
1. **低延迟**:
|
||||
|
||||
- 流式输入可以实现实时或近实时的数据处理,因为数据可以在到达时立即被处理。
|
||||
|
||||
1. **资源高效**:
|
||||
|
||||
- 由于数据是逐块处理的,流式输入可以显著减少内存占用,适用于处理大规模数据集。
|
||||
|
||||
## 应用场景
|
||||
|
||||
1. **文件读写**:
|
||||
|
||||
- 处理大文件时,可以使用流式输入逐块读取文件内容,避免一次性加载整个文件导致内存溢出。
|
||||
- 例如,使用 Node.js 的 fs.createReadStream 方法读取大文件。
|
||||
|
||||
1. **网络通信**:
|
||||
|
||||
|
||||
|
||||
- 在网络编程中,数据通常以流的形式传输,例如 HTTP 请求和响应。
|
||||
- 例如,使用 Node.js 的 http 模块处理 HTTP 请求和响应。
|
||||
|
||||
1. **实时数据处理**:
|
||||
|
||||
- 处理实时数据流,如传感器数据、日志数据等。
|
||||
- 例如,使用 Apache Kafka 或 AWS Kinesis 处理实时数据流。
|
||||
|
||||
1. **多媒体处理**:
|
||||
|
||||
- 处理音频、视频等多媒体数据时,通常使用流式输入逐块读取和处理数据。
|
||||
- 例如,使用 FFmpeg 处理视频流。
|
||||
|
||||
## 示例
|
||||
|
||||
## Node.js 中的流式文件读取
|
||||
|
||||
```text
|
||||
const fs = require('fs');
|
||||
|
||||
// 创建一个可读流
|
||||
const readStream = fs.createReadStream('large-file.txt', { highWaterMark: 1024 * 1024 }); // 每次读取1MB
|
||||
|
||||
// 监听数据事件
|
||||
readStream.on('data', (chunk) => {
|
||||
console.log(`Received ${chunk.length} bytes of data.`);
|
||||
// 处理数据块
|
||||
});
|
||||
|
||||
// 监听结束事件
|
||||
readStream.on('end', () => {
|
||||
console.log('No more data to read.');
|
||||
});
|
||||
|
||||
// 监听错误事件
|
||||
readStream.on('error', (err) => {
|
||||
console.error('Error reading file:', err);
|
||||
});
|
||||
```
|
||||
|
||||
## 使用 Express 处理 HTTP 请求流
|
||||
|
||||
```text
|
||||
const express = require('express');
|
||||
const app = express();
|
||||
|
||||
app.get('/stream', (req, res) => {
|
||||
// 创建一个可读流
|
||||
const readStream = fs.createReadStream('large-file.txt');
|
||||
|
||||
// 将可读流管道到响应对象
|
||||
readStream.pipe(res);
|
||||
});
|
||||
|
||||
app.listen(3000, () => {
|
||||
console.log('Server is running on port 3000');
|
||||
});
|
||||
```
|
||||
|
||||
## Node.js 中的流式文件写入
|
||||
|
||||
```text
|
||||
const fs = require('fs');
|
||||
|
||||
// 创建一个可写流
|
||||
const writeStream = fs.createWriteStream('large-file.txt', { highWaterMark: 1024 * 1024 }); // 每次写入1MB
|
||||
|
||||
// 生成数据并写入流
|
||||
for (let i = 0; i < 1000; i++) {
|
||||
const data = `This is line ${i}\n`;
|
||||
writeStream.write(data, (err) => {
|
||||
if (err) {
|
||||
console.error('Error writing to file:', err);
|
||||
}
|
||||
});
|
||||
}
|
||||
|
||||
// 结束写入
|
||||
writeStream.end(() => {
|
||||
console.log('File has been written successfully.');
|
||||
});
|
||||
|
||||
// 监听错误事件
|
||||
writeStream.on('error', (err) => {
|
||||
console.error('Error writing to file:', err);
|
||||
});
|
||||
```
|
||||
|
||||
## 使用 Express 发送 HTTP 响应流
|
||||
|
||||
```text
|
||||
const express = require('express');
|
||||
const fs = require('fs');
|
||||
const app = express();
|
||||
|
||||
app.get('/stream', (req, res) => {
|
||||
// 创建一个可读流
|
||||
const readStream = fs.createReadStream('large-file.txt');
|
||||
|
||||
// 将可读流管道到响应对象
|
||||
readStream.pipe(res);
|
||||
});
|
||||
|
||||
app.listen(3000, () => {
|
||||
console.log('Server is running on port 3000');
|
||||
});
|
||||
```
|
||||
|
||||
## 总结
|
||||
|
||||
流式输入/出是一种高效的数据处理方式,特别适用于处理大量数据或实时数据。通过逐块处理数据,它可以减少内存占用并提高处理效率。
|
||||
@@ -0,0 +1,148 @@
|
||||
流式输入(Stream Input)是一种数据处理方式,其中数据不是一次性全部加载到内存中,而是以连续的数据流形式逐块处理。这种方式特别适用于处理大量数据或实时数据,因为它可以减少内存占用并提高处理效率。
|
||||
|
||||
流式输出(Stream Output)是一种数据处理方式,其中数据不是一次性全部生成并发送,而是以连续的数据流形式逐块生成并发送。这种方式特别适用于处理大量数据或实时数据,因为它可以减少内存占用并提高处理效率。
|
||||
|
||||
关键概念和应用场景:
|
||||
|
||||
## 关键概念
|
||||
|
||||
1. **数据流**:
|
||||
|
||||
- 数据流是指数据以连续的方式传输,而不是一次性传输完整个数据集。
|
||||
- 数据流可以是字节流、字符流、文件流等。
|
||||
|
||||
1. **逐块处理**:
|
||||
|
||||
- 流式输入通常以固定大小的块(例如,几KB或几MB)读取数据,并在读取后立即处理这些块。
|
||||
- 这种方式允许程序在数据到达时就开始处理,而不需要等待所有数据都加载完毕。
|
||||
|
||||
1. **低延迟**:
|
||||
|
||||
- 流式输入可以实现实时或近实时的数据处理,因为数据可以在到达时立即被处理。
|
||||
|
||||
1. **资源高效**:
|
||||
|
||||
- 由于数据是逐块处理的,流式输入可以显著减少内存占用,适用于处理大规模数据集。
|
||||
|
||||
## 应用场景
|
||||
|
||||
1. **文件读写**:
|
||||
|
||||
- 处理大文件时,可以使用流式输入逐块读取文件内容,避免一次性加载整个文件导致内存溢出。
|
||||
- 例如,使用 Node.js 的 fs.createReadStream 方法读取大文件。
|
||||
|
||||
1. **网络通信**:
|
||||
|
||||
|
||||
|
||||
- 在网络编程中,数据通常以流的形式传输,例如 HTTP 请求和响应。
|
||||
- 例如,使用 Node.js 的 http 模块处理 HTTP 请求和响应。
|
||||
|
||||
1. **实时数据处理**:
|
||||
|
||||
- 处理实时数据流,如传感器数据、日志数据等。
|
||||
- 例如,使用 Apache Kafka 或 AWS Kinesis 处理实时数据流。
|
||||
|
||||
1. **多媒体处理**:
|
||||
|
||||
- 处理音频、视频等多媒体数据时,通常使用流式输入逐块读取和处理数据。
|
||||
- 例如,使用 FFmpeg 处理视频流。
|
||||
|
||||
## 示例
|
||||
|
||||
## Node.js 中的流式文件读取
|
||||
|
||||
```text
|
||||
const fs = require('fs');
|
||||
|
||||
// 创建一个可读流
|
||||
const readStream = fs.createReadStream('large-file.txt', { highWaterMark: 1024 * 1024 }); // 每次读取1MB
|
||||
|
||||
// 监听数据事件
|
||||
readStream.on('data', (chunk) => {
|
||||
console.log(`Received ${chunk.length} bytes of data.`);
|
||||
// 处理数据块
|
||||
});
|
||||
|
||||
// 监听结束事件
|
||||
readStream.on('end', () => {
|
||||
console.log('No more data to read.');
|
||||
});
|
||||
|
||||
// 监听错误事件
|
||||
readStream.on('error', (err) => {
|
||||
console.error('Error reading file:', err);
|
||||
});
|
||||
```
|
||||
|
||||
## 使用 Express 处理 HTTP 请求流
|
||||
|
||||
```text
|
||||
const express = require('express');
|
||||
const app = express();
|
||||
|
||||
app.get('/stream', (req, res) => {
|
||||
// 创建一个可读流
|
||||
const readStream = fs.createReadStream('large-file.txt');
|
||||
|
||||
// 将可读流管道到响应对象
|
||||
readStream.pipe(res);
|
||||
});
|
||||
|
||||
app.listen(3000, () => {
|
||||
console.log('Server is running on port 3000');
|
||||
});
|
||||
```
|
||||
|
||||
## Node.js 中的流式文件写入
|
||||
|
||||
```text
|
||||
const fs = require('fs');
|
||||
|
||||
// 创建一个可写流
|
||||
const writeStream = fs.createWriteStream('large-file.txt', { highWaterMark: 1024 * 1024 }); // 每次写入1MB
|
||||
|
||||
// 生成数据并写入流
|
||||
for (let i = 0; i < 1000; i++) {
|
||||
const data = `This is line ${i}\n`;
|
||||
writeStream.write(data, (err) => {
|
||||
if (err) {
|
||||
console.error('Error writing to file:', err);
|
||||
}
|
||||
});
|
||||
}
|
||||
|
||||
// 结束写入
|
||||
writeStream.end(() => {
|
||||
console.log('File has been written successfully.');
|
||||
});
|
||||
|
||||
// 监听错误事件
|
||||
writeStream.on('error', (err) => {
|
||||
console.error('Error writing to file:', err);
|
||||
});
|
||||
```
|
||||
|
||||
## 使用 Express 发送 HTTP 响应流
|
||||
|
||||
```text
|
||||
const express = require('express');
|
||||
const fs = require('fs');
|
||||
const app = express();
|
||||
|
||||
app.get('/stream', (req, res) => {
|
||||
// 创建一个可读流
|
||||
const readStream = fs.createReadStream('large-file.txt');
|
||||
|
||||
// 将可读流管道到响应对象
|
||||
readStream.pipe(res);
|
||||
});
|
||||
|
||||
app.listen(3000, () => {
|
||||
console.log('Server is running on port 3000');
|
||||
});
|
||||
```
|
||||
|
||||
## 总结
|
||||
|
||||
流式输入/出是一种高效的数据处理方式,特别适用于处理大量数据或实时数据。通过逐块处理数据,它可以减少内存占用并提高处理效率。
|
||||
@@ -0,0 +1,26 @@
|
||||
|
||||
|
||||
初始化创建
|
||||
|
||||
```Plain Text
|
||||
cargo new rust-dylib-test --lib
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
手动修改 Cargo.toml
|
||||
|
||||
```Plain Text
|
||||
[dependencies]
|
||||
libc = "0.2.133"
|
||||
|
||||
[lib]
|
||||
crate-type = ["cdylib"]
|
||||
```
|
||||
|
||||
[Rust 与 C 之间,传递字符串的 7 种方式!](rust+04e8e86f-2e98-4d42-8ed7-bd3f2faa6b46/Rust+%E4%B8%8E+C+%E4%B9%8B%E9%97%B4%EF%BC%8C%E4%BC%A0%E9%80%92%E5%AD%97%E7%AC%A6%E4%B8%B2%E7%9A%84+7+%E7%A7%8D%E6%96%B9%E5%BC%8F%EF%BC%81%20d4df9d63-e517-4dbd-a5b2-2284c128313a.md)
|
||||
|
||||
[使用bindgen将C语言头文件转换为Rust接口代码](rust+04e8e86f-2e98-4d42-8ed7-bd3f2faa6b46/%E4%BD%BF%E7%94%A8bindgen%E5%B0%86%EF%BC%A3%E8%AF%AD%E8%A8%80%E5%A4%B4%E6%96%87%E4%BB%B6%E8%BD%AC%E6%8D%A2%E4%B8%BARust%E6%8E%A5%E5%8F%A3%E4%BB%A3%E7%A0%81%2047543bc0-182e-4f47-97da-6b83812741a6.md)
|
||||
|
||||
@@ -0,0 +1,26 @@
|
||||
|
||||
|
||||
初始化创建
|
||||
|
||||
```Plain Text
|
||||
cargo new rust-dylib-test --lib
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
手动修改 Cargo.toml
|
||||
|
||||
```Plain Text
|
||||
[dependencies]
|
||||
libc = "0.2.133"
|
||||
|
||||
[lib]
|
||||
crate-type = ["cdylib"]
|
||||
```
|
||||
|
||||
[Rust 与 C 之间,传递字符串的 7 种方式!](rust+04e8e86f-2e98-4d42-8ed7-bd3f2faa6b46/Rust+%E4%B8%8E+C+%E4%B9%8B%E9%97%B4%EF%BC%8C%E4%BC%A0%E9%80%92%E5%AD%97%E7%AC%A6%E4%B8%B2%E7%9A%84+7+%E7%A7%8D%E6%96%B9%E5%BC%8F%EF%BC%81%20d4df9d63-e517-4dbd-a5b2-2284c128313a.md)
|
||||
|
||||
[使用bindgen将C语言头文件转换为Rust接口代码](rust+04e8e86f-2e98-4d42-8ed7-bd3f2faa6b46/%E4%BD%BF%E7%94%A8bindgen%E5%B0%86%EF%BC%A3%E8%AF%AD%E8%A8%80%E5%A4%B4%E6%96%87%E4%BB%B6%E8%BD%AC%E6%8D%A2%E4%B8%BARust%E6%8E%A5%E5%8F%A3%E4%BB%A3%E7%A0%81%2047543bc0-182e-4f47-97da-6b83812741a6.md)
|
||||
|
||||
@@ -0,0 +1,333 @@
|
||||
摘要:Rust 得以在编程语言中火速崛起的原因之一,就是它能够与 C 语言进行互操作。因此在本文中,作者介绍了在 Rust 与 C 之间传递字符串的七种方式,这些方法不仅可用于传递字符串,也可用于其他数据。
|
||||
|
||||
(英)原文链接:https://dev.to/kgrech/7-ways-to-pass-a-string-between-rust-and-c-4ieb
|
||||
|
||||
|
||||
|
||||
Rust和C语言能够互操作,这恐怕是Rust最不可思议的功能之一。能够在C语言中调用安全地Rust代码,能够在Rust中通过C接口使用一些流行库,正是Rust能够在整个行业迅速流行的原因之一。此外,我们还可以通过C接口,用不同的语言编写代码,这样凡是能够调用C的语言都可以使用这些代码。
|
||||
|
||||
|
||||
|
||||
FFI 接口的编写难度很高,新手很难成功。如何处理 into_raw 和 as_ptr 方法,才不会导致内存泄漏或引发安全漏洞?在编写代码时,我们难免会使用一些不安全的关键字,这会令我们不安。我将在本文中介绍有关FFI接口的内存处理,并提供一些我在项目中使用过的有效模式。
|
||||
|
||||
|
||||
|
||||
> 注意:这里我以字符串作为例进行说明,实际上这些技术也适用于将字节数组或指针传输到 Box 或 Arc 类型的堆结构上。
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||

|
||||
|
||||
## **基本规则**
|
||||
|
||||
在学习如何实现FFI函数之前,我想先介绍一些基本的规则。你应该在设计的过程中牢记这些规则,因为缺少其中任何一个都可能引发各种bug,最终导致函数全面崩溃或内存泄漏。
|
||||
|
||||
### **规则1:一个指针,一个分配器**
|
||||
|
||||
你可能会认为内存分配只不过是调用一些操作系统API。然而实际上,获取一大块内存,写入缓存区是一项复杂且开销很大的操作。编译器和库开发人员很想应用各种优化,比如获得更大的内存块以避免频繁调用操作系统API,而且实现方式也各异。
|
||||
|
||||
你不应该假设调用库的人会使用某种类型的内存分配器。他们不一定会使用malloc,而且也不会受限于libc。换句话说,Rust代码分配的内存应该由Rust代码删除,越过FFI边界获取的指针应该交还给创建者去释放。如果使用malloc分配内存,请不要将其转换为Box,然后drop。我们应该通过调用Box::into_raw()获取的指针,不应该通过调用free来释放。
|
||||
|
||||
### **规则2:所有权**
|
||||
|
||||
Rust是一种内存安全语言,会明确指出所有权。如果在代码中看到Box<dyn Any>,你就知道在你drop Box之后,存储Any的内存会被立即释放。相反,如果看到void*,则无法判断是应该调用free释放内存,还是由其他人来释放这些内存(或许这些内存压根不需要被释放,因为它指向堆栈)。
|
||||
|
||||
在Rust中,将结构转化为原始指针的方法有一种命名约定。标准的库,比如Box、Arc、CStr和CString提供了as_ptr,还有一对into_raw和from_raw方法。并非每个结构都提供这三种方法,因此实际情况更加混乱。
|
||||
|
||||
我们来具体讨论一下这些库。首先是CString,它提供以上三种方法,as_ptr和into_raw方法都提供了相同类型的指针。然而,就像上面提到的void*一样,这些指针的所有权略有不同。
|
||||
|
||||
as_ptr方法以引用的形式接受&self。这意味着,在as_ptr返回后,CString实例依然会留在栈上,而数据的所有权也会保留。换句话说,返回的指针指向的数据仍归CString实例所有。一旦删除实例,指针就会悬空。在删除CString实例后,你永远不应再使用此指针。在安全的Rust中,指针的此属性由引用的生命周期(类似于指针)表示,并由编译器控制,但如果使用原始指针,一切都将变成未知。
|
||||
|
||||
与as_ptr不同,into_raw会通过值接受并销毁self。那么,会不会破坏释放内存?事实证明,into_raw不会调用drop方法。它会创建一个自己拥有的指针,然后将Rust分配器提供的内存块“泄漏”出来,脱离Rust编译器的控制范围。如果你只删除该指针,而不调用from_raw方法,就会引发内存泄漏。但是,它永远不会悬空(除非在调用from_raw之前修改或克隆它)。
|
||||
|
||||
如果你想让C暂时“借用”Rust的内存,则应该使用as_ptr。它有一个巨大的优势,因为 C 代码不必释放这块内存,而且还会限制指针的生命周期。但请不要将这个指针保存到某个全局结构中,或将其传递给另一个线程,也不应该将这样的指针作为函数调用的结果返回。
|
||||
|
||||
into_raw方法会将数据的所有权转移到C中。只要代码需要,它就可以保留指针,但请务必记得将它转移回Rust删除。
|
||||
|
||||
### **字符串的内存表示**
|
||||
|
||||
不幸的是,在Rust和语言C中,字符串的表示方式不同。C的字符串通常是char*指针,指向以 /0 结尾的char数组。而Rust则会保存字符数组及其长度。
|
||||
|
||||
由于这个原因,Rust的String和str类型与原始指针之间不应该互相转换。你应该使用CString和CStr中间类型来实现。通常,我们使用CString将Rust字符串传递给C代码,使用CStr将C的字符串转换为Rust的&str。请注意,这种转换并不一定会复制底层的数据。因此,通过CStr获得的&str会指向C分配的数组,而且它的生命周期与指针绑定。
|
||||
|
||||
注意:String:new会复制数据,但CStr::new不会。
|
||||
|
||||
## **项目设置**
|
||||
|
||||
### **如何将Rust和C连接起来**
|
||||
|
||||
网上有很多关于如何构建C代码,以及使用build.rs将C连接到Rust crate的资料,但是如何将Rust代码添加到C项目的文章却很少。相比之下,我更喜欢用C语言实现主要功能,并使用CMake作为构建系统。我希望CMake项目将Rust crate作为库,并根据Rust代码生成C的头文件。
|
||||
|
||||
### **通过CMake运行Cargo**
|
||||
|
||||
我建立了一个简单的CMake 3控制台应用程序。
|
||||
|
||||
首先,我们需要定义构建Rust库的命令和保存Rust成果物的位置:
|
||||
|
||||
```SQL
|
||||
if (CMAKE_BUILD_TYPE STREQUAL "Debug")
|
||||
set(CARGO_CMD RUSTFLAGS=-Zsanitizer=address cargo build -Zbuild-std --target x86_64-unknown-linux-gnu)
|
||||
set(TARGET_DIR "x86_64-unknown-linux-gnu/debug")
|
||||
else ()
|
||||
set(CARGO_CMD cargo build --release)
|
||||
set(TARGET_DIR "release")
|
||||
endif ()
|
||||
SET(LIB_FILE "${CMAKE_CURRENT_BINARY_DIR}/${TARGET_DIR}/librust_lib.a")
|
||||
```
|
||||
|
||||
对于熟悉Rust的人来说,这个构建crate调试版本的命令可能看起来有点古怪。我们完全可以使用cargo build来代替这个命令,但是我想利用Rust不稳定的地址清理器功能来确保内存不会被泄漏。
|
||||
|
||||
其次,我们需要自定义命令和目标,让它们根据命令输出结果。然后,我们可以定义一个名为rust_lib的静态导入库,并根据目标构建它:
|
||||
|
||||
```Plain Text
|
||||
add_custom_command(OUTPUT ${LIB_FILE}
|
||||
COMMENT "Compiling rust module"
|
||||
COMMAND CARGO_TARGET_DIR=${CMAKE_CURRENT_BINARY_DIR} ${CARGO_CMD}
|
||||
WORKING_DIRECTORY ${CMAKE_CURRENT_SOURCE_DIR}/rust_lib)
|
||||
add_custom_target(rust_lib_target DEPENDS ${LIB_FILE})
|
||||
add_library(rust_lib STATIC IMPORTED GLOBAL)
|
||||
add_dependencies(rust_lib rust_lib_target)
|
||||
```
|
||||
|
||||
最后,我们可以使用将二进制文件与Rust库(以及其他必需的系统库)链接在一起。我们还在C代码中启用了地址清理器:
|
||||
|
||||
```PHP
|
||||
target_compile_options(rust_c_interop PRIVATE -fno-omit-frame-pointer -fsanitize=address)
|
||||
target_link_libraries(rust_c_interop PRIVATE Threads::Threads rust_lib ${CMAKE_DL_LIBS} -fno-omit-frame-pointer -fsanitize=address)
|
||||
```
|
||||
|
||||
如此一来,运行CMake即可自动构建rust create,并与之链接。但是,我们还需要从C代码中调用Rust的方法。
|
||||
|
||||
### **生成C的头文件,并将它们添加到CMake项目中**
|
||||
|
||||
最简单的在Rust代码中获取C头文件的方法是使用cbingen库。
|
||||
|
||||
我们可以将以下代码添加到Rust crate的build.rs文件中,以检测Rust中定义的所有extern "C"函数,为其生成头文件定义,并保存到include/目录下:
|
||||
|
||||
```Swift
|
||||
let crate_dir = env::var("CARGO_MANIFEST_DIR").unwrap();
|
||||
let package_name = env::var("CARGO_PKG_NAME").unwrap();
|
||||
let output_file = PathBuf::from(&crate_dir)
|
||||
.join("include")
|
||||
.join(format!("{}.h", package_name));
|
||||
cbindgen::generate(&crate_dir)
|
||||
.unwrap()
|
||||
.write_to_file(output_file);
|
||||
```
|
||||
|
||||
此外,我们还应该在Rust crate的根目录中创建cbindgen.toml文件,并指明language = "C"。
|
||||
|
||||
接下来,CMake需要在Rust crate的include文件夹中查找头文件:
|
||||
|
||||
```Shell
|
||||
SET(LIB_HEADER_FOLDER "${CMAKE_CURRENT_SOURCE_DIR}/rust_lib/include")
|
||||
set_target_properties(rust_lib
|
||||
PROPERTIES
|
||||
IMPORTED_LOCATION ${LIB_FILE}
|
||||
INTERFACE_INCLUDE_DIRECTORIES ${LIB_HEADER_FOLDER})
|
||||
```
|
||||
|
||||
**将Rust字符串传递到C的五种方式**
|
||||
|
||||
一切准备就绪。下面,我们来看看如何从Rust的数据中获取字符串,然后在C中使用。我们怎么才能安全地传递字符串,同时不会造成内存泄漏?
|
||||
|
||||
### **方法1:提供创建和删除方法**
|
||||
|
||||
如果不知道C代码需要使用字符串多久,就可以采用这种方式。为了将所有权移交给C,我们可以构建CString对象,并使用into_raw将其转换为指针。free方法只需要构建CString,再drop这个对象就可以释放内存:
|
||||
|
||||
```PHP
|
||||
#[no_mangle]
|
||||
pub extern fn create_string() -> *const c_char {
|
||||
let c_string = CString::new(STRING).expect("CString::new failed");
|
||||
c_string.into_raw() // Move ownership to C
|
||||
}
|
||||
/// # Safety
|
||||
/// The ptr should be a valid pointer to the string allocated by rust
|
||||
#[no_mangle]
|
||||
pub unsafe extern fn free_string(ptr: *const c_char) {
|
||||
// Take the ownership back to rust and drop the owner
|
||||
let _ = CString::from_raw(ptr as *mut _);
|
||||
}
|
||||
```
|
||||
|
||||
不要忘记调用free_string,以避免内存泄漏:
|
||||
|
||||
```C++
|
||||
const char* rust_string = create_string();
|
||||
printf("1. Printed from C: %s\n", rust_string);
|
||||
free_string(rust_string);
|
||||
```
|
||||
|
||||
不要调用libc free方法,也不要尝试修改此类指针指向的数据。
|
||||
|
||||
这个方法虽然效果很好,但如果我们想在使用内存时释放Rust库,或者在不知道Rust库的代码中释放内存,该怎么办?你可以考虑以下三种方法。
|
||||
|
||||
### **方法2:分配缓冲区并复制数据**
|
||||
|
||||
还记得规则1吗?如果我们想在C中使用free方法释放内存,就应该使用malloc分配内存。但是,Rust怎么会知道malloc呢?一种解决方案是,“问一问”Rust需要多少内存,然后为它分配一个缓冲区:
|
||||
|
||||
```C++
|
||||
size_t len = get_string_len();
|
||||
char *buffer = malloc(len);
|
||||
copy_string(buffer);
|
||||
printf("4. Printed from C: %s\n", buffer);
|
||||
free(buffer);
|
||||
```
|
||||
|
||||
Rust只需要告诉我们缓冲区的大小,并小心翼翼地将Rust字符串复制到其中(注意不要漏掉末尾的字节0):
|
||||
|
||||
```PHP
|
||||
#[no_mangle]
|
||||
pub extern fn get_string_len() -> usize {
|
||||
STRING.as_bytes().len() + 1
|
||||
}
|
||||
/// # Safety
|
||||
/// The ptr should be a valid pointer to the buffer of required size
|
||||
#[no_mangle]
|
||||
pub unsafe extern fn copy_string(ptr: *mut c_char) {
|
||||
let bytes = STRING.as_bytes();
|
||||
let len = bytes.len();
|
||||
std::ptr::copy(STRING.as_bytes().as_ptr().cast(), ptr, len);
|
||||
std::ptr::write(ptr.offset(len as isize) as *mut u8, 0u8);
|
||||
}
|
||||
```
|
||||
|
||||
这个方法的优势在于,我们不必实现free_string,可以直接使用free。还有一个优点是,如有需要C代码也可以修改缓冲区(这就是我们使用*mut c_char,而不是*const c_char的原因)。
|
||||
|
||||
问题在于,我们仍然需要实现额外的方法get_string_len,而且还需要分配一块新内存,并复制数据(但其实CString::new也需要)。
|
||||
|
||||
如果你想将Rust字符串移动到C函数栈上分配的缓冲区,也可以使用此方法,但应该确保有足够的空间。
|
||||
|
||||
### **方法3:将内存分配器方法传递给Rust**
|
||||
|
||||
我们可以避免使用get_string_len方法吗?有没有其他方法在Rust中分配内存?一种简单的方法是将分配内存函数传递给Rust:
|
||||
|
||||
```C#
|
||||
type Allocator = unsafe extern fn(usize) -> *mut c_void;
|
||||
/// # Safety
|
||||
/// The allocator function should return a pointer to a valid buffer
|
||||
#[no_mangle]
|
||||
pub unsafe extern fn get_string_with_allocator(allocator: Allocator) -> *mut c_char {
|
||||
let ptr: *mut c_char = allocator(get_string_len()).cast();
|
||||
copy_string(ptr);
|
||||
ptr
|
||||
}
|
||||
```
|
||||
|
||||
上述示例使用了的copy_string,接下来我们可以使用get_string_with_allocator:
|
||||
|
||||
```C++
|
||||
char* rust_string_3 = get_string_with_allocator(malloc);
|
||||
printf("3. Printed from C: %s\n", rust_string_3);
|
||||
free(rust_string_3);
|
||||
```
|
||||
|
||||
这个方法与方法2相同,而且优缺点也一样。
|
||||
|
||||
但是,我们现在必须传递额外的参数allocator。其实,我们可以进行一些优化,将其保存到某个全局变量中,就可以避免向每个函数传递。
|
||||
|
||||
### **方法4:从Rust调用glibc**
|
||||
|
||||
如果我们的C代码会使用malloc/free来分配内存,则可以尝试在Rust代码中引入libc crate,尽管这种方式有点冒险:
|
||||
|
||||
```Properties files
|
||||
#[no_mangle]
|
||||
pub unsafe extern fn get_string_with_malloc() -> *mut c_char {
|
||||
let ptr: *mut c_char = libc::malloc(get_string_len()).cast();
|
||||
copy_string(ptr);
|
||||
ptr
|
||||
}
|
||||
```
|
||||
|
||||
C代码不变:
|
||||
|
||||
```C++
|
||||
char* rust_string_4 = get_string_with_malloc();
|
||||
printf("4. Printed from C: %s\n", rust_string_4);
|
||||
free(rust_string_4);
|
||||
```
|
||||
|
||||
在这种方式下,我们不需要提供分配内存的方法,但是C代码也会受到很多限制。我们最好做好文档记录,尽量避免使用这种方式,除非我们确定百分百安全。
|
||||
|
||||
### **方法5:借用Rust字符串**
|
||||
|
||||
以上这些方法都是将数据的所有权传递给C。但如果我们不需要传递所有权呢?举个例子,Rust代码需要同步调用C方法,并向它传递一些数据。这时,可以考虑使用CString的as_ptr:
|
||||
|
||||
```C++
|
||||
type Callback = unsafe extern fn(*const c_char);
|
||||
#[no_mangle]
|
||||
pub unsafe extern fn get_string_in_callback(callback: Callback) {
|
||||
let c_string = CString::new(STRING).expect("CString::new failed");
|
||||
// as_ptr() keeps ownership in rust unlike into_raw()
|
||||
callback(c_string.as_ptr())
|
||||
}
|
||||
```
|
||||
|
||||
不幸的是,即便在这种情况下,CString:new也会复制数据(因为它需要在末尾添加字节0)。
|
||||
|
||||
C代码如下:
|
||||
|
||||
```C++
|
||||
void callback(const char* string) {
|
||||
printf("5. Printed from C: %s\n", string);
|
||||
}
|
||||
int main() {
|
||||
get_string_in_callback(callback);
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
如果有一个生命周期已知的C指针,则我们应该优先使用这种方式,因为它可以保证没有内存泄漏。
|
||||
|
||||
## **将C字符串传递给Rust的两种方法**
|
||||
|
||||
下面,我们来介绍两种反向操作的方法,即将C的字符串转换为Rust的类型。主要方法有以下两种:
|
||||
|
||||
- 将C字符串转换成&str,不复制数据;
|
||||
|
||||
- 复制数据并接收字符串。
|
||||
|
||||
这两种方法的示例相同,因为它们非常相似。实际上,方法2需要先使用方法1。
|
||||
|
||||
C代码如下。我们在堆上分配数据,但实际上我们也可以将指针传递给栈:
|
||||
|
||||
```C++
|
||||
char *test = (char*) malloc(13*sizeof(char));
|
||||
strcpy(test, "Hello from C");
|
||||
print_c_string(test);
|
||||
free(test);
|
||||
```
|
||||
|
||||
Rust的实现如下:
|
||||
|
||||
```Swift
|
||||
#[no_mangle]
|
||||
/// # Safety
|
||||
/// The ptr should be a pointer to valid String
|
||||
pub unsafe extern fn print_c_string(ptr: *const c_char) {
|
||||
let c_str = CStr::from_ptr(ptr);
|
||||
let rust_str = c_str.to_str().expect("Bad encoding");
|
||||
// calling libc::free(ptr as *mut _); causes use after free vulnerability
|
||||
println!("1. Printed from rust: {}", rust_str);
|
||||
let owned = rust_str.to_owned();
|
||||
// calling libc::free(ptr as *mut _); does not cause after free vulnerability
|
||||
println!("2. Printed from rust: {}", owned);
|
||||
}
|
||||
```
|
||||
|
||||
注意,此处我们使用了CStr,而不是CString。如果不是CString::into_raw创建的指针,请不要调用CString:from_raw。
|
||||
|
||||
这里还需要注意,&str引用的生命周期不是“静态”的,而是绑定到了c_str对象方法。Rust编译器会阻止你在该方法之外返回&str,或将其移动到全局变量/另一个线程,因为一旦C代码释放内存,&str引用就会变成非法。
|
||||
|
||||
如果需要在Rust中长时间保留数据的所有权,只需调用to_owned()即可获取字符串的副本。如果不想复制,则可以使用CStr,但我们应该确保C代码不会在字符串还在使用期间释放内存。
|
||||
|
||||
## **总结**
|
||||
|
||||
在本文中,我们讨论了Rust与C之间的互操作,并介绍了几种跨FFI边界传递数据的方法。这些方法不仅可用于传递字符串,也可用于其他数据,或者利用FFI将Rust连接到其他编程语言。
|
||||
|
||||
BIN

Binary file not shown.
|
After Width: | Height: | Size: 68 KiB |
@@ -0,0 +1,37 @@
|
||||
## 擅长领域
|
||||
- 高性能 Web Service
|
||||
- WebAssembly
|
||||
- 命令行工具
|
||||
- 网络编程
|
||||
- 嵌入式设备
|
||||
- 系统编程
|
||||
|
||||
## 优点
|
||||
- 性能高
|
||||
- 安全性好
|
||||
- 无所畏惧的并发
|
||||
|
||||
## 数据类型
|
||||
|
||||
#### 标量类型
|
||||
- 整数
|
||||
- 值溢出,debug 模式会panic ,release 模式不会
|
||||
- 浮点类型
|
||||
- 布尔
|
||||
- 字符
|
||||
|
||||
|
||||
#### 复合类型
|
||||
- 元组 tuple
|
||||
- 数组
|
||||
|
||||
|
||||
## 所有权
|
||||
- 每个值同时只能有一个所有者
|
||||
|
||||
### 引用
|
||||
|
||||
|
||||
|
||||
|
||||
### 借用
|
||||
@@ -0,0 +1,37 @@
|
||||
## 擅长领域
|
||||
- 高性能 Web Service
|
||||
- WebAssembly
|
||||
- 命令行工具
|
||||
- 网络编程
|
||||
- 嵌入式设备
|
||||
- 系统编程
|
||||
|
||||
## 优点
|
||||
- 性能高
|
||||
- 安全性好
|
||||
- 无所畏惧的并发
|
||||
|
||||
## 数据类型
|
||||
|
||||
#### 标量类型
|
||||
- 整数
|
||||
- 值溢出,debug 模式会panic ,release 模式不会
|
||||
- 浮点类型
|
||||
- 布尔
|
||||
- 字符
|
||||
|
||||
|
||||
#### 复合类型
|
||||
- 元组 tuple
|
||||
- 数组
|
||||
|
||||
|
||||
## 所有权
|
||||
- 每个值同时只能有一个所有者
|
||||
|
||||
### 引用
|
||||
|
||||
|
||||
|
||||
|
||||
### 借用
|
||||
@@ -0,0 +1,378 @@
|
||||
[嵌入式系统](https://so.csdn.net/so/search?q=%E5%B5%8C%E5%85%A5%E5%BC%8F%E7%B3%BB%E7%BB%9F&spm=1001.2101.3001.7020)层及应用层的软件开发,离不开C语言。笔者希望使用一种高效、稳定的开发语言,在一定程度上替代C语言,从而提高开发效率、降低嵌入式软件的扩展、维护成本,同时缩小研发团队规模。[Rust](https://rust-lang.org/)编程语言很好地满足了高效、稳定这两个要求。不过需要在一定程度解决`Rust`调用外部C语言模块的问题:`Rust`语言已提供了完善的解决方案,笔者希望通过本文做一个必要的记录。
|
||||
|
||||
笔者在之前一篇[文章](https://blog.csdn.net/yeholmes/article/details/118660405)中简要介绍了[Rust](https://rust-lang.org/)语言调用C语言动态库提供的函数的一般方法。不过随着`Rust`工程依赖的外部的C语言模块越来越来复杂,手工将C语言头文件定义的调用接口转换为`Rust`接口代码变得不具可操作性。幸运的是,一个名为[bindgen](https://github.com/rust-lang/rust-bindgen)的开源项目很好地解决了这个问题,它通过[clang](https://clang.llvm.org/docs/)编译器库对C语言的头文件进行预处理,并生成相应的`Rust`接口代码;本文参考了其[官方文档](https://rust-lang.github.io/rust-bindgen),结合笔者的开发需要作简要的使用说明。
|
||||
|
||||
#### Rust语言将字符串转换为整型
|
||||
|
||||
笔者在实际开发过程,需要将`Rust`的一个字符串类型转换为整型,`Rust`柡准库已经提供了相应的转换函数[parse](https://doc.rust-lang.org/std/primitive.str.html#method.parse):
|
||||
|
||||
```Rust
|
||||
pub fn parse<F>(&self) -> Result<F, <F as FromStr>::Err>where
|
||||
F: FromStr,
|
||||
...
|
||||
let four: u32 = "4".parse().unwrap();
|
||||
assert_eq!(4, four);
|
||||
|
||||
12345
|
||||
```
|
||||
|
||||
不过,`parse`函数的缺陷是,它要求输入的字符串是十进制的,对于`"0x1234"`之类的非十六进制数,则不能正确处理。然而,柡准库也提供了另一个函数[from_str_radix](https://doc.rust-lang.org/std/primitive.i64.html#method.from_str_radix),可指定任意仍意进制的字符串到整型:
|
||||
|
||||
```Rust
|
||||
pub fn from_str_radix(src: &str, radix: u32) -> Result<i64, ParseIntError>
|
||||
...
|
||||
assert_eq!(i64::from_str_radix("A", 16), Ok(10));
|
||||
|
||||
123
|
||||
```
|
||||
|
||||
结合这两个柡准库提供的函数,就可以编写一个纯粹的`Rust`函数,根据字符串的前缀决定调用哪一个转换函数了。不过笔者是怀旧的,希望继续调用C语言柡准库提供的函数`strtoll/strtoull`,这两个函数可以自动判断字符串的进制(尽管仅限于几个进制)。
|
||||
|
||||
笔者为`Rust`工程编写的代码如下(完整代码可参考[此处](https://github.com/jaqchen/bindings)):
|
||||
|
||||
```C
|
||||
/* extmodule/extmodule.h */
|
||||
#ifndef RUST_EXTMODULE_H
|
||||
#define RUST_EXTMODULE_H 1
|
||||
|
||||
int extm_strtol(const char * strp, long long * valp, int base);
|
||||
int extm_strtoul(const char * strp, unsigned long long * valp, int base);
|
||||
|
||||
#endif
|
||||
|
||||
/* extmodule/extmodule.c */
|
||||
#include <errno.h>
|
||||
#include <stdio.h>
|
||||
#include <string.h>
|
||||
#include <stdlib.h>
|
||||
#include <time.h>
|
||||
|
||||
int extm_strtol(const char * strp, long long * valp, int base)
|
||||
{
|
||||
long long ret;
|
||||
int error = EINVAL;
|
||||
char * strend = NULL;
|
||||
|
||||
if (strp == NULL)
|
||||
return error;
|
||||
|
||||
errno = 0;
|
||||
ret = strtoll(strp, &strend, base);
|
||||
error = errno;
|
||||
if (error || strend == strp)
|
||||
return (error > 0) ? error : EINVAL;
|
||||
|
||||
if (valp != NULL)
|
||||
*valp = ret;
|
||||
return 0;
|
||||
}
|
||||
|
||||
int extm_strtoul(const char * strp, unsigned long long * valp, int base)
|
||||
{
|
||||
int error = EINVAL;
|
||||
char * strend = NULL;
|
||||
unsigned long long ret;
|
||||
|
||||
if (strp == NULL)
|
||||
return error;
|
||||
|
||||
errno = 0;
|
||||
ret = strtoull(strp, &strend, base);
|
||||
error = errno;
|
||||
if (error || strend == strp)
|
||||
return (error > 0) ? error : EINVAL;
|
||||
|
||||
if (valp != NULL)
|
||||
*valp = ret;
|
||||
return 0;
|
||||
}
|
||||
|
||||
12345678910111213141516171819202122232425262728293031323334353637383940414243444546474849505152535455
|
||||
```
|
||||
|
||||
之后,笔者对这两个函数`extm_strtol/extm_strtoul`进一步封装:
|
||||
|
||||
```Rust
|
||||
// src/lib.rs
|
||||
#![allow(non_snake_case)]
|
||||
#![allow(non_camel_case_types)]
|
||||
#![allow(non_upper_case_globals)]
|
||||
|
||||
use std::os::raw::c_int;
|
||||
use std::os::raw::c_longlong;
|
||||
use std::os::raw::c_ulonglong;
|
||||
|
||||
include!(concat!(env!("OUT_DIR"), "/bindings.rs"));
|
||||
|
||||
pub fn strtol(x: &str, base: i32) -> Result<i64, std::io::Error> {
|
||||
let mut res: c_longlong = 0;
|
||||
let y: Vec<u8> = x.as_bytes().iter().cloned().collect();
|
||||
let error = unsafe {
|
||||
let z = std::ffi::CString::from_vec_unchecked(y);
|
||||
extm_strtol(z.as_ptr(), &mut res as *mut c_longlong, base as c_int)
|
||||
};
|
||||
match error {
|
||||
0 => Ok(res as i64),
|
||||
_ => Err(std::io::Error::from_raw_os_error(error as i32)),
|
||||
}
|
||||
}
|
||||
|
||||
pub fn strtoul(x: &str, base: i32) -> Result<u64, std::io::Error> {
|
||||
let mut res: c_ulonglong = 0;
|
||||
let y: Vec<u8> = x.as_bytes().iter().cloned().collect();
|
||||
let error = unsafe {
|
||||
let z = std::ffi::CString::from_vec_unchecked(y);
|
||||
extm_strtoul(z.as_ptr(), &mut res as *mut c_ulonglong, base as c_int)
|
||||
};
|
||||
match error {
|
||||
0 => Ok(res as u64),
|
||||
_ => Err(std::io::Error::from_raw_os_error(error as i32)),
|
||||
}
|
||||
}
|
||||
|
||||
123456789101112131415161718192021222324252627282930313233343536
|
||||
```
|
||||
|
||||
这样,笔者就得到了两个`Rust`语言版本的字符串到整型的转换函数,`strtol/strtoul`。接下来就要解决编译的问题,即将`extmodule/extmodule.h`头文件转换为`src/lib.rs`包含的接口文件,`bindings.rs`:
|
||||
|
||||
```Rust
|
||||
include!(concat!(env!("OUT_DIR"), "/bindings.rs"));
|
||||
|
||||
1
|
||||
```
|
||||
|
||||
此外还要求在为嵌入式设备编译构建时,也能够交叉编译`extmodule`模块。
|
||||
|
||||
#### 编写build.rs自动化编译外部模块
|
||||
|
||||
笔者参考了[bindgen](https://rust-lang.github.io/rust-bindgen/)的相关文档,调用相关的`binding`接口,将`extmodule/extmodule.h`转换为`$(OUT_DIR)`目录下的`bindings.rs`接口代码;之后又调用了[make](https://www.gnu.org/software/make/)命令行工具,实现`extmodule`的(交叉)编译,生成`libextm.so`动态库:
|
||||
|
||||
```Rust
|
||||
extern crate bindgen;
|
||||
use std::process::Command;
|
||||
|
||||
fn main() {
|
||||
// generate binding.rs for extmodule
|
||||
let bindings = bindgen::Builder::default()
|
||||
.header("extmodule/extmodule.h")
|
||||
.parse_callbacks(Box::new(bindgen::CargoCallbacks))
|
||||
.generate()
|
||||
.expect("Unable to generate bindings");
|
||||
let out_path = std::path::PathBuf::from(std::env::var("OUT_DIR").unwrap());
|
||||
bindings.write_to_file(out_path.join("bindings.rs"))
|
||||
.expect("Couldn't write bindings!");
|
||||
|
||||
// invoke make to build external C module
|
||||
let cc = format!("CC={}", std::env::var("TARGET_CC")
|
||||
.unwrap_or_else(|_| "cc".to_string()));
|
||||
let cflags = format!("CFLAGS={}", std::env::var("TARGET_CFLAGS")
|
||||
.unwrap_or_else(|_| "-Wall -fPIC -D_GNU_SOURCE -Os -ggdb".to_string()));
|
||||
let okay = Command::new("make")
|
||||
.arg(AsRef::<std::ffi::OsStr>::as_ref(&cc))
|
||||
.arg(AsRef::<std::ffi::OsStr>::as_ref(&cflags))
|
||||
.args(&["-C", "./extmodule", "-j1", "clean", "all"])
|
||||
.spawn()
|
||||
.expect("Failed to invoke make utility")
|
||||
.wait()
|
||||
.expect("Failed to wait make utility")
|
||||
.success();
|
||||
if !okay {
|
||||
eprintln!("Error, make for external C module has failed!");
|
||||
std::process::exit(1);
|
||||
}
|
||||
|
||||
println!("cargo:rustc-link-lib=extm");
|
||||
println!("cargo:rustc-link-search=./extmodule");
|
||||
println!("cargo:rerun-if-changed=./extmodule/extmodule.h");
|
||||
println!("cargo:rustc-link-arg-bins=-Wl,-rpath=$ORIGIN");
|
||||
}
|
||||
|
||||
1234567891011121314151617181920212223242526272829303132333435363738
|
||||
```
|
||||
|
||||
在编译之前,需要为系统安装`clang`相关的依赖,这是`bindgen`需要的:
|
||||
|
||||
```Shell
|
||||
sudo apt install clang-14 libclang-14-dev # for ubuntu-22.04
|
||||
|
||||
1
|
||||
```
|
||||
|
||||
笔者编译、运行`bindings`工程的输出结果如下:
|
||||
|
||||
```Plain Text
|
||||
yejq@ubuntu:~/program/bindings$ cargo build --release
|
||||
Compiling bindings v0.1.0 (/home/yejq/program/bindings)
|
||||
Finished release [optimized] target(s) in 0.73s
|
||||
yejq@ubuntu:~/program/bindings$ cp -v ./extmodule/libextm.so ./target/release/
|
||||
'./extmodule/libextm.so' -> './target/release/libextm.so'
|
||||
yejq@ubuntu:~/program/bindings$ ./target/release/bindings 2099 0x2030
|
||||
arg0: 2099, arg1: 0x2030
|
||||
System uptime: 86910
|
||||
total 0
|
||||
lrwx------ 1 yejq yejq 64 1月 25 11:35 0 -> /dev/pts/11
|
||||
lrwx------ 1 yejq yejq 64 1月 25 11:35 1 -> /dev/pts/11
|
||||
lrwx------ 1 yejq yejq 64 1月 25 11:35 2 -> /dev/pts/11
|
||||
lr-x------ 1 yejq yejq 64 1月 25 11:35 3 -> /dev/null
|
||||
lr-x------ 1 yejq yejq 64 1月 25 11:35 4 -> /proc/17644/fd
|
||||
total 0
|
||||
lrwx------ 1 yejq yejq 64 1月 25 11:35 0 -> /dev/pts/11
|
||||
lrwx------ 1 yejq yejq 64 1月 25 11:35 1 -> /dev/pts/11
|
||||
lrwx------ 1 yejq yejq 64 1月 25 11:35 2 -> /dev/pts/11
|
||||
lr-x------ 1 yejq yejq 64 1月 25 11:35 3 -> /proc/17645/fd
|
||||
|
||||
12345678910111213141516171819
|
||||
```
|
||||
|
||||
可以看到,使用`extmodule`外部模块,可以很好地解决十六进制字符串`0x2030`转换为整型的问题。
|
||||
|
||||
#### 使用`bindgen`命令行工具转换接口文件
|
||||
|
||||
`Rust`语言、工具链开发者选择`Rust`作为自定义编译构建的语言,相应的代码为工作根目录下的`build.rs`。该代码依赖了`bindgen`库,将`extmodule/extmodule.h`转化为`Rust`编程语言的接口文件,这一依赖在`Cargo.toml`需要指明:
|
||||
|
||||
```Toml
|
||||
[dependencies]
|
||||
|
||||
[build-dependencies]
|
||||
bindgen = "0.62.0"
|
||||
|
||||
1234
|
||||
```
|
||||
|
||||
有人可能会提议,使用`build.rs`作为自定义编译构建代码,可能不太方便,因为某些工程不产生以上依赖,而是使用[bindgen](https://rust-lang.github.io/rust-bindgen/command-line-usage.html)命令行工具实现以上C语言头文件到`bindings.rs`接口的转换,那么使用`shell`脚本就更合理。例如`build.rs.sh`脚本实现了目前的`build.rs`所有功能:
|
||||
|
||||
```Shell
|
||||
#!/bin/bash
|
||||
|
||||
# Created by yejq.jiaqiang@gmail.com
|
||||
# Simple build script for bindtest
|
||||
# 2023/01/24
|
||||
|
||||
# generate bindings.rs source file in `$(OUT_DIR) directory
|
||||
generate_bindings() {
|
||||
if [ ! -d "${OUT_DIR}" ] ; then
|
||||
echo "Error, \`\${OUT_DIR} not found." 1>&2
|
||||
return 1
|
||||
fi
|
||||
bindgen -o "${OUT_DIR}/bindings.rs" 'extmodule/extmodule.h'
|
||||
return $?
|
||||
}
|
||||
|
||||
compile_extmodule() {
|
||||
local COMPILER="${TARGET_CC:-gcc}"
|
||||
local C_FLAGS="${TARGET_CFLAGS:--Wall -fPIC -Os -D_GNU_SOURCE -ggdb}"
|
||||
make "CC=${COMPILER}" "CFLAGS=${C_FLAGS}" -C extmodule -j1 clean all
|
||||
return $?
|
||||
}
|
||||
|
||||
define_rustc_flags() {
|
||||
echo "cargo:rustc-link-lib=extm"
|
||||
echo "cargo:rustc-link-search=./extmodule"
|
||||
echo "cargo:rerun-if-changed=./build.rs.sh"
|
||||
echo "cargo:rerun-if-changed=./extmodule/extmodule.h"
|
||||
echo "cargo:rustc-link-arg-bins=-Wl,-rpath=\$ORIGIN"
|
||||
return 0
|
||||
}
|
||||
|
||||
generate_bindings || exit $?
|
||||
compile_extmodule || exit $?
|
||||
define_rustc_flags ; exit 0
|
||||
|
||||
1234567891011121314151617181920212223242526272829303132333435
|
||||
```
|
||||
|
||||
该脚本,即简洁,又具备很强的扩展性,修改起来又比`build.rs`方便很多;确实是这样。那么可以修改`build.rs`脚本,实现对该脚本的一劳永逸的调用:
|
||||
|
||||
```diff
|
||||
diff --git a/Cargo.toml b/Cargo.toml
|
||||
index a57c279..3b947ae 100644
|
||||
--- a/Cargo.toml
|
||||
+++ b/Cargo.toml
|
||||
@@ -8,4 +8,4 @@ edition = "2021"
|
||||
[dependencies]
|
||||
|
||||
[build-dependencies]
|
||||
-bindgen = "0.62.0"
|
||||
+libc = { version = "0.2.139" }
|
||||
diff --git a/build.rs b/build.rs
|
||||
index 6a2fff1..dddf1f8 100644
|
||||
--- a/build.rs
|
||||
+++ b/build.rs
|
||||
@@ -1,38 +1,17 @@
|
||||
-extern crate bindgen;
|
||||
-use std::process::Command;
|
||||
+use std::ffi::CString;
|
||||
+use libc::{c_char, execv};
|
||||
+use std::collections::VecDeque;
|
||||
|
||||
fn main() {
|
||||
- // generate binding.rs for extmodule
|
||||
- let bindings = bindgen::Builder::default()
|
||||
- .header("extmodule/extmodule.h")
|
||||
- .parse_callbacks(Box::new(bindgen::CargoCallbacks))
|
||||
- .generate()
|
||||
- .expect("Unable to generate bindings");
|
||||
- let out_path = std::path::PathBuf::from(std::env::var("OUT_DIR").unwrap());
|
||||
- bindings.write_to_file(out_path.join("bindings.rs"))
|
||||
- .expect("Couldn't write bindings!");
|
||||
-
|
||||
- // invoke make to build external C module
|
||||
- let cc = format!("CC={}", std::env::var("TARGET_CC")
|
||||
- .unwrap_or_else(|_| "cc".to_string()));
|
||||
- let cflags = format!("CFLAGS={}", std::env::var("TARGET_CFLAGS")
|
||||
- .unwrap_or_else(|_| "-Wall -fPIC -D_GNU_SOURCE -Os -ggdb".to_string()));
|
||||
- let okay = Command::new("make")
|
||||
- .arg(AsRef::<std::ffi::OsStr>::as_ref(&cc))
|
||||
- .arg(AsRef::<std::ffi::OsStr>::as_ref(&cflags))
|
||||
- .args(&["-C", "./extmodule", "-j1", "clean", "all"])
|
||||
- .spawn()
|
||||
- .expect("Failed to invoke make utility")
|
||||
- .wait()
|
||||
- .expect("Failed to wait make utility")
|
||||
- .success();
|
||||
- if !okay {
|
||||
- eprintln!("Error, make for external C module has failed!");
|
||||
- std::process::exit(1);
|
||||
- }
|
||||
-
|
||||
- println!("cargo:rustc-link-lib=extm");
|
||||
- println!("cargo:rustc-link-search=./extmodule");
|
||||
- println!("cargo:rerun-if-changed=./extmodule/extmodule.h");
|
||||
- println!("cargo:rustc-link-arg-bins=-Wl,-rpath=$ORIGIN");
|
||||
+ // invoke build.rs.sh script instead
|
||||
+ let argv: Vec<String> = std::env::args().skip(1).collect();
|
||||
+ let mut argw: VecDeque<CString> = argv.iter()
|
||||
+ .map(|x| CString::new(x.as_bytes()).unwrap()).collect();
|
||||
+ argw.push_front(CString::new("./build.rs.sh").unwrap());
|
||||
+ let mut argx: Vec<*const c_char> = argw.iter().map(|y| y.as_ptr()).collect();
|
||||
+ argx.push(std::ptr::null());
|
||||
+ unsafe { execv(argx[0], argx.as_mut_ptr()) };
|
||||
+ eprintln!("Error, failed to invoke ./build.rs.sh: {:?}",
|
||||
+ std::io::Error::last_os_error());
|
||||
+ std::process::exit(1);
|
||||
}
|
||||
|
||||
12345678910111213141516171819202122232425262728293031323334353637383940414243444546474849505152535455565758596061626364656667
|
||||
```
|
||||
|
||||
#### 简单的C语言头文件
|
||||
|
||||
以上的编译构建,考虑到了对嵌入式设备支持。主要是在`build.rs`(或`build.rs.sh`)访问`TARGET_CC`/`TARGET_CFLAGS`两个与交叉编译相关的环境变量。不过,值得说明的是,对于简单的C语言头文件(例如笔者编写的`extmodule/extmodule.h`)可以这样转换,但对于复杂的开源库,交叉编译时,因其头文件比较复杂,这种基于`bindgen`的接口转换常常是不可用的。举个例子,对于开源的[paho.mqtt.rust](https://github.com/eclipse/paho.mqtt.rust/tree/master/paho-mqtt-sys/bindings)软件,因其依赖了`paho.mqtt.c`库,在交叉编译时,就会使用该工程自己维护的`bindings`接口代码,而不是使用`bindgen`来转换:
|
||||
|
||||
```Plain Text
|
||||
yejq@ubuntu:~/program/paho.mqtt.rust/paho-mqtt-sys/bindings$ ls -lh
|
||||
total 1.7M
|
||||
-rw-rw-r-- 1 ubuntu ubuntu 267K Jan 25 11:36 bindings_paho_mqtt_c_1.3.12-aarch64-unknown-linux-gnu.rs
|
||||
-rw-rw-r-- 1 ubuntu ubuntu 216K Jan 25 11:36 bindings_paho_mqtt_c_1.3.12-armv7-unknown-linux-gnueabihf.rs
|
||||
-rw-rw-r-- 1 ubuntu ubuntu 216K Jan 25 11:36 bindings_paho_mqtt_c_1.3.12-default-32.rs
|
||||
-rw-rw-r-- 1 ubuntu ubuntu 265K Jan 25 11:36 bindings_paho_mqtt_c_1.3.12-default-64.rs
|
||||
-rw-rw-r-- 1 ubuntu ubuntu 281K Jan 25 11:36 bindings_paho_mqtt_c_1.3.12-x86_64-apple-darwin.rs
|
||||
-rw-rw-r-- 1 ubuntu ubuntu 211K Jan 25 11:36 bindings_paho_mqtt_c_1.3.12-x86_64-pc-windows-msvc.rs
|
||||
-rw-rw-r-- 1 ubuntu ubuntu 265K Jan 25 11:36 bindings_paho_mqtt_c_1.3.12-x86_64-unknown-linux-gnu.rs
|
||||
drwxrwxr-x 2 ubuntu ubuntu 4.0K Jan 25 11:36 old
|
||||
|
||||
12345678910
|
||||
```
|
||||
|
||||
虽然如此,我们在[嵌入式软件](https://so.csdn.net/so/search?q=%E5%B5%8C%E5%85%A5%E5%BC%8F%E8%BD%AF%E4%BB%B6&spm=1001.2101.3001.7020)开发时,可以编写易于转换的C语言头文件,这就需要我们在实际开发中不断调整头文件的编写。
|
||||
|
||||
Some files were not shown because too many files have changed in this diff Show More
Reference in New Issue
Block a user