
21 KiB
最近几个月我们对公司内部的微服务框架进行升级,将我们公司的框架升级到能支持JDK17和Springboot2.7.18的版本(这个是因为3.x太过于割裂,业务升级会非常痛苦,所以我们觉得阶段性升级springboot)
在完成升级之后我需要在公司内部进行一个大范围的分享,借此我将我分享的内容做一个记录
首先让我们来看一下JDK8-->JDK17增加了多少的新特性:
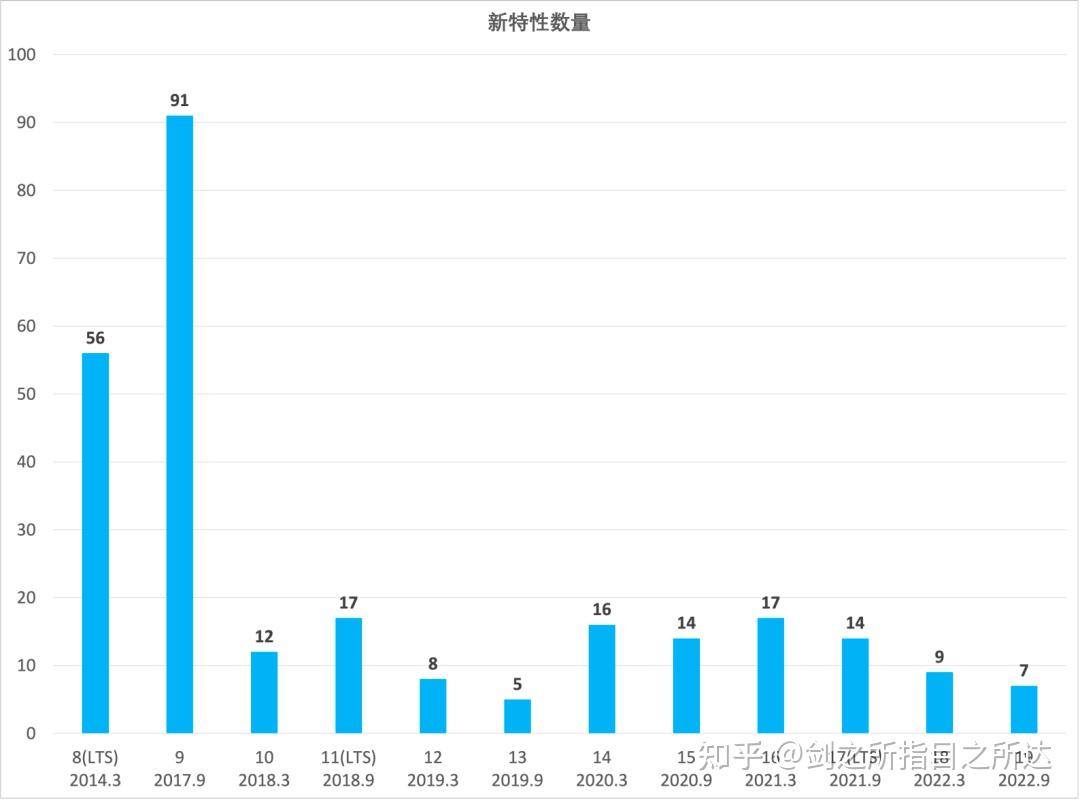
上图显示了自 Java 8 起到 Java 19 各版本新增特性的数量。从 Java 8 到 Java 17 总共引入了超过 234 个新特性.由于jJDK18与19不属于LTS版本,所以这里我们不讨论它.
从这里可以看出除了JDK9 以外,大部分的jdk版本的新特性都大约在10个左右.所以对于大家来说单独升级JDK升级不会有太多的复杂度
下面我们看一下第三方机构(OptaPlanner)对于JDK升级的性能评测:
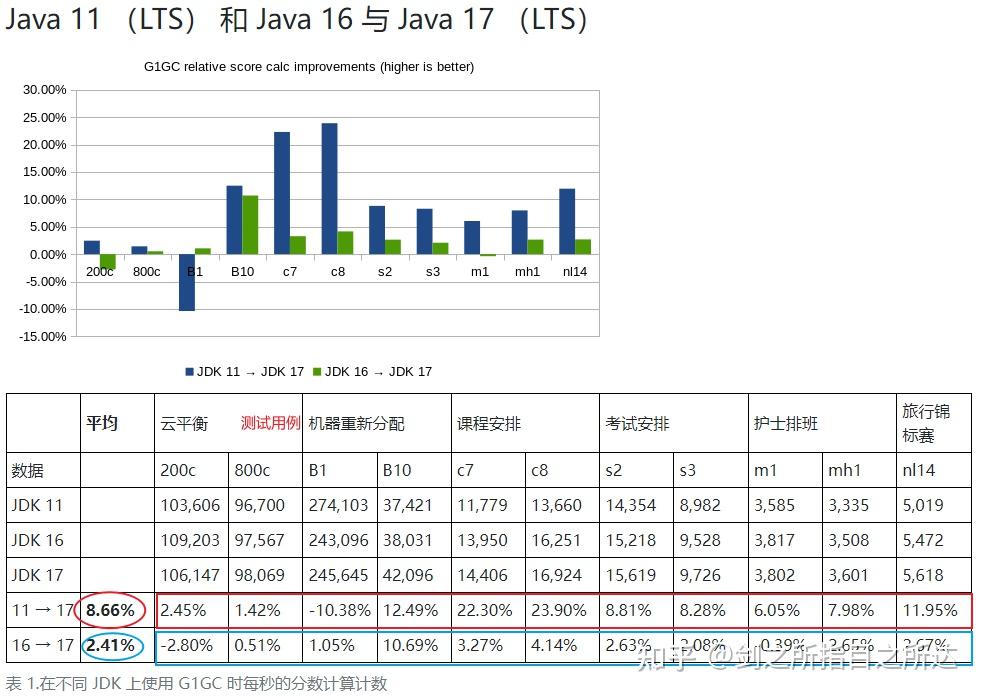
在不同版本的jdk中,使用G1垃圾回收机制,运行相同的测试代码,jdk17的平均性能,比jdk11提升8.66%,比jdk16提升2.41%
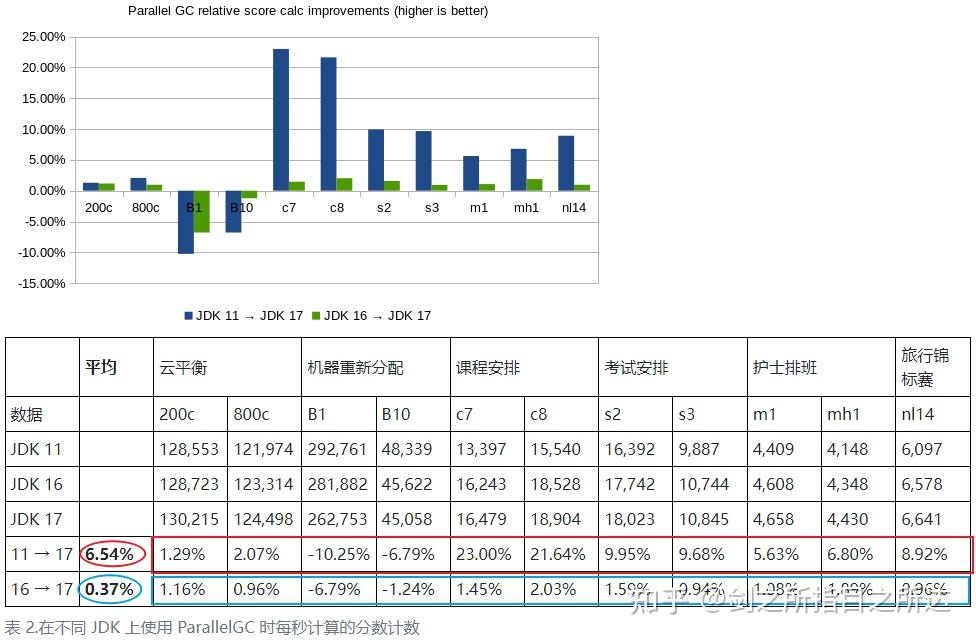
使用parallel垃圾回收机制,运行相同的测试代码,jdk17的平均性能,比jdk11提升6.54%,比jdk16提升0.37%。
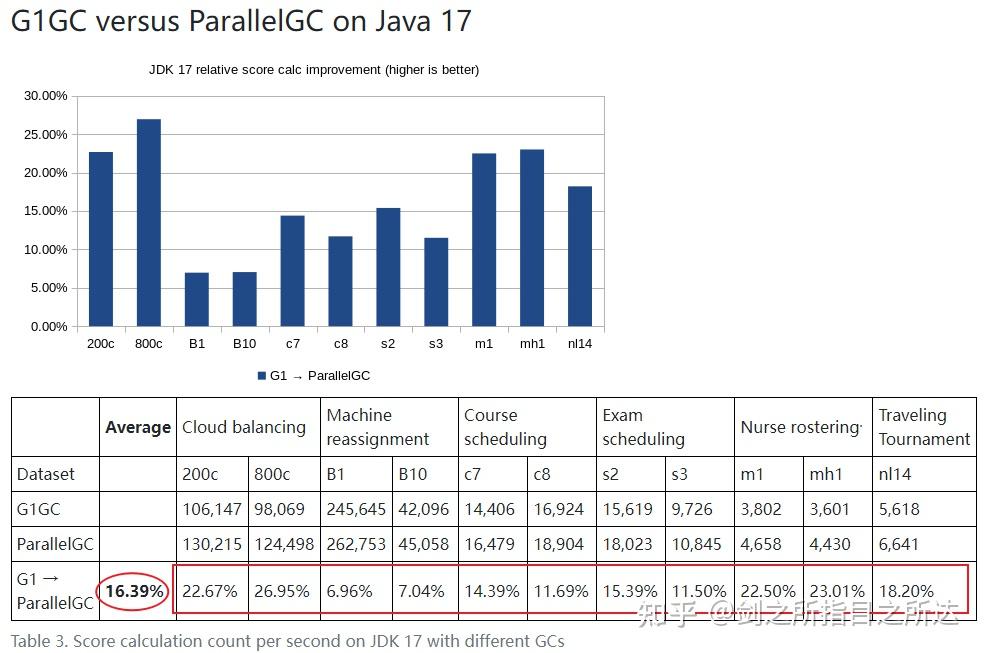
jdk17,分别使用G1垃圾回收机制和Parallel垃圾回收机制,测试结果发现,使用Parallel垃圾回收机制要比G1垃圾回收机制,平均要快16.39%
评测链接:https://www.optaplanner.org/blog/2021/09/15/HowMuchFasterIsJava17.html?utm_source=testingpai.com
本次分享主要分为三个部分 :
- 一个是新的功能特性
- 一个是语法糖的增加与优化
- GC 的改变
新的功能特性
JDK9的模块化:
什么是模块化:
简单理解,Java模块化就是将目前多个包(package)组成一个封装体,这个封装体有它的逻辑含义 ,同时也存在具体实例。和大家平常使用的二方包差不多.
它解决Java平台长期以来存在的一些核心问题,并提高其性能、安全性和可维护性。
- **更好的封装性:**在传统的Java应用中,即使是私有类也可以通过反射被外部访问,这对于保护内部API不被非法访问来说是一个问题。模块化通过引入模块作为一种新的Java程序组件,允许开发者显式地控制哪些包是对外公开的,哪些是模块内部私有的,从而提高了封装性。
- 更小的运行时环境:在模块化之前,Java运行时环境(JRE)是一个庞大的单体,包含了所有的Java标准库。这意味着即使一个简单的程序也需要加载整个JRE(JDK9之前,rt.jar是个巨大的Java运行时类库,大概有60MB左右。JDK9将其拆分成90个模块左右),这对于资源受限的环境(如小型设备或云计算环境)来说是不理想的。通过模块化,可以根据应用程序的实际需要,仅包含必要的模块,从而减小运行时环境的大小。
- 更好的性能:模块化有助于改进JVM的启动时间和运行时性能,因为JVM可以快速定位到需要加载的类和资源,减少了不必要的加载和处理。
- 依赖管理:在模块化系统中,每个模块都需要声明它所依赖的其他模块。这种显式的依赖声明使得依赖管理更加清晰和可控,有助于避免“JAR地狱”(即由于多个版本的JAR文件共存导致的依赖冲突问题)
可以避免NoClassDefFoundError 问题. - 更好的安全性:通过限制对敏感或内部API的访问,模块化有助于提高Java应用的安全性。这使得攻击者更难利用Java平台的内部API进行攻击。
这里应该是代码展示的,关于写法大家自行查找吧!哈哈哈~~~懒狗是这样的!!!
模块化带来的影响
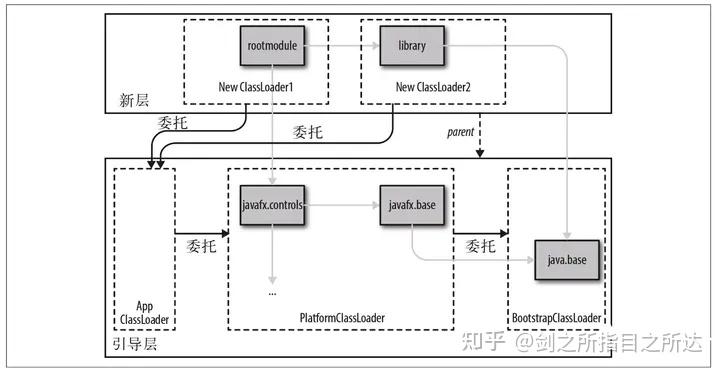
- **默认类加载器的升级 与 双亲委派的部分逻辑破坏
**在JDK 9之前,Java的类和资源是基于类路径(Classpath)来加载的,这是一个线性的搜索路径,由JAR文件和目录组成。类加载器在类路径中按顺序搜索类或资源,直到找到为止。
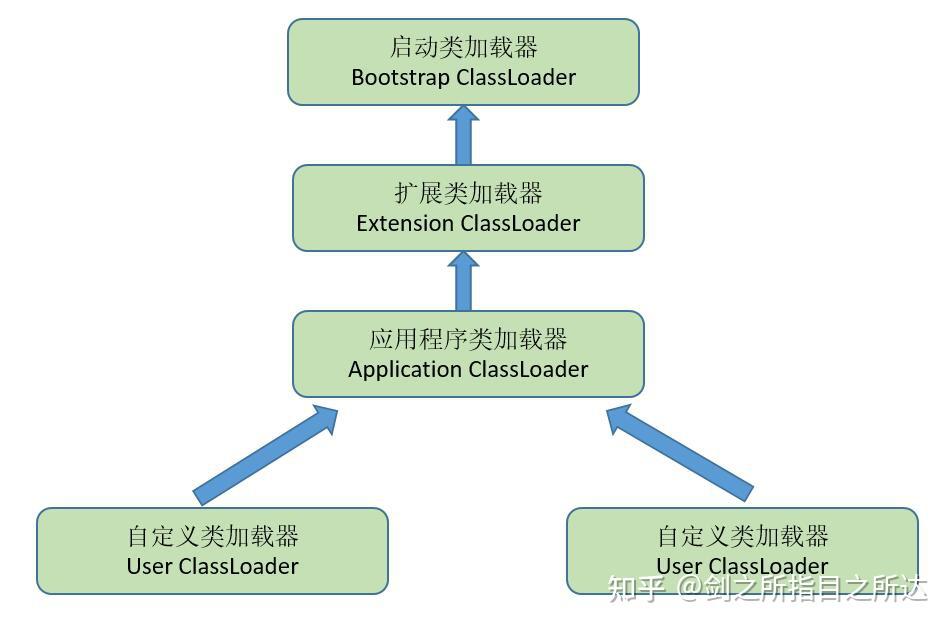
JDK 9引入了模块化系统,增加了一个新的概念:模块路径(Module Path)。模块路径是模块化JAR文件(包含module-info.class的JAR)的集合,每个模块都定义了自己的名称、导出的包和对其他模块的依赖。这意味着类的加载现在不仅需要考虑类的名称,还需要考虑类所在的模块和模块之间的依赖关系。
- 部分反射逻辑被警告
WARNING: An illegal reflective access operation has occurred WARNING: Illegal reflective access by xxx.xxxx.test.demo.AAA to field java.util.Calendar.fields
WARNING: Please consider reporting this to the maintainers of com.jd.jsf.java.util.GregorianCalendar_$$_Template_1798100948_0
WARNING: Use --illegal-access=warn to enable warnings of further illegal reflective access operations WARNING: All illegal access operations will be denied in a future release
通过反射访问JDK模块内类的私有方法或属性,且当前模块并未开放指定类用于反射访问,就会出现以上告警。解决方式也必须使用模块化相关知识,可以使用遵循模块化之间的访问规则,也可以通过设置 –add-opens java.base/java.lang = ALL-UNNNAMED 破坏模块的封装性方式临时解决
JDK14的record与JDK17的封闭类
record
record 是 JDK 14 引入的关键字,用于声明不可变的数据类。它适用于存储纯粹的值类型数据,如接口传输数据、坐标点和只读的日志记录。与 lombok 相比,record 简化了定义纯粹数据类型的过程。由于 record 类是不可变的,成员变量只能设置一次且无法更改,无需提供显式的 setter () 方法。
写法如下:
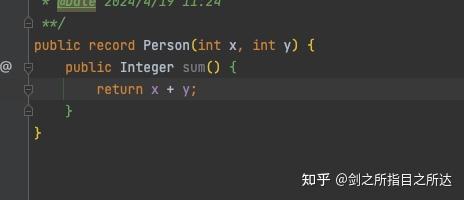
反编译后:
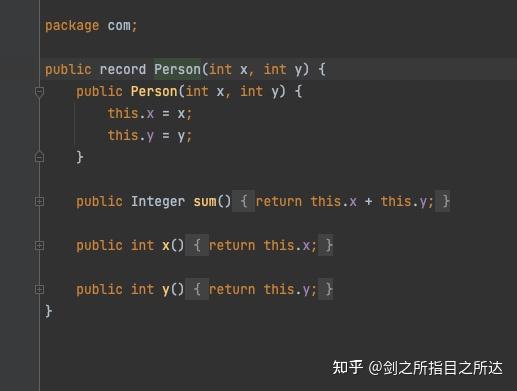
好处:
- 减少样板代码
在引入记录类型之前,定义一个简单的数据载体类需要编写大量的样板代码,包括字段、构造函数、getter方法以及equals()、hashCode()和toString()方法。记录类型自动为所有字段生成这些方法,极大地减少了必须手动编写的代码量。 - 提升代码的可读性和可维护性
- 不可变性
记录类型的实例是不可变的。这意味着一旦实例被创建,它的状态就不能改变。不可变性有助于创建更安全、更易于理解和维护的代码,尤其是在多线程环境中。 - 易于使用
记录类型的语法非常简洁,使得定义新的数据载体类变得非常容易 - 促进函数式编程
记录类型的不可变性和简洁性支持了函数式编程范式。在函数式编程中,不可变数据结构是核心概念之一,记录类型自然而然地融入了这种编程风格
封闭类(Sealed Classes)
对于继承能力的控制,Java很早就已经有一些了,主要是这两种方式:
- final修饰类,这样类就无法被继承了
- package-private类(非public类),可以控制只能被同一个包下的类继承
但很显然,这两种限制方式的粒度都非常粗,如果有更精细化的限制需求的话,是很难实现的
为了进一步增强限制能力,Java 17中的密封类增加了几个重要关键词:
- sealed:修饰类/接口,用来描述这个类/接口为密封类/接口
- non-sealed:修饰类/接口,用来描述这个类/接口为非密封类/接口
- permits:用在extends和implements之后,指定可以继承或实现的类
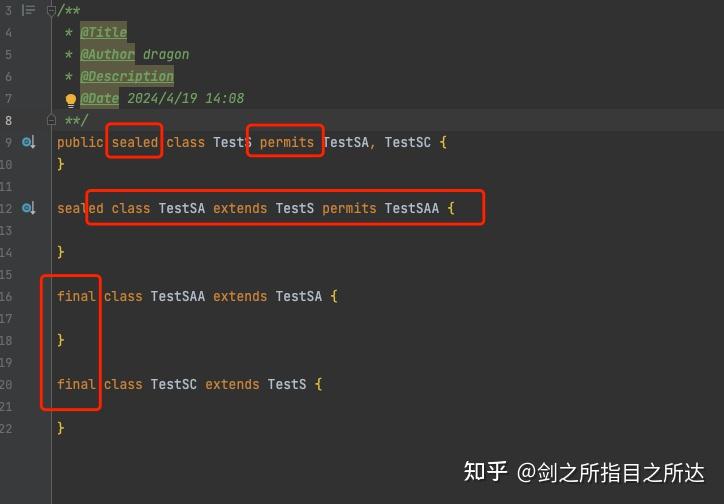
同时这些子类是需要使用final修饰不允许再次继承的
好处:
- 更精准的控制继承
这种精确的控制有助于创建更加安全和可维护的代码库,因为它限制了未经授权的类继承,减少了意外扩展的可能性。 - 增强的模式匹配
封闭类与Java中的模式匹配(如instanceof的模式匹配)结合得很好,使得模式匹配更加强大和表达性更强 - 改进的可读性和可维护性
通过明确指定一个类或接口的所有子类,封闭类提高了代码的可读性和可维护性。开发者和维护者可以轻松地理解类的继承结构 - 促进不变性和线程安全
封闭类通过限制继承,有助于设计不可变的数据结构,这对于创建线程安全的应用程序是非常重要的。
语法糖的增加与优化
(JDK14)文本块与(JDK11)String方法的增强
文本块:
类似于Python和Groovy,方便编写多行的字符串字面量。 Java13中已引入作为预览特性,Java 14中做了改进,引入了两个新的转义序列。可以使用 \s 转义序列来表示一个空格,可以使用反斜杠 \ 来避免在行尾插入换行字符
String text = """

  			"""
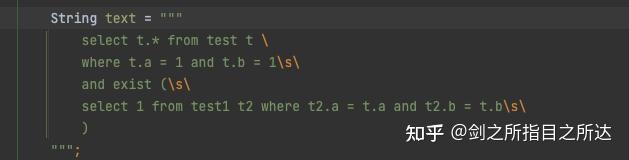
String方法增强:
String str = "woshidage";
boolean isblank = str.isBlank(); //判断字符串是空白
boolean isempty = str.isEmpty(); //判断字符串是否为空
String result1 = str.strip(); //首位空白
String result2 = str.stripTrailing(); //去除尾部空白
String result3 = str.stripLeading(); //去除首部空白
String copyStr = str.repeat(2); //复制几遍字符串
long lineCount = str.lines().count(); //行数统计
(JDK16)instanceof模式匹配 和 (JDK19 )try-with-resource改造
- instanceof模式匹配
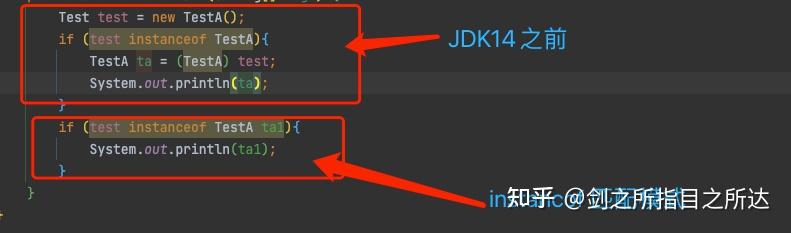
- try-with-resource
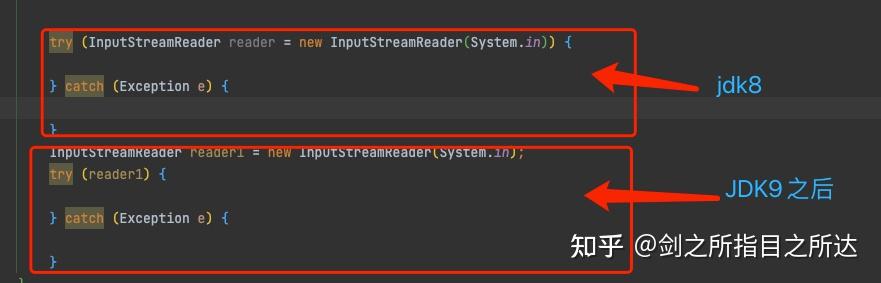
(JDK12)Switch 表达式扩展,可以有返回值
boolean isWeekend = switch (day) {
  case MONDAY, TUESDAY, WEDNESDAY, THURSDAY, FRIDAY -> false;
  case SATURDAY, SUNDAY -> true;
  default -> throw new IllegalStateException("Illegal day entry :: " + day);
};
(JDK10)Var变量
从JDK 10开始,Java引入了var关键字,用于局部变量类型推断。这意味着编译器可以根据变量的初始值自动推断出变量的类型,从而允许开发者在声明局部变量时不必显式指定其类型。使用var不仅可以减少一些冗余的代码,还可以使代码看起来更简洁
使用的基本规则:
- 只能用于局部变量:var只能用于方法内部、构造器内部、初始化块内部或者for循环的局部变量。它不能用于类的成员变量、方法参数或者方法返回类型。
- 必须初始化:使用var声明变量时,必须在声明时初始化变量。这是因为var依赖于变量的初始值来推断变量的类型。
- 单变量声明:每个var声明只能声明一个变量。即,不能用一个var声明来同时声明多个变量。
- 不可用于null值:不能使用var来声明一个初始值为null的变量,因为null没有足够的信息来让编译器推断出具体的类型。
好处:
- 代码更简洁:减少了声明变量时需要的类型冗余,使代码更加简洁易读。
- 提高开发效率:在某些情况下,使用var可以减少编写和维护类型声明的工作量,特别是对于复杂的泛型类型。
- 保持类型安全:尽管使用var不需要显式声明类型,但Java仍然是一种静态类型语言。编译器在编译时会推断出var变量的确切类型,保持了类型安全。
注意事项:
- 可读性:过度使用var可能会降低代码的可读性,特别是当变量的类型不是从右侧的表达式中显而易见时。因此,推荐在类型明显可以从右侧表达式推断出来时使用var。
- 代码维护:在一些情况下,如果初始值的类型改变了,var变量的类型也会随之改变,这可能会导致一些意外的行为。因此,在使用var时需要注意代码的维护和变量类型的预期。
GC 的改变
在JDK8->jdk17中,GC从常用的并行+CMS 升级成了G1 ,而后继续衍生了ZGC,并且G1从11到 17进行更多性能的优化
- CMS:主要用于老年代的垃圾回收。它通过并发标记和并发清除的方式来减少应用程序的停顿时间,适合对响应时间有高要求的应用场景。CMS的主要特点是低停顿时间,但它可能会导致较多的CPU资源占用和内存碎片问题 [1]
- G1:是JDK9开始作为默认GC,替代了之前的Parallel GC和CMS GC。G1通过将堆划分为多个区域(Regions)并优先回收价值最大的区域来减少停顿时间。G1的目标是提供一个平衡了吞吐量和停顿时间的垃圾收集器,适用于需要处理大量内存且要求较短停顿时间的应用
- ZGC:是JDK15正式发布的垃圾回收器,是一种针对减少应用程序停顿时间设计的垃圾收集器,目标是在处理大型堆(数TB级别)时仍能保持低延迟。(染色体技术)ZGC通过并发和大部分工作的并行处理来实现这一目标,几乎消除了垃圾收集过程中的停顿时间。 [2]
G1与ZGC都是标记-复制
G1 的SWT 阶段为 初始标记,再标记,内存清理,复制转移阶段
ZGC的SWT阶段为初始标记,再标记,,初始转移阶段常见GC ROOT:
本地变量和输入参数(栈帧中的局部变量):活动线程的方法调用栈中的局部变量和输入参数。每个线程都有自己的栈,栈帧中的引用对象作为GC Roots。
活动线程(Active Threads):Java程序中的所有活动线程都是GC Roots。这包括Java应用创建的线程以及JVM自身的线程。
静态变量(Static Fields):类的静态字段直接附属于类,而类是由类加载器加载的。因此,所有的静态变量都是GC Roots,因为它们可以从加载它们的类加载器中访问。
常量引用(Constant References):被定义在方法区的常量引用也是GC Roots。例如,字符串常量池中的引用。
JNI引用(JNI References):从本地代码(如C或C++代码)中通过Java本地接口(JNI)访问的对象。这些引用也被视为GCRoots,因为本地代码可能会持有Java对象的引用,这些对象必须被视为活动对象,直到本地代码释放它们。
类加载器(Class Loaders):类加载器本身也是GC Roots。由于类加载器可以加载类,而这些类又可能有静态字段引用其他对象,因此类加载器及其加载的类结构也被视为GC Roots。
JVM内部结构:例如,一些用于JVM内部处理或优化的数据结构,也可能作为GC Roots。
G1 11->17的变化点
-
并行回收改进:G1垃圾收集器在JDK 11之后的版本中继续优化了并行回收的效率。
通过改进线程的利用率和减少同步开销,G1能够更快地完成垃圾回收,从而提高了应用程序的吞吐量。 -
引入了并发线程数的自动调整:为了更好地适应不同的工作负载和硬件配置,G1在后续版本中引入了并发线程数的自动调整机制。
这意味着G1可以根据当前的系统负载动态调整用于垃圾回收的线程数,以达到最佳的回收效率。 -
停顿时间改进
G1本身允许用户指定期望的最大停顿时间(Pause Time Goal),以此来控制垃圾收集(GC)过程中的停顿时间,使之不超过用户设定的阈值。为了实现这一目标,G1收集器采用了一个停顿时间预测模型,该模型负责预测执行特定垃圾收集活动所需的时间。基于这些预测,G1收集器决定在每次GC中应该完成多少工作,以便在清理内存的同时,尽量满足用户设定的停顿时间目标。 -
改进的停顿时间预测模型:G1收集器在JDK 17中进一步改进了其停顿时间预测模型,使得用户设定的停顿时间目标更加准确可靠。这通过更精确地估计回收区域的成本和收益来实现,从而更好地平衡回收工作量与停顿时间目标。
-
更精确的预测算法:改进了预测算法,使其能更准确地估计完成GC所需的时间。这包括更好地理解和预测不同类型的GC活动(如年轻代收集、混合收集)所需的时间。
-
动态调整策略:G1收集器能够根据实际的GC性能和停顿时间目标动态调整其行为。如果发现实际的停顿时间与目标有较大偏差,G1会调整其内部参数,以便在未来的GC活动中更接近用户设定的目标。
-
改进的工作量估计:G1收集器改进了对清理工作量(如回收区域的数量和大小)的估计方法。这使得G1能够更好地决定在达到停顿时间目标的同时,可以完成多少实际的垃圾收集工作。
-
反馈机制:引入了更强的反馈机制,根据前一次GC的表现调整下一次GC的策略。这种自适应调整有助于在应用运行期间不断优化GC性能。
-
增强的卡表处理:G1在处理卡表(用于记录跨代引用的数据结构)时进行了优化,减少了卡表处理对停顿时间的影响,特别是在并发标记阶段。
-
更快的卡表扫描:通过优化卡表的数据结构和扫描算法,减少了在垃圾收集过程中处理卡表所需的时间。
-
并发卡表清理:在早期版本的G1中,卡表的清理可能在某些阶段需要停顿应用线程。增强后的G1可以更多地并发执行卡表清理工作,减少了因卡表处理导致的停顿时间。
-
精确的卡表标记:通过提高卡表标记的精确度,减少了误标(即错误地将某个区域标记为包含跨代引用的情况),从而减少了不必要的垃圾收集工作量。
-
动态卡表调整:G1垃圾收集器可以根据应用程序的实际运行情况动态调整卡表的大小和行为,以达到更好的性能平衡。
-
内存管理增强
字符串去重优化:字符串去重是一种减少Java堆内存使用的技术,通过消除重复的字符串实例来节省空间。从JDK 11到JDK 17,G1收集器对字符串去重机制进行了优化,提高了去重效率和节省了更多的内存。(JDK 8u20开始启用) -
改进的去重逻辑:优化了决定哪些字符串应该被去重的逻辑。通过更精确地分析字符串的使用模式和生命周期,JVM可以更智能地选择去重的目标,从而减少不必要的去重操作,提高去重效率。
-
去重过程的性能优化
-
并发去重:在早期版本中,字符串去重的过程可能会影响垃圾收集的性能。通过优化,使得去重操作更加高效,并尽可能地并发执行,减少对应用程序的影响。
-
减少内存占用:通过优化去重数据结构的内存布局,减少了去重本身对内存的占用。这意味着去重功能不仅可以节省更多的应用内存,而且去重机制本身也变得更加轻量。
-
增强的监控和诊断
-
改进的监控和日志记录:增强了与字符串去重相关的监控和日志记录功能。这使得开发者和运维人员可以更容易地观察去重的效果,评估内存节省量,并调整去重策略。
-
自动化和易用性改进
-
更好的默认行为:在某些版本中,改进了字符串去重的默认行为,使其在默认配置下能够提供更好的内存节省效果,而无需用户进行复杂的配置。
-
Elastic Heap(实验阶段):JDK 17引入的Elastic Heap特性允许Java堆在运行时动态调整大小,这对于云环境和容器环境中的内存管理非常有用。这项特性可以帮助应用根据实际使用情况自动优化堆大小,从而提高资源利用率。
-
对新技术的支持
-
增强的JFR(Java Flight Recorder)集成:G1垃圾收集器在JDK 17中增强了与JFR的集成,提供了更丰富的垃圾收集监控和诊断信息。这使得开发者和运维人员能够更深入地了解G1的行为和性能特点,从而更有效地调优和解决问题。
针对G1的配置我们需要注意:
- 不要轻易限制 年轻代region的大小,默认情况下年轻代最小为5% 最大 60%
G1 GC算法在运行时修改了年轻代的大小,以达到其暂停时间目标。如果显式地定义了年轻代的大小,则将无法达到暂停时间目标。 - -XX:MaxGCPauseMillis=200 我们可以通过这个配置控制我们的 SWT的时间,防止SWT时间过长
- -XX:ParallelGCThreads=n 为SWT时,并发标记的线程数,这里一般 n=核数
- -XX:+ UseStringDeduplication 可以设置消除字符串重复
是一个案例研究,显示了 Spring Boot框架浪费的内存。内存浪费的主要原因之一是字符串的重复。最近的一项研究表明,应用程序内存的13.5%包含重复的字符串。当我们传递“ -XX:+ UseStringDeduplication”参数时,G1 GC提供了消除重复字符串的选项