vault backup: 2026-11-07 16:33:44
This commit is contained in:
 cheney
@@ -0,0 +1,128 @@
|
||||
多租户技术是一种软件架构技术,可以实现多个租户共享系统实例,并且租户间能够实现数据与行为的隔离。传统软件项目一般是指,面向客户开发一套特定的软件系统,并部署在独立的环境中,通常是企业内部环境。
|
||||
|
||||
而SaaS模式,是将软件服务部署到云端环境,可以面向不同的客户提供相同的软件服务。
|
||||
|
||||
![[9825a70efdf865254d3bb6050331a58b_v2-9abd98a64444d6268e1f66b8f99e0ba9_1440w.jpg]]
|
||||
### **SaaS多租户隔离模式**
|
||||
|
||||
对于SaaS模式,多租户间的资源隔离是非常基础的能力,出于成本和运营效率考虑,SaaS服务商需要构建多租户可同时访问软件的环境,不同租户虽然访问同一套SaaS产品服务,但资源访问需要严格隔离开。
|
||||
|
||||
### **SaaS资源隔离包含几个层次:**
|
||||
|
||||
- 第一层是SaaS系统底层所涉及到的计算、存储、网络等资源的隔离。
|
||||
- 第二层是系统基础数据的隔离,主要包括组织,用户,角色,权限,产品能力授权关系等。
|
||||
- 第三层是系统使用过程中,各类业务动态数据的隔离,例如业务单据、操作记录等。
|
||||
|
||||
多租户架构主要是解决第一层的隔离问题,即计算、存储、网络等资源的隔离。为了实现多租户隔离架构,我们先要搞清楚常见的几种多租户隔离模式。
|
||||
|
||||
### **竖井隔离模式**
|
||||
|
||||
|
||||
|
||||
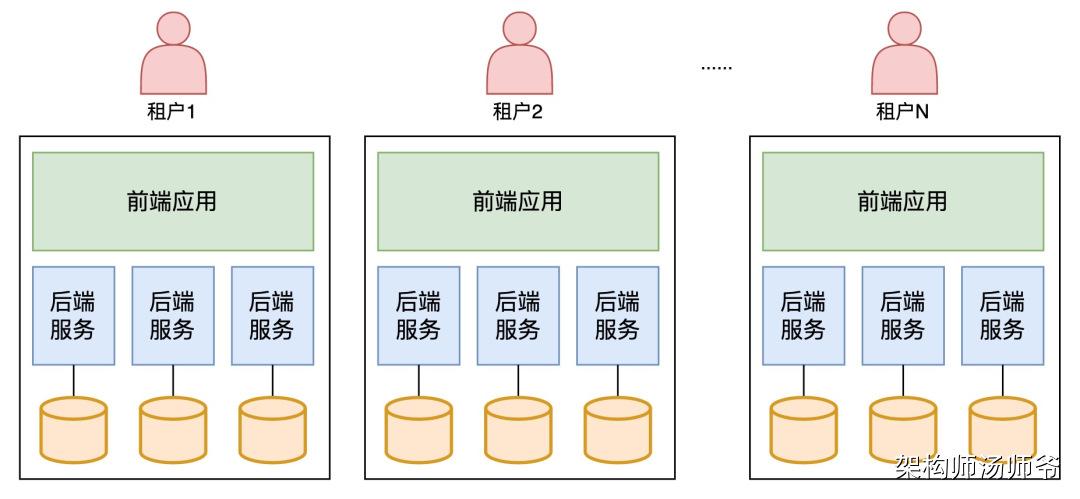
有些SaaS服务商会选择竖井隔离模式,即每个租户都运行在隔离的一套资源中。有人会说,这不就是传统软件模式吗,为什么会是SaaS模式呢?但如果这些竖井式的资源,拥有标准化的租户身份识别、入驻流程、计费体系、部署流程、运营流程,那边它依然是SaaS模式,只不过每个客户都有一套端到端的基础设施。
|
||||
|
||||
### **优势**
|
||||
|
||||
- 满足强隔离需求:一些客户为了系统和数据的安全性,可能提出非常严格的隔离需求,期望软件产品能够部署在一套完全独立的环境中,不和其他租户的应用实例、数据放在一起。
|
||||
- 计费逻辑简单:SaaS服务商需要针对租户使用资源进行计费,对于复杂的业务场景,计算、存储、网络资源间的关系同样也会非常复杂,计费模型是很有挑战的,但在竖井模式下,计费模型相对来说是比较简单的。
|
||||
- 降低故障影响面:因为每个客户的系统都部署在自己的环境中,如果其中一个环境出现故障,并不会影响其他客户使用软件服务。
|
||||
|
||||
### **劣势**
|
||||
|
||||
- 规模化问题:由于租户的SaaS环境是独立的,所以每入驻一个租户,就需要创建和运营一套SaaS环境,如果只是少量的租户,还可能可以管理,但如果是成千上万的租户,管理和运营这些环境将会是非常大的挑战。
|
||||
- 成本问题:每个租户都有独立的环境,花费在单个客户上的成本将非常高,会大幅削弱SaaS软件服务的盈利能力。
|
||||
- 敏捷迭代问题:SaaS模式的一个优势是能够快速响应市场需求,迭代产品功能。但竖井隔离策略会阻碍这种敏捷迭代能力,因为更新、管理、支撑这些租户的SaaS环境,会变得非常复杂和低效。
|
||||
- 系统管理与监控:在同一套环境中,对部署的基础设施进行管理与监控,是较为简单的。但每个租户都有独立的环境,在这种非中心化的模式下,对每个租户的基础设施进行管理与监控,同样也是非常复杂、困难的。
|
||||
|
||||
### **共享模式**
|
||||
|
||||
|
||||
|
||||
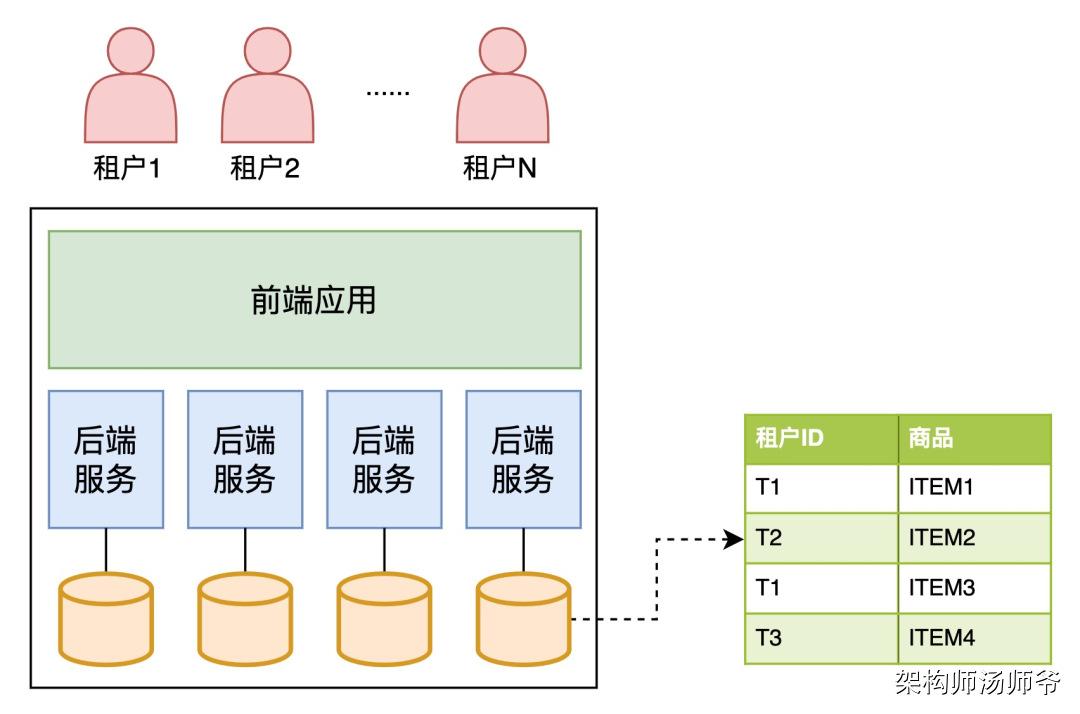
相信很多SaaS服务商会优先选择共享模式,即多租户共享一套基础设施资源,这样能让SaaS软件服务更加高效、敏捷、低成本。
|
||||
|
||||
### **优势**
|
||||
|
||||
- 高效管理:在共享策略下,能够集中化地管理、运营所有租户,管理效率非常高。同时,对基础设施配置管理、监控,也将更加容易。相比竖井策略,产品的迭代更新会更快。
|
||||
- 成本低:SaaS服务商的成本结构中,很大一块是基础设施的成本。在共享模型下,服务商可以根据租户们的实际资源负载情况,动态伸缩系统,这样基础设施的利用率将非常高。
|
||||
|
||||
### **劣势**
|
||||
|
||||
- 租户相互影响:由于所有租户共享一套资源,当其中一个租户大量占用机器资源,其他租户的使用体验很可能受到影响,在这种场景下,需要在技术架构上设计一些限制措施(限流、降级、服务器隔离等),让影响面可控。
|
||||
- 租户计费困难:在竖井模型下,非常容易统计租户的资源消耗。然而,在共享模型下,由于所有租户共享一套资源,需要投入更多的精力统计单个租户的合理费用。
|
||||
|
||||
### **分域隔离模式**
|
||||
|
||||
|
||||
|
||||
传统大企业更喜欢私有化部署、个性化交付的传统模式,因为他们需要更强的管控和更高的安全性。然而,中小企业付费能力有限,需求往往也更加标准化,所以更喜欢价格更低的、订购更简单的SaaS产品。
|
||||
|
||||
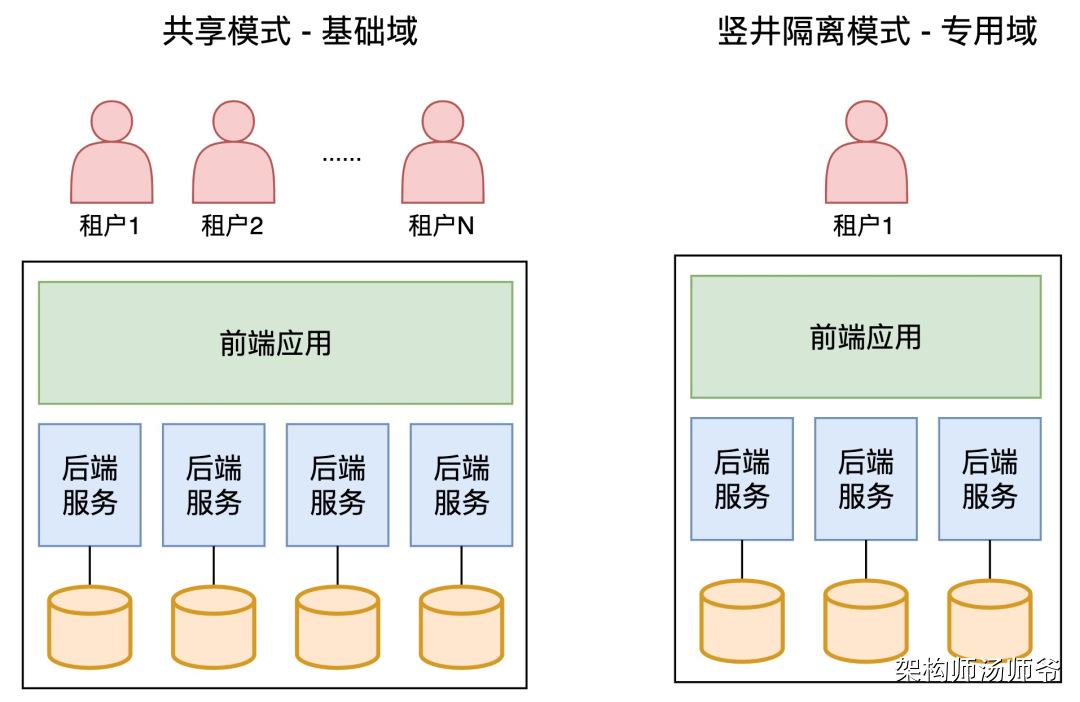
为了满足不同客户的需求,还有一种混合了竖井模型与共享模型的模式,即分域隔离模式。在该模式下,会细分基础域、专用域,基础域是使用共享模型,所有租户共享一套资源;而专用域是使用竖井模型,每个租户都有独立的资源环境。
|
||||
|
||||
对于大多数中小客户来说,他们都是在基础域环境使用SaaS产品,只有少量的大客户会在专用域使用SaaS产品,通常他们付费能力强,有强烈的强隔离需求。
|
||||
|
||||
但需要注意的是,为了避免多套产品版本出现,SaaS服务商需要保证基础域、专用域的产品版本一致,个性化的部分尽可能通过构建PaaS平台,让ISV参与建设。否则,一旦SaaS产品的标准化程度降低,后续各版本的维护将变成灾难。
|
||||
|
||||
### **多租户系统的定位**
|
||||
|
||||
了解各种多租户隔离模式后,我们来总结下多租户系统的定位。
|
||||
|
||||
多租户系统是为了满足多用户使用一套产品,并实现用户间的数据与行为隔离,但根据用户需求不同,可以共享或隔离软硬件资源,系统架构上能够灵活支持多种隔离模式。
|
||||
|
||||
### **多租户系统需要具备的能力**
|
||||
|
||||
- 多个租户支持共享一套云资源,如计算、存储、网络资源等。单个租户也可以独占一套云资源。
|
||||
- 多个租户间能够实现数据与行为的隔离,能够对租户进行分权分域控制。
|
||||
- 租户内部能够支持基于组织架构的管理,可以对产品能力进行授权和管理。
|
||||
- 不同的产品能力可以根据客户需求,支持运行在不同的云资源上。
|
||||
|
||||
### **多租户概念模型**
|
||||
|
||||
### **多租户核心概念**
|
||||
|
||||
- 租户:一般指一个企业客户或个人客户,租户之间数据与行为是隔离的。
|
||||
- 用户:在某个租户内的具体使用者,可以通过使用账户名、密码等登录信息,登录到SaaS系统使用软件服务。
|
||||
- 组织:如果租户是一个企业客户,通常会拥有自己的组织架构。
|
||||
- 员工:是指组织内部具体的某位员工。
|
||||
- 解决方案:为了解决客户的某类型业务问题,SaaS服务商将产品与服务组合在一起,为商家提供整体的打包方案。
|
||||
- 产品能力:指的是SaaS服务商对客户售卖的产品应用,特指能够帮助客户实现端到端场景解决方案闭环的能力。
|
||||
- 资源域:用来运行1个或多个产品应用的一套云资源环境。
|
||||
- 云资源:SaaS产品一般都部署在各种云平台上,例如阿里云、腾讯云、华为云等。对这些云平台提供的计算、存储、网络、容器等资源,抽象为云资源。
|
||||
|
||||
### **概念模型设计**
|
||||
|
||||
|
||||
|
||||
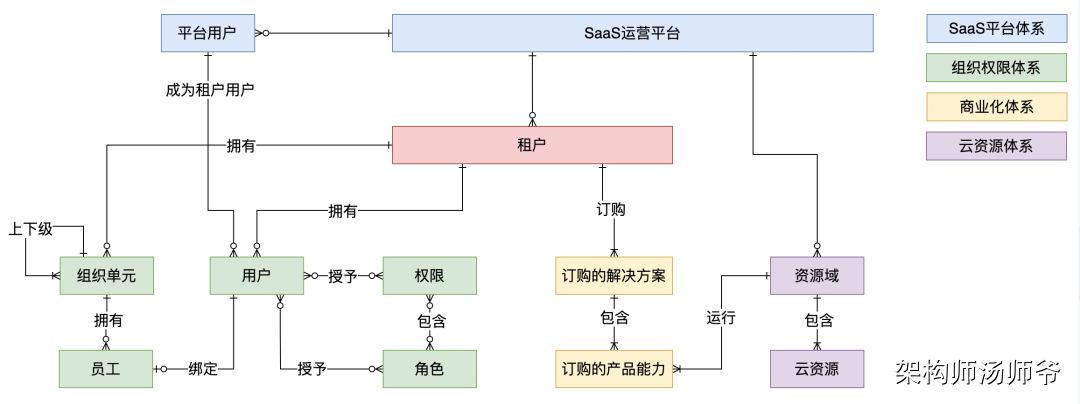
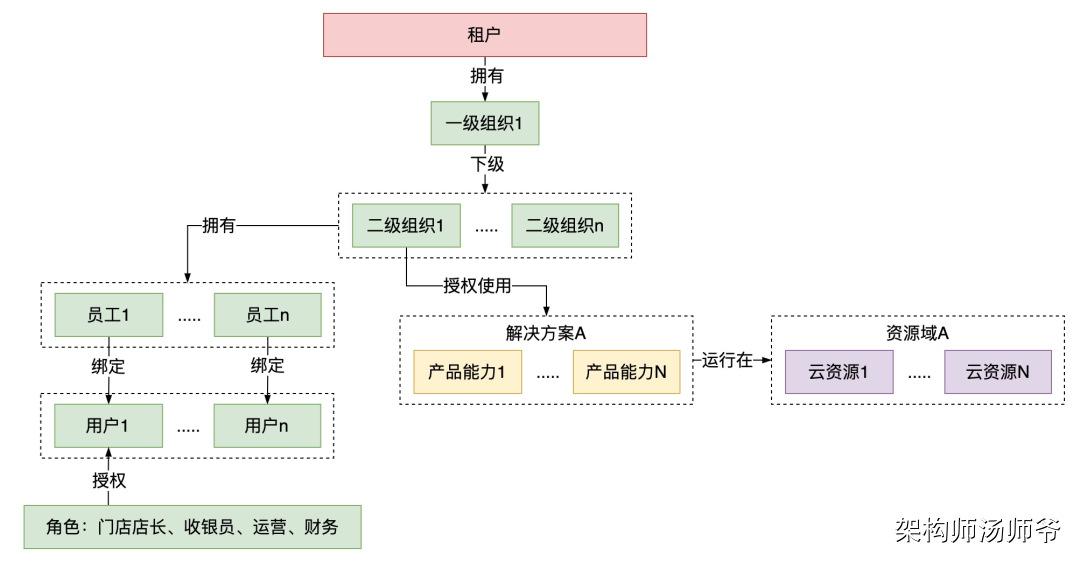
- SaaS平台可以创建与管理多个平台用户、多个租户、多个资源域。
|
||||
- 单个平台用户可以关联到多个租户下,例如,平台用户张三,可以是租户A的用户,也可以是租户B的用户。单个租户下可以拥有多个用户。
|
||||
- 单个租户可以订购多个解决方案,解决方案可以包多个产品能力,产品能力运行在某个资源域上。
|
||||
- 组织单元间有上下级关系,单个组织下可以有多个员工,员工与单个用户进行绑定。
|
||||
|
||||
### **多租户核心场景**
|
||||
|
||||
### **租户内部模型关系**
|
||||
|
||||
对SaaS产品来说,租户是最顶层的概念,租户内部拥有组织、用户、产品能力、云资源等模型,租户就像租了一套大房子,其他模型都是房子内部的家具或设施。
|
||||
|
||||
|
||||
|
||||
### **租户身份识别**
|
||||
|
||||
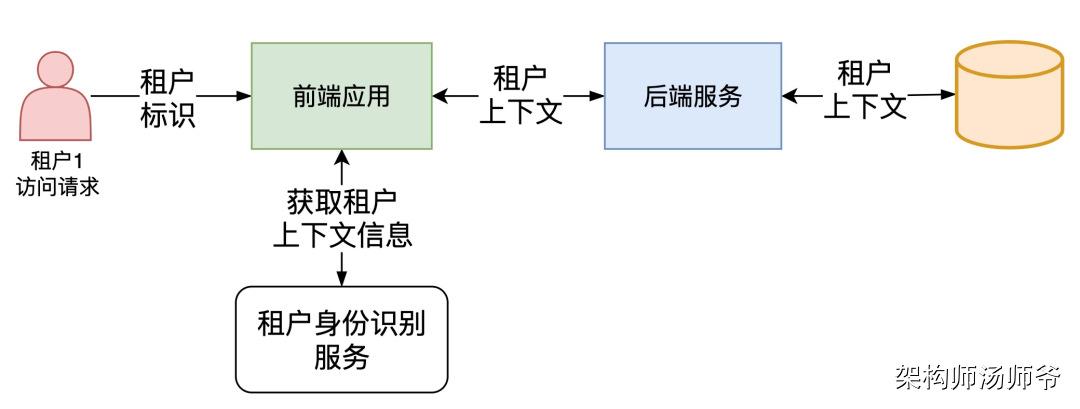
在各种隔离模式下,识别租户身份,获取租户的资源配置,是非常关键的。当一个用户登录SaaS系统后,系统会返回租户上下文信息,上下文会包含用户绑定的租户信息,以及隔离模式。
|
||||
|
||||
租户上下文信息会被附加在每一次系统交互中,贯穿整个系统调用链路,让上游调用方知道路由到哪些下游资源。
|
||||
|
||||
|
||||
|
||||
### **租户计费计量管理**
|
||||
|
||||
在竖井隔离模式下,由于资源本身就是隔离的,所以可以根据占用的计算、存储、网络资源来计费计量,逻辑相对简单。
|
||||
|
||||
在共享模式下,计费计量就比较复杂,我们要能准确地采集到各个租户对实际资源的使用情况,一般会根据请求并发量、存储容量、数据对象数量等数据来进行组合计费。
|
||||
|
||||
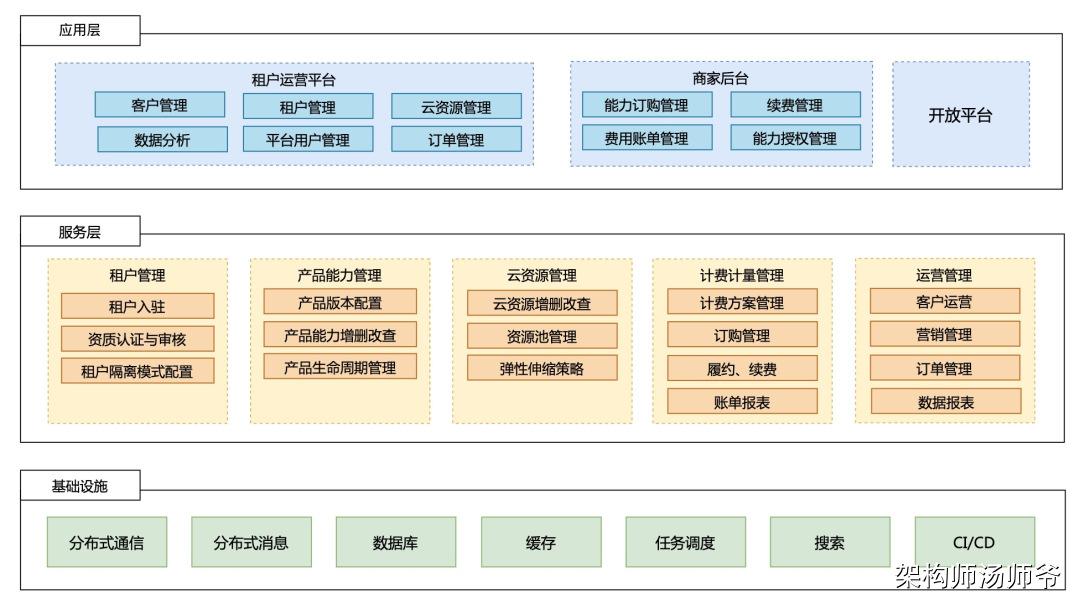
### **多租户系统应用架构**
|
||||
|
||||
|
||||
|
||||
### **总结**
|
||||
|
||||
本文首先介绍了什么是多租户,对比传统软件模式与SaaS模式的区别。通过分析多租户的三种隔离模式,逐步梳理出多租户的系统架构设计,包括概念模型、场景推演、应用架构等。期望对读者有帮助,有问题欢迎随时交流。
|
||||
@@ -0,0 +1 @@
|
||||
TCP_NODELAY 来禁用 Nagle 算法。
|
||||

Binary file not shown.
|
After Width: | Height: | Size: 465 KiB |
@@ -0,0 +1,196 @@
|
||||
Zig 的“统一编译”理念和内置的跨平台支持,让它在这个领域表现出色。结合 Docker 可以保证环境的一致性和可复现性。
|
||||
|
||||
下面我将为你梳理需要了解的核心概念和基础知识,并提供一个完整的 Docker 化工作流。
|
||||
|
||||
### 第一部分:核心概念与 Zig 基础知识
|
||||
|
||||
#### 1. Zig 的“统一编译”理念
|
||||
这是 Zig 最核心的竞争力之一。它意味着:
|
||||
* **单一编译器:** 你只需要安装一个 Zig 编译器和对应的标准库源码,就可以为任何支持的目标平台进行编译。无需安装多个交叉编译工具链。
|
||||
* **目标三元组:** Zig 使用 `-target` 参数来指定编译目标。格式为:`cpu-arch-vendor-os-abi`。
|
||||
* 例如:`x86_64-linux-gnu`, `aarch64-macos-none`, `wasm32-freestanding`。
|
||||
* **内置标准库:** Zig 编译器内置了所有目标平台的 C 标准库(如 glibc, musl, libc++ 等)的源码,并在编译时按需链接。这确保了编译结果的确定性和可复现性。
|
||||
|
||||
#### 2. Zig 构建系统的核心:`build.zig`
|
||||
Zig 使用一个用 Zig 语言编写的 `build.zig` 文件来定义构建规则,而不是 Makefile 或 CMakeLists.txt。
|
||||
* **运行方式:** `zig build` 命令会读取当前目录的 `build.zig` 文件。
|
||||
* **核心对象:**
|
||||
* `std.Build`:构建系统的主要对象,提供了创建编译步骤的方法。
|
||||
* `*std.Build.Step.Compile`:代表一个可执行文件、静态库或动态库的编译步骤。
|
||||
* `*std.Build.Step`:代表一个构建步骤(如运行命令、安装文件等)。
|
||||
* **基本结构:**
|
||||
```zig
|
||||
// build.zig
|
||||
const std = @import("std");
|
||||
|
||||
pub fn build(b: *std.Build) void {
|
||||
// 标准构建选项
|
||||
const target = b.standardTargetOptions(.{});
|
||||
const optimize = b.standardOptimizeOption(.{});
|
||||
|
||||
// 定义一个可执行文件
|
||||
const exe = b.addExecutable(.{
|
||||
.name = "my_app",
|
||||
.root_source_file = .{ .path = "src/main.zig" },
|
||||
.target = target,
|
||||
.optimize = optimize,
|
||||
});
|
||||
|
||||
// 这将创建一个 `zig build install` 步骤,将可执行文件安装到 `zig-out/bin/`
|
||||
b.installArtifact(exe);
|
||||
|
||||
// 定义一个运行测试的步骤
|
||||
const exe_tests = b.addTest(.{
|
||||
.root_source_file = .{ .path = "src/main.zig" },
|
||||
.target = target,
|
||||
.optimize = optimize,
|
||||
});
|
||||
const run_exe_tests = b.addRunArtifact(exe_tests);
|
||||
|
||||
// 创建一个 `zig build test` 步骤来运行测试
|
||||
const test_step = b.step("test", "Run unit tests");
|
||||
test_step.dependOn(&run_exe_tests.step);
|
||||
}
|
||||
```
|
||||
|
||||
#### 3. 交叉编译的关键:`std.Build.installArtifact`
|
||||
在 `build.zig` 中,`b.installArtifact(exe)` 是核心。它告诉构建系统:“我想要生成这个可执行文件,并把它安装到标准输出目录(通常是 `zig-out/bin/`)”。
|
||||
|
||||
当你运行 `zig build -Dtarget=<target_triple>` 时,构建系统会自动处理所有交叉编译的细节,并将对应平台的可执行文件安装到 `zig-out/bin/`。
|
||||
|
||||
#### 4. WebAssembly 的特殊性
|
||||
对于 WASM,目标通常是 `wasm32-freestanding`。
|
||||
* **Freestanding:** 表示没有操作系统。WASM 模块运行在沙箱环境中。
|
||||
* **导出函数:** 你需要使用 `export` 关键字来导出希望 JavaScript 能够调用的函数。
|
||||
```zig
|
||||
// math.zig
|
||||
export fn add(a: i32, b: i32) i32 {
|
||||
return a + b;
|
||||
}
|
||||
```
|
||||
* **构建配置:** 在 `build.zig` 中,你需要创建一个**静态库**而不是可执行文件,因为 WASM 模块本质上是库。
|
||||
```zig
|
||||
const wasm_lib = b.addStaticLibrary(.{
|
||||
.name = "math",
|
||||
.root_source_file = .{ .path = "src/math.zig" },
|
||||
.target = b.resolveTargetQuery(.{
|
||||
.cpu_arch = .wasm32,
|
||||
.os_tag = .freestanding,
|
||||
}),
|
||||
.optimize = optimize,
|
||||
});
|
||||
// 重要:设置链接模式
|
||||
wasm_lib.override_libc = null; // 我们不链接 libc
|
||||
wasm_lib.rdynamic = true; // 确保所有符号都被导出
|
||||
|
||||
b.installArtifact(wasm_lib); // 会生成 zig-out/lib/math.wasm
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
### 第二部分:Docker 环境下的工作流
|
||||
|
||||
使用 Docker 可以固化构建环境,确保任何人、任何机器上都能得到完全相同的编译结果。
|
||||
|
||||
#### 1. 创建 Dockerfile
|
||||
这个 Dockerfile 会安装 Zig 编译器并设置工作目录。
|
||||
|
||||
```dockerfile
|
||||
# Dockerfile
|
||||
# 选择一个轻量级的基础镜像
|
||||
FROM alpine:latest AS zig-builder
|
||||
|
||||
# 安装依赖(Alpine 使用 musl libc,非常轻量)
|
||||
RUN apk add --no-cache xz tar
|
||||
|
||||
# 设置工作目录
|
||||
WORKDIR /workspace
|
||||
|
||||
# 从官方地址下载并安装 Zig
|
||||
# 请替换为最新的稳定版本,可从 https://ziglang.org/download/ 获取
|
||||
ARG ZIG_VERSION=0.12.0
|
||||
ARG ZIG_ARCH=x86_64-linux
|
||||
RUN wget https://ziglang.org/builds/zig-${ZIG_ARCH}-${ZIG_VERSION}.tar.xz && \
|
||||
tar -xf zig-${ZIG_ARCH}-${ZIG_VERSION}.tar.xz && \
|
||||
rm zig-${ZIG_ARCH}-${ZIG_VERSION}.tar.xz
|
||||
|
||||
# 将 Zig 二进制文件路径添加到 PATH
|
||||
ENV PATH="/workspace/zig-${ZIG_ARCH}-${ZIG_VERSION}:${PATH}"
|
||||
|
||||
# 验证安装
|
||||
RUN zig version
|
||||
|
||||
# 设置默认命令
|
||||
CMD ["/bin/sh"]
|
||||
```
|
||||
|
||||
#### 2. 创建 docker-compose.yml(推荐)
|
||||
使用 Docker Compose 可以更方便地管理构建命令和卷映射。
|
||||
|
||||
```yaml
|
||||
# docker-compose.yml
|
||||
version: '3.8'
|
||||
|
||||
services:
|
||||
zig-build:
|
||||
build:
|
||||
context: .
|
||||
dockerfile: Dockerfile
|
||||
volumes:
|
||||
# 将宿主机的当前目录挂载到容器的 /workspace
|
||||
- .:/workspace
|
||||
working_dir: /workspace
|
||||
# 默认命令,可以覆盖
|
||||
command: zig build --help
|
||||
```
|
||||
|
||||
#### 3. 项目目录结构
|
||||
```
|
||||
my-zig-project/
|
||||
├── Dockerfile
|
||||
├── docker-compose.yml
|
||||
├── build.zig
|
||||
├── src/
|
||||
│ └── main.zig
|
||||
└── zig-out/ (由 zig build 自动生成)
|
||||
```
|
||||
|
||||
#### 4. 完整的构建命令示例
|
||||
|
||||
假设你的 `build.zig` 已经配置好,并且定义了名为 `my_app` 的可执行文件。
|
||||
|
||||
1. **构建 Docker 镜像:**
|
||||
```bash
|
||||
docker-compose build
|
||||
```
|
||||
|
||||
2. **编译 Linux x86_64 版本:**
|
||||
```bash
|
||||
docker-compose run zig-build zig build -Dtarget=x86_64-linux-musl -Doptimize=ReleaseSafe
|
||||
```
|
||||
完成后,在宿主机的 `zig-out/bin/` 目录下会找到 `my_app`。
|
||||
|
||||
3. **编译 Windows x86_64 版本:**
|
||||
```bash
|
||||
docker-compose run zig-build zig build -Dtarget=x86_64-windows-gnu -Doptimize=ReleaseSafe
|
||||
```
|
||||
完成后,在宿主机的 `zig-out/bin/` 目录下会找到 `my_app.exe`。
|
||||
|
||||
4. **编译 WebAssembly:**
|
||||
假设你的 `build.zig` 中已经定义了 `wasm_lib`。
|
||||
```bash
|
||||
# 这个命令会运行 build.zig 中定义的安装步骤,生成 .wasm 文件
|
||||
docker-compose run zig-build zig build -Doptimize=ReleaseSmall
|
||||
# 或者,如果你为 wasm 定义了一个特定的构建步骤(例如 b.step("wasm", "Build WASM")),你可以运行:
|
||||
# docker-compose run zig-build zig build wasm
|
||||
```
|
||||
完成后,在宿主机的 `zig-out/lib/` 目录下会找到 `math.wasm`。
|
||||
|
||||
### 总结
|
||||
|
||||
1. **核心概念:** 理解 Zig 的**目标三元组**和基于 `build.zig` 的**构建系统**。
|
||||
2. **WASM 要点:** 使用 `wasm32-freestanding` 目标,创建**静态库**,并使用 `export` 导出函数。
|
||||
3. **Docker 化:** 使用 Dockerfile 固化 Zig 编译环境,使用 Docker Compose 简化构建命令的执行。
|
||||
4. **工作流:** 通过 `docker-compose run zig-build zig build -Dtarget=...` 来为不同平台交叉编译。
|
||||
|
||||
这个组合(Zig + Docker)为你提供了一个极其强大、一致且可移植的跨平台编译环境,无论是用于本地开发、CI/CD 流水线,还是为团队统一构建环境,都非常高效。
|
||||
@@ -0,0 +1,114 @@
|
||||
|
||||
## 摘要
|
||||
|
||||
试验由安装了docker的A、B两台电脑完成,在两台电脑上创建docker桥接网络然后依托于网桥在每台电脑中运行一个docker容器,并在容器中安装 keepalived组件,最后采用断网的方式测试虚拟ip的漂移情况。
|
||||
|
||||
#### (1)软件环境:
|
||||
|
||||
- 宿主机系统:centos7
|
||||
- docker 版本:19.03.0
|
||||
- 镜像版本:centos:7
|
||||
- keepalived版本:2.0.7
|
||||
|
||||
#### (2)逻辑环境:
|
||||
|
||||
| | | | |
|
||||
|---|---|---|---|
|
||||
|宿主机名|宿主机IP|容器IP|虚拟IP|
|
||||
|宿主机1|192.168.234.130|192.168.234.132|192.168.234.140|
|
||||
|宿主机2|192.168.234.131|192.168.23|
|
||||
|
||||

|
||||
|
||||
## 安装步骤
|
||||
|
||||
以宿主机1安装步骤为例讲解试验的安装过程
|
||||
|
||||
#### (1)创建网络和容器
|
||||
|
||||
**创建网络**
|
||||
|
||||
docker有**bridge、host、container、none**四种网络模式,其中**bridge**是dokcer网络的默认设置。安装完docker,系统会自动添加一个供docker使用的网桥docker0,我们创建一个新的容器时,容器通过DHCP获取一个与docker0同网段的IP地址。并默认连接到docker0网桥,以此实现容器与宿主机的网络互通。但默认**bridge**网络的IP是172段的,而我们通常需要docker容器可以和局域网中其他机器相互访问,因此我们需要创建指定IP段的自定义**bridge。**
|
||||
|
||||
> docker network create -d macvlan --subnet=192.168.234.0/24 --gateway=192.168.234.2 -o parent=ens33 mynet
|
||||
|
||||
- -d 指定 Docker 网络 driver 为macvlan
|
||||
- --subnet 指定 macvlan 网络所在的网络段
|
||||
- --gateway 指定网关
|
||||
- -o parent 指定用来分配 macvlan 网络的物理网卡
|
||||
|
||||
**创建容器**
|
||||
|
||||
> docker run -itd --privileged=true --name test --net mynet --ip 192.168.234.132 centos:7 /bin/bash
|
||||
|
||||
- **-i** 打开STDIN,用于控制台交互
|
||||
- **-t** 分配tty设备,该可以支持终端登录,默认为false
|
||||
- **-d** 让容器在后台运行
|
||||
- **--privileged** 特权模式(默认关闭),用于容器启动后台服务
|
||||
- **--net** 指定容器网络
|
||||
- **--ip** 指定容器IP
|
||||
|
||||
**进入容器**
|
||||
|
||||
> docker exec -it test sh
|
||||
|
||||
#### (2)安装依赖包
|
||||
|
||||
> yum install -y curl gcc openssl openssl-devel libnl libnl-devel libnfnetlink-devel
|
||||
|
||||
#### (3)安装依赖命令
|
||||
|
||||
> # 安装make编译命令
|
||||
>
|
||||
> **yum -y install cmake**
|
||||
>
|
||||
> # 安装ifconfig命令
|
||||
>
|
||||
> **yum -y install net-tools**
|
||||
>
|
||||
> # 安装wget命令
|
||||
>
|
||||
> **yum -y install wget**
|
||||
|
||||
#### **(4)安装keepalived**
|
||||
|
||||
```cobol
|
||||
#下载安装包 wget http://www.keepalived.org/software/keepalived-2.0.7.tar.gz # 解压缩 tar xvf keepalived-2.0.7.tar.gz cd keepalived-2.0.7 # 设置编译位置 ./configure --prefix=/usr/local/keepalived --sysconf=/etc # 编译安装 make && make install # 将keepalived主程序加入到环境变量 cp /usr/local/keepalived/sbin/keepalived /usr/sbin/keepalived # keepalived启动脚本(源码目录下),放到/etc/init.d/目录下就可以使用service命令便捷调用 cp /usr/local/keepalived-2.0.7/keepalived/etc/init.d/keepalived /etc/init.d/keepalived
|
||||
```
|
||||
|
||||
#### (5)**配置keepalived.conf**
|
||||
|
||||
**vi /etc/keepalived/keepalived.conf**
|
||||
|
||||
```cobol
|
||||
global_defs { notification_email { …… } … vrrp_strict # 此配置注释掉后外界才能ping通虚拟IP ……} vrrp_instance VI_1 { state MASTER #主从标识MASTER/BACKUP interface ens33 # 网卡 virtual_router_id 51 #路由ID主从必须一致 priority 101 # 权重用于选举 advert_int 1 # 1代表1秒检查一次 authentication { auth_type PASS auth_pass 1111 } virtual_ipaddress { 192.168.234.140 # 虚拟IP }}
|
||||
```
|
||||
|
||||
#### **(6)配置启动命令**
|
||||
|
||||
> # 安装service命令
|
||||
> **yum install initscripts -y**
|
||||
> # 添加service 命令
|
||||
> **chkconfig --add keepalived**
|
||||
|
||||
#### **(7)启动keepalived**
|
||||
|
||||
> # 启动服务
|
||||
> **service keepalived start|stop**
|
||||
|
||||
```cobol
|
||||
sh-4.2# service keepalived startFailed to get D-Bus connection: Operation not permitted Starting keepalived: [ ok ]
|
||||
```
|
||||
|
||||
> # 查看虚拟ip命令
|
||||
> **ip addr show eth0**
|
||||
|
||||
```cobol
|
||||
sh-4.2# ip addr show eth021: eth0@if2: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP group default link/ether 02:42:c0:a8:ea:84 brd ff:ff:ff:ff:ff:ff link-netnsid 0 inet 192.168.234.132/24 brd 192.168.234.255 scope global eth0 valid_lft forever preferred_lft forever inet 192.168.234.140/32 scope global eth0 valid_lft forever preferred_lft forever
|
||||
```
|
||||
|
||||
## 总结
|
||||
|
||||
到此宿主机1的安装已完成,宿主机2的安装与其安装过程完全相同(注意keepalived.conf配置),在keepalived中我将宿主机1运行容器安装的keepalived设置为MASTER而宿主机2运行容器安装的keepalived设置为BACKUP,正常启动情况下虚拟IP 140 绑定在MASTER网卡上,当我将宿主机1关闭容器的情况下,BACKUP会自动获取虚拟IP 140 而当MASTER再次启动时虚拟IP会自动回到MASTER,以上就是我使用docker容器测试keepalived高可用的过程,希望对有需要的同学有用。
|
||||
|
||||
(补充:我尝试过使用host方式运行keepalived,但当关闭容器时宿主机虚拟IP不会在本机下载掉造成双虚拟IP在线也就是脑裂现象。)
|
||||
@@ -0,0 +1,5 @@
|
||||
|
||||
## FRP
|
||||
## Cloudflare Tunnel
|
||||
|
||||
## HappyNet
|
||||
@@ -0,0 +1,3 @@
|
||||
## JexChan 单文件程序制作工具
|
||||
## Enigma Virtual Box
|
||||
# VMware ThinApp
|
||||
@@ -0,0 +1,5 @@
|
||||
3平米
|
||||
|
||||
- 水泥找平
|
||||
- 宽排水槽
|
||||
- 环氧地坪
|
||||
@@ -0,0 +1,65 @@
|
||||
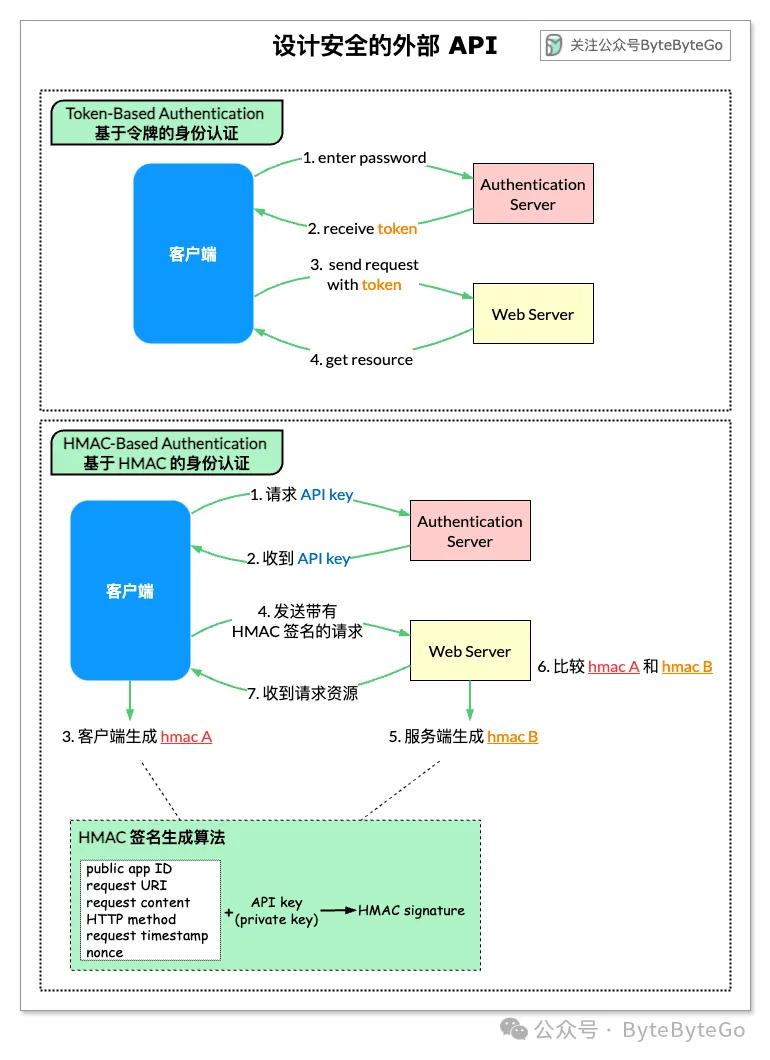
当向外部服务暴露 API 时,确保安全通信至关重要,以防止未经授权的访问和数据泄露。
|
||||
|
||||
两种常用的 API 安全方法是**基于 Token 的身份认证**和**基于 HMAC(哈希消息认证码)的认证**。
|
||||
|
||||
下面我们来介绍这两种方法的工作原理,并比较它们的不同之处。
|
||||
|
||||
|
||||
|
||||
## 01 基于令牌
|
||||
|
||||
- 第 1 步 - 用户在客户端输入密码,客户端将密码发送给验证服务器。
|
||||
|
||||
- 第 2 步 - 验证服务器验证凭据并生成一个有有效期的令牌。
|
||||
|
||||
- 第 3 步和第 4 步 - 现在,客户端可以发送请求,客户端在每个 API 请求的 Authorization 头中包含这个Token,访问服务器资源。这种访问在令牌过期前一直有效。
|
||||
|
||||
|
||||
### 优点
|
||||
|
||||
- 无状态:服务器不需要维护会话状态,Token 本身包含验证所需的所有信息。
|
||||
|
||||
- 灵活性:Token 可以包含角色或权限等元数据,支持细粒度的访问控制。
|
||||
|
||||
- 支持 OAuth 集成:与OAuth 2.0 兼容,适合第三方集成场景。
|
||||
|
||||
|
||||
### 缺点
|
||||
|
||||
- Token 泄露风险:如果 Token 被拦截,攻击者可以在 Token 过期前滥用它,除非有其他机制(如 Token 吊销)在起作用。
|
||||
|
||||
- Token 存储:客户端需要安全存储 Token,对于 Web 或移动应用程序来说,这可能比较复杂。
|
||||
|
||||
|
||||
## 02 基于 HMAC
|
||||
|
||||
该机制使用哈希函数(SHA256 或 MD5)生成消息验证码(签名)。
|
||||
|
||||
- 第 1 和 2 步 - 服务器生成两个密钥,一个是公共 APP ID(公钥),另一个是 API 密钥(私钥)。
|
||||
|
||||
- 第 3 步:现在我们在客户端生成一个 HMAC 签名(hmac A)。该签名是根据图中列出的一组属性生成的。
|
||||
|
||||
- 第 4 步 - 客户端发送访问服务器资源的请求,HTTP 头中包含 hmac A。
|
||||
|
||||
- 第 5 步 - 服务器收到包含请求数据和身份验证标头的请求。它从请求中提取必要的属性,并使用存储在服务器端的 API 密钥生成签名(hmac B。)
|
||||
|
||||
- 第 6 和 7 步 - 服务器会比较 hmac A(在客户端生成)和 hmac B(在服务器端生成)。如果两者匹配,请求的资源将返回给客户端。
|
||||
|
||||
|
||||
### 优点
|
||||
|
||||
- 防篡改:HMAC 确保请求在传输过程中未被篡改,哪怕只改变一个字节,签名也会不匹配。
|
||||
|
||||
- 简单:不需要 Token 的发放或刷新,仅依赖共享密钥和哈希算法。
|
||||
|
||||
- 无 Token 泄露风险:因为没有 Token 可被盗取,这种方法天然安全。
|
||||
|
||||
|
||||
### 缺点
|
||||
|
||||
- 密钥管理:客户端和服务器都必须安全地管理和存储共享密钥。一旦密钥泄露,安全性就会受到影响。
|
||||
|
||||
- 无状态 API 较复杂:HMAC 不提供内嵌元数据的无状态认证,访问控制需要单独处理。
|
||||
|
||||
|
||||
在 HMAC 签名中加入时间戳是为了**防止重放攻击**(replay attack)。重放攻击是一种网络攻击方式,攻击者拦截合法的请求并在之后重复发送相同的请求,试图伪造身份或重复操作。通过时间戳,服务器可以验证请求是否在合理的时间范围内,从而大大提高系统的安全性。
|
||||
@@ -0,0 +1,5 @@
|
||||
并发连接数 - 链接并保持
|
||||
并发用户数 - 链接并交易
|
||||
|
||||
|
||||
![[d089acca1b788be052b418499e1f4a5.png]]
|
||||
@@ -0,0 +1,8 @@
|
||||
|
||||
|
||||
|
||||
![[Pasted image 20241022162610.png]]
|
||||
|
||||
|
||||
在 Windows 平台主要通过“云文件 API”实现,Windows 10 版本 1709(也称为 Fall Creators Update)引入了云文件 API。
|
||||
|
||||
@@ -0,0 +1,12 @@
|
||||
|
||||
# glances
|
||||
单机,数据缓存在本地
|
||||
服务模式,需要外部拉取
|
||||
restful api
|
||||
|
||||
|
||||
|
||||
## beszel
|
||||
集群,数据存储在管理端
|
||||
服务模式,管理机客户端拉取集群内所有服务器
|
||||
TODO 远程命令执行
|
||||
@@ -0,0 +1,10 @@
|
||||
https://online.visual-paradigm.com/
|
||||
只能用来取图标,编辑起来卡的要命。
|
||||
|
||||
|
||||
https://icraft.gantcloud.com/editor
|
||||
2D 和 3D
|
||||
|
||||
|
||||
https://bpstudio.console.aliyun.com/
|
||||
阿里云速搭,直接对应阿里云服务。
|
||||
@@ -0,0 +1 @@
|
||||
- 监控定时任务有没有正常执行
|
||||
@@ -0,0 +1,9 @@
|
||||
|
||||
- 服务器说明
|
||||
目前网关设备即 baishe 服务器,使用 ssh root@baishe 即可免密登录。
|
||||
- 域名说明
|
||||
\*.honor3.com 系列域名全部解析到网关设备
|
||||
- 配置说明
|
||||
- 子域名转发配置使用 nginx。
|
||||
- 导航配置使用 homepage 程序。配置目录 /app/homepage
|
||||
|
||||
@@ -0,0 +1,4 @@
|
||||
|
||||
## 系统代理
|
||||
|
||||
## Tun 模式
|
||||
@@ -0,0 +1,10 @@
|
||||
https://online.visual-paradigm.com/
|
||||
只能用来取图标,编辑起来卡的要命。
|
||||
|
||||
|
||||
https://icraft.gantcloud.com/editor
|
||||
2D 和 3D
|
||||
|
||||
|
||||
https://bpstudio.console.aliyun.com/
|
||||
阿里云速搭,直接对应阿里云服务。
|
||||
@@ -0,0 +1,6 @@
|
||||
**负载均衡产品:**
|
||||
|
||||
- **nginx**:工作在应用层
|
||||
- **haproxy**:工作在传输层
|
||||
- **lvs**:工作在网络层
|
||||
- **f5**:工作在数据链路层
|
||||
@@ -0,0 +1,415 @@
|
||||
### [高可用性](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E9%AB%98%E5%8F%AF%E7%94%A8%E6%80%A7&zhida_source=entity):从理论到实践,打造坚如磐石的系统
|
||||
|
||||
### 什么是可用性?
|
||||
|
||||
可用性,简单来说就是系统能正常干活的时间比例。它是一个可以量化的指标,计算公式是这样的:
|
||||
|
||||
**可用性 = (总运行时间 - 宕机时间) / 总运行时间**
|
||||
|
||||
行业内通常用“几个9”来衡量可用性水平:
|
||||
|
||||
- **99.9%(三个9)**:年宕机时间不超过8.76小时。
|
||||
- **99.99%(四个9)**:年宕机时间不超过52.6分钟。
|
||||
- **99.999%(五个9)**:年宕机时间不超过5.26分钟。
|
||||
|
||||
对于大多数系统来说,**99.99%(四个9)**是起步要求,只有达到这个水平,才能勉强算得上高可用。
|
||||
|
||||
### 什么是高可用?
|
||||
|
||||
高可用(High Availability,HA),说白了就是系统能**无中断地提供服务**的能力。它是系统设计的核心准则之一,目标是尽量减少宕机时间,确保服务在任何情况下都能稳定运行。
|
||||
|
||||
但要注意,**100%可用是不可能的**!无论你设计得多完美,硬件故障、网络波动、人为失误等问题总是难以避免。所以,高可用的核心思想是:**尽最大可能提高系统的可用性,让服务在绝大多数情况下都能对外正常提供服务**。
|
||||
|
||||
### 高可用的本质
|
||||
|
||||
用一句话概括高可用的本质:**高可用就是让系统在任何情况下都能“扛得住、稳得住、恢复得快”**。
|
||||
|
||||
- **扛得住**:面对突发流量、硬件故障等异常情况,系统能稳定运行。
|
||||
- **稳得住**:在日常运行中,系统能长期保持稳定,不出现性能波动。
|
||||
- **恢复得快**:即使出现问题,系统也能快速恢复,将影响降到最低。
|
||||
|
||||
### 为什么高可用如此重要?
|
||||
|
||||
在当今的互联网时代,用户对系统的稳定性要求越来越高。一次小小的宕机,可能导致:
|
||||
|
||||
- 用户体验下降,用户流失。
|
||||
- 业务损失,尤其是电商、金融等对实时性要求高的行业。
|
||||
- 品牌信誉受损,甚至引发公关危机。
|
||||
|
||||
> 还记得2025年1月16日下午,支付宝出现了“**政府补贴**”错误提示,导致部分用户在支付时享受了不应有的折扣。支付宝官方确认了此事,并表示不会向用户追款。造成了严重的资金损失。
|
||||
|
||||
所以,高可用不仅是一个技术问题,更是一个业务问题。只有把高可用做到位,才能让系统真正成为业务的坚实后盾。
|
||||
|
||||
> _**最近无意间获得一份阿里大佬写的刷题笔记,一下子打通了我的任督二脉,进大厂原来没那么难。这是大佬写的,**_[[7701页的BAT大佬写的刷题笔记,让我offer拿到手软]](https://link.zhihu.com/?target=https%3A//cxykk.com/%23zhuanlan)
|
||||
|
||||
## 高可用系统设计思想
|
||||
|
||||
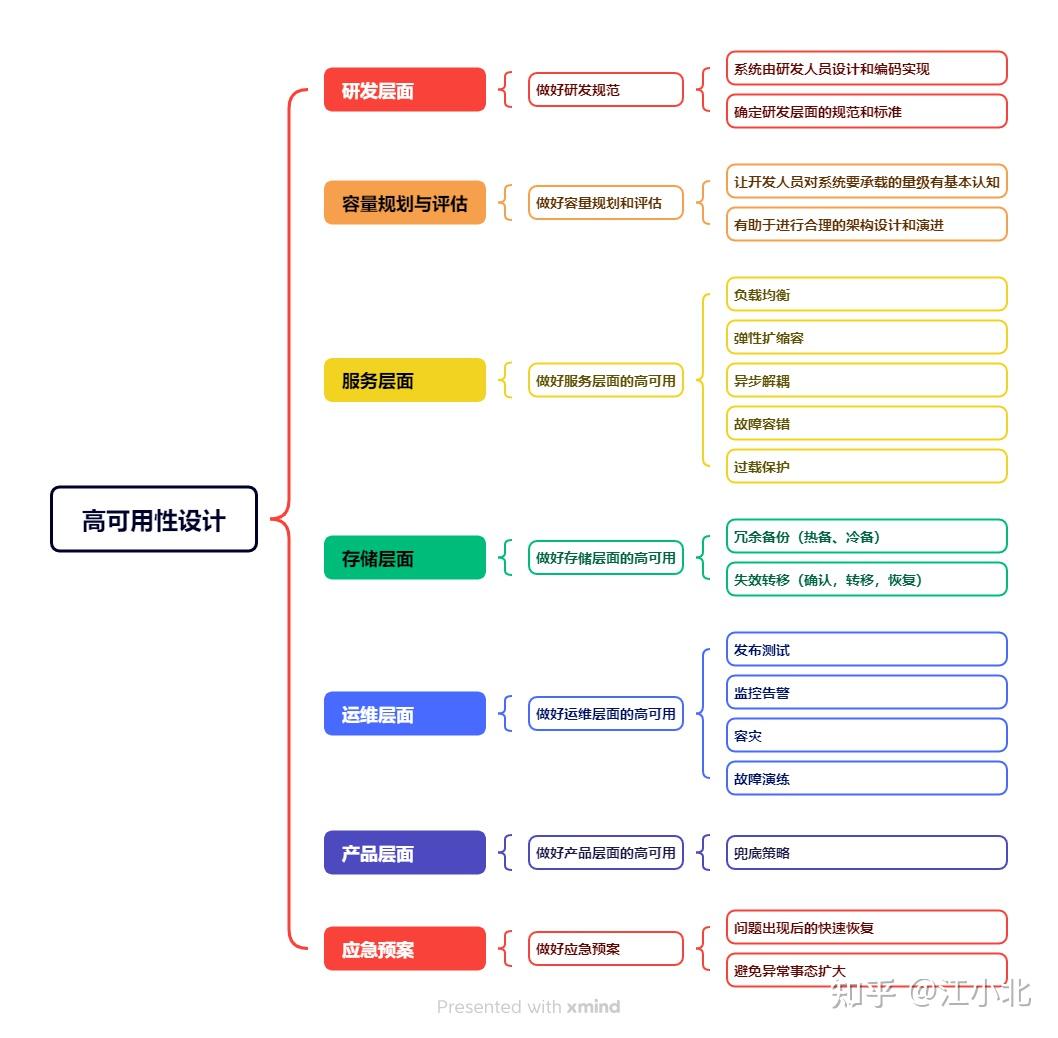
高可用系统的设计,需要有一套比较科学的工程管理套路,要从产品、开发、运维、基建等全方位去考量和设计,高可用系统的设计思想包括但不限于:
|
||||
|
||||
|
||||
|
||||
> **做好研发规范**,系统都是研发人员设计和编码写出来的,因此首先要对研发层面有一个规范和标准
|
||||
> **做好容量规划和评估**,主要是让开发人员对系统要抗住的量级有一个基本认知,方便进行合理的架 构设计和演进。
|
||||
> **做好服务层面的高可用**,主要是[负载均衡](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E8%B4%9F%E8%BD%BD%E5%9D%87%E8%A1%A1&zhida_source=entity)、[弹性扩缩容](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E5%BC%B9%E6%80%A7%E6%89%A9%E7%BC%A9%E5%AE%B9&zhida_source=entity)、异步解耦、故障容错、过载保护等。
|
||||
> **做好存储层面的高可用**,主要是冗余备份(热备、冷备)、失效转移(确认,转移,恢复)等。
|
||||
> **做好运维层面的高可用**,主要是发布测试、[监控告警](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E7%9B%91%E6%8E%A7%E5%91%8A%E8%AD%A6&zhida_source=entity)、容灾、[故障演练](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E6%95%85%E9%9A%9C%E6%BC%94%E7%BB%83&zhida_source=entity)等。
|
||||
> **做好产品层面的高可用**,主要是兜底策略。
|
||||
> **做好应急预案**,主要是在出现问题后怎么快速恢复,不至于让我们的异常事态扩大。
|
||||
|
||||
## 二、研发规范层面
|
||||
|
||||
## 方案设计和编码规范
|
||||
|
||||
研发规范层面这个是大家容易忽视的一个点,但是,我们所有的设计,都是研发人员来完成的,包括从设计文档到编码到发布上线,因此,研发层面也是有一个规范流程和套路,来让我们更好的去研发和维护一个高可用的系统:
|
||||
|
||||
### 设计阶段
|
||||
|
||||
> 方案设计后一定要进行评审,在我们团队中,新项目一定要评审,重构项目一定要评审,大 的系统优化或者升级一定要评审,其他的一般研发工作量超过一周的建议要评审的。
|
||||
|
||||
### 编码阶段
|
||||
|
||||
> 不要随便打日志 要接入远程日志 要能够分布式链路追踪
|
||||
> 代码编写完需要有一定的单测来保证代码的健壮性,同时也能保障我们后续调整逻辑或者优化的时候可以保证代码的稳定 包括增量覆盖率、全量覆盖率,具体的覆盖率要达到多少可以根据团队内部的实际情况来定,在我们团队,定的规则是 50% 的覆盖率。
|
||||
> 工程的 layout 目录结构规范,团队内部保持统一,尽量简洁 遵循团队内部的代码规范,一般公司都有对应语言的规范,如果没有则参考官方的规范,代 码规范可以大大减少 bug 并且提高可用性。
|
||||
> 执行代码规范 单测覆盖率 日志规范
|
||||
> 发布上线阶段,参考下面运维部署层面那一章节的灰度发布和接口测试相关说明
|
||||
|
||||
## 容量规划和评估
|
||||
|
||||
### 容量评估
|
||||
|
||||
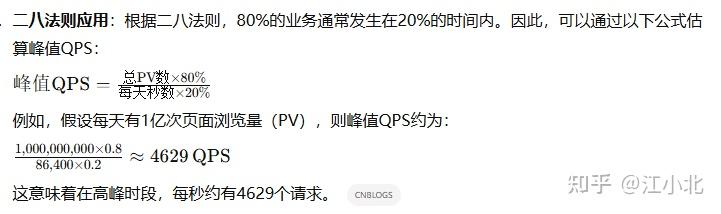
**容量评估**,是指我们需要评估好,我们这个系统,是为了应对一个什么体量的业务,这个业务请求量的平均值、高峰的峰值大概都在一个什么级别。
|
||||
|
||||
如果是新系统,那么就需要根据产品和运营同学对业务有一个大体的预估,然后开发同学根据产品给的数据再进行详细的评估。如果是老系统,那么就可以根据历史数据来评估。评估的时候,要从一个整体角度来看全局的量级,然后再细化到每个子业务模块要承载的量级。
|
||||
|
||||
例如常用的二八法则估算
|
||||
|
||||
|
||||
|
||||
### 容量规划
|
||||
|
||||
**容量规划**,简单说就是我们在设计系统的时候,就要大概知道系统能承受多少流量,是十万、百万,还是更多。
|
||||
|
||||
不同的流量量级,系统架构的设计差别可大了,尤其是到了千万、亿级别的流量,架构设计就得考虑的更多。
|
||||
|
||||
不过,别误会,并不是说一开始就得做个能承受几亿请求的系统——没必要。你得根据自己业务的真实流量来做,合适的才是最好的。
|
||||
|
||||
容量规划还得考虑我们系统上下游的各个模块,比如你依赖的存储、三方服务等,它们各自需要多少资源,这些数据得能量化出来。
|
||||
|
||||
最重要的是,容量规划更多是靠经验,团队的经验。比如,得了解你用的**日志系统的性能**、**Redis的性能**、**RPC接口的性能**、**服务化框架的性能**等,通过这些组件的性能数据,综合评估系统整体能承受多少流量。
|
||||
|
||||
做完容量评估和规划后,下一步就是进行性能压测,最好是全链路压测。性能压测的目的是为了验证容量规划到底准不准。
|
||||
|
||||
比如,你规划的系统能抗千万级别的请求,实际上能不能真的承受得住?这就得靠性能压测来给出准确答案。
|
||||
|
||||
经验固然重要,但一定得有实际的数据来支撑,才能确保系统上线不会出问题。
|
||||
|
||||
性能压测时,要关注的指标其实很多,但最关键的两个:一个是**QPS(每秒请求量)**,另一个是**响应时间**。确保压测的结果符合你的预期才行。
|
||||
|
||||
至于怎么压测,最好是先分模块逐个压测,如果有条件,能做全链路压测更好。这样才能真正知道,系统在大流量压力下的表现如何。
|
||||
|
||||
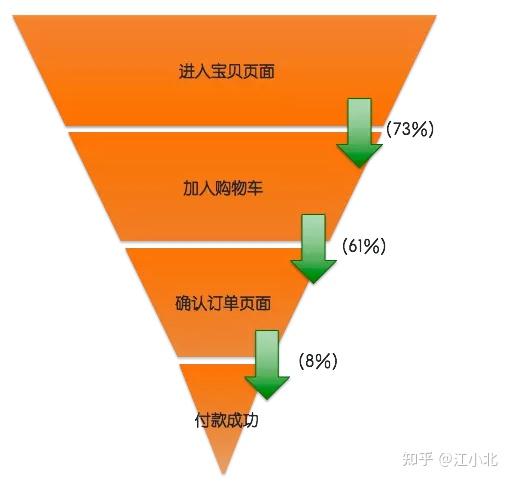
**QPS 预估(漏斗型)**,其实就是从一个真实请求进来后,依次经过系统的各个层级和模块。每一层级的 QPS(每秒请求量)都会有不同的量级,通常来说,越往下走,QPS的量级会逐步减少,因为每通过一个层级,都有可能会过滤掉一些请求。
|
||||
|
||||
举个例子,就像用户从活动页进入,查看商品详情,再到下单的过程。最开始,所有用户进入活动页时,都会有请求进入系统;接着,有部分用户会去查询商品详情;然后,在查看商品详情的用户中,又只有一部分最终会下单。所以,你会看到从活动页到下单的这个过程,就像一个漏斗,层级越往下,流量就会越来越少。
|
||||
|
||||
|
||||
|
||||
> _**最近无意间获得一份阿里大佬写的刷题笔记,一下子打通了我的任督二脉,进大厂原来没那么难。这是大佬写的,**_[[7701页的BAT大佬写的刷题笔记,让我offer拿到手软]](https://link.zhihu.com/?target=https%3A//cxykk.com/%23zhuanlan)
|
||||
|
||||
## 三、应用服务层面
|
||||
|
||||
## 无状态和负载均衡设计
|
||||
|
||||
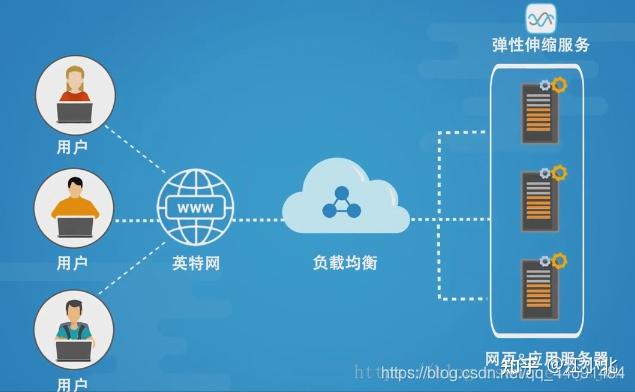
为了让我们的系统保持高可用,通常会设计成**无状态**的应用服务。
|
||||
|
||||
> 这是什么意思呢?
|
||||
|
||||
就是我们可以把服务拆成多个实例来提高可用性。多个实例的流量分配,靠的就是负载均衡。
|
||||
|
||||
|
||||
|
||||
无状态服务加上负载均衡,不仅能提升系统的并发能力,还能让系统在面对故障时更加稳健。
|
||||
|
||||
如果我们用的是微服务框架来开发的,那大概率框架内部自带了服务发现和负载均衡的功能。
|
||||
|
||||
也就是说,有一整套流程:服务注册、服务发现、负载均衡、健康检查、自动剔除。当某个服务实例出了问题,系统会自动把它剔除,新增的服务实例会自动加入,继续提供服务。这样一来,整个系统就更加灵活、可靠。
|
||||
|
||||
但如果我们没有用微服务框架开发,而是用传统架构,那么就得依赖一些代理服务来做负载均衡了,比如**LVS** 或者 **Nginx**。这些工具会帮我们处理流量分配,保证系统的可用性和稳定性。
|
||||
|
||||
## 弹性扩缩容设计
|
||||
|
||||
弹性扩缩容是应对突发流量的绝招,也是保证我们服务能一直在线、可用的必要手段。它的核心是**无状态的应用服务**,因为服务是无状态的,所以我们可以根据实际的流量来随时进行扩容或缩容。流量猛增时,扩容来处理更多请求;流量下降时,缩容,节省资源,减少浪费。
|
||||
|
||||
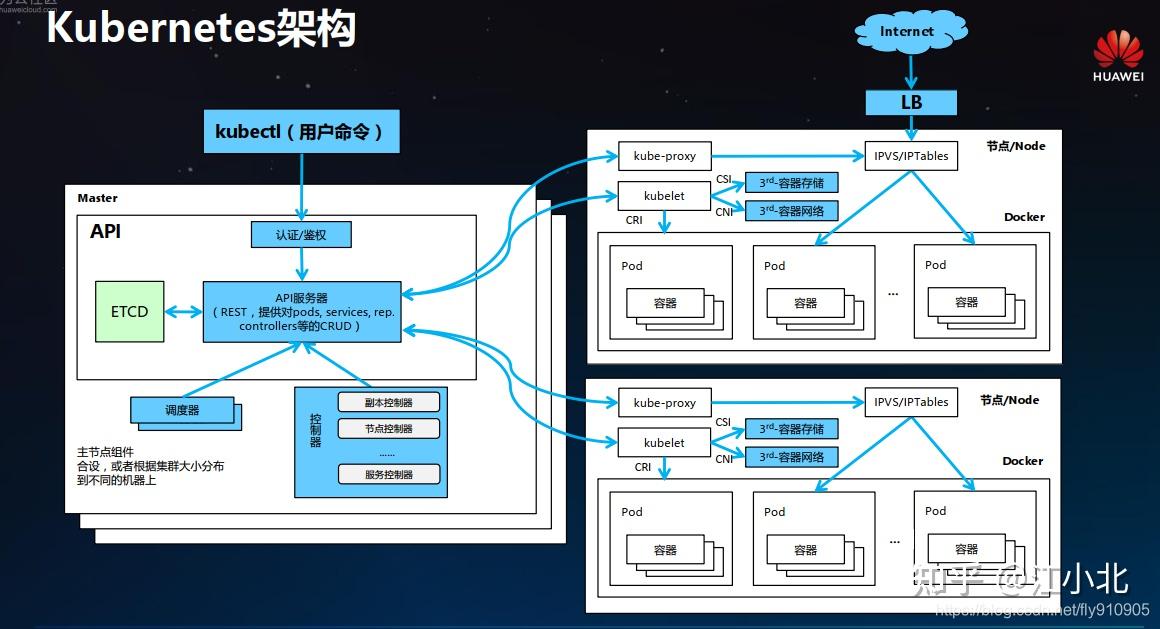
那我们到底怎么实现弹性扩缩容呢?现在是云原生时代,很多公司都采用容器化部署,像是**K8s**(Kubernetes)这样的平台。对于这种架构,弹性扩缩容就变得特别简单。只需要在K8s中配置好弹性扩缩容的条件,比如设置CPU使用率的阈值,K8s就能自动监控、自动调整,保证系统始终处于最佳状态。
|
||||
|
||||
举个例子,假设你有一个电商系统在双十一期间,流量激增。K8s可以根据CPU使用情况,自动增加容器实例来应对大量并发请求。如果在流量低谷时,K8s又会根据预设条件自动减少实例数,节约资源。
|
||||
|
||||
|
||||
|
||||
但如果你没有用容器化,而是传统的物理机部署,那要实现弹性扩缩容就没那么简单了。你得有强大的内部基础设施支持,通过运营平台实时监控服务的CPU使用率或者QPS。一旦这些指标超过某个阈值,系统就会自动触发扩缩容操作。虽然实现起来没有K8s那么自动化,但原理是一样的:根据需求动态调整资源。
|
||||
|
||||
无论是容器化还是物理机,弹性扩缩容的目标都是一样的:让服务在流量波动中保持高可用,同时也避免资源浪费。
|
||||
|
||||
## [消息队列](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E6%B6%88%E6%81%AF%E9%98%9F%E5%88%97&zhida_source=entity):异步解耦 + 削峰的秘密武器
|
||||
|
||||
想让系统扛得住高并发、稳如老狗?架构设计上就得学会“切蛋糕”——分层分模块。
|
||||
|
||||
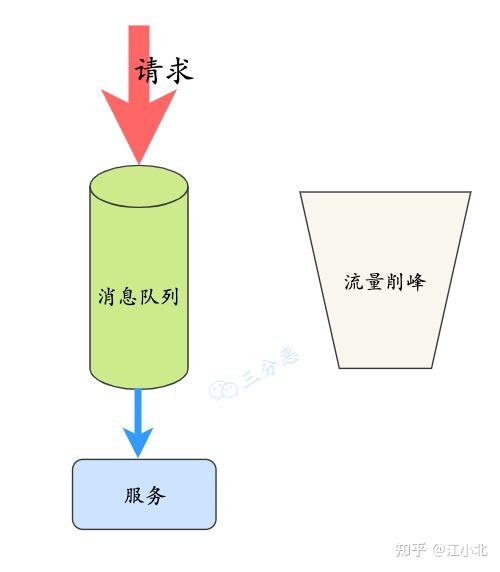
但光分开了还不够,还得让模块之间“各干各的”,这时候就要靠消息队列(比如**Kafka**、**RocketMQ**)的异步解耦和削峰能力了。这两招能让你的系统从“一碰就碎”变成“韧性十足”。
|
||||
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 异步解耦
|
||||
|
||||
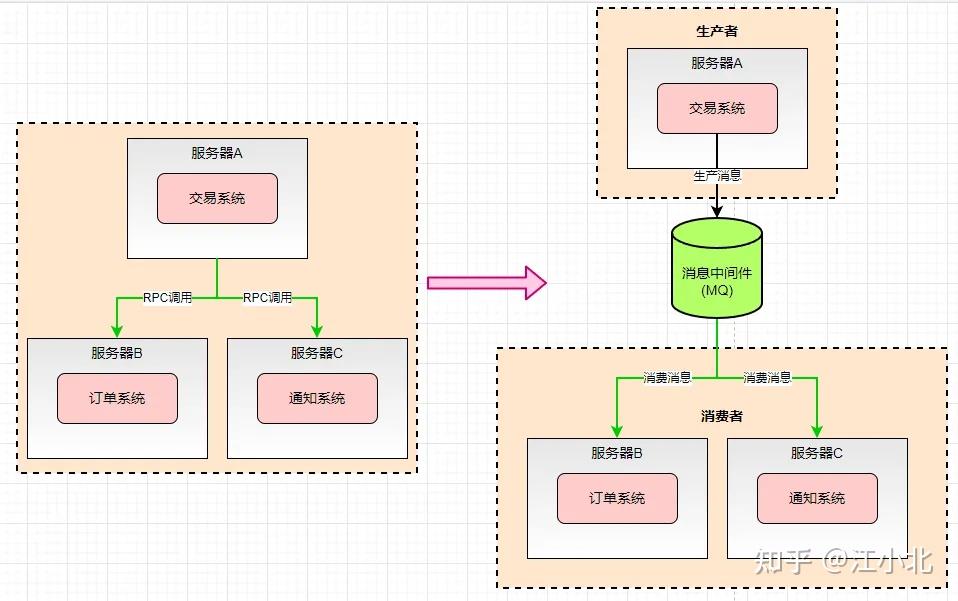
想象一下,A模块要调B模块,如果每次都要等B模块回复才能继续干活。但用了消息队列,A模块只需要把消息往队列里一扔(比如订单数据写到Kafka),就可以转身继续处理其他请求。B模块(比如支付系统)什么时候有空了,再去队列里慢慢取消息处理。
|
||||
|
||||
|
||||
|
||||
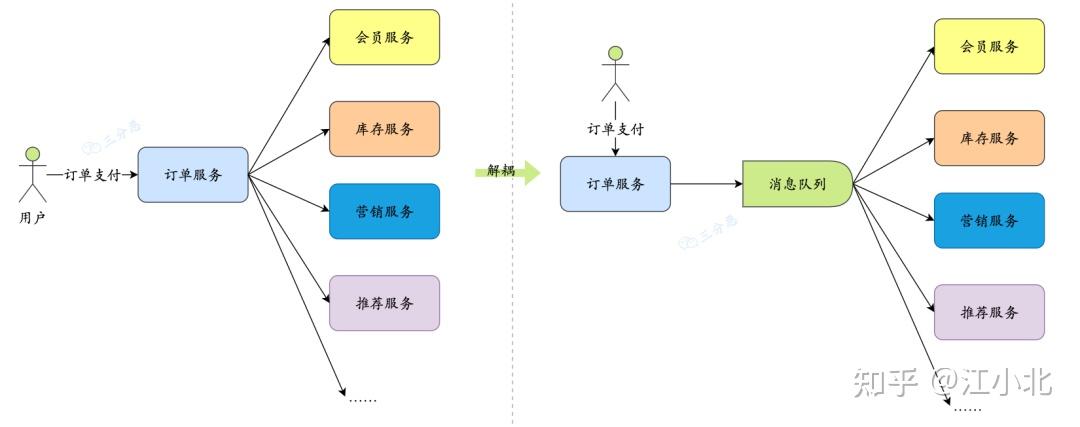
**例如**: 电商平台用**RocketMQ**处理订单。用户下单后,订单服务直接把消息丢进队列,不用等库存服务、支付服务挨个处理完才给用户反馈。哪怕库存服务突然宕机了,订单数据还在队列里存着,恢复后继续扣库存,用户完全感知不到。
|
||||
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 消息队列选型小贴士
|
||||
|
||||
- **Kafka**:吞吐量怪兽,适合日志处理、大数据场景(比如用户行为分析)
|
||||
- **RocketMQ**:业务消息专家,事务消息、顺序消息一把梭(比如电商订单、金融交易)
|
||||
- **RabbitMQ**:轻量灵活,适合中小规模业务(比如通知提醒)
|
||||
|
||||
## 故障和容错设计
|
||||
|
||||
高可用设计的核心不是追求100%不出错(这不可能),而是出错时怎么让用户觉得“问题不大”,甚至无感知。因此业界来评价可用性 SLA都是说多少个 9,比如 4 个 9(99.99%)的可用性。
|
||||
|
||||
### 过载保护设计(限流、熔断、降级)
|
||||
|
||||
---
|
||||
|
||||
### 第一板斧:限流
|
||||
|
||||
想象一下双十一零点,每秒百万请求冲进来,服务器眼看要挂。这时候就得学地铁站——限流!比如:
|
||||
|
||||
- **接口限流**:只允许每秒处理1万次下单请求,超出的直接返回“稍后再试”
|
||||
- **用户限流**:单个用户1秒内最多点5次“抢购”,防止机器人刷单
|
||||
- **服务限流**:支付服务最多承受5万QPS,超了就让部分用户走备用通道
|
||||
|
||||
例如前端时间,华哥演唱会开票时,10万人同时开抢,系统只放前1万请求进核心流程,后面的直接展示“排队中”。虽然有人骂,但至少系统没崩,比全员404强多了。
|
||||
|
||||
---
|
||||
|
||||
### 第二板斧:熔断
|
||||
|
||||
当你发现依赖的服务开始抽风(比如数据库响应从50ms变成5秒),千万别头铁继续调用!这时候要像家里电路跳闸一样,直接切断连接。比如:
|
||||
|
||||
1. 监控到下游服务错误率超过50% → 触发熔断
|
||||
2. 后续请求直接走本地缓存/默认值
|
||||
3. 每隔30秒试探性放一个请求,确认下游恢复后关闭熔断
|
||||
|
||||
---
|
||||
|
||||
### 第三板斧:降级
|
||||
|
||||
系统快扛不住时,得学会“丢车保帅”。比如:
|
||||
|
||||
- 关闭商品详情页的“猜你喜欢”推荐
|
||||
- 停用积分兑换功能
|
||||
- 订单页隐藏非必填字段
|
||||
|
||||
**真实案例**:微博社交App在明星官宣离婚时,立刻降级非核心功能:
|
||||
|
||||
1. 关闭动态页的“热门评论”计算
|
||||
2. 停用消息页的未读红点推送
|
||||
3. 保留核心的发布/浏览功能 虽然用户体验打了折扣,但至少没崩盘上热搜。
|
||||
|
||||
---
|
||||
|
||||
### 容错设计心法
|
||||
|
||||
1. **Fail Fast原则**:就像发现煤气泄漏,第一时间关总闸而不是找漏气点
|
||||
2. **分层防御**:前端限流 → 网关熔断 → 服务降级,层层设防
|
||||
3. **监控告警**:给每个熔断降级动作加告警(比如企业微信/钉钉通知)
|
||||
|
||||
系统出问题不可怕,可怕的是雪崩时没有应急预案。设计系统时,不妨多想一步——如果这个服务挂了,用户能不能至少完成核心操作?
|
||||
|
||||
**四、存储层面的高可用**
|
||||
|
||||
现在的互联网应用大部分都是无状态的,所以保证应用服务的高可用其实挺简单的。但是要保证数据存储的高可用就复杂多了,因为数据是有状态的。
|
||||
|
||||
> **那我们到底该怎么保证数据存储的高可用呢?**
|
||||
|
||||
数据存储高可用的本质就是通过“冗余”来确保数据的可靠性,简单来说,就是把数据复制到多个地方。
|
||||
|
||||
这样不仅能避免数据丢失,还能提升并发能力。因为数据本身是有状态的,所以数据存储的高可用比应用服务的高可用复杂多了。
|
||||
|
||||
**主要体现在以下几个方面:**
|
||||
|
||||
- 数据该怎么复制?各个节点分别负责什么?
|
||||
- 复制过程中的延迟咋办?
|
||||
- 复制中断了,怎么办?
|
||||
|
||||
其实解决这些问题的常见方法就是两种:[集群存储](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E9%9B%86%E7%BE%A4%E5%AD%98%E5%82%A8&zhida_source=entity)和[分布式存储](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E5%88%86%E5%B8%83%E5%BC%8F%E5%AD%98%E5%82%A8&zhida_source=entity)。
|
||||
|
||||
业界大多数方案其实都是围绕这两种方式进行的,或者对它们做了一些衍生和扩展。
|
||||
|
||||
**集群存储(集中式存储)**
|
||||
|
||||
所谓集群,其实就是一群逻辑上在做同一个任务的机器。它们可以在同一个机房,也可以分布在不同的机房。集群存储就是把这些机器上的存储资源合在一起,呈现给外部一个统一的存储系统。
|
||||
|
||||
集群存储其实适用于那些业务存储量规模不算特别大的场景。对于一般的业务数据存储,集群方式就足够用了。比如现在大家用的Redis、MySQL等,都是采用集群存储方式。对于中大型互联网公司来说,默认就是这么做的。
|
||||
|
||||
集群存储的工作方式是:1主多备或者1主多从。数据写入通过主机,读取一般由从机来承担。集群存储要解决的关键问题就是:
|
||||
|
||||
- 主机怎么把数据复制到备机(从机)上?
|
||||
|
||||
- 这里的数据同步就是主机负责的,把数据复制到备机(从机)。不过得注意,主备之间的数据同步有可能会有延迟。
|
||||
|
||||
|
||||
- 备机(从机)怎么监控主机状态?
|
||||
|
||||
- 如果主机故障,备机(从机)怎么接管主机的角色,变成新的主机?
|
||||
|
||||
简而言之,在主从架构中,一旦主机挂掉,备机(从机)就可以直接接管,继续提供服务。这也是集群存储的基本思想。
|
||||
|
||||
> _**最近无意间获得一份阿里大佬写的刷题笔记,一下子打通了我的任督二脉,进大厂原来没那么难。这是大佬写的,**_[[7701页的BAT大佬写的刷题笔记,让我offer拿到手软]](https://link.zhihu.com/?target=https%3A//cxykk.com/%23zhuanlan)
|
||||
|
||||
**1. 主备复制**
|
||||
|
||||
主备复制是最常见、最简单的存储高可用方案了。几乎所有的存储系统都能提供这种功能,比如 MySQL、Redis、MongoDB 这些大家熟悉的工具,都是这么做的。
|
||||
|
||||
在主备架构里,所谓“备机”主要是用来做备份的,并不会参与实际的读写操作。如果想要让备机变成主机,那就得手动干预了。所以,这种架构一般用于后台管理系统,或者一些不需要高实时性的场景。
|
||||
|
||||
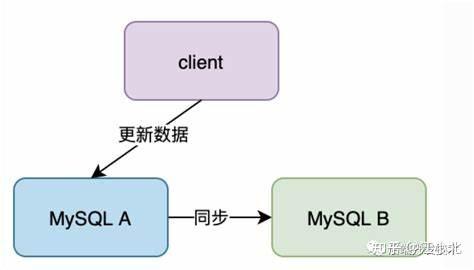
|
||||
|
||||
**2. 主从复制**
|
||||
|
||||
主从复制和主备复制听起来差不多,但其实是两种不同的设计思路。简单来说,“从”就是听命的意思,“备”是备份的意思。主从复制的“从机”是要真的干活的,它会处理数据的“读”操作,而“主机”负责“写”和“读”操作。
|
||||
|
||||
所以,主从架构里,主机负责数据的读写,而从机只负责数据的读取。写操作不会由从机来承担。
|
||||
|
||||
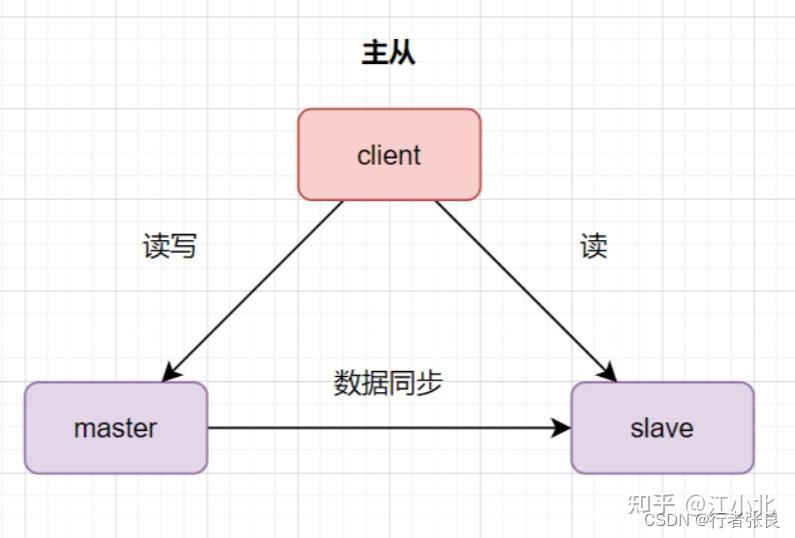
|
||||
|
||||
**3. 主从切换**
|
||||
|
||||
主备复制和主从复制这两种方案,虽然挺常见,但都有个问题:主机故障后,系统就不能继续写数据了。如果主机坏了,还得人工去指定一个新的主机。
|
||||
|
||||
为了解决这两个问题,就出现了主从切换(有时候叫主备切换)。这就是在原有架构上加了一点“智能”,也就是当主机异常时,系统会自动检测并把备机或者从机切换成主机。这个方案在实际应用中非常常见,因为它能保证主机挂掉后,从机能自动顶上,保证业务不出问题。
|
||||
|
||||
**4. 主主复制**
|
||||
|
||||
主主复制就是两台机器都当“主机”,它们互相将数据复制给对方。客户端可以随便选择一台机器进行读写操作,没啥限制。但主主复制的一个大挑战是:两台机器之间的数据必须能双向同步。所以,这种架构的实现要求相对较高,需要更强的数据一致性保证。
|
||||
|
||||
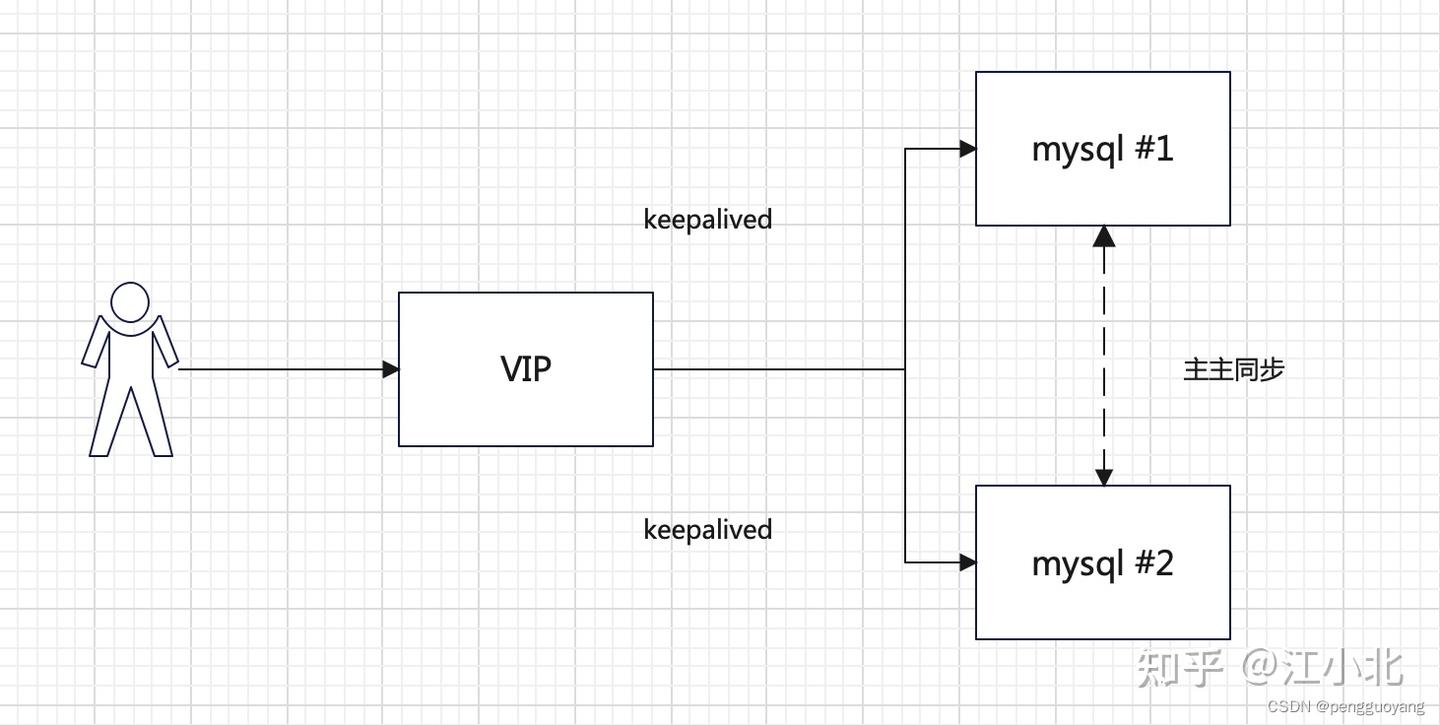
|
||||
|
||||
**分布式存储**
|
||||
|
||||
集群和分布式听起来有点像,但其实不一样。集群是把几台服务器集中在一起,做同一个业务,而分布式就是把不同的业务分散到不同的地方,形成一个整体。在分布式系统里,每一个节点都有可能是一个小集群。
|
||||
|
||||
分布式存储就是通过网络,把企业每台机器的磁盘空间给用上,将这些零散的存储资源整合成一个虚拟的存储设备。数据就像散落在各个角落一样,分布在不同的地方。分布式存储的每台服务器都能处理读写请求,不像集群存储那样只有一个主机负责写数据。可是,虽然没有主机这种角色,还是得有一个“指挥官”来负责数据分配算法,这个“指挥官”可以是独立的服务器,也可以是集群中选举出来的某台机器。
|
||||
|
||||
这种分布式存储特别适合海量数据存储,尤其是那些数据量特别大的业务场景。常见的分布式存储系统有Hadoop(HDFS)、HBase、Elasticsearch等。
|
||||
|
||||
**五、产品层面的高可用**
|
||||
|
||||
在产品层面上,高可用架构主要是指我们的“兜底”策略,也就是当系统出现问题时,能保证用户体验不至于崩溃。降级和限流策略更多是从后端架构的角度来考虑,而产品层的兜底策略就是从用户的角度,确保即使出现问题,用户也能感知到的是友好的提醒,而不是系统崩塌。
|
||||
|
||||
举个例子,假如我们的页面获取不到数据或者不能访问时,我们该如何友好地通知用户呢?像“稍后重试”这种提示就很有用。
|
||||
|
||||
再比如,当真实页面无法访问时,产品应该提供一个默认页面。如果后端获取不到真实数据,直接给用户渲染默认的页面,而不是让他们一直等。
|
||||
|
||||
再比如,服务器需要停机维护时,产品应该给出一个停机页面,所有用户看到的就是这个页面,不会再请求后端服务,避免系统负担过重。
|
||||
|
||||
还有一种情况,比如抽奖活动,万一后台数据出问题,给一个默认的兜底商品,至少能让用户看到一个结果,而不是一片空白。
|
||||
|
||||
> _**最近无意间获得一份阿里大佬写的刷题笔记,一下子打通了我的任督二脉,进大厂原来没那么难。这是大佬写的,**_[[7701页的BAT大佬写的刷题笔记,让我offer拿到手软]](https://link.zhihu.com/?target=https%3A//cxykk.com/%23zhuanlan)
|
||||
|
||||
**六、运维部署层面**
|
||||
|
||||
**开发阶段——灰度发布、接口测试设计**
|
||||
|
||||
说到灰度发布和接口测试,很多人都会觉得这两者是个常见的流程,尤其是在大公司里,基本都会涉及到这些环节。灰度发布是啥?就是服务上线的时候,不是一次性把所有实例都发布出去,而是先发布1-2个实例,然后慢慢放量,看看效果如何。如果没问题,再继续发布,直到所有实例都上线。
|
||||
|
||||
接口测试呢,就是每次服务发布前,要先跑一遍接口测试用例,确保接口没有问题,避免上线后出现麻烦。接口测试能让我们在发布前知道,接口是不是能正常工作。
|
||||
|
||||
这两项工作,尤其在大公司中,基本都由专门的DevOps团队来负责,确保每次发布都安全、稳定。
|
||||
|
||||
**开发阶段——监控告警设计**
|
||||
|
||||
监控告警的设计,听起来可能有点复杂,但在大公司里这通常不是问题。公司会有一群专门的人来搭建这个基础设施,配套的系统也会有,开发同学只需要配置好、使用好就行了。
|
||||
|
||||
但如果你在的公司没有这样的基础设施,那就得自己动手了,得接入一些监控系统来保证服务的稳定性。
|
||||
|
||||
**监控系统**
|
||||
|
||||
说到监控系统,现在有几个开源的解决方案特别流行,可以帮助我们快速搭建自己的监控体系:
|
||||
|
||||
> **ELK (Elasticsearch、Logstash、Kibana)** :日志收集和分析。 由于微服务化后,日志分布在各个机器上,不能都存在本地,这时候ELK就是不二选择。它能将日志收集起来,做集中管理和分析。
|
||||
>
|
||||
> **Prometheus**:监控数据收集。 它可以帮助我们监控各种系统指标,甚至自定义一些业务指标。
|
||||
>
|
||||
> **OpenTracing**:分布式全链路追踪。 这意味着,你可以追踪一个请求从开始到结束的整个流程,查看涉及到的每一个服务,精准找到问题。
|
||||
>
|
||||
> **OpenTelemetry**:可观测系统标准。 这是个新标准,能结合追踪数据、指标数据和日志数据来观察分布式系统的状态,简化了很多监控的工作。
|
||||
|
||||
这些监控工具都是用来帮我们搭建一个全方位的监控体系。监控的指标会包括以下几个层面:
|
||||
|
||||
> **基础设施层监控**:主要是监控网络、交换机、路由器等底层设备。如果这些设备出现问题,那我们的业务服务肯定也会受影响。常见的监控指标包括网络流量(进和出)、丢包情况、连接数等。
|
||||
>
|
||||
> **操作系统层监控**:包括物理机和容器的监控,主要监控CPU使用率、内存占用、磁盘IO和网络带宽等。
|
||||
>
|
||||
> **应用服务层监控**:这个层面就比较复杂了,涉及到很多指标,比如主调请求量、被调请求量、接口成功率、失败率、响应时间(包括P99、P95等)等。
|
||||
>
|
||||
> **业务自定义监控**:每个业务服务都有自己独特的监控指标。例如电商系统里可能需要监控浏览量、支付成功率、发货情况等。
|
||||
>
|
||||
> **端用户层监控**:这一层关注的是用户实际体验,比如用户访问页面时的耗时、数据获取的耗时等。这个通常是前端或者客户端需要进行统计的。
|
||||
|
||||
这些监控系统和指标的设计,最终目的是为了让我们在服务出现问题时能尽早发现,并且能迅速定位到问题所在,确保系统始终稳定运行。
|
||||
|
||||
**告警系统**
|
||||
|
||||
虽然我们通过监控系统已经把所有可能出现的问题都统计清楚了,但如果没有一个实时告警系统,问题出现时我们就无法及时反应,系统出问题后,可能就会错失最佳处理时机,最终导致大规模的故障或者灾难。所以,除了监控,还得有一个能即时报警的系统。
|
||||
|
||||
告警系统的设计要做到:
|
||||
|
||||
- **实时性**:要做到秒级监控,问题一出现就能发现。
|
||||
- **全面性**:要覆盖公司所有的系统和业务,确保没有遗漏。
|
||||
- **实用性**:告警要分级,轻微问题和严重问题要有不同的预警级别,监控人员可以根据严重程度做出准确的决策。
|
||||
- **多样性**:告警方式要多样,除了常规的短信和邮件,还要有可视化界面,方便监控人员随时发现问题。
|
||||
|
||||
**开发阶段——安全性、防攻击设计**
|
||||
|
||||
防刷、防黑产、防黑客攻击这些防御措施,就是为了保护我们的系统不被外部恶意攻击。通常有几种常见策略:
|
||||
|
||||
- 在公司级的流量入口上做好统一的防刷和鉴权能力,比如统一接入层的封装。
|
||||
- 在业务服务内部,要做好细致的业务鉴权,比如登录状态的管理,或者加入更多业务层的鉴权逻辑,确保每一步都安全。
|
||||
|
||||
**部署阶段——多机房部署(容灾设计)**
|
||||
|
||||
我们通常会设计高可用策略,确保一个机房内的服务稳定运行,但万一整个机房出问题怎么办?比如地震、火灾,或者光纤被挖断了,那可就麻烦了。这时候就需要有容灾设计,常见的做法就是多机房部署。
|
||||
|
||||
- **服务的多机房部署**:这一点相对容易,因为服务大多数是无状态的,只要名字服务能发现不同机房的服务,调用就能顺利进行。但要注意,名字服务或者负载均衡服务需要有就近访问的能力。
|
||||
- **存储的多机房部署**:这就比较难搞了,因为存储是有状态的,部署到不同机房就意味着要考虑存储的同步和复制问题,这要求要更高。
|
||||
|
||||
如果条件有限,至少保证多机房部署业务服务就好,毕竟存储的多机房部署相对复杂。
|
||||
|
||||
**线上运行阶段——故障演练([混沌实验](https://zhida.zhihu.com/search?content_id=716292842&content_type=Answer&match_order=1&q=%E6%B7%B7%E6%B2%8C%E5%AE%9E%E9%AA%8C&zhida_source=entity))**
|
||||
|
||||
故障演练在大公司里是常见手段,尤其是像Netflix这种大公司,早在2010年就推出了混沌实验工具——Chaos Monkey。这个“混沌实验”对提升复杂分布式系统的健壮性和可靠性非常有效。
|
||||
|
||||
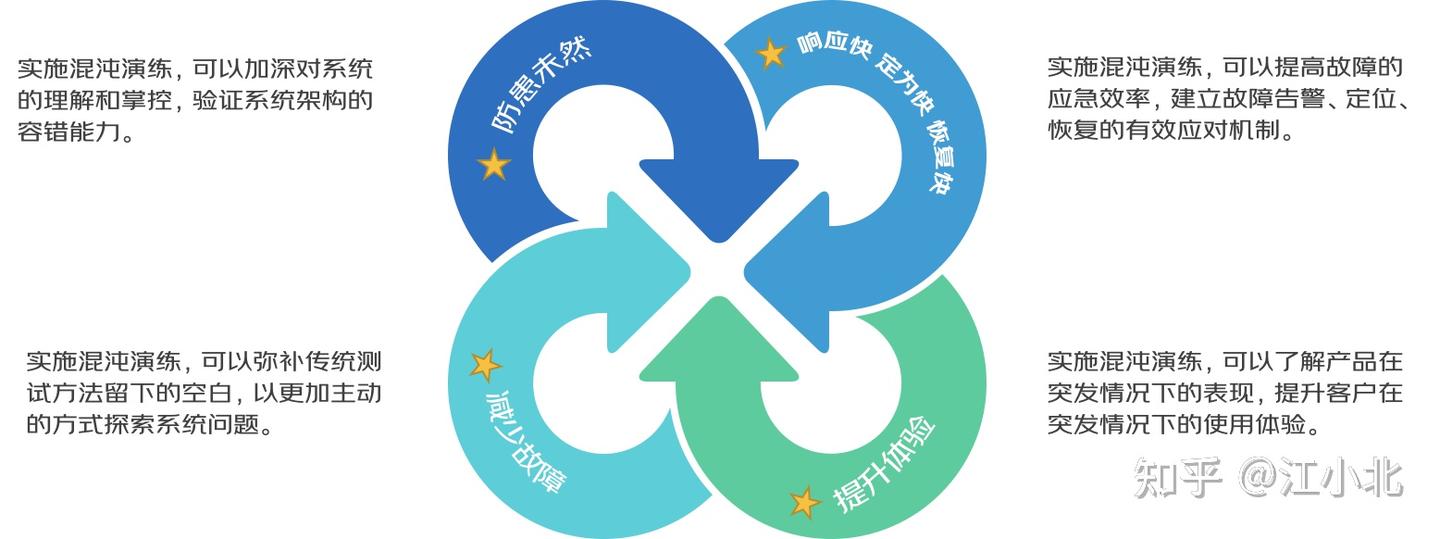
|
||||
|
||||
故障演练其实挺简单,就是模拟一些极端场景,比如机房断电、网络断开、服务挂掉,看看我们的系统能不能正常运行。这其实是个大工程,得按照混沌实验的框架来规划和设计,但一旦实施,效果非常好。不过,这需要大量人力来做基础设施的开发和支撑。
|
||||
|
||||
**线上运行阶段——接口拨测设计**
|
||||
|
||||
接口拨测,说白了就像是巡检。服务上线后,我们需要定时(比如每隔5秒)调用后端的各种接口,检查它们是否正常。如果发现接口异常,就立即报警。
|
||||
|
||||
接口拨测通常会有一些配套的工具来支持实现这个功能。如果没有这样的工具,那我们就只能自己开发一个接口拨测(巡检)服务,定期检查那些重要的接口,确保它们随时正常。
|
||||
|
||||
**七、异常应急层面**
|
||||
|
||||
虽然前面做了各种保障措施,但毕竟线上服务总会遇到一些不可预见的异常。服务出现问题、无法正常提供服务时,我们还得有一套应急预案,把损失降到最低。
|
||||
|
||||
应急预案的核心就是:在业务系统出现问题时,我们需要有明确的恢复步骤,知道第一时间该怎么应对。我们要事先制定好相关的规则和流程,一旦异常情况发生,就能按流程执行,避免手忙脚乱,导致问题扩大。
|
||||
|
||||
没有一个完备的应急预案,你的业务在遇到重大故障时,基本上就会瘫痪,完全失去控制。所以,做好预案,时刻保持应急准备,才是线上服务的“救命稻草”。
|
||||
@@ -0,0 +1,119 @@
|
||||
**高可用性(High Availability, HA)**和**稳定性(Stability)**是系统设计中两个密切相关但又有明显区别的概念。它们共同目标是提升系统的可靠性,但侧重点和实现方式有所不同。以下是它们的详细区别:
|
||||
|
||||
---
|
||||
|
||||
### 1. **定义与核心目标**
|
||||
|
||||
- **高可用性**:
|
||||
|
||||
- **定义**:系统能够在**长时间内持续提供服务**,尽量减少停机时间。
|
||||
- **核心目标**:确保系统在出现故障时能够快速恢复,减少对用户的影响。
|
||||
- **衡量指标**:通常用“可用性百分比”表示,例如99.9%(每年停机时间不超过8.76小时)。
|
||||
3 个 9 = 8 小时
|
||||
4 个 9 = 1 小时
|
||||
|
||||
- **稳定性**:
|
||||
|
||||
- **定义**:系统在**各种条件下**能够**持续、可靠地运行**,不会出现意外崩溃或性能波动。系统稳定性是指系统在运行过程中面对各种非预期事件影响下能够持续提供可靠服务的能力。
|
||||
|
||||
- **核心目标**:确保系统在长时间运行中表现一致,避免因内部或外部因素导致的异常。
|
||||
- **衡量指标**:通常用“平均无故障时间(MTBF)”和“故障率”来衡量。
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 2. **关注点**
|
||||
|
||||
- **高可用性**:
|
||||
- 关注系统在**故障发生时的应对能力**,强调**容错性**和**快速恢复**。
|
||||
- 重点解决的是**外部可见的停机问题**,即用户能否持续访问服务。
|
||||
|
||||
- **稳定性**:
|
||||
- 关注系统在**长时间运行中的表现**,强调**一致性和可靠性**。
|
||||
- 重点解决的是**内部性能问题**,如内存泄漏、资源竞争、死锁等,这些问题可能导致系统崩溃或性能下降。
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 3. **实现方式**
|
||||
|
||||
- **高可用性**:
|
||||
- **冗余设计**:通过主备节点、集群等方式,确保某个节点故障时其他节点可以接管。
|
||||
- **自动故障转移**:当检测到故障时,系统能够自动切换到备用节点。
|
||||
- **负载均衡**:将流量分散到多个节点,避免单点过载。
|
||||
- **灾难恢复**:通过异地备份和容灾机制,确保在极端情况下系统仍能恢复。
|
||||
|
||||
- **稳定性**:
|
||||
|
||||
- **代码质量**:通过严格的代码审查、测试和优化,减少潜在的缺陷。
|
||||
- **资源管理**:合理分配和管理系统资源(如内存、CPU、磁盘),避免资源耗尽。
|
||||
- **异常处理**:设计健壮的异常处理机制,防止局部故障扩散。
|
||||
- **性能优化**:通过算法优化、缓存机制等手段,提升系统性能并减少波动。
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 4. **故障场景**
|
||||
|
||||
- **高可用性**:
|
||||
- 主要应对**硬件故障**、**网络中断**、**数据中心故障**等外部问题。
|
||||
- 目标是**快速恢复服务**,减少停机时间。
|
||||
|
||||
- **稳定性**:
|
||||
- 主要应对**软件缺陷**、**资源竞争**、**内存泄漏**、**死锁**等内部问题。
|
||||
- 目标是**避免系统崩溃或性能下降**,确保长期可靠运行。
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 5. **用户感知**
|
||||
|
||||
- **高可用性**:
|
||||
- 用户感知的是**服务是否中断**。例如,网站是否能够访问,应用是否能够正常使用。
|
||||
- 高可用性差的系统会频繁出现“服务不可用”或“连接失败”等问题。
|
||||
|
||||
- **稳定性**:
|
||||
- 用户感知的是**服务是否稳定**。例如,应用是否卡顿、响应时间是否波动、功能是否异常。
|
||||
- 稳定性差的系统可能会出现性能下降、功能失效或意外崩溃。
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 6. **时间维度**
|
||||
|
||||
- **高可用性**:
|
||||
|
||||
- 更关注**短期内的服务连续性**,即在故障发生时能否快速恢复。
|
||||
|
||||
- **稳定性**:
|
||||
|
||||
- 更关注**长期的系统表现**,即在长时间运行中是否能够保持一致性和可靠性。
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 7. **示例**
|
||||
|
||||
- **高可用性示例**:
|
||||
|
||||
- 一个电商网站在“双11”期间,即使某个服务器故障,也能通过负载均衡和自动故障转移,确保用户仍能正常下单。
|
||||
|
||||
- **稳定性示例**:
|
||||
|
||||
- 同一个电商网站在长时间运行中,不会因为内存泄漏或数据库连接池耗尽而导致性能下降或崩溃。
|
||||
|
||||
|
||||
---
|
||||
|
||||
### 总结
|
||||
|
||||
| **特性** | **高可用性** | **稳定性** |
|
||||
| -------- | ---------------- | -------------------- |
|
||||
| **核心目标** | 减少停机时间,确保服务连续性 | 确保系统长期可靠运行,避免性能波动或崩溃 |
|
||||
| **关注点** | 故障恢复、容错性、灾难恢复 | 代码质量、资源管理、异常处理 |
|
||||
| **实现方式** | 冗余设计、自动故障转移、负载均衡 | 代码优化、资源管理、性能调优 |
|
||||
| **故障场景** | 硬件故障、网络中断、数据中心故障 | 软件缺陷、资源竞争、内存泄漏 |
|
||||
| **用户感知** | 服务是否中断 | 服务是否稳定 |
|
||||
| **时间维度** | 短期内的服务连续性 | 长期的系统表现 |
|
||||
|
||||
简而言之,**高可用性**关注的是系统在故障发生时能否快速恢复并继续提供服务,而**稳定性**关注的是系统在长时间运行中是否能够保持可靠和一致的表现。两者相辅相成,共同构成一个健壮的系统。
|
||||
Reference in New Issue
Block a user