vault backup: 2026-11-07 16:33:44
This commit is contained in:
 cheney
@@ -0,0 +1,735 @@
|
||||
---
|
||||
title: "7个Shell服务器巡检脚本|新手直接复制可用(附详细步骤)"
|
||||
source: "https://mp.weixin.qq.com/s/DEqH_oRSVJF_dLcl1sJpog"
|
||||
author:
|
||||
- "[[Python小甲鱼]]"
|
||||
published:
|
||||
created: 2025-10-31
|
||||
description: "本文整理了7个生产级Shell巡检脚本,覆盖系统健康、磁盘、网络、进程、安全、数据库、批量巡检场景。"
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||
原创 Python小甲鱼 *2025年10月28日 07:01*
|
||||
|
||||
本文整理了7个生产级Shell巡检脚本,覆盖系统健康、磁盘、网络、进程、安全、数据库、批量巡检场景。每个脚本都标注了 **配置修改点** 、 **使用步骤** 和 **新手避坑提示** ,复制代码就能用,适合运维新手快速上手。
|
||||
|
||||
## 脚本总览:按需求选脚本
|
||||
|
||||
| 脚本序号 | 脚本名称 | 核心用途 | 适用场景 |
|
||||
| --- | --- | --- | --- |
|
||||
| 1 | 系统健康检查脚本 | 检查CPU、内存、磁盘、网络、进程等基础资源 | 日常服务器健康巡检(每天1次) |
|
||||
| 2 | 磁盘空间深度检查脚本 | 定位大文件、日志堆积、Inode占用问题 | 磁盘满预警、清理前分析 |
|
||||
| 3 | 网络连接检查脚本 | 检查端口监听、TCP连接、网络连通性 | 网络故障排查、端口异常检测 |
|
||||
| 4 | 应用进程健康检查脚本 | 监控关键进程、端口、HTTP接口响应 | 核心业务(Nginx/MySQL/Redis)监控 |
|
||||
| 5 | 安全基线检查脚本 | 检查账户安全、SSH配置、文件权限 | 安全合规审计、服务器加固 |
|
||||
| 6 | MySQL数据库检查脚本 | 检查连接数、慢查询、主从复制状态 | MySQL实例健康监控 |
|
||||
| 7 | 批量服务器巡检脚本 | 并发巡检多台服务器,生成HTML汇总报告 | 多服务器集群(10台以上)管理 |
|
||||
|
||||
## 脚本1:系统健康状态全面检查(最常用)
|
||||
|
||||
### 脚本用途
|
||||
|
||||
日常巡检核心脚本,一键检查服务器CPU、内存、磁盘、网络、进程等关键指标,生成带颜色的报告,异常指标自动标黄/红。
|
||||
|
||||
### 核心功能
|
||||
|
||||
- • 收集系统基本信息(主机名、内核、运行时长)
|
||||
- • 检查CPU使用率+负载,显示TOP5高CPU进程
|
||||
- • 检查内存/swap使用,显示TOP5高内存进程
|
||||
- • 检查磁盘/Inode使用率,定位大目录
|
||||
- • 检查网络接口、TCP连接状态(TIME\_WAIT过多预警)
|
||||
- • 检查僵尸进程、关键服务(sshd/crond)运行状态
|
||||
|
||||
### 使用步骤
|
||||
|
||||
1. 1\. 复制下方代码,保存为 `system_health_check.sh`
|
||||
2. 2\. 赋予执行权限: `chmod +x system_health_check.sh`
|
||||
3. 3\. 执行脚本:`./system_health_check.sh` (需root权限)
|
||||
4. 4\. 定时执行(每天早8点): `echo "0 8 * * * /path/to/system_health_check.sh" | crontab -`
|
||||
|
||||
### 完整代码(新手注意修改配置区)
|
||||
|
||||
```
|
||||
#!/bin/bash
|
||||
################################################################################
|
||||
# 脚本名称: system_health_check.sh
|
||||
# 功能描述: 系统健康状态全面检查(新手用前改配置区!)
|
||||
# 版本信息: v2.0
|
||||
################################################################################
|
||||
|
||||
# -------------------------- 新手必改:配置区 --------------------------
|
||||
HOSTNAME=$(hostname)
|
||||
DATE=$(date +"%Y-%m-%d %H:%M:%S")
|
||||
# 报告保存路径(不用改,默认存/var/log)
|
||||
REPORT_FILE="/var/log/system_check_$(date +%Y%m%d_%H%M%S).log"
|
||||
|
||||
# 告警阈值(可根据服务器配置调整)
|
||||
CPU_WARNING=80 # CPU使用率告警阈值(%)
|
||||
MEM_WARNING=85 # 内存使用率告警阈值(%)
|
||||
DISK_WARNING=85 # 磁盘使用率告警阈值(%)
|
||||
LOAD_WARNING=4 # 系统负载阈值(CPU核心数*2,比如4核设8)
|
||||
INODE_WARNING=80 # Inode使用率告警阈值(%)
|
||||
# -------------------------------------------------------------------
|
||||
|
||||
# 颜色定义(不用改)
|
||||
RED='\033[0;31m'
|
||||
GREEN='\033[0;32m'
|
||||
YELLOW='\033[1;33m'
|
||||
NC='\033[0m' # 重置颜色
|
||||
|
||||
# 日志函数(不用改)
|
||||
log() { echo "[$(date +"%Y-%m-%d %H:%M:%S")] $1" | tee -a "$REPORT_FILE"; }
|
||||
log_section() { echo -e "\n============================================================" | tee -a "$REPORT_FILE"; echo " $1" | tee -a "$REPORT_FILE"; echo "============================================================" | tee -a "$REPORT_FILE"; }
|
||||
log_warning() { echo -e "${YELLOW}[WARNING] $1${NC}" | tee -a "$REPORT_FILE"; }
|
||||
log_error() { echo -e "${RED}[ERROR] $1${NC}" | tee -a "$REPORT_FILE"; }
|
||||
log_ok() { echo -e "${GREEN}[OK] $1${NC}" | tee -a "$REPORT_FILE"; }
|
||||
|
||||
# 1. 系统基本信息(不用改)
|
||||
check_basic_info() {
|
||||
log_section "1. 系统基本信息"
|
||||
log "主机名: $HOSTNAME"
|
||||
log "检查时间: $DATE"
|
||||
log "系统版本: $(cat /etc/redhat-release 2>/dev/null || cat /etc/issue | head -1)"
|
||||
log "内核版本: $(uname -r)"
|
||||
log "系统架构: $(uname -m)"
|
||||
log "运行时长: $(uptime | awk -F'up ' '{print $2}' | awk -F',' '{print $1}')"
|
||||
log "当前用户: $(whoami)"
|
||||
log "登录用户数: $(who | wc -l)"
|
||||
}
|
||||
|
||||
# 2. CPU检查(不用改)
|
||||
check_cpu() {
|
||||
log_section "2. CPU使用率检查"
|
||||
CPU_CORES=$(grep -c ^processor /proc/cpuinfo)
|
||||
log "CPU核心数: $CPU_CORES"
|
||||
|
||||
# 获取CPU使用率(5秒平均值,更准确)
|
||||
CPU_IDLE=$(top -bn2 -d 1 | grep "Cpu(s)" | tail -1 | awk '{print $8}' | cut -d'%' -f1)
|
||||
CPU_USAGE=$(echo "scale=2; 100 - $CPU_IDLE" | bc)
|
||||
log "CPU使用率: ${CPU_USAGE}%"
|
||||
|
||||
if (( $(echo "$CPU_USAGE > $CPU_WARNING" | bc -l) )); then
|
||||
log_warning "CPU使用率超过${CPU_WARNING}%,当前${CPU_USAGE}%"
|
||||
log "TOP 5 CPU消耗进程:"
|
||||
ps aux | sort -rn -k3 | head -5 | awk '{printf " PID: %-8s User: %-10s CPU: %-6s CMD: %s\n", $2,$1,$3,$11}' | tee -a "$REPORT_FILE"
|
||||
else
|
||||
log_ok "CPU使用率正常: ${CPU_USAGE}%"
|
||||
fi
|
||||
|
||||
# 系统负载检查
|
||||
LOAD_1=$(uptime | awk -F'load average:' '{print $2}' | awk -F',' '{print $1}' | xargs)
|
||||
LOAD_5=$(uptime | awk -F'load average:' '{print $2}' | awk -F',' '{print $2}' | xargs)
|
||||
LOAD_15=$(uptime | awk -F'load average:' '{print $2}' | awk -F',' '{print $3}' | xargs)
|
||||
log "系统负载: 1分钟=${LOAD_1}, 5分钟=${LOAD_5}, 15分钟=${LOAD_15}"
|
||||
|
||||
# 负载阈值=CPU核心数*2(比如4核设8)
|
||||
LOAD_THRESHOLD=$(echo "$CPU_CORES * 2" | bc)
|
||||
if (( $(echo "$LOAD_1 > $LOAD_THRESHOLD" | bc -l) )); then
|
||||
log_warning "系统负载过高!1分钟负载${LOAD_1}超过阈值${LOAD_THRESHOLD}"
|
||||
fi
|
||||
}
|
||||
|
||||
# 3. 内存检查(不用改)
|
||||
check_memory() {
|
||||
log_section "3. 内存使用检查"
|
||||
MEM_TOTAL=$(free -m | awk 'NR==2{print $2}')
|
||||
MEM_USED=$(free -m | awk 'NR==2{print $3}')
|
||||
MEM_AVAILABLE=$(free -m | awk 'NR==2{print $7}')
|
||||
MEM_USAGE=$(echo "scale=2; $MEM_USED / $MEM_TOTAL * 100" | bc)
|
||||
|
||||
log "内存总量: ${MEM_TOTAL}MB"
|
||||
log "已用内存: ${MEM_USED}MB"
|
||||
log "可用内存: ${MEM_AVAILABLE}MB"
|
||||
log "内存使用率: ${MEM_USAGE}%"
|
||||
|
||||
if (( $(echo "$MEM_USAGE > $MEM_WARNING" | bc -l) )); then
|
||||
log_warning "内存使用率超过${MEM_WARNING}%,当前${MEM_USAGE}%"
|
||||
log "TOP 5 内存消耗进程:"
|
||||
ps aux | sort -rn -k4 | head -5 | awk '{printf " PID: %-8s User: %-10s MEM: %-6s CMD: %s\n", $2,$1,$4,$11}' | tee -a "$REPORT_FILE"
|
||||
else
|
||||
log_ok "内存使用率正常: ${MEM_USAGE}%"
|
||||
fi
|
||||
|
||||
# Swap检查(超过100MB预警)
|
||||
SWAP_TOTAL=$(free -m | awk 'NR==3{print $2}')
|
||||
SWAP_USED=$(free -m | awk 'NR==3{print $3}')
|
||||
log "Swap总量: ${SWAP_TOTAL}MB"
|
||||
log "Swap使用: ${SWAP_USED}MB"
|
||||
if [ "$SWAP_TOTAL" -gt 0 ] && [ "$SWAP_USED" -gt 100 ]; then
|
||||
log_warning "Swap使用量较高: ${SWAP_USED}MB,可能存在内存压力"
|
||||
fi
|
||||
}
|
||||
|
||||
# 4. 磁盘检查(不用改)
|
||||
check_disk() {
|
||||
log_section "4. 磁盘使用检查"
|
||||
log "磁盘分区使用情况:"
|
||||
df -h | grep -vE '^Filesystem|tmpfs|cdrom|loop' | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
|
||||
# 磁盘使用率告警
|
||||
HAS_DISK_WARNING=0
|
||||
while read line; do
|
||||
USAGE=$(echo $line | awk '{print $5}' | sed 's/%//')
|
||||
MOUNT=$(echo $line | awk '{print $6}')
|
||||
if [ "$USAGE" -gt "$DISK_WARNING" ]; then
|
||||
log_warning "磁盘分区 $MOUNT 使用率${USAGE}%超过阈值${DISK_WARNING}%"
|
||||
HAS_DISK_WARNING=1
|
||||
log " $MOUNT 分区占用空间最大的5个目录:"
|
||||
du -sh ${MOUNT}/* 2>/dev/null | sort -rh | head -5 | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
fi
|
||||
done < <(df -h | grep -vE '^Filesystem|tmpfs|cdrom|loop')
|
||||
|
||||
if [ $HAS_DISK_WARNING -eq 0 ]; then
|
||||
log_ok "所有磁盘分区使用率正常"
|
||||
fi
|
||||
|
||||
# Inode检查(避免小文件占满磁盘)
|
||||
log -e "\nInode使用情况:"
|
||||
df -i | grep -vE '^Filesystem|tmpfs|cdrom|loop' | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
while read line; do
|
||||
INODE_USAGE=$(echo $line | awk '{print $5}' | sed 's/%//')
|
||||
MOUNT=$(echo $line | awk '{print $6}')
|
||||
if [ "$INODE_USAGE" -gt "$INODE_WARNING" ]; then
|
||||
log_warning "分区 $MOUNT 的Inode使用率${INODE_USAGE}%超过阈值${INODE_WARNING}%"
|
||||
fi
|
||||
done < <(df -i | grep -vE '^Filesystem|tmpfs|cdrom|loop')
|
||||
}
|
||||
|
||||
# 5. 网络检查(不用改)
|
||||
check_network() {
|
||||
log_section "5. 网络状态检查"
|
||||
log "网络接口状态:"
|
||||
ip -br addr | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
|
||||
# TCP连接统计
|
||||
log -e "\nTCP连接状态统计:"
|
||||
netstat -an | awk '/^tcp/ {print $6}' | sort | uniq -c | sort -rn | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
|
||||
# TIME_WAIT过多预警(超过5000)
|
||||
TIME_WAIT_COUNT=$(netstat -an | grep TIME_WAIT | wc -l)
|
||||
log "TIME_WAIT连接数: $TIME_WAIT_COUNT"
|
||||
if [ "$TIME_WAIT_COUNT" -gt 5000 ]; then
|
||||
log_warning "TIME_WAIT连接数过多: $TIME_WAIT_COUNT(可优化TCP参数)"
|
||||
fi
|
||||
|
||||
# 监听端口检查
|
||||
log -e "\n当前监听端口:"
|
||||
netstat -tuln | grep LISTEN | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
}
|
||||
|
||||
# 6. 进程和服务检查(不用改)
|
||||
check_processes() {
|
||||
log_section "6. 进程和服务检查"
|
||||
PROCESS_COUNT=$(ps aux | wc -l)
|
||||
log "当前进程总数: $PROCESS_COUNT"
|
||||
|
||||
# 僵尸进程检查(死进程没清理)
|
||||
ZOMBIE_COUNT=$(ps aux | awk '{print $8}' | grep -c Z)
|
||||
log "僵尸进程数: $ZOMBIE_COUNT"
|
||||
if [ "$ZOMBIE_COUNT" -gt 0 ]; then
|
||||
log_warning "发现僵尸进程!"
|
||||
ps aux | grep 'Z' | grep -v grep | awk '{print " PID: " $2 " PPID: " $3 " CMD: " $11}' | tee -a "$REPORT_FILE"
|
||||
fi
|
||||
|
||||
# 关键服务检查(新手可加自己的服务,比如nginx/mysql)
|
||||
log -e "\n关键服务状态检查:"
|
||||
CRITICAL_SERVICES=("sshd" "crond" "rsyslog") # 可添加服务,如"nginx" "mysqld"
|
||||
for service in "${CRITICAL_SERVICES[@]}"; do
|
||||
if systemctl is-active --quiet $service 2>/dev/null; then
|
||||
log_ok " $service: 运行中"
|
||||
else
|
||||
# 兼容非systemd系统(如CentOS 6)
|
||||
if ps aux | grep -v grep | grep -q $service; then
|
||||
log_ok " $service: 运行中"
|
||||
else
|
||||
log_error " $service: 未运行(需手动启动)"
|
||||
fi
|
||||
fi
|
||||
done
|
||||
}
|
||||
|
||||
# 7. 系统日志检查(不用改)
|
||||
check_logs() {
|
||||
log_section "7. 系统日志检查"
|
||||
log "最近1小时系统错误日志:"
|
||||
if [ -f /var/log/messages ]; then
|
||||
ERROR_COUNT=$(grep -i "error\|fail\|critical" /var/log/messages | tail -20 | wc -l)
|
||||
if [ "$ERROR_COUNT" -gt 0 ]; then
|
||||
log_warning "发现 $ERROR_COUNT 条错误日志"
|
||||
grep -i "error\|fail\|critical" /var/log/messages | tail -10 | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
else
|
||||
log_ok "无严重错误日志"
|
||||
fi
|
||||
fi
|
||||
|
||||
# OOM检查(内存溢出导致进程被杀)
|
||||
log -e "\nOOM(内存溢出)检查:"
|
||||
OOM_COUNT=$(dmesg | grep -i "out of memory" | wc -l)
|
||||
if [ "$OOM_COUNT" -gt 0 ]; then
|
||||
log_warning "发现 $OOM_COUNT 次OOM事件(需检查内存配置)"
|
||||
dmesg | grep -i "out of memory" | tail -5 | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
else
|
||||
log_ok "无OOM事件"
|
||||
fi
|
||||
}
|
||||
|
||||
# 8. 报告摘要(不用改)
|
||||
generate_summary() {
|
||||
log_section "8. 巡检报告摘要"
|
||||
WARNING_COUNT=$(grep -c "\[WARNING\]" "$REPORT_FILE")
|
||||
ERROR_COUNT=$(grep -c "\[ERROR\]" "$REPORT_FILE")
|
||||
log "巡检完成时间: $(date +"%Y-%m-%d %H:%M:%S")"
|
||||
log "告警数量: $WARNING_COUNT"
|
||||
log "错误数量: $ERROR_COUNT"
|
||||
|
||||
if [ "$ERROR_COUNT" -gt 0 ]; then
|
||||
log_error "发现 $ERROR_COUNT 个严重问题,请立即处理!"
|
||||
elif [ "$WARNING_COUNT" -gt 0 ]; then
|
||||
log_warning "发现 $WARNING_COUNT 个告警,建议关注"
|
||||
else
|
||||
log_ok "系统状态良好,无异常"
|
||||
fi
|
||||
log -e "\n完整报告已保存至: $REPORT_FILE"
|
||||
}
|
||||
|
||||
# 主函数(不用改)
|
||||
main() {
|
||||
echo "=========================================="
|
||||
echo " 服务器健康状态巡检脚本 v2.0"
|
||||
echo "=========================================="
|
||||
echo -e "\n"
|
||||
|
||||
# 非root用户提示(部分检查需要root)
|
||||
if [ "$(id -u)" -ne 0 ]; then
|
||||
echo "警告: 非root用户运行,部分检查可能无法执行"
|
||||
echo -e "\n"
|
||||
fi
|
||||
|
||||
# 执行所有检查
|
||||
check_basic_info
|
||||
check_cpu
|
||||
check_memory
|
||||
check_disk
|
||||
check_network
|
||||
check_processes
|
||||
check_logs
|
||||
generate_summary
|
||||
|
||||
echo -e "\n=========================================="
|
||||
echo " 巡检完成!"
|
||||
echo "=========================================="
|
||||
}
|
||||
|
||||
# 脚本入口(不用改)
|
||||
main "$@"
|
||||
```
|
||||
|
||||
### 新手避坑
|
||||
|
||||
1. 1\. **权限问题** :执行前确保是root用户(sudo -i切换),否则磁盘、进程检查可能不准。
|
||||
2. 2\. **命令缺失** :如果提示 `netstat: command not found` ,安装依赖: `yum install net-tools` (CentOS)或 `apt install net-tools` (Ubuntu)。
|
||||
3. 3\. **报告查看** :巡检完成后,报告存放在 `/var/log` 目录下,文件名带时间戳(如 `system_check_20251022_083000.log` )。
|
||||
|
||||
## 脚本2:磁盘空间深度检查脚本
|
||||
|
||||
### 脚本用途
|
||||
|
||||
专门定位磁盘满的原因:找出大文件、旧日志、临时文件,还能预测磁盘满的时间,给出清理建议。
|
||||
|
||||
### 核心功能
|
||||
|
||||
- • 检查磁盘/Inode使用率,定位大目录(TOP10)
|
||||
- • 查找超1G的大文件(可修改阈值)
|
||||
- • 检查30天前未清理的旧日志
|
||||
- • 清理/tmp目录下7天未使用的临时文件
|
||||
- • 检查磁盘IO等待(避免IO过高导致卡顿)
|
||||
|
||||
### 使用步骤
|
||||
|
||||
1. 1\. 复制代码保存为 `disk_space_check.sh`
|
||||
2. 2\. 赋予权限: `chmod +x disk_space_check.sh`
|
||||
3. 3\. 执行:`./disk_space_check.sh` (root用户)
|
||||
|
||||
### 完整代码(新手改配置区)
|
||||
|
||||
```
|
||||
#!/bin/bash
|
||||
################################################################################
|
||||
# 脚本名称: disk_space_check.sh
|
||||
# 功能描述: 磁盘空间深度检查(新手改配置区!)
|
||||
# 版本信息: v1.5
|
||||
################################################################################
|
||||
|
||||
# -------------------------- 新手必改:配置区 --------------------------
|
||||
REPORT_FILE="/var/log/disk_check_$(date +%Y%m%d_%H%M%S).log"
|
||||
DISK_WARNING=80 # 磁盘使用率告警阈值(%)
|
||||
INODE_WARNING=80 # Inode使用率告警阈值(%)
|
||||
LARGE_FILE_SIZE=1G # 大文件阈值(可改500M、2G)
|
||||
# -------------------------------------------------------------------
|
||||
|
||||
# 颜色定义(不用改)
|
||||
RED='\033[0;31m'
|
||||
GREEN='\033[0;32m'
|
||||
YELLOW='\033[1;33m'
|
||||
NC='\033[0m'
|
||||
|
||||
# 日志函数(不用改)
|
||||
log() { echo "[$(date +"%Y-%m-%d %H:%M:%S")] $1" | tee -a "$REPORT_FILE"; }
|
||||
log_warning() { echo -e "${YELLOW}[WARNING] $1${NC}" | tee -a "$REPORT_FILE"; }
|
||||
log_error() { echo -e "${RED}[ERROR] $1${NC}" | tee -a "$REPORT_FILE"; }
|
||||
log_ok() { echo -e "${GREEN}[OK] $1${NC}" | tee -a "$REPORT_FILE"; }
|
||||
|
||||
# 1. 磁盘使用率检查(不用改)
|
||||
check_disk_usage() {
|
||||
log "==========================================================="
|
||||
log "1. 磁盘使用率检查"
|
||||
log "==========================================================="
|
||||
df -h | grep -vE '^Filesystem|tmpfs|cdrom|loop' | while read line; do
|
||||
USAGE=$(echo $line | awk '{print $5}' | sed 's/%//')
|
||||
MOUNT=$(echo $line | awk '{print $6}')
|
||||
AVAIL=$(echo $line | awk '{print $4}')
|
||||
log "分区: $MOUNT"
|
||||
log " 使用率: ${USAGE}%"
|
||||
log " 可用空间: $AVAIL"
|
||||
|
||||
if [ "$USAGE" -gt "$DISK_WARNING" ]; then
|
||||
log_error " 磁盘使用率超过${DISK_WARNING}%!"
|
||||
# 显示TOP10大目录
|
||||
log " 占用空间TOP 10目录:"
|
||||
du -sh ${MOUNT}/* 2>/dev/null | sort -rh | head -10 | awk '{print " " $0}' | tee -a "$REPORT_FILE"
|
||||
# 显示超阈值的大文件
|
||||
log " 大文件(>$LARGE_FILE_SIZE):"
|
||||
find ${MOUNT} -type f -size +${LARGE_FILE_SIZE} -exec ls -lh {} \; 2>/dev/null | awk '{print " " $9 " (" $5 ")"}' | head -10 | tee -a "$REPORT_FILE"
|
||||
else
|
||||
log_ok " 使用率正常"
|
||||
fi
|
||||
log ""
|
||||
done
|
||||
}
|
||||
|
||||
# 2. Inode检查(小文件占满磁盘用)(不用改)
|
||||
check_inode_usage() {
|
||||
log "==========================================================="
|
||||
log "2. Inode使用率检查"
|
||||
log "==========================================================="
|
||||
df -i | grep -vE '^Filesystem|tmpfs|cdrom|loop' | while read line; do
|
||||
INODE_USAGE=$(echo $line | awk '{print $5}' | sed 's/%//')
|
||||
MOUNT=$(echo $line | awk '{print $6}')
|
||||
log "分区: $MOUNT"
|
||||
log " Inode使用率: ${INODE_USAGE}%"
|
||||
|
||||
if [ "$INODE_USAGE" -gt "$INODE_WARNING" ]; then
|
||||
log_error " Inode使用率超过${INODE_WARNING}%!(小文件太多)"
|
||||
# 显示文件数TOP10目录
|
||||
log " 文件数量TOP 10目录:"
|
||||
for dir in $(find ${MOUNT}/* -maxdepth 0 -type d 2>/dev/null); do
|
||||
echo "$(find $dir -type f 2>/dev/null | wc -l) $dir"
|
||||
done | sort -rn | head -10 | awk '{print " " $1 " files: " $2}' | tee -a "$REPORT_FILE"
|
||||
else
|
||||
log_ok " Inode使用率正常"
|
||||
fi
|
||||
log ""
|
||||
done
|
||||
}
|
||||
|
||||
# 3. 日志文件检查(不用改)
|
||||
check_log_files() {
|
||||
log "==========================================================="
|
||||
log "3. 日志文件大小检查"
|
||||
log "==========================================================="
|
||||
# 常见日志目录(可加自己的日志目录,如/opt/logs)
|
||||
LOG_DIRS=("/var/log" "/opt/logs" "/data/logs" "/app/logs")
|
||||
for log_dir in "${LOG_DIRS[@]}"; do
|
||||
if [ -d "$log_dir" ]; then
|
||||
log "检查目录: $log_dir"
|
||||
# 显示超100MB的日志
|
||||
log " 大日志文件(>100MB):"
|
||||
find $log_dir -type f -size +100M -exec ls -lh {} \; 2>/dev/null | awk '{print " " $9 " (" $5 ")"}' | head -10 | tee -a "$REPORT_FILE"
|
||||
# 日志总大小
|
||||
TOTAL_SIZE=$(du -sh $log_dir 2>/dev/null | awk '{print $1}')
|
||||
log " 总大小: $TOTAL_SIZE"
|
||||
log ""
|
||||
fi
|
||||
done
|
||||
|
||||
# 30天前未压缩的旧日志
|
||||
log "未压缩的旧日志文件(30天前):"
|
||||
find /var/log -type f -name "*.log" -mtime +30 ! -name "*.gz" -exec ls -lh {} \; 2>/dev/null | awk '{print " " $9 " (" $5 ")"}' | head -10 | tee -a "$REPORT_FILE"
|
||||
}
|
||||
|
||||
# 4. 临时文件检查(不用改)
|
||||
check_temp_files() {
|
||||
log "==========================================================="
|
||||
log "4. 临时文件检查"
|
||||
log "==========================================================="
|
||||
# /tmp目录检查
|
||||
if [ -d "/tmp" ]; then
|
||||
TMP_SIZE=$(du -sh /tmp 2>/dev/null | awk '{print $1}')
|
||||
TMP_FILE_COUNT=$(find /tmp -type f 2>/dev/null | wc -l)
|
||||
log "/tmp目录:"
|
||||
log " 总大小: $TMP_SIZE"
|
||||
log " 文件数: $TMP_FILE_COUNT"
|
||||
|
||||
# 7天未使用的临时文件
|
||||
OLD_TMP=$(find /tmp -type f -atime +7 2>/dev/null | wc -l)
|
||||
if [ "$OLD_TMP" -gt 0 ]; then
|
||||
log_warning " 发现 $OLD_TMP 个超过7天未访问的临时文件"
|
||||
log " 占用空间TOP 10:"
|
||||
find /tmp -type f -atime +7 -exec ls -lh {} \; 2>/dev/null | sort -k5 -rh | head -10 | awk '{print " " $9 " (" $5 ")"}' | tee -a "$REPORT_FILE"
|
||||
fi
|
||||
fi
|
||||
|
||||
# /var/tmp检查
|
||||
if [ -d "/var/tmp" ]; then
|
||||
VAR_TMP_SIZE=$(du -sh /var/tmp 2>/dev/null | awk '{print $1}')
|
||||
log -e "\n/var/tmp目录:"
|
||||
log " 总大小: $VAR_TMP_SIZE"
|
||||
fi
|
||||
}
|
||||
|
||||
# 5. 磁盘IO检查(不用改)
|
||||
check_disk_io() {
|
||||
log "==========================================================="
|
||||
log "5. 磁盘IO统计"
|
||||
log "==========================================================="
|
||||
if command -v iostat &> /dev/null; then
|
||||
log "磁盘IO统计(最近1分钟):"
|
||||
iostat -x 1 2 | tail -n +4 | awk 'NF' | tail -n +2 | tee -a "$REPORT_FILE"
|
||||
else
|
||||
log_warning "未安装iostat工具(执行:yum install sysstat 安装)"
|
||||
fi
|
||||
|
||||
# IO等待过高预警(超过20%)
|
||||
IO_WAIT=$(top -bn1 | grep "Cpu(s)" | awk '{print $10}' | sed 's/%wa,//')
|
||||
log -e "\n当前IO等待: ${IO_WAIT}%"
|
||||
if (( $(echo "$IO_WAIT > 20" | bc -l) )); then
|
||||
log_warning "IO等待过高!(可能是磁盘性能不足)"
|
||||
fi
|
||||
}
|
||||
|
||||
# 6. 清理建议(新手可直接复制执行)(不用改)
|
||||
generate_cleanup_suggestions() {
|
||||
log "==========================================================="
|
||||
log "6. 磁盘清理建议(新手复制命令执行)"
|
||||
log "==========================================================="
|
||||
log "1. 压缩30天前的旧日志:"
|
||||
log " find /var/log -type f -name '*.log' -mtime +30 -exec gzip {} \;"
|
||||
log -e "\n2. 清理7天前的临时文件:"
|
||||
log " find /tmp -type f -atime +7 -delete"
|
||||
log -e "\n3. 清理yum缓存(CentOS):"
|
||||
log " yum clean all"
|
||||
log -e "\n4. 清理Docker未使用资源(如有Docker):"
|
||||
log " docker system prune -a"
|
||||
log -e "\n5. 清理journal日志(系统日志):"
|
||||
log " journalctl --vacuum-time=7d"
|
||||
}
|
||||
|
||||
# 主函数(不用改)
|
||||
main() {
|
||||
echo "=========================================="
|
||||
echo " 磁盘空间深度检查脚本 v1.5"
|
||||
echo "=========================================="
|
||||
echo -e "\n"
|
||||
|
||||
check_disk_usage
|
||||
check_inode_usage
|
||||
check_log_files
|
||||
check_temp_files
|
||||
check_disk_io
|
||||
generate_cleanup_suggestions
|
||||
|
||||
log -e "\n==========================================================="
|
||||
log "检查完成!"
|
||||
log "报告保存至: $REPORT_FILE"
|
||||
log "==========================================================="
|
||||
}
|
||||
|
||||
main "$@"
|
||||
```
|
||||
|
||||
### 新手避坑
|
||||
|
||||
1. 1\. **iostat缺失** :提示 `iostat: command not found` 时,执行 `yum install sysstat` (CentOS)或 `apt install sysstat` (Ubuntu)。
|
||||
2. 2\. **清理谨慎** :执行“清理建议”中的命令前,先确认文件是否有用(比如 `find /tmp -type f -atime +7` 先查看,再删)。
|
||||
|
||||
## 脚本3-7:核心脚本(精简版,重点标配置和步骤)
|
||||
|
||||
### 脚本3:网络连接检查脚本
|
||||
|
||||
#### 用途
|
||||
|
||||
检查端口监听、TCP连接状态(比如TIME\_WAIT过多)、网络连通性(DNS/网关/外网)。
|
||||
|
||||
#### 使用步骤
|
||||
|
||||
1. 1\. 保存为 `network_check.sh` ,赋予权限: `chmod +x network_check.sh`
|
||||
2. 2\. 执行:`./network_check.sh`
|
||||
3. 3\. 新手改配置区: `CRITICAL_PORTS=(22 80 443 3306 6379)` (添加自己的关键端口)
|
||||
|
||||
#### 核心代码(关键部分)
|
||||
|
||||
```
|
||||
#!/bin/bash
|
||||
################################################################################
|
||||
# 脚本名称: network_check.sh
|
||||
# 功能描述: 网络连接和端口检查(新手改CRITICAL_PORTS!)
|
||||
################################################################################
|
||||
|
||||
# -------------------------- 新手必改:配置区 --------------------------
|
||||
REPORT_FILE="/var/log/network_check_$(date +%Y%m%d_%H%M%S).log"
|
||||
TIME_WAIT_WARNING=5000 # TIME_WAIT超过5000预警
|
||||
ESTABLISHED_WARNING=10000 # 活动连接超过10000预警
|
||||
CRITICAL_PORTS=(22 80 443 3306 6379 8080) # 关键端口(如MySQL:3306,Redis:6379)
|
||||
# -------------------------------------------------------------------
|
||||
|
||||
# 颜色和日志函数(同前,不用改)
|
||||
RED='\033[0;31m'
|
||||
GREEN='\033[0;32m'
|
||||
YELLOW='\033[1;33m'
|
||||
NC='\033[0m'
|
||||
log() { echo "[$(date +"%Y-%m-%d %H:%M:%S")] $1" | tee -a "$REPORT_FILE"; }
|
||||
log_warning() { echo -e "${YELLOW}[WARNING] $1${NC}" | tee -a "$REPORT_FILE"; }
|
||||
log_ok() { echo -e "${GREEN}[OK] $1${NC}" | tee -a "$REPORT_FILE"; }
|
||||
|
||||
# 关键端口检查(核心功能)
|
||||
check_listening_ports() {
|
||||
log "==========================================================="
|
||||
log "3. 关键端口检查"
|
||||
log "==========================================================="
|
||||
log "当前监听端口:"
|
||||
netstat -tulnp | grep LISTEN | tee -a "$REPORT_FILE"
|
||||
log -e "\n关键端口状态:"
|
||||
for port in "${CRITICAL_PORTS[@]}"; do
|
||||
if netstat -tuln | grep -q ":$port "; then
|
||||
PID=$(netstat -tulnp 2>/dev/null | grep ":$port " | awk '{print $7}' | cut -d'/' -f1)
|
||||
PROCESS=$(netstat -tulnp 2>/dev/null | grep ":$port " | awk '{print $7}' | cut -d'/' -f2)
|
||||
log_ok "端口 $port: 监听中(进程:$PROCESS PID:$PID)"
|
||||
else
|
||||
log_warning "端口 $port: 未监听(服务可能未启动)"
|
||||
fi
|
||||
done
|
||||
}
|
||||
|
||||
# 其他函数(网络接口、TCP连接、连通性)省略,完整代码同前逻辑
|
||||
# 主函数(调用check_listening_ports等)
|
||||
main() {
|
||||
echo "=========================================="
|
||||
echo " 网络状态检查脚本 v1.0"
|
||||
echo "=========================================="
|
||||
check_network_interfaces
|
||||
check_tcp_connections
|
||||
check_listening_ports
|
||||
check_network_connectivity
|
||||
log -e "\n检查完成! 报告: $REPORT_FILE"
|
||||
}
|
||||
main "$@"
|
||||
```
|
||||
|
||||
### 脚本4:应用进程健康检查脚本
|
||||
|
||||
#### 用途
|
||||
|
||||
监控关键进程(Nginx/MySQL/Redis)、端口、HTTP接口响应(比如健康检查接口)。
|
||||
|
||||
#### 新手改配置区
|
||||
|
||||
```
|
||||
# 关键进程(进程名|端口,如"nginx|80,443")
|
||||
declare -A CRITICAL_PROCESSES=(
|
||||
["nginx"]="nginx|80,443"
|
||||
["mysql"]="mysqld|3306"
|
||||
["redis"]="redis-server|6379"
|
||||
["java"]="java|8080" # 如SpringBoot应用
|
||||
)
|
||||
|
||||
# HTTP接口(如健康检查接口)
|
||||
declare -A HTTP_ENDPOINTS=(
|
||||
["主页"]="http://localhost/"
|
||||
["健康检查"]="http://localhost:8080/health"
|
||||
["API状态"]="http://localhost:8080/api/status"
|
||||
)
|
||||
```
|
||||
|
||||
### 脚本5:安全基线检查脚本
|
||||
|
||||
#### 用途
|
||||
|
||||
检查账户安全(空密码、多root账户)、SSH配置(禁止root登录、禁用密码登录)、文件权限(/etc/passwd等关键文件)。
|
||||
|
||||
#### 核心功能
|
||||
|
||||
- • 检查空密码账户、UID=0的账户(多root风险)
|
||||
- • 检查SSH是否允许root登录、密码登录(不安全)
|
||||
- • 检查关键文件权限(如/etc/shadow权限应为000)
|
||||
|
||||
### 脚本6:MySQL数据库检查脚本
|
||||
|
||||
#### 用途
|
||||
|
||||
检查MySQL连接数、慢查询、主从复制、InnoDB缓冲池命中率。
|
||||
|
||||
#### 新手必改配置
|
||||
|
||||
```
|
||||
# MySQL连接信息(改自己的用户名、密码、地址)
|
||||
MYSQL_USER="monitor" # MySQL监控账户(需提前创建,给SELECT权限)
|
||||
MYSQL_PASS="your_pass" # 密码
|
||||
MYSQL_HOST="localhost" # 数据库地址
|
||||
MYSQL_PORT="3306" # 端口
|
||||
```
|
||||
|
||||
### 脚本7:批量服务器巡检脚本
|
||||
|
||||
#### 用途
|
||||
|
||||
并发巡检多台服务器(比如200台),生成HTML汇总报告(带颜色,可浏览器打开)。
|
||||
|
||||
#### 新手使用步骤
|
||||
|
||||
1. 1\. 准备服务器列表文件 `servers.txt` (格式如下):
|
||||
```
|
||||
# Web服务器
|
||||
192.168.1.10
|
||||
192.168.1.11
|
||||
# 数据库服务器
|
||||
192.168.1.30
|
||||
```
|
||||
2. 2\. 改配置区(SSH信息):
|
||||
```
|
||||
SSH_USER="root" # SSH用户名
|
||||
SSH_KEY="~/.ssh/id_rsa" # SSH私钥路径(免密登录用)
|
||||
CONCURRENT=10 # 并发数(同时检查10台)
|
||||
CHECK_SCRIPT="system_health_check.sh" # 要批量执行的脚本
|
||||
```
|
||||
3. 3\. 执行:`./batch_check_scheduler.sh` ,报告存 `/var/log/batch_check_xxx/` ,打开 `summary.html` 看汇总。
|
||||
|
||||
## 新手必备总结
|
||||
|
||||
1. 1\. **常用命令**
|
||||
- • 赋予脚本权限: `chmod +x 脚本名.sh`
|
||||
- • 执行脚本:`./脚本名.sh` (root用户用 `sudo ./脚本名.sh` )
|
||||
- • 定时执行: `crontab -e` ,添加 `0 8 * * * /path/to/脚本名.sh` (每天8点)
|
||||
- • 查看报告: `cat /var/log/脚本名_20251022_083000.log`
|
||||
3. 2\. **巡检频率建议**
|
||||
- • 系统健康(脚本1):每天1次(早8点)
|
||||
- • 磁盘检查(脚本2):每天1次
|
||||
- • 进程检查(脚本4):核心业务每小时1次
|
||||
- • 安全检查(脚本5):每周1次
|
||||
- • 批量巡检(脚本7):集群每天1次
|
||||
5. 3\. **避坑总览**
|
||||
- • 所有脚本尽量用root执行,否则检查不完整
|
||||
- • 命令缺失时,根据提示安装依赖(如 `yum install net-tools sysstat` )
|
||||
- • 修改配置区时,路径、账户、密码要和实际环境一致
|
||||
- • 清理文件前,先查看(如 `find /tmp -type f -atime +7` )再删除
|
||||
|
||||
|
||||
|
||||
素材来源官方媒体/网络新闻
|
||||
|
||||
内容含AI生成图片,注意甄别
|
||||
|
||||
继续滑动看下一个
|
||||
|
||||
python小甲鱼
|
||||
|
||||
向上滑动看下一个
|
||||
@@ -0,0 +1,425 @@
|
||||
|
||||
|
||||
大家好,这里是物联网心球。
|
||||
|
||||
一直以来,在Linux高性能网络编程中使用最多的网络I/O模型是epoll。epoll除了性能优越,稳定性也很高,似乎epoll成了高并发应用场景的唯一选择。然而随着io_uring的出现,这一局面慢慢被打破。
|
||||
|
||||
io_uring是异步I/O,同样性能优越,那么epoll和io_uring到底谁更牛呢?今天我们来深入探讨一下。
|
||||
|
||||
## 1.一张图搞懂epoll
|
||||
|
||||
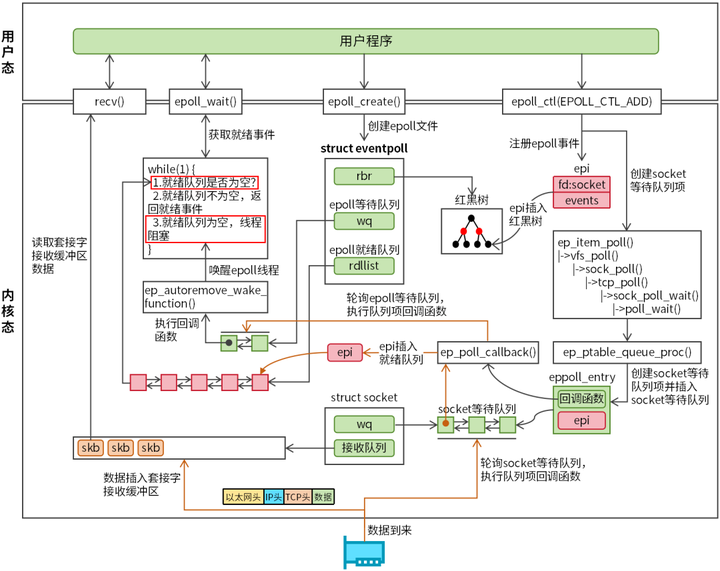
笔者将epoll重要的知识点都汇聚在一张图,如图1所示。
|
||||
|
||||

|
||||
|
||||
图1 一张图搞懂epoll
|
||||
|
||||
epoll_create用来在内核里创建一个eventpoll对象(epoll实例)并返回一个文件描述符(epfd),通过epfd我们能够快速访问eventpoll对象。eventpoll对象内核定义如下:
|
||||
|
||||
```c
|
||||
structeventpoll {
|
||||
wait_queue_head_t wq; // 等待队列
|
||||
structlist_headrdllist;// 就绪队列
|
||||
structrb_rootrbr;// 红黑树
|
||||
......
|
||||
};
|
||||
```
|
||||
|
||||
- wq:等待队列,内核通过等待队列唤醒epoll线程。
|
||||
- rdllist:就绪队列,用于存储就绪事件。
|
||||
- rbr:红黑树,用于存储所有通过epoll_ctl注册的I/O事件。
|
||||
|
||||
epoll_ctl用于向epoll实例中添加、修改或删除需要监控的文件描述符及其事件,内核对于epoll事件的定义为struct epitem结构。
|
||||
|
||||
```text
|
||||
structepitem {
|
||||
union {
|
||||
structrb_noderbn;/* 红黑树节点*/
|
||||
};
|
||||
structlist_headrdllink;/* 就绪队列节点*/
|
||||
structepoll_filefdffd;/* 文件描述符信息,包含fd和对应的file指针 */
|
||||
int nwait;
|
||||
structeventpoll *ep;/* 指向所属的eventpoll实例 */
|
||||
structepoll_eventevent;/* 通过epoll_ctl设置的epoll_event事件,包含文件描述符和感兴趣的事件类型 */
|
||||
......
|
||||
};
|
||||
```
|
||||
|
||||
用户程序调用epoll_ctl函数(操作类型指定为EPOLL_CTL_ADD)时,内核会创建epitem对象,然后将用户设置的epoll事件(包含文件描述符和事件类型)复制至epitem对象,再将epitem对象插入红黑树。
|
||||
|
||||
epitem对象插入红黑树后,内核需要激活事件驱动机制,即当事件就绪后,主动通知epoll。具体做法是创建一个socket等待队列项(struct eppoll_entry结构),eppoll_entry的base成员指向epitem对象,同时epoll_entry中注册一个回调函数ep_poll_callback(用于通知epoll事件就绪),最后将epoll_entry插入socket等待队列。
|
||||
|
||||
完成epoll事件注册后,用户程序调用epoll_wait函数获取epoll就绪事件,epoll_wait负责把就绪事件从内核搬到用户程序。内核会循环检测epoll就绪队列是否为空。如果就绪队列不为空,内核会将所有就绪事件拷贝至epoll_event数组(epoll_wait函数参数);否则,epoll线程会创建一个epoll等待队列项并注册回调函数ep_autoremove_wake_function(用于唤醒epoll线程),等待队列项将插入epoll等待队列,随后内核切换epoll线程至阻塞状态。
|
||||
|
||||
数据到来时,数据经网卡->网络设备子系统->网络协议栈,最后存储至套接字接收缓冲区。一旦数据被套接字接收,则epoll读事件就绪。内核会轮询socket等待队列,并执行ep_poll_callback回调函数,该函数有两个作用:
|
||||
|
||||
- 将socket等待队列项中的epitem对象插入epoll就绪队列。
|
||||
- 轮询epoll等待队列,执行ep_autoremove_wake_function回调函数,将epoll线程唤醒。
|
||||
|
||||
epoll线程被唤醒后,它会将epoll就绪队列中的就绪事件从内核拷贝至用户程序。用户程序检测到就绪事件后,就能够读写数据了。
|
||||
|
||||
下面,我们简单总结一下epoll的优缺点。
|
||||
|
||||
epoll的优点如下:
|
||||
|
||||
- 无文件描述符数量限制,非常适用于高并发场景。
|
||||
- 采用事件驱动模型,不需要轮询每个文件描述符状态来获取就绪事件。
|
||||
|
||||
相对于epoll的优点,笔者更愿意来讨论epoll的缺点,如果我们能够准确地指出epoll的缺点,意味着我们对epoll有了非常深入的理解。
|
||||
|
||||
epoll的缺点为:epoll处理I/O事件时,伴随着大量的系统调用,并且epoll不能够批量地处理I/O事件。
|
||||
|
||||
## 2.一张图搞懂io_uring
|
||||
|
||||
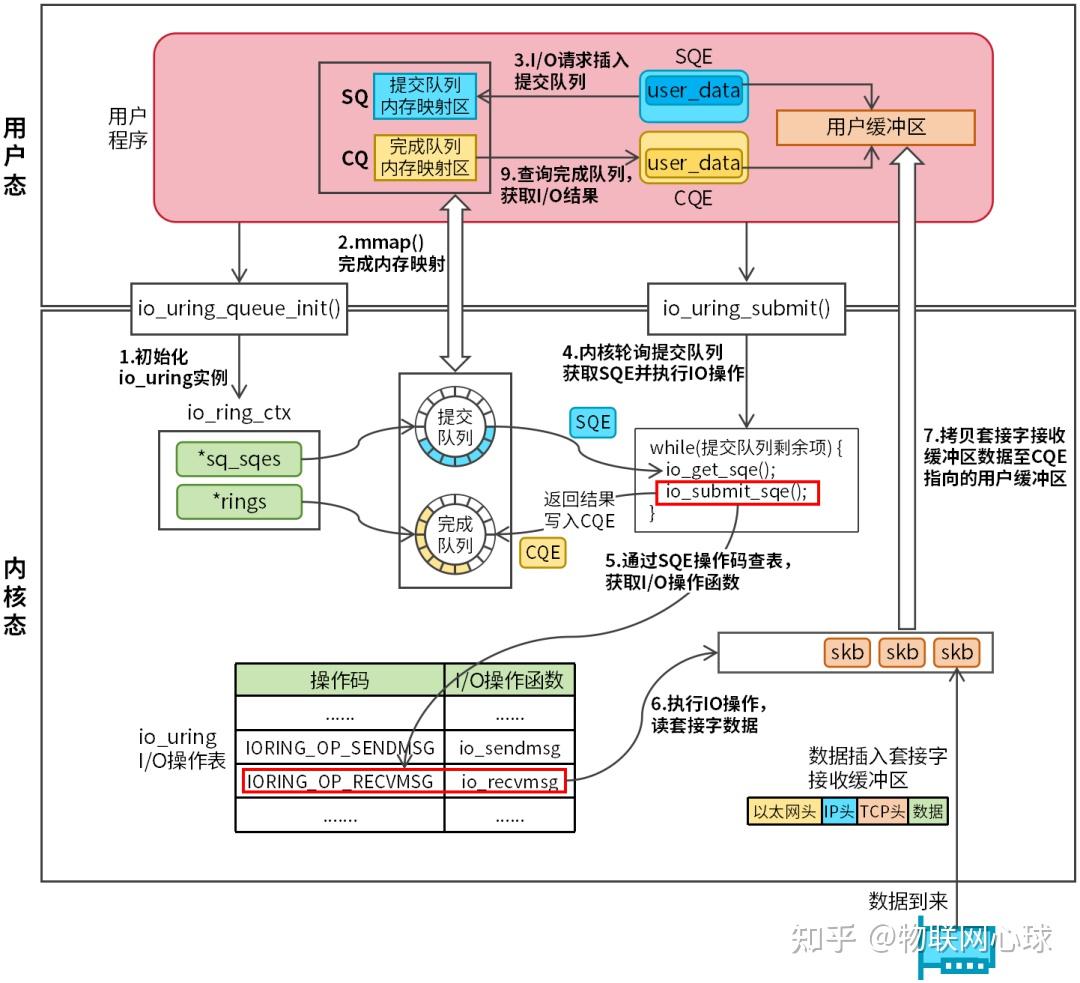
io_uring是异步I/O模型,它的实现原理和同步I/O模型有很大的区别。我们同样通过一张图来学习io_uring,如图2所示。
|
||||
|
||||
|
||||
|
||||
图2 一张图搞懂io_uring
|
||||
|
||||
io_uring同样有三个系统调用:
|
||||
|
||||
- io_uring_setup:用于创建和初始化io_uring实例。
|
||||
- io_uring_enter:负责提交I/O请求和获取完成事件。
|
||||
- io_uring_register:用于将文件描述符、缓冲区等资源预先注册到io_uring实例中。
|
||||
|
||||
图2中并没有出现这三个系统调用,实际开发中,我们会使用liburing库,liburing库将io_uring中的三个系统调用进行了封装,提供了更加丰富和友好的编程接口。
|
||||
|
||||
用户程序调用io_uring_queue_init函数(内部封装了io_uring_setup系统调用),该函数将创建和初始化一个io_uring实例(struct io_ring_ctx),内核定义如下:
|
||||
|
||||
```c
|
||||
struct io_ring_ctx {
|
||||
struct io_rings *rings; /* 指向完成队列CQ */
|
||||
struct io_uring_sqe *sq_sqes; /* 指向提交队列SQ */
|
||||
......
|
||||
};
|
||||
```
|
||||
|
||||
struct io_ring_ctx结构非常复杂,这里不展开讲解,我们需要关注两个重要成员:rings(CQ,完成队列)和sq_sqes(SQ,提交队列)。
|
||||
|
||||
CQ和SQ都是无锁环形队列。内核初始化io_uring实例时,会从内核直接映射区分配内存作为CQ和SQ。之所以从内核直接映射区分配内存,是为了方便用户程序执行mmap内存映射,确保用户程序和内核能够直接都能够访问这块内存区域。CQ和SQ是用户程序和内核数据传输的通道,借用这个通道,用户程序可以在不使用系统调用的情况下和内核实现数据交换。CQ和SQ采用无锁化编程,在高并发场景下,能够最大程度减少锁的开销。
|
||||
|
||||
内核维护了一张io_uring I/O操作表,这张表定义了io_uring所有的I/O操作,共50多种操作,定义如下:
|
||||
|
||||
```c
|
||||
/* 内核io_uring I/O操作表 */
|
||||
conststructio_issue_def io_issue_defs[] = {
|
||||
......
|
||||
[IORING_OP_SENDMSG] = {
|
||||
.needs_file = 1,
|
||||
.unbound_nonreg_file = 1,
|
||||
.pollout = 1,
|
||||
.ioprio = 1,
|
||||
.async_size = sizeof(struct io_async_msghdr),
|
||||
.prep = io_sendmsg_prep,
|
||||
.issue = io_sendmsg,
|
||||
},
|
||||
[IORING_OP_RECVMSG] = {
|
||||
.needs_file = 1,
|
||||
.unbound_nonreg_file = 1,
|
||||
.pollin = 1,
|
||||
.buffer_select = 1,
|
||||
.ioprio = 1,
|
||||
.async_size = sizeof(struct io_async_msghdr),
|
||||
.prep = io_recvmsg_prep,
|
||||
.issue = io_recvmsg,
|
||||
},
|
||||
......
|
||||
}
|
||||
```
|
||||
|
||||
每个I/O操作都有一个操作码,内核根据操作码查找I/O操作表,获取I/O操作函数并执行。
|
||||
|
||||
io_uring执行一个异步I/O操作的流程为:
|
||||
|
||||
- 步骤1:用户程序从SQ中申请一个空闲的SQE,然后设置SQE中的I/O操作码和用户数据。
|
||||
- 步骤2:用户程序调用io_uring_submit函数(内部封装了io_uring_enter系统调用)提交SQE,内核通过I/O操作码查询I/O操作表获取I/O操作函数并执行。I/O操作成功后,内核从CQ中申请一个CQE,将返回结果存储在CQE。
|
||||
- 步骤3:用户程序检测CQ是否为空,如果CQ不为空,用户程序从CQ中获取CQE,并解析I/O操作返回结果。
|
||||
|
||||
最后,我们同样来看一下io_uring有哪些优缺点。
|
||||
|
||||
io_uring优点如下:
|
||||
|
||||
- 用户程序和内核共享内存:SQ/CQ通过mmap映射,避免传统read/write的多次数据拷贝。
|
||||
- 批处理:一次提交/收割多个I/O请求,减少系统调用次数。
|
||||
- SQPOLL模式:内核线程(SQ线程)主动轮询SQ,进一步减少系统调用。
|
||||
|
||||
io_uring在设计上并没有很大的缺陷,由于io_uring是一种比较新的网络I/O模型,所以还存在一些bug,需要持续优化。
|
||||
|
||||
## 3.epoll和io_uring性能对比测试
|
||||
|
||||
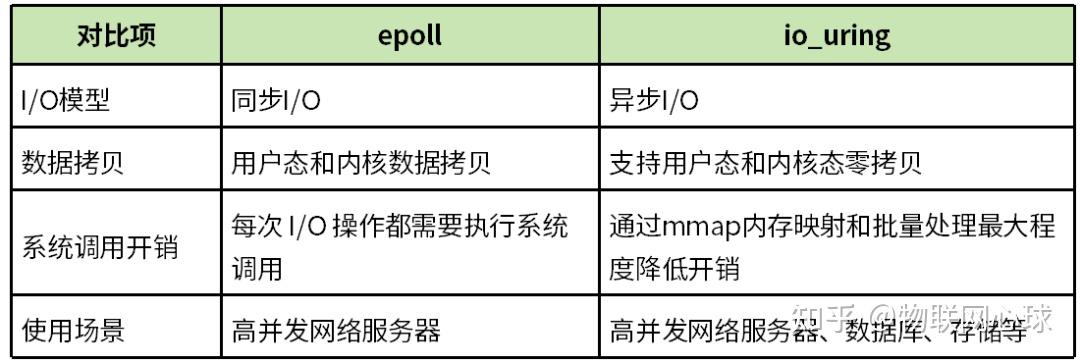
epoll和io_uring性能对比见表1。
|
||||
|
||||
|
||||
|
||||
表1 epoll和io_uring对比
|
||||
|
||||
从表1可以看出,io_uring在数据拷贝和系统调用开销两个方面是优于epoll的,当然,这些只是理论上的分析。下面,我们通过一个测试来验证上述观点。
|
||||
|
||||
### 3.1 测试环境
|
||||
|
||||
测试硬件环境如下:
|
||||
|
||||
客户端主机:AMD Ryzen 7 8845HS,8核16线程,主频3.8GHz,24G内存。
|
||||
|
||||
服务端主机:12th Gen Intel(R) Core(TM) i5-12500H,8核16线程,16G内存,主频4.1GHz。
|
||||
|
||||
局域网连接,带宽1Gbps。
|
||||
|
||||
### 3.2 测试用例
|
||||
|
||||
TCP客户端程序创建50个线程,每个线程和TCP服务端建立20000个TCP连接,总共百万个TCP连接。每个TCP连接发送和接收100个数据包(数据包长度100字节)。
|
||||
|
||||
客户端程序代码(只保留主线代码)如下:
|
||||
|
||||
```text
|
||||
/* TCP连接处理线程 */
|
||||
void *test_proc(void *arg) {
|
||||
int pos = (int)(intptr_t)arg;
|
||||
char send_buffer[BUFFER_SIZE] = {0};
|
||||
char recv_buffer[BUFFER_SIZE] = {0};
|
||||
memset(send_buffer, 'a', sizeof(send_buffer));
|
||||
/* 每个线程建立20000个连接 */
|
||||
for (int i = 0; i < REQS_THREAD; i++) {
|
||||
int sockfd = do_connect(server_ip, server_port, pos);
|
||||
if (sockfd == -1) continue;
|
||||
/* 每个连接发送和接收100个数据包 */
|
||||
for (int j = 0; j < PACKETS_THREAD; j++) {
|
||||
int ret = send(sockfd, send_buffer, 100, 0);
|
||||
if (ret < 0) break;
|
||||
ret = recv(sockfd, recv_buffer, sizeof(recv_buffer), 0);
|
||||
if (ret < 0) break;
|
||||
}
|
||||
close(sockfd);
|
||||
}
|
||||
returnNULL;
|
||||
}
|
||||
|
||||
int main(int argc, char *argv[]) {
|
||||
server_ip = argv[1];
|
||||
server_port = atoi(argv[2]);
|
||||
int start_pos = atoi(argv[3]);
|
||||
|
||||
struct timeval start, end;
|
||||
gettimeofday(&start, NULL);
|
||||
pthread_t th[THREADS];
|
||||
/* 创建50个线程 */
|
||||
for (int i = 0; i < THREADS; i++) {
|
||||
int ret = pthread_create(&th[i], NULL, test_proc, (void *)(intptr_t)(start_pos + i));
|
||||
if (ret != 0) {
|
||||
perror("pthread_create");
|
||||
}
|
||||
}
|
||||
|
||||
for (int i = 0; i < THREADS; i++) {
|
||||
pthread_join(th[i], NULL);
|
||||
}
|
||||
gettimeofday(&end, NULL);
|
||||
/* 统计百万连接处理时间 */
|
||||
double time_used = (end.tv_sec - start.tv_sec) * 1000.0 + (end.tv_usec - start.tv_usec) / 1000.0;
|
||||
int reqs = (REQS_THREAD * THREADS);
|
||||
double qps = reqs / (time_used / 1000.0);
|
||||
|
||||
printf("sucess: %d, time_used: %.0f(ms), qps: %.2f\n",
|
||||
reqs, time_used, qps);
|
||||
|
||||
return0;
|
||||
}
|
||||
```
|
||||
|
||||
TCP服务端分为:epoll服务端和io_uring服务端。epoll服务端代码(只保留主线代码)如下:
|
||||
|
||||
```text
|
||||
int main(int argc, char *argv[]) {
|
||||
char *local_ip = argv[1];
|
||||
unsignedshort local_port = atoi(argv[2]);
|
||||
|
||||
/* 初始化TCP服务端 */
|
||||
int sockfd = init_server(local_ip, local_port);
|
||||
/* 创建和初始化epoll实例 */
|
||||
int epfd = epoll_create(100);
|
||||
/* epoll注册监听套接字事件 */
|
||||
epoll_add_event(epfd, sockfd);
|
||||
while(1) {
|
||||
struct epoll_event events[MAX_EVENTS] = {0};
|
||||
int timeout = 2000;
|
||||
int nfds = epoll_wait(epfd, events, MAX_EVENTS, timeout);
|
||||
if (nfds == 0) {
|
||||
continue;
|
||||
} elseif (nfds == -1) {
|
||||
break;
|
||||
}
|
||||
for (int i = 0; i < nfds; i++) {
|
||||
int fd = events[i].data.fd;
|
||||
if (events[i].events & EPOLLIN) {
|
||||
if (fd == sockfd) {
|
||||
/* 处理连接请求 */
|
||||
int new_sockfd = accept(sockfd, NULL, NULL);
|
||||
if (new_sockfd == -1) {
|
||||
continue;
|
||||
}
|
||||
set_nonblock(new_sockfd);
|
||||
epoll_add_event(epfd, new_sockfd);
|
||||
} else {
|
||||
char buf[BUF_LEN] = {0};
|
||||
int len = 0;
|
||||
int pos = 0;
|
||||
while (1) {
|
||||
/* 接收数据 */
|
||||
len = recv(fd, buf+pos, ONCE_LEN, 0);
|
||||
if ((len == 0) || ((len == -1) && (errno != EAGAIN))) {
|
||||
close(fd);
|
||||
epoll_del_event(epfd, fd);
|
||||
break;
|
||||
} elseif ((len == -1) && (errno == EAGAIN)) {
|
||||
break;
|
||||
} else {
|
||||
pos += (len > 0 ? len : 0);
|
||||
break;
|
||||
}
|
||||
}
|
||||
if (pos > 0) {
|
||||
/* 发送数据 */
|
||||
int slen = send(fd, buf, pos, 0);
|
||||
if (slen < 0) {
|
||||
close(fd);
|
||||
epoll_del_event(epfd, fd);
|
||||
continue;
|
||||
}
|
||||
}
|
||||
}
|
||||
} else {
|
||||
}
|
||||
}
|
||||
}
|
||||
close(epfd);
|
||||
close(sockfd);
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
io_uring服务端代码(只保留主线代码)如下:
|
||||
|
||||
```text
|
||||
int main(int argc, char *argv[]) {
|
||||
char *server_ip = argv[1];
|
||||
unsignedshort server_port = atoi(argv[2]);
|
||||
|
||||
int listen_fd = init_server(server_ip, server_port);
|
||||
|
||||
struct io_uring ring;
|
||||
#if 1 /* 普通模式 */
|
||||
if (io_uring_queue_init(ENTRIES, &ring, 0) < 0) {
|
||||
return-1;
|
||||
}
|
||||
#else /* SQPOLL模式 */
|
||||
struct io_uring_params params = {0};
|
||||
params.flags = IORING_SETUP_SQPOLL |
|
||||
IORING_SETUP_SQ_AFF;
|
||||
params.sq_thread_cpu = 1;
|
||||
if (io_uring_queue_init_params(ENTRIES, &ring, ¶ms) < 0) {
|
||||
return1;
|
||||
}
|
||||
#endif
|
||||
|
||||
/* accept I/O请求插入SQ */
|
||||
setup_accept(&ring, listen_fd);
|
||||
struct io_uring_cqe *cqes[BATCH_SIZE];
|
||||
while (1) {
|
||||
/* 提交全部SQE */
|
||||
io_uring_submit(&ring);
|
||||
/* 阻塞等待CQE */
|
||||
int ret = io_uring_wait_cqe(&ring, &cqes[0]);
|
||||
if (ret < 0) {
|
||||
break;
|
||||
}
|
||||
/* 批处理CQE */
|
||||
int ready = io_uring_peek_batch_cqe(&ring, cqes, BATCH_SIZE);
|
||||
if (ready == 0) {
|
||||
continue;
|
||||
}
|
||||
for (int i = 0; i < ready; i++) {
|
||||
struct io_uring_cqe *cqe = cqes[i];
|
||||
io_info* info = (io_info*)io_uring_cqe_get_data(cqe);
|
||||
switch (info->type) {
|
||||
case ACCEPT:
|
||||
if (cqe->res == -1) {
|
||||
close(info->client_fd);
|
||||
break;
|
||||
}
|
||||
/* 读数据I/O请求插入SQ */
|
||||
setup_read(&ring, cqe->res, &info->client_addr);
|
||||
/* accept I/O请求插入SQ */
|
||||
setup_accept(&ring, listen_fd);
|
||||
break;
|
||||
case READ:
|
||||
if (cqe->res > 0) {
|
||||
info->bytes_read = cqe->res;
|
||||
info->buffer[cqe->res] = '\0';
|
||||
/* 写数据I/O请求插入SQ */
|
||||
setup_write(&ring, info->client_fd,
|
||||
info->buffer, info->bytes_read,
|
||||
&info->client_addr);
|
||||
} elseif (cqe->res <= 0) {
|
||||
close(info->client_fd);
|
||||
}
|
||||
break;
|
||||
case WRITE:
|
||||
if (cqe->res > 0) {
|
||||
/* 读数据I/O请求插入SQ */
|
||||
setup_read(&ring, info->client_fd, &info->client_addr);
|
||||
} elseif (cqe->res <= 0) {
|
||||
close(info->client_fd);
|
||||
}
|
||||
break;
|
||||
}
|
||||
free_connection_info(info);
|
||||
}
|
||||
/* CQ推进 */
|
||||
io_uring_cq_advance(&ring, ready);
|
||||
}
|
||||
|
||||
close(listen_fd);
|
||||
io_uring_queue_exit(&ring);
|
||||
return0;
|
||||
}
|
||||
```
|
||||
|
||||
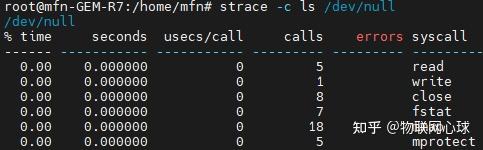
TCP客户端分别和两个TCP服务端建立百万连接,并分别统计处理百万连接所花费的时间。同时通过strace -c命令统计epoll服务端和io_uring服务端系统调用情况。
|
||||
|
||||
strace -c命令输出示例如下:
|
||||
|
||||
|
||||
|
||||
每一列的解析如下:
|
||||
|
||||
- % time:该系统调用耗时占总时间的百分比。
|
||||
- seconds:该系统调用总耗时(秒)。
|
||||
- usecs/call:每次调用平均耗时(微妙)。
|
||||
- calls:总调用次数。
|
||||
- errors:调用失败次数。
|
||||
- syscall:系统调用名称。
|
||||
|
||||
### 3.3 测试结果
|
||||
|
||||
**(1)epoll服务端测试结果**
|
||||
|
||||
执行strace -c ./tcp_epoll 192.168.2.2 9999命令统计epoll服务端系统调用情况,统计结果如下:
|
||||
|
||||

|
||||
|
||||
epoll服务端总系统调用次数为211828279(超2亿次),除了发送和接收系统调用次数超百万次,其他系统调用(如epoll_wait、epoll_ctl)次数也有几十万次。完成百万连接测试用时632008毫秒。
|
||||
|
||||
**(2)io_uring服务端测试结果**
|
||||
|
||||
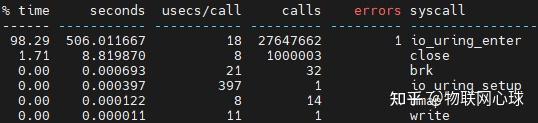
执行strace -c ./io_uring_server 192.168.2.2 9999命令统计io_uring服务端系统调用情况,统计结果如下:
|
||||
|
||||
|
||||
|
||||
开启批处理和SQ线程后,io_uring服务端总系统调用次数为28647744次(近3千万次),其中io_uring_enter系统调用次数占比为98%。百万连接测试时间为626473毫秒。
|
||||
|
||||
从测试结果可以看出,epoll服务端的系统调用次数远远大于io_uring服务端的系统调用次数。如果每次系统调用的处理时间约为1us,1千万次系统调用将耗时10秒,所以io_uring服务端完成百万连接测试用时相对较短。
|
||||
|
||||
## 总结:
|
||||
|
||||
文章中涉及到的epoll、io_uring以及百万并发相关的知识在我的新书《图解Linux网络编程》中有详细介绍,如果你想系统性地学习Linux网络编程,成为别人眼中的大佬,欢迎入手我的新书,书籍已经在各大电商平台上线。
|
||||
@@ -0,0 +1,524 @@
|
||||
### 来看一个常见的场景
|
||||
|
||||
假设你正在开发一个数据备份脚本。这个脚本需要执行以下操作:
|
||||
|
||||
1. 创建临时工作目录
|
||||
2. 将数据复制到临时目录
|
||||
3. 压缩打包
|
||||
4. 清理临时文件
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
|
||||
WORK_DIR="/tmp/backup_$(date +%Y%m%d)"
|
||||
|
||||
echo "开始备份..."
|
||||
mkdir -p "$WORK_DIR"
|
||||
echo "创建临时目录: $WORK_DIR"
|
||||
|
||||
echo "复制文件中..."
|
||||
cp -r /path/to/data "$WORK_DIR/"
|
||||
sleep 5 # 模拟耗时操作
|
||||
|
||||
echo "压缩打包..."
|
||||
tar -czf backup.tar.gz "$WORK_DIR"
|
||||
sleep 3 # 模拟耗时操作
|
||||
|
||||
echo "清理临时文件..."
|
||||
rm -rf "$WORK_DIR"
|
||||
|
||||
echo "备份完成!"
|
||||
```
|
||||
|
||||
### 如果我中断了脚本怎么办!
|
||||
|
||||
当我们运行这个脚本时,如果在执行过程中按下 Ctrl+C 中断操作,会发生什么?
|
||||
|
||||
临时目录 `$WORK_DIR` 将被遗留在系统中,因为清理步骤没有被执行。长期积累下来,这些未清理的临时文件会占用大量磁盘空间。
|
||||
|
||||
### 使用 trap 命令改善程序
|
||||
|
||||
这时,`trap` 命令就派上用场了。`trap` 可以捕获特定的信号并执行相应的处理函数。SIGINT(通常由 Ctrl+C 触发)就是最常见的信号之一。
|
||||
|
||||
首先,我们定义一个中断处理函数:
|
||||
|
||||
```text
|
||||
on_interrupt() {
|
||||
echo -e "\n程序被中断!"
|
||||
echo "清理临时文件..."
|
||||
rm -rf "$WORK_DIR"
|
||||
exit 1
|
||||
}
|
||||
```
|
||||
|
||||
然后,在脚本开头使用 `trap` 设置信号处理:
|
||||
|
||||
```text
|
||||
trap on_interrupt SIGINT
|
||||
```
|
||||
|
||||
完整的改进版脚本如下:
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
|
||||
WORK_DIR="/tmp/backup_$(date +%Y%m%d)"
|
||||
|
||||
# 定义中断处理函数
|
||||
on_interrupt() {
|
||||
echo -e "\n程序被中断!"
|
||||
echo "清理临时文件..."
|
||||
rm -rf "$WORK_DIR"
|
||||
exit 1
|
||||
}
|
||||
|
||||
# 设置 trap
|
||||
trap on_interrupt SIGINT
|
||||
|
||||
echo "开始备份..."
|
||||
mkdir -p "$WORK_DIR"
|
||||
echo "创建临时目录: $WORK_DIR"
|
||||
|
||||
echo "复制文件中..."
|
||||
cp -r /path/to/data "$WORK_DIR/"
|
||||
sleep 5 # 模拟耗时操作
|
||||
|
||||
echo "压缩打包..."
|
||||
tar -czf backup.tar.gz "$WORK_DIR"
|
||||
sleep 3 # 模拟耗时操作
|
||||
|
||||
echo "清理临时文件..."
|
||||
rm -rf "$WORK_DIR"
|
||||
|
||||
echo "备份完成!"
|
||||
```
|
||||
|
||||
## trap 命令说明
|
||||
|
||||
`trap` 命令的基本语法是:
|
||||
|
||||
```text
|
||||
trap command signal
|
||||
```
|
||||
|
||||
其中:
|
||||
|
||||
- `command` 可以是函数名或直接的命令
|
||||
- `signal` 是要捕获的信号名称,如 SIGINT、SIGTERM 等
|
||||
|
||||
常见的信号包括:
|
||||
|
||||
- SIGINT (2):用户按下 Ctrl+C
|
||||
- SIGTERM (15):终止信号
|
||||
- EXIT:脚本退出时
|
||||
|
||||
你还可以同时捕获多个信号:
|
||||
|
||||
```text
|
||||
trap on_interrupt SIGINT SIGTERM
|
||||
```
|
||||
|
||||
通过使用 `trap` 命令和 `on_interrupt` 函数,我们实现了:
|
||||
|
||||
1. 优雅地处理程序中断
|
||||
2. 确保临时资源被正确清理
|
||||
3. 提供了友好的用户提示
|
||||
|
||||
这种模式不仅适用于备份脚本,还可以用在任何需要资源清理的脚本中,比如:
|
||||
|
||||
- 临时文件处理
|
||||
- 数据库连接清理
|
||||
- 锁文件删除
|
||||
- 进程清理
|
||||
|
||||
## 扩展: trap 命令的高级应用
|
||||
|
||||
### 多信号处理
|
||||
|
||||
有时我们需要对不同的信号进行不同的处理。比如在一个数据处理脚本中:
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
|
||||
# 定义变量
|
||||
DATA_FILE="data.txt"
|
||||
TEMP_FILE="temp.txt"
|
||||
LOG_FILE="process.log"
|
||||
|
||||
# 处理 Ctrl+C
|
||||
on_interrupt() {
|
||||
echo -e "\n收到 SIGINT,正在优雅关闭..."
|
||||
cleanup
|
||||
exit 1
|
||||
}
|
||||
|
||||
# 处理 SIGTERM
|
||||
on_terminate() {
|
||||
echo -e "\n收到 SIGTERM,保存进度后退出..."
|
||||
save_progress
|
||||
cleanup
|
||||
exit 1
|
||||
}
|
||||
|
||||
# 处理正常退出
|
||||
on_exit() {
|
||||
echo "程序正常结束,执行清理..."
|
||||
cleanup
|
||||
}
|
||||
|
||||
# 清理函数
|
||||
cleanup() {
|
||||
rm -f "$TEMP_FILE"
|
||||
echo "清理完成"
|
||||
}
|
||||
|
||||
# 保存进度
|
||||
save_progress() {
|
||||
echo "保存当前进度到 $LOG_FILE"
|
||||
echo "Progress saved at $(date)" >> "$LOG_FILE"
|
||||
}
|
||||
|
||||
# 设置多重信号处理
|
||||
trap on_interrupt SIGINT
|
||||
trap on_terminate SIGTERM
|
||||
trap on_exit EXIT
|
||||
|
||||
# 主程序
|
||||
echo "开始处理数据..."
|
||||
while true; do
|
||||
echo "处理中..."
|
||||
sleep 1
|
||||
done
|
||||
```
|
||||
|
||||
### 临时禁用和恢复信号处理
|
||||
|
||||
有时我们需要临时禁用信号处理,比如在执行关键操作时:
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
|
||||
critical_operation() {
|
||||
# 临时禁用 Ctrl+C
|
||||
trap '' SIGINT
|
||||
|
||||
echo "执行关键操作,这段时间按 Ctrl+C 无效..."
|
||||
sleep 5
|
||||
|
||||
# 恢复信号处理
|
||||
trap on_interrupt SIGINT
|
||||
echo "关键操作完成,恢复正常信号处理"
|
||||
}
|
||||
|
||||
on_interrupt() {
|
||||
echo -e "\n操作被中断!"
|
||||
exit 1
|
||||
}
|
||||
|
||||
trap on_interrupt SIGINT
|
||||
|
||||
echo "开始执行..."
|
||||
critical_operation
|
||||
echo "继续其他操作..."
|
||||
```
|
||||
|
||||
### DEBUG 信号与调试处理
|
||||
|
||||
DEBUG 并不是中断信号,而是 Bash 的一个特殊 trap 事件。它在执行每个命令之前触发,主要用于调试目的。让我们看一个更实用的例子:
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
|
||||
# 用于控制是否在错误处理函数中触发 DEBUG trap
|
||||
IN_ERROR_HANDLER=0
|
||||
|
||||
# 定义调试处理函数
|
||||
on_debug() {
|
||||
# 如果在错误处理函数中,跳过调试输出
|
||||
if ((IN_ERROR_HANDLER)); then
|
||||
return
|
||||
fi
|
||||
# $1 是行号,$BASH_COMMAND 是即将执行的命令
|
||||
echo "[DEBUG] 行 $1: 准备执行 -> $BASH_COMMAND"
|
||||
}
|
||||
|
||||
# 错误处理函数
|
||||
on_error() {
|
||||
local err=$? # 立即保存错误码
|
||||
local line=$1
|
||||
local cmd=$2
|
||||
|
||||
# 设置标志,防止在错误处理中触发 DEBUG trap
|
||||
IN_ERROR_HANDLER=1
|
||||
|
||||
echo "[ERROR] 行 $line 执行失败"
|
||||
echo "命令: $cmd"
|
||||
echo "错误码: $err"
|
||||
|
||||
# 重置标志
|
||||
IN_ERROR_HANDLER=0
|
||||
}
|
||||
|
||||
# 启用调试跟踪
|
||||
enable_debug() {
|
||||
# 启用 ERR trap
|
||||
set -E
|
||||
# -T 选项可以显示函数调用跟踪
|
||||
set -T
|
||||
# 设置 DEBUG trap,传入行号参数
|
||||
trap 'on_debug ${LINENO}' DEBUG
|
||||
trap 'on_error ${LINENO} "$BASH_COMMAND"' ERR
|
||||
}
|
||||
|
||||
# 关闭调试跟踪
|
||||
disable_debug() {
|
||||
trap - DEBUG
|
||||
trap - ERR
|
||||
set +E
|
||||
set +T
|
||||
}
|
||||
|
||||
# 通过环境变量控制是否开启调试
|
||||
if [[ "${ENABLE_DEBUG}" == "true" ]]; then
|
||||
enable_debug
|
||||
fi
|
||||
|
||||
# 测试函数
|
||||
test_function() {
|
||||
echo "执行测试函数"
|
||||
local result=$((2 + 2))
|
||||
echo "计算结果: $result"
|
||||
# 故意制造一个错误
|
||||
ls /nonexistent_directory
|
||||
}
|
||||
|
||||
# 主程序
|
||||
echo "开始执行..."
|
||||
test_function
|
||||
echo "尝试访问不存在的文件..."
|
||||
cat nonexistent_file.txt
|
||||
```
|
||||
|
||||
使用方式:
|
||||
|
||||
```text
|
||||
# 普通执行
|
||||
./script.sh
|
||||
|
||||
# 开启调试模式执行
|
||||
ENABLE_DEBUG=true ./script.sh
|
||||
```
|
||||
|
||||
普通模式输出:
|
||||
|
||||
```text
|
||||
开始执行...
|
||||
执行测试函数
|
||||
计算结果: 4
|
||||
ls: cannot access '/nonexistent_directory': No such file or directory
|
||||
尝试访问不存在的文件...
|
||||
cat: nonexistent_file.txt: No such file or directory
|
||||
```
|
||||
|
||||
DEBUG 模式输出:
|
||||
|
||||
```text
|
||||
[DEBUG] 行 41: 准备执行 -> trap 'on_error ${LINENO} "$BASH_COMMAND"' ERR
|
||||
[DEBUG] 行 67: 准备执行 -> echo "开始执行..."
|
||||
开始执行...
|
||||
[DEBUG] 行 68: 准备执行 -> test_function
|
||||
[DEBUG] 行 58: 准备执行 -> test_function
|
||||
[DEBUG] 行 59: 准备执行 -> echo "执行测试函数"
|
||||
执行测试函数
|
||||
[DEBUG] 行 60: 准备执行 -> local result=$((2 + 2))
|
||||
[DEBUG] 行 61: 准备执行 -> echo "计算结果: $result"
|
||||
计算结果: 4
|
||||
[DEBUG] 行 63: 准备执行 -> ls /nonexistent_directory
|
||||
ls: cannot access '/nonexistent_directory': No such file or directory
|
||||
[DEBUG] 行 63: 准备执行 -> ls /nonexistent_directory
|
||||
[DEBUG] 行 17: 准备执行 -> ls /nonexistent_directory
|
||||
[DEBUG] 行 18: 准备执行 -> local err=$?
|
||||
[DEBUG] 行 19: 准备执行 -> local line=$1
|
||||
[DEBUG] 行 20: 准备执行 -> local cmd=$2
|
||||
[DEBUG] 行 23: 准备执行 -> IN_ERROR_HANDLER=1
|
||||
[ERROR] 行 63 执行失败
|
||||
命令: ls /nonexistent_directory
|
||||
错误码: 2
|
||||
[DEBUG] 行 68: 准备执行 -> ls /nonexistent_directory
|
||||
[DEBUG] 行 17: 准备执行 -> ls /nonexistent_directory
|
||||
[DEBUG] 行 18: 准备执行 -> local err=$?
|
||||
[DEBUG] 行 19: 准备执行 -> local line=$1
|
||||
[DEBUG] 行 20: 准备执行 -> local cmd=$2
|
||||
[DEBUG] 行 23: 准备执行 -> IN_ERROR_HANDLER=1
|
||||
[ERROR] 行 68 执行失败
|
||||
命令: ls /nonexistent_directory
|
||||
错误码: 2
|
||||
[DEBUG] 行 69: 准备执行 -> echo "尝试访问不存在的文件..."
|
||||
尝试访问不存在的文件...
|
||||
[DEBUG] 行 70: 准备执行 -> cat nonexistent_file.txt
|
||||
cat: nonexistent_file.txt: No such file or directory
|
||||
[DEBUG] 行 70: 准备执行 -> cat nonexistent_file.txt
|
||||
[DEBUG] 行 17: 准备执行 -> cat nonexistent_file.txt
|
||||
[DEBUG] 行 18: 准备执行 -> local err=$?
|
||||
[DEBUG] 行 19: 准备执行 -> local line=$1
|
||||
[DEBUG] 行 20: 准备执行 -> local cmd=$2
|
||||
[DEBUG] 行 23: 准备执行 -> IN_ERROR_HANDLER=1
|
||||
[ERROR] 行 70 执行失败
|
||||
命令: cat nonexistent_file.txt
|
||||
错误码: 1
|
||||
```
|
||||
|
||||
### 文件锁机制 trap vs flock
|
||||
|
||||
让我们比较 trap 和 flock 的锁机制:
|
||||
|
||||
**使用 trap 的文件锁**
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
|
||||
LOCK_FILE="/tmp/script.lock"
|
||||
PID_FILE="/tmp/script.pid"
|
||||
|
||||
cleanup() {
|
||||
rm -f "$LOCK_FILE" "$PID_FILE"
|
||||
echo "清理锁文件和PID文件"
|
||||
}
|
||||
|
||||
get_lock() {
|
||||
if [ -e "$LOCK_FILE" ]; then
|
||||
local pid
|
||||
pid=$(cat "$PID_FILE" 2>/dev/null)
|
||||
if [ -n "$pid" ] && kill -0 "$pid" 2>/dev/null; then
|
||||
echo "另一个实例(PID: $pid)正在运行"
|
||||
exit 1
|
||||
fi
|
||||
# 如果进程不存在,清理旧的锁
|
||||
cleanup
|
||||
fi
|
||||
|
||||
echo $$ > "$PID_FILE"
|
||||
touch "$LOCK_FILE"
|
||||
trap cleanup EXIT
|
||||
}
|
||||
```
|
||||
|
||||
**使用 flock 的实现:**
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
|
||||
LOCK_FILE="/tmp/script.lock"
|
||||
|
||||
(
|
||||
# 获取文件锁,等待最多5秒
|
||||
flock -w 5 200 || { echo "无法获取锁,另一个实例正在运行"; exit 1; }
|
||||
|
||||
echo "获得锁,开始执行..."
|
||||
sleep 10
|
||||
echo "执行完成"
|
||||
|
||||
) 200>"$LOCK_FILE"
|
||||
```
|
||||
|
||||
**比较分析**
|
||||
|
||||
1. **可靠性**
|
||||
|
||||
|
||||
- flock 更可靠,它使用内核级文件锁
|
||||
- trap 方式可能在极端情况下(如系统崩溃)留下孤立的锁文件
|
||||
|
||||
1. **使用场景**
|
||||
|
||||
|
||||
- flock 适合要求严格的生产环境
|
||||
- trap 方式适合简单的脚本和开发环境
|
||||
|
||||
1. **推荐选择**
|
||||
|
||||
|
||||
- 推荐使用 flock,因为它:
|
||||
|
||||
- 自动处理进程终止
|
||||
- 支持超时设置
|
||||
- 提供阻塞和非阻塞模式
|
||||
- 可靠性更高
|
||||
|
||||
### 事务的实现
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
|
||||
# 状态变量
|
||||
TRANSACTION_ACTIVE=false
|
||||
|
||||
# 动态改变信号处理
|
||||
update_signal_handler() {
|
||||
if $TRANSACTION_ACTIVE; then
|
||||
# 事务进行中,设置中断处理为提示并结束
|
||||
trap 'echo "事务进行中,已被强行中断..."; cleanup; exit 1' SIGINT
|
||||
else
|
||||
# 非事务状态,可以安全退出
|
||||
trap 'echo "正常退出..."; exit 0' SIGINT
|
||||
fi
|
||||
}
|
||||
|
||||
# 清理函数
|
||||
cleanup() {
|
||||
echo "执行清理操作..."
|
||||
# 这里添加实际的清理代码
|
||||
}
|
||||
|
||||
# 模拟事务
|
||||
start_transaction() {
|
||||
TRANSACTION_ACTIVE=true
|
||||
update_signal_handler
|
||||
echo "事务开始"
|
||||
|
||||
# 模拟事务操作
|
||||
echo "执行事务步骤 1/3"
|
||||
sleep 2
|
||||
echo "执行事务步骤 2/3"
|
||||
sleep 2
|
||||
echo "执行事务步骤 3/3"
|
||||
sleep 2
|
||||
|
||||
TRANSACTION_ACTIVE=false
|
||||
update_signal_handler
|
||||
echo "事务完成"
|
||||
}
|
||||
|
||||
# 设置初始信号处理
|
||||
update_signal_handler
|
||||
|
||||
# 主程序执行流程
|
||||
echo "开始执行..."
|
||||
start_transaction
|
||||
echo "继续其他操作..."
|
||||
```
|
||||
|
||||
**执行流程说明:**
|
||||
|
||||
1. 脚本启动
|
||||
|
||||
|
||||
- `TRANSACTION_ACTIVE` 初始值为 `false`
|
||||
- 首次调用 `update_signal_handler`,设置正常的中断处理
|
||||
|
||||
1. 执行 `start_transaction`
|
||||
|
||||
|
||||
- 设置 `TRANSACTION_ACTIVE` 为 `true`
|
||||
- 更新信号处理为事务保护模式
|
||||
- 执行事务操作
|
||||
- 完成后,设置 `TRANSACTION_ACTIVE` 为 `false`
|
||||
- 恢复正常的信号处理
|
||||
|
||||
1. 信号处理行为
|
||||
|
||||
|
||||
- 事务进行中收到 SIGINT:显示中断消息,执行清理,然后退出
|
||||
- 非事务状态收到 SIGINT:直接安全退出
|
||||
|
||||
通过这些高级用法,我们可以构建更健壮、更可靠的 shell 脚本。无论是处理意外中断、实现锁机制,还是进行调试,`trap` 都是一个强大的工具。
|
||||
@@ -0,0 +1,23 @@
|
||||
Linux 靠一个叫/etc/fstab的配置文件实现 “开机自动挂载”
|
||||
编辑`/etc/fstab`前,必须先拿到两个 “关键参数”:**设备的 UUID**和**文件系统类型**—— 这是新手最容易忽略的,用设备路径(比如`/dev/sdb1`)容易出错(比如插新硬盘后,原 U 盘路径可能从`sdb1`变成`sdc1`),而 UUID 是设备的 “唯一身份证”,永远不会变。
|
||||
|
||||
|
||||
`blkid`能显示所有分区 / U 盘的 UUID 和文件系统类型,必须用`sudo`执行(普通用户看不了):
|
||||
|
||||
```text
|
||||
sudo blkid
|
||||
```
|
||||
|
||||
和手动挂载一样,自动挂载也需要 “挂载点”(空目录),建议放在`/mnt`(手动管理的设备)或`/media`(系统自动管理的设备)下
|
||||
|
||||
|
||||
### 测试配置是否正确(避免重启后失败)
|
||||
|
||||
编辑完别直接重启!用`mount -a`命令让系统 “加载新的 fstab 配置”,如果没报错,就代表配置没问题:
|
||||
|
||||
```text
|
||||
sudo mount -a # 加载fstab,没输出就是成功
|
||||
```
|
||||
|
||||
|
||||
U 盘自动挂载时,没加`nofail`,结果 U 盘没插,开机卡在 “waiting for device”(等设备),要等 1 分钟才进系统 —— 后来加了`nofail`,没插 U 盘也能正常开机。
|
||||
+74
@@ -0,0 +1,74 @@
|
||||
|
||||
|
||||
图示解析
|
||||
|
||||
本质上其实是三处地盘和两种用户之间的排列组合的结果:
|
||||
|
||||
三处“地盘”([根目录](https://zhida.zhihu.com/search?content_id=754281048&content_type=Answer&match_order=1&q=%E6%A0%B9%E7%9B%AE%E5%BD%95&zhida_source=entity)、/usr、/usr/local) × 两种“人群”(bin 给所有用户,sbin 给管理员)。
|
||||
|
||||
## **系统启动必需的目录**
|
||||
|
||||
### **/bin**
|
||||
|
||||
- 含基础命令,开机到最小救援都离不开它。
|
||||
|
||||
- 示例:ls、cp、mv、bash 等。
|
||||
|
||||
|
||||
### **/sbin**
|
||||
|
||||
- 系统管理、修复、分区等关键工具,多在救援/启动早期使用。
|
||||
|
||||
- 示例:reboot、fdisk、init 等。
|
||||
|
||||
|
||||
> 这些目录下断网断挂载也要能用。
|
||||
|
||||
|
||||
|
||||
## **[发行版](https://zhida.zhihu.com/search?content_id=754281048&content_type=Answer&match_order=1&q=%E5%8F%91%E8%A1%8C%E7%89%88&zhida_source=entity)的标准配给**
|
||||
|
||||
### **/usr/bin**(标准应用区)
|
||||
|
||||
- 发行版仓库装来的大多数[用户程序](https://zhida.zhihu.com/search?content_id=754281048&content_type=Answer&match_order=1&q=%E7%94%A8%E6%88%B7%E7%A8%8B%E5%BA%8F&zhida_source=entity)。
|
||||
|
||||
- 示例:gcc、python、vim、git。
|
||||
|
||||
|
||||
### **/usr/sbin**(标准运维区)
|
||||
|
||||
- 官方提供的[服务端](https://zhida.zhihu.com/search?content_id=754281048&content_type=Answer&match_order=1&q=%E6%9C%8D%E5%8A%A1%E7%AB%AF&zhida_source=entity)/管理类程序与工具。
|
||||
|
||||
- 示例:useradd、cron、sshd。
|
||||
|
||||
|
||||
> 这两个相当于系统的“总仓库”,绝大多数工具从这里发货。
|
||||
|
||||
|
||||
|
||||
## **本机自装地盘**
|
||||
|
||||
### **/usr/local/bin**(自带装备)
|
||||
|
||||
- 你自己手动编译/安装、给所有用户用的程序与脚本。
|
||||
|
||||
- 很典型的,例如:源码 make install 的可执行文件、自定义脚本。
|
||||
|
||||
|
||||
### **/usr/local/sbin**(自建运维角)
|
||||
|
||||
- 你自装的管理员工具、服务启动脚本、定制小工具。
|
||||
|
||||
|
||||
|
||||
> 这俩类似“私人工具柜”,不影响系统仓库,备份/迁移也更省心。
|
||||
|
||||
---
|
||||
|
||||
或者也可以这么看和区分:
|
||||
|
||||
- **谁能用**:bin对应普通用户,sbin对应管理员(当然他也可以用bin)。
|
||||
|
||||
- **谁提供**:系统/发行版(/usr) ,本机管理员(/usr/local)。
|
||||
|
||||
- **是否启动必需**:必须(/bin、/sbin) ,非必需(/usr/*)。
|
||||
@@ -0,0 +1,141 @@
|
||||
以下是 Mountpoint for Amazon S3 的安装和与 S3 兼容服务(如 RustFS)配合使用的教程。
|
||||
|
||||
### 1. 安装 Mountpoint
|
||||
|
||||
Mountpoint 提供预编译的安装包,支持多种 Linux 发行版。
|
||||
|
||||
* **Ubuntu / Debian (基于 DEB)**
|
||||
```bash
|
||||
# 下载适用于 x86_64 架构的 .deb 包
|
||||
wget https://s3.amazonaws.com/mountpoint-s3-release/latest/x86_64/mount-s3.deb
|
||||
# 安装
|
||||
sudo apt-get install -y ./mount-s3.deb
|
||||
```
|
||||
对于 ARM64 架构,将 URL 中的 `x86_64` 替换为 `arm64`。
|
||||
|
||||
* **Amazon Linux / RHEL / CentOS (基于 RPM)**
|
||||
```bash
|
||||
# 下载适用于 x86_64 架构的 .rpm 包
|
||||
wget https://s3.amazonaws.com/mountpoint-s3-release/latest/x86_64/mount-s3.rpm
|
||||
# 安装
|
||||
sudo yum install -y ./mount-s3.rpm
|
||||
```
|
||||
对于 ARM64 架构,将 URL 中的 `x86_64` 替换为 `arm64`。
|
||||
|
||||
* **验证安装**
|
||||
安装完成后,运行以下命令验证是否成功:
|
||||
```bash
|
||||
mount-s3 --version
|
||||
```
|
||||
如果安装成功,会输出版本信息,例如 `mount-s3 1.21.0`。
|
||||
|
||||
### 2. 配置访问凭证
|
||||
|
||||
Mountpoint 使用与 AWS CLI 相同的方式发现凭证。对于自建的 S3 服务,你需要通过环境变量提供访问密钥:
|
||||
|
||||
```bash
|
||||
export AWS_ACCESS_KEY_ID=myaccesskey
|
||||
export AWS_SECRET_ACCESS_KEY=mysecretkey
|
||||
export AWS_ENDPOINT_URL=http://你的RustFS服务IP:9000
|
||||
```
|
||||
Mountpoint 会自动读取这些环境变量。
|
||||
|
||||
### 3. 挂载存储桶
|
||||
|
||||
#### 3.1 基础挂载(适用于 AWS S3)
|
||||
|
||||
如果你的目标是标准的 AWS S3,挂载命令非常简单:
|
||||
```bash
|
||||
mkdir ~/mnt
|
||||
mount-s3 my-bucket ~/mnt
|
||||
```
|
||||
此时,`~/mnt` 目录就成为了你 S3 存储桶的挂载点。
|
||||
|
||||
#### 3.2 挂载到 S3 兼容服务(如 RustFS)
|
||||
|
||||
对于非 AWS 的 S3 兼容服务,**必须指定服务端点(Endpoint)**。
|
||||
|
||||
Mountpoint 提供两种方式:
|
||||
|
||||
* **方式一:使用命令行参数 `--endpoint-url`**
|
||||
```bash
|
||||
mount-s3 my-bucket ~/mnt --endpoint-url http://你的RustFS服务IP:9000
|
||||
```
|
||||
|
||||
* **方式二:使用环境变量 `AWS_ENDPOINT_URL`(推荐)**
|
||||
这种方式更便于在容器或脚本中统一管理配置。
|
||||
```bash
|
||||
export AWS_ENDPOINT_URL=http://你的RustFS服务IP:9000
|
||||
mount-s3 my-bucket ~/mnt
|
||||
```
|
||||
|
||||
> **注意**:Mountpoint 默认使用 `virtual-hosted-style` 的请求方式。如果你的 S3 服务(如 RustFS)不支持这种样式,可能会遇到 DNS 解析问题。此时,你可能需要在挂载时添加 `--endpoint-url` 参数,并确保其指向正确的服务地址。
|
||||
|
||||
### 4. 启用 10GB 本地缓存
|
||||
|
||||
Mountpoint 支持可选的本地缓存,用于加速对热点数据的重复读取。它的工作模式是按需加载,只有被访问过的数据才会被缓存。
|
||||
|
||||
你可以通过以下参数启用并限制缓存大小:
|
||||
|
||||
* `--cache <目录>`:指定缓存数据存放的本地目录。
|
||||
* `--max-cache-size <大小>`:**以 MiB 为单位**设置缓存的最大容量。缓存淘汰策略为 **LRU(最近最少使用)**。
|
||||
|
||||
**挂载命令示例(10GB = 10240 MiB):**
|
||||
|
||||
```bash
|
||||
# 创建缓存目录
|
||||
mkdir ~/cache
|
||||
|
||||
# 挂载并启用缓存,限制最大10GB
|
||||
mount-s3 my-bucket ~/mnt \
|
||||
--endpoint-url http://你的RustFS服务IP:9000 \
|
||||
--cache ~/cache \
|
||||
--max-cache-size 10240
|
||||
```
|
||||
|
||||
当缓存占满后,Mountpoint 会自动淘汰最久未使用的数据以腾出空间。
|
||||
|
||||
### 5. 其他常用选项
|
||||
|
||||
* **元数据缓存 (`--metadata-ttl`)**:缓存文件的元数据(如大小、存在性),可减少对 S3 的请求。但需要注意,这可能会使外部对文件的修改无法及时看到。
|
||||
* **后台运行**:`mount-s3` 命令默认在后台运行,不会阻塞终端。
|
||||
* **卸载挂载点**:
|
||||
```bash
|
||||
umount ~/mnt
|
||||
```
|
||||
如果权限不足,可能需要使用 `sudo`。
|
||||
|
||||
### 6. 核心注意事项
|
||||
|
||||
1. **缓存仅加速读取**:本地缓存**仅对读取操作生效**。所有的写入(创建、修改、删除)操作都会**直接提交到后端的 S3 服务**,不会先写入缓存。
|
||||
2. **非完整 POSIX 兼容**:Mountpoint 并非一个完整的 POSIX 文件系统,它针对高吞吐量的读写访问进行了优化。一些依赖复杂文件系统特性(如文件锁、稀疏文件等)的应用可能无法正常工作。
|
||||
3. **权限问题**:如果遇到权限错误,可以尝试在挂载命令中添加 `--allow-other` 参数,允许其他用户访问挂载点。
|
||||
|
||||
### 7. 在 Docker 容器中使用
|
||||
|
||||
Mountpoint 也提供了官方 Docker 镜像,方便在容器化环境中使用。
|
||||
|
||||
```bash
|
||||
# 拉取镜像
|
||||
docker pull public.ecr.aws/mountpoint-s3/mountpoint-s3
|
||||
|
||||
# 运行容器并挂载
|
||||
docker run -it --rm \
|
||||
--cap-add SYS_ADMIN \
|
||||
--device /dev/fuse \
|
||||
-e AWS_ACCESS_KEY_ID=myaccesskey \
|
||||
-e AWS_SECRET_ACCESS_KEY=mysecretkey \
|
||||
-e AWS_ENDPOINT_URL=http://你的RustFS服务IP:9000 \
|
||||
public.ecr.aws/mountpoint-s3/mountpoint-s3 \
|
||||
my-bucket /mnt
|
||||
```
|
||||
注意,运行需要添加 `--cap-add SYS_ADMIN` 和 `--device /dev/fuse` 权限。
|
||||
|
||||
|
||||
|
||||
## 查询所有挂载
|
||||
mount | grep mountpoint-s3
|
||||
|
||||
|
||||
## 取消挂载
|
||||
umount
|
||||
@@ -0,0 +1,163 @@
|
||||
监测管理网络设备的工具。SNMP="Simple Network Management Protocol"="简单网络管理协议",应用层协议,传输层一般采用UDP。SNMP采用 UDP 161端口接收和发送请求,162端口接收trap。
|
||||
|
||||
SNMP 目前共有 3 个版本,分别为 v1、v2 和 v3,说明如下:
|
||||
- SNMP v1:是 SNMP 协议的最初版本,在 1988 年被制定,并被 Internet 体系结构委员会(IAB)采纳作为一个短期的网络管理解决方案。不过依然是众多厂家实现SNMP基本方式。
|
||||
- SNMP v2:是 1992 年发布的 SNMP 的第二个版本。它修订了第一版,并且在性能、安全、机密性和管理者之间通信等方面进行了大量改进。通常被指是基于community的SNMP V2。Community实质上就是密码。
|
||||
- SNMP v3:是目前最新的版本。它是 2004 年制定的,协议编号为 RFC3411-RFC3418(STD0062)。它为提升协议的安全性,增加了认证和密文传输功能,它对网络管理最大的贡献在于其安全性
|
||||
|
||||
## 架构
|
||||
SNMP网络架构组成:NMS(网络管理站)、Agent(代理)、MIB(管理信息库)
|
||||
|
||||
Agent(代理)运行在被管理的网络节点上。
|
||||
NMS(网络管理站)负责收集维护各个SNMP 元素的信息(NMS主动向Agent请求,或Agent主动SNMP trap 上传),能请求/上传哪些内容去MIB中读取(MIB定义了设备中的被管理对象)。
|
||||
|
||||
|
||||
![[7c1f20e259bd77445fba6dd39df75b22_f0a37d4194ff4267bfedd0e8e852b3dd.png]]
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## 配置
|
||||
```
|
||||
cd /etc/snmp/
|
||||
```
|
||||
有 snmpd.conf 、snmptrapd.conf 两个配置文件。
|
||||
|
||||
|
||||
|
||||
## 允许远程主机访问
|
||||
|
||||
默认情况下,snmp服务只是对本地开启,是无法通过远程获取该主机的snmp信息的:
|
||||
|
||||
> root@apig:/etc/snmp# sudo netstat -antup | grep 161
|
||||
> udp 0 0 127.0.0.1:161 0.0.0.0:* 19410/snmpd
|
||||
|
||||
可以看到,161端口只对本机开放(161端口号是snmp服务的端口号),我们需要修改一下,让snmp服务对外开放。
|
||||
|
||||
修改`/etc/snmp/snmpd.conf`配置文件,大概在15行,将下面一行注释掉:
|
||||
|
||||
> agentAddress udp:127.0.0.1:161
|
||||
|
||||
同时去掉下面这一行的注释:
|
||||
|
||||
> #agentAddress udp:161,udp6:[::1]:161
|
||||
|
||||
|
||||
|
||||
重新启动snmp服务,再通过命令观察:
|
||||
|
||||
> root@apig:/etc/snmp# sudo service snmpd restart
|
||||
> root@apig:/etc/snmp# sudo netstat -antup | grep 161
|
||||
> udp 0 0 0.0.0.0:161 0.0.0.0:* 19770/snmpd
|
||||
> udp6 0 0 ::1:161 :::* 19770/snmpd
|
||||
>
|
||||
|
||||
|
||||
|
||||
## 配置共同体(可理解为密码)
|
||||
snmpd.conf 中需要配置
|
||||
|
||||
```
|
||||
rocommunity public
|
||||
syslocation "Your Location"
|
||||
syscontact your@email.com
|
||||
```
|
||||
|
||||
SNMP community strings leverage a user ID or password to access the router or other device information. SNMP community strings are only available with SNMPv1 and SNMPv2c protocols. SNMPv3 requires username/password authentication as well as an encryption key. Many SNMPv1 and v2c devices are shipped with a “public” read-only community string. Most network administrators customize the community strings in the device settings as a best practice.
|
||||
|
||||
|
||||
|
||||
自行修改
|
||||
```
|
||||
rocommunity sunyard
|
||||
syslocation "Hangzhou Zhejiang China"
|
||||
syscontact scm@sunyard.com
|
||||
|
||||
```
|
||||
|
||||
|
||||
![[Pasted image 20241023152807.png]]
|
||||
|
||||
|
||||
|
||||
|
||||
## SNMP OID
|
||||
Network Interface Statistics
|
||||
List NIC names: .1.3.6.1.2.1.2.2.1.2
|
||||
Get Bytes IN: .1.3.6.1.2.1.2.2.1.10
|
||||
Get Bytes IN for NIC 4: .1.3.6.1.2.1.2.2.1.10.4
|
||||
Get Bytes OUT: .1.3.6.1.2.1.2.2.1.16
|
||||
Get Bytes OUT for NIC 4: .1.3.6.1.2.1.2.2.1.16.4
|
||||
|
||||
|
||||
|
||||
CPU Statistics
|
||||
Load
|
||||
1 minute Load: .1.3.6.1.4.1.2021.10.1.3.1
|
||||
5 minute Load: .1.3.6.1.4.1.2021.10.1.3.2
|
||||
15 minute Load: .1.3.6.1.4.1.2021.10.1.3.3
|
||||
|
||||
|
||||
|
||||
CPU times
|
||||
percentage of user CPU time: .1.3.6.1.4.1.2021.11.9.0
|
||||
raw user cpu time: .1.3.6.1.4.1.2021.11.50.0
|
||||
percentages of system CPU time: .1.3.6.1.4.1.2021.11.10.0
|
||||
raw system cpu time: .1.3.6.1.4.1.2021.11.52.0
|
||||
percentages of idle CPU time: .1.3.6.1.4.1.2021.11.11.0
|
||||
raw idle cpu time: .1.3.6.1.4.1.2021.11.53.0
|
||||
raw nice cpu time: .1.3.6.1.4.1.2021.11.51.0
|
||||
|
||||
|
||||
|
||||
Memory Statistics
|
||||
Total Swap Size: .1.3.6.1.4.1.2021.4.3.0
|
||||
Available Swap Space: .1.3.6.1.4.1.2021.4.4.0
|
||||
Total RAM in machine: .1.3.6.1.4.1.2021.4.5.0
|
||||
Total RAM used: .1.3.6.1.4.1.2021.4.6.0
|
||||
Total RAM Free: .1.3.6.1.4.1.2021.4.11.0
|
||||
Total RAM Shared: .1.3.6.1.4.1.2021.4.13.0
|
||||
Total RAM Buffered: .1.3.6.1.4.1.2021.4.14.0
|
||||
Total Cached Memory: .1.3.6.1.4.1.2021.4.15.0
|
||||
|
||||
|
||||
|
||||
Disk Statistics
|
||||
Add the following line to snmpd.conf and restart:
|
||||
`includeAllDisks 10% for all partitions and disks`
|
||||
|
||||
|
||||
|
||||
Disk OID's
|
||||
Path where the disk is mounted: .1.3.6.1.4.1.2021.9.1.2.1
|
||||
Path of the device for the partition: .1.3.6.1.4.1.2021.9.1.3.1
|
||||
Total size of the disk/partion (kBytes): .1.3.6.1.4.1.2021.9.1.6.1
|
||||
Available space on the disk: .1.3.6.1.4.1.2021.9.1.7.1
|
||||
Used space on the disk: .1.3.6.1.4.1.2021.9.1.8.1
|
||||
Percentage of space used on disk: .1.3.6.1.4.1.2021.9.1.9.1
|
||||
Percentage of inodes used on disk: .1.3.6.1.4.1.2021.9.1.10.1
|
||||
|
||||
|
||||
|
||||
System Uptime: .1.3.6.1.2.1.1.3.0
|
||||
|
||||
|
||||
|
||||
# 什么是SNMP trap?
|
||||
|
||||
被管理设备主动上发消息
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## 参考
|
||||
- [Linux SNMP OID’s for CPU, Memory and Disk Statistics](http://www.linux-admins.net/2012/02/linux-snmp-oids-for-cpumemory-and-disk.html)
|
||||
- [SNMP的安装与Trap的发送与接收java实现](https://blog.csdn.net/weixin_42551921/article/details/117479344)
|
||||
@@ -0,0 +1,163 @@
|
||||
监测管理网络设备的工具。SNMP="Simple Network Management Protocol"="简单网络管理协议",应用层协议,传输层一般采用UDP。SNMP采用 UDP 161端口接收和发送请求,162端口接收trap。
|
||||
|
||||
SNMP 目前共有 3 个版本,分别为 v1、v2 和 v3,说明如下:
|
||||
- SNMP v1:是 SNMP 协议的最初版本,在 1988 年被制定,并被 Internet 体系结构委员会(IAB)采纳作为一个短期的网络管理解决方案。不过依然是众多厂家实现SNMP基本方式。
|
||||
- SNMP v2:是 1992 年发布的 SNMP 的第二个版本。它修订了第一版,并且在性能、安全、机密性和管理者之间通信等方面进行了大量改进。通常被指是基于community的SNMP V2。Community实质上就是密码。
|
||||
- SNMP v3:是目前最新的版本。它是 2004 年制定的,协议编号为 RFC3411-RFC3418(STD0062)。它为提升协议的安全性,增加了认证和密文传输功能,它对网络管理最大的贡献在于其安全性
|
||||
|
||||
## 架构
|
||||
SNMP网络架构组成:NMS(网络管理站)、Agent(代理)、MIB(管理信息库)
|
||||
|
||||
Agent(代理)运行在被管理的网络节点上。
|
||||
NMS(网络管理站)负责收集维护各个SNMP 元素的信息(NMS主动向Agent请求,或Agent主动SNMP trap 上传),能请求/上传哪些内容去MIB中读取(MIB定义了设备中的被管理对象)。
|
||||
|
||||
|
||||
![[7c1f20e259bd77445fba6dd39df75b22_f0a37d4194ff4267bfedd0e8e852b3dd.png]]
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## 配置
|
||||
```
|
||||
cd /etc/snmp/
|
||||
```
|
||||
有 snmpd.conf 、snmptrapd.conf 两个配置文件。
|
||||
|
||||
|
||||
|
||||
## 允许远程主机访问
|
||||
|
||||
默认情况下,snmp服务只是对本地开启,是无法通过远程获取该主机的snmp信息的:
|
||||
|
||||
> root@apig:/etc/snmp# sudo netstat -antup | grep 161
|
||||
> udp 0 0 127.0.0.1:161 0.0.0.0:* 19410/snmpd
|
||||
|
||||
可以看到,161端口只对本机开放(161端口号是snmp服务的端口号),我们需要修改一下,让snmp服务对外开放。
|
||||
|
||||
修改`/etc/snmp/snmpd.conf`配置文件,大概在15行,将下面一行注释掉:
|
||||
|
||||
> agentAddress udp:127.0.0.1:161
|
||||
|
||||
同时去掉下面这一行的注释:
|
||||
|
||||
> #agentAddress udp:161,udp6:[::1]:161
|
||||
|
||||

|
||||
|
||||
重新启动snmp服务,再通过命令观察:
|
||||
|
||||
> root@apig:/etc/snmp# sudo service snmpd restart
|
||||
> root@apig:/etc/snmp# sudo netstat -antup | grep 161
|
||||
> udp 0 0 0.0.0.0:161 0.0.0.0:* 19770/snmpd
|
||||
> udp6 0 0 ::1:161 :::* 19770/snmpd
|
||||
>
|
||||
|
||||
|
||||
|
||||
## 配置共同体(可理解为密码)
|
||||
snmpd.conf 中需要配置
|
||||
|
||||
```
|
||||
rocommunity public
|
||||
syslocation "Your Location"
|
||||
syscontact your@email.com
|
||||
```
|
||||
|
||||
SNMP community strings leverage a user ID or password to access the router or other device information. SNMP community strings are only available with SNMPv1 and SNMPv2c protocols. SNMPv3 requires username/password authentication as well as an encryption key. Many SNMPv1 and v2c devices are shipped with a “public” read-only community string. Most network administrators customize the community strings in the device settings as a best practice.
|
||||
|
||||
|
||||
|
||||
自行修改
|
||||
```
|
||||
rocommunity sunyard
|
||||
syslocation "Hangzhou Zhejiang China"
|
||||
syscontact scm@sunyard.com
|
||||
|
||||
```
|
||||
|
||||
|
||||
![[Pasted image 20241023152807.png]]
|
||||
|
||||
|
||||
|
||||
|
||||
## SNMP OID
|
||||
Network Interface Statistics
|
||||
List NIC names: .1.3.6.1.2.1.2.2.1.2
|
||||
Get Bytes IN: .1.3.6.1.2.1.2.2.1.10
|
||||
Get Bytes IN for NIC 4: .1.3.6.1.2.1.2.2.1.10.4
|
||||
Get Bytes OUT: .1.3.6.1.2.1.2.2.1.16
|
||||
Get Bytes OUT for NIC 4: .1.3.6.1.2.1.2.2.1.16.4
|
||||
|
||||
|
||||
|
||||
CPU Statistics
|
||||
Load
|
||||
1 minute Load: .1.3.6.1.4.1.2021.10.1.3.1
|
||||
5 minute Load: .1.3.6.1.4.1.2021.10.1.3.2
|
||||
15 minute Load: .1.3.6.1.4.1.2021.10.1.3.3
|
||||
|
||||
|
||||
|
||||
CPU times
|
||||
percentage of user CPU time: .1.3.6.1.4.1.2021.11.9.0
|
||||
raw user cpu time: .1.3.6.1.4.1.2021.11.50.0
|
||||
percentages of system CPU time: .1.3.6.1.4.1.2021.11.10.0
|
||||
raw system cpu time: .1.3.6.1.4.1.2021.11.52.0
|
||||
percentages of idle CPU time: .1.3.6.1.4.1.2021.11.11.0
|
||||
raw idle cpu time: .1.3.6.1.4.1.2021.11.53.0
|
||||
raw nice cpu time: .1.3.6.1.4.1.2021.11.51.0
|
||||
|
||||
|
||||
|
||||
Memory Statistics
|
||||
Total Swap Size: .1.3.6.1.4.1.2021.4.3.0
|
||||
Available Swap Space: .1.3.6.1.4.1.2021.4.4.0
|
||||
Total RAM in machine: .1.3.6.1.4.1.2021.4.5.0
|
||||
Total RAM used: .1.3.6.1.4.1.2021.4.6.0
|
||||
Total RAM Free: .1.3.6.1.4.1.2021.4.11.0
|
||||
Total RAM Shared: .1.3.6.1.4.1.2021.4.13.0
|
||||
Total RAM Buffered: .1.3.6.1.4.1.2021.4.14.0
|
||||
Total Cached Memory: .1.3.6.1.4.1.2021.4.15.0
|
||||
|
||||
|
||||
|
||||
Disk Statistics
|
||||
Add the following line to snmpd.conf and restart:
|
||||
`includeAllDisks 10% for all partitions and disks`
|
||||
|
||||
|
||||
|
||||
Disk OID's
|
||||
Path where the disk is mounted: .1.3.6.1.4.1.2021.9.1.2.1
|
||||
Path of the device for the partition: .1.3.6.1.4.1.2021.9.1.3.1
|
||||
Total size of the disk/partion (kBytes): .1.3.6.1.4.1.2021.9.1.6.1
|
||||
Available space on the disk: .1.3.6.1.4.1.2021.9.1.7.1
|
||||
Used space on the disk: .1.3.6.1.4.1.2021.9.1.8.1
|
||||
Percentage of space used on disk: .1.3.6.1.4.1.2021.9.1.9.1
|
||||
Percentage of inodes used on disk: .1.3.6.1.4.1.2021.9.1.10.1
|
||||
|
||||
|
||||
|
||||
System Uptime: .1.3.6.1.2.1.1.3.0
|
||||
|
||||
|
||||
|
||||
# 什么是SNMP trap?
|
||||
|
||||
被管理设备主动上发消息
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
## 参考
|
||||
- [Linux SNMP OID’s for CPU, Memory and Disk Statistics](http://www.linux-admins.net/2012/02/linux-snmp-oids-for-cpumemory-and-disk.html)
|
||||
- [SNMP的安装与Trap的发送与接收java实现](https://blog.csdn.net/weixin_42551921/article/details/117479344)
|
||||
@@ -0,0 +1 @@
|
||||
https://link.zhihu.com/?target=https%3A//github.com/aquasecurity/trivy
|
||||
@@ -0,0 +1,327 @@
|
||||
虽然说只要高级语言能转换成 LLVM IR,就能被编译成 WebAssembly 字节码,官方也推荐c/c++的方式,但是让一个前端工程师去熟练使用c/c++显然是有点困难,那么TypeScript 的方式便是前端编写 WebAssembly 最佳选择。
|
||||
|
||||
要将TypeScript 编译为WebAssembly,就要用到[AssemblyScript](https://github.com/AssemblyScript)编译器了。
|
||||
|
||||
AssemblyScript使用Binaryen(Emscripten的WebAssembly后端)将严格类型化的TypeScript(基本的带有类型的JavaScript)编译为WebAssembly,虽然它提供了几种新的特定于WebAssembly的类型和内置函数,但它本身并不是一种真正的语言,而是一种编译器变体。 它生成精简的WebAssembly模块,只需要一个npm安装。
|
||||
|
||||
## 1.安装
|
||||
|
||||
推荐使用cnpm安装,npm太慢了。
|
||||
|
||||
1 cnpm install --save-dev AssemblyScript/assemblyscript
|
||||
|
||||
执行过程如下,安装完成之后只有一个node_modules文件夹
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
1 E:\Code\assembly>cnpm install --save-dev AssemblyScript/assemblyscript
|
||||
2 - [@AssemblyScript/assemblyscript] install from git github:AssemblyScript/assemblyscript, may be very slow, please keep patience
|
||||
3 √ Installed 1 packages
|
||||
4 √ Linked 15 latest versions
|
||||
5 √ Run 0 scripts
|
||||
6 Recently updated (since 2019-02-17): 1 packages (detail see file E:\Code\assembly\node_modules\.recently_updates.txt)
|
||||
7 √ All packages installed (14 packages installed from npm registry, 1 packages installed from git, used 1m(network 1m), speed 10.27kB/s, json 14(31.43kB), tarball 707.23kB)
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
## 2.创建项目
|
||||
|
||||
正确安装AssemblyScript后,它会提供一个名为asinit的小型实用工具来构建一个新项目,例如,在当前目录中:
|
||||
|
||||
1 npx asinit .
|
||||
|
||||
就像使用express初始化项目一样,执行过程如下
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
1 E:\Code\assembly>npx asinit .
|
||||
2 Version: 0.6.0
|
||||
3
|
||||
4 This command will make sure that the following files exist in the project 5 directory 'E:\Code\assembly':
|
||||
6
|
||||
7 ./assembly
|
||||
8 Directory holding the AssemblyScript sources being compiled to WebAssembly.
|
||||
9
|
||||
10 ./assembly/tsconfig.json
|
||||
11 TypeScript configuration inheriting recommended AssemblyScript settings.
|
||||
12
|
||||
13 ./assembly/index.ts
|
||||
14 Exemplary entry file being compiled to WebAssembly to get you started.
|
||||
15
|
||||
16 ./build
|
||||
17 Build artifact directory where compiled WebAssembly files are stored.
|
||||
18
|
||||
19 ./build/.gitignore
|
||||
20 Git configuration that excludes compiled binaries from source control.
|
||||
21
|
||||
22 ./index.js
|
||||
23 Main file loading the WebAssembly module and exporting its exports.
|
||||
24
|
||||
25 ./package.json
|
||||
26 Package info containing the necessary commands to compile to WebAssembly.
|
||||
27
|
||||
28 The command will try to update existing files to match the correct settings
|
||||
29 for this instance of the compiler in 'E:\Code\assembly\node_modules\_assemblyscript@0.6.0@assemblyscript'.
|
||||
30
|
||||
31 Do you want to proceed? [Y/n] y
|
||||
32
|
||||
33 - Making sure that the project directory exists...
|
||||
34 Exists: E:\Code\assembly
|
||||
35
|
||||
36 - Making sure that the 'assembly' directory exists...
|
||||
37 Created: E:\Code\assembly\assembly
|
||||
38
|
||||
39 - Making sure that 'assembly/tsconfig.json' is set up...
|
||||
40 Created: E:\Code\assembly\assembly\tsconfig.json
|
||||
41
|
||||
42 - Making sure that 'assembly/index.ts' exists...
|
||||
43 Created: E:\Code\assembly\assembly\index.ts
|
||||
44
|
||||
45 - Making sure that the 'build' directory exists...
|
||||
46 Created: E:\Code\assembly\build
|
||||
47
|
||||
48 - Making sure that 'build/.gitignore' is set up...
|
||||
49 Created: E:\Code\assembly\build\.gitignore
|
||||
50
|
||||
51 - Making sure that 'package.json' contains the build commands...
|
||||
52 Updated: E:\Code\assembly\package.json
|
||||
53
|
||||
54 - Making sure that 'index.js' exists...
|
||||
55 Created: E:\Code\assembly\index.js
|
||||
56
|
||||
57 Done!
|
||||
58
|
||||
59 To edit the entry file, open 'assembly/index.ts' in your editor of choice.
|
||||
60 Create as many additional files as necessary and use them as imports.
|
||||
61
|
||||
62 To build the entry file to WebAssembly when you are ready, run:
|
||||
63
|
||||
64 npm run asbuild
|
||||
65
|
||||
66 Running the command above creates the following binaries incl. their respective
|
||||
67 text format representations and source maps:
|
||||
68
|
||||
69 ./build/untouched.wasm
|
||||
70 ./build/untouched.wasm.map
|
||||
71 ./build/untouched.wat
|
||||
72
|
||||
73 ^ The untouched WebAssembly module as generated by the compiler.
|
||||
74 This one matches your sources exactly, without any optimizations.
|
||||
75
|
||||
76 ./build/optimized.wasm
|
||||
77 ./build/optimized.wasm.map
|
||||
78 ./build/optimized.wat
|
||||
79
|
||||
80 ^ The optimized WebAssembly module using default optimization settings (-O2s).
|
||||
81 You can change the optimization settings in 'package.json'.
|
||||
82
|
||||
83 Additional documentation is available at the AssemblyScript wiki:
|
||||
84
|
||||
85 https://github.com/AssemblyScript/assemblyscript/wiki
|
||||
86
|
||||
87 Have a nice day!
|
||||
88
|
||||
89 E:\Code\assembly>
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
完成的目录结构是这样的:
|
||||
|
||||
[](https://img2018.cnblogs.com/blog/1604637/201902/1604637-20190224233253174-1657805576.png)
|
||||
|
||||
目录结构含义:
|
||||
|
||||
assembly / index.ts上的示例性条目文件
|
||||
|
||||
index.js中的通用索引文件,用于加载已编译的二进制文件和必要的配置文件,如package.json和tsconfig.json
|
||||
|
||||
初始化后,只需在编码时使用现有的TypeScript工具,并使用编译器手动构建到WebAssembly,或者使用生成的构建任务:按照提示,运行以下命令:
|
||||
|
||||
1 npm run asbuild
|
||||
|
||||
build文件夹初始化只有一个.gitignore,该命令会在build文件夹中创建.wat与.wasm文件
|
||||
|
||||
以上只是构建一个示例项目,如果需要适合开发的安装,可以通过克隆GitHub存储库来实现:
|
||||
|
||||
1 $> git clone https://github.com/AssemblyScript/assemblyscript.git
|
||||
2 $> cd assemblyscript
|
||||
3 $> npm install
|
||||
4 $> npm link
|
||||
|
||||
请注意,编译器的新克隆将使用dist /中的分发文件,但它也可以在npm运行清理后直接通过ts节点运行源,这在开发中很有用。 也可以通过运行asc -v来检查这种情况(如果它声明-dev则运行源)。
|
||||
|
||||
## 3.使用编译器
|
||||
|
||||
类似于TypeScript的tsc编译为JavaScript,AssemblyScript的asc编译为WebAssembly:
|
||||
|
||||
例如,用 TypeScript 实现斐波那契序列计算的模块 f.ts 如下:
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
1 export function f(x: i32): i32 {
|
||||
2 if (x === 1 || x === 2) {
|
||||
3 return 1;
|
||||
4 }
|
||||
5 return f(x - 1) + f(x - 2)
|
||||
6 }
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
执行以下asc命令,就能把以上代码编译成可运行的 WebAssembly 模块,比起c/c++的编译方式,这种人性化多了。
|
||||
|
||||
1 asc f.ts -o f.wasm
|
||||
|
||||
以上代码中出现了一个新的内置类型 i32,这是 AssemblyScript 在 TypeScript 的基础上内置的类型。 AssemblyScript 和 TypeScript 有细微区别,AssemblyScript 是 TypeScript 的子集,为了方便编译成 WebAssembly 在 TypeScript 的基础上加了更严格的[类型限制](https://github.com/AssemblyScript/assemblyscript/wiki/Limitations), 区别如下:
|
||||
|
||||
- 比 TypeScript 多了很多更细致的内置类型,以优化性能和内存占用,详情[文档](https://github.com/AssemblyScript/assemblyscript/wiki/Types);
|
||||
- 不能使用 any 和 undefined 类型,以及枚举类型;
|
||||
- 可空类型的变量必须是引用类型,而不能是基本数据类型如 string、number、boolean;
|
||||
- 函数中的可选参数必须提供默认值,函数必须有返回类型,无返回值的函数返回类型需要是 void;
|
||||
- 不能使用 JS 环境中的内置函数,只能使用 [AssemblyScript 提供的内置函数](https://github.com/AssemblyScript/assemblyscript/wiki/Built-in-functions)。
|
||||
|
||||
总体来说 AssemblyScript 比 TypeScript 又多了很多限制,编写起来会觉得局限性很大; 用 AssemblyScript 来写 WebAssembly 经常会出现 tsc 编译通过但运行 WebAssembly 时出错的情况,这很可能就是你没有遵守以上限制导致的;但 AssemblyScript 通过修改 TypeScript 编译器默认配置能在编译阶段找出大多错误。
|
||||
|
||||
AssemblyScript 的实现原理其实也借助了 LLVM,它通过 TypeScript 编译器把 TS 源码解析成 AST,再把 AST 翻译成 IR,再通过 LLVM 编译成 WebAssembly 字节码实现; 上面提到的各种限制都是为了方便把 AST 转换成 LLVM IR。
|
||||
|
||||
**asc编译器具体API如下**
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
1 SYNTAX
|
||||
2 asc [entryFile ...] [options]
|
||||
3
|
||||
4 EXAMPLES
|
||||
5 asc hello.ts
|
||||
6 asc hello.ts -b hello.wasm -t hello.wat
|
||||
7 asc hello1.ts hello2.ts -b -O > hello.wasm
|
||||
8
|
||||
9 OPTIONS
|
||||
10 --version, -v Prints just the compiler's version and exits.
|
||||
11 --help, -h Prints this message and exits.
|
||||
12 --optimize, -O Optimizes the module. Also has the usual shorthands:
|
||||
13
|
||||
14 -O Uses defaults. Equivalent to -O2s
|
||||
15 -O0 Equivalent to --optimizeLevel 0
|
||||
16 -O1 Equivalent to --optimizeLevel 1
|
||||
17 -O2 Equivalent to --optimizeLevel 2
|
||||
18 -O3 Equivalent to --optimizeLevel 3
|
||||
19 -Oz Equivalent to -O but with --shrinkLevel 2
|
||||
20 -O3s Equivalent to -O3 with --shrinkLevel 1 etc.
|
||||
21
|
||||
22 --optimizeLevel How much to focus on optimizing code. [0-3]
|
||||
23 --shrinkLevel How much to focus on shrinking code size. [0-2, s=1, z=2]
|
||||
24 --validate, -c Validates the module using Binaryen. Exits if invalid.
|
||||
25 --baseDir Specifies the base directory of input and output files.
|
||||
26 --outFile, -o Specifies the output file. File extension indicates format.
|
||||
27 --binaryFile, -b Specifies the binary output file (.wasm).
|
||||
28 --textFile, -t Specifies the text output file (.wat).
|
||||
29 --asmjsFile, -a Specifies the asm.js output file (.js).
|
||||
30 --idlFile, -i Specifies the WebIDL output file (.webidl).
|
||||
31 --tsdFile, -d Specifies the TypeScript definition output file (.d.ts).
|
||||
32 --sourceMap Enables source map generation. Optionally takes the URL
|
||||
33 used to reference the source map from the binary file.
|
||||
34 --debug Enables debug information in emitted binaries.
|
||||
35 --noAssert Replaces assertions with just their value without trapping.
|
||||
36 --noEmit Performs compilation as usual but does not emit code.
|
||||
37 --importMemory Imports the memory instance provided by the embedder.
|
||||
38 --sharedMemory Declare memory as shared by settings the max shared memory.
|
||||
39 --memoryBase Sets the start offset of compiler-generated static memory.
|
||||
40 --importTable Imports the function table instance provided by the embedder.
|
||||
41 --noLib Does not include the shipped standard library.
|
||||
42 --lib Adds one or multiple paths to custom library components and
|
||||
43 uses exports of all top-level files at this path as globals.
|
||||
44 --use, -u Aliases a global object under another name, e.g., to switch
|
||||
45 the default 'Math' implementation used: --use Math=JSMath
|
||||
46 --trapMode Sets the trap mode to use.
|
||||
47
|
||||
48 allow Allow trapping operations. This is the default.
|
||||
49 clamp Replace trapping operations with clamping semantics.
|
||||
50 js Replace trapping operations with JS semantics.
|
||||
51
|
||||
52 --runPasses Specifies additional Binaryen passes to run after other
|
||||
53 optimizations, if any. See: Binaryen/src/passes/pass.cpp
|
||||
54 --enable Enables additional (experimental) WebAssembly features.
|
||||
55
|
||||
56 sign-extension Enables sign-extension operations
|
||||
57 mutable-global Enables mutable global imports and exports
|
||||
58 bulk-memory Enables bulk memory operations
|
||||
59 simd Enables SIMD types and operations.
|
||||
60 threads Enables threading and atomic operations.
|
||||
61
|
||||
62 --transform Specifies the path to a custom transform to 'require'.
|
||||
63 --measure Prints measuring information on I/O and compile times.
|
||||
64 --noColors Disables terminal colors.
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
编译器API也可以以编程方式使用。 它接受与CLI相同的选项,但也允许您覆盖stdout和stderr和/或提供回调:
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
1 const asc = require("assemblyscript/cli/asc");
|
||||
2 asc.main([
|
||||
3 "myModule.ts",
|
||||
4 "--binaryFile", "myModule.wasm",
|
||||
5 "--optimize",
|
||||
6 "--sourceMap",
|
||||
7 "--measure"
|
||||
8 ], {
|
||||
9 stdout: process.stdout,
|
||||
10 stderr: process.stderr
|
||||
11 }, function(err) {
|
||||
12 if (err)
|
||||
13 throw err;
|
||||
14 ...
|
||||
15 });
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
可以通过编程方式获取可用的命令行选项:
|
||||
|
||||
1 const options = require("assemblyscript/cli/asc.json");
|
||||
2 ...
|
||||
|
||||
您也可以直接编译源字符串,例如在浏览器环境中:
|
||||
|
||||
1 const { binary, text, stdout, stderr } = asc.compileString(`...`, { optimize: 2 });
|
||||
2 ...
|
||||
|
||||
## 4.使用编译的.wasm模块
|
||||
|
||||
index.js示例代码如下:
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
1 const fs = require("fs");
|
||||
2 const compiled = new WebAssembly.Module(fs.readFileSync(__dirname + "/build/optimized.wasm"));
|
||||
3 const imports = {};
|
||||
4 Object.defineProperty(module, "exports", {
|
||||
5 get: () => new WebAssembly.Instance(compiled, imports).exports
|
||||
6 });
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
使用上面编译的f.wasm
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
1 fetch('f.wasm') // 网络加载 f.wasm 文件
|
||||
2 .then(res => res.arrayBuffer()) // 转成 ArrayBuffer
|
||||
3 .then(WebAssembly.instantiate) // 编译为当前 CPU 架构的机器码 + 实例化
|
||||
4 .then(mod => { // 调用模块实例上的 f 函数计算
|
||||
5 console.log(mod.instance.f(50));
|
||||
6 });
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
## 5.参考文献:
|
||||
|
||||
[GitHub—AssemblyScript 开源项目](https://github.com/AssemblyScript/assemblyscript#installation)
|
||||
|
||||
[吴浩麟—WebAssembly 现状与实战](https://www.ibm.com/developerworks/cn/web/wa-lo-webassembly-status-and-reality/index.html)
|
||||
|
||||
- [1.安装](https://www.cnblogs.com/jixiaohua/p/10428785.html#tid-SJS3EZ)
|
||||
- [2.创建项目](https://www.cnblogs.com/jixiaohua/p/10428785.html#tid-4SQ4xa)
|
||||
- [3.使用编译器](https://www.cnblogs.com/jixiaohua/p/10428785.html#tid-djiMkK)
|
||||
- [4.使用编译的.wasm模块](https://www.cnblogs.com/jixiaohua/p/10428785.html#tid-RwBDGt)
|
||||
- [5.参考文献:](https://www.cnblogs.com/jixiaohua/p/10428785.html#tid-bRHtGH)
|
||||
@@ -0,0 +1,32 @@
|
||||
### 安装需要网络问题
|
||||
|
||||
|
||||
### 如何通过 ip 命令配置网络(临时)
|
||||
查看
|
||||
ip addr show
|
||||
|
||||
ip a
|
||||
|
||||
### 配置静态IP地址
|
||||
|
||||
要为网络接口配置静态 IP 地址,您可以使用 `ip addr add` 命令。例如,为 `eth0` 接口配置 IP 地址 `192.168.1.100` 和子网掩码 `255.255.255.0`:
|
||||
|
||||
`sudo ip addr add 192.168.1.100/24 dev eth0`
|
||||
|
||||
### 设置默认网关
|
||||
|
||||
要设置默认网关,可以使用 `ip route add` 命令。例如,设置网关为 `192.168.1.1`:
|
||||
|
||||
`sudo ip route add default via 192.168.1.1`
|
||||
|
||||
### 设置DNS服务器
|
||||
|
||||
在 Ubuntu 中,DNS 服务器的设置通常在 `/etc/resolv.conf` 文件中进行。您可以使用文本编辑器编辑该文件来添加 DNS 服务器:
|
||||
|
||||
`sudo nano /etc/resolv.conf`
|
||||
|
||||
然后添加您的 DNS 服务器,例如:
|
||||
|
||||
`nameserver 8.8.8.8 nameserver 8.8.4.4`
|
||||
|
||||
保存并退出编辑器。
|
||||
@@ -0,0 +1,32 @@
|
||||
### 安装需要网络问题
|
||||
|
||||
|
||||
### 如何通过 ip 命令配置网络(临时)
|
||||
查看
|
||||
ip addr show
|
||||
|
||||
ip a
|
||||
|
||||
### 配置静态IP地址
|
||||
|
||||
要为网络接口配置静态 IP 地址,您可以使用 `ip addr add` 命令。例如,为 `eth0` 接口配置 IP 地址 `192.168.1.100` 和子网掩码 `255.255.255.0`:
|
||||
|
||||
`sudo ip addr add 192.168.1.100/24 dev eth0`
|
||||
|
||||
### 设置默认网关
|
||||
|
||||
要设置默认网关,可以使用 `ip route add` 命令。例如,设置网关为 `192.168.1.1`:
|
||||
|
||||
`sudo ip route add default via 192.168.1.1`
|
||||
|
||||
### 设置DNS服务器
|
||||
|
||||
在 Ubuntu 中,DNS 服务器的设置通常在 `/etc/resolv.conf` 文件中进行。您可以使用文本编辑器编辑该文件来添加 DNS 服务器:
|
||||
|
||||
`sudo nano /etc/resolv.conf`
|
||||
|
||||
然后添加您的 DNS 服务器,例如:
|
||||
|
||||
`nameserver 8.8.8.8 nameserver 8.8.4.4`
|
||||
|
||||
保存并退出编辑器。
|
||||
@@ -0,0 +1,47 @@
|
||||
systemd-resolved 服务是用来提供本机应用软件与DNS 解析服务的,其包含解析主机名称、IP 地址、域名、DNS 资源记录等,Ubuntu修改DNS就需要通过此服务来完成!
|
||||
|
||||
# 问题
|
||||
|
||||
通常我们知道,修改dns的几个途径
|
||||
|
||||
- /etc/resolv.conf
|
||||
- /etc/netplan/01-netcfg.yaml
|
||||
|
||||
修改上面两个文件,一般情况下,可以解决,但是在一次使用新安装的ubuntu22.04的时候,发现,无论怎么修改,dig解析域名都是往127.0.0.53发送,哪怕在缓存中的已经生效
|
||||
|
||||
如何查看缓存中生效的配置呢
|
||||
|
||||
```bash
|
||||
cat /run/systemd/resolve/resolv.conf
|
||||
```
|
||||
|
||||
# 解决方法
|
||||
|
||||
需要删掉或者修改 **/etc/resolv.conf** 文件名
|
||||
|
||||
先修改dns配置
|
||||
|
||||
```bash
|
||||
vim /etc/systemd/resolved.conf
|
||||
[Resolve]
|
||||
DNS=223.6.6.6 114.114.114.114
|
||||
```
|
||||
|
||||
删除或者修改文件名
|
||||
|
||||
```bash
|
||||
mv /etc/resolv.conf /etc/resolv.conf.bak
|
||||
```
|
||||
|
||||
将 **/etc/systemd/resolved.conf** 新建快捷方式为 **/etc/resolv.conf**
|
||||
|
||||
```bash
|
||||
ln -s /run/systemd/resolve/resolv.conf /etc/
|
||||
```
|
||||
|
||||
最后重启网络
|
||||
|
||||
```bash
|
||||
systemctl restart systemd-resolved
|
||||
systemctl restart NetworkManager
|
||||
```
|
||||
@@ -0,0 +1,41 @@
|
||||
在Ubuntu中,默认情况下是禁用root用户的登录,而是使用sudo命令来获取root权限。如果你想要开启root用户权限,可以按照以下步骤操作:
|
||||
|
||||
1. 使用sudo命令获取root权限:
|
||||
|
||||
```
|
||||
sudo -i
|
||||
```
|
||||
|
||||
输入你当前用户的密码,即可进入root用户的环境。
|
||||
|
||||
2. 设置root用户的密码:
|
||||
|
||||
```
|
||||
sudo passwd root
|
||||
```
|
||||
|
||||
输入你当前用户的密码,并设置root用户的密码。
|
||||
|
||||
3. 打开root用户的登录权限: 编辑`/etc/ssh/sshd_config`文件:
|
||||
|
||||
```
|
||||
sudo nano /etc/ssh/sshd_config
|
||||
```
|
||||
|
||||
找到`PermitRootLogin`这一行,将其改为:
|
||||
|
||||
```
|
||||
PermitRootLogin yes
|
||||
```
|
||||
|
||||
保存文件并退出。
|
||||
|
||||
4. 重启SSH服务:
|
||||
|
||||
```
|
||||
sudo service ssh restart
|
||||
```
|
||||
|
||||
这样就成功开启了root用户权限。请注意,开启root用户权限会增加系统被攻击的风险,建议在使用完毕后再禁用root用户的登录权限。
|
||||
|
||||
购买使用亿速云服务器,可以极大降低初创企业、中小企业以及个人开发者等用户群体的整体IT使用成本,无需亲自搭建基础设施、简化了运维和管理的日常工作量,使用户能够更专注于自身的业务发展和创新。
|
||||
@@ -0,0 +1,62 @@
|
||||
### 一、组网说明
|
||||
|
||||
SW 3和SW 4两台交换机运行VRRP协议,为SW 1和SW 2提供虚拟网关服务,以保证SW 3和SW 4任意一台设备或链路中断的情况下SW 1还可以和SW 2通讯。
|
||||
|
||||
### 二、组网图
|
||||
|
||||
|
||||
|
||||
### 三、配置步骤
|
||||
|
||||
SW 3的配置
|
||||
#配置Vlan和三层接口
|
||||
switch(config)#**vlan** 10
|
||||
switch(config-Vlan10)#**switchport interface ethernet address** 1/1
|
||||
switch(config-Vlan10)#**ip address** 192.168.10.2 255.255.255.0
|
||||
switch(config-Vlan10)#**exit**
|
||||
switch(config)#**vlan** 20
|
||||
switch(config-Vlan20)#**switchport interface ethernet address** 1/2
|
||||
switch(config-Vlan20)#**ip address** 192.168.20.2 255.255.255.0
|
||||
switch(config-Vlan20)#**exit**
|
||||
#配置VRRP
|
||||
switch(config)#**router vrrp** 10
|
||||
switch(config-router)#**virtual-ip** 192.168.10.254
|
||||
switch(config-router)#**interface vlan** 10
|
||||
switch(config-router)#**priority** 120
|
||||
switch(config-router)#**enable**
|
||||
switch(config-router)#**exit**
|
||||
switch(config)#**router vrrp** 20
|
||||
switch(config-router)#**virtual-ip** 192.168.20.254
|
||||
switch(config-router)#**interface vlan** 20
|
||||
switch(config-router)#**priority** 120
|
||||
switch(config-router)#**enable**
|
||||
switch(config-router)#**exit**
|
||||
SW 4的配置
|
||||
#配置Vlan和三层接口
|
||||
switch(config)#**vlan** 10
|
||||
switch(config-Vlan10)#**switchport interface ethernet address** 1/1
|
||||
switch(config-Vlan10)#**ip address** 192.168.10.3 255.255.255.0
|
||||
switch(config-Vlan10)#**exit**
|
||||
switch(config)#**vlan** 20
|
||||
switch(config-Vlan20)#**switchport interface ethernet address** 1/2
|
||||
switch(config-Vlan20)#**ip address** 192.168.20.3 255.255.255.0
|
||||
switch(config-Vlan20)#**exit**
|
||||
#配置VRRP
|
||||
switch(config)#**router vrrp** 10
|
||||
switch(config-router)#**virtual-ip** 192.168.10.254
|
||||
switch(config-router)#**interface vlan** 10
|
||||
switch(config-router)#**enable**
|
||||
switch(config-router)#**exit**
|
||||
switch(config)#**router vrrp** 20
|
||||
switch(config-router)#**virtual-ip** 192.168.20.254
|
||||
switch(config-router)#**interface vlan** 20
|
||||
switch(config-router)#**enable**
|
||||
switch(config-router)#**exit**
|
||||
|
||||
### 四、注意事项
|
||||
|
||||
1.VRRP配置完成后,必须使用enable命令将VRRP使能。否则VRRP配置不生效。在修改VRRP组的配置时,也需要先将VRRP组Disable后才可以修改VRRP组的配置。
|
||||
2.VRRP组的ID号从1-255,总共可以创建255个VRRP组。
|
||||
3.VRRP组默认监控的是三层接口的UP/Down,在冗余链路的环境中,需要配合STP协议一起使用,以保证网络的可用性。(后续版本中,可以配合BFD功能监控物理接口的UP/Down)
|
||||
4.VRRP的交互报文只有定期发送的Hello报文,默认的交互时间是1S。当整机的VRRP组超过10组时,建议修改VRRP的交互间隔,避免设备在同一时间处理大量的VRRP报文。
|
||||
5.VRRP组根据优先级比较确认那台设备会成为Master,默认的优先级是100。优先级相同时,再比较IP地址,IP地址较大的一台会做为Master。
|
||||
@@ -0,0 +1,7 @@
|
||||
|
||||
初始配置 vim ~/.vimrc
|
||||
```
|
||||
" 设置 F10 键为切换粘贴模式的快捷键
|
||||
set pastetoggle=<F10>
|
||||
set nu
|
||||
```
|
||||
@@ -0,0 +1,21 @@
|
||||
# 1. 中文乱码问题
|
||||
查看服务器是否包含中文字体,注意是中文字体不是中文编码。
|
||||
查看包含哪些中文字体:
|
||||
fc-list :lang=zh
|
||||
若不包含,或者X11路径下未包含中文字体,则直接安装中文字体即可。
|
||||
安装中文字体:
|
||||
apt install fonts-wqy-microhei,随便安个中文字体就行
|
||||
|
||||
# 2. 中文输入法问题
|
||||
|
||||
|
||||
# 3. ubuntu安装 x11 桌面环境
|
||||
|
||||
要在Ubuntu上安装X11桌面环境,您可以按照以下步骤进行操作:
|
||||
|
||||
1. 在Ubuntu终端中,使用以下命令安装x11vnc:sudo apt-get install x11vnc [1。
|
||||
2. 安装完成后,您可以使用x11vnc命令来启动VNC服务器。
|
||||
3. 在终端中输入x11vnc命令时,您可能需要提供一些参数来配置VNC服务器的行为。例如,您可以指定密码、访问控制等。
|
||||
4. 安装完成后,您可以使用VNC客户端连接到Ubuntu上的X11桌面环境。您可以在客户端中输入Ubuntu的IP地址和配置的VNC服务器端口号来进行连接。
|
||||
|
||||
需要注意的是,Ubuntu 21.04之后,默认启用了Wayland协议,而不是传统的X11协议。这意味着有些基于X11的软件可能会在新的Wayland环境中出现兼容性问题。不过,您仍然可以使用上述方法安装和使用X11桌面环境。
|
||||

Binary file not shown.
|
After Width: | Height: | Size: 109 KiB |
@@ -0,0 +1,231 @@
|
||||
# Fail2ban 安装与 `fail2ban-client` 命令使用手册
|
||||
|
||||
本手册基于 **Ubuntu 24.04** 环境,结合 UFW 防火墙,详细说明 Fail2ban 的安装、配置以及 `fail2ban-client` 的常用命令。
|
||||
|
||||
---
|
||||
|
||||
## 1. Fail2ban 安装
|
||||
|
||||
### 1.1 通过 APT 安装
|
||||
```bash
|
||||
sudo apt update
|
||||
sudo apt install fail2ban -y
|
||||
```
|
||||
|
||||
### 1.2 验证服务状态
|
||||
安装完成后,服务会自动启动:
|
||||
```bash
|
||||
sudo systemctl status fail2ban
|
||||
```
|
||||
- 如果未启动,可手动启动:`sudo systemctl start fail2ban`
|
||||
- 设置开机自启:`sudo systemctl enable fail2ban`
|
||||
|
||||
---
|
||||
|
||||
## 2. 配置 Fail2ban(使用 UFW 作为封禁后端)
|
||||
|
||||
### 2.1 创建自定义配置文件
|
||||
**不要直接修改 `/etc/fail2ban/jail.conf`**,因为包更新会覆盖它。应创建 `jail.local`:
|
||||
```bash
|
||||
sudo nano /etc/fail2ban/jail.local
|
||||
```
|
||||
|
||||
### 2.2 基础配置示例
|
||||
将以下内容粘贴到 `jail.local` 中:
|
||||
```ini
|
||||
[DEFAULT]
|
||||
# 封禁时间(1小时)
|
||||
bantime = 1h
|
||||
# 检测时间窗口(10分钟)
|
||||
findtime = 10m
|
||||
# 最大失败尝试次数
|
||||
maxretry = 5
|
||||
|
||||
# 关键:使用 UFW 执行封禁
|
||||
banaction = ufw
|
||||
|
||||
# 白名单(保护自己的IP不被封禁)
|
||||
# 格式:用空格分隔多个IP或CIDR
|
||||
ignoreip = 127.0.0.1/8 ::1 你的.公网.IP
|
||||
|
||||
# 启用 SSH 防护
|
||||
[sshd]
|
||||
enabled = true
|
||||
```
|
||||
|
||||
> **注意**:将 `你的.公网.IP` 替换为你的实际 IP。
|
||||
|
||||
### 2.3 重启 Fail2ban 使配置生效
|
||||
```bash
|
||||
sudo systemctl restart fail2ban
|
||||
```
|
||||
|
||||
### 2.4 确认 UFW 已开启
|
||||
启用 UFW 前,先放行 SSH 端口:
|
||||
```bash
|
||||
sudo ufw allow ssh
|
||||
sudo ufw enable
|
||||
sudo ufw status verbose
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 3. `fail2ban-client` 常用命令
|
||||
|
||||
`fail2ban-client` 是与 Fail2ban 服务交互的命令行工具。
|
||||
|
||||
### 3.1 查看整体状态
|
||||
```bash
|
||||
sudo fail2ban-client status
|
||||
```
|
||||
输出示例:
|
||||
```
|
||||
Status
|
||||
|- Number of jail: 1
|
||||
`- Jail list: sshd
|
||||
```
|
||||
|
||||
### 3.2 查看特定监狱(Jail)的详细信息
|
||||
```bash
|
||||
sudo fail2ban-client status sshd
|
||||
```
|
||||
输出示例:
|
||||
```
|
||||
Status for the jail: sshd
|
||||
|- Filter
|
||||
| |- Currently failed: 0
|
||||
| |- Total failed: 123
|
||||
| `- File list: /var/log/auth.log
|
||||
`- Actions
|
||||
|- Currently banned: 3
|
||||
|- Total banned: 15
|
||||
`- Banned IP list: 91.92.40.239 27.49.238.44 176.65.139.183
|
||||
```
|
||||
|
||||
### 3.3 查看所有监狱的被封禁 IP(汇总)
|
||||
```bash
|
||||
sudo fail2ban-client banned
|
||||
```
|
||||
输出格式类似:
|
||||
```
|
||||
{
|
||||
"sshd": ["91.92.40.239", "27.49.238.44"]
|
||||
}
|
||||
```
|
||||
|
||||
### 3.4 手动封禁 IP
|
||||
```bash
|
||||
sudo fail2ban-client set <监狱名> banip <IP地址>
|
||||
```
|
||||
示例:
|
||||
```bash
|
||||
sudo fail2ban-client set sshd banip 203.0.113.5
|
||||
```
|
||||
|
||||
### 3.5 手动解封 IP
|
||||
```bash
|
||||
sudo fail2ban-client set <监狱名> unbanip <IP地址>
|
||||
```
|
||||
示例:
|
||||
```bash
|
||||
sudo fail2ban-client set sshd unbanip 203.0.113.5
|
||||
```
|
||||
|
||||
### 3.6 重载配置(修改配置后无需重启服务)
|
||||
```bash
|
||||
sudo fail2ban-client reload
|
||||
```
|
||||
若只想重载特定监狱:
|
||||
```bash
|
||||
sudo fail2ban-client reload sshd
|
||||
```
|
||||
|
||||
### 3.7 查看 Fail2ban 日志(含封禁记录)
|
||||
```bash
|
||||
sudo grep "Ban" /var/log/fail2ban.log
|
||||
```
|
||||
或实时监控:
|
||||
```bash
|
||||
sudo tail -f /var/log/fail2ban.log | grep "Ban"
|
||||
```
|
||||
|
||||
### 3.8 测试配置文件语法
|
||||
```bash
|
||||
sudo fail2ban-client -t
|
||||
```
|
||||
|
||||
### 3.9 前台运行调试(用于测试)
|
||||
```bash
|
||||
sudo fail2ban-client -f start
|
||||
```
|
||||
按 `Ctrl+C` 停止。
|
||||
|
||||
---
|
||||
|
||||
## 4. 封禁策略调整
|
||||
|
||||
### 4.1 修改封禁时长
|
||||
在 `jail.local` 的 `[DEFAULT]` 或具体监狱中修改 `bantime`:
|
||||
- `bantime = 1h`(1小时)
|
||||
- `bantime = 86400`(24小时,单位为秒)
|
||||
- 设为 `-1` 表示永久封禁。
|
||||
|
||||
### 4.2 修改失败次数阈值
|
||||
`maxretry` 决定在 `findtime` 内失败多少次触发封禁。
|
||||
|
||||
### 4.3 添加白名单
|
||||
在 `ignoreip` 中添加 IP 或网段,用空格分隔。
|
||||
|
||||
### 4.4 封禁其他服务(如 HTTP)
|
||||
可以启用 `[nginx-http-auth]` 等监狱,只需在 `jail.local` 中添加:
|
||||
```ini
|
||||
[nginx-http-auth]
|
||||
enabled = true
|
||||
port = http,https
|
||||
logpath = /var/log/nginx/error.log
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 5. 常见问题排查
|
||||
|
||||
### 5.1 Fail2ban 未生效
|
||||
- 检查日志路径是否正确(如 `/var/log/auth.log`)。
|
||||
- 确认 `enabled = true` 已设置。
|
||||
- 查看服务日志:`sudo journalctl -u fail2ban -f`
|
||||
|
||||
### 5.2 封禁后仍可访问
|
||||
- 确认 `banaction = ufw` 配置正确。
|
||||
- 检查 UFW 是否启用:`sudo ufw status`
|
||||
- 查看防火墙实际规则:`sudo iptables -L -n | grep DROP` 或 `sudo nft list ruleset`
|
||||
|
||||
### 5.3 误封自己的 IP
|
||||
- 立即解封:`sudo fail2ban-client set sshd unbanip 你的IP`
|
||||
- 并检查 `ignoreip` 是否正确配置。
|
||||
|
||||
---
|
||||
|
||||
## 6. 卸载 Fail2ban
|
||||
```bash
|
||||
sudo apt remove fail2ban -y
|
||||
sudo apt autoremove -y
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 附录:常用命令速查表
|
||||
|
||||
| 目的 | 命令 |
|
||||
| :------------- | :------------------------------------------- |
|
||||
| 查看所有监狱状态 | `sudo fail2ban-client status` |
|
||||
| 查看某监狱详情(含封禁IP) | `sudo fail2ban-client status sshd` |
|
||||
| 查看所有被封禁IP | `sudo fail2ban-client banned` |
|
||||
| 手动封禁IP | `sudo fail2ban-client set sshd banip <IP>` |
|
||||
| 手动解封IP | `sudo fail2ban-client set sshd unbanip <IP>` |
|
||||
| 重载配置 | `sudo fail2ban-client reload` |
|
||||
| 查看封禁日志 | `sudo grep "Ban" /var/log/fail2ban.log` |
|
||||
| 测试配置 | `sudo fail2ban-client -t` |
|
||||
|
||||
---
|
||||
|
||||
本手册适用于 Ubuntu 24.04 + UFW 环境,按照以上步骤即可快速部署并管理 Fail2ban。如有其他需求,可参考官方文档或社区资源。
|
||||
@@ -0,0 +1,66 @@
|
||||
|
||||
fcitx5是很好用的一个输入法框架,安装后不需要再安装搜狗拼音,百度输入法,谷歌输入法(谷歌输入法巨难用)等东西了。
|
||||
fcitx5有个缺点是,与gnome桌面合不来,之前折腾了好久,最后还是转投kde桌面了(真香)。
|
||||
(我是直接装的ubuntu server, 最开始没有桌面,可以直接装kde. 已经有桌面的小伙伴可以先把kde装了,然后再卸载gnome)
|
||||
|
||||
# 1. 安装kde桌面,可以直接装kubuntu-desktop,安装过程会让选桌面管理工具,建议选sddm. (gnome 是用gdm3)
|
||||
|
||||
```bash
|
||||
sudo apt-get install kubuntu-desktop
|
||||
```
|
||||
|
||||
然后重启即可。
|
||||
|
||||
# 2. 安装fcitx5
|
||||
|
||||
```bash
|
||||
sudo add-apt-repository ppa:hosxy/fcitx5
|
||||
sudo apt install fcitx5 fcitx5-*
|
||||
```
|
||||
|
||||
然后配置输入法为fcitx5
|
||||
|
||||
```bash
|
||||
im-config
|
||||
```
|
||||
|
||||
过程中记得选fcitx5
|
||||
|
||||
# 3. 配置fcitx5
|
||||
|
||||
设置环境变量:在~/.xprofile文件中写入:export QT_IM_MODULE=fcitx
|
||||
|
||||
```bash
|
||||
echo export QT_IM_MODULE=fcitx > ~/.xprofile
|
||||
source ~/.xprofile
|
||||
```
|
||||
|
||||
配置fcitx5,在~/.config/fcitx5/profile写入:(注意配置的时候要把fcitx5关闭,不然会被覆盖)
|
||||
|
||||
```csharp
|
||||
[Groups/0]
|
||||
Name="分组 1"
|
||||
Default Layout=us
|
||||
DefaultIM=pinyin
|
||||
[Groups/0/Items/0]
|
||||
Name=keyboard-us
|
||||
Layout=
|
||||
[Groups/0/Items/1]
|
||||
Name=pinyin
|
||||
Layout=us
|
||||
|
||||
[Groups/1]
|
||||
Name="分组 2"
|
||||
Default Layout=cn-altgr-pinyin
|
||||
DefaultIM=pinyin
|
||||
[Groups/1/Items/0]
|
||||
Name=keyboard-cn-altgr-pinyin
|
||||
Layout=
|
||||
[Groups/1/Items/1]
|
||||
Name=pinyin
|
||||
Layout=
|
||||
|
||||
[GroupOrder]
|
||||
0="分组 1"
|
||||
1="分组 2"
|
||||
```
|
||||
@@ -0,0 +1,395 @@
|
||||
# 别再无脑敲 grep 了,我靠这 5 个选项,定位问题速度提升 10 倍
|
||||
|
||||
|
||||
在日常运维工作中,我们几乎每天都在和日志、配置文件、代码片段打交道。
|
||||
|
||||
日志动辄几十 GB,配置文件成百上千行,出问题时,时间永远是最宝贵的资源。
|
||||
|
||||
|
||||
|
||||
很多同事都会用 grep,但**90% 的人只会用最基础的 grep "keyword" file**。 结果就是:
|
||||
|
||||
- 要么匹配不准
|
||||
|
||||
- 要么结果一大堆
|
||||
|
||||
- 要么漏掉关键信息
|
||||
|
||||
|
||||
今天这篇文章,我不讲 grep 的所有参数,而是分享**我在一线运维工作中,真正高频使用、最有价值的 5 个 grep 选项**。
|
||||
|
||||
只要你把这 5 个选项用熟,**你几乎可以在任何复杂场景下,快速定位你想要的内容**。
|
||||
|
||||
在进入正题之前,先统一一个认知。
|
||||
|
||||
|
||||
grep 是什么?
|
||||
|
||||
> grep = Global Regular Expression Print
|
||||
|
||||
但在运维眼里,它的真实含义是:
|
||||
|
||||
- 日志分析利器
|
||||
|
||||
- 故障定位放大镜
|
||||
|
||||
- 海量文本的“手术刀”
|
||||
|
||||
|
||||
无论你是:
|
||||
|
||||
- 查 Nginx / Tomcat / MySQL 日志
|
||||
|
||||
- 翻 Kubernetes 容器日志
|
||||
|
||||
- 排查线上报错
|
||||
|
||||
- 审计配置变更
|
||||
|
||||
- 甚至简单查代码
|
||||
|
||||
|
||||
**grep 几乎是第一反应。**
|
||||
|
||||
## 我最常用的 5 个 grep 选项总览
|
||||
|
||||
先给大家一个总览,后面逐个展开。
|
||||
|
||||
|选项|作用|使用频率|
|
||||
|---|---|---|
|
||||
|`-n`|显示行号|⭐⭐⭐⭐⭐|
|
||||
|`-i`|忽略大小写|⭐⭐⭐⭐|
|
||||
|`-v`|反向匹配|⭐⭐⭐⭐⭐|
|
||||
|`-C / -A / -B`|上下文查看|⭐⭐⭐⭐|
|
||||
|`-E`|扩展正则|⭐⭐⭐⭐⭐|
|
||||
|
||||
这 5 个选项,**几乎覆盖了我 80% 的 grep 使用场景**。
|
||||
|
||||
## 行号
|
||||
|
||||
### 1️⃣ 基本用法
|
||||
|
||||
```
|
||||
grep -n "error" application.log
|
||||
```
|
||||
|
||||
输出类似:
|
||||
|
||||
```
|
||||
2451:2024-06-01 10:23:11 ERROR Connection timeout
|
||||
```
|
||||
|
||||
### 2️⃣ 为什么我几乎永远带 `-n`
|
||||
|
||||
原因很简单:**行号 = 定位能力**。
|
||||
|
||||
- 你要和同事对齐信息
|
||||
|
||||
- 你要回到文件中继续分析
|
||||
|
||||
- 你要用 sed / vim / awk 二次处理
|
||||
|
||||
|
||||
**没有行号,等于失去坐标。**
|
||||
|
||||
### 3️⃣ 实战场景
|
||||
|
||||
- 让开发快速定位代码或日志位置
|
||||
|
||||
- 在 vim 里 `:2451` 直接跳转
|
||||
|
||||
- 用 sed 精确截取问题区间
|
||||
|
||||
|
||||
只要 grep 文件,我几乎条件反射就加 -n
|
||||
|
||||
## `-i`:别让大小写浪费你的时间
|
||||
|
||||
### 1️⃣ 基本用法
|
||||
|
||||
```
|
||||
grep -i "error" app.log
|
||||
```
|
||||
|
||||
等价于:
|
||||
|
||||
- error
|
||||
|
||||
- Error
|
||||
|
||||
- ERROR
|
||||
|
||||
- eRrOr
|
||||
|
||||
|
||||
### 2️⃣ 真实痛点
|
||||
|
||||
你一定遇到过这种情况:
|
||||
|
||||
```
|
||||
grep "error" app.log# 什么都没匹配到
|
||||
```
|
||||
|
||||
结果一看日志,全是:
|
||||
|
||||
```
|
||||
ERROR
|
||||
```
|
||||
|
||||
### 3️⃣ 运维经验
|
||||
|
||||
- 日志格式不统一
|
||||
|
||||
- 不同组件输出风格不同
|
||||
|
||||
- 第三方程序你根本控制不了
|
||||
|
||||
|
||||
**与其记大小写,不如让 grep 忽略它。**
|
||||
|
||||
### 4️⃣ 建议
|
||||
|
||||
> **查日志时,只要关键词是英文,我几乎都会加 -i**
|
||||
|
||||
## `-v`:排除干扰信息,快速聚焦重点
|
||||
|
||||
### 1️⃣ `-v` 是什么
|
||||
|
||||
```
|
||||
grep -v "info" app.log
|
||||
```
|
||||
|
||||
含义是:**显示不包含 info 的行**
|
||||
|
||||
### 2️⃣ 为什么 `-v` 在运维中非常重要
|
||||
|
||||
日志里最常见的是什么?
|
||||
|
||||
- INFO
|
||||
|
||||
- DEBUG
|
||||
|
||||
- 心跳日志
|
||||
|
||||
- 健康检查
|
||||
|
||||
|
||||
但我们真正关心的,往往只有:
|
||||
|
||||
- ERROR
|
||||
|
||||
- WARN
|
||||
|
||||
- Exception
|
||||
|
||||
|
||||
### 3️⃣ 经典组合用法
|
||||
|
||||
```
|
||||
grep -i "error" app.log | grep -v "timeout"
|
||||
```
|
||||
|
||||
含义是:
|
||||
|
||||
> 查 error,但排除已知的、无关的 timeout 错误
|
||||
|
||||
### 4️⃣ 实战案例
|
||||
|
||||
排查线上告警:
|
||||
|
||||
```
|
||||
grep -i "error" app.log | grep -v "connection reset"
|
||||
```
|
||||
|
||||
**瞬间把 90% 的“噪音”过滤掉。**
|
||||
|
||||
-v 是 grep 的“降噪耳机”
|
||||
|
||||
## `-C / -A / -B`:只看一行,等于没看日志
|
||||
|
||||
### 1️⃣ 为什么只看一行日志是不够的
|
||||
|
||||
一条 ERROR 往往是这样的:
|
||||
|
||||
- 前几行:请求参数
|
||||
|
||||
- 当前行:错误提示
|
||||
|
||||
- 后几行:堆栈信息
|
||||
|
||||
|
||||
如果你只看命中那一行,**信息是不完整的**。
|
||||
|
||||
### 2️⃣ 常用参数说明
|
||||
|
||||
- `-A n`:显示匹配行 **后 n 行**
|
||||
|
||||
- `-B n`:显示匹配行 **前 n 行**
|
||||
|
||||
- `-C n`:显示前后各 n 行
|
||||
|
||||
|
||||
### 3️⃣ 实战示例
|
||||
|
||||
```
|
||||
grep -n -C 5 "NullPointerException" app.log
|
||||
```
|
||||
|
||||
输出的不是一行,而是一个**完整上下文块**。
|
||||
|
||||
### 4️⃣ 典型使用场景
|
||||
|
||||
- Java 堆栈分析
|
||||
|
||||
- 请求链路排查
|
||||
|
||||
- 分析程序执行路径
|
||||
|
||||
|
||||
grep + 上下文,才是真正的“读日志”
|
||||
|
||||
## `-E`:让 grep 真正“强大”的关键
|
||||
|
||||
### 1️⃣ 什么是 `-E`
|
||||
|
||||
`-E` 启用 **扩展正则表达式**,让 grep 支持:
|
||||
|
||||
- `|`(或)
|
||||
|
||||
- `+`
|
||||
|
||||
- `?`
|
||||
|
||||
- `()` 分组
|
||||
|
||||
|
||||
### 2️⃣ 没有 `-E` 的痛苦
|
||||
|
||||
```
|
||||
grep "error|warn" app.log# 匹配不到
|
||||
```
|
||||
|
||||
### 3️⃣ 正确用法
|
||||
|
||||
```
|
||||
grep -E "error|warn|exception" app.log
|
||||
```
|
||||
|
||||
### 4️⃣ 高频实战场景
|
||||
|
||||
一次查多种关键字:
|
||||
|
||||
```
|
||||
grep -Ei "error|fail|timeout" app.log
|
||||
```
|
||||
|
||||
匹配 IP:
|
||||
|
||||
```
|
||||
grep -E "([0-9]{1,3}\.){3}[0-9]{1,3}" access.log
|
||||
```
|
||||
|
||||
只要涉及“多条件匹配”,我直接上 -E
|
||||
|
||||
## 我最常用的 grep 组合拳
|
||||
|
||||
最后分享几个我在生产环境里**天天用的组合命令**。
|
||||
|
||||
### 1️⃣ 查错误并带上下文
|
||||
|
||||
```
|
||||
grep -in -C 5 "error" app.log
|
||||
```
|
||||
|
||||
### 2️⃣ 查错误,排除已知无关问题
|
||||
|
||||
```
|
||||
grep -Ei "error|exception" app.log | grep -v "timeout"
|
||||
```
|
||||
|
||||
### 3️⃣ 查最近错误(配合 tail)
|
||||
|
||||
```
|
||||
tail -n 1000 app.log | grep -i "error"
|
||||
```
|
||||
|
||||
|
||||
|
||||
**大事!运维漫谈-技术交流群对外开放!**
|
||||
|
||||
|
||||
|
||||
扫码可添加小编微信,**申请进****群**
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
▲长按加群
|
||||
|
||||
|
||||
|
||||
**运维漫谈**
|
||||
|
||||
运维漫谈,漫谈整个网络安全、云计算、大数据、数据库、开发等运维技术干货,旨在分享干货,帮您更快学习相关知识,解决问题,同时还有福利活动哦,关注我,带你成为大神,遨游技术海洋!
|
||||
|
||||
922篇原创内容
|
||||
|
||||
公众号
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
Linux · 目录
|
||||
|
||||
上一篇这6个工具,让你的Linux监控如鱼得水,运维效率翻倍!下一篇如何查看 Ubuntu 服务器到底什么时候重启的?
|
||||
|
||||
阅读 3351
|
||||
|
||||
grep上下文参数
|
||||
|
||||
|
||||
|
||||
**留言 1**
|
||||
|
||||
写留言
|
||||
|
||||
- 
|
||||
|
||||
亮
|
||||
|
||||
北京23小时前
|
||||
|
||||
赞
|
||||
|
||||
grep -Rni
|
||||
|
||||
|
||||
已无更多数据
|
||||
|
||||
[](javacript:;)
|
||||
|
||||
|
||||
|
||||
运维漫谈
|
||||
|
||||
关注
|
||||
|
||||
76
|
||||
|
||||
295
|
||||
|
||||
58
|
||||
|
||||
1
|
||||
|
||||

|
||||
|
||||
复制搜一搜
|
||||
|
||||
复制搜一搜
|
||||
|
||||
暂无评论
|
||||
@@ -0,0 +1,465 @@
|
||||
# IP 系列命令管理 Linux 网络完全指南
|
||||
|
||||
## 一、IP 命令概述
|
||||
|
||||
`ip` 命令是 `iproute2` 工具包的一部分,取代了传统的 `ifconfig`、`route`、`arp` 等命令,提供更强大和统一的网络管理功能。
|
||||
|
||||
### 基本语法结构
|
||||
```bash
|
||||
ip [OPTIONS] OBJECT { COMMAND | help }
|
||||
```
|
||||
|
||||
**常用 OBJECT(对象):**
|
||||
- `link` - 网络接口管理
|
||||
- `address` - IP地址管理
|
||||
- `route` - 路由表管理
|
||||
- `neigh` - ARP/邻居表管理
|
||||
- `netns` - 网络命名空间管理
|
||||
- `maddr` - 多播地址管理
|
||||
|
||||
---
|
||||
|
||||
## 二、网络接口管理(link)
|
||||
|
||||
### 1. 查看接口信息
|
||||
```bash
|
||||
# 查看所有接口状态
|
||||
ip link show
|
||||
ip -s link show # 带统计信息
|
||||
ip -s -s link show # 更详细的统计信息
|
||||
|
||||
# 查看特定接口
|
||||
ip link show eth0
|
||||
ip -s link show eth0
|
||||
```
|
||||
|
||||
### 2. 接口启停控制
|
||||
```bash
|
||||
# 启用接口
|
||||
ip link set eth0 up
|
||||
|
||||
# 禁用接口
|
||||
ip link set eth0 down
|
||||
|
||||
# 修改接口MTU
|
||||
ip link set eth0 mtu 9000
|
||||
|
||||
# 修改MAC地址
|
||||
ip link set eth0 address 00:11:22:33:44:55
|
||||
```
|
||||
|
||||
### 3. 接口重命名
|
||||
```bash
|
||||
# 临时重命名
|
||||
ip link set eth0 name eth-new
|
||||
|
||||
# 永久重命名(需要配合系统配置)
|
||||
# 1. 先禁用接口
|
||||
ip link set eth0 down
|
||||
# 2. 重命名
|
||||
ip link set eth0 name eth-new
|
||||
# 3. 启用
|
||||
ip link set eth-new up
|
||||
```
|
||||
|
||||
### 4. 查看接口详情
|
||||
```bash
|
||||
ip -d link show # 显示接口详细信息
|
||||
ip -d link show eth0
|
||||
```
|
||||
|
||||
**输出示例:**
|
||||
```
|
||||
2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc pfifo_fast state UP mode DEFAULT group default qlen 1000
|
||||
link/ether 00:0c:29:xx:xx:xx brd ff:ff:ff:ff:ff:ff promiscuity 0
|
||||
addrgenmode eui64 numtxqueues 1 numrxqueues 1 gso_max_size 65536 gso_max_segs 65535
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 三、IP地址管理(address/addr)
|
||||
|
||||
### 1. 查看IP地址
|
||||
```bash
|
||||
# 查看所有接口IP地址
|
||||
ip address show
|
||||
ip addr show
|
||||
ip a # 简写
|
||||
|
||||
# 查看特定接口
|
||||
ip addr show eth0
|
||||
ip a show dev eth0
|
||||
|
||||
# 查看IPv4或IPv6地址
|
||||
ip -4 addr show # 只显示IPv4
|
||||
ip -6 addr show # 只显示IPv6
|
||||
```
|
||||
|
||||
### 2. 添加IP地址
|
||||
```bash
|
||||
# 添加IPv4地址
|
||||
ip addr add 192.168.1.100/24 dev eth0
|
||||
ip addr add 192.168.1.101/24 dev eth0 label eth0:1
|
||||
|
||||
# 添加IPv6地址
|
||||
ip addr add 2001:db8::1/64 dev eth0
|
||||
```
|
||||
|
||||
### 3. 删除IP地址
|
||||
```bash
|
||||
# 删除指定IP
|
||||
ip addr del 192.168.1.100/24 dev eth0
|
||||
|
||||
# 删除所有IP(慎用)
|
||||
ip addr flush dev eth0
|
||||
ip addr flush dev eth0 scope global # 只删除全局地址
|
||||
```
|
||||
|
||||
### 4. 清理和刷新地址
|
||||
```bash
|
||||
# 清理特定类型的地址
|
||||
ip addr flush dynamic # 清理动态获取的地址
|
||||
ip addr flush permanent # 清理永久地址
|
||||
ip addr flush temporary # 清理临时地址
|
||||
|
||||
# 清理IPv6特定地址
|
||||
ip -6 addr flush dev eth0
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 四、路由表管理(route)
|
||||
|
||||
### 1. 查看路由表
|
||||
```bash
|
||||
# 查看所有路由
|
||||
ip route show
|
||||
ip route list
|
||||
ip r # 简写
|
||||
|
||||
# 查看特定网络路由
|
||||
ip route show 192.168.1.0/24
|
||||
|
||||
# 查看特定接口路由
|
||||
ip route show dev eth0
|
||||
|
||||
# 查看缓存路由
|
||||
ip route show cache
|
||||
|
||||
# 查看详细路由信息
|
||||
ip -d route show
|
||||
```
|
||||
|
||||
### 2. 添加路由
|
||||
```bash
|
||||
# 添加默认网关
|
||||
ip route add default via 192.168.1.1 dev eth0
|
||||
|
||||
# 添加网络路由
|
||||
ip route add 10.0.0.0/8 via 192.168.1.254 dev eth0
|
||||
|
||||
# 添加直连路由
|
||||
ip route add 192.168.2.0/24 dev eth1
|
||||
|
||||
# 添加多路径路由
|
||||
ip route add default nexthop via 192.168.1.1 weight 1 \
|
||||
nexthop via 192.168.2.1 weight 2
|
||||
```
|
||||
|
||||
### 3. 删除路由
|
||||
```bash
|
||||
# 删除默认路由
|
||||
ip route del default
|
||||
|
||||
# 删除特定路由
|
||||
ip route del 10.0.0.0/8 via 192.168.1.254
|
||||
ip route del 192.168.2.0/24 dev eth1
|
||||
```
|
||||
|
||||
### 4. 修改和替换路由
|
||||
```bash
|
||||
# 替换路由(如果存在则替换,不存在则添加)
|
||||
ip route replace 192.168.1.0/24 via 10.0.0.1 dev eth0
|
||||
|
||||
# 修改路由属性
|
||||
ip route change 192.168.1.0/24 via 10.0.0.2 dev eth0 metric 100
|
||||
```
|
||||
|
||||
### 5. 特殊路由操作
|
||||
```bash
|
||||
# 清空路由表
|
||||
ip route flush table main
|
||||
ip route flush cache # 清空路由缓存
|
||||
|
||||
# 添加策略路由
|
||||
ip route add table 100 default via 10.0.0.1
|
||||
|
||||
# 查看特定路由表
|
||||
ip route show table local
|
||||
ip route show table main
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 五、邻居表管理(ARP/NDP)
|
||||
|
||||
### 1. 查看邻居表
|
||||
```bash
|
||||
# 查看ARP表(IPv4)
|
||||
ip neigh show
|
||||
ip neighbor show
|
||||
|
||||
# 查看IPv6邻居发现表
|
||||
ip -6 neigh show
|
||||
|
||||
# 查看特定接口
|
||||
ip neigh show dev eth0
|
||||
```
|
||||
|
||||
### 2. 添加/删除ARP条目
|
||||
```bash
|
||||
# 添加静态ARP条目
|
||||
ip neigh add 192.168.1.100 lladdr 00:11:22:33:44:55 dev eth0 nud permanent
|
||||
|
||||
# 删除ARP条目
|
||||
ip neigh del 192.168.1.100 dev eth0
|
||||
|
||||
# 刷新ARP表
|
||||
ip neigh flush dev eth0
|
||||
```
|
||||
|
||||
### 3. 邻居状态说明
|
||||
- `permanent` - 永久条目,手动添加
|
||||
- `noarp` - 不需ARP验证
|
||||
- `reachable` - 可达状态
|
||||
- `stale` - 陈旧状态
|
||||
- `delay` - 延迟验证
|
||||
- `failed` - 验证失败
|
||||
|
||||
---
|
||||
|
||||
## 六、网络命名空间管理(netns)
|
||||
|
||||
### 1. 命名空间操作
|
||||
```bash
|
||||
# 创建命名空间
|
||||
ip netns add ns1
|
||||
ip netns add ns2
|
||||
|
||||
# 列出所有命名空间
|
||||
ip netns list
|
||||
|
||||
# 在命名空间中执行命令
|
||||
ip netns exec ns1 ip addr show
|
||||
ip netns exec ns1 bash # 进入命名空间的shell
|
||||
|
||||
# 删除命名空间
|
||||
ip netns del ns1
|
||||
```
|
||||
|
||||
### 2. 命名空间网络配置
|
||||
```bash
|
||||
# 创建虚拟以太网对
|
||||
ip link add veth0 type veth peer name veth1
|
||||
|
||||
# 将一端移到命名空间
|
||||
ip link set veth1 netns ns1
|
||||
|
||||
# 在命名空间内配置
|
||||
ip netns exec ns1 ip addr add 10.0.0.1/24 dev veth1
|
||||
ip netns exec ns1 ip link set veth1 up
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 七、网络统计和监控
|
||||
|
||||
### 1. 查看网络统计
|
||||
```bash
|
||||
# 查看所有接口统计
|
||||
ip -s link show
|
||||
|
||||
# 查看特定接口详细统计
|
||||
ip -s -s link show eth0
|
||||
|
||||
# 持续监控网络统计
|
||||
watch -n 1 'ip -s link show eth0'
|
||||
```
|
||||
|
||||
### 2. 监控网络事件
|
||||
```bash
|
||||
# 监控网络事件(需要root)
|
||||
ip monitor all # 监控所有事件
|
||||
ip monitor link # 只监控链路事件
|
||||
ip monitor address # 只监控地址事件
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 八、高级网络配置
|
||||
|
||||
### 1. 多播地址管理
|
||||
```bash
|
||||
# 查看多播地址
|
||||
ip maddr show
|
||||
ip maddr show dev eth0
|
||||
|
||||
# 添加多播地址
|
||||
ip maddr add 224.0.0.1 dev eth0
|
||||
|
||||
# 删除多播地址
|
||||
ip maddr del 224.0.0.1 dev eth0
|
||||
```
|
||||
|
||||
### 2. 策略路由
|
||||
```bash
|
||||
# 查看路由规则
|
||||
ip rule show
|
||||
|
||||
# 添加路由规则
|
||||
ip rule add from 192.168.1.0/24 table 100
|
||||
ip rule add fwmark 1 table 100
|
||||
|
||||
# 删除路由规则
|
||||
ip rule del from 192.168.1.0/24
|
||||
```
|
||||
|
||||
### 3. 隧道配置
|
||||
```bash
|
||||
# 创建GRE隧道
|
||||
ip tunnel add gre1 mode gre remote 203.0.113.1 local 192.0.2.1 ttl 255
|
||||
ip link set gre1 up
|
||||
ip addr add 10.0.0.1/30 dev gre1
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 九、实用脚本示例
|
||||
|
||||
### 1. 网络配置脚本
|
||||
```bash
|
||||
#!/bin/bash
|
||||
# 配置多IP地址
|
||||
INTERFACE="eth0"
|
||||
NETWORK="192.168.1"
|
||||
|
||||
# 清除现有配置
|
||||
ip addr flush dev $INTERFACE
|
||||
|
||||
# 添加主IP
|
||||
ip addr add ${NETWORK}.100/24 dev $INTERFACE
|
||||
|
||||
# 添加多个辅助IP
|
||||
for i in {101..110}; do
|
||||
ip addr add ${NETWORK}.$i/24 dev $INTERFACE label ${INTERFACE}:$i
|
||||
done
|
||||
|
||||
# 设置默认网关
|
||||
ip route add default via ${NETWORK}.1
|
||||
|
||||
# 启用接口
|
||||
ip link set $INTERFACE up
|
||||
```
|
||||
|
||||
### 2. 网络诊断脚本
|
||||
```bash
|
||||
#!/bin/bash
|
||||
# 网络状态诊断
|
||||
echo "=== 接口状态 ==="
|
||||
ip link show | grep -E "^[0-9]+:"
|
||||
|
||||
echo -e "\n=== IP地址 ==="
|
||||
ip addr show | grep -E "inet|inet6"
|
||||
|
||||
echo -e "\n=== 路由表 ==="
|
||||
ip route show
|
||||
|
||||
echo -e "\n=== ARP表 ==="
|
||||
ip neigh show
|
||||
|
||||
echo -e "\n=== 连接统计 ==="
|
||||
ss -s
|
||||
```
|
||||
|
||||
### 3. 批量配置脚本
|
||||
```bash
|
||||
#!/bin/bash
|
||||
# 批量配置网络命名空间
|
||||
for i in {1..5}; do
|
||||
# 创建命名空间
|
||||
ip netns add ns$i
|
||||
|
||||
# 创建虚拟接口对
|
||||
ip link add veth$i type veth peer name vpeer$i
|
||||
|
||||
# 配置主端
|
||||
ip link set veth$i up
|
||||
ip addr add 10.0.$i.1/24 dev veth$i
|
||||
|
||||
# 配置命名空间端
|
||||
ip link set vpeer$i netns ns$i
|
||||
ip netns exec ns$i ip link set vpeer$i up
|
||||
ip netns exec ns$i ip addr add 10.0.$i.2/24 dev vpeer$i
|
||||
ip netns exec ns$i ip route add default via 10.0.$i.1
|
||||
done
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 十、IP命令与传统命令对照表
|
||||
|
||||
| **功能** | **传统命令** | **ip命令** |
|
||||
|---------|------------|-----------|
|
||||
| 查看接口 | `ifconfig -a` | `ip link show` |
|
||||
| 配置IP | `ifconfig eth0 192.168.1.100 netmask 255.255.255.0` | `ip addr add 192.168.1.100/24 dev eth0` |
|
||||
| 查看路由 | `route -n` | `ip route show` |
|
||||
| 添加路由 | `route add -net 10.0.0.0 netmask 255.0.0.0 gw 192.168.1.1` | `ip route add 10.0.0.0/8 via 192.168.1.1` |
|
||||
| 查看ARP | `arp -an` | `ip neigh show` |
|
||||
| 添加ARP | `arp -s 192.168.1.100 00:11:22:33:44:55` | `ip neigh add 192.168.1.100 lladdr 00:11:22:33:44:55 dev eth0` |
|
||||
|
||||
---
|
||||
|
||||
## 十一、常见问题排查
|
||||
|
||||
### 1. 网络不通排查步骤
|
||||
```bash
|
||||
# 1. 检查接口状态
|
||||
ip link show eth0
|
||||
|
||||
# 2. 检查IP配置
|
||||
ip addr show eth0
|
||||
|
||||
# 3. 检查路由
|
||||
ip route show
|
||||
ip route get 8.8.8.8
|
||||
|
||||
# 4. 检查ARP表
|
||||
ip neigh show dev eth0
|
||||
|
||||
# 5. 检查防火墙
|
||||
iptables -L -n -v
|
||||
```
|
||||
|
||||
### 2. 快速诊断命令
|
||||
```bash
|
||||
# 一键诊断
|
||||
ip a && ip r && ip neigh
|
||||
|
||||
# 保存网络配置快照
|
||||
ip addr show > /tmp/network_snapshot.txt
|
||||
ip route show >> /tmp/network_snapshot.txt
|
||||
ip neigh show >> /tmp/network_snapshot.txt
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
## 十二、最佳实践
|
||||
|
||||
1. **使用完整语法**:虽然简写方便,但脚本中建议使用完整命令
|
||||
2. **配置持久化**:`ip` 命令配置是临时的,重启后会丢失
|
||||
3. **参数验证**:重要操作前先验证参数
|
||||
4. **批量操作**:多个接口配置使用循环
|
||||
5. **错误处理**:脚本中添加错误检查
|
||||
6. **权限管理**:大部分 `ip` 命令需要 root 权限
|
||||
|
||||
通过掌握 `ip` 系列命令,你可以高效地管理 Linux 网络配置,进行网络故障排查和性能优化。
|
||||
@@ -0,0 +1,454 @@
|
||||
>**iptables命令** 是Linux上常用的防火墙软件,是netfilter项目的一部分。可以直接配置,也可以通过许多前端和图形界面配置。
|
||||
|
||||
### 语法
|
||||
|
||||
```shell
|
||||
iptables(选项)(参数)
|
||||
```
|
||||
|
||||
### [](https://wangchujiang.com/linux-command/c/iptables.html#%E9%80%89%E9%A1%B9)选项
|
||||
|
||||
```shell
|
||||
-t, --table table 对指定的表 table 进行操作, table 必须是 raw, nat,filter,mangle 中的一个。如果不指定此选项,默认的是 filter 表。
|
||||
|
||||
# 通用匹配:源地址目标地址的匹配
|
||||
-p:指定要匹配的数据包协议类型;
|
||||
-s, --source [!] address[/mask] :把指定的一个/一组地址作为源地址,按此规则进行过滤。当后面没有 mask 时,address 是一个地址,比如:192.168.1.1;当 mask 指定时,可以表示一组范围内的地址,比如:192.168.1.0/255.255.255.0。
|
||||
-d, --destination [!] address[/mask] :地址格式同上,但这里是指定地址为目的地址,按此进行过滤。
|
||||
-i, --in-interface [!] <网络接口name> :指定数据包的来自来自网络接口,比如最常见的 eth0 。注意:它只对 INPUT,FORWARD,PREROUTING 这三个链起作用。如果没有指定此选项, 说明可以来自任何一个网络接口。同前面类似,"!" 表示取反。
|
||||
-o, --out-interface [!] <网络接口name> :指定数据包出去的网络接口。只对 OUTPUT,FORWARD,POSTROUTING 三个链起作用。
|
||||
|
||||
# 查看管理命令
|
||||
-L, --list [chain] 列出链 chain 上面的所有规则,如果没有指定链,列出表上所有链的所有规则。
|
||||
|
||||
# 规则管理命令
|
||||
-A, --append chain rule-specification 在指定链 chain 的末尾插入指定的规则,也就是说,这条规则会被放到最后,最后才会被执行。规则是由后面的匹配来指定。
|
||||
-I, --insert chain [rulenum] rule-specification 在链 chain 中的指定位置插入一条或多条规则。如果指定的规则号是1,则在链的头部插入。这也是默认的情况,如果没有指定规则号。
|
||||
-D, --delete chain rule-specification -D, --delete chain rulenum 在指定的链 chain 中删除一个或多个指定规则。
|
||||
-R num:Replays替换/修改第几条规则
|
||||
|
||||
# 链管理命令(这都是立即生效的)
|
||||
-P, --policy chain target :为指定的链 chain 设置策略 target。注意,只有内置的链才允许有策略,用户自定义的是不允许的。
|
||||
-F, --flush [chain] 清空指定链 chain 上面的所有规则。如果没有指定链,清空该表上所有链的所有规则。
|
||||
-N, --new-chain chain 用指定的名字创建一个新的链。
|
||||
-X, --delete-chain [chain] :删除指定的链,这个链必须没有被其它任何规则引用,而且这条上必须没有任何规则。如果没有指定链名,则会删除该表中所有非内置的链。
|
||||
-E, --rename-chain old-chain new-chain :用指定的新名字去重命名指定的链。这并不会对链内部造成任何影响。
|
||||
-Z, --zero [chain] :把指定链,或者表中的所有链上的所有计数器清零。
|
||||
|
||||
-j, --jump target <指定目标> :即满足某条件时该执行什么样的动作。target 可以是内置的目标,比如 ACCEPT,也可以是用户自定义的链。
|
||||
-h:显示帮助信息;
|
||||
```
|
||||
|
||||
## [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%9F%BA%E6%9C%AC%E5%8F%82%E6%95%B0)基本参数
|
||||
|
||||
|参数|作用|
|
||||
|---|---|
|
||||
|-P|设置默认策略:iptables -P INPUT (DROP|
|
||||
|-F|清空规则链|
|
||||
|-L|查看规则链|
|
||||
|-A|在规则链的末尾加入新规则|
|
||||
|-I|num 在规则链的头部加入新规则|
|
||||
|-D|num 删除某一条规则|
|
||||
|-s|匹配来源地址IP/MASK,加叹号"!"表示除这个IP外。|
|
||||
|-d|匹配目标地址|
|
||||
|-i|网卡名称 匹配从这块网卡流入的数据|
|
||||
|-o|网卡名称 匹配从这块网卡流出的数据|
|
||||
|-p|匹配协议,如tcp,udp,icmp|
|
||||
|--dport num|匹配目标端口号|
|
||||
|--sport num|匹配来源端口号|
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%91%BD%E4%BB%A4%E9%80%89%E9%A1%B9%E8%BE%93%E5%85%A5%E9%A1%BA%E5%BA%8F)命令选项输入顺序
|
||||
|
||||
```shell
|
||||
iptables -t 表名 <-A/I/D/R> 规则链名 [规则号] <-i/o 网卡名> -p 协议名 <-s 源IP/源子网> --sport 源端口 <-d 目标IP/目标子网> --dport 目标端口 -j 动作
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%B7%A5%E4%BD%9C%E6%9C%BA%E5%88%B6)工作机制
|
||||
|
||||
规则链名包括(也被称为五个钩子函数(hook functions)):
|
||||
|
||||
- **INPUT链** :处理输入数据包。
|
||||
- **OUTPUT链** :处理输出数据包。
|
||||
- **FORWARD链** :处理转发数据包。
|
||||
- **PREROUTING链** :用于目标地址转换(DNAT)。
|
||||
- **POSTOUTING链** :用于源地址转换(SNAT)。
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E9%98%B2%E7%81%AB%E5%A2%99%E7%9A%84%E7%AD%96%E7%95%A5)防火墙的策略
|
||||
|
||||
防火墙策略一般分为两种,一种叫`通`策略,一种叫`堵`策略,通策略,默认门是关着的,必须要定义谁能进。堵策略则是,大门是洞开的,但是你必须有身份认证,否则不能进。所以我们要定义,让进来的进来,让出去的出去,`所以通,是要全通,而堵,则是要选择`。当我们定义的策略的时候,要分别定义多条功能,其中:定义数据包中允许或者不允许的策略,filter过滤的功能,而定义地址转换的功能的则是nat选项。为了让这些功能交替工作,我们制定出了“表”这个定义,来定义、区分各种不同的工作功能和处理方式。
|
||||
|
||||
我们现在用的比较多个功能有3个:
|
||||
|
||||
1. filter 定义允许或者不允许的,只能做在3个链上:INPUT ,FORWARD ,OUTPUT
|
||||
2. nat 定义地址转换的,也只能做在3个链上:PREROUTING ,OUTPUT ,POSTROUTING
|
||||
3. mangle功能:修改报文原数据,是5个链都可以做:PREROUTING,INPUT,FORWARD,OUTPUT,POSTROUTING
|
||||
|
||||
我们修改报文原数据就是来修改TTL的。能够实现将数据包的元数据拆开,在里面做标记/修改内容的。而防火墙标记,其实就是靠mangle来实现的。
|
||||
|
||||
小扩展:
|
||||
|
||||
- 对于filter来讲一般只能做在3个链上:INPUT ,FORWARD ,OUTPUT
|
||||
- 对于nat来讲一般也只能做在3个链上:PREROUTING ,OUTPUT ,POSTROUTING
|
||||
- 而mangle则是5个链都可以做:PREROUTING,INPUT,FORWARD,OUTPUT,POSTROUTING
|
||||
|
||||
iptables/netfilter(这款软件)是工作在用户空间的,它可以让规则进行生效的,本身不是一种服务,而且规则是立即生效的。而我们iptables现在被做成了一个服务,可以进行启动,停止的。启动,则将规则直接生效,停止,则将规则撤销。
|
||||
|
||||
iptables还支持自己定义链。但是自己定义的链,必须是跟某种特定的链关联起来的。在一个关卡设定,指定当有数据的时候专门去找某个特定的链来处理,当那个链处理完之后,再返回。接着在特定的链中继续检查。
|
||||
|
||||
注意:规则的次序非常关键,`谁的规则越严格,应该放的越靠前`,而检查规则的时候,是按照从上往下的方式进行检查的。
|
||||
|
||||
表名包括:
|
||||
|
||||
- **raw** :高级功能,如:网址过滤。
|
||||
- **mangle** :数据包修改(QOS),用于实现服务质量。
|
||||
- **nat** :地址转换,用于网关路由器。
|
||||
- **filter** :包过滤,用于防火墙规则。
|
||||
|
||||
动作包括:
|
||||
|
||||
- **ACCEPT** :接收数据包。
|
||||
- **DROP** :丢弃数据包。
|
||||
- **REDIRECT** :重定向、映射、透明代理。
|
||||
- **SNAT** :源地址转换。
|
||||
- **DNAT** :目标地址转换。
|
||||
- **MASQUERADE** :IP伪装(NAT),用于ADSL。
|
||||
- **LOG** :日志记录。
|
||||
- **SEMARK** : 添加SEMARK标记以供网域内强制访问控制(MAC)
|
||||
|
||||
```shell
|
||||
┏╍╍╍╍╍╍╍╍╍╍╍╍╍╍╍┓
|
||||
┌───────────────┐ ┃ Network ┃
|
||||
│ table: filter │ ┗━━━━━━━┳━━━━━━━┛
|
||||
│ chain: INPUT │◀────┐ │
|
||||
└───────┬───────┘ │ ▼
|
||||
│ │ ┌───────────────────┐
|
||||
┌ ▼ ┐ │ │ table: nat │
|
||||
│local process│ │ │ chain: PREROUTING │
|
||||
└ ┘ │ └─────────┬─────────┘
|
||||
│ │ │
|
||||
▼ │ ▼ ┌─────────────────┐
|
||||
┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅ │ ┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅ │table: nat │
|
||||
Routing decision └───── outing decision ─────▶│chain: PREROUTING│
|
||||
┅┅┅┅┅┅┅┅┅┳┅┅┅┅┅┅┅┅┅ ┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅ └────────┬────────┘
|
||||
│ │
|
||||
▼ │
|
||||
┌───────────────┐ │
|
||||
│ table: nat │ ┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅┅ │
|
||||
│ chain: OUTPUT │ ┌─────▶ outing decision ◀──────────────┘
|
||||
└───────┬───────┘ │ ┅┅┅┅┅┅┅┅┳┅┅┅┅┅┅┅┅
|
||||
│ │ │
|
||||
▼ │ ▼
|
||||
┌───────────────┐ │ ┌────────────────────┐
|
||||
│ table: filter │ │ │ chain: POSTROUTING │
|
||||
│ chain: OUTPUT ├────┘ └──────────┬─────────┘
|
||||
└───────────────┘ │
|
||||
▼
|
||||
┏╍╍╍╍╍╍╍╍╍╍╍╍╍╍╍┓
|
||||
┃ Network ┃
|
||||
┗━━━━━━━━━━━━━━━┛
|
||||
```
|
||||
|
||||
### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%AE%9E%E4%BE%8B)实例
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E6%B8%85%E7%A9%BA%E5%BD%93%E5%89%8D%E7%9A%84%E6%89%80%E6%9C%89%E8%A7%84%E5%88%99%E5%92%8C%E8%AE%A1%E6%95%B0)清空当前的所有规则和计数
|
||||
|
||||
```shell
|
||||
iptables -F # 清空所有的防火墙规则
|
||||
iptables -X # 删除用户自定义的空链
|
||||
iptables -Z # 清空计数
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E9%85%8D%E7%BD%AE%E5%85%81%E8%AE%B8ssh%E7%AB%AF%E5%8F%A3%E8%BF%9E%E6%8E%A5)配置允许ssh端口连接
|
||||
|
||||
```shell
|
||||
iptables -A INPUT -s 192.168.1.0/24 -p tcp --dport 22 -j ACCEPT
|
||||
# 22为你的ssh端口, -s 192.168.1.0/24表示允许这个网段的机器来连接,其它网段的ip地址是登陆不了你的机器的。 -j ACCEPT表示接受这样的请求
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%85%81%E8%AE%B8%E6%9C%AC%E5%9C%B0%E5%9B%9E%E7%8E%AF%E5%9C%B0%E5%9D%80%E5%8F%AF%E4%BB%A5%E6%AD%A3%E5%B8%B8%E4%BD%BF%E7%94%A8)允许本地回环地址可以正常使用
|
||||
|
||||
```shell
|
||||
iptables -A INPUT -i lo -j ACCEPT
|
||||
#本地圆环地址就是那个127.0.0.1,是本机上使用的,它进与出都设置为允许
|
||||
iptables -A OUTPUT -o lo -j ACCEPT
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E8%AE%BE%E7%BD%AE%E9%BB%98%E8%AE%A4%E7%9A%84%E8%A7%84%E5%88%99)设置默认的规则
|
||||
|
||||
```shell
|
||||
iptables -P INPUT DROP # 配置默认的不让进
|
||||
iptables -P FORWARD DROP # 默认的不允许转发
|
||||
iptables -P OUTPUT ACCEPT # 默认的可以出去
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E9%85%8D%E7%BD%AE%E7%99%BD%E5%90%8D%E5%8D%95)配置白名单
|
||||
|
||||
```shell
|
||||
iptables -A INPUT -p all -s 192.168.1.0/24 -j ACCEPT # 允许机房内网机器可以访问
|
||||
iptables -A INPUT -p all -s 192.168.140.0/24 -j ACCEPT # 允许机房内网机器可以访问
|
||||
iptables -A INPUT -p tcp -s 183.121.3.7 --dport 3380 -j ACCEPT # 允许183.121.3.7访问本机的3380端口
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%BC%80%E5%90%AF%E7%9B%B8%E5%BA%94%E7%9A%84%E6%9C%8D%E5%8A%A1%E7%AB%AF%E5%8F%A3)开启相应的服务端口
|
||||
|
||||
```shell
|
||||
iptables -A INPUT -p tcp --dport 80 -j ACCEPT # 开启80端口,因为web对外都是这个端口
|
||||
iptables -A INPUT -p icmp --icmp-type 8 -j ACCEPT # 允许被ping
|
||||
iptables -A INPUT -m state --state ESTABLISHED,RELATED -j ACCEPT # 已经建立的连接得让它进来
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E4%BF%9D%E5%AD%98%E8%A7%84%E5%88%99%E5%88%B0%E9%85%8D%E7%BD%AE%E6%96%87%E4%BB%B6%E4%B8%AD)保存规则到配置文件中
|
||||
|
||||
```shell
|
||||
cp /etc/sysconfig/iptables /etc/sysconfig/iptables.bak # 任何改动之前先备份,请保持这一优秀的习惯
|
||||
iptables-save > /etc/sysconfig/iptables
|
||||
cat /etc/sysconfig/iptables
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%88%97%E5%87%BA%E5%B7%B2%E8%AE%BE%E7%BD%AE%E7%9A%84%E8%A7%84%E5%88%99)列出已设置的规则
|
||||
|
||||
> iptables -L [-t 表名] [链名]
|
||||
|
||||
- 四个表名 `raw`,`nat`,`filter`,`mangle`
|
||||
- 五个规则链名 `INPUT`、`OUTPUT`、`FORWARD`、`PREROUTING`、`POSTROUTING`
|
||||
- filter表包含`INPUT`、`OUTPUT`、`FORWARD`三个规则链
|
||||
|
||||
```shell
|
||||
iptables -L -t nat # 列出 nat 上面的所有规则
|
||||
# ^ -t 参数指定,必须是 raw, nat,filter,mangle 中的一个
|
||||
iptables -L -t nat --line-numbers # 规则带编号
|
||||
iptables -L INPUT
|
||||
|
||||
iptables -L -nv # 查看,这个列表看起来更详细
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E6%B8%85%E9%99%A4%E5%B7%B2%E6%9C%89%E8%A7%84%E5%88%99)清除已有规则
|
||||
|
||||
```shell
|
||||
iptables -F INPUT # 清空指定链 INPUT 上面的所有规则
|
||||
iptables -X INPUT # 删除指定的链,这个链必须没有被其它任何规则引用,而且这条上必须没有任何规则。
|
||||
# 如果没有指定链名,则会删除该表中所有非内置的链。
|
||||
iptables -Z INPUT # 把指定链,或者表中的所有链上的所有计数器清零。
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%88%A0%E9%99%A4%E5%B7%B2%E6%B7%BB%E5%8A%A0%E7%9A%84%E8%A7%84%E5%88%99)删除已添加的规则
|
||||
|
||||
```shell
|
||||
# 添加一条规则
|
||||
iptables -A INPUT -s 192.168.1.5 -j DROP
|
||||
```
|
||||
|
||||
将所有iptables以序号标记显示,执行:
|
||||
|
||||
```shell
|
||||
iptables -L -n --line-numbers
|
||||
```
|
||||
|
||||
比如要删除INPUT里序号为8的规则,执行:
|
||||
|
||||
```shell
|
||||
iptables -D INPUT 8
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%BC%80%E6%94%BE%E6%8C%87%E5%AE%9A%E7%9A%84%E7%AB%AF%E5%8F%A3)开放指定的端口
|
||||
|
||||
```shell
|
||||
iptables -A INPUT -s 127.0.0.1 -d 127.0.0.1 -j ACCEPT #允许本地回环接口(即运行本机访问本机)
|
||||
iptables -A INPUT -m state --state ESTABLISHED,RELATED -j ACCEPT #允许已建立的或相关连的通行
|
||||
iptables -A OUTPUT -j ACCEPT #允许所有本机向外的访问
|
||||
iptables -A INPUT -p tcp --dport 22 -j ACCEPT #允许访问22端口
|
||||
iptables -A INPUT -p tcp --dport 80 -j ACCEPT #允许访问80端口
|
||||
iptables -A INPUT -p tcp --dport 21 -j ACCEPT #允许ftp服务的21端口
|
||||
iptables -A INPUT -p tcp --dport 20 -j ACCEPT #允许FTP服务的20端口
|
||||
iptables -A INPUT -j reject #禁止其他未允许的规则访问
|
||||
iptables -A FORWARD -j REJECT #禁止其他未允许的规则访问
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%B1%8F%E8%94%BDip)屏蔽IP
|
||||
|
||||
```shell
|
||||
iptables -A INPUT -p tcp -m tcp -s 192.168.0.8 -j DROP # 屏蔽恶意主机(比如,192.168.0.8
|
||||
iptables -I INPUT -s 123.45.6.7 -j DROP #屏蔽单个IP的命令
|
||||
iptables -I INPUT -s 123.0.0.0/8 -j DROP #封整个段即从123.0.0.1到123.255.255.254的命令
|
||||
iptables -I INPUT -s 124.45.0.0/16 -j DROP #封IP段即从123.45.0.1到123.45.255.254的命令
|
||||
iptables -I INPUT -s 123.45.6.0/24 -j DROP #封IP段即从123.45.6.1到123.45.6.254的命令是
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E6%8C%87%E5%AE%9A%E6%95%B0%E6%8D%AE%E5%8C%85%E5%87%BA%E5%8E%BB%E7%9A%84%E7%BD%91%E7%BB%9C%E6%8E%A5%E5%8F%A3)指定数据包出去的网络接口
|
||||
|
||||
只对 OUTPUT,FORWARD,POSTROUTING 三个链起作用。
|
||||
|
||||
```shell
|
||||
iptables -A FORWARD -o eth0
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E6%9F%A5%E7%9C%8B%E5%B7%B2%E6%B7%BB%E5%8A%A0%E7%9A%84%E8%A7%84%E5%88%99)查看已添加的规则
|
||||
|
||||
```shell
|
||||
iptables -L -n -v
|
||||
Chain INPUT (policy DROP 48106 packets, 2690K bytes)
|
||||
pkts bytes target prot opt in out source destination
|
||||
5075 589K ACCEPT all -- lo * 0.0.0.0/0 0.0.0.0/0
|
||||
191K 90M ACCEPT tcp -- * * 0.0.0.0/0 0.0.0.0/0 tcp dpt:22
|
||||
1499K 133M ACCEPT tcp -- * * 0.0.0.0/0 0.0.0.0/0 tcp dpt:80
|
||||
4364K 6351M ACCEPT all -- * * 0.0.0.0/0 0.0.0.0/0 state RELATED,ESTABLISHED
|
||||
6256 327K ACCEPT icmp -- * * 0.0.0.0/0 0.0.0.0/0
|
||||
|
||||
Chain FORWARD (policy ACCEPT 0 packets, 0 bytes)
|
||||
pkts bytes target prot opt in out source destination
|
||||
|
||||
Chain OUTPUT (policy ACCEPT 3382K packets, 1819M bytes)
|
||||
pkts bytes target prot opt in out source destination
|
||||
5075 589K ACCEPT all -- * lo 0.0.0.0/0 0.0.0.0/0
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%90%AF%E5%8A%A8%E7%BD%91%E7%BB%9C%E8%BD%AC%E5%8F%91%E8%A7%84%E5%88%99)启动网络转发规则
|
||||
|
||||
公网`210.14.67.7`让内网`192.168.188.0/24`上网
|
||||
|
||||
```shell
|
||||
iptables -t nat -A POSTROUTING -s 192.168.188.0/24 -j SNAT --to-source 210.14.67.127
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E7%AB%AF%E5%8F%A3%E6%98%A0%E5%B0%84)端口映射
|
||||
|
||||
本机的 2222 端口映射到内网 虚拟机的22 端口
|
||||
|
||||
```shell
|
||||
iptables -t nat -A PREROUTING -d 210.14.67.127 -p tcp --dport 2222 -j DNAT --to-dest 192.168.188.115:22
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E5%AD%97%E7%AC%A6%E4%B8%B2%E5%8C%B9%E9%85%8D)字符串匹配
|
||||
|
||||
比如,我们要过滤所有TCP连接中的字符串`test`,一旦出现它我们就终止这个连接,我们可以这么做:
|
||||
|
||||
```shell
|
||||
iptables -A INPUT -p tcp -m string --algo kmp --string "test" -j REJECT --reject-with tcp-reset
|
||||
iptables -L
|
||||
|
||||
# Chain INPUT (policy ACCEPT)
|
||||
# target prot opt source destination
|
||||
# REJECT tcp -- anywhere anywhere STRING match "test" ALGO name kmp TO 65535 reject-with tcp-reset
|
||||
#
|
||||
# Chain FORWARD (policy ACCEPT)
|
||||
# target prot opt source destination
|
||||
#
|
||||
# Chain OUTPUT (policy ACCEPT)
|
||||
# target prot opt source destination
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E9%98%BB%E6%AD%A2windows%E8%A0%95%E8%99%AB%E7%9A%84%E6%94%BB%E5%87%BB)阻止Windows蠕虫的攻击
|
||||
|
||||
```shell
|
||||
iptables -I INPUT -j DROP -p tcp -s 0.0.0.0/0 -m string --algo kmp --string "cmd.exe"
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E9%98%B2%E6%AD%A2syn%E6%B4%AA%E6%B0%B4%E6%94%BB%E5%87%BB)防止SYN洪水攻击
|
||||
|
||||
```shell
|
||||
iptables -A INPUT -p tcp --syn -m limit --limit 5/second -j ACCEPT
|
||||
```
|
||||
|
||||
#### [](https://wangchujiang.com/linux-command/c/iptables.html#%E6%B7%BB%E5%8A%A0secmark%E8%AE%B0%E5%BD%95)添加SECMARK记录
|
||||
|
||||
```shell
|
||||
iptables -t mangle -A INPUT -p tcp --src 192.168.1.2 --dport 443 -j SECMARK --selctx system_u:object_r:myauth_packet_t
|
||||
# 向从 192.168.1.2:443 以TCP方式发出到本机的包添加MAC安全上下文 system_u:object_r:myauth_packet_t
|
||||
```
|
||||
|
||||
## [](https://wangchujiang.com/linux-command/c/iptables.html#%E6%9B%B4%E5%A4%9A%E5%AE%9E%E4%BE%8B)更多实例
|
||||
|
||||
> 用iptables搭建一套强大的安全防护盾 [http://www.imooc.com/learn/389](http://www.imooc.com/learn/389)
|
||||
|
||||
iptables: linux 下应用层防火墙工具
|
||||
|
||||
iptables 5链: 对应 Hook point netfilter: linux 操作系统核心层内部的一个数据包处理模块 Hook point: 数据包在 netfilter 中的挂载点; `PRE_ROUTING / INPUT / OUTPUT / FORWARD / POST_ROUTING`
|
||||
|
||||
iptables & netfilter 
|
||||
|
||||
iptables 4表5链 
|
||||
|
||||
iptables rules 
|
||||
|
||||
- 4表
|
||||
|
||||
**filter**: 访问控制 / 规则匹配 **nat**: 地址转发 mangle / raw
|
||||
|
||||
- 规则
|
||||
|
||||
数据访问控制: ACCEPT / DROP / REJECT 数据包改写(nat -> 地址转换): snat / dnat 信息记录: log
|
||||
|
||||
## [](https://wangchujiang.com/linux-command/c/iptables.html#%E4%BD%BF%E7%94%A8%E5%9C%BA%E6%99%AF%E5%AE%9E%E4%BE%8B)使用场景实例
|
||||
|
||||
- 场景一
|
||||
|
||||
开放 tcp 10-22/80 端口 开放 icmp 其他未被允许的端口禁止访问
|
||||
|
||||
存在的问题: 本机无法访问本机; 本机无法访问其他主机
|
||||
|
||||
- 场景二
|
||||
|
||||
ftp: 默认被动模式(服务器产生随机端口告诉客户端, 客户端主动连接这个端口拉取数据) vsftpd: 使 ftp 支持主动模式(客户端产生随机端口通知服务器, 服务器主动连接这个端口发送数据)
|
||||
|
||||
- 场景三
|
||||
|
||||
允许外网访问: web http -> 80/tcp; https -> 443/tcp mail smtp -> 25/tcp; smtps -> 465/tcp pop3 -> 110/tcp; pop3s -> 995/tcp imap -> 143/tcp
|
||||
|
||||
内部使用: file nfs -> 123/udp samba -> 137/138/139/445/tcp ftp -> 20/21/tcp remote ssh -> 22/tcp sql mysql -> 3306/tcp oracle -> 1521/tcp
|
||||
|
||||
- 场景四
|
||||
|
||||
nat 转发
|
||||
|
||||
- 场景五
|
||||
|
||||
防CC攻击
|
||||
|
||||
```shell
|
||||
iptables -L -F -A -D # list flush append delete
|
||||
# 场景一
|
||||
iptables -I INPUT -p tcp --dport 80 -j ACCEPT # 允许 tcp 80 端口
|
||||
iptables -I INPUT -p tcp --dport 10:22 -j ACCEPT # 允许 tcp 10-22 端口
|
||||
iptables -I INPUT -p icmp -j ACCEPT # 允许 icmp
|
||||
iptables -A INPUT -j REJECT # 添加一条规则, 不允许所有
|
||||
|
||||
# 优化场景一
|
||||
iptables -I INPUT -i lo -j ACCEPT # 允许本机访问
|
||||
iptables -I INPUT -m state --state ESTABLISHED,RELATED -j ACCEPT # 允许访问外网
|
||||
iptables -I INPUT -p tcp --dport 80 -s 10.10.188.233 -j ACCEPT # 只允许固定ip访问80
|
||||
|
||||
# 场景二
|
||||
vi /etc/vsftpd/vsftpd.conf # 使用 vsftpd 开启 ftp 主动模式
|
||||
port_enable=yes
|
||||
connect_from_port_20=YES
|
||||
iptables -I INPUT -p tcp --dport 21 -j ACCEPT
|
||||
|
||||
vi /etc/vsftpd/vsftpd.conf # 建议使用 ftp 被动模式
|
||||
pasv_min_port=50000
|
||||
pasv_max_port=60000
|
||||
iptables -I INPUT -p tcp --dport 21 -j ACCEPT
|
||||
iptables -I INPUT -p tcp --dport 50000:60000 -j ACCEPT
|
||||
|
||||
# 还可以使用 iptables 模块追踪来自动开发对应的端口
|
||||
|
||||
# 场景三
|
||||
iptables -I INPUT -i lo -j ACCEPT # 允许本机访问
|
||||
iptables -I INPUT -m state --state ESTABLISHED,RELATED -j ACCEPT # 允许访问外网
|
||||
iptables -I INPUT -s 10.10.155.0/24 -j ACCEPT # 允许内网访问
|
||||
iptables -I INPUT -p tcp -m multiport --dports 80,1723 -j ACCEPT # 允许端口, 80 -> http, 1723 -> vpn
|
||||
iptables -A INPUT -j REJECT # 添加一条规则, 不允许所有
|
||||
|
||||
iptables-save # 保存设置到配置文件
|
||||
|
||||
# 场景四
|
||||
iptables -t nat -L # 查看 nat 配置
|
||||
|
||||
iptables -t nat -A POST_ROUTING -s 10.10.177.0/24 -j SNAT --to 10.10.188.232 # SNAT
|
||||
vi /etc/sysconfig/network # 配置网关
|
||||
|
||||
iptables -t nat -A POST_ROUTING -d 10.10.188.232 -p tcp --dport 80 -j DNAT --to 10.10.177.232:80 # DNAT
|
||||
|
||||
#场景五
|
||||
iptables -I INPUT -p tcp --syn --dport 80 -m connlimit --connlimit-above 100 -j REJECT # 限制并发连接访问数
|
||||
iptables -I INPUT -m limit --limit 3/hour --limit-burst 10 -j ACCEPT # limit模块; --limit-burst 默认为5
|
||||
```
|
||||
@@ -0,0 +1,121 @@
|
||||
作者:沐安大数据运维
|
||||
链接:https://www.zhihu.com/question/23063802/answer/1967299165974423120
|
||||
来源:知乎
|
||||
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
|
||||
|
||||
|
||||
都很明确:**开,必须开,除非你想体验半夜被报警电话吵醒的刺激感。**
|
||||
|
||||
前任运维说“咱们有云防火墙,系统层iptables没必要开,影响性能”。
|
||||
|
||||
有个业务部门偷偷开了个[Redis](https://zhida.zhihu.com/search?content_id=754271874&content_type=Answer&match_order=1&q=Redis&zhida_source=entity)端口在外网,没设密码。一个月后,我们成了别人的挖矿肉鸡,CPU常年100%,清理后门花了两天时间。
|
||||
|
||||
养成个好习惯:新服务器上线,第一件事就是配iptables。
|
||||
|
||||
### iptables不是累赘,是你的“安全底线”
|
||||
|
||||
很多人觉得,现在都是云时代了,有云厂商的安全组,iptables多余。这话对了一半。
|
||||
|
||||
[云安全组](https://zhida.zhihu.com/search?content_id=754271874&content_type=Answer&match_order=1&q=%E4%BA%91%E5%AE%89%E5%85%A8%E7%BB%84&zhida_source=entity)确实好用,像大楼的物业保安。但iptables是你家的防盗门。**保安可能会看走眼,但防盗门永远忠实地守在你家门口。**
|
||||
|
||||
如果云平台控制台故障,安全组规则突然失效。
|
||||
|
||||
如果服务器上的iptables还开着,那几千台机器就能否避免全暴露在公网上。
|
||||
|
||||
想想都头皮发麻。
|
||||
|
||||
### 性能影响?别自己吓自己
|
||||
|
||||
“开防火墙影响性能”——这是最大的误解。
|
||||
|
||||
看到过过一个测试:开启基础防护规则(开22、80、443端口,默认拒绝其他入站),对网络性能的影响可以忽略不计。除非你每条规则都带着几十个复杂的字符串匹配,那确实会慢。但正常使用,根本感觉不出来。
|
||||
|
||||
**比起性能那点微不足道的损失,安全带来的收益太大了。**
|
||||
|
||||
### 怎么配置才既安全又省心?
|
||||
|
||||
```text
|
||||
我现在的标准配置模板,用了很多年,分享给大家:
|
||||
# 清空现有规则
|
||||
iptables -F
|
||||
# 设置默认策略:进来的包都拒绝,出去的都允许
|
||||
iptables -P INPUT DROP
|
||||
iptables -P FORWARD DROP
|
||||
iptables -P OUTPUT ACCEPT
|
||||
# 本机访问本机全部允许
|
||||
iptables -A INPUT -i lo -j ACCEPT
|
||||
|
||||
# 允许已建立的连接和相关的连接通过(最关键的一条!)
|
||||
iptables -A INPUT -m state --state ESTABLISHED,RELATED -j ACCEPT
|
||||
|
||||
# 开SSH端口(根据实际情况改)
|
||||
iptables -A INPUT -p tcp --dport 22 -j ACCEPT
|
||||
|
||||
# 开Web端口(如果需要)
|
||||
iptables -A INPUT -p tcp --dport 80 -j ACCEPT
|
||||
iptables -A INPUT -p tcp --dport 443 -j ACCEPT
|
||||
|
||||
# 最后,允许ping(调试用)
|
||||
iptables -A INPUT -p icmp -j ACCEPT
|
||||
```
|
||||
|
||||
这套规则的核心思想是:**先堵死所有入口,再按需开小门。**
|
||||
|
||||
### 不同场景下的灵活用法
|
||||
|
||||
根据服务器角色,配置要有侧重:
|
||||
|
||||
**Web服务器**:主要开80、443,数据库端口3306只对内部IP开放
|
||||
|
||||
```text
|
||||
iptables -A INPUT -p tcp -s 192.168.1.0/24 --dport 3306 -j ACCEPT
|
||||
```
|
||||
|
||||
**数据库服务器**:尽量不暴露在外网,业务端口只对应用服务器IP开放
|
||||
|
||||
**跳板机**:SSH端口可以改成非标准端口,减少被扫描的概率
|
||||
|
||||
```text
|
||||
iptables -A INPUT -p tcp --dport 58222 -j ACCEPT
|
||||
```
|
||||
|
||||
### 运维老鸟的小技巧
|
||||
|
||||
1. **规则顺序很重要**:iptables按顺序匹配,常用的规则放前面
|
||||
2. **保存规则是必须的**:配置完一定要`service iptables save`,否则重启就没了
|
||||
3. **先放行再操作**:远程操作时,先在crontab里设置5分钟后清空规则的备份计划,防止把自己锁在外面
|
||||
4. **日志记录**:对可疑的访问尝试记录日志,方便排查
|
||||
|
||||
```text
|
||||
iptables -A INPUT -p tcp --dport 22 -m limit --limit 5/min -j LOG --log-prefix "SSH attempt: "
|
||||
```
|
||||
|
||||
### 新时代的替代品?各有各的好
|
||||
|
||||
现在确实有更现代的方案:
|
||||
|
||||
- **[firewalld](https://zhida.zhihu.com/search?content_id=754271874&content_type=Answer&match_order=1&q=firewalld&zhida_source=entity)**:RedHat系的主流,配置更直观,适合桌面和服务器
|
||||
- **[ufw](https://zhida.zhihu.com/search?content_id=754271874&content_type=Answer&match_order=1&q=ufw&zhida_source=entity)**:Ubuntu的简化工具,几条命令就能搞定基础防护
|
||||
- **云安全组**:管理方便,不耗服务器资源
|
||||
|
||||
习惯iptables,因为它:
|
||||
|
||||
- **通用**:哪个Linux发行版都有
|
||||
- **透明**:每条规则我都知道在干什么
|
||||
- **灵活**:想怎么配就怎么配,没有黑盒子
|
||||
|
||||
### 讲话
|
||||
|
||||
运维这行干久了,你会明白一个道理:**安全往往败在侥幸心理上**。
|
||||
|
||||
“就一会儿,应该没事”
|
||||
“咱们系统小,没人会盯上”
|
||||
“有云防火墙呢,够了”
|
||||
|
||||
不要等代价产生了再后悔。
|
||||
|
||||
开启iptables,就像是给你的服务器买了份保险。
|
||||
|
||||
平时感觉不到它的存在,真出事了,它能救你的命。
|
||||
|
||||
在运维的世界里,谨慎从来都不是坏事。
|
||||
@@ -0,0 +1,215 @@
|
||||
`less` 是一个功能强大的分页查看器,远远不止“空格翻页”那么简单。以下是一些能显著提升效率的实用技巧。
|
||||
|
||||
---
|
||||
|
||||
## 1. 基础但重要的导航
|
||||
|
||||
| 操作 | 快捷键 | 说明 |
|
||||
|------|--------|------|
|
||||
| 向下翻一屏 | `空格` / `f` / `Ctrl+F` | 最常用 |
|
||||
| 向上翻一屏 | `b` / `Ctrl+B` | |
|
||||
| 向下翻一行 | `j` / `e` / `↓` / `Enter` | |
|
||||
| 向上翻一行 | `k` / `y` / `↑` | |
|
||||
| 转到文件首行 | `g` | |
|
||||
| 转到文件末行 | `G` | |
|
||||
| 转到第 n 行 | `n` + `g` 或 `nG` | 例如 `100g` |
|
||||
| 跳转百分比 | `n%` | 例如 `50%` |
|
||||
| 向右滚动 | `→` | 长行 |
|
||||
| 向左滚动 | `←` | |
|
||||
|
||||
---
|
||||
|
||||
## 2. 强大的搜索功能
|
||||
|
||||
| 操作 | 快捷键 | 说明 |
|
||||
|------|--------|------|
|
||||
| 向前搜索 | `/关键词` + `Enter` | 向下查找 |
|
||||
| 向后搜索 | `?关键词` + `Enter` | 向上查找 |
|
||||
| 查找下一个 | `n` | 保持同一方向 |
|
||||
| 查找上一个 | `N` | 反方向 |
|
||||
| 搜索时不区分大小写 | `/关键词` 然后按 `-i` 再按 `Enter` | 或启动时加 `-i` |
|
||||
| 高亮所有匹配 | `/关键词` 后,输入 `&` 并回车 | 见下文“过滤模式” |
|
||||
|
||||
💡 **技巧**:输入 `/` 后按 `↑` 可以调出上一次搜索的关键词。
|
||||
|
||||
---
|
||||
|
||||
## 3. 高级过滤:只显示匹配的行(类似 grep)
|
||||
|
||||
这是 `less` 的一个隐藏神技 —— **& 命令**:
|
||||
|
||||
1. 按 `&` 键
|
||||
2. 输入正则表达式(例如 `error` 或 `^INFO`)
|
||||
3. 回车
|
||||
|
||||
→ `less` 会**只显示包含该模式的行**,其他行隐藏。效果类似于 `grep` 但仍在 `less` 中,可以继续上下翻动、搜索。
|
||||
|
||||
- 退出过滤模式:按 `&` 然后直接回车(不输入内容)
|
||||
|
||||
---
|
||||
|
||||
## 4. 标记与跳转(适合查看长日志或代码)
|
||||
|
||||
| 操作 | 快捷键 | 说明 |
|
||||
|------|--------|------|
|
||||
| 设置标记 | `m` + 小写字母 | 例如 `ma` 在当前行设标记 a |
|
||||
| 跳转到标记 | `'` + 同一字母 | 例如 `'a` 跳回标记 a 位置 |
|
||||
| 查看所有标记 | 无直接命令 | 但标记会保持到退出 |
|
||||
|
||||
💡 标记在查看大文件时极有用:例如看到一处错误,设标记 `me`,继续往下翻,然后 `'e` 快速回来。
|
||||
|
||||
---
|
||||
|
||||
在 `less` 中显示行号有两种常用方法:
|
||||
|
||||
### 方法一:启动时加参数 `-N`
|
||||
|
||||
```bash
|
||||
less -N filename
|
||||
```
|
||||
|
||||
示例效果:
|
||||
```
|
||||
1 first line
|
||||
2 second line
|
||||
3 third line
|
||||
```
|
||||
|
||||
`-N` 表示 `--LINE-NUMBERS`,在每行前面显示行号(从 1 开始)。
|
||||
|
||||
---
|
||||
|
||||
### 方法二:在 `less` 运行中动态切换
|
||||
|
||||
进入 `less` 后,按 `-` 键,然后按 `N`,再按回车。
|
||||
|
||||
步骤分解:
|
||||
1. 按 `-`(减号)
|
||||
2. 输入 `N`(大写字母 N)
|
||||
3. 按 `Enter`
|
||||
|
||||
此时行号会立即显示或隐藏。可以随时再次执行相同操作来切换。
|
||||
|
||||
---
|
||||
|
||||
### 其他实用组合
|
||||
|
||||
- **同时显示行号且不换行(方便看表格数据)**
|
||||
```bash
|
||||
less -NS filename
|
||||
```
|
||||
|
||||
- **显示行号并实时跟踪日志**
|
||||
```bash
|
||||
less -N +F filename
|
||||
```
|
||||
进入后按 `Ctrl+C` 退出跟随模式即可看到行号。
|
||||
|
||||
- **行号显示样式说明**
|
||||
行号默认是右对齐,占据固定宽度。如果文件行数很大(如超过 10 万行),`less` 会自动调整宽度,不会截断。
|
||||
|
||||
---
|
||||
|
||||
### 注意事项
|
||||
|
||||
- `-N` 会稍微降低性能(极大数据集时),但通常可以忽略。
|
||||
- 在管道中使用时,`less -N` 也能工作,例如:`grep error log.txt | less -N`。
|
||||
|
||||
如果你希望**永久开启行号**,可以在 `~/.lesskey` 或环境变量 `$LESS` 中设置:
|
||||
```bash
|
||||
export LESS="-N"
|
||||
```
|
||||
这样每次使用 `less` 都会自动显示行号。
|
||||
|
||||
|
||||
---
|
||||
|
||||
|
||||
|
||||
## 5. 实时查看动态文件(类似 tail -f)
|
||||
|
||||
```bash
|
||||
less +F logfile
|
||||
```
|
||||
或进入 `less` 后按 `F`(大写)。
|
||||
|
||||
此时 `less` 会进入**跟随模式**,新追加的内容会自动显示。要退出跟随模式并回到普通 `less` 视图,按 `Ctrl+C`。
|
||||
|
||||
---
|
||||
|
||||
## 6. 多文件操作
|
||||
|
||||
同时查看多个文件:
|
||||
```bash
|
||||
less file1 file2 file3
|
||||
```
|
||||
|
||||
| 操作 | 快捷键 | 说明 |
|
||||
|------|--------|------|
|
||||
| 查看下一个文件 | `:n` | |
|
||||
| 查看上一个文件 | `:p` | |
|
||||
| 列出所有文件 | `:f` | 显示当前文件名及位置 |
|
||||
| 切换到第 N 个文件 | `:x N` | |
|
||||
|
||||
---
|
||||
|
||||
## 7. 常用命令行选项(启动时)
|
||||
|
||||
| 选项 | 效果 |
|
||||
|------|------|
|
||||
| `less -N filename` | 显示行号 |
|
||||
| `less -i filename` | 搜索时不区分大小写 |
|
||||
| `less -S filename` | 不换行(长行横向滚动),按 `-S` 可动态切换 |
|
||||
| `less -R filename` | 保留 ANSI 颜色(例如 `ls --color=yes \| less -R`) |
|
||||
| `less -F filename` | 若文件短于一屏则直接 cat(适合脚本) |
|
||||
| `less +F filename` | 启动即进入 follow 模式 |
|
||||
| `less +/error filename` | 启动后直接搜索 `error` |
|
||||
|
||||
---
|
||||
|
||||
## 8. 实用内部命令(在 `less` 内输入)
|
||||
|
||||
| 命令 | 效果 |
|
||||
| -------------- | ---------------------------- |
|
||||
| `=` 或 `Ctrl+G` | 显示当前行号、总行数、百分比 |
|
||||
| `-N` 然后回车 | 动态显示/隐藏行号 |
|
||||
| `-S` 然后回车 | 动态切换长行折行/切分模式 |
|
||||
| `-i` 然后回车 | 动态切换搜索大小写敏感 |
|
||||
| `v` | 用默认编辑器($EDITOR)打开当前文件并定位到同一行 |
|
||||
| `h` | 显示完整帮助 |
|
||||
| `q` 或 `Q` | 退出 |
|
||||
|
||||
---
|
||||
|
||||
## 9. 使用正则表达式搜索
|
||||
|
||||
`/` 和 `?` 支持基础正则表达式:
|
||||
- `error\|warn` 匹配 error 或 warn
|
||||
- `^INFO` 行首
|
||||
- `.*abc.*` 任意包含 abc
|
||||
- `\berror\b` 全词匹配
|
||||
|
||||
💡 若想使用扩展正则(如 `+` `?`),可以在 `less` 中按 `-E` 启用(`less -E` 启动或在内部按 `-E` 回车)。不同版本支持度略有差异。
|
||||
|
||||
---
|
||||
|
||||
## 10. 实用组合技
|
||||
|
||||
| 需求 | 命令/步骤 |
|
||||
|------|----------|
|
||||
| 查看大日志,高亮关键词 | `less -p "error" big.log`(启动后自动搜索并高亮) |
|
||||
| 实时跟踪并搜索 | `less +F log` 然后按 `Ctrl+C` 进入普通模式,按 `/` 搜索,再按 `F` 恢复跟踪 |
|
||||
| 过滤出错误行并实时跟踪 | `less +F log` 按 `Ctrl+C`,按 `&error` 过滤,再按 `F` |
|
||||
| 查看命令输出的同时保存副本 | `command \| tee output.log \| less` |
|
||||
|
||||
---
|
||||
|
||||
## 总结:最值得记住的 5 个技巧
|
||||
|
||||
1. **`/` 搜索,`n`/`N` 跳转**
|
||||
2. **`&` 只显示匹配行**(比 `grep` 更灵活)
|
||||
3. **`F` 实时跟踪文件增长**(`tail -f` 的替代)
|
||||
4. **`m`+字母 和 `'`+字母 做标记跳转**
|
||||
5. **`v` 用编辑器打开当前文件**(配合 `git diff` 或日志分析)
|
||||
|
||||
需要更具体的场景(比如查看超大 CSV、源码阅读、日志分析),我可以进一步展开。
|
||||
@@ -0,0 +1,8 @@
|
||||
|
||||
|
||||
locale -a
|
||||
fc-list :lang=zh
|
||||
echo $LANG $LC_ALL
|
||||
bash -c 'echo -e "\xe4\xb8\xad\xe6\x96\x87"'
|
||||
|
||||
|
||||
@@ -0,0 +1,301 @@
|
||||
## 背景
|
||||
|
||||
linux性能监测主要是关于Linux系统上程序的性能跟踪。
|
||||
|
||||
**前排提示**: 如果你只想要一个可监测linux性能的工具,并且有可视化的web,并且开源且持续更新,那么你可以查看 [Performance Co-Pilot](https://link.segmentfault.com/?enc=I8PbLahWDovcH2lDY1AzRw%3D%3D.Rp26m8avBzRv%2BendMImpEALexFgfk7xCQMe2M%2B1z8bKyvClWxAoKbSUDyEFWrE8D),比较不错。如果你需要更深入的了解linux性能监测,或者希望降低监测所带来的性能消耗,那么可以往下看。
|
||||
|
||||
从广义上讲, linux跟踪系统由三层组成
|
||||
|
||||
- 信息源
|
||||
- 对接信息源的追踪框架
|
||||
- 前端操作界面
|
||||
|
||||

|
||||
|
||||
## 信息源(event_sources)
|
||||
|
||||

|
||||
|
||||
**事件源是性能监测的基础**,**是跟踪数据的来源**,跟踪框架运行在内核中,负责数据收集、计数。
|
||||
|
||||
信息源主要分为以下三类:
|
||||
|
||||
1. 硬件事件
|
||||
2. 静态探针
|
||||
3. 动态探针
|
||||
|
||||

|
||||
|
||||
### 1.硬件事件
|
||||
|
||||
**性能监控计数器(PMCs**)是处理器上的可编程硬件计数器,用于测量处理器中发生的事件。
|
||||
|
||||
**PMCs是CPU自带的功能**,因此能得到最底层的、用别的手段得不到的性能信息,例如只有通过PMC才能测量CPU指令执行的效率、CPU缓存命中率、内存/数据互联和设备总线的利用率,以及阻塞的指令周期等。
|
||||
|
||||
由于硬件事件比较底层的,我们性能监测的时候,一般很少从此处获取可优化的数据。
|
||||
|
||||
### 2. 静态事件
|
||||
|
||||
#### 2.1 内核跟踪点(tracepoints)
|
||||
|
||||
即linux内核源代码中预先定义的跟踪点。
|
||||
|
||||
linux源码中,**有很多以 trace_ 开头的函数**, 这些都是是linux中预定义好的跟踪点。
|
||||
|
||||
int netif_receive_skb(struct sk_buff *skb)
|
||||
|
||||
{
|
||||
|
||||
trace_netif_receive_skb_entry(skb); // 调用netif_receive_skb对应的trace event函数
|
||||
|
||||
return netif_receive_skb_internal(skb);
|
||||
|
||||
}
|
||||
|
||||
如想查看这些 trace_ 开头的函数, 可到 `/sys/kernel/debug/tracing/`下查看
|
||||
|
||||
#### 2.2 USDT探针
|
||||
|
||||
USDT探针(User Statically-Defined Tracing)全称是用户级静态定义跟踪,需要在源码中插入 DTRACE_PROBE() 代码,并编译到应用程序中。这里不做详述。
|
||||
|
||||
### 3 动态探针
|
||||
|
||||
顾名思义,则是指没有事先在代码中定义,但却**可以在运行时动态添加的探针**(重点是不需要重新编译目标程序)。主要由kprobe(内核探针)和uprobe(用户态探针)组成。
|
||||
|
||||
#### 3.1 内核探针kprobes
|
||||
|
||||
kprobes(Kernel Dynamic Probes)。一种提供**内核函数动态跟踪**的 Linux 内核技术。
|
||||
|
||||
本质: **是在指定的探测点**(比如函数的某行, 函数的入口地址和出口地址, 或者内核的指定地址处)**插入一组处理程序**. 内核执行到这组处理程序的时候就可以获取到当前正在执行的上下文信息。
|
||||
|
||||
详细可查看[An introduction to KProbes](https://link.segmentfault.com/?enc=pWx1IyYTst7XSBCnoHOGUQ%3D%3D.Bh%2FQ%2BthpR863%2BLX2x%2Fn0GCiHdV7zrgDaivy%2FtWfsHQf%2FHCxB4T85A4NeZ4FTOKEi)
|
||||
|
||||
#### 3.2 用户态探针uprobes
|
||||
|
||||
一种提供**用户级函数动态跟踪**的 Linux 内核技术
|
||||
|
||||
详细可查看[Linux uprobe:用户级动态跟踪](https://link.segmentfault.com/?enc=RQResacFYQ84MCxrVW%2FjOQ%3D%3D.kzO2kG3zIhMH8RERHxgShB3gINabhcG63PcbFeKML9HsYCr0y0h63wIXFl3gQPDVDkQ1tmzu1ucvJaaJyARPloCVuTDdjKZVCTTsB5Hrc9E%3D)
|
||||
|
||||
---
|
||||
|
||||
总之,只需要了解**信息源主要分为硬件事件,静态探针,动态探针**
|
||||
|
||||
## 追踪框架
|
||||
|
||||
先介绍一下这方面的一个大神:[brendangregg](https://link.segmentfault.com/?enc=n4I1R0wLobR7Qm7AdSwR7g%3D%3D.UNXi6JWw%2Fem%2Fjk2NhlSxhJ7GnzYZ9MBnQyo7UEY9PFPilBg1qdGHhhdwuiaEcvF0), 很多编入内核的追踪框架都有他的贡献。
|
||||
|
||||
以下是他画的一张关于 linux 观察性能工具的一张图。
|
||||

|
||||
|
||||
可以说,linux 的各方面(cpu, 磁盘,调度,网络,io)都有对应的工具。
|
||||
|
||||
### 基础命令
|
||||
|
||||
我们可以先用一些基础命令来查看一些基本信息,比如上图中的 top, free等
|
||||
|
||||
**top命令:**
|
||||
|
||||

|
||||
|
||||
**平均负载**:三个值分别为1分钟、5分钟、15分钟前到现在的平均值(根据cpu数量去判断。最佳状态为 平均负载约等于cpu个数)
|
||||
|
||||
**Cpu(s)**:
|
||||
|
||||
1. 32.0%us(用户使用cpu占比)
|
||||
2. 2.0%sy(系统使用cpu占比)
|
||||
3. 0.0%ni(用户空间内改变过优先级的进程占用CPU百分比)
|
||||
4. 65.3%id(空闲cpu占比)
|
||||
5. 0.1%wa(等待输入输出CPU时间百分比)
|
||||
6. 0.1%hi(CPU服务于硬件中断所耗费的时间总额)
|
||||
7. 0.5%si(CPU服务软中断所耗费的时间总额)
|
||||
8. 0.0%st(Steal Time)
|
||||
|
||||
**Mem:**
|
||||
|
||||
1. total(物理内存总量)
|
||||
2. used(已使用的物理内存)
|
||||
3. free(剩余的物理内存)
|
||||
4. buffers(缓冲区内存)
|
||||
|
||||
**free 命令:**
|
||||

|
||||
|
||||
free命令显示内存的使用信息。默认按照k(b)的计数单位统计。也可以 -m 显示单位为 MB。更多参数可以查看 man free
|
||||
|
||||
**iostat命令:**
|
||||
iostat主要用于监控系统设备的IO负载情况。 可以获取io读写的速度等信息。 更多参数可以查看 man iostat
|
||||
|
||||

|
||||
|
||||
---
|
||||
|
||||
**其实 top, free, iostat 等一些命令,** **实质上都是通过读取 linux 的 /proc/ 文件夹下的文件 来实现数据报告**。
|
||||
|
||||
例如
|
||||
|
||||
> **/proc/cpuinfo** : cpu的硬件信息,如型号、速率、核数、cache大小等
|
||||
>
|
||||
> **/proc/meminfo**:内存的信息,如内存总量、free空间、swap空间
|
||||
>
|
||||
> **/proc/stat:** 所有的CPU活动状态的信息
|
||||
>
|
||||
> **/proc/diskstats** :磁盘信息
|
||||
>
|
||||
> **/proc/loadavg** : 根据过去一段时间内CPU和IO的状态得出的负载状态
|
||||
|
||||

|
||||
|
||||
所以,**直接 cat 相应的文件无疑也是个好方法**
|
||||
|
||||
### 框架
|
||||
|
||||
在来说说框架
|
||||
|
||||

|
||||
在这张图的左边,列出了比较常用的框架
|
||||
|
||||
1. perf
|
||||
2. ftrace
|
||||
3. lttng
|
||||
4. BCC
|
||||
5. bpftrace
|
||||
|
||||
当然也有更多:
|
||||

|
||||
|
||||
这是 brendangregg 大神在2015年的一篇文章 [选择 Linux 跟踪器](https://link.segmentfault.com/?enc=Nzqzn3IgCMDSw6e9AmmCoA%3D%3D.GDOSgy0GFBKOaZvOTaCc9sj8ccmsaTJTol6vHs%2F6RLDlGBLtXfOm3PETHRsutr4nuK66DYDxTB2XRPnjs50FZmXYq2ae9EiVs70%2BYZ%2FGhdU%3D) 到今日也有一定的参考价值。
|
||||
|
||||
博主本人比较推荐了解以下框架:
|
||||
|
||||
1. ftrace (内置在Linux内核中),比较经典
|
||||
2. perf (来源位于 Linux 内核中,通常通过 linux-tools-common 包添加)
|
||||
3. bpftrace (持续开源更新中)
|
||||
|
||||
以下是相关这三个工具的了解
|
||||

|
||||
|
||||
### ftrace
|
||||
|
||||
ftrace 在/sys/kernel/debug/tracing 位置上, 构建了一个文件系统,用户通过读写文件的方式来使用ftrace。
|
||||
|
||||
一切皆文件 的哲学在这里体现的淋漓尽致。
|
||||
|
||||
操作步骤:
|
||||
|
||||
#1、进入debugfs目录
|
||||
$ cd /sys/kernel/debug/tracing
|
||||
#如果找不到目录,执行下列命令挂载debugfs:
|
||||
$ mount -t debugfs nodev /sys/kernel/debug
|
||||
#2、查询支持的追踪器
|
||||
$ cat available_tracers
|
||||
#常用的有两种:
|
||||
#
|
||||
#- function 表示跟踪函数的执行;
|
||||
#- function_graph 则是跟踪函数的调用关系;
|
||||
#3、查看支持追踪的内核函数和事件。其中函数就是内核中的函数名,而事件,则是内核源码中预先定义的跟踪点。
|
||||
#//查看内核函数
|
||||
$ cat available_filter_functions
|
||||
#//查看事件
|
||||
$ cat available_events
|
||||
#4、设置追踪函数:
|
||||
$ echo do_sys_open > set_graph_function
|
||||
#5、设置追踪器
|
||||
$ echo function_graph > current_tracer
|
||||
$ echo funcgraph-proc > trace_options
|
||||
#6、开启追踪
|
||||
$ echo 1 > tracing_on
|
||||
#7、执行一个 ls 命令后,再关闭跟踪
|
||||
$ ls
|
||||
$ echo 0 > tracing_on
|
||||
#8、最后一步,查看跟踪结果
|
||||
$ cat trace
|
||||
|
||||
例如,我们上面的代码执行了如下步骤:
|
||||
1 .跟踪了 `do_sys_open` 这个系统函数
|
||||
|
||||
2. 我们设置跟踪器为 `function_graph`
|
||||
3. 开启跟踪
|
||||
4. 执行ls命令,因为该命令会调用 `do_sys_open` 这个系统函数
|
||||
5. 查看跟踪结果是否跟踪到这个函数
|
||||
|
||||

|
||||
|
||||
查看该跟踪结果, 可以查看 执行该命令的CPU, cmd, pid. 执行事件,调用栈。
|
||||
|
||||
从而函数的调用栈和调用时间,可分析出该进程在哪个函数上耗费的时间较多。
|
||||
|
||||
一顿操作下来,是不是感觉有点麻烦?
|
||||
所以,我们后续可以尝试一下 ftrace的命令行版: trace-cmd, 亦或是 集成有 ftrace 的 perf_tools。
|
||||
|
||||
### perf
|
||||
|
||||
perf 这个工具原理比较简单,而且生成的火焰图,可迅速分析 函数的热点, 非常推荐使用,而且perf工具非常强大,如果用的好基本上可以完全满足应用程序的性能分析和调优工作的需求。
|
||||
|
||||
#### 原理
|
||||
|
||||

|
||||
|
||||
原理:**每隔一个固定时间(取决于采样率),看当前是哪个进程、哪个函数**,**然后给对应的进程和函数加一个统计值**,这样就知道CPU有多少时间在某个进程或某个函数上了
|
||||
|
||||
当 80% 的采样都落在 func1时, 我们大概率可以得出: 函数热点在 func1上。
|
||||
|
||||
同时我们也可以得出:**采样率越大,结果越精确**
|
||||
|
||||
**perf top命令:**
|
||||
适合监控整个系统的性能
|
||||
|
||||
$ perf top --call-graph fractal
|
||||
|
||||

|
||||
|
||||
**perf stat命令:**
|
||||
|
||||
比较适合单个程序的性能分析
|
||||
|
||||
`$ sudo perf stat ls -lt`
|
||||
|
||||

|
||||
|
||||
**perf record/report:**
|
||||
record/report 更适合对程序进行更细粒度的分析
|
||||
|
||||
#在当前目录生成perf.data文件
|
||||
|
||||
sudo perf record -a -g -p <pid>
|
||||
|
||||
#结果显示
|
||||
|
||||
sudo perf report
|
||||
|
||||

|
||||
|
||||
可以获取该进程的热点在哪个函数。
|
||||
|
||||
**火焰图:**
|
||||
|
||||
perf 结合 brendangregg 大神开发的 [火焰图工具](https://link.segmentfault.com/?enc=GeoHegINlCXdcGX4KUOaEw%3D%3D.RXciMNuqy7Be9Hdgsh5mmWqMYcMbhITRUqgLxScD%2BF9DyWv4gPZOp1dr%2Bxg6bH93)
|
||||
|
||||
可以在如下链接看看效果:
|
||||
|
||||
[https://www.brendangregg.com/FlameGraphs/example-perf.svg](https://link.segmentfault.com/?enc=R1ZgIG5LgTDCfHRj5lAGYg%3D%3D.RJM2xvK%2B5z1gGxmmCWdIJtJUrthxFAIJ9Xmy6xmhDt%2BUvgVg%2BE8D9yVo6oMnGu2aEzftVXv1TdZwENdwj7YJCw%3D%3D)
|
||||
|
||||
当某一长块占下方长块大部分长度时,该长块所代表的函数就是该进程的cpu热点。
|
||||
|
||||
### bpftrace
|
||||
|
||||
开源并持续更新的仓库,可以看看。
|
||||
[bpftrace github仓库](https://link.segmentfault.com/?enc=DIdHI6Oy2U1SqkLV61Lb0Q%3D%3D.GNfaefztZX%2Fi3g01ChGPqkw%2FVoHWzTcplGYJ75oVQipxaE9xJwqc3Oa4WsblXZN0)
|
||||
|
||||
## 总结
|
||||
|
||||
可以按自己需求选择需要自己需要的工具。
|
||||
|
||||
希望内容可以帮助到一些人。
|
||||
|
||||
参考:
|
||||
[https://leezhenghui.github.io/linux/2019/03/05/exploring-usdt...](https://link.segmentfault.com/?enc=y5fC2NVDakGEtGWSCaOR6w%3D%3D.IMtuAi5iXo2OrNmyhd4ojMAWPsXjs429urlZe9q56v9HHR8G9HKuraMVT%2FXqifCBbxW4BsvPLion7uOVH419BROqYpS5pQHGhnz3ReRy8cA%3D)
|
||||
[https://www.brendangregg.com/index.html](https://link.segmentfault.com/?enc=yUkOSWeJ3X%2Fb%2F8uTB0mMNg%3D%3D.nsqfWFD8kKMzdQu9dKao%2Fuvhn3q%2B5S75iX0mvhAPb%2BLCX00f6%2BInwDU9BomaHuVE)
|
||||
[https://www.brendangregg.com/blog/2015-07-08/choosing-a-linux...](https://link.segmentfault.com/?enc=vzTGAWjOCULAZyajlUctUg%3D%3D.ZXFZAO4i7cr7R%2F4gVXowkNHETTWFCzSvLlPd2Qq1CAS1OwUCj2ktwwoncHFtpS0fddTaNRwakBi%2BS7kT4NYlJKzicwH%2Bb1diE0JeRyDkJew%3D)
|
||||
[https://zhuanlan.zhihu.com/p/672872237](https://link.segmentfault.com/?enc=FTig72OfaU5CkdyGHLCOEA%3D%3D.2uHpKmD6bDeAgu5XKltM0RtD9KB8Wnq96DUCzvsRaNGHmj1IgGNj1fJSTb8kH9gS)
|
||||
|
||||
[linux](https://segmentfault.com/t/linux)
|
||||
@@ -0,0 +1,21 @@
|
||||
flowchart TD
|
||||
A[开始: 在终端输入 sudo nmtui] --> B[nmtui 主菜单]
|
||||
B --> C{选择要执行的操作}
|
||||
|
||||
C -- 最常用 --> D[编辑连接]
|
||||
C --> E[启用连接]
|
||||
C --> F[设置主机名]
|
||||
|
||||
D --> G[选择或添加连接]
|
||||
G --> H{连接类型?}
|
||||
|
||||
H -- 以太网 --> I[配置有线网络<br>设置IP(静态/DHCP), DNS等]
|
||||
H -- Wi-Fi --> J[扫描并选择无线网络<br>输入密码连接]
|
||||
|
||||
I --> K[保存配置并返回]
|
||||
J --> K
|
||||
|
||||
K --> L[可选: 返回主菜单“启用连接”<br>以激活新配置]
|
||||
L --> M[完成退出]
|
||||
E --> M
|
||||
F --> M
|
||||
@@ -0,0 +1,30 @@
|
||||
针对你的需求——网络断开时仍能读写,网络恢复后自动同步——`mount-s3` 本身**无法实现**。它的设计哲学是强一致性,所有操作都依赖与 S3 的实时交互,没有提供参数来调整为“离线优先”模式。
|
||||
|
||||
要实现你想要的效果,需要换用其他专为这种场景设计的工具。
|
||||
|
||||
### 🛠️ 替代方案推荐:rclone
|
||||
|
||||
`rclone` 是目前实现你需求的最佳选择。它是一款功能强大的命令行工具,支持将 S3 挂载为文件系统,并提供了强大的 **VFS(虚拟文件系统)缓存**功能。
|
||||
|
||||
#### 核心配置参数
|
||||
|
||||
通过以下参数,你可以将 `rclone` 配置为“离线优先”模式:
|
||||
|
||||
* **`--vfs-cache-mode full`**:**最关键参数**。它会让所有读写操作都先经过本地缓存。写入时,数据先存本地,稍后再异步上传到 S3;读取时,文件会被缓存到本地供后续离线使用。这能有效隔离网络问题对应用的影响。
|
||||
|
||||
* **`--vfs-cache-max-size`**:设置本地缓存的最大大小,例如 `10G` 或 `500G`。
|
||||
|
||||
* **`--vfs-cache-max-age`**:设置缓存文件的有效期,例如 `24h`。
|
||||
|
||||
* **`--vfs-write-back`**:设置数据在本地缓存后,延迟多久上传到 S3,例如 `5s`。
|
||||
|
||||
* **`--retries` 与 `--low-level-retries`**:设置网络请求失败时的重试次数,例如 `--retries 10 --low-level-retries 20`。
|
||||
|
||||
#### 使用示例
|
||||
|
||||
1. **安装 rclone**:参考 [rclone.org](https://rclone.org/) 官方文档。
|
||||
2. **配置 S3 远程存储**:运行 `rclone config` 按指引添加你的 S3 端点(支持 AWS S3 及所有 S3 兼容服务)。
|
||||
3. **执行挂载命令**:
|
||||
```bash
|
||||
rclone mou可以帮忙输入是吧
|
||||
```
|
||||
@@ -0,0 +1,9 @@
|
||||
vim ./scripts/install.sh
|
||||
:set ff=unix
|
||||
:wq
|
||||
|
||||
|
||||
|
||||
:e ++ff=dos " 强制按 dos 读,让 \r 归入换行符
|
||||
:set ff=unix
|
||||
:wq
|
||||
@@ -0,0 +1,266 @@
|
||||
[SSH](https://zhida.zhihu.com/search?content_id=763139071&content_type=Answer&match_order=1&q=SSH&zhida_source=entity)连服务器跑脚本,网一断任务就没了,这事吃过几次亏之后我开始用[tmux](https://zhida.zhihu.com/search?content_id=763139071&content_type=Answer&match_order=1&q=tmux&zhida_source=entity)。后来发现这东西不止能防断网,还有不少骚操作。
|
||||
|
||||
---
|
||||
|
||||
**1. 断网保命**
|
||||
|
||||
SSH连服务器跑个脚本,网一抖任务就没了。
|
||||
|
||||
tmux解决这个问题:
|
||||
|
||||
```text
|
||||
tmux new -s deploy
|
||||
./deploy.sh
|
||||
# Ctrl+b d 断开
|
||||
```
|
||||
|
||||
任务在服务器上跑着,你断开连接、关电脑、换个地方都行。回来 `tmux a -t deploy` 继续看。
|
||||
|
||||
我有次在高铁上部署,信号断断续续,靠这个救了。不然那个迁移脚本跑一半断了,数据库就成半成品了。
|
||||
|
||||
---
|
||||
|
||||
**2. 一屏多用**
|
||||
|
||||
```text
|
||||
Ctrl+b % # 左右分屏
|
||||
Ctrl+b " # 上下分屏
|
||||
Ctrl+b 方向键 # 切换
|
||||
```
|
||||
|
||||
我日常开发的布局:
|
||||
|
||||
```text
|
||||
┌─────────────────┬─────────────────┐
|
||||
│ │ tail -f log │
|
||||
│ vim/code ├─────────────────┤
|
||||
│ │ shell │
|
||||
└─────────────────┴─────────────────┘
|
||||
```
|
||||
|
||||
左边写代码,右上角看日志,右下角跑命令。一个终端三件事。
|
||||
|
||||
`Ctrl+b z` 可以把当前面板最大化,再按一次恢复。看日志的时候放大看,看完缩回去,不用来回开终端。
|
||||
|
||||
---
|
||||
|
||||
**3. 会话不是一次性的**
|
||||
|
||||
很多人把tmux当成”防断网工具”,用完就kill。
|
||||
|
||||
其实可以给不同项目建不同会话:
|
||||
|
||||
```text
|
||||
tmux new -s project-a
|
||||
tmux new -s project-b
|
||||
tmux new -s server-monitor
|
||||
```
|
||||
|
||||
每个会话保持自己的布局、目录、运行的命令。
|
||||
|
||||
`Ctrl+b s` 可以在会话之间切换,像切换桌面一样。早上来了 `tmux a -t project-a`,下班 `Ctrl+b d`,第二天接着搞。
|
||||
|
||||
---
|
||||
|
||||
**4. 改掉反人类的默认配置**
|
||||
|
||||
tmux默认的 `Ctrl+b` 太难按了,b键离得太远。
|
||||
|
||||
改成 `Ctrl+a`:
|
||||
|
||||
```text
|
||||
# ~/.tmux.conf
|
||||
unbind C-b
|
||||
set -g prefix C-a
|
||||
bind C-a send-prefix
|
||||
```
|
||||
|
||||
分屏的 `%` 和 `"` 也反直觉,改成 `|` 和 `-`:
|
||||
|
||||
```text
|
||||
bind | split-window -h -c "#{pane_current_path}"
|
||||
bind - split-window -v -c "#{pane_current_path}"
|
||||
```
|
||||
|
||||
`-c "#{pane_current_path}"` 是让新分出来的面板保持当前目录,不然每次都从~开始,还得cd。
|
||||
|
||||
鼠标支持默认是关的,开了之后可以点击切换面板、拖拽调整大小、滚轮看历史:
|
||||
|
||||
```text
|
||||
set -g mouse on
|
||||
```
|
||||
|
||||
改完后 `tmux source-file ~/.tmux.conf` 生效。
|
||||
|
||||
---
|
||||
|
||||
**5. vim键位移动**
|
||||
|
||||
如果你用vim,在tmux里也用vim键位会很爽:
|
||||
|
||||
```text
|
||||
# ~/.tmux.conf
|
||||
bind h select-pane -L
|
||||
bind j select-pane -D
|
||||
bind k select-pane -U
|
||||
bind l select-pane -R
|
||||
```
|
||||
|
||||
这样 `Ctrl+a h/j/k/l` 就能上下左右切换面板,不用去够方向键。
|
||||
|
||||
复制模式也改成vi键位:
|
||||
|
||||
```text
|
||||
setw -g mode-keys vi
|
||||
```
|
||||
|
||||
`Ctrl+a [` 进入复制模式后,用 j/k 上下移动,`/` 搜索,空格开始选择,回车复制。
|
||||
|
||||
---
|
||||
|
||||
**6. 同步输入**
|
||||
|
||||
这个很少有人知道:
|
||||
|
||||
```text
|
||||
Ctrl+a :setw synchronize-panes on
|
||||
```
|
||||
|
||||
开了之后,你在一个面板敲的东西会同时出现在所有面板。
|
||||
|
||||
用途:同时操作多台服务器。
|
||||
|
||||
```text
|
||||
# 开四个面板,分别ssh到四台服务器
|
||||
# 然后开启同步输入
|
||||
# 敲一遍命令,四台服务器同时执行
|
||||
```
|
||||
|
||||
批量重启服务、批量改配置,效率翻几倍。
|
||||
|
||||
再敲一遍 `setw synchronize-panes off` 关掉。
|
||||
|
||||
---
|
||||
|
||||
**7. 发送命令到其他面板**
|
||||
|
||||
有时候想在脚本里控制tmux,比如自动化开发环境启动:
|
||||
|
||||
```text
|
||||
#!/bin/bash
|
||||
tmux new-session -d -s dev
|
||||
|
||||
# 第一个面板跑后端
|
||||
tmux send-keys -t dev 'cd ~/project/backend && npm run dev' Enter
|
||||
|
||||
# 分屏,第二个面板跑前端
|
||||
tmux split-window -h -t dev
|
||||
tmux send-keys -t dev 'cd ~/project/frontend && npm run dev' Enter
|
||||
|
||||
# 再分屏,第三个面板开着备用
|
||||
tmux split-window -v -t dev
|
||||
|
||||
tmux attach -t dev
|
||||
```
|
||||
|
||||
每天跑一下这个脚本,开发环境就全起来了,不用手动一个个开。
|
||||
|
||||
---
|
||||
|
||||
**8. 会话持久化**
|
||||
|
||||
tmux的会话在服务器重启后会没。
|
||||
|
||||
装 [tmux-resurrect](https://zhida.zhihu.com/search?content_id=763139071&content_type=Answer&match_order=1&q=tmux-resurrect&zhida_source=entity) 插件可以保存和恢复:
|
||||
|
||||
```text
|
||||
# 装插件管理器
|
||||
git clone https://github.com/tmux-plugins/tpm ~/.tmux/plugins/tpm
|
||||
|
||||
# ~/.tmux.conf 加上
|
||||
set -g @plugin 'tmux-plugins/tpm'
|
||||
set -g @plugin 'tmux-plugins/tmux-resurrect'
|
||||
run '~/.tmux/plugins/tpm/tpm'
|
||||
```
|
||||
|
||||
重载配置,`Ctrl+a I` 安装插件。
|
||||
|
||||
之后 `Ctrl+a Ctrl+s` 保存会话,`Ctrl+a Ctrl+r` 恢复。服务器重启了也能恢复到之前的布局。
|
||||
|
||||
---
|
||||
|
||||
**9. 共享终端**
|
||||
|
||||
两个人可以同时连同一个会话:
|
||||
|
||||
```text
|
||||
# A创建
|
||||
tmux new -s pair
|
||||
|
||||
# B连接
|
||||
tmux a -t pair
|
||||
```
|
||||
|
||||
两个人看到的完全同步,A敲的B能看到,B敲的A也能看到。
|
||||
|
||||
远程带人排查问题、[pair programming](https://zhida.zhihu.com/search?content_id=763139071&content_type=Answer&match_order=1&q=pair+programming&zhida_source=entity)都能用。比共享屏幕流畅,因为只传文字不传画面。
|
||||
|
||||
我带新人排查线上问题就用这个,他在他电脑上操作,我实时看着,随时能接手。如果服务器在内网连不上的话,可以用星空组网之类的工具先把网络打通,然后再共享tmux会话。
|
||||
|
||||
---
|
||||
|
||||
**10. 快速切窗口**
|
||||
|
||||
窗口多了之后,`Ctrl+a n/p` 一个个切太慢。
|
||||
|
||||
`Ctrl+a w` 可以列出所有窗口,上下选择,回车切换。还能预览每个窗口里在跑什么。
|
||||
|
||||
或者直接 `Ctrl+a 数字` 切到对应窗口。但默认窗口编号从0开始,改成从1开始更顺手:
|
||||
|
||||
```text
|
||||
set -g base-index 1
|
||||
setw -g pane-base-index 1
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
最后贴一下我的完整配置,直接抄就能用:
|
||||
|
||||
```text
|
||||
# ~/.tmux.conf
|
||||
|
||||
# 前缀改成Ctrl+a
|
||||
unbind C-b
|
||||
set -g prefix C-a
|
||||
bind C-a send-prefix
|
||||
|
||||
# 鼠标
|
||||
set -g mouse on
|
||||
|
||||
# 历史
|
||||
set -g history-limit 50000
|
||||
|
||||
# 窗口编号从1开始
|
||||
set -g base-index 1
|
||||
setw -g pane-base-index 1
|
||||
set -g renumber-windows on
|
||||
|
||||
# 分屏
|
||||
bind | split-window -h -c "#{pane_current_path}"
|
||||
bind - split-window -v -c "#{pane_current_path}"
|
||||
|
||||
# vim式移动
|
||||
bind h select-pane -L
|
||||
bind j select-pane -D
|
||||
bind k select-pane -U
|
||||
bind l select-pane -R
|
||||
setw -g mode-keys vi
|
||||
|
||||
# 减少延迟
|
||||
set -sg escape-time 0
|
||||
|
||||
# 快速重载
|
||||
bind r source-file ~/.tmux.conf \; display "Reloaded"
|
||||
```
|
||||
|
||||
tmux上手有点门槛,但用熟了真的回不去。现在让我用普通终端开一堆窗口来回切,我会很难受。
|
||||
@@ -0,0 +1,17 @@
|
||||
1、执行更改命令
|
||||
|
||||
sudo tzselect
|
||||
|
||||
- 1.
|
||||
|
||||
依次输入如下数字
|
||||
|
||||

|
||||
|
||||
提示如下信息为更改成功
|
||||
|
||||

|
||||
|
||||
2、创建软连接
|
||||
|
||||
sudo ln -sf /usr/share/zoneinfo/Asia/Shanghai /etc/localtime
|
||||
@@ -0,0 +1,3 @@
|
||||
|
||||
快捷键添加到
|
||||
C:\Users\occul\AppData\Roaming\Microsoft\Windows\Start Menu\Programs
|
||||
@@ -0,0 +1,84 @@
|
||||
错误信息 `QEMU guest agent is not configured` 是因为你使用了 `--quiesce` 参数。该参数要求虚拟机内部必须运行 **QEMU Guest Agent**,并且 libvirt 已经配置好与之通信的通道。`--quiesce` 的作用是在快照前通过 guest agent 暂停虚拟机的文件系统 I/O,以保证快照的数据一致性(尤其对 Windows 系统很重要)。
|
||||
|
||||
---
|
||||
|
||||
## 🎯 镜像管理
|
||||
安装并配置 QEMU Guest Agent(推荐)这是最规范的做法,既能保证快照一致性,又能实现后续更多管理功能(如获取 IP、关机等)。
|
||||
|
||||
#### 1. 下载 virtio-win ISO(如果尚未下载)
|
||||
```bash
|
||||
wget https://fedorapeople.org/groups/virt/virtio-win/direct-downloads/stable-virtio/virtio-win.iso -O /tmp/virtio-win.iso
|
||||
```
|
||||
|
||||
#### 2. 挂载 ISO 到 Windows 虚拟机
|
||||
你可以动态挂载,也可以关机后添加一个光驱设备。这里采用**动态挂载**(虚拟机运行时):
|
||||
```bash
|
||||
cat > /tmp/attach-ga.xml <<EOF
|
||||
<disk type='file' device='cdrom'>
|
||||
<driver name='qemu' type='raw'/>
|
||||
<source file='/tmp/virtio-win.iso'/>
|
||||
<target dev='sdc' bus='sata'/>
|
||||
<readonly/>
|
||||
</disk>
|
||||
EOF
|
||||
|
||||
virsh attach-device win10-ltsc /tmp/attach-ga.xml --live
|
||||
```
|
||||
|
||||
#### 3. 在 Windows 虚拟机内安装 Guest Agent
|
||||
- 打开“此电脑”,找到新出现的虚拟光驱(盘符可能为 D: 或 E:)。
|
||||
- 进入 `guest-agent` 文件夹,双击安装 `qemu-ga-x86_64.msi`(根据系统版本选择)。
|
||||
- 按向导完成安装,**不需要重启**(但后续最好重启一次)。
|
||||
|
||||
#### 4. 配置 libvirt 虚拟机 XML,添加 guest agent 通道
|
||||
如果虚拟机正在运行,可以先关闭(`virsh shutdown win10-ltsc`),然后编辑配置:
|
||||
```bash
|
||||
virsh edit win10-ltsc
|
||||
```
|
||||
在 `<devices>` 段内,添加以下内容:
|
||||
```xml
|
||||
<channel type='unix'>
|
||||
<source mode='bind' path='/var/lib/libvirt/qemu/channel/target/domain-1-win10-ltsc/org.qemu.guest_agent.0'/>
|
||||
<target type='virtio' name='org.qemu.guest_agent.0' state='connected'/>
|
||||
</channel>
|
||||
```
|
||||
保存退出。
|
||||
|
||||
#### 5. 启动虚拟机并验证 guest agent
|
||||
```bash
|
||||
virsh start win10-ltsc
|
||||
# 等待虚拟机启动后,检查 guest agent 是否在线
|
||||
virsh guestinfo win10-ltsc --name
|
||||
```
|
||||
如果返回了主机名,说明 agent 工作正常。
|
||||
|
||||
#### 6. 重新执行快照命令(现在应该成功)
|
||||
```bash
|
||||
virsh snapshot-create-as win10-ltsc win10-clean --disk-only --quiesce
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
### 方案 B:去掉 `--quiesce` 参数(简单但不推荐)
|
||||
如果你不想安装 guest agent,可以放弃数据一致性保证,直接创建快照:
|
||||
```bash
|
||||
virsh snapshot-create-as win10-ltsc win10-clean --disk-only
|
||||
```
|
||||
这样不会报错,但快照时文件系统可能处于不一致状态(尤其当有大量磁盘写入时),恢复后可能触发磁盘检查或数据丢失。**仅建议用于测试或非关键环境**。
|
||||
|
||||
---
|
||||
|
||||
## 📌 补充说明
|
||||
- **快照位置**:即使没有 `--quiesce`,快照数据仍会保存在原始磁盘文件内(内部快照)或生成新文件(外部快照),位置不变。
|
||||
- **外部快照**:如果你想生成独立的快照文件(方便备份),可以指定 `--diskspec` 参数,例如:
|
||||
```bash
|
||||
virsh snapshot-create-as win10-ltsc win10-clean --disk-only --diskspec vda,file=/vm/disk/win10-clean.qcow2
|
||||
```
|
||||
- **恢复快照**:使用 `virsh snapshot-revert win10-ltsc win10-clean`。
|
||||
|
||||
---
|
||||
|
||||
## ✅ 建议
|
||||
如果你打算长期使用快照功能,**请采用方案 A**,配置 guest agent 后快照会更可靠。安装过程不复杂,后续对虚拟机管理也很有帮助。
|
||||
|
||||
如果方案 A 中遇到任何问题(例如 XML 编辑报错),请告诉我具体的错误信息,我会帮你调整。
|
||||
@@ -0,0 +1 @@
|
||||
![[130841-20240504215108564-1504327544.png]]
|
||||
@@ -0,0 +1,4 @@
|
||||
yum install yum --downloadonly --downloaddir=./yum
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,84 @@
|
||||
|
||||
|
||||
`GParted` 是一款适用于 `Linux` 的图形化磁盘分区管理工具,通过它可以便捷地为 `VMware` 中的 `Ubuntu Desktop` 增大磁盘空间。然而你可能正在使用 `Ubuntu Server`,并不想要安装或并不被允许安装图形化界面,本文介绍了如何在不使用 `GParted` 的情况下,通过命令行使用自带的工具为 `VMware` 中的 `Ubuntu Server` 增大磁盘空间。
|
||||
|
||||
> 请注意辨别磁盘空间是真的接近耗尽,而不是在系统安装时只真正使用了大约一半空间。参见 [Ubuntu server 20.04 安装后没有分配全部磁盘空间](https://www.moralok.com/2023/06/24/Ubuntu-server-20-04-not-all-disk-space-was-allocated-after-installation/ "Ubuntu server 20.04 安装后没有分配全部磁盘空间")
|
||||
|
||||
## [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E8%83%8C%E6%99%AF%E4%BB%8B%E7%BB%8D "背景介绍")背景介绍
|
||||
|
||||
环境如下:
|
||||
|
||||
- VMware® Workstation 17 Pro 17.5.0 build-22583795
|
||||
- Ubuntu 20.04.6 LTS (GNU/Linux 5.4.0-169-generic x86_64)
|
||||
|
||||
尽管最初按照心理预期为 `Ubuntu Server` 分配了 `50G` 的磁盘空间,主要用于运行一些 `Docker` 容器,但是不知不觉之间发现磁盘空间的占用率还是上升到了 `90%`。一时之间想不到可以清理什么,决定先增大一些磁盘空间。
|
||||
|
||||
- 使用 `df -h` 命令显示文件系统的总空间和可用空间信息。可知 `/dev/mapper/ubuntu--vg-ubuntu--lv` 已使用 `95%`。
|
||||
|
||||
$ df -h <br>Filesystem Size Used Avail Use% Mounted on <br>udev 7.8G 0 7.8G 0% /dev <br>tmpfs 1.6G 3.0M 1.6G 1% /run <br>/dev/mapper/ubuntu--vg-ubuntu--lv 48G 43G 2.5G 95% / <br>tmpfs 7.8G 0 7.8G 0% /dev/shm <br>tmpfs 5.0M 0 5.0M 0% /run/lock <br>tmpfs 7.8G 0 7.8G 0% /sys/fs/cgroup <br>vmhgfs-fuse 932G 859G 73G 93% /mnt/hgfs <br>/dev/sda2 2.0G 209M 1.6G 12% /boot <br>/dev/loop0 64M 64M 0 100% /snap/core20/2015 <br>/dev/loop1 64M 64M 0 100% /snap/core20/2105 <br>/dev/loop2 41M 41M 0 100% /snap/snapd/20290 <br>/dev/loop3 92M 92M 0 100% /snap/lxd/24061 <br>/dev/loop4 41M 41M 0 100% /snap/snapd/20671 <br>tmpfs 1.6G 0 1.6G 0% /run/user/1000|
|
||||
|
||||
|
||||
## [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E8%A7%A3%E5%86%B3%E6%AD%A5%E9%AA%A4 "解决步骤")解决步骤
|
||||
|
||||
### [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E8%B0%83%E6%95%B4%E8%99%9A%E6%8B%9F%E7%A3%81%E7%9B%98%E5%A4%A7%E5%B0%8F "调整虚拟磁盘大小")调整虚拟磁盘大小
|
||||
|
||||
> 不论如何,需要先修改 `VMware` 的相关设置。
|
||||
|
||||
1. 先将客户机 `Ubuntu server` 关机
|
||||
2. 然后通过“虚拟机设置 -> 硬盘 -> 扩展 -> 最大磁盘大小”将最大虚拟磁盘大小设置为目标值(`50G -> 80G`)
|
||||
3. 根据提示可知,在 `VMware` 中的扩展操作仅增大虚拟磁盘的大小,分区和文件系统的大小不受影响。你必须从客户机操作系统内部对磁盘重新进行分区和扩展文件系统。
|
||||
|
||||
### [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E8%B0%83%E6%95%B4%E5%88%86%E5%8C%BA%E5%A4%A7%E5%B0%8F "调整分区大小")调整分区大小
|
||||
|
||||
#### [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E5%88%86%E5%8C%BA%E7%AE%A1%E7%90%86 "分区管理")分区管理
|
||||
|
||||
1. 使用 `sudo cfdisk` 命令进入分区管理的交互式界面。可知可用空间为新增的 `30G`。
|
||||
2. 使用上下方向键选择准备调整大小的分区 `/dev/sda3`,使用左右方向键选择 `Resize` 操作。
|
||||
3. 输入新的分区大小,默认为原大小加上可用空间大小等于 `78G`。
|
||||
4. 使用左右方向键选择 `Write` 操作,写入修改。然后输入 `yes` 确认。
|
||||
5. 提示分区表已改变。然后使用左右方向键选择 `Quit` 操作,退出分区管理的交互式界面。
|
||||
6. 退出时提示如下。
|
||||
|
||||
$ sudo cfdisk <br>GPT PMBR size mismatch (104857599 != 167772159) will be corrected by write. <br> <br>Syncing disks.|
|
||||
|
||||
|
||||
#### [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E8%B0%83%E6%95%B4%E7%89%A9%E7%90%86%E5%8D%B7%E5%A4%A7%E5%B0%8F "调整物理卷大小")调整物理卷大小
|
||||
|
||||
1. 使用 `sudo pvresize /dev/sda3` 命令调整 `LVM` 中物理卷的大小。
|
||||
|
||||
|$ sudo pvresize /dev/sda3 <br> Physical volume "/dev/sda3" changed <br> 1 physical volume(s) resized or updated / 0 physical volume(s) not resized|
|
||||
|
||||
|
||||
#### [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E8%B0%83%E6%95%B4%E9%80%BB%E8%BE%91%E5%8D%B7%E5%A4%A7%E5%B0%8F "调整逻辑卷大小")调整逻辑卷大小
|
||||
|
||||
1. 使用 `sudo fdisk -l` 命令显示物理卷和逻辑卷的大小差异。在末尾可见 `/dev/sda3` 的大小为 `78G`,`/dev/mapper/ubuntu--vg-ubuntu--lv` 的大小为 `47.102G`。
|
||||
|
||||
$ sudo fdisk -l <br>Disk /dev/loop0: 63.48 MiB, 66547712 bytes, 129976 sectors <br>Units: sectors of 1 * 512 = 512 bytes <br>Sector size (logical/physical): 512 bytes / 512 bytes <br>I/O size (minimum/optimal): 512 bytes / 512 bytes <br> <br> <br>Disk /dev/loop1: 63.93 MiB, 67014656 bytes, 130888 sectors <br>Units: sectors of 1 * 512 = 512 bytes <br>Sector size (logical/physical): 512 bytes / 512 bytes <br>I/O size (minimum/optimal): 512 bytes / 512 bytes <br> <br> <br>Disk /dev/loop2: 40.88 MiB, 42840064 bytes, 83672 sectors <br>Units: sectors of 1 * 512 = 512 bytes <br>Sector size (logical/physical): 512 bytes / 512 bytes <br>I/O size (minimum/optimal): 512 bytes / 512 bytes <br> <br> <br>Disk /dev/loop3: 91.85 MiB, 96292864 bytes, 188072 sectors <br>Units: sectors of 1 * 512 = 512 bytes <br>Sector size (logical/physical): 512 bytes / 512 bytes <br>I/O size (minimum/optimal): 512 bytes / 512 bytes <br> <br> <br>Disk /dev/loop4: 40.44 MiB, 42393600 bytes, 82800 sectors <br>Units: sectors of 1 * 512 = 512 bytes <br>Sector size (logical/physical): 512 bytes / 512 bytes <br>I/O size (minimum/optimal): 512 bytes / 512 bytes <br> <br> <br>Disk /dev/fd0: 1.42 MiB, 1474560 bytes, 2880 sectors <br>Units: sectors of 1 * 512 = 512 bytes <br>Sector size (logical/physical): 512 bytes / 512 bytes <br>I/O size (minimum/optimal): 512 bytes / 512 bytes <br>Disklabel type: dos <br>Disk identifier: 0x90909090 <br> <br>Device Boot Start End Sectors Size Id Type <br>/dev/fd0p1 2425393296 4850786591 2425393296 1.1T 90 unknown <br>/dev/fd0p2 2425393296 4850786591 2425393296 1.1T 90 unknown <br>/dev/fd0p3 2425393296 4850786591 2425393296 1.1T 90 unknown <br>/dev/fd0p4 2425393296 4850786591 2425393296 1.1T 90 unknown <br> <br> <br>Disk /dev/sda: 80 GiB, 85899345920 bytes, 167772160 sectors <br>Disk model: VMware Virtual S <br>Units: sectors of 1 * 512 = 512 bytes <br>Sector size (logical/physical): 512 bytes / 512 bytes <br>I/O size (minimum/optimal): 512 bytes / 512 bytes <br>Disklabel type: gpt <br>Disk identifier: 81C6F71E-C634-49E6-BC3D-9272C86326A4 <br> <br>Device Start End Sectors Size Type <br>/dev/sda1 2048 4095 2048 1M BIOS boot <br>/dev/sda2 4096 4198399 4194304 2G Linux filesystem <br>/dev/sda3 4198400 167772126 163573727 78G Linux filesystem <br> <br> <br>Disk /dev/mapper/ubuntu--vg-ubuntu--lv: 47.102 GiB, 51535413248 bytes, 100655104 sectors <br>Units: sectors of 1 * 512 = 512 bytes <br>Sector size (logical/physical): 512 bytes / 512 bytes <br>I/O size (minimum/optimal): 512 bytes / 512 bytes|
|
||||
|
||||
2. 使用 `sudo lvresize -l +100%FREE /dev/mapper/ubuntu--vg-ubuntu--lv` 命令调整逻辑卷的大小。
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1 <br>2 <br>3|$ sudo lvresize -l +100%FREE /dev/mapper/ubuntu--vg-ubuntu--lv <br> Size of logical volume ubuntu-vg/ubuntu-lv changed from <48.00 GiB (12287 extents) to <78.00 GiB (19967 extents). <br> Logical volume ubuntu-vg/ubuntu-lv successfully resized.|
|
||||
|
||||
|
||||
### [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E8%B0%83%E6%95%B4%E6%96%87%E4%BB%B6%E7%B3%BB%E7%BB%9F%E5%A4%A7%E5%B0%8F "调整文件系统大小")调整文件系统大小
|
||||
|
||||
1. 使用 `sudo resize2fs /dev/mapper/ubuntu--vg-ubuntu--lv` 命令调整文件系统的大小。
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1 <br>2 <br>3 <br>4 <br>5|$ sudo resize2fs /dev/mapper/ubuntu--vg-ubuntu--lv <br>resize2fs 1.45.5 (07-Jan-2020) <br>Filesystem at /dev/mapper/ubuntu--vg-ubuntu--lv is mounted on /; on-line resizing required <br>old_desc_blocks = 6, new_desc_blocks = 10 <br>The filesystem on /dev/mapper/ubuntu--vg-ubuntu--lv is now 20446208 (4k) blocks long.|
|
||||
|
||||
2. 使用 `df -h` 命令显示文件系统的总空间和可用空间信息。确认 `/dev/mapper/ubuntu--vg-ubuntu--lv` 的大小已调整为 `77G`。
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1 <br>2 <br>3 <br>4 <br>5 <br>6 <br>7 <br>8 <br>9 <br>10 <br>11 <br>12 <br>13 <br>14 <br>15 <br>16|$ df -h <br>Filesystem Size Used Avail Use% Mounted on <br>udev 7.8G 0 7.8G 0% /dev <br>tmpfs 1.6G 3.1M 1.6G 1% /run <br>/dev/mapper/ubuntu--vg-ubuntu--lv 77G 43G 31G 59% / <br>tmpfs 7.8G 0 7.8G 0% /dev/shm <br>tmpfs 5.0M 0 5.0M 0% /run/lock <br>tmpfs 7.8G 0 7.8G 0% /sys/fs/cgroup <br>vmhgfs-fuse 932G 859G 73G 93% /mnt/hgfs <br>/dev/sda2 2.0G 209M 1.6G 12% /boot <br>/dev/loop0 64M 64M 0 100% /snap/core20/2015 <br>/dev/loop1 64M 64M 0 100% /snap/core20/2105 <br>/dev/loop2 41M 41M 0 100% /snap/snapd/20290 <br>/dev/loop3 92M 92M 0 100% /snap/lxd/24061 <br>/dev/loop4 41M 41M 0 100% /snap/snapd/20671 <br>tmpfs 1.6G 0 1.6G 0% /run/user/1000|
|
||||
|
||||
|
||||
## [](https://www.moralok.com/2024/01/14/increase-disk-space-of-Ubuntu-server-on-VMware-without-using-GParted/#%E5%8F%82%E8%80%83%E6%96%87%E7%AB%A0 "参考文章")参考文章
|
||||
|
||||
- [Increase disk space on Ubuntu guest VM – no GUI or GParted](https://razvanm.ro/tutorial/increase-disk-space-on-ubuntu-guest-vm-no-gui-or-gparted/#Increase-Physical-Volume)
|
||||
|
||||
[# linux](https://www.moralok.com/tags/linux/) [# ubuntu](https://www.moralok.com/tags/ubuntu/)
|
||||
@@ -0,0 +1,50 @@
|
||||
**glic**是GNU项目的标准C运行库。glibc 是 Linux 系统中最底层的API,几乎其它任何运行库都会依赖于glibc。
|
||||
|
||||
Linux各个发行版都是基于Linux内核的,也就是说理论上某个发行版编译出来的二进制文件在其他Linux发行版都可以运行,但是实际上并非如此,因为动态链接编译出来的可执行文件依赖的库其他系统可能不满足需求(相应的库不存在或者库的版本不满足需求)。
|
||||
|
||||
想要一次编译就能在其他Linux发行版运行,可以以静态链接的方式进行编译,但是大型软件都会依赖很多其他的第三方库,静态链接的方式可能不太现实。
|
||||
|
||||
动态链接的可执行文件在其他系统运行,可能会提示缺少某个动态库或者相应库版本过低,这时能想到的就升级更高版本的库。这种做法很对,但是**千万不要升级glibc,千万不要升级glibc,千万不要升级glibc**,重要的事需要说三遍。
|
||||
|
||||
没有金刚钻就不要升级glibc!因为glibc是系统最基础的C库,几乎所有的运行库都依赖它,特别是系统命令,一旦升级了glibc极有可能会导致很多系统命令都没法正常使用,这个系统基本上就报废了,这是很多Linux小白容易遇到的问题。
|
||||
|
||||
其他依赖的第三方库都可以升级,唯有glibc不建议升级。正确的做法是在同一版本或者更低版本glibc的系统上进行编译可执行文件。
|
||||
|
||||
下表是主流Linux发行版Ubuntu/CentOS/Debian系统默认的glic版本。
|
||||
|
||||
| Ubuntu | Debian | CentOS | Glibc |
|
||||
| :----: | :----: | :----: | :---: |
|
||||
| 24.04 | 13 | | 2.37 |
|
||||
| 22.04 | - | - | 2.34 |
|
||||
| 20.04 | 11 | - | 2.31 |
|
||||
| - | 10 | 8 | 2.28 |
|
||||
| 18.04 | - | - | 2.27 |
|
||||
| - | 9 | - | 2.24 |
|
||||
| 16.04 | - | - | 2.23 |
|
||||
| 14.04 | 8 | - | 2.19 |
|
||||
| 13.04 | - | 7 | 2.17 |
|
||||
| 12.04 | - | - | 2.15 |
|
||||
| - | 7 | - | 2.13 |
|
||||
| - | - | 6 | 2.12 |
|
||||
|
||||
通过上表可以看到 CentOS7 的 glibc 版本为2.17,如果使用 CentOS7 系统编译的可执行文件,就可以在 Ubuntu13.04 以及更新版本和 Debian8 及更新版本上运行。
|
||||
|
||||
查看Linux系统glibc版本有多种方法:
|
||||
|
||||
**方法1**
|
||||
|
||||
sh
|
||||
|
||||
| | |
|
||||
| --- | ------------- |
|
||||
| 1 | ldd --version |
|
||||
|
||||
**方法2**
|
||||
|
||||
sh
|
||||
|
||||
| | |
|
||||
|---|---|
|
||||
|1 <br>2 <br>3 <br>4 <br>5 <br>6 <br>7 <br>8|# 查询libc.so位置 <br>find / -name libc.so.6 <br> <br># libc.so也是可执行文件,直接运行 <br>/xxxx/libc.so.6 <br> <br># 或者查看符号 <br>strings libc.so.6 \| grep GLIBC|
|
||||
|
||||
------ 本文结束,感谢您的阅读 ------
|
||||
@@ -0,0 +1,223 @@
|
||||
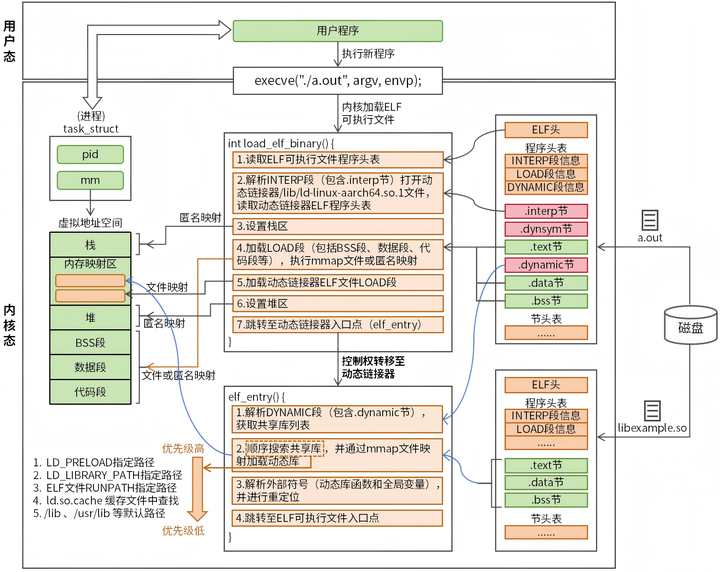
|
||||
|
||||
大家好,这里是物联网心球。
|
||||
|
||||
说到Linux动态库(.so文件)大家并不陌生,我想每个Linux开发者都应该使用过Linux动态库。动态库的使用其实并不简单,我们平时习以为常的动态库操作背后都隐藏了哪些秘密?本文我们一一来揭晓。
|
||||
|
||||
## 1.测试项目简介
|
||||
|
||||
学习Linux动态库时,最好先准备一个实际的测试项目,边调试边学习,这样才能够做到深入理解。笔者使用的测试项目目录结构如图1所示。
|
||||
|
||||

|
||||
|
||||
图1 测试项目目录结构
|
||||
|
||||
example.c和example.h文件将被编译为libexample.so动态库文件,example.c文件中定义了两个函数(hello函数和add函数)以及一个全局变量global。
|
||||
|
||||
main.c文件将被编译成可执行文件,main函数调用hello和add函数,并将global变量重新赋值。可执行文件编译的过程需要链接libexample.so动态库文件。
|
||||
|
||||
## 2.动态库文件
|
||||
|
||||
动态库文件是在程序运行时才被加载和链接的共享代码模块。Linux系统中通常以 .so (Shared Object) 结尾,例如 libm.so(数学库)、libc.so(C标准库)。
|
||||
|
||||
动态库文件有以下几大特点:
|
||||
|
||||
- 代码共享:多个程序可以共享同一份动态库代码,节省磁盘空间和内存资源。
|
||||
- 运行时加载:动态库在程序运行时才被加载到内存。
|
||||
- 位置无关代码(PIC):动态库可加载到不同的内存地址,避免地址冲突。
|
||||
|
||||
动态库文件其实并不神秘,它也是一种ELF文件。ELF文件基础介绍请参考我的这篇文章:[从ELF文件到Linux进程](https://link.zhihu.com/?target=https%3A//mp.weixin.qq.com/s%3F__biz%3DMzkyNDIyNzU4Mg%3D%3D%26mid%3D2247486346%26idx%3D1%26sn%3Dffd28a5045068754285b41a3ab42b90a%26scene%3D21%23wechat_redirect)。
|
||||
|
||||
动态库文件ELF格式如图2所示。
|
||||
|
||||
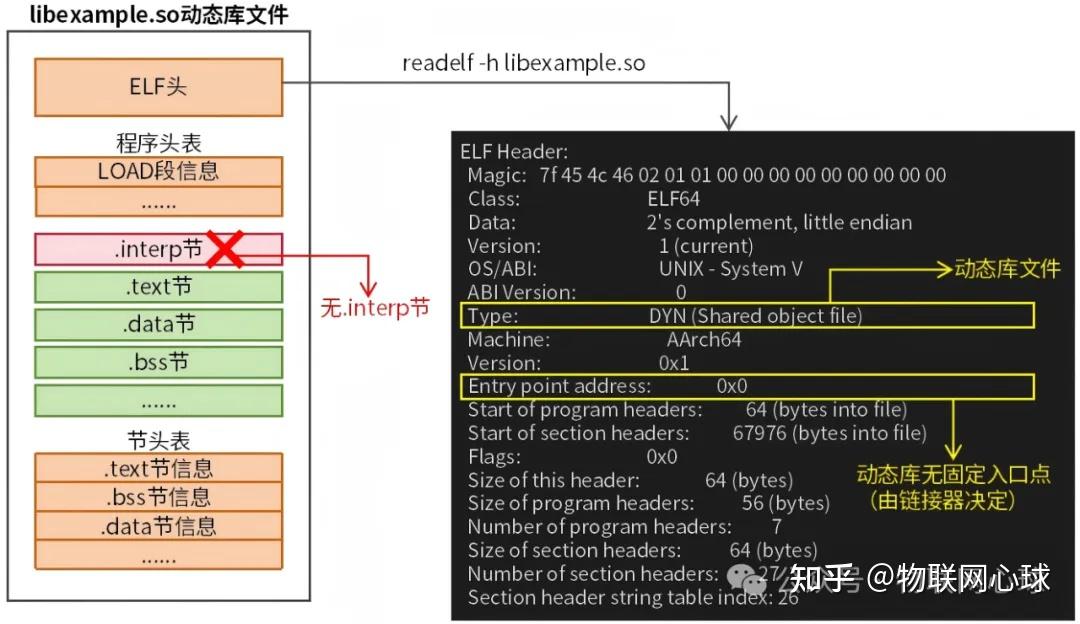
|
||||
|
||||
图2 动态库文件ELF格式
|
||||
|
||||
通过 readelf -h 动态库文件 命令查看ELF文件头,可以看到动态库文件类型是DYN(Shared object file)。DYN(Shared object file)表示文件包含位置无关代码(通过gcc -fPIC编译)。
|
||||
|
||||
动态库文件的程序入口点(Entry point address)为0,表示动态库不是独立程序,没有自己的入口点,这点和可执行文件不同。
|
||||
|
||||
动态库文件无INTERP段(不指定动态链接器路径),动态库的主要功能是提供函数和数据供其他程序调用,而不是独立运行。因此,动态库不需要指定动态链接器的路径。
|
||||
|
||||
除了以上几个点,动态库ELF文件和可执行ELF文件并没有很大的区别。
|
||||
## 3.编译和链接阶段
|
||||
|
||||
动态库的编译必须要加上-fPIC编译选项,-fPIC选项告诉编译器生成位置无关代码,命令如下:
|
||||
|
||||
```c
|
||||
gcc -fPIC -shared -o libexample.so example.c
|
||||
```
|
||||
|
||||
编译可执行ELF文件链接动态库示例命令如下:
|
||||
|
||||
```text
|
||||
gcc main.c -o a.out -I. -L. -lexample -Wl,-rpath='$ORIGIN':/opt
|
||||
```
|
||||
|
||||
- -L选项:用于编译时指定动态库搜索路径。
|
||||
- -l选项:用于编译时指定动态库文件名(去掉lib前缀和扩展名)。
|
||||
- -Wl,-rpath选项:用于向可执行文件中嵌入一个运行时搜索路径(Runpath)。
|
||||
|
||||
编译完后,可执行文件(a.out)ELF格式如图3所示。
|
||||
|
||||
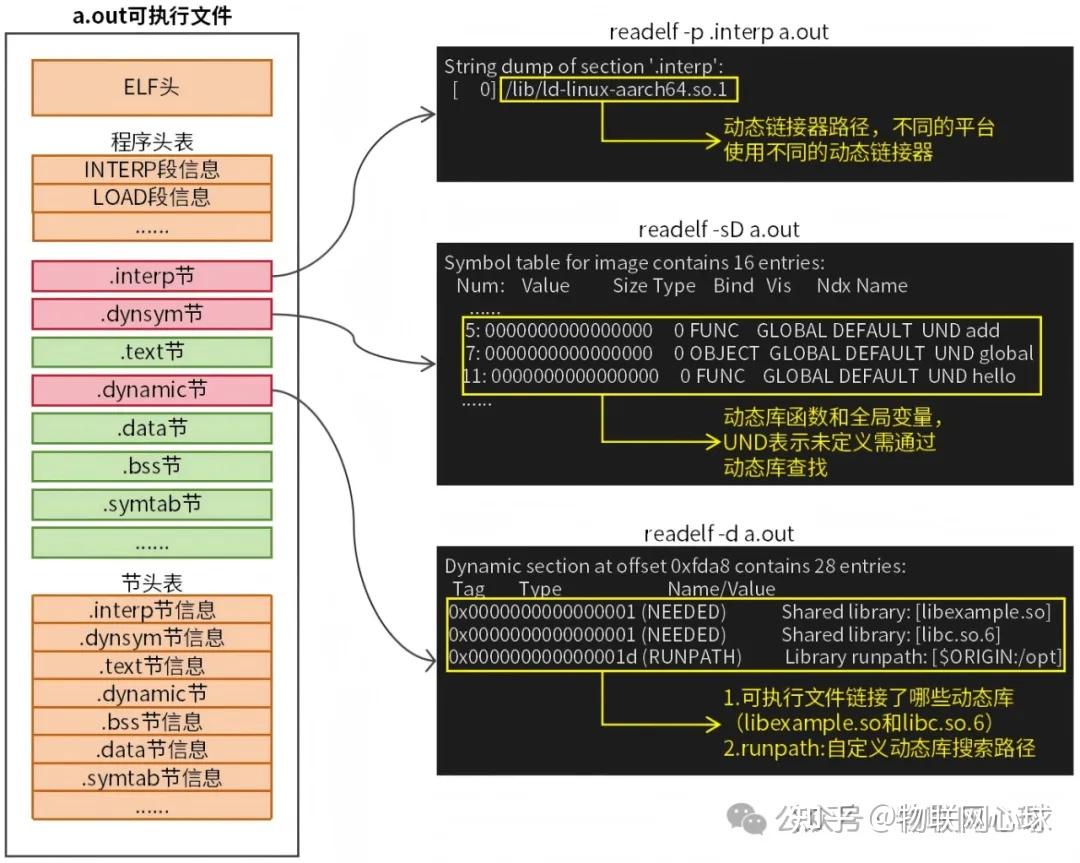
|
||||
|
||||
图3 可执行文件ELF格式
|
||||
|
||||
可执行文件如果链接了动态库,ELF文件中会有几个特殊的节:.interp节、.dynsym节、dynamic节。
|
||||
|
||||
**(1) .interp节**
|
||||
|
||||
.interp节是一个包含动态链接器路径的节,用于指定可执行文件运行时使用哪个动态链接器来加载和解析动态库。
|
||||
|
||||
通过 readelf -d 可执行文件 命令可以查看.interp节信息,输出示例如下:
|
||||
|
||||
```c
|
||||
# readelf -p .interp a.out
|
||||
String dump of section '.interp':
|
||||
[ 0] /lib/ld-linux-aarch64.so.1
|
||||
```
|
||||
|
||||
/lib/ld-linux-aarch64.so.1为动态链接器路径,当操作系统启动一个可执行文件时,它会读取.interp节中的路径,找到并加载指定的动态链接器。
|
||||
|
||||
注意:动态链接器也是一个动态库,负责在程序运行时加载和解析动态库,并将动态库定义的符号(函数和变量)绑定到程序中。
|
||||
|
||||
**(2).dynsym节**
|
||||
|
||||
.dynsym节是 ELF 文件中的动态符号表,它包含了动态链接时所需的符号信息。这些符号通常是全局变量和函数,它们在程序运行时被动态加载和解析。
|
||||
|
||||
通过 readelf -sD 可执行文件 命令可以查看.dynsym节,输出示例如下:
|
||||
|
||||
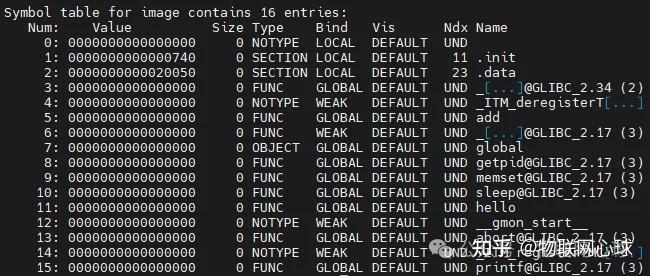
|
||||
|
||||
相关字段解析如下:
|
||||
|
||||
- Num:符号表中的条目编号。
|
||||
- Value:符号的地址或值。对于已定义符号,这通常是一个虚拟地址;对于未定义的符号(如UND),该值为0。
|
||||
- Size:符号的大小,以字节为单位。函数的大小是其指令长度,变量的大小是其占用的字节数。如果大小为0,通常表示该符号的大小未知或不是数据对象(如节名或未定义符号)。
|
||||
- Type:符号的类型,常见的类型有:
|
||||
|
||||
1. NOTYPE:类型未指定。
|
||||
2. SECTION:该符号关联到一个节。
|
||||
3. FUNC:表示是一个函数。
|
||||
4. OBJECT:表示是一个数据对象。
|
||||
|
||||
- Bind:符号的绑定属性,表示符号的可见范围,常见的绑定属性有:
|
||||
- LOCAL:局部符号,只在当前目标文件内可见。
|
||||
- GLOBAL:全局符号,可被其他目标文件引用。
|
||||
- WEAK:弱符号,类似于全局符号,但优先级较低。如果存在同名的全局符号,则全局符号优先;如果没有全局符号,则使用弱符号。
|
||||
- Vis:符号的可见性,常见类型如下:
|
||||
|
||||
1. DEFAULT:默认可见性,符号可以被其他模块引用。
|
||||
2. HIDDEN:符号在模块外不可见。
|
||||
3. INTERNAL:内部可见性。
|
||||
4. PROTECTED:受保护的,该符号在模块外可见,但不可被覆盖(即不能重定位)。
|
||||
|
||||
- Ndx:符号所在的节的索引,其中:
|
||||
|
||||
1. 数字:对应节的索引。
|
||||
2. UND:未定义符号(需动态链接)。
|
||||
3. ABS:绝对值符号。
|
||||
|
||||
- Name:符号的名称及版本信息。
|
||||
|
||||
**(3).dynamic节**
|
||||
|
||||
.dynamic节用于存储动态链接器在运行时需要的信息,包括动态库依赖关系、动态库搜索路径、节的位置等。
|
||||
|
||||
通过 readelf -d 可执行文件 命令可以查看.dynamic节,输出示例如下:
|
||||
|
||||
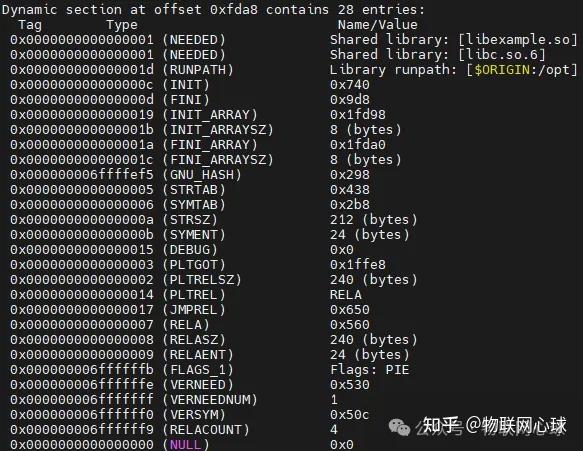
|
||||
|
||||
.dynamic节中的信息比较多,我们只需要关注和本文相关的信息。
|
||||
|
||||
NEEDED指的是程序运行时需要加载的动态库,如测试项目中,可执行文件依赖libexample.so库和libc.so.6库(C标准库)。
|
||||
|
||||
RUNPATH指运行时库搜索路径,优先级低于LD_LIBRARY_PATH,高于系统默认路径,$ORIGIN表示可执行文件所在目录,多个路径通过冒号分隔。
|
||||
|
||||
## 4.运行时动态链接阶段
|
||||
|
||||
当一个可执行文件链接了动态库,系统启动可执行程序时,除了要加载可执行文件的LOAD段(包括:.interp、.dynsym、.text、.dynamic、.data、.bss等节),同时也需要通过动态连接器加载动态库文件的LOAD段,这个过程比较复杂,我们通过图4来讲解。
|
||||
|
||||
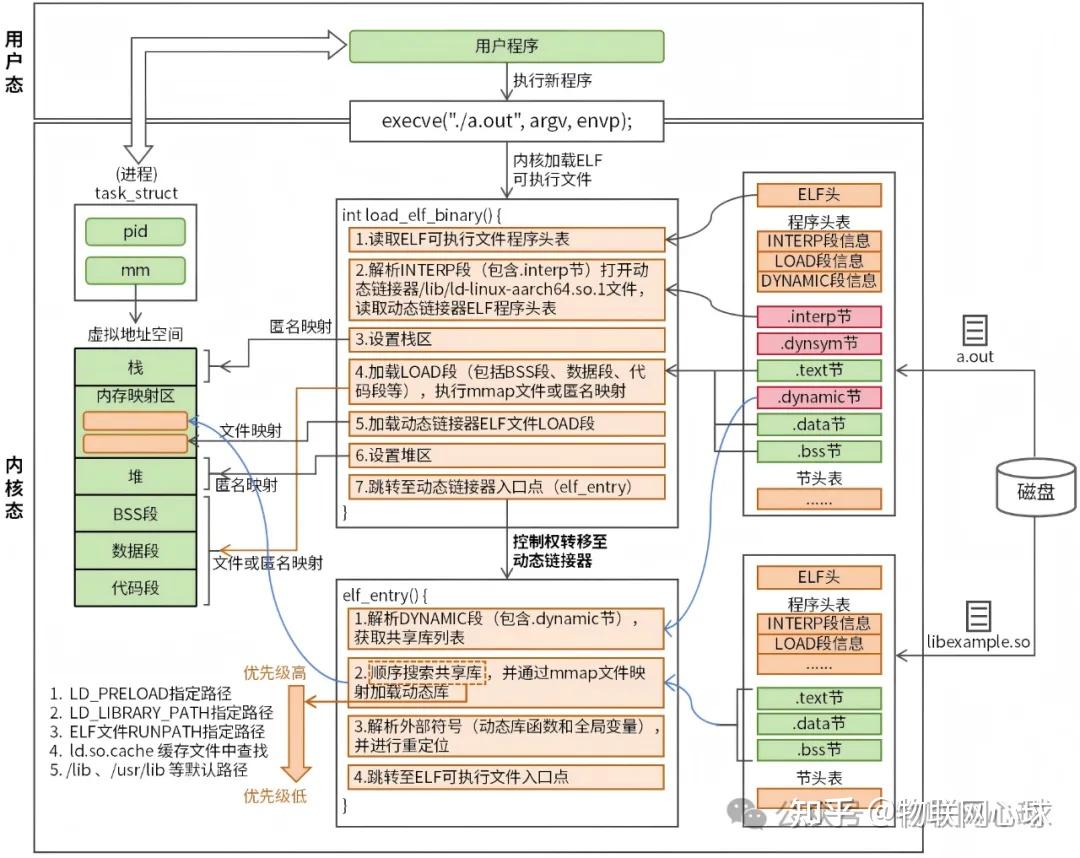
|
||||
|
||||
图4 运行时动态连接阶段
|
||||
|
||||
可执行文件的加载过程是本文的重点,了解了这个过程,就会深入理解动态库。
|
||||
|
||||
用户程序想要执行新代码,需要调用execve系统调用(或execve家族函数)来加载可执行文件。execve会用新程序的代码、数据、堆和栈来替换当前进程的虚拟地址空间的内容,并执行新程序。
|
||||
|
||||
要想知道内核是如何加载ELF文件的,就要搞清楚execve的工作流程。execve加载ELF文件的主要流程在load_elf_binary函数中实现,该函数主要做了两件事情:加载可执行文件和加载动态库文件。
|
||||
|
||||
### 4.1 加载可执行文件
|
||||
|
||||
加载可执行文件具体步骤如下。
|
||||
|
||||
**(1)加载程序头表**
|
||||
|
||||
程序头表每个条目都是一个段(如INTERP段、LOAD段等),内核通过解析段将ELF文件相关数据加载至内存,所以加载程序头表是加载ELF文件的第一步。
|
||||
|
||||
**(2)解析INTERP段**
|
||||
|
||||
INTERP段只包含一个节(.interp节),前面介绍过.interp节中存储的是动态链接器路径(如 /lib/ld-linux-aarch64.so.1)。解析INTERP段的目的是加载动态链接器,为后续加载动态库文件做准备。
|
||||
|
||||
**(3)设置栈区**
|
||||
|
||||
执行新程序,需要重新设置栈区,保证新程序有正确的执行环境。
|
||||
|
||||
**(4)加载LOAD段**
|
||||
|
||||
LOAD段记录的是需要加载进内存的节(如.text、.data、.bss等)。内核会通过mmap文件或匿名映射将可执行文件的LOAD段加载至内存。
|
||||
|
||||
**(5)加载动态链接器LOAD段**
|
||||
|
||||
为了确保动态链接器能够正常启动,通常需要将动态链接器通过mmap文件映射方式映射至内存(内存映射区)。动态链接器也是动态库,加载其LOAD段即可。
|
||||
|
||||
**(6)设置堆区**
|
||||
|
||||
同栈区。
|
||||
|
||||
**(7)跳转至动态链接器入口点**
|
||||
|
||||
完成以上工作后,可执行文件已经被加载至内存。接下来是加载动态库,动态库的加载工作由动态链接器完成,所以需要跳转至动态库链接器入口点启动动态链接器。
|
||||
|
||||
### 4.2 加载动态库
|
||||
|
||||
程序控制权转移至动态链接器后,动态链接器开始加载可执行文件依赖的动态库,具体步骤如下。
|
||||
|
||||
**(1)解析ELF可执行文件DYNAMIC段**
|
||||
|
||||
可执行文件DYNAMIC段同样只包含一个节(.dynamic),该节记录了可执行文件依赖的动态库路径以及自定义动态库搜索路径(RUNPATH)。
|
||||
|
||||
**(2)顺序搜索动态库**
|
||||
|
||||
根据DYNAMIC段提供的信息,动态链接器将在指定的路径下搜索动态库。按照优先级从高到低的顺序,动态库搜索路径排序如下:
|
||||
|
||||
- LD_PRELOAD指定路径。
|
||||
- LD_LIBRARY_PATH指定路径。
|
||||
- ELF文件RUNPATH指定路径。
|
||||
- ld.so.cache 缓存文件中查找。
|
||||
- /lib 、/usr/lib 等默认路径。
|
||||
|
||||
只要我们编译的动态库处于以上几种方式指定的路径中,就能够被动态链接器搜索到,也就能够正确解析动态库符号。
|
||||
|
||||
这里我们看到了几个熟悉的身影(如:LD_LIBRARY_PATH、/lib、/usr/lib等),我们平时做软件开发时经过会用到它们,但很少关注其底层原理和作用。通过本文的学习,我们就能够彻底搞懂这些基础知识了。
|
||||
|
||||
搜索到动态库后,我们需要解析动态库,并将其LOAD段通过mmap方式加载至内存(内存映射区)。
|
||||
|
||||
**(3)外部符号重定位**
|
||||
|
||||
所谓外部符号是指ELF可执行文件.dynsym节中未定义(UND)的符号,这些符号通常在动态库中定义。动态库文件中定义的是位置无关代码(-fPIC),这些代码只有相对地址,没有绑定实际虚拟地址,需要由动态链接器进行重定位绑定实际虚拟地址,才能够正常调用。
|
||||
|
||||
**(4)跳转至ELF可执行程序入口点**
|
||||
|
||||
动态链接器完成全部工作后,程序会跳转至ELF可执行程序入口点,开始执行新程序。这样链接了动态库的可执行文件就加载完毕了。
|
||||
|
||||
最后,我们通过 cat /proc/<pid>/maps 命令查看进程虚拟地址空间内存布局,来验证上述的理论知识,输出示例如下:
|
||||
|
||||
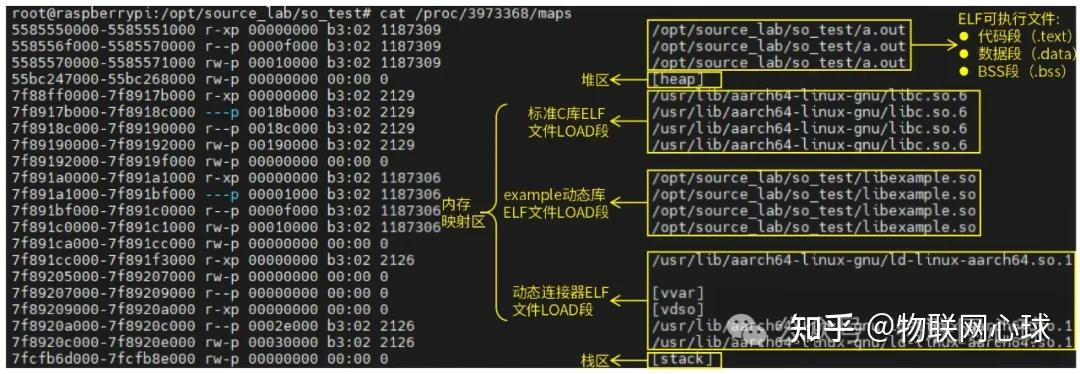
|
||||
|
||||
## 总结:
|
||||
|
||||
动态库是Linux一个非常重要的知识点,通过本文我们能够深入理解动态库底层实现原理,从而能够更高效地使用动态库。
|
||||
@@ -0,0 +1,9 @@
|
||||
#### Windows **Process Monitor (ProcMon)**: 这是一个高级的 Windows 系统监控工具,可以实时显示文件系统活动。你可以使用它来监控特定程序的文件访问情况。
|
||||
- 下载并运行 Process Monitor。
|
||||
- 设置过滤器,只显示你感兴趣的程序活动。
|
||||
- 运行程序并观察 Process Monitor 中的活动。
|
||||
|
||||
|
||||
#### Linux **inotify**: 这是 Linux 内核中的一个文件系统监控机制,可以监控文件系统上的各种事件。可以使用 `inotifywait` 命令来监控文件变化。
|
||||
- 安装 `inotify-tools` 包。
|
||||
- 使用 `inotifywait` 命令来监控特定目录的文件变化。例如:`inotifywait -m /path/to/directory`
|
||||
@@ -0,0 +1,137 @@
|
||||
下面这张图,看懂了能让你节约10年左右时间。因为我是用了大概十年时间才总结出的。
|
||||
|
||||
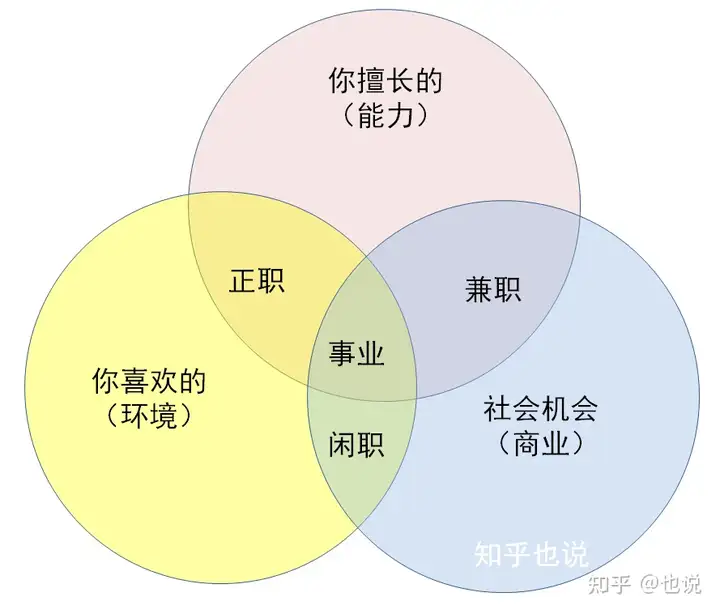
|
||||
|
||||
有点复杂,没关系,我带着你来做一遍,用三分钟给自己列一个人生理想职业的规划。
|
||||
|
||||
**首先,你要考虑你擅长________能力。**
|
||||
|
||||
注意,这个不是职业,不是工种,是**“能力**”,比如说“计算”、“沟通”、“[逻辑推理](https://www.zhihu.com/search?q=%E9%80%BB%E8%BE%91%E6%8E%A8%E7%90%86&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D)”、“写作”、“创意”、“精细重复的检查”等等。
|
||||
|
||||
可以多列几种,从你认为最强的,从小大家都夸奖你的开始,老师经常在个人评价里面写赞扬的那些话。
|
||||
|
||||
**注意,这个能力,未必是你喜欢的。但必须是你擅长的。**
|
||||
|
||||
比如说你其实挺讨厌和陌生人打交道的,但是往往凭借情商能很快赢得陌生人好感。但心里可以是厌恶这种无用社交的。
|
||||
|
||||
能力往往代表一个人的**天赋**,作为你的职业将是非常轻松的,但未必热爱它。
|
||||
|
||||
你可以有目的的去强化你的能力,包括用PS,写字漂亮等等, 都可以算。每个人一般不止一种。
|
||||
|
||||
**第二步,考虑你喜欢在________的环境下。**
|
||||
|
||||
这个环境,可以稍微宽泛一些,比如“自己一个人能独处的”、“热闹充满商业气息的”、“高档时尚大家都正装领带的”、“艺术感十足的”、“国外的”、“人均素质很高的”等等。
|
||||
|
||||
我们真正喜欢的,往往不是“工种”本身,而是某种“环境”。你可以在这种气氛中非常的满足,继而产生归属感和成就感。
|
||||
|
||||
这里甚至可以填“家中”,但不能写“慵懒不用努力的”这样的条件,因为不管任何你喜欢或不喜欢的工作内容,最后都是需要努力的,区别只是努力的过程能不能带来成就感。
|
||||
|
||||
你也可以写下来不止一种,比如农村自然的、家里独处的、和动物一起的等等。
|
||||
|
||||
**第三步,不是写最后一块“商业机会”,而是先找一和二的重合部分。**
|
||||
|
||||
目的是,看看能诞生什么职业,我把这类职业叫做**“正职”。**也就是比较正式的日常职业。
|
||||
|
||||
这里你可以做一下连连看,把左边的能力和右边的环境试着建立下联系,职业写在中间。
|
||||
|
||||
比如:
|
||||
|
||||
|
||||
|
||||
### **在正职了解一个行业后,你可以写下自己感觉到的机会**
|
||||
|
||||
这个“机会”可以是你洞察到的趋势,观察到的需求,人脉带来的渠道等等。
|
||||
|
||||
这个比较宽泛,未必能直接写下来,更多是敏锐洞察到,然后和你的“能力”,融合在一起,就变成“**兼职**”或者收入的机会。
|
||||
|
||||
举个例子:
|
||||
|
||||
|
||||
|
||||
### 而在你的收入达到一定水平,可以财务自由或不用生计发愁时,可以考虑“闲职”。
|
||||
|
||||
这个词也是我放了个相对合适的,可以理解为“**不以收入为第一目的的职业**”。
|
||||
|
||||
有点像“**[提前退休](https://www.zhihu.com/search?q=%E6%8F%90%E5%89%8D%E9%80%80%E4%BC%91&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D)后自娱自乐的职业**”。带来成就感和取悦自己为第一目的,收入反而无所谓。
|
||||
|
||||
它一般是在你喜欢的“**环境**”下,从事有一定挑战且流行的“**机会**”[性工作](https://www.zhihu.com/search?q=%E6%80%A7%E5%B7%A5%E4%BD%9C&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D)。
|
||||
|
||||
比如:
|
||||
|
||||
大家都在做“短视频(机会)”,你自己喜欢“西餐厅(环境爱好)”,于是开始录制“探访西餐厅的视频(闲职)”,不在乎有多少人打赏,也不指着它吃饭,就是做喜欢的事情。
|
||||
|
||||
再比如:
|
||||
|
||||
你平时是职业的会计师,但喜欢和朋友们聚会喝啤酒(环境爱好),正好有朋友能提供一个不要钱的场地(机会),你和几个朋友开了个酒吧([闲职](https://www.zhihu.com/search?q=%E9%97%B2%E8%81%8C&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D)),基本不赚钱但大家多了个聚会的场所。
|
||||
|
||||
### **注意,要分清“正职”、“兼职”和“闲职”的区别。**
|
||||
|
||||
- 正职,一定要是你擅长的,甚至未必喜欢,但能确保养活自己,稳定挣到收入。
|
||||
- 兼职,一般是伴随机会的,挣的很多是投机收入,未必长久,但尽量擅长否则可能赔钱。
|
||||
- 闲职,要明白未必能带来收益,更多是满足自己爱好,但如果做的好也能变成兼职。
|
||||
|
||||
### 不管从哪项出发,如果未来能找到三者的同时满足,那么恭喜你,就找到自己的事业了。
|
||||
|
||||
所谓“事业”就是能给自己干,不辞辛苦、乐在其中、有不错的收益,还能有长远发展的。
|
||||
|
||||
它需要你首先爱这份工作,然后熟悉且擅长,最好有很不错的机会或者未来前景,才可能挣钱,给自己带来金钱和成就感的两方面满足效果。
|
||||
|
||||
大部分在23岁毕业,都是先找到能满足一方面的工作——或者是擅长,或者喜欢的环境。
|
||||
|
||||
之后在行业熟悉两三年,可以洞察一些机会,跳到“擅长+机会”的工作,有一份收入不错的正职或兼职。
|
||||
|
||||
还有一些家庭经济比较好,不担心收入的人,则是选择“喜欢的环境+擅长“的工作,比如比较有面子的工作,或者比较轻松的环境。
|
||||
|
||||
### 30岁的时候,可能你会面临一次“创业”或者“继续打工”的选择。
|
||||
|
||||
不管哪一种,到了30岁,你应该明白自己“**擅长**”什么,了解到所在行业有什么“**机会**”。这个时候往往需要你做一个选择——是不是能走出舒适的“**环境**”。
|
||||
|
||||
- 不愿意走出来的,放弃机会,依旧选择舒适环境下的安逸正职。
|
||||
- 尝试着走出来的,放弃掉一些舒适,看看能不能抓住机会多个收入的兼职。
|
||||
- 还有一些喜欢迎接挑战,或者很幸运喜欢新机会的新环境的,直接辞职去创业。
|
||||
|
||||
比如之前的旅游热,让很多人看到机会,又喜欢山野的环境,直接放弃工作开民俗。利用自己擅长的写作、摄影、视频做[营销推广](https://www.zhihu.com/search?q=%E8%90%A5%E9%94%80%E6%8E%A8%E5%B9%BF&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D),成功实现了想创业的梦想。
|
||||
|
||||
但注意,创业的第一前提不是喜欢,而是收入,能给你稳定来带收入的才叫“事业”,否则这是一个爱好,或者“闲职”罢了。
|
||||
|
||||
### 什么样的“能力”是需要始终保持的。
|
||||
|
||||
而如果你选择了“闲职”,也就是不追求收入,也要做自己喜欢的事情。那么一定要保留一种擅长并能获得收入的能力。因为你不知道什么时候会突然需要用钱,之前攒的钱很可能不够。
|
||||
|
||||
这就要求你或者有一些不因为时间被脱节的技能,或者能通过资本的管理不断获得收入的投资。
|
||||
|
||||
最好的技能是脱离了大体系,依然可以依靠自己或平台带来收入的能力。
|
||||
|
||||
举例:比如“行政运营”或“[产品规划](https://www.zhihu.com/search?q=%E4%BA%A7%E5%93%81%E8%A7%84%E5%88%92&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D)”,严格说就不是一种好的能力,因为必须在公司体系内才能发挥作用变成收入。
|
||||
|
||||
而“**摄影**”或者“**绘画**”相对就好很多,因为哪怕离开了大企业,它依旧能通过个人的关系网或者平台给自己带来收入,且不易因为时间而变得落伍,贬值。
|
||||
|
||||
我们一般把前者称为“**[岗位技能](https://www.zhihu.com/search?q=%E5%B2%97%E4%BD%8D%E6%8A%80%E8%83%BD&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D)**“或“**管理能力**”,后者则称为“**[专业技能](https://www.zhihu.com/search?q=%E4%B8%93%E4%B8%9A%E6%8A%80%E8%83%BD&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D)**”或“**个人能力**”。
|
||||
|
||||
请记住,如果有时间和有选择时,尽可能多学习后种能力,因为它是可以陪伴你哪怕离开了当前集体,依旧发挥大部分作用,且会随着你的熟练度不断提升带来更高收入的。
|
||||
|
||||
而前者,往往要依靠这些能力帮组织实现了增长目标,得到认可后才能间接给自己带来收入。甚至因为现代企业的增长是一个分工细化的集体项目,有可能你完成的很好,依旧无法实现目标。
|
||||
|
||||
当然,这类知识,往往企业会更愿意给予培训的机会,所以在工作上如果有机会由企业买单去学习,当然也不可放过。
|
||||
|
||||
这两种知识和技能都可以归结为“对自己未来有意义”的准备。
|
||||
|
||||
而所谓的“机会”或“人脉(也算一种机会)”,则不是刻意追求的,当你随着能力和职位变化,对别人足够有用时,往往水到渠成,比年轻时刻意追求效果还要更好。
|
||||
|
||||
### 最后,并不是“有事业”才是唯一的正确答案
|
||||
|
||||
虽然,“事业”是前面图中三者的共同核心,好像能同时满足三者,但遵从本心的生活比“成功”有时候更重要。
|
||||
|
||||
如果你就希望平静、悠闲的日子,那么一份“**闲职+兼职**”可能反而让不少有事业的老板都要羡慕。因为随时可以决定自己的日程规划。
|
||||
|
||||
甚至不少年轻人就喜欢和父母一样,在一个稳定的单位做一份稳定的工作,赚取不多但够全家用的薪水,平静的过一生,这也很好。没有很多烦恼和压力。
|
||||
|
||||
我们每个人都有自己的人生目标,随时改变都不晚,没有一定的对错。
|
||||
|
||||
在人生的三种能力中“**内心强大的能力**”和“**让技能变强的能力**”、“**抓住机会的能力**”一样重要。
|
||||
|
||||
只要能顺从本心,过自己想要的生活,不用管别人的价值观和声音,甚至其实某种意义上这才是“**成功的[人生规划](https://www.zhihu.com/search?q=%E4%BA%BA%E7%94%9F%E8%A7%84%E5%88%92&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra=%7B%22sourceType%22%3A%22answer%22%2C%22sourceId%22%3A2672454360%7D)**”,按照自己想要的方式生活。
|
||||
|
||||
甚至对很多人,年纪越大才越明白能“想做什么就能做什么”未必是最好的,“不想做什么就不做什么”,才是一种真正的自由和强大。
|
||||
|
||||
|
||||
@@ -0,0 +1,29 @@
|
||||
方法:反问
|
||||
问什么:
|
||||
- 确认对方意图
|
||||
有人问:“你都三十多了,怎么还没结婚?”
|
||||
|
||||
老实人:“因为忙……”(陷入自证)
|
||||
|
||||
高手反问:“你是对我的感情生活感兴趣,还是手头有合适的人想介绍给我?”
|
||||
|
||||
这样一问,你争取了思考时间,同时理清了对方是单纯八卦还是真好心。你的回答将更有针对性,而不是被动挨打,扭扭捏捏地说,“还没找到合适的。”
|
||||
|
||||
|
||||
- 确认对方感受
|
||||
伴侣突然发难:“你为什么对我这么冷淡?”
|
||||
|
||||
老实人:“我哪有冷淡,我刚下班……”(开始吵架)
|
||||
|
||||
高手反问:“亲爱的,你是觉得我最近太忙了没时间陪你,还是说在哪件具体的事上让你感到被冷落了?”
|
||||
|
||||
|
||||
|
||||
- 确认对方立场
|
||||
客户刁难:“你这个方案为什么这么设计?不是有更好的方案吗?”
|
||||
|
||||
老实人:“因为这个质量好……”(苍白的辩解)
|
||||
|
||||
高手反问:“您现在是更关心初期的投入成本,还是更想了解方案长期的可行性和回报率?”
|
||||
|
||||
这个反问让你明确了对方关心的核心是什么。是想省钱,还是想要效果?摸清了底牌,你的下一个回答就能俘获对方的心。
|
||||
@@ -0,0 +1,3 @@
|
||||
vim ./scripts/install.sh
|
||||
:set ff=unix
|
||||
:wq
|
||||
@@ -0,0 +1,23 @@
|
||||
### IAM 与 RAC:不同层面的概念
|
||||
|
||||
**IAM (Identity and Access Management,身份与访问管理)** 是一个框架或系统服务-。它是一个宏观的管理体系,负责整个数字身份的生命周期管理(创建、修改、删除)以及定义“谁”在“什么条件”下可以“访问”什么“资源”。
|
||||
|
||||
### IAM 中的主流授权模型:RBAC vs ABAC
|
||||
|
||||
在实际的IAM系统中,最主流的两种授权模型是RBAC和ABAC[-4](https://support.huaweicloud.com/intl/zh-cn/api-cci2/cci_02_0089.html)-。它们的核心区别如下:
|
||||
|
||||
|特性|基于角色的访问控制 (RBAC)|基于属性的访问控制 (ABAC)|
|
||||
|---|---|---|
|
||||
|**授权基础**|基于用户在组织中的**职能或角色**(如:管理员、开发者)[-1](https://support.huaweicloud.com/intl/zh-cn/productdesc-iam5/iam_01_1274.html)。|基于**动态属性**,如用户属性、资源属性、操作类型、环境等[-1](https://support.huaweicloud.com/intl/zh-cn/productdesc-iam5/iam_01_1274.html)。|
|
||||
|**权限关系**|**用户 → 角色 → 权限**[-4](https://support.huaweicloud.com/intl/zh-cn/api-cci2/cci_02_0089.html)。|**用户/资源 → 策略 (基于属性规则)**[-1](https://support.huaweicloud.com/intl/zh-cn/productdesc-iam5/iam_01_1274.html)。|
|
||||
|**管理粒度**|相对**粗粒度**,通常授予对一类服务的访问权限[-4](https://support.huaweicloud.com/intl/zh-cn/api-cci2/cci_02_0089.html)。|**细粒度**,可以精确到某个操作、某个特定资源[-1](https://support.huaweicloud.com/intl/zh-cn/productdesc-iam5/iam_01_1274.html)[-4](https://support.huaweicloud.com/intl/zh-cn/api-cci2/cci_02_0089.html)。|
|
||||
|**扩展性与灵活性**|**灵活性较差**。新增资源或人员变动时,通常需要手动更新角色或策略[-1](https://support.huaweicloud.com/intl/zh-cn/productdesc-iam5/iam_01_1274.html)。|**灵活性高**。只要属性匹配,新资源的权限可自动授予,无需修改策略[-1](https://support.huaweicloud.com/intl/zh-cn/productdesc-iam5/iam_01_1274.html)。|
|
||||
|**适用场景**|组织架构稳定,角色和职责明确的环境[-4](https://support.huaweicloud.com/intl/zh-cn/api-cci2/cci_02_0089.html)。|环境动态变化,需要精细化、自动化权限管控的大型或复杂组织[-4](https://support.huaweicloud.com/intl/zh-cn/api-cci2/cci_02_0089.html)。|
|
||||
|
||||
|
||||
|
||||
**Linux 用户系统核心是 DAC (自主访问控制)**[-17](https://z.itpub.net/article/detail/42DE3A43D7D8A4A695A5061B04013496)
|
||||
|
||||
- **机制**:这是Linux最基础的权限模型,即经典的**UGO(用户、组、其他人)+ RWX(读、写、执行)权限**,以及更灵活的**ACL(访问控制列表)**-[-17](https://z.itpub.net/article/detail/42DE3A43D7D8A4A695A5061B04013496)。
|
||||
- **特点**:资源(文件、目录)的**拥有者**可以自主决定授予谁什么权限[-15](https://blog.csdn.net/fuladulu/article/details/157652085)[-17](https://z.itpub.net/article/detail/42DE3A43D7D8A4A695A5061B04013496)。
|
||||
- **例子**:你使用`chmod`命令修改自己文件的权限,就是典型的DAC操作[-17](https://z.itpub.net/article/detail/42DE3A43D7D8A4A695A5061B04013496)。
|
||||
@@ -0,0 +1,363 @@
|
||||
|
||||
|
||||
去年换服务器的时候我干了件事:没有直接把旧环境整个搬过去,而是从一台干干净净的机器开始,谁让我用得难受了,我才装谁。
|
||||
|
||||
这个过程比我想的有意思。头十分钟我装了四个东西,接下来两天陆陆续续又装了几个,然后就基本停了。而我旧机器上那一堆当年兴冲冲装的、名字都挺酷的工具,一多半我压根没想起来。
|
||||
|
||||
那份记录后来变成了一个叫 setup.sh 的文件,现在二十三行。这篇讲的就是这二十三行,以及它们各自是因为什么进来的。
|
||||
|
||||
我不太想写成一份"神器大全"。那种清单我以前收藏过很多,收藏完就没再打开。真正有用的信息不是"有哪些工具",是"什么样的疼痛值得用工具去治,以及它是怎么治的"。所以下面每一个我都会说清楚:我因为什么装的它,它具体解决了什么,怎么用。
|
||||
|
||||
命令我都会翻译成人话,没怎么碰过终端的人也能看懂在干嘛。
|
||||
|
||||
先说一句丑话:这里头有几个是近几年才流行的新工具,不同发行版的安装方式和名字略有差异,你真要装的时候查一下当下的官方说明。我给的是这些工具解决什么问题,这个是不会过期的。
|
||||
|
||||
## 头十分钟装的那四个
|
||||
|
||||
新机器上最先让我难受的,永远是同一件事:我知道那个东西在,但我找不到它。
|
||||
|
||||
一个跑了半年的项目,几十个实验目录,里面藏着日志、配置、checkpoint、临时脚本。你脑子里只有一个模糊的印象:那个改过学习率的配置文件,好像在某个 exp_0 什么的目录里。
|
||||
|
||||
系统自带的 find 能干这事,但它的写法对人非常不友好:
|
||||
|
||||
find . -name "*config*" -type f
|
||||
|
||||
要引号,要 -name,要 -type f,少一个就报错或者给你一堆你不想要的东西。而且它会一头钻进 .git 目录和虚拟环境里,给你翻出几千条垃圾结果。
|
||||
|
||||
第一个装的是 fd。同样的事:
|
||||
|
||||
fd config
|
||||
|
||||
完了。它默认忽略隐藏目录和 .gitignore 里写明不用管的东西,所以吐出来的结果是干净的。想只看 Python 文件加个 -e py:
|
||||
|
||||
fd -e py train
|
||||
|
||||
意思是:名字里带 train 的 py 文件在哪。
|
||||
|
||||
第二个是 ripgrep,命令名是 rg。这个是找文件内容的,对应系统自带的 [grep](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=2&q=grep&zhida_source=entity)。
|
||||
|
||||
rg "lr=" exp_*/config.yaml
|
||||
|
||||
意思是:在这些配置文件里,把含有 lr= 的行都找出来,顺便告诉我是哪个文件的第几行。
|
||||
|
||||
它比 grep 快很多,而且同样会自动跳过那些不该搜的目录。我第一次在整个项目目录下 rg 一个函数名、瞬间就出结果的时候,是真的愣了一下。以前用 grep -r 搜同样的东西,我习惯是敲完回车就去接杯水。
|
||||
|
||||
第三个是 fzf,如果只让我留一个,我留它。
|
||||
|
||||
它干的事听起来很平淡:给你一个模糊搜索的选择框。你输入几个不连续的字母,它从一堆候选里实时筛。它的价值在于,它能接在任何东西后面。
|
||||
|
||||
装完之后最直接的变化是,按下 Ctrl-R 翻历史命令,从原来那种一下一下往上按的痛苦,变成了输入三个字母就把三个月前那条又长又复杂的命令捞出来。我上一篇讲命令行的时候说过,命令是可以被写下来的东西,而 fzf 让"写下来的东西"真正变得可以被随时找回。这两件事凑一块儿威力才完整。
|
||||
|
||||
还能这么用:
|
||||
|
||||
vim $(fzf)
|
||||
|
||||
先弹出选择框让你搜文件,选中哪个就用编辑器打开哪个。
|
||||
|
||||
杀掉一个进程也不用先 ps 再抄 PID 了:
|
||||
|
||||
kill -9 $(ps aux | fzf | awk '{print $2}')
|
||||
|
||||
意思是:把所有进程列出来给我搜,我选中一行,把它的进程号取出来,杀掉。
|
||||
|
||||
第四个是 zoxide。装完之后你用 z 代替 cd:
|
||||
|
||||
z exp3
|
||||
|
||||
它会记住你常去哪些目录,你只需要给个片段,它带你跳过去。不用再敲那种十几层的长路径。这个东西的收益特别隐形,你装的时候觉得"就这?",一个月后回到没装它的机器上,你会明显地烦。
|
||||
|
||||
这四个是一类东西,它们不给你新能力,它们只是让"找"这件事从一件需要动脑的事变成一个反射动作。这种改善听起来不性感,但它节省的是你一天里被打断几十次的那种细碎的注意力。
|
||||
|
||||
## 服务器磁盘满了那次,我装了 ncdu
|
||||
|
||||
有一天集群提示我空间不够,训练起不来。
|
||||
|
||||
我第一反应是 du -sh * 一层层往下找,找了十几分钟,眼睛都花了。那次之后我装了 ncdu。
|
||||
|
||||
ncdu ~/
|
||||
|
||||
它会扫一遍,然后给你一个可以上下键走进走出的界面,每个目录后面标着占了多大、按大小排好序。哪个目录胖,一眼就看见,还能直接在里面按 d 删掉。
|
||||
|
||||
我那次进去三层就找到了元凶:一个我早就放弃的实验,每个 epoch 存一个 checkpoint,存了四十多个,一个两个多G。
|
||||
|
||||
顺手提一下 [dust](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=dust&zhida_source=entity),它是 du 的替代品,直接画出一棵带条形图的树,适合"我就想扫一眼谁最胖"这种需求。ncdu 适合排查,dust 适合扫视。
|
||||
|
||||
还有 duf,看各个分区还剩多少,比 df -h 那一堆对不齐的数字好读。这三个都属于装了不用天天想起、但出事那天能救你的东西。
|
||||
|
||||
多说一句我踩过的坑:磁盘报满的时候,别只看文件大小,还要看是不是被删掉的文件还被进程占着。你 rm 掉一个日志,但写它的程序还在跑,空间不会释放。这时候用 lsof 找它:
|
||||
|
||||
lsof | grep deleted
|
||||
|
||||
意思是:列出所有被打开的文件,找出那些"已经被删了但还被占着"的。我第一次遇到这个的时候完全懵了,明明删了几十个G,df 一看一点没变。
|
||||
|
||||
## 训练跑起来之后,你需要看清它在干嘛
|
||||
|
||||
这块是我最有体感的,因为跑多模态的实验,大部分时间就是等,而等的时候你需要知道它到底活着还是已经僵了。
|
||||
|
||||
第一个,gpustat 或者 [nvtop](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=nvtop&zhida_source=entity)。
|
||||
|
||||
nvidia-smi 大家都会,但它一屏东西太多,看一次要找半天。gpustat 是一行一张卡,谁占了、占了多少显存、利用率多少,清清楚楚:
|
||||
|
||||
gpustat -i
|
||||
|
||||
那个 -i 是持续刷新。nvtop 更进一步,给你一个带曲线的界面,像 [htop](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=htop&zhida_source=entity) 但是给显卡用的。你能一眼看出利用率是稳定在高位,还是在那儿一顿一顿地跳。
|
||||
|
||||
这个真的有用,不是花架子。利用率一顿一顿的,通常意味着显卡在等数据,瓶颈在数据加载而不是在计算。这个信号如果你看不见,你会白白多等几个小时,还以为是模型本来就慢。
|
||||
|
||||
第二个,ts,来自一个叫 moreutils 的工具包。
|
||||
|
||||
它干的事一句话说完:给流水一样的日志,每行前面加个时间戳。
|
||||
|
||||
python train.py | ts '%F %T'
|
||||
|
||||
以前我的日志长这样:一堆 loss 数字,不知道哪一行是什么时候打的。出问题回头查,只能靠猜。加了 ts 之后,每一行前面都有精确到秒的时间,你能立刻算出每个 epoch 花了多久、卡在哪一步。
|
||||
|
||||
这个改动小到不值一提,但它把我的日志从"一堆数字"变成了"一份有时间轴的记录"。查问题的时候差别巨大。
|
||||
|
||||
moreutils 里还有一个更冷门的,叫 [sponge](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=sponge&zhida_source=entity)。它解决一个特别隐蔽的坑:
|
||||
|
||||
sort file.txt > file.txt
|
||||
|
||||
这条看起来合理,其实会把文件清空,因为输出重定向会先把文件截断,而此时 sort 还没读完。换成:
|
||||
|
||||
sort file.txt | sponge file.txt
|
||||
|
||||
sponge 会先把内容全吸进去,等上游结束了再一次性写回。我是被坑过之后才知道有这么个东西的,那个文件不重要,但那种"我明明只是排个序,你怎么给我清空了"的荒谬感,记了很久。
|
||||
|
||||
第三个,pv。
|
||||
|
||||
传一个几十G的数据集、解压一个大压缩包,系统默认什么都不告诉你,你只能盯着光标看它转,完全不知道是快好了还是刚开始。
|
||||
|
||||
pv data.tar.gz | tar xzf -
|
||||
|
||||
加了 pv,你就有了进度条、速度和剩余时间。它本质上是插在管道中间的一个观察窗,任何数据流过它,它就报告一下流了多少。
|
||||
|
||||
## 数据处理:这几个能省掉大量临时脚本
|
||||
|
||||
搞机器学习,一半时间在跟数据的格式较劲。以前我遇到点需求就写个 Python 小脚本,写完就扔,下次再写。后来发现好多需求根本不值得开一个 py 文件。
|
||||
|
||||
jq,处理 JSON 的。这个可能不算冷门,但用得深的人不多。
|
||||
|
||||
jq '.results[] | .score' out.json
|
||||
|
||||
意思是:把 results 这个列表里每一项的 score 拿出来。加个 -r 可以去掉引号,方便接给别的命令。
|
||||
|
||||
我最常用的场景是:一堆评测输出的 json,我想看某个指标的分布。以前是写脚本,现在是一行,而且能直接接到后面排序、算平均。
|
||||
|
||||
[shuf](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=shuf&zhida_source=entity),这个是系统自带的,但我很少见人提,而它对做机器学习的人来说简直是量身定做:
|
||||
|
||||
shuf -n 1000 huge.jsonl > sample.jsonl
|
||||
|
||||
意思是:从这个巨大的文件里随机抽一千行出来。
|
||||
|
||||
调试数据处理流程的时候,你不需要跑全量,你需要一个有代表性的小样本。用 head 取前一千行是有偏的,因为数据往往按某种顺序排过。shuf 一行解决,而且它对大文件的处理效率很好。
|
||||
|
||||
split,也是自带的,把大文件切块:
|
||||
|
||||
split -l 100000 big.jsonl part_
|
||||
|
||||
每十万行切一个,分块之后可以并行处理。
|
||||
|
||||
[column -t](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=column+-t&zhida_source=entity),自带的排版小工具,冷门到我怀疑一半人不知道它存在:
|
||||
|
||||
cat result.txt | column -t
|
||||
|
||||
它会把用空格分隔的内容对齐成整齐的列。我那些手工输出的实验结果,加这一下之后从一团乱麻变成一张表,看错数字的概率明显降低。
|
||||
|
||||
sd,替代 sed 做简单替换的。sed 的语法我每次用都要查:
|
||||
|
||||
sd 'lr=0.001' 'lr=0.0005' config.yaml
|
||||
|
||||
就这么直观,前面是找什么,后面是换成什么。复杂的场合 sed 还是更强,但九成的日常替换,sd 足够,而且不容易写错。
|
||||
|
||||
处理 CSV 我用 miller,命令名 mlr:
|
||||
|
||||
mlr --csv stats1 -a mean,max -f loss data.csv
|
||||
|
||||
意思是:算这个 csv 里 loss 这一列的均值和最大值。
|
||||
|
||||
不过这个我用得不算深,我基本只用统计和筛选那几个功能,它更复杂的能力我没吃透,不敢多讲。
|
||||
|
||||
## 让重复的事自己发生
|
||||
|
||||
这一组是我认为收益最高、但知道的人最少的一类。
|
||||
|
||||
entr,监视文件变化然后自动执行命令。
|
||||
|
||||
fd -e py | entr -r python train.py
|
||||
|
||||
意思是:所有 py 文件,只要有任何一个被我保存了,就重新跑一次训练。那个 -r 是先杀掉上一次的进程再重启。
|
||||
|
||||
这个东西改变了我调试的节奏。以前是改代码、切窗口、回车、看结果、切回去改。现在是改代码、保存,眼睛都不用离开编辑器,旁边那个窗口自己就跑起来了。写测试的时候尤其明显:
|
||||
|
||||
fd -e py | entr pytest tests/
|
||||
|
||||
保存即测试。这个循环紧到什么程度,直接决定了你调试时的心态,松一点你就容易走神,紧一点你就一直在状态里。
|
||||
|
||||
[GNU parallel](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=GNU+parallel&zhida_source=entity),把串行的事变成并行。
|
||||
|
||||
parallel -j 4 python eval.py --ckpt {} ::: ckpt/*.pt
|
||||
|
||||
意思是:对每一个 checkpoint 文件都跑一次评测,同时跑四个。那个 {} 是占位符,代表当前这个文件。
|
||||
|
||||
我以前干这事是写个 for 循环一个个跑,二十个 checkpoint 排队等着。现在四个一起上,时间除以四。要注意别开太多把显存或者内存挤爆,-j 后面那个数字要看着机器给。
|
||||
|
||||
[hyperfine](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=hyperfine&zhida_source=entity),给命令做基准测试。
|
||||
|
||||
hyperfine 'python loader_a.py' 'python loader_b.py'
|
||||
|
||||
它会各跑很多次,给你平均耗时、标准差,还有谁快多少倍。
|
||||
|
||||
我用它比较过两种数据加载的写法。之前判断哪个快,我是自己 time 一下,跑两三次,凭感觉。但单次测量的波动其实很大,我不止一次被随机波动骗过,以为某个改动有效,后来发现是噪声。hyperfine 给的是带方差的结论。
|
||||
|
||||
这一点其实挺重要:做科研的人应该对"单次测量"天然警惕,但轮到自己写代码调性能的时候,反而经常凭一次运行下结论。我自己犯过这个错,还挺尴尬的。
|
||||
|
||||
[direnv](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=direnv&zhida_source=entity),进入目录自动加载环境变量。
|
||||
|
||||
在项目目录里放一个 .envrc,写上这个项目要用的显卡、路径、密钥,cd 进来自动生效,cd 出去自动失效。
|
||||
|
||||
export CUDA_VISIBLE_DEVICES=2
|
||||
|
||||
我用它主要是为了防一件事:忘了自己上一次把显卡设成了哪张,结果新实验一头撞到别人正在用的卡上。这种事发生一次就够让人不好意思了。
|
||||
|
||||
timeout,自带的,给命令设一个上限:
|
||||
|
||||
timeout 300 python probe.py
|
||||
|
||||
超过五分钟就掐掉。写探测脚本或者跑不确定会不会卡死的东西时,加上它,你就不会回来发现某个进程僵在那儿占了一晚上资源。
|
||||
|
||||
flock,防止同一个任务重复执行:
|
||||
|
||||
flock -n /tmp/mytask.lock python task.py
|
||||
|
||||
如果上一次还在跑,这一次就直接放弃。定时任务里这个特别有用,不然上一轮没跑完下一轮又起来了,两个一起写同一个文件,场面会很难看。
|
||||
|
||||
## 在共用服务器上活下来的几个
|
||||
|
||||
实验室的机器是大家共用的,这一组是关于怎么当个不讨人嫌的人,顺便别把自己搞死。
|
||||
|
||||
[nice 和 ionice](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=nice+%E5%92%8C+ionice&zhida_source=entity)。
|
||||
|
||||
nice -n 19 ionice -c3 python preprocess.py
|
||||
|
||||
意思是:这个数据预处理,把它的 CPU 优先级和磁盘优先级都降到最低。它会慢一点,但它不会拖慢别人正在跑的训练。
|
||||
|
||||
我第一次意识到该这么做,是有次我起了一个吃满 CPU 的预处理,隔壁同门的训练速度掉了三成,他还以为是自己代码的问题,查了半天。那次挺不好意思的。这两个命令加起来不到二十个字符,成本几乎为零,但它是一种态度。
|
||||
|
||||
lsof,找出是谁占着东西。
|
||||
|
||||
lsof -i :8888
|
||||
|
||||
意思是:8888 这个端口被谁占了。启不了 Jupyter 的时候第一个敲它。
|
||||
|
||||
显卡上有僵尸进程占着显存但 nvidia-smi 看不出是谁的时候:
|
||||
|
||||
fuser -v /dev/nvidia*
|
||||
|
||||
它会列出所有正在用显卡的进程。找到自己那个僵掉的,杀了就行。别人的别乱动,这个我得强调一下,共用机器上手快一时爽,后面很尴尬。
|
||||
|
||||
[mosh](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=mosh&zhida_source=entity),替代 ssh 的连接方式。
|
||||
|
||||
它最大的价值是:你合上笔记本、换个网络、地铁上断线,连接还在。ssh 在这些情况下会断,断了你正在前台跑的东西就没了。mosh 会自己缓存和重连,你重新打开电脑,光标还在那儿等你。
|
||||
|
||||
配合 [tmux](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=tmux&zhida_source=entity) 用最稳妥。tmux 保证程序活着,mosh 保证你回来得顺畅。
|
||||
|
||||
[trash-cli](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=trash-cli&zhida_source=entity),给 rm 一个回收站。
|
||||
|
||||
trash-put old_ckpt/
|
||||
|
||||
它把东西移到回收站而不是直接抹掉。我装它的原因不太光彩:我用通配符删过一批文件,范围比我以为的大,几天的训练结果跟着一起没了。
|
||||
|
||||
那天下午我坐在工位上,把那条命令反复看了很多遍,想搞清楚自己到底怎么写错的。其实很简单,就是手快。
|
||||
|
||||
我没有把 rm 直接 alias 成 trash-put,因为那会让我在别人的机器上产生错误的肌肉记忆,那更危险。我的做法是:删单个明确的东西照常用 rm,批量删、带通配符的一律先 ls 看一眼,重要的用 trash-put。
|
||||
|
||||
[croc](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=croc&zhida_source=entity),两台机器之间直接传文件。
|
||||
|
||||
croc send data.zip
|
||||
|
||||
它给你一个短语,在另一台机器上敲 croc 加那个短语,就开始传了,不用配置密钥、不用管中间有没有跳板机。临时给同门传个模型权重,比来回折腾 scp 路径快得多。
|
||||
|
||||
## 你机器上已经装好了、但你没用过的
|
||||
|
||||
这一段不用装任何东西,全是自带的,而且冷门得离谱。
|
||||
|
||||
comm,比较两个已排序的列表:
|
||||
|
||||
comm -23 all.txt done.txt
|
||||
|
||||
意思是:哪些在 all 里但不在 done 里。断点续跑的时候,这一条就能算出"还有哪些没处理",不用写脚本。
|
||||
|
||||
tac,把文件倒着输出。看日志找最近的报错特别顺手:
|
||||
|
||||
tac log.txt | rg -m1 "Error"
|
||||
|
||||
意思是:从后往前找,遇到第一个 Error 就停。日志几百万行的时候,这比从头搜快得多。
|
||||
|
||||
xargs,把上游的输出变成下游命令的参数:
|
||||
|
||||
fd -e ckpt | xargs -I{} ls -lh {}
|
||||
|
||||
它是把两个不搭的命令粘起来的胶水,值得单独花十分钟搞懂。
|
||||
|
||||
script,把整个终端会话录下来:
|
||||
|
||||
script session.log
|
||||
|
||||
之后你敲的和屏幕上出现的所有东西都会写进那个文件。我用它记过一次很麻烦的环境配置过程,后来照着复盘,把那份记录整理成了脚本。
|
||||
|
||||
还有两个纯粹的手指效率,免费的:
|
||||
|
||||
!! 代表上一条命令。忘了加 sudo 的时候,sudo !! 。
|
||||
|
||||
!$ 代表上一条命令的最后一个参数。刚 mkdir 了一个长路径,下一句 cd !$ 直接进去。
|
||||
|
||||
最后一个,tldr。这不是自带的,但值得作为这一段的结尾:
|
||||
|
||||
tldr tar
|
||||
|
||||
man 手册是给专家做参考的,又长又劝退。tldr 给你的是五六个最常用的例子。tar 的参数我到现在都记不全,每次都是 tldr 一下抄一条。
|
||||
|
||||
不背参数这件事,不丢人。你需要记住的是"有这么个东西能干这件事",具体怎么写,查。
|
||||
|
||||
## 现在说点扫兴的
|
||||
|
||||
写到这儿我得把另一面讲清楚,不然这篇就是一份不负责的种草清单。
|
||||
|
||||
第一,别把肌肉记忆绑在别人机器上没有的工具上。
|
||||
|
||||
我认识一个人,把 ls 全 alias 成了新工具,cat 换掉,cd 换掉,配置得极其漂亮。结果他一上没有权限装东西的集群,整个人就废了,连最基本的操作都要卡一下。
|
||||
|
||||
我的规矩是:新工具用新名字,不覆盖原来的命令。fd 就是 fd,不动 find。你在任何一台裸机上都得能干活,这是底线。
|
||||
|
||||
第二,很多服务器你没有 sudo。
|
||||
|
||||
好消息是上面这些新工具大多是单文件的,可以直接下载扔进自己家目录的 bin 里,不需要管理员权限。[conda](https://zhida.zhihu.com/search?content_id=792766250&content_type=Answer&match_order=1&q=conda&zhida_source=entity) 和 pip 也能装不少。真装不上的,就退回自带工具,前面那一段"已经装好了"的内容就是为这种情况准备的。
|
||||
|
||||
第三,这才是我真正想说的那句。
|
||||
|
||||
我大二那年是个装备党。收藏了几十篇神器推荐,配置文件搞得花里胡哨,终端打开是一屏漂亮的信息面板,给同学演示的时候挺有面子。
|
||||
|
||||
但那些工具我一个都没真正用起来。因为它们不是从我的疼痛里长出来的,是从别人的清单里抄来的。
|
||||
|
||||
后来某个阶段我意识到一件不太好意思承认的事:我那段时间之所以那么热衷于折腾工具,是因为实验做不出来。改配置有即时的、确定的成就感,而实验没有。捣鼓终端主题的那两个小时,我感觉自己在"提升效率",实际上我是在躲。
|
||||
|
||||
想通这个之后我给自己定了个规矩,一直用到现在:一个工具要进 setup.sh,得先有一次真实的狼狈。磁盘满了、日志没时间戳、文件误删了、显卡被自己撞了。疼过一次,再去找工具,那个工具就会活下来。
|
||||
|
||||
反过来,某天我又想装个什么新东西,先问自己一句:它在解决什么疼?如果答不上来,那大概不是工具的问题,是我今天不太想面对手上那件难的事。
|
||||
|
||||
这个自问帮我省下的时间,比上面所有工具加起来还多。
|
||||
|
||||
## 如果只让你装五个
|
||||
|
||||
真要挑,我的顺序是:fzf、ripgrep、fd、ncdu、entr。
|
||||
|
||||
前三个改善的是每天几十次的细碎动作,收益天天都在;ncdu 是出事那天救你;entr 会实实在在改变你调试的节奏。
|
||||
|
||||
跑深度学习的话,再加 gpustat 和 ts,这两个是这个行当的专属刚需。
|
||||
|
||||
判断一个工具值不值得进你的清单,标准我只有一条:它必须对应一次你真实卡住过的时刻。你想不起那个时刻,就先别装,等它来找你。
|
||||
|
||||
那份 setup.sh 现在躺在我的仓库里,二十三行,每行前面我都写了一句注释,写的不是这个工具是什么,而是我为什么装它。翻那个文件,比翻任何一份工具清单都有意思,因为它记的其实不是工具,是我这几年具体在哪些地方栽过。
|
||||
|
||||
写完这篇我看了一眼,今天的实验还在跑,进度条走了六成。
|
||||
@@ -0,0 +1,15 @@
|
||||
# 查看指定网卡信息
|
||||
sudo ethtool eth0
|
||||
|
||||
# 查看所有网卡的接口类型
|
||||
for iface in $(ip link show | awk -F: '/^[0-9]+:/ {print $2}' | tr -d ' '); do
|
||||
echo -n "$iface: "
|
||||
sudo ethtool $iface 2>/dev/null | grep -E "Supported link modes|Port|Speed"
|
||||
done
|
||||
|
||||
|
||||
**关键判断点:**
|
||||
|
||||
- **电口(RJ45)**:显示 `Port: Twisted Pair` 或支持 `1000baseT/Full`、`10GBASE-T` 等模式
|
||||
|
||||
- **光口(Fiber)**:显示 `Port: FIBRE` 或支持 `1000baseX/Full`、`10GBASE-SR/LR` 等模式
|
||||
@@ -0,0 +1,10 @@
|
||||
|
||||
设置IP和掩码
|
||||
ifconfig eth0 192.168.5.40 netmask 255.255.255.0
|
||||
设置网关
|
||||
route add default gw 192.168.5.1
|
||||
|
||||
|
||||
route add -net 192.168.3.0/24 dev eth0
|
||||
route add -net 192.168.2.0/24 gw 192.168.3.254
|
||||
|
||||
@@ -0,0 +1,155 @@
|
||||
网卡的bond(绑定)是一种网络技术,它允许将多个物理网络接口卡(NIC)组合成一个单一的逻辑通道,以提高网络吞吐量并提供冗余。以下是网卡绑定的一些关键点:
|
||||
|
||||
1. **提高带宽**:通过将多个网卡绑定在一起,可以增加可用的网络带宽,因为数据可以通过多个网卡同时传输。
|
||||
|
||||
2. **冗余**:如果其中一个网卡出现故障,绑定可以自动切换到另一个网卡,从而减少网络中断的风险。
|
||||
|
||||
3. **负载均衡**:绑定还可以在多个网卡之间分配网络流量,这称为负载均衡,有助于更均匀地使用网络资源。
|
||||
|
||||
以下是Linux网卡绑定(bonding)模式及其对应配置值的详细表格:
|
||||
|
||||
## 网卡Bonding模式对应关系表
|
||||
|
||||
| **Mode编号** | **模式名称** | **Linux内核名称** | **负载均衡** | **容错性** | **交换机要求** |
|
||||
| ---------- | ----------- | ------------- | -------- | ------- | --------- |
|
||||
| **mode=0** | 负载均衡(轮询) | balance-rr | ✅ 轮询方式 | ✅ | 不需要特殊配置 |
|
||||
| **mode=1** | 主备模式 | active-backup | ❌ | ✅ 高可用 | 不需要特殊配置 |
|
||||
| **mode=2** | 负载均衡(XOR哈希) | balance-xor | ✅ 基于哈希 | ✅ | 不需要特殊配置 |
|
||||
| **mode=3** | 广播模式 | broadcast | ❌ | ✅ 高冗余 | 不需要特殊配置 |
|
||||
| **mode=4** | 动态链路聚合 | 802.3ad | ✅ 动态聚合 | ✅ | 需要支持LACP |
|
||||
| **mode=5** | 适配器传输负载均衡 | balance-tlb | ✅ 自适应 | ✅ | 不需要特殊配置 |
|
||||
| **mode=6** | 适配器负载均衡 | balance-alb | ✅ 自适应 | ✅ | 不需要特殊配置 |
|
||||
|
||||
## 各模式详细说明
|
||||
|
||||
### **mode=0 (balance-rr) - 轮询负载均衡**
|
||||
- **特点**:数据包按顺序轮流从每个slave接口发送
|
||||
- **优点**:带宽叠加,负载均衡
|
||||
- **缺点**:数据包可能乱序到达
|
||||
- **适用场景**:需要高带宽,不严格要求包顺序
|
||||
|
||||
### **mode=1 (active-backup) - 主备模式**
|
||||
- **特点**:只有一个接口活跃,其他作为备份
|
||||
- **优点**:高可用性,配置简单
|
||||
- **缺点**:不能增加带宽
|
||||
- **适用场景**:关键业务需要冗余备份
|
||||
|
||||
### **mode=2 (balance-xor) - XOR哈希策略**
|
||||
- **特点**:基于源/目的MAC地址的XOR运算选择出口
|
||||
- **优点**:同会话流量走同一接口,避免乱序
|
||||
- **缺点**:负载均衡不够精细
|
||||
- **配置示例**:
|
||||
```bash
|
||||
# 哈希策略选项
|
||||
xmit_hash_policy=layer2 # 默认,基于MAC地址
|
||||
xmit_hash_policy=layer2+3 # 基于MAC+IP
|
||||
xmit_hash_policy=layer3+4 # 基于IP+端口
|
||||
```
|
||||
|
||||
### **mode=3 (broadcast) - 广播模式**
|
||||
- **特点**:所有数据包在所有接口发送
|
||||
- **优点**:极高冗余性
|
||||
- **缺点**:网络开销大,浪费带宽
|
||||
- **适用场景**:极端可靠性要求
|
||||
|
||||
### **mode=4 (802.3ad/LACP) - 动态链路聚合**
|
||||
- **特点**:需要交换机支持LACP协议
|
||||
- **优点**:标准协议,兼容性好,智能负载均衡
|
||||
- **缺点**:依赖交换机配置
|
||||
- **交换机配置要求**:
|
||||
```bash
|
||||
# 配置LACP参数
|
||||
lacp_rate=slow # 默认,每30秒发送LACPDU
|
||||
lacp_rate=fast # 每秒发送LACPDU(1秒)
|
||||
```
|
||||
|
||||
### **mode=5 (balance-tlb) - 适配器传输负载均衡**
|
||||
- **特点**:根据每个slave的负载情况动态分配
|
||||
- **优点**:不需要特殊交换机
|
||||
- **缺点**:只均衡出站流量,入站流量由当前slave处理
|
||||
|
||||
### **mode=6 (balance-alb) - 适配器负载均衡**
|
||||
- **特点**:mode=5的增强版,包含ARP协商
|
||||
- **优点**:出入站流量都均衡,无需交换机支持
|
||||
- **缺点**:可能引起ARP刷新问题
|
||||
|
||||
## 常用配置参数
|
||||
|
||||
### 1. **基础参数**
|
||||
```bash
|
||||
BONDING_OPTS="mode=1 miimon=100"
|
||||
```
|
||||
- **miimon=100**:每100ms检查链路状态(毫秒)
|
||||
- **downdelay=200**:链路down后等待200ms再禁用
|
||||
- **updelay=200**:链路恢复后等待200ms再启用
|
||||
|
||||
### 2. **主备模式专用参数**
|
||||
```bash
|
||||
BONDING_OPTS="mode=1 miimon=100 primary=eth0"
|
||||
```
|
||||
- **primary=eth0**:指定主接口
|
||||
- **primary_reselect=always**:主接口恢复后是否切回
|
||||
|
||||
### 3. **LACP模式专用参数**
|
||||
```bash
|
||||
BONDING_OPTS="mode=4 miimon=100 lacp_rate=fast xmit_hash_policy=layer3+4"
|
||||
```
|
||||
|
||||
## 配置文件示例
|
||||
|
||||
### RHEL/CentOS/Fedora
|
||||
```bash
|
||||
# /etc/sysconfig/network-scripts/ifcfg-bond0
|
||||
DEVICE=bond0
|
||||
TYPE=Bond
|
||||
BONDING_MASTER=yes
|
||||
IPADDR=192.168.1.100
|
||||
NETMASK=255.255.255.0
|
||||
ONBOOT=yes
|
||||
BOOTPROTO=none
|
||||
BONDING_OPTS="mode=4 miimon=100 lacp_rate=fast"
|
||||
|
||||
# /etc/sysconfig/network-scripts/ifcfg-eth0
|
||||
DEVICE=eth0
|
||||
TYPE=Ethernet
|
||||
MASTER=bond0
|
||||
SLAVE=yes
|
||||
ONBOOT=yes
|
||||
```
|
||||
|
||||
### Ubuntu/Debian
|
||||
```bash
|
||||
# /etc/network/interfaces
|
||||
auto bond0
|
||||
iface bond0 inet static
|
||||
address 192.168.1.100
|
||||
netmask 255.255.255.0
|
||||
bond-mode 4
|
||||
bond-miimon 100
|
||||
bond-lacp-rate 1
|
||||
bond-slaves eth0 eth1
|
||||
```
|
||||
|
||||
## 状态检查命令
|
||||
|
||||
```bash
|
||||
# 查看bonding状态
|
||||
cat /proc/net/bonding/bond0
|
||||
|
||||
# 查看网络接口统计
|
||||
ip link show bond0
|
||||
|
||||
# 查看bonding模块参数
|
||||
cat /sys/class/net/bond0/bonding/mode
|
||||
cat /sys/class/net/bond0/bonding/slaves
|
||||
```
|
||||
|
||||
## 选择建议
|
||||
|
||||
1. **需要高可用性**:mode=1(主备模式)
|
||||
2. **需要带宽聚合且交换机支持LACP**:mode=4(802.3ad)
|
||||
3. **需要带宽聚合但交换机不支持LACP**:mode=0或mode=6
|
||||
4. **需要极致的冗余性**:mode=3(广播模式)
|
||||
5. **服务器负载均衡**:mode=2或mode=4
|
||||
|
||||
选择bond模式时,请确保了解网络环境和业务需求,并在测试环境中验证后再部署到生产环境。
|
||||
@@ -0,0 +1,45 @@
|
||||
网卡的bond(绑定)是一种网络技术,它允许将多个物理网络接口卡(NIC)组合成一个单一的逻辑通道,以提高网络吞吐量并提供冗余。以下是网卡绑定的一些关键点:
|
||||
|
||||
1. **提高带宽**:通过将多个网卡绑定在一起,可以增加可用的网络带宽,因为数据可以通过多个网卡同时传输。
|
||||
|
||||
2. **冗余**:如果其中一个网卡出现故障,绑定可以自动切换到另一个网卡,从而减少网络中断的风险。
|
||||
|
||||
3. **负载均衡**:绑定还可以在多个网卡之间分配网络流量,这称为负载均衡,有助于更均匀地使用网络资源。
|
||||
|
||||
## bond 模式
|
||||
1. **平衡模式(Round-robin, Balance-rr)**:
|
||||
|
||||
- 描述:按照顺序将网络流量轮流分配到每个网卡上。
|
||||
- 使用场景:适用于所有网卡具有相同速度和双工模式的情况。
|
||||
2. **主动-备份模式(Active-backup)**:
|
||||
|
||||
- 描述:通常只有一个网卡处于活动状态,负责处理所有网络流量。其他网卡处于备份状态,仅在活动网卡发生故障时接管。
|
||||
- 使用场景:适用于需要高可靠性但不需要增加带宽的场景。
|
||||
3. **XOR模式(Adaptive load balancing, Balance-xor)**:
|
||||
|
||||
- 描述:使用XOR算法根据目标MAC地址或IP地址将流量分配到不同的网卡上。
|
||||
- 使用场景:适用于需要更智能的负载分配,以减少特定网卡的流量压力。
|
||||
4. **广播模式(Broadcast)**:
|
||||
|
||||
- 描述:将所有传入的流量复制并发送到所有绑定的网卡上。
|
||||
- 使用场景:适用于需要将流量广播到多个目的地的场景。
|
||||
5. **链路聚合模式(Link aggregation, LACP - Link Aggregation Control Protocol)**:
|
||||
|
||||
- 描述:通过LACP协议动态地将多个网卡组合成一个单一的逻辑链路,可以自动进行负载均衡和故障转移。
|
||||
- 使用场景:适用于需要动态管理链路聚合的情况。
|
||||
6. **静态聚合模式(Static)**:
|
||||
|
||||
- 描述:需要手动配置哪些网卡参与聚合,并且不会自动进行故障转移。
|
||||
- 使用场景:适用于需要手动控制链路聚合的情况。
|
||||
7. **传输队列模式( Transmit load balancing, Balance-tlb)**:
|
||||
|
||||
- 描述:根据每个网卡的传输队列长度分配流量,以避免队列溢出。
|
||||
- 使用场景:适用于需要优化传输队列性能的场景。
|
||||
8. **接收队列模式(Receive load balancing, Balance-rlb)**:
|
||||
|
||||
- 描述:根据每个网卡的接收队列长度分配流量,以避免队列溢出。
|
||||
- 使用场景:适用于需要优化接收队列性能的场景。
|
||||
9. **最小链接模式(Minimize link usage, Balance-alb)**:
|
||||
|
||||
- 描述:尽可能使用最少使用的网卡,以减少所有网卡的平均使用率。
|
||||
- 使用场景:适用于希望最小化网卡使用率的场景。
|
||||
@@ -0,0 +1,202 @@
|
||||
在无图形界面的服务器上,全程通过命令行操作是标准做法。核心思路是使用 `virt-install` 命令创建虚拟机,并通过 **VNC** 远程连接来完成 Windows 的图形化安装。
|
||||
|
||||
以下是完整的命令行操作手册:
|
||||
|
||||
---
|
||||
|
||||
### 📋 一、前提条件
|
||||
|
||||
在开始之前,请确保:
|
||||
|
||||
1. **CPU 支持虚拟化**:你的 E5-2673 支持,但需在 BIOS 中确认 **Intel VT-x** 已启用。
|
||||
2. **拥有 sudo 权限**。
|
||||
|
||||
### 🛠️ 二、安装 KVM 及相关工具
|
||||
|
||||
1. **更新软件包列表**:
|
||||
```bash
|
||||
sudo apt update
|
||||
```
|
||||
|
||||
2. **安装 KVM、QEMU、libvirt 和 virt-install**(无需图形界面工具 `virt-manager`):
|
||||
```bash
|
||||
sudo apt install -y qemu-kvm libvirt-daemon-system libvirt-clients bridge-utils virtinst ovmf
|
||||
```
|
||||
|
||||
3. **将当前用户加入 `libvirt` 和 `kvm` 组**:
|
||||
```bash
|
||||
sudo usermod -aG libvirt $USER
|
||||
sudo usermod -aG kvm $USER
|
||||
```
|
||||
|
||||
4. **启动 `libvirtd` 服务并设置开机自启**:
|
||||
```bash
|
||||
sudo systemctl enable --now libvirtd
|
||||
```
|
||||
|
||||
5. **验证服务状态**:
|
||||
```bash
|
||||
sudo systemctl status libvirtd
|
||||
```
|
||||
确保状态为 `active (running)`。
|
||||
|
||||
### 🌐 三、(可选)配置桥接网络
|
||||
|
||||
默认的 `NAT` 网络(`default`)可以让虚拟机访问互联网,但如果需要虚拟机与宿主机在同一个局域网,并拥有独立 IP,则需要配置桥接网络。
|
||||
|
||||
> **注意**:以下操作通过 SSH 连接服务器时请格外小心,错误的网络配置可能导致连接中断。建议通过服务器控制台(如 IPMI、iDRAC)操作。
|
||||
|
||||
1. **查看网卡名称**:
|
||||
```bash
|
||||
ip link show
|
||||
```
|
||||
找到你的物理网卡,如 `enp3s0` 或 `eth0`。
|
||||
|
||||
2. **备份当前 Netplan 配置**:
|
||||
```bash
|
||||
sudo cp /etc/netplan/50-cloud-init.yaml /etc/netplan/50-cloud-init.yaml.bak
|
||||
```
|
||||
你的配置文件可能叫别的名字,以 `/etc/netplan/` 目录下的实际文件名为准。
|
||||
|
||||
3. **编辑 Netplan 配置文件**:
|
||||
```bash
|
||||
sudo nano /etc/netplan/50-cloud-init.yaml
|
||||
```
|
||||
|
||||
4. **修改为以下内容**(请将 `enp3s0`、IP 地址等替换为你自己的信息):
|
||||
```yaml
|
||||
network:
|
||||
version: 2
|
||||
renderer: networkd
|
||||
ethernets:
|
||||
enp3s0:
|
||||
dhcp4: false
|
||||
bridges:
|
||||
br0:
|
||||
interfaces: [enp3s0]
|
||||
addresses: [192.168.1.100/24] # 替换为你的静态IP
|
||||
routes:
|
||||
- to: default
|
||||
via: 192.168.1.1 # 替换为你的网关
|
||||
nameservers:
|
||||
addresses: [8.8.8.8, 8.8.4.4]
|
||||
parameters:
|
||||
stp: false
|
||||
forward-delay: 0
|
||||
```
|
||||
> 如果希望网桥通过 DHCP 自动获取 IP,可将 `addresses`、`routes`、`nameservers` 替换为 `dhcp4: true`。
|
||||
|
||||
5. **应用配置**:
|
||||
```bash
|
||||
sudo netplan apply
|
||||
```
|
||||
|
||||
6. **验证网桥**:
|
||||
```bash
|
||||
ip addr show br0
|
||||
```
|
||||
|
||||
### 💾 四、准备 ISO 镜像文件
|
||||
|
||||
创建目录存放 ISO 文件:
|
||||
```bash
|
||||
mkdir -p ~/iso
|
||||
```
|
||||
|
||||
将以下两个 ISO 文件放入 `~/iso` 目录:
|
||||
* **Windows 10 LTSC ISO 镜像**
|
||||
* **VirtIO 驱动 ISO**:从 [Fedora 官方仓库](https://fedorapeople.org/groups/virt/virtio-win/direct-downloads/stable-virtio/virtio-win.iso) 下载。
|
||||
|
||||
### 🚀 五、使用 virt-install 创建虚拟机
|
||||
|
||||
执行以下命令创建虚拟机:
|
||||
|
||||
```bash
|
||||
sudo virt-install \
|
||||
--name win10-ltsc \
|
||||
--memory 8192 \
|
||||
--vcpus sockets=1,cores=4,threads=1 \
|
||||
--disk path=/vm/disk/win10-ltsc.qcow2,size=60,bus=virtio \
|
||||
--disk path=/vm/iso/virtio-win.iso,device=cdrom \
|
||||
--cdrom /vm/iso/zh-cn_windows_10_enterprise_ltsc_2021_x64_dvd_033b7312.iso \
|
||||
--os-variant win10 \
|
||||
--network network=default,model=virtio \
|
||||
--graphics vnc,listen=0.0.0.0 \
|
||||
--console pty,target_type=serial \
|
||||
--boot uefi,firmware.feature0.name=secure-boot,firmware.feature0.enabled=no \
|
||||
--check path_in_use=off
|
||||
```
|
||||
|
||||
#### 各参数说明
|
||||
|
||||
| 参数 | 说明 |
|
||||
| :--- | :--- |
|
||||
| `--name` | 虚拟机名称 |
|
||||
| `--memory` | 分配的内存大小(MB),此处为 8GB |
|
||||
| `--vcpus` | CPU 配置:1 个 CPU 插槽,4 个核心,每个核心 1 个线程 |
|
||||
| `--disk` | 磁盘路径、大小(GB)和总线类型(`virtio` 性能最佳) |
|
||||
| `--cdrom` | Windows ISO 镜像路径 |
|
||||
| `--os-variant` | 操作系统类型,`win10` 适用于 Windows 10/11 |
|
||||
| `--network` | 网桥名称(如用 NAT 则填 `default`)和网卡型号(`virtio`) |
|
||||
| `--graphics` | **关键**:启用 VNC,并监听所有网络接口 |
|
||||
| `--console` | 开启串行控制台,便于故障排查 |
|
||||
| `--boot` | 使用 UEFI 固件(`ovmf`)启动 |
|
||||
|
||||
> **关于 `--os-variant`**:执行 `osinfo-query os | grep win` 可查看所有支持的 Windows 版本。
|
||||
|
||||
### 🖥️ 六、通过 VNC 完成 Windows 安装
|
||||
|
||||
1. **确认 VNC 端口**:
|
||||
```bash
|
||||
sudo virsh vncdisplay win10-ltsc
|
||||
```
|
||||
输出类似 `127.0.0.1:0`,表示 VNC 服务在 **5900** 端口(`:0` 对应 5900,`:1` 对应 5901)。
|
||||
|
||||
2. **连接 VNC**:在本地电脑上用 VNC 客户端连接:
|
||||
```
|
||||
你的服务器IP:5900
|
||||
```
|
||||
> **安全提醒**:上述配置中 VNC 未设密码,任何人都可连接。建议通过 SSH 隧道转发 VNC 端口,或使用 `--graphics vnc,password=你的密码` 设置密码。
|
||||
|
||||
3. **在 VNC 窗口中安装 Windows**:
|
||||
* 正常进入安装界面。
|
||||
* 当提示 **“未找到任何驱动器”** 时,点击 **“加载驱动程序”**。
|
||||
* 点击 **“浏览”**,找到 VirtIO 驱动 ISO 中的 `viostor\w10\amd64` 文件夹,加载 **“Red Hat VirtIO SCSI Controller”** 驱动。
|
||||
* 磁盘识别后,继续完成 Windows 安装。
|
||||
|
||||
### 🚀 七、安装完成后的优化
|
||||
|
||||
1. **安装 VirtIO 网卡驱动**:
|
||||
* Windows 安装完成后,进入“此电脑”,打开 VirtIO 驱动光盘。
|
||||
* 运行 `virtio-win-gt-x64.exe` 安装所有驱动。
|
||||
|
||||
2. **启用远程桌面(RDP)**:
|
||||
* 在 Windows 中:设置 → 系统 → 远程桌面 → 开启远程桌面。
|
||||
* 之后可通过 RDP 客户端直接连接,比 VNC 更流畅。
|
||||
|
||||
3. **常用虚拟机管理命令**:
|
||||
```bash
|
||||
# 启动虚拟机
|
||||
sudo virsh start win10-ltsc
|
||||
# 关闭虚拟机(需在 Windows 内关机)
|
||||
sudo virsh shutdown win10-ltsc
|
||||
# 强制关闭
|
||||
sudo virsh destroy win10-ltsc
|
||||
# 查看所有虚拟机状态
|
||||
sudo virsh list --all
|
||||
# 删除虚拟机
|
||||
sudo virsh undefine win10-ltsc
|
||||
```
|
||||
|
||||
### 💎 总结
|
||||
|
||||
整个流程可概括为:
|
||||
|
||||
1. **安装** KVM 相关软件包。
|
||||
2. **(可选)配置**桥接网络。
|
||||
3. **准备** Windows ISO 和 VirtIO 驱动 ISO。
|
||||
4. **执行** `virt-install` 命令创建虚拟机。
|
||||
5. **通过 VNC 连接**,在 Windows 安装过程中加载 VirtIO 驱动。
|
||||
6. **安装 VirtIO 驱动**并启用 RDP,完成优化。
|
||||
|
||||
如果在 VNC 连接或驱动加载环节遇到问题,可以随时再来问我。
|
||||
@@ -0,0 +1,183 @@
|
||||
删除原文件后链接不需要保留的就用软链接;删除原文件后链接还要保留的用硬链接。
|
||||
### 数据在Linux系统中是如何存储
|
||||
|
||||
为了理解什么是硬链接和软链接,需要了解数据在Linux系统中是如何存储的。
|
||||
|
||||
在计算机中,数据存储在硬盘上。硬盘被分成多个Block,每个Block又被分成很多称为扇区(sector)的小块。典型情况下,每个扇区的大小是 512 字节,Block的大小为4096字节,这种情况下,一个Block包含8个扇区。
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
文件系统是以Block为单位分配空间的,你可以这么理解,即使你创建一个大小只有1字节的文件,它都会占用一个完整的Block。你用ls -l去查看这个文件的大小,会显示是4096 个字节大小。
|
||||
|
||||
但是如果你创建的文件大小超过4096个字节怎么办?答案是文件将被“碎片化”并存储到多个不同的Block中。
|
||||
|
||||
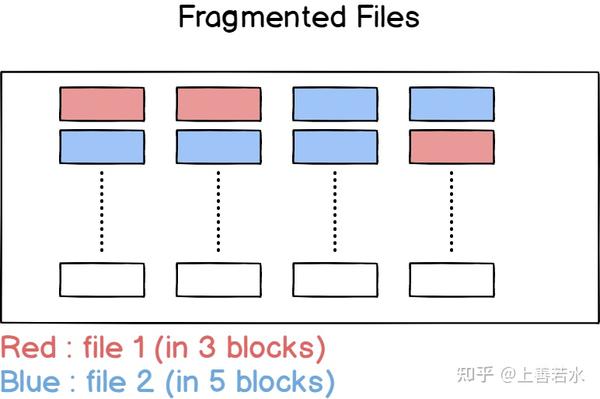
|
||||
|
||||
|
||||
|
||||
### 什么是 inode
|
||||
|
||||
Inode 本质上是用于描述文件的数据结构,innode主要存储了如文件权限、文件类型、文件大小等文件元数据信息,但最重要的是存储了该文件的真实数据存放在磁盘上的哪些Block中。
|
||||
|
||||
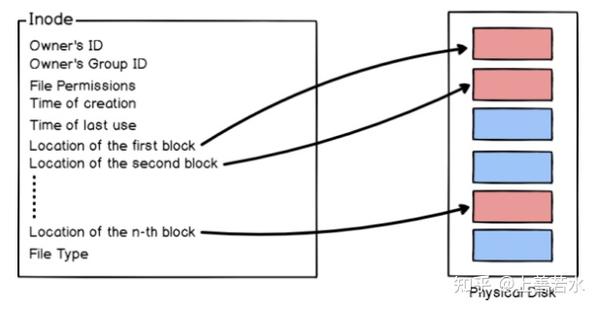
|
||||
|
||||
需要注意的是`文件名不是 inode 的一部分。`
|
||||
|
||||
### 关于文件名和 inode
|
||||
|
||||
在 Linux 系统上,文件名保存在单独的索引中,这个单独的索引记录了系统上所有文件(包括目录)的文件名,并且它也知道每一个文件其对应的inode。
|
||||
|
||||
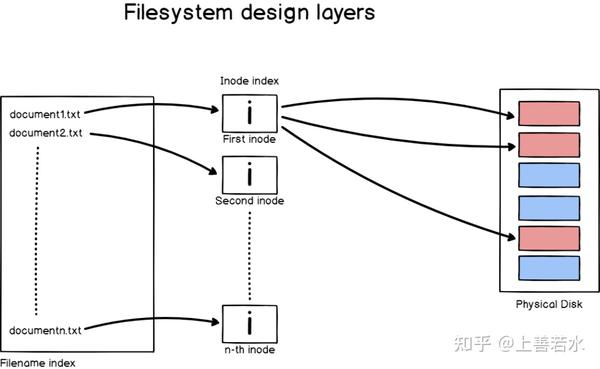
|
||||
|
||||
### Linux 上的硬链接和软链接是什么
|
||||
|
||||
有了上面的背景,现在我们可以来介绍硬链接和软链接了。
|
||||
|
||||
让我们从软链接开始,因为它可能是最容易理解的。
|
||||
|
||||
### 软链接
|
||||
|
||||
软链接,也称为符号链接,运行 ls 命令时,符号链接用文件类型“ l ”标识,同时文件名那一列是`链接名称 -> 所引用文件的文件名。`
|
||||
|
||||

|
||||
|
||||
|
||||
|
||||
这个图中,文件“shortcut”指向我文件系统上的文件“file.txt ”。
|
||||
|
||||
现在我们来看一下原文件file.txt的 inode 和shortcut的 inode。
|
||||
|
||||
```text
|
||||
$ stat shortcut
|
||||
File: shortcut -> file.txt
|
||||
Size: 3 Blocks: 0 IO Block: 4096 symbolic link
|
||||
Device: fc01h/64513d Inode: 258539 Links: 1
|
||||
|
||||
$ stat file.txt
|
||||
File: job
|
||||
Size: 59 Blocks: 8 IO Block: 4096 regular file
|
||||
Device: fc01h/64513d Inode: 258545 Links: 2
|
||||
```
|
||||
|
||||
可以看出,两个文件的 inode不同,但是两者也有一定的关联:原始文件 inode 直接指向文件内容(即包含实际数据的块),而符号链接“shortcut”的 inode 指向包含原始文件路径的块。
|
||||
|
||||
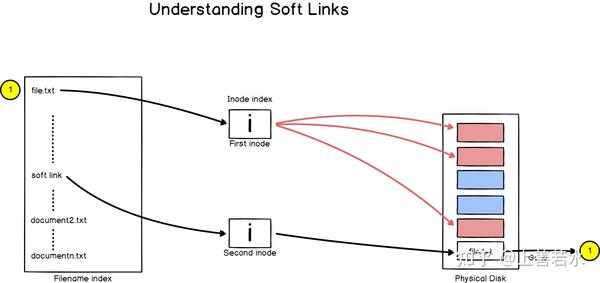
|
||||
|
||||
不难看出,软链接下,链接文件和原始文件是共享文件的实际数据,这意味着如果我修改链接 文件的内容,其实就是修改了原始文件的内容。
|
||||
|
||||
如果我删除链接文件,它只会删除对第一个 inode(原始文件的 inode) 的引用。由于原始文件的 inode仍然引用磁盘上文件的内容,因此内容不会丢失,但是,如果我删除原始文件,将无法再读取该文件,符号链接会变成一个“断开”的链接,因为它指向的文件已经不存在了,这就是我们所说的悬空符号链接,即未指向任何内容的链接。
|
||||
|
||||
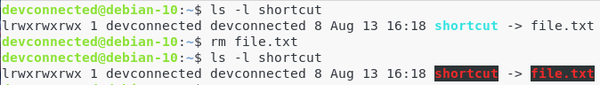
|
||||
|
||||
|
||||
|
||||
现在,我们来思路另外一个问题:软链接的大小是多少?
|
||||
|
||||
为了说明这个问题,下面我创建了一个名为“devconnected”的文件,并使用 ln 命令为它建立了一个软链接。
|
||||
|
||||
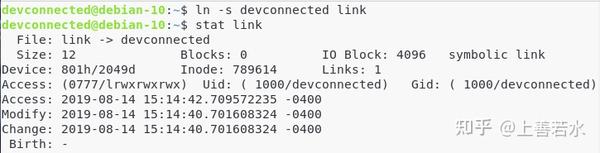
|
||||
|
||||
可以看出软链接的大小是12,这个大小正好是原始文件名 “devconnected”的长度。
|
||||
|
||||
最后需要说明的是:软链接可以指向不同的文件系统,包括指向远程文件系统。如果您使用 NFS(网络文件系统),则可以创建从一个文件系统到网络访问的文件系统的软链接。
|
||||
|
||||
### 硬链接
|
||||
|
||||
我们再来看一下原始文件 inode和硬链接 inode。
|
||||
|
||||
```text
|
||||
$ stat hardlink
|
||||
File: hardlink
|
||||
Size: 59 Blocks: 8 IO Block: 4096 regular file
|
||||
Device: fc01h/64513d Inode: 258545 Links: 2
|
||||
|
||||
$ stat file.txt
|
||||
File: file.txt
|
||||
Size: 59 Blocks: 8 IO Block: 4096 regular file
|
||||
Device: fc01h/64513d Inode: 258545 Links: 2
|
||||
```
|
||||
|
||||
您可能已经注意到,inode 是相同的,但是文件名不同!
|
||||
|
||||
以下是此情况下文件系统发生的情况。
|
||||
|
||||
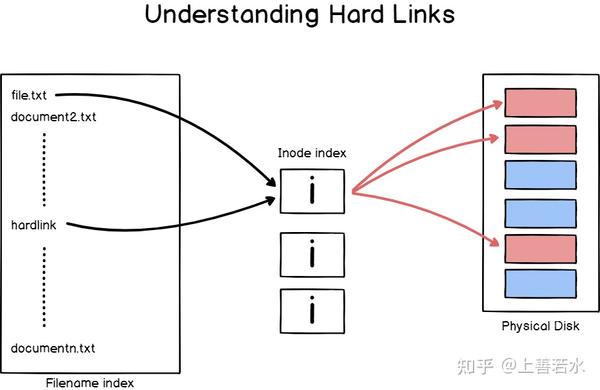
|
||||
|
||||
因此,如果修改硬链接文件中的内容,则原文件中的内容也会改变,同样地,如果你修改了原始文件中的内容,那么在硬链接文件中也会被修改。
|
||||
|
||||
但是,如果删除硬链接文件,您仍然可以访问原始文件内容,同样,删除原始文件不会对硬链接的内容产生任何影响,`这也是和软链接一个显著的不同点。`
|
||||
|
||||
最后需要注意的一点是`不能为目录创建硬链接`。
|
||||
|
||||
### 链接相关操作
|
||||
|
||||
### 创建软链接
|
||||
|
||||
要创建软链接,需要使用ln命令,带有-s选项(表示符号)和两个参数,第一个参数指定想要链接到的原文件名称,第二个参数指定即将创建的软链接的名称。
|
||||
|
||||
```text
|
||||
$ ln -s file shortcut
|
||||
|
||||
$ ls -l
|
||||
-rw-rw-r-- 1 schkn schkn 0 Aug 14 20:12 file
|
||||
lrwxrwxrwx 1 schkn schkn 4 Aug 14 20:12 shortcut -> file
|
||||
```
|
||||
|
||||
还可以创建到目录的软链接:
|
||||
|
||||
```text
|
||||
$ mkdir folder
|
||||
$ ln -s folder shortcut-folder
|
||||
|
||||
$ ls -l
|
||||
drwxrwxr-x 2 schkn schkn 4096 Aug 14 20:13 folder
|
||||
lrwxrwxrwx 1 schkn schkn 7 Aug 14 20:14 shortcut-folder -> folder/
|
||||
```
|
||||
|
||||
### 删除软链接
|
||||
|
||||
要删除现有的软链接,使用unlink命令,后面的参数是要删除的软链接名称。
|
||||
|
||||
```text
|
||||
$ unlink shortcut
|
||||
|
||||
$ ls -l
|
||||
-rw-rw-r-- 1 schkn schkn 0 Aug 14 20:12 file
|
||||
```
|
||||
|
||||
### 创建硬链接
|
||||
|
||||
创建硬链接也是使用ln命令,只是不需要-s选项。
|
||||
|
||||
```text
|
||||
$ ln file hardlink
|
||||
|
||||
$ ls -l
|
||||
-rw-rw-r-- 2 schkn schkn 0 Aug 14 20:12 file
|
||||
-rw-rw-r-- 2 schkn schkn 0 Aug 14 20:12 hardlink
|
||||
```
|
||||
|
||||
### 删除硬链接
|
||||
|
||||
同样,可以使用unlink命令删除 Linux 系统上的硬链接。
|
||||
|
||||
```text
|
||||
$ ln file hardlink
|
||||
$ unlink hardlink
|
||||
$ ls -l
|
||||
-rw-rw-r-- 2 schkn schkn 0 Aug 14 20:12 file
|
||||
```
|
||||
|
||||
### 查找系统上的链接
|
||||
|
||||
在 Linux 系统上可以使用find 命令查找链接,find 命令有一个选项可以指定类型来查找文件,因此可以使用它来查找系统上的链接:
|
||||
|
||||
```text
|
||||
$ find . -type l -ls
|
||||
262558 0 lrwxrwxrwx 1 schkn schkn 7 Aug 14 20:14 ./shortcut-folder2 -> folder2/
|
||||
262558 0 lrwxrwxrwx 1 schkn schkn 7 Aug 14 20:14 ./shortcut-folder -> folder/
|
||||
```
|
||||
|
||||
[编辑于 2024-07-09 19:19](https://zhuanlan.zhihu.com/p/707875954)
|
||||
@@ -0,0 +1,21 @@
|
||||
硬盘大小120G,安装系统时选择了自动分区,结果进系统后发现有个/backup挂载点占了40G的空间,于是准备把这个挂载点删除,把空出来的40G分给根。
|
||||
|
||||
开始操作
|
||||
|
||||
1、查看[逻辑卷](https://so.csdn.net/so/search?q=%E9%80%BB%E8%BE%91%E5%8D%B7&spm=1001.2101.3001.7020)
|
||||
|
||||
> lvdisplay
|
||||
|
||||
2、删除挂载到/backup的逻辑卷
|
||||
|
||||
> lvremovo /dev/mapper/klas-backup
|
||||
|
||||
3、把空闲出来的存储空间加到/下
|
||||
|
||||
> lvextend -L +40G /dev/mapper/klas-root
|
||||
|
||||
4、执行调整,使之生效
|
||||
|
||||
> xfs_growfs /
|
||||
|
||||
注意最后一步xfs_growfs后面跟的是挂载点,不是设备名。
|
||||
Reference in New Issue
Block a user