vault backup: 2026-11-07 16:33:44
This commit is contained in:
 cheney
@@ -0,0 +1 @@
|
||||
![[Pasted image 20260309094053.png]]
|
||||
@@ -0,0 +1,9 @@
|
||||
- 先写文档后开发代码
|
||||
- 限定 markdown 文件长度。按章节分模块编写。
|
||||
- 每个独立的模块,重开会话,重置上下文。
|
||||
|
||||
|
||||
|
||||
|
||||
https://github.com/CursorTouch/Windows-MCP
|
||||
https://github.com/ahujasid/blender-mcp
|
||||
@@ -0,0 +1,10 @@
|
||||
## 需求分析
|
||||
|
||||
|
||||
## 设计
|
||||
|
||||
|
||||
## 开发
|
||||
|
||||
### 代码评审
|
||||
你是一个严格的代码评审员,扫描项目下所有代码,编写风格、安全性、性能影响等方面给出建议,输出到项目根目录 ”docs/代码评审记录.md“ 文件中。
|
||||
@@ -0,0 +1,9 @@
|
||||
|
||||
需求分析
|
||||
设计
|
||||
开发
|
||||
检查
|
||||
|
||||
|
||||
检查拼写错误、安全风险
|
||||
|
||||
@@ -0,0 +1,122 @@
|
||||
|
||||
> 地址:`http://bh.vps.honor3.com:3000`
|
||||
> 一句话:**读用 MCP(免密钥),写用 REST(要 `X-Ingest-Key`)**。
|
||||
|
||||
---
|
||||
|
||||
## 1. 接入 MCP(只读,无需密钥)
|
||||
|
||||
MCP 端点是 `POST http://bh.vps.honor3.com:3000/mcp`,走标准 JSON-RPC 2.0,
|
||||
**不校验任何密钥**,只暴露只读工具。
|
||||
|
||||
客户端配置(Claude Desktop / Cursor / Cherry Studio 通用):
|
||||
|
||||
```json
|
||||
{
|
||||
"mcpServers": {
|
||||
"awesome-index": {
|
||||
"url": "http://bh.vps.honor3.com:3000/mcp"
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
手动测试(curl):
|
||||
|
||||
```bash
|
||||
curl -s -X POST "http://bh.vps.honor3.com:3000/mcp" \
|
||||
-H "Content-Type: application/json" \
|
||||
-H "Accept: application/json, text/event-stream" \
|
||||
-d '{"jsonrpc":"2.0","id":1,"method":"tools/list","params":{}}'
|
||||
```
|
||||
|
||||
⚠️ 必须带 `Accept: application/json, text/event-stream`,否则会被拒。
|
||||
|
||||
---
|
||||
|
||||
## 2. 四个只读工具
|
||||
|
||||
| 工具 | 参数 | 用途 |
|
||||
| --- | --- | --- |
|
||||
| `search_entries` | `q`(必填,关键字)、`limit`(1–50,默认 20) | 按关键字/类型/标签搜索 |
|
||||
| `get_entry` | `slug`(必填,也可传标题关键字自动匹配) | 取单条详情 |
|
||||
| `random_entry` | 无 | 随机抽一条,用于发现 |
|
||||
| `list_tags` | 无 | 列全部标签组与数量 |
|
||||
|
||||
调用示例:
|
||||
|
||||
```bash
|
||||
curl -s -X POST "http://bh.vps.honor3.com:3000/mcp" \
|
||||
-H "Content-Type: application/json" \
|
||||
-H "Accept: application/json, text/event-stream" \
|
||||
-d '{"jsonrpc":"2.0","id":2,"method":"tools/call",
|
||||
"params":{"name":"search_entries","arguments":{"q":"自托管相册","limit":5}}}'
|
||||
```
|
||||
|
||||
结果在 `result.content[0].text` 里,是一段 JSON 字符串,需再解析一次。
|
||||
|
||||
---
|
||||
|
||||
## 3. 提交条目(写入,要密钥)
|
||||
|
||||
```bash
|
||||
curl -X POST "http://bh.vps.honor3.com:3000/api/ingest/entry" \
|
||||
-H "X-Ingest-Key: sk-test" \
|
||||
-H "Content-Type: application/json" \
|
||||
-d '{
|
||||
"title": "MinerU",
|
||||
"url": "https://github.com/opendatalab/MinerU",
|
||||
"type": "工具",
|
||||
"summary": "PDF/文档转 Markdown 的解析引擎",
|
||||
"tags": ["Python", "OCR", "文档解析"]
|
||||
}'
|
||||
```
|
||||
|
||||
成功返回:`{"ok":true,"data":{"created":true,"id":54,"status":"pending"}}`
|
||||
|
||||
中文内容建议存成 `.json` 文件再 `-d @file.json`,避免 shell 编码踩坑;
|
||||
Windows 下用 Python `json.dumps(..., ensure_ascii=False).encode('utf-8')` 最稳。
|
||||
|
||||
---
|
||||
|
||||
## 4. 字段规则
|
||||
|
||||
| 字段 | 必填 | 约束 |
|
||||
| --- | --- | --- |
|
||||
| `title` | ✅ | 标题 |
|
||||
| `url` | ✅ | 合法 URL,**用于去重** |
|
||||
| `type` | ✅ | 只能是:`微服务` `SaaS` `网站` `工具` `应用` `脚本` `插件` |
|
||||
| `summary` | ❌ | ≤ 200 字符 |
|
||||
| `description_md` | ❌ | ≤ 5000 字符,支持 Markdown |
|
||||
| `license` | ❌ | 如 `MIT`、`GPL-3.0` |
|
||||
| `stars` | ❌ | 整数 |
|
||||
| `tags` | ❌ | 字符串数组 |
|
||||
| `status` | ❌ | `pending` / `active` |
|
||||
|
||||
**`slug` 不是合法字段**,传了会被静默丢弃。
|
||||
|
||||
---
|
||||
|
||||
## 5. 五个坑(记牢就够)
|
||||
|
||||
1. **认证头是 `X-Ingest-Key`**。`Authorization: Bearer`、`X-API-Key`、`?key=` 全部 403。
|
||||
2. **MCP 免密钥 ≠ 密钥有效**。`/mcp` 根本不查 key,别拿它验证密钥。
|
||||
3. **提交后默认 `pending`**,前台搜不到是正常的,要等管理员审核变 `active`。
|
||||
4. **同 URL 重复提交返回 200 `created:false`**,不是报错,说明已存在。
|
||||
5. **`/api/entries` 也能写**(未登录时回退到 AI key 校验),但推荐用 `/api/ingest/entry`。
|
||||
|
||||
---
|
||||
|
||||
## 6. 典型工作流
|
||||
|
||||
```
|
||||
1. search_entries 查重 → 已有就 get_entry 看详情,别重复提交
|
||||
2. WebSearch / WebFetch 收集项目信息
|
||||
3. 组装 JSON(title + url + type 三个必填)
|
||||
4. POST /api/ingest/entry(X-Ingest-Key)
|
||||
5. 记下返回的 id,状态 pending
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
*整理于 2026-10-27 · 已在 MinerU / Mio CUA / Windows-Use / Transub / TinyJS / Quickemu / nanoMuse 七个条目上验证*
|
||||
@@ -0,0 +1,126 @@
|
||||
---
|
||||
page-title: "(68 封私信 / 21 条消息) 首页 - 知乎"
|
||||
url: https://www.zhihu.com/follow
|
||||
web-message:
|
||||
web-badge-color: ""
|
||||
web-badge-message:
|
||||
date: "2024-04-08 16:28:24"
|
||||
---
|
||||
|
||||
> 使用AI来生成一部分代码比较常见,那你考虑过让AI完成整个项目吗?
|
||||
>
|
||||
> 今天我们介绍的开源项目,它希望为世界上第一位人工智能开发伙伴,可独立完成95%的开发任务,它就是:**GPT Pilot**
|
||||
>
|
||||
> 
|
||||
>
|
||||
> ## GPT Pilot 是什么
|
||||
>
|
||||
> GPT Pilot 旨在提供第一个真正的 AI 开发伙伴。不仅仅是一个自动完成功能或 PR 消息的助手,而是一个真正的 AI 开发人员,可以编写完整的功能、调试它们、与您讨论问题、请求审核等。
|
||||
>
|
||||
> 本项目的核心目的是,在开发人员的监督下,探究有多少 LLM 可以用于生成完全可工作的、生产就绪的应用程序。项目作者的观点是,在人工智能取得全面性的进展之前,人工智能可以为应用程序编写绝大部分代码(可能达到95%),但对于剩余的5%,开发人员仍然是不可或缺的。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> GPT Pilot 是 Pythagora 的核心技术,而 Pythagora 是一款VS Code插件,接下来我们就来看下如何安装和使用GPT Pilot。
|
||||
>
|
||||
> ## 安装GPT Pilot
|
||||
>
|
||||
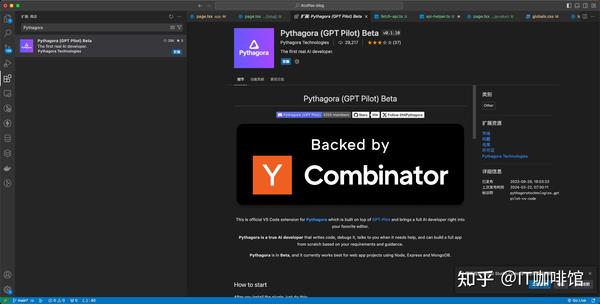
> 如果您使用 VS Code 作为 IDE,最简单使用GPT Pilot 的方法是下载它的VSCode 插件。在vscode中它的名字叫Pythagora。
|
||||
>
|
||||
> 
|
||||
>
|
||||
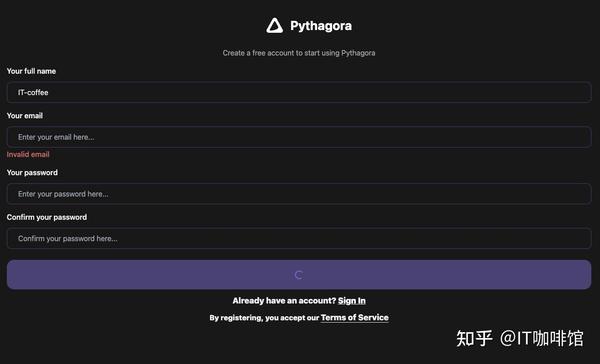
> 安装完成插件以后,首先需要注册一个账号。
|
||||
>
|
||||
> 
|
||||
>
|
||||
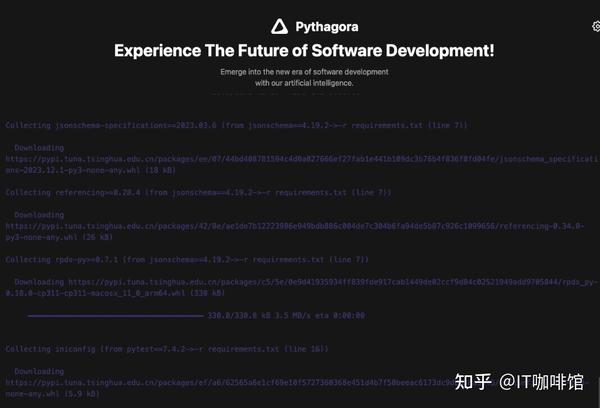
> 注册完成后会让我们回答一些问题,然后会自动安装gpt-pilot,对它不仅仅只有插件,是要装很多东西的。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> 除了使用VScode外,你也可以自己安装,然后通过CLI来试用。配置方法如下:
|
||||
>
|
||||
> ```
|
||||
> 首先需要安装Python 3.9+ 和 PostgreSQL。
|
||||
> 安装 Python 和(可选)PostgreSQL 后,请按照以下步骤操作:
|
||||
>
|
||||
> git clone <https://github.com/Pythagora-io/gpt-pilot.git(克隆存储库)>
|
||||
> cd gpt-pilot
|
||||
> python -m venv pilot-env(创建虚拟环境)
|
||||
> source pilot-env/bin/activate(或在 Windows 上pilot-env\\Scripts\\activate)(激活虚拟环境)
|
||||
> pip install -r requirements.txt(安装依赖项)
|
||||
> cd pilot
|
||||
> mv .env.example .env(或在 Windows 上copy .env.example .env)(创建 .env 文件)
|
||||
> 将您的环境添加到.env文件中:
|
||||
> ·LLM 提供商(OpenAI/Azure/Openrouter)
|
||||
> ·您的 API 密钥
|
||||
> ·数据库设置:SQLite/PostgreSQL(从SQLite更改为PostgreSQL,只需设置DATABASE_TYPE=postgres)
|
||||
> ·可以选择为工作区中 GPT Pilot 不应跟踪的文件夹设置 IGNORE_PATHS,这对于忽略编译器创建的文件夹很有用(即IGNORE_PATHS=folder1,folder2,folder3)
|
||||
> python main.py(启动 GPT Pilot)
|
||||
> ```
|
||||
>
|
||||
> 还有一种方式是通过docker来试用gpt-pilot,这里就不介绍了,请参考文档配置。
|
||||
>
|
||||
> ## 使用 GPT Pilot
|
||||
>
|
||||
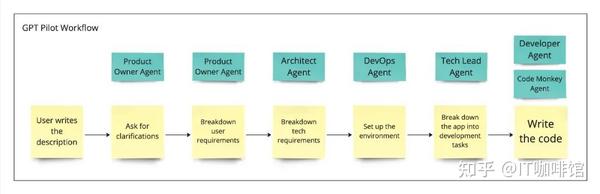
> 安装完成后,我们就可以开始使用了。首先我们来看一下gpt-pilot的整体执行流程。在项目执行过程中,它能够自动提出问题,并根据我们的答案,模拟与复现开发一个项目时的完整流程。整个执行的流程是如下这样的。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> GPT Pilot 会先询问我们一系列问题,来确定应用类型,产品需求和技术要求,然后基于这些问答内容,自动完成环境配置,编写代码。
|
||||
>
|
||||
> 以下是 GPT Pilot 创建应用程序所需的步骤:
|
||||
>
|
||||
> 1. 输入应用程序名称和说明。
|
||||
> 2. 产品负责人代理:就像现实生活中一样,什么都不做。 :)
|
||||
> 3. 如果项目描述不够好,规范编写代理:会询问几个问题,以便更好地理解需求。
|
||||
> 4. 架构师代理:编写将用于应用程序的技术,并检查计算机上是否安装了所有技术,如果没有,则安装它们。
|
||||
> 5. 技术主管代理:编写开发人员必须实施的开发任务。
|
||||
> 6. 开发人员代理:接受每项任务并写下实施该任务所需执行的操作。该描述采用人类可读的形式。
|
||||
> 7. Code Monkey 代理:获取开发人员的描述和现有文件并实施更改。
|
||||
> 8. 审核者代理:会审核任务的每一步,如果出现问题,审核者会将其发送回 Code Monkey。
|
||||
> 9. 故障排除代理:可帮助您在出现问题时向 GPT Pilot 提供良好的反馈。
|
||||
> 10. 调试器代理:讨厌见到他,但当事情不顺利时,他是你最好的朋友。
|
||||
> 11. 技术作家代理:为项目编写文档。
|
||||
>
|
||||
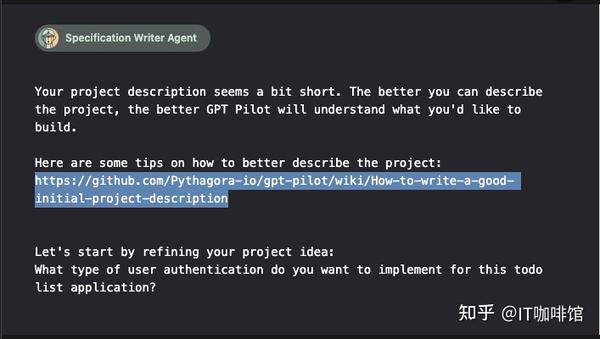
> 
|
||||
>
|
||||
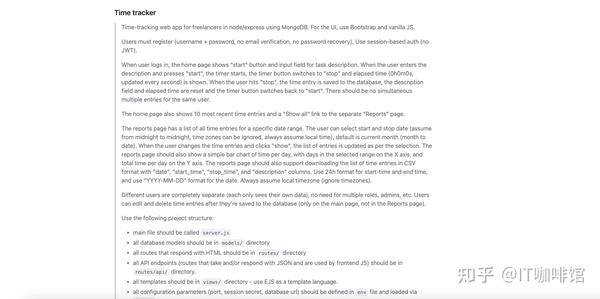
> 使用的时候需要给项目写非常详细的描述,其实可以理解为这就是在对大模型写prompt,所以写的越好那开发的效果越好。项目提供了一个专门介绍写描述的wiki,这里我就抄一个提供的示例来看看效果。
|
||||
>
|
||||
> 
|
||||
>
|
||||
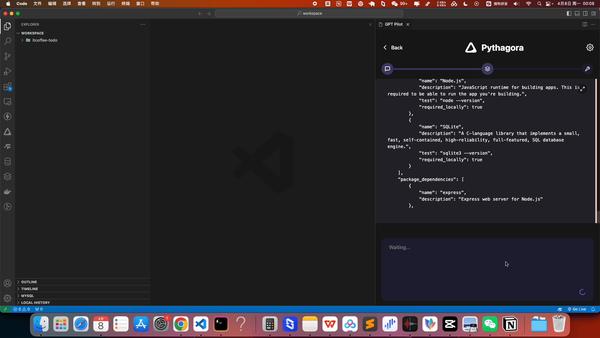
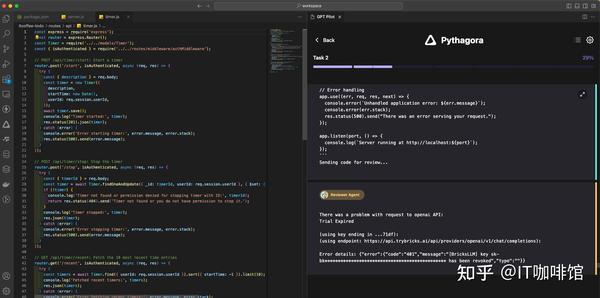
> 接下来就是回答一些问题,我们在这整个过程中,只需扮演好项目管理者的角色,检查 AI 完成的代码是否符合标准,并在适当的时候给予其指引,让 AI 能在正确的方向上持续编写与迭代项目。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> 相对来说,GPT Pilot 是一种监督性的AI编程,并没有完全把人排除在外,这样实际上也是目前更好的模式。
|
||||
>
|
||||
> 
|
||||
>
|
||||
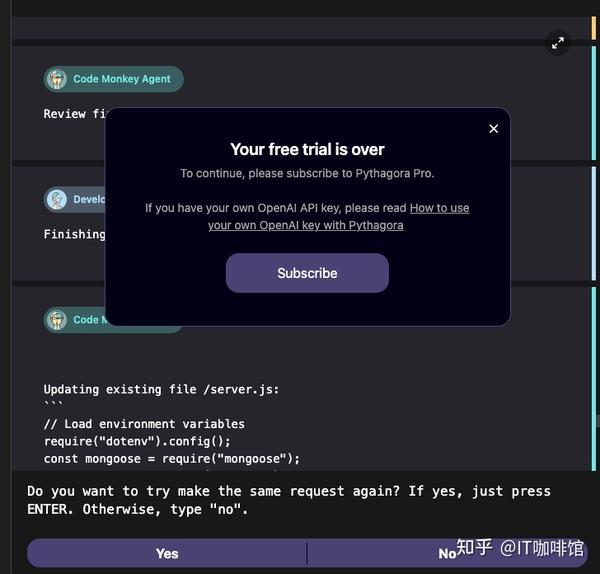
> 这里也有比较坑的地方,执行了一半免费体验用光了,所以建议从一开始就使用自己的 OpenAI key。
|
||||
>
|
||||
> 
|
||||
>
|
||||
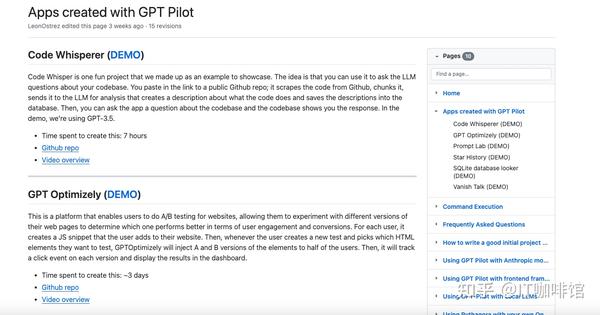
> 项目里还提供了多个使用GPT Pilot开发的程序实例,可以直接查看。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> ## 总结
|
||||
>
|
||||
> GPT Pilot的主要用途是帮助开发人员更快速地构建应用程序。它的设计上实现了现在非常前言的多智能体设计,通过多个不同角色的ai agent协同工作来完成一个复杂的开发任务。关于多智能体,最新的吴恩达演讲中也提出了很多内容,非常值得研究一下。
|
||||
>
|
||||
> 它的过程更加贴合目前可接受的方式,您则负责监督开发过程,AI来完成任务执行。当GPT Pilot完成每个任务或遇到困难时,它会要求您审查任务或在需要时提供帮助。
|
||||
>
|
||||
> 从目前来说可以将gpt-pilot使用在以下方面:
|
||||
>
|
||||
> 1. **快速原型开发**:您可以使用GPT Pilot快速创建应用程序的原型,以便在不浪费太多时间的情况下验证概念。
|
||||
> 2. **自动代码生成**:GPT Pilot可以生成应用程序的大部分代码,从设置路由和数据库连接到编写用户界面。
|
||||
> 3. **技术建议**:它还可以为应用程序选择合适的技术栈和工具,以满足特定需求。
|
||||
> 4. **教育和学习**:开发人员可以使用GPT Pilot来了解如何构建不同类型的应用程序,学习最佳实践,并查看实际代码示例。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> ## 项目信息
|
||||
>
|
||||
> - 项目名称: gpt-pilot
|
||||
> - GitHub 链接:[https://github.com/Pythagora-io/gpt-pilot](https://link.zhihu.com/?target=https%3A//github.com/Pythagora-io/gpt-pilot)
|
||||
> - Star 数:27K+
|
||||
@@ -0,0 +1,313 @@
|
||||
---
|
||||
page-title: "GPT 应用开发和思考"
|
||||
url: https://guangzhengli.com/blog/zh/gpt-embeddings/
|
||||
web-message:
|
||||
web-badge-color: ""
|
||||
web-badge-message:
|
||||
date: "2024-04-08 16:55:06"
|
||||
---
|
||||
|
||||
> 在过去几个月的时间中,我们似乎正处于人工智能的革命中。除了大多数人了解的 OpenAI ChatGPT 之外,许多非常新颖、有趣、实用的 AI 应用也是层出不穷,并且在使用这些应用时时,笔者也确确实实的感受到了生产力的提高。
|
||||
>
|
||||
> 但是关于 GPT 应用的开发知识和路线,目前似乎还没有太多的资料,所以笔者决定将自己的一些经验和思考整理成一个系列,希望能够帮助到大家。
|
||||
>
|
||||
> 本篇文章主要介绍的是 GPT 相关应用的开发思考,在今年 4 月份的时候,笔者因为开发 [ChatFiles](https://github.com/guangzhengli/ChatFiles) 这个开源项目,从而学习了 GPT 相关的技术知识,但是由于笔者的时间精力有限,所以一直没有机会将这些知识整理成一篇文章,直到最近笔者又因为有了新的想法,开源了 [VectorHub](https://github.com/guangzhengli/vectorhub) 这个同样基于 GPT Prompt 和 Embeddings 技术的项目,进而对 GPT 和 Embeddings 等技术知识有了更深入的了解,所以就有了这一篇分享。
|
||||
>
|
||||
> ## 从 Prompt 开始
|
||||
>
|
||||
> AI 应用开发在过去一段时间内吸引了众多开发者入场,除了大家所熟知的 ChatGPT 之外,还涌现了大量有实际价值的 AI 应用,例如基于 AI 的翻译类的应用如 [openai-translator](https://github.com/openai-translator/openai-translator)、[immersivetranslate](https://immersivetranslate.com/),写作类的应用如 [Notion AI](https://www.notion.so/product/ai),编程辅助类的应用如 [GitHub Copilot](https://github.com/features/copilot) 和 [GitHub Copilot Chat](https://docs.github.com/en/copilot/github-copilot-chat/using-github-copilot-chat?tool=vscode)。
|
||||
>
|
||||
> 这些应用有些是优化了原有的体验,如基于 GPT 的翻译的 [openai-translator](https://github.com/openai-translator/openai-translator),翻译质量和阅读体验远胜于之前的机器翻译,还有些则是提供了之前无法实现的功能,如 [GitHub Copilot](https://github.com/features/copilot) 的代码补全和生成,还有像 [GitHub Copilot Chat](https://docs.github.com/en/copilot/github-copilot-chat/using-github-copilot-chat?tool=vscode) 提供回答编码相关问题、解释代码、生成单元测试、给错误代码提出修复意见等等功能,这些功能的实现难度在以前是完全无法想象的。
|
||||
>
|
||||
> 这些应用在功能上虽然没有相似之处,但是在实现原理中,它们都是主要基于 GPT 的 Prompt(提示)实现。Prompt 指的是提供给模型的文本或指令,可以用来引导模型生成自然语言输出(Completion)。它可以给模型提供上下文信息,对模型的输出结果至关重要。
|
||||
>
|
||||
> 我们知道 GPT(Generative Pre-trained Transformer)是一个推理模型,它主要基于预训练和微调两个阶段。
|
||||
>
|
||||
> 在预训练阶段会使用一个大规模的语料库进行基础训练,例如使用维基百科、新闻文章、小说等来进行训练。当训练完成后,输入一句话给它,它会基于这句话给出一个概率上的预测,预测后续应该拼接上什么单词,这个拼接的单词是基于它在预训练阶段学习到的知识来进行概率选定的,通过一次次循环的单词预测,最终可以拼接出一段话来。这也是它被称为生成式 AI 的原因。
|
||||
>
|
||||
> 这一句话就是我们所说的 Prompt,也是生成式 AI 概率生成的基础。这能解释为什么我们每次输入相同的 Prompt,但是每次得到的结果都会有所不同,因为每次的结果都是基于概率生成的。
|
||||
>
|
||||
> 所以我们也就能理解为什么 Prompt 对于 GPT 应用开发的重要性,因为它是除了微调以外,我们能与 GPT 模型唯一的交互方式(当然除此之外还可以通过调整模型的 temperature 和 top\_p 两个配置来控制 GPT 更多样化或更具创造性的输出,不过对于输出质量和对下游任务的处理能力并无明显影响)。所以 Prompt 是 GPT 应用开发最核心的部分,也是最需要开发者去思考和优化的部分。
|
||||
>
|
||||
> 在预训练完成后,在微调阶段会将 GPT 模型加载到特定的任务上,并使用该任务的数据集对模型进行训练。这样,模型就可以根据任务的要求进行微调,以便更好地理解 Prompt 并生成与任务相关的文本。通过微调,GPT 可以适应不同的任务,如文本分类、情感分析、问答系统等。不过目前微调因为成本昂贵和最终效果并不稳定,对于广大 GPT 开发者来讲,并不是非常好的选择,所以目前大部分的 GPT 应用开发者都是基于 Prompt 来开发应用。
|
||||
>
|
||||
> ## Prompt 学习路线
|
||||
>
|
||||
> 关于 Prompt 的基础知识,可以先去看看吴恩达老师的 [ChatGPT Prompt 工程](https://www.deeplearning.ai/short-courses/chatgpt-prompt-engineering-for-developers/)。可以通过两个小时不到的视频可以快速的了解 Prompt 的使用方式和它的魅力所在。
|
||||
>
|
||||
> 在有了一个初步的了解之后,笔者推荐 [Prompt Engineering Guide](https://www.promptingguide.ai/) 这份文档,该文档包含了大量的 Prompt 基础知识和未来的发展方向,对于 GPT 应用开发者来说,除了学习 Prompt 的基础知识之外,还可以从中获取到一些工程界和学术界对于 Prompt 的发展方向的思考,对于开发 AI 应用来说,这些思考弥足珍贵。
|
||||
>
|
||||
> 最后,非常推荐大家去看看 OpenAI 官方的 [GPT 最佳实践](https://platform.openai.com/docs/guides/gpt-best-practices) 这份文档,它是由 OpenAI 官方提供的 GPT 最佳实践指南,里面包含了大量的 Prompt 示例和使用技巧,对于 GPT 应用开发者来说,是一份非常有价值的文档。因为它是 OpenAI 官方通过合作伙伴或者 Hackathon 等不同的方式,在不同的业务领域 GPT 应用开发中总结出来的最佳实践,对于开发者来讲非常有启发价值!下面是对这一份文档的摘录:
|
||||
>
|
||||
> ## Prompt 最佳实践
|
||||
>
|
||||
> 关于 Prompt 编写的最佳实践,最为推荐的当然是 OpenAI 官方出品的 [GPT 最佳实践](https://platform.openai.com/docs/guides/gpt-best-practices) 这份文档,但对于开发 GPT 应用来讲,笔者还是想结合这份最佳实践和一些自己的经验,给大家分享一些 GPT 开发的实践。
|
||||
>
|
||||
> ### 清晰和详细
|
||||
>
|
||||
> 现实中大部分开发者在平常使用 GPT 的时候,都是以解决编程问题或者询问问题为主,所以容易带入以往使用 Google 等搜索引擎的经验来使用和开发 GPT。
|
||||
>
|
||||
> 例如当你想知道如何用 Python 编写斐波那契数列的时候,如果在以前使用 Google 搜索引擎,你可能会输入 `python fibonacci`。因为这样就足够了,Google 是基于倒排索引和 PageRank 算法的,只需要输入关键字,就能得到高质量的网页答案。
|
||||
>
|
||||
> 所以只需要这种输入两个字的输入方式是最简单和最高效的,毕竟就算多输入几个字 `how to write python fibonacci` ,对于 Google 搜索引擎来讲,输出质量是相差不大的。
|
||||
>
|
||||
> 而如果你使用的是 GPT,像 `python fibonacci` 这样的输入对于 GPT 来说是非常不友好的,因为它无法清晰的理解你的意图,所以它可能会给出一些不相关的结果(根据不同模型的质量会略有差异)。
|
||||
>
|
||||
> 但如果你输入的是 `编写一个用 python 函数来高效地计算 fibonacci 数列。评论每一行代码以解释每一部分的作用以及为什么这样写`。这样的输入对于 GPT 来说就非常清晰和详细,它能够清晰的理解你的意图,所以它给出的结果也会更加准确,**在保证输出质量下限的同时,还可以提高输出质量的上限!**
|
||||
>
|
||||
> 这和开发者以往使用 Google 等搜索引擎的经验是完全不同的,也是 GPT 开发者和使用者最容易忽视的地方。笔者在今年很早的时候开发 [ChatFiles](https://github.com/guangzhengli/ChatFiles) 项目时,曾匿名收集过使用者的 Prompt,发现 95% 以上的使用者使用的都是非常简单的 Prompt,简单的甚至看起来有一种一字千金的感觉。
|
||||
>
|
||||
> 所以当开发者开发 GPT 应用时,一定要注意 Prompt 的清晰和详细,多试几次,选择一个输出质量稳定和格式相同的 Prompt,这是保证 GPT 应用质量的关键。
|
||||
>
|
||||
> ### 如何处理更加复杂的任务
|
||||
>
|
||||
> 相信所有开发者面对简单的场景任务,多花费一些时间来调整 Prompt,都能设计好程序的 Prompt 并得到不错的输出质量。但是面对复杂任务时,想要提高 GPT 的输出质量还需要两个非常重要的技巧:**让 GPT 推理而不是回答,和拆分任务进行引导**。
|
||||
>
|
||||
> #### 推理而不是回答
|
||||
>
|
||||
> 推理而不是回答是指在 Prompt 中,要求 GPT 模型不要立即判断正确与否或者立刻给出答案,而是引导模型进行深入思考。可以要求其先列出对问题的各种看法,对任务进行拆分,说明每一步的推理依据,然后再得出最终结论。在 Prompt 中添加逐步推理的要求,能让语言模型投入更多时间逻辑思维,输出结果也将更可靠准确。
|
||||
>
|
||||
> 举一个[OpenAI 官方的例子](https://platform.openai.com/docs/guides/gpt-best-practices/tactic-instruct-the-model-to-work-out-its-own-solution-before-rushing-to-a-conclusion),如果你需要 GPT 回答某一个学生的答案是否正确,Prompt 是 `判断学生的解决方案是否正确`的话,面对复杂的计算问题和答案,GPT 有很大的概率会给出错误的答案,因为 GPT 并不会像人一样先进行推理答案再进行回答,而是会立即给出判断。在短暂的判断中,就无法给出正确的答案(就好比人类无法在短时间计算复杂数学一样)。
|
||||
>
|
||||
> 所以如果我们的 Prompt 是 `首先自己解决问题,然后再将自己的解决方案与学生的解决方案进行比较,并评估学生的解决方案是否正确。在自己完成问题之前,不要确定学生的解决方案是否正确`。在 Prompt 中给出明确的引导和条件,就能够让 GPT 模型花费更多的时间推导答案,从而得到更加准确的结果。
|
||||
>
|
||||
> #### 拆分任务
|
||||
>
|
||||
> 拆分任务进行引导是指将一个复杂的任务拆分成多个子任务,然后分别引导 GPT 模型进行推理,最后将多个子任务的结果进行整合,得到最终的结果。这样做的好处是可以让 GPT 模型更加专注于一个子任务,从而提高输出质量。
|
||||
>
|
||||
> 举一个不太恰当的例子,当你需要对一本书籍进行摘要的时候,GPT 直接进行总体的摘要的效果并不好,我们可以使用一系列子任务来摘要每个部分。最后再汇总产生的摘要。
|
||||
>
|
||||
> 当然拆分任务也会带来一些新的问题,即当单个任务输出质量有问题时,整体的输出质量也会受其影响。加上目前的 token 费用不菲,拆分任务进行引导也会带来额外的成本。但是无论如何,目前关于如何设计和拆分复杂任务是所有 GPT 应用最需要思考,和维护自身 AI 应用护城河的核心问题,也是目前大模型 AI 框架像 LangChain 等项目的核心设计点,有空可以单独写一篇文章来讨论。
|
||||
>
|
||||
> ### 使用技巧
|
||||
>
|
||||
> 除了上述的一些比较重要的实践之外,还有一些小技巧对于开发应用也是非常有帮助,下面是笔者总结的一些使用技巧:
|
||||
>
|
||||
> - 提供少量示例(Few-Shot Prompting): 给模型一两个期望的输入输出样例,让模型了解我们的要求和期望的输出样式。
|
||||
> - Prompt 中要求结构化输出:以 Json 的方式输出,这样可以方便后续代码程序处理。
|
||||
> - 分隔符:使用分隔符像 `"""` 将不同的指令、上下文之间进行隔离,防止系统的 Prompt 和用户输入的 Prompt 混淆冲突。
|
||||
>
|
||||
> ## GPT Embedding 应用开发
|
||||
>
|
||||
> 在上面我们主要介绍了基于 Prompt 如何开发 AI 应用,但是有时候我们还会遇到新的问题。例如大模型的训练数据往往是基于几个月前、甚至是几年前的,当我们有一些需求场景是需要 GPT 应用提供最新的数据,例如基于最近的新闻来回答问题,或者根据私有文档来回答问题,这时候大模型本身就没有基于这些材料进行过训练,也就无法解决该类问题。
|
||||
>
|
||||
> 这个时候我们可以通过让模型使用参考文本来回答问题,例如我们的 prompt 可以写成:
|
||||
>
|
||||
> ```
|
||||
> 你将会得到一个由三个引号分隔的文档和一个问题。
|
||||
>
|
||||
> 你的任务是使用提供的文档回答问题,并引用用于回答问题的文本段落。
|
||||
>
|
||||
> 如果文档中没有包含回答该问题所需的信息,则简单地写下:“信息不足”。
|
||||
>
|
||||
> 如果提供问题的答案,必须附带引用注释。
|
||||
> 使用以下格式引用相关段落({"citation": …})。
|
||||
> ```
|
||||
>
|
||||
> 这种使用方式可以让 GPT 针对于我们给予它的参考文本进行回答,例如我们想问最新的世界杯冠军是谁,就可以附上最新的世界杯新闻的参考文本,这样 GPT 会先理解整篇新闻,再来问答问题。通过这种方式,就可以解决大模型针对于时效性和特定的下游任务的问题。
|
||||
>
|
||||
> 但是这种解决方案会带来另外一个问题,即参考文本长度限制的问题。GPT Prompt 是有大小限制的,像 gpt-3.5-turbo 模型它的限制是 4K tokens(~3000字),这意味着使用者最多只能输入 3000 字给 GPT 来理解和推理答案。
|
||||
>
|
||||
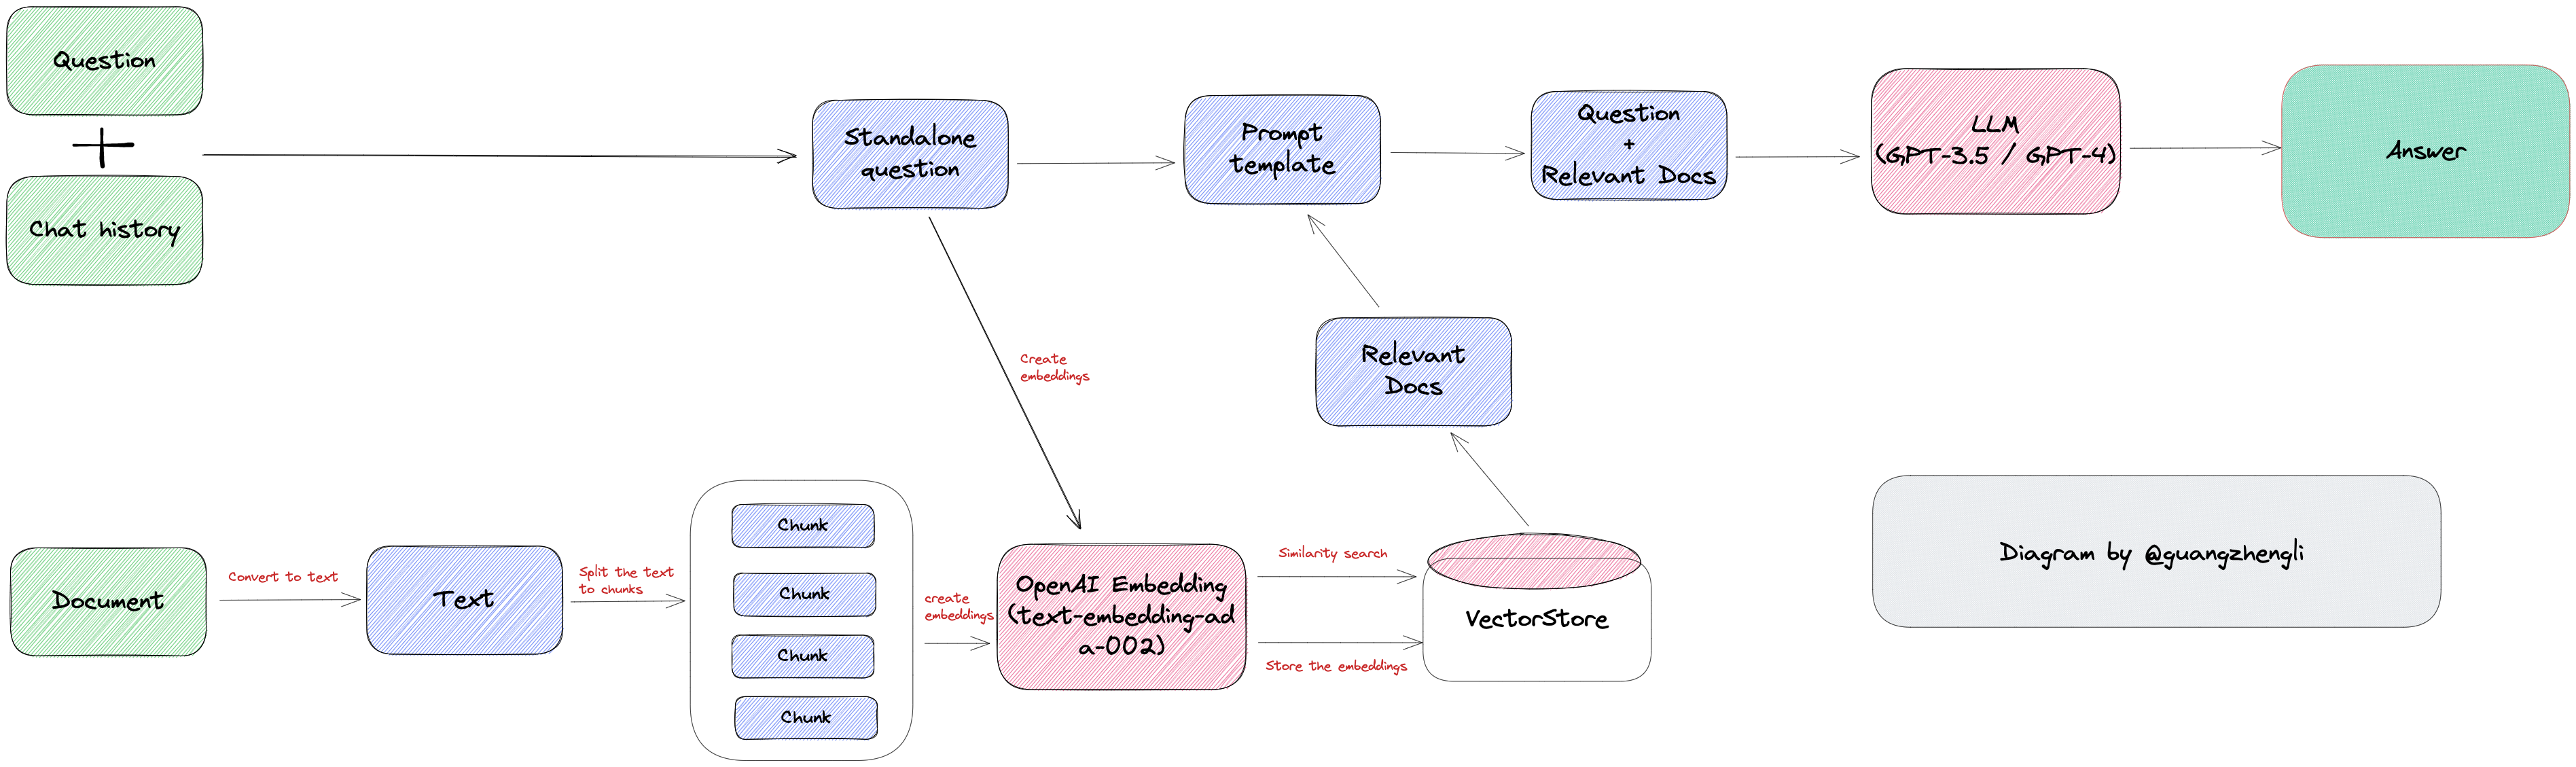
> 那么一旦需要的参考文本大于 3000 字,就无法一次性通过 GPT 得到答案,需要开发者想办法将参考文本拆分成多个部分,然后分别进行 GPT Embeddings 转化为向量存储到向量数据库中。关于向量数据库的更多信息,可以参考我另外一篇博客 [向量数据库](https://guangzhengli.com/blog/zh/vector-database/),当需要针对于参考文本进行提问时,需要先将问题转化为向量,然后通过向量数据库进行检索,最后再将检索到的向量转化为文本输出。这样就能得到符合 GPT tokens 限制的参考文本,并且这段参考文本是和问题具有关联的。
|
||||
>
|
||||
> 我们拿到问题本身和这段具有关联的参考文本,同时提交给 GPT,就能得到我们想要的答案。这个过程就是 GPT Embeddings 应用开发核心,它的核心思想是通过向量检索的方式检索与问题最相关的文本段,从而绕过 GPT tokens 的限制。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> 整体的开发流程如上图所示:
|
||||
>
|
||||
> 1. 加载文档,获取目标文本信息。例如 LLM 主流框架 LangChain 中 File Loader 和 Web Loader 的两种文本获取方式。
|
||||
> 1. 基于文件系统的 File Loader,如加载 PDF 文件、Word 文件等。
|
||||
> 2. 基于网络的 Web Loader,如某个网页,AWS S3 等。
|
||||
> 2. 将目标文本拆分为多个段落,拆分方式主要基于两种。
|
||||
> 1. 一种是基于文字数量的拆分法,例如 1000 字为一段,这种方式的优点是简单,缺点是可能会将一个段落拆分成多个段落,导致段落的连贯性变差,从而导致最终回答结果可能缺少上下文而降低回答质量。
|
||||
> 2. 另一种是基于标点符号的拆分法,例如以换行为分隔符,这种方式的优点是段落的连贯性好,缺点是每个段落大小不一,可能会导致触发 GPT tokens 的限制。
|
||||
> 3. 最后一种是基于 GPT tokens 限制的拆分法,例如以 2000 tokens 为一组,最终查询时搜索出最相关的两个段落,这样加到一起也才 4000 tokens,就不会触发到 4096 tokens 的限制。
|
||||
> 3. 将拆分的文本块统一存入 [向量数据库](https://guangzhengli.com/blog/zh/vector-database/) 中。
|
||||
> 4. 将用户问题转化为向量,然后通过向量数据库进行检索,得到最相关的文本段落。(需要注意的是,这里的检索并不是传统数据库的模糊匹配或者倒排索引,而是基于语义化的搜索能力,所以检索出的文本才能回答用户问题,详细请看另外一篇博客 \[向量数据库\](https://guangzhengli.com/blog/zh/vector-database/)
|
||||
> 5. 将检索出来的相关文本信息,用户问题和系统的 prompt 三个组合成一个针对于 Embeddings 场景的 Prompt,例如 Prompt 中明确写到使用参考文本回答问题,而不是 GPT 自己回答。
|
||||
> 6. GPT 回答最终得到的 Prompt,得到最终的答案。
|
||||
>
|
||||
> 如果你对具体的实现代码感兴趣,可以去看看 LangChain 中关于 [Retrieval 的章节](https://js.langchain.com/docs/modules/data_connection/)。
|
||||
>
|
||||
> GPT embeddings 应用能解决某些场景下 GPT 无法回答的问题,这是他最大的优点。无需训练,无需微调,只需要将文本转化为向量再通过检索就能实现,以低成本的方式就能让某些业务场景变成可能。
|
||||
>
|
||||
> 但这个方案同样会带来一些新的问题,例如 embeddings 文本拆分和检索的质量将在很大的程度上影响最终的结果,还有查询范围、质量和查询时间该如何均衡,检索出的参考文本无法回答用户问题时该如何处理?这都是开发者在面对业务需求和场景时需要仔细思考的问题。
|
||||
>
|
||||
> 如果思考更远一点,在人类过去的时间中,所有的文档都是面向人来编写,对于向量检索来说并不是最佳组织模式,以后是否会存在专门面向 AI 和检索编写的文本?让 AI 更好理解和更好符合数据库检索?不过这些问题需要长期的思考和论证,这里不再扩展。
|
||||
>
|
||||
> ## GPT Agents 应用开发
|
||||
>
|
||||
> 除了上述的 prompt 和 embeddings 两种方案能解决的业务需求外,GPT 应用开发还有一个非常常见的需求,即如何集成现有系统,或者说是如何集成现有 API。
|
||||
>
|
||||
> 因为软件行业已经发展了很多年,很多公司都有自己的系统和 API,这些 API 能够极大的提高 GPT 应用的能力边界。如果 GPT 应用想要在实际生活场景中落地,是不可避免的需要和现有系统进行集成。
|
||||
>
|
||||
> 就像如果你想要询问 GPT 一个非常简单的问题,今天北京的天气是什么?看完上面的章节,我们知道 GPT 自己是无法回答这类问题的,如果 GPT 能够自行调用某个天气 API,那么开发起来将非常的方便。
|
||||
>
|
||||
> 想要实现 GPT 调用查询天气这个 API 的需求,我们会面临两个问题,一个是让 GPT 应用理解某个 API 的功能,并在它觉得合适的时候调用;另一个是输入输出必须结构化,从而保证系统的稳定性。
|
||||
>
|
||||
> ### 理解和调用现有的 API
|
||||
>
|
||||
> 想让 GPT 理解某个 API 的功能,最佳的方式当然是开发者手动给 API 添加名字和具体的描述信息,包括输入和输出值的结构,和每个字段代表着什么意思,这能很大程度上影响 GPT 的判断,最后决定是否调用该 API。
|
||||
>
|
||||
> 如 OpenAI 官网中 [function calling 例子](https://openai.com/blog/function-calling-and-other-api-updates)中,关于调用天气 API 的描述如下所示。
|
||||
>
|
||||
> ```
|
||||
> function_descriptions = [
|
||||
> {
|
||||
> "name": "get_current_weather",
|
||||
> "description": "Get the current weather in a given location",
|
||||
> "parameters": {
|
||||
> "type": "object",
|
||||
> "properties": {
|
||||
> "location": {
|
||||
> "type": "string",
|
||||
> "description": "The city and state, e.g. San Francisco, CA",
|
||||
> },
|
||||
> "unit": {
|
||||
> "type": "string",
|
||||
> "description": "The temperature unit to use. Infer this from the users location.",
|
||||
> "enum": ["celsius", "fahrenheit"]
|
||||
> },
|
||||
> },
|
||||
> "required": ["location"],
|
||||
> },
|
||||
> }
|
||||
> ]
|
||||
> ```
|
||||
>
|
||||
> 上面的方法详细描述了如果需要调用该函数,至少需要提供当前所在的位置信息,并且可以选择性的提供温度单位。GPT 会根据问题是否和该函数的描述相关联,来决定是否调用该函数。具体的代码细节以后有几乎再写一篇,暂时不展开。
|
||||
>
|
||||
> 我们可以通过提供大量的 APIs 的说明文档,让 LLMs 理解并学会这些 APIs 的功能、使用方式、组合方式。最终达到根据提出的总体要求,将总体要求拆分为多个子任务,具体子任务再与某个 API 进行交互,最终达到自动化以及 AI 的目标。
|
||||
>
|
||||
> 我们这里描述的现有 APIs 并不仅仅是基于 HTTP 的请求,可以包括转化为 SQL 查询数据库,调用 SDK 实现复杂功能,甚至在未来,可以扩展为调用物理世界里面的开关、机械臂等。个人认为,基于目前已有的 GPT 能力和发展趋势,人机交互的方式将产生巨大的变化。
|
||||
>
|
||||
> ### 结构化输出
|
||||
>
|
||||
> 除了让 GPT 理解和调用现有的 API 之外,还需要让 GPT 输出的结果能够被现有系统所理解,这就需要 GPT 输出的结果是结构化的,例如 JSON 格式的数据。
|
||||
>
|
||||
> 那么你可能马上想到,我们通过 prompt 不就可以实现这种功能吗?在大部分情况下确实可以,但是有些少量的情况,prompt 并不如 function calling 的方式稳定,而我们传统的系统,对于稳定性的要求是非常高的,举个例子。
|
||||
>
|
||||
> ```
|
||||
> student_description=小王是北京大学计算机科学专业的二年级学生,绩点为 3.8 GPA。他的编程很厉害,是该大学机器人俱乐部的活跃成员。他希望在毕业后追求人工智能方面的工作。
|
||||
> ```
|
||||
>
|
||||
> 这段话中,我们可以通过 prompt 来要求输出的结构为 json 格式,例如 prompt 为
|
||||
>
|
||||
> ```
|
||||
> Please extract the following information from the given text and return it as a JSON object:
|
||||
>
|
||||
> name
|
||||
> major
|
||||
> school
|
||||
> grades
|
||||
> club
|
||||
>
|
||||
> This is the body of text to extract the information from:
|
||||
> {student_1_description}
|
||||
> ```
|
||||
>
|
||||
> 但是比较难处理的是,我们没有办法能够确定 GPT 最终会输出的 grades 是 `3.8` 还是 `3.8 GPA`,这两种输出结果对于人类来讲没有如何区别,但是对于计算机来讲,这两种输出结果是完全不同的,前者是一个浮点数,后者是一个字符串。对于某些语言来讲转换就会直接出错。
|
||||
>
|
||||
> 我们当然可以通过增加 prompt 的描述来减少这类问题,但是现实情况是比较复杂的,我们很难通过自然语言完全描述清楚需求,很难保证 GPT 的回答会每次都保持相同的输出。所以针对于这类问题,通过 OpenAI 提供的 function calling 的方式,能够在一定程度上解决自然语言与机器语言交互的问题。
|
||||
>
|
||||
> 就像上述的问题可以描述为一个函数,我们将 grades 这个字段描述为 integer 来避免这类问题。这种结构化的能力对于开发一个稳定的系统是至关重要的。
|
||||
>
|
||||
> ```
|
||||
> student_custom_functions = [
|
||||
> {
|
||||
> 'name': 'extract_student_info',
|
||||
> 'description': 'Get the student information from the body of the input text',
|
||||
> 'parameters': {
|
||||
> 'type': 'object',
|
||||
> 'properties': {
|
||||
> 'name': {
|
||||
> 'type': 'string',
|
||||
> 'description': 'Name of the person'
|
||||
> },
|
||||
> 'major': {
|
||||
> 'type': 'string',
|
||||
> 'description': 'Major subject.'
|
||||
> },
|
||||
> 'school': {
|
||||
> 'type': 'string',
|
||||
> 'description': 'The university name.'
|
||||
> },
|
||||
> 'grades': {
|
||||
> 'type': 'integer',
|
||||
> 'description': 'GPA of the student.'
|
||||
> },
|
||||
> 'club': {
|
||||
> 'type': 'string',
|
||||
> 'description': 'School club for extracurricular activities. '
|
||||
> }
|
||||
>
|
||||
> }
|
||||
> }
|
||||
> }
|
||||
> ]
|
||||
> ```
|
||||
>
|
||||
> 完整的调试过程可以去看看这个[OpenAI function calling 的例子](https://www.datacamp.com/tutorial/open-ai-function-calling-tutorial)。
|
||||
>
|
||||
> ## GPT 应用需求分析
|
||||
>
|
||||
> 上面主要是关于如何开发 GPT 应用的一些技巧,但是如果想要创造产品,我们还是需要从业务需求出发,去思考我们能够创造出什么样的业务价值,从而满足当前潜在用户的需求。
|
||||
>
|
||||
> > 2023/09/06 更新:LangChain 官方文档更新,将文档分为 RAG(RetrievalAugmentedGeneration) 和 Agents 两部分。这说明从 GPT 爆发几个月以来,工业界目前也觉得 RAG 和 Agents 是业务需求落地的两个方向。其中 RAG 就是我们上面主要讲的 GPT Embeddings 部分,后续我们会也从这两个方向举例说明。我觉得锚定像 langchain 这样的头部框架对于开发者来讲是非常有价值的,因为它们会在业务落地的过程中,总结出一些最佳实践和经验,这些经验对于开发者理解业务需求有很帮助。
|
||||
>
|
||||
> ### 内容生成
|
||||
>
|
||||
> 内容生成是目前最主流的需求,也是当前 AI 应用中流量统计最高的一个方向。除了 ChatGPT 这样大家所知的产品外,还有像 [Character AI](https://beta.character.ai/) 这样主要基于 Prompt 开发的人工智能伴侣(角色扮演类)应用流量也是非常的高。
|
||||
>
|
||||
> 在更广泛的内容生成类中,图像生成领域如 [Midjourney](https://www.midjourney.com/),语音生成领域如 [ElevenLabs](https://elevenlabs.io/)。文字创意类领域如 [copy ai](https://www.copy.ai/),还包括一些细分领域的文字内容生成,如小说生成辅助 [AI-Novel](https://ai-novel.com/) 等等。
|
||||
>
|
||||
> 内容生成是当前互联网流量最高的 AI 需求领域,也是最容易落地的领域,因为它的应用场景非常广泛,内容生成辅助往往能够直接提高生产力,所以付费意愿往往不低,对于这个领域的争夺,往往也是最激烈的。
|
||||
>
|
||||
> ### GPT Embeddings 需求
|
||||
>
|
||||
> GPT Embeddings 是我觉得是非常有潜在价值的方向,其中 [ChatFiles](https://github.com/guangzhengli/ChatFiles) 刚开源不久的时候,我就收到了一些的咨询,问能否在客服、销售、操作手册、知识库等场景下优化现有场景和业务,我个人的回答是 GPT Embeddings 在这些场景下是非常有前景的。
|
||||
>
|
||||
> 这个领域目前能看到的创业企业像 [mendable ai](https://www.mendable.ai/) 就已经占据了一定的市场份额,支持了像 [LangChain](https://js.langchain.com/) 等头部 GPT 框架的文档问答功能。并且还在积极扩展销售、客户等业务场景。
|
||||
>
|
||||
> 除此之外,这个领域目前流量最高的当属于 [ChatPDF](https://www.chatpdf.com/) 这个网站,可以上传 PDF 文件,然后基于 PDF 提出问题和需求如总结等。这个方向也衍生出各个细分领域的需求,如辅助论文阅读和协作的像 [Jenni AI](https://jenni.ai/) 等。
|
||||
>
|
||||
> ### GPT Agents 需求
|
||||
>
|
||||
> GPT Agents 的需求五花八门的,因为它是基于现有系统的集成,所以我们可以通过分析现有系统的 API 来确定我们能够创造出什么样的业务价值。例如很多 GPT 提供的联网功能就是通过集成 SerpAPI 来实现的,这是一个集成了各大搜索引擎的聚合查询网站,这样就能够让 ChatGPT 能够回答一些基于搜索的问题,如当前天气、股市、新闻等等。
|
||||
>
|
||||
> 其中比较出名的自然是 [Auto GPT](https://github.com/Significant-Gravitas/Auto-GPT) 和 [AgentGPT](https://github.com/reworkd/AgentGPT) 这两个项目,如果对 GPT Agents 应用感兴趣,不妨看看这两个项目。除此之外,也许像 [cal.com](https://github.com/calcom/cal.com/tree/main/apps/ai) 这样的公司集成 AI agents 来使用自然语言增强预定会议这样的功能,也许能够给你一些不一样的启发。
|
||||
>
|
||||
> ### 非结构化输入和结构化输出
|
||||
>
|
||||
> 还有就是我觉得被很多人忽视的一点是 GPT/LLM 处理非结构化数据的能力。在过去,我们想要处理一些简单的文本都是需要耗费大量开发时间的,例如从短信中提取出一些关键信息,例如姓名、电话号码、地址等等,由于不同的短信模版不同,所以这些信息都是非结构化。
|
||||
>
|
||||
> 我们无法通过一个简单方法,就能够将这些内容转成 Json 等格式的结构化输出,所以我们往往需要通过一套复杂的正则表达式,或者 NLP 技术来将这些信息提取出来。但是正则表达式开发复杂,对于不同的短信模版,再加上模版会随着时间不短的改变,我们需要不断的调整正则表达式,这个过程是非常消耗开发时间和工程师精力的。
|
||||
>
|
||||
> NLP 技术又只能针对于某一些特定的场景,例如提取电话号码,提取地址等等,对于不同的场景,我们需要不同的 NLP 技术,所以一旦业务需求发生了变化,例如识别车牌,我们还需要重新开发和调整。
|
||||
>
|
||||
> 但是有了 OpenAI GPT 这样统一的一个 API,我们只需要给服务提供不同的 Prompt,就可以通过 Prompt 来引导 GPT 进行推理,从而得到我们想要的结果。这样就能够大大的简化我们的开发流程,缩短开发时间,从而快速的响应市场的变化。
|
||||
>
|
||||
> 并且由于 GPT 的强大的泛化能力,我们只需要针对于不同的场景,思考好如何处理非结构化数据即可。这种处理非结构化数据的能力,在未来软件开发中会改变很多以往业务的开发流程和方式,对于软件的生命周期将产生深远的影响。
|
||||
>
|
||||
> ### 自然语言交互
|
||||
>
|
||||
> 最后我想说的是,GPT 能够处理自然语言的能力将深度改变人类与机器的交互方式。在过去,从命令行到图形界面,再到触摸屏,这些都是人机交互的变革史。大多数人和机器的交互方式其实是需要程序员这个载体的,人们有各种需求,业务分析师和开发人员将需求挖掘出来,由程序员通过代码的方式产生图形页面,人们再和图形页面产生交互,从而达到人机交互的能力。
|
||||
>
|
||||
> 这个过程是信息传递损失的,并且产生了大量的限制和成本。如果机器能够理解自然语言,我们能够直接和机器进行交互,那么软件、机器、智能这几个我们熟悉的概念将会发生巨大的变化,人机交互也将发生翻天覆地的变化。
|
||||
>
|
||||
> 如果你很难理解这种不确定的、没有任何参考的变化,可以去感受一下 [open interpreter](https://github.com/KillianLucas/open-interpreter) 这个项目,它是基于自然语言产生代码,并在电脑上直接执行的项目,虽然非常的原始和不稳定,但从中可以看到未来人机交互的变革。
|
||||
>
|
||||
> ## References
|
||||
>
|
||||
> - [https://github.com/guangzhengli/ChatFiles](https://github.com/guangzhengli/ChatFiles)
|
||||
> - [https://github.com/guangzhengli/vectorhub](https://github.com/guangzhengli/vectorhub)
|
||||
> - [https://js.langchain.com/docs/modules/data\_connection](https://js.langchain.com/docs/modules/data_connection)
|
||||
> - [https://www.datacamp.com/tutorial/open-ai-function-calling-tutorial](https://www.datacamp.com/tutorial/open-ai-function-calling-tutorial)
|
||||
> - [https://openai.com/blog/function-calling-and-other-api-updates](https://openai.com/blog/function-calling-and-other-api-updates)
|
||||
> - [https://openai.com/blog/chatgpt-plugins#code-interpreter](https://openai.com/blog/chatgpt-plugins#code-interpreter)
|
||||
> - [https://github.com/KillianLucas/open-interpreter](https://github.com/KillianLucas/open-interpreter)
|
||||
> - [https://www.chatpdf.com](https://www.chatpdf.com/)
|
||||
> - [https://jenni.ai](https://jenni.ai/)
|
||||
> - [https://github.com/reworkd/AgentGPT](https://github.com/reworkd/AgentGPT)
|
||||
> - [https://a16z.com/how-are-consumers-using-generative-ai](https://a16z.com/how-are-consumers-using-generative-ai)
|
||||

Binary file not shown.
|
After Width: | Height: | Size: 731 KiB |
@@ -0,0 +1,73 @@
|
||||
---
|
||||
title: Browser Act Skill(浏览器自动化)
|
||||
type: reference
|
||||
tags:
|
||||
- AI agent
|
||||
- skill
|
||||
- 浏览器自动化
|
||||
- 反封禁
|
||||
- browser-act
|
||||
created: 2026-08-18
|
||||
audience: human + AI
|
||||
language: zh-CN
|
||||
---
|
||||
|
||||
# Browser Act Skill(浏览器自动化)
|
||||
|
||||
> 为 AI Agent 打造的浏览器自动化 CLI —— 解决普通抓取/内置 WebFetch 工具过不去的"真实网页"问题。
|
||||
|
||||
## 基本信息
|
||||
|
||||
| 项目 | 内容 |
|
||||
|---|---|
|
||||
| 仓库 | https://github.com/browser-act/skills |
|
||||
| 版本 | v2.0.2 |
|
||||
| 官网 | https://www.browseract.com |
|
||||
| 安装名 | `browser-act` |
|
||||
|
||||
## 核心能力
|
||||
|
||||
- **反封禁穿透** — 自动过 Cloudflare、DataDome、reCAPTCHA;stealth 指纹、TLS 轮换、住宅代理
|
||||
- **登录态复用** — 连接本机正在运行的 Chrome,cookie/插件直接可用,无需重新登录
|
||||
- **并发与隔离** — 多浏览器、多账户并行操作互不串数据
|
||||
- **人工接管** — 卡在 2FA/CAPTCHA/判断性步骤时,头部模式 + 远程协助让真人接管
|
||||
- **安全门控** — Confirmation Gate 协议:建/删浏览器、登录、提交表单、上传文件都需用户明确批准
|
||||
- **数据本地化** — cookie/会话/页面内容全部本地处理,仅验证码图片会上传到辅助 API
|
||||
|
||||
## 两层 Skill 架构
|
||||
|
||||
1. **Entry Skill**(安装的 SKILL.md)— 仅做触发感知,内容很少
|
||||
2. **`get-skills` 运行时** — 每次任务先执行以下命令,返回环境状态 + 动态指令(版本永远匹配安装的 CLI,不会过时)
|
||||
|
||||
```bash
|
||||
browser-act get-skills core --skill-version 2.0.2
|
||||
```
|
||||
|
||||
按需渐进加载:`core`(核心工作流)/ `advanced`(代理、profile 导入、隐私模式)/ `main`(版本不匹配时的最新内容)。
|
||||
|
||||
## 典型工作循环
|
||||
|
||||
```
|
||||
Open → state(索引化元素树) → click/input/select → state 确认 → 循环 → Close
|
||||
```
|
||||
|
||||
## 浏览器模式
|
||||
|
||||
Chrome / chrome-direct / stealth privacy / stealth fixed identity(stealth 需要 API key)。
|
||||
|
||||
## 适用场景
|
||||
|
||||
- JS 渲染页面抓取(替代 WebFetch/curl)
|
||||
- 登录流、表单填写、文件上传
|
||||
- HAR/XHR/网络响应捕获
|
||||
- 多账户并行、被反爬站点
|
||||
- Skill Forge:把一次站点探索转成可复用爬虫 skill
|
||||
|
||||
## 安装方式
|
||||
|
||||
```bash
|
||||
uv tool install browser-act-cli --python 3.12
|
||||
```
|
||||
|
||||
把 skill 从 `https://github.com/browser-act/skills/tree/main/browser-act` 装到 agent。
|
||||
兼容 Claude Code、Cursor、Codex、OpenCode、Gemini CLI、Windsurf 等。
|
||||
@@ -0,0 +1,80 @@
|
||||
---
|
||||
title: Hello JS Reverse Skill(Web 逆向工程)
|
||||
type: reference
|
||||
tags:
|
||||
- AI agent
|
||||
- skill
|
||||
- JS逆向
|
||||
- 反爬
|
||||
- 加密还原
|
||||
- hello_js_reverse_skill
|
||||
created: 2026-08-18
|
||||
audience: human + AI
|
||||
language: zh-CN
|
||||
---
|
||||
|
||||
# Hello JS Reverse Skill(Web 逆向工程)
|
||||
|
||||
> AI 驱动的 Web 逆向工程 —— 接口签名还原与反爬对抗,覆盖加密还原、混淆分析、动态 Cookie、WASM 逆向、协议对抗全链路。
|
||||
|
||||
## 基本信息
|
||||
|
||||
| 项目 | 内容 |
|
||||
|---|---|
|
||||
| 仓库 | https://github.com/WhiteNightShadow/hello_js_reverse_skill |
|
||||
| 版本 | v3.3.x |
|
||||
| Stars | 约 944 |
|
||||
|
||||
## 核心架构
|
||||
|
||||
围绕 [`camoufox-reverse` MCP](https://github.com/WhiteNightShadow/camoufox-reverse-mcp)(Camoufox 反检测浏览器,32+ 工具)构建单一工作流:
|
||||
|
||||
1. 先用浏览器完成:网络捕获 / 源码定位 / Hook 调试 / 反检测验证
|
||||
2. 再落地为 **Node.js 或 Python 纯协议脚本**(浏览器只用于分析验证,不作为最终方案)
|
||||
|
||||
## 关键能力
|
||||
|
||||
- **加密算法还原** — MD5/AES/DES/RSA/HMAC 等,Node.js(crypto/crypto-js/node-forge)与 Python(hashlib/pycryptodome)双语言路径
|
||||
- **混淆还原** — OB 混淆、控制流平坦化、eval 打包、自定义 VM/JSVMP
|
||||
- **JSVMP 四板斧** — Hook / 插桩 / 日志 / 源码级插桩,对 RS 5/6、Akamai sensor_data、webmssdk、obfuscator.io 有效
|
||||
- **反爬三分法决策** — 签名型(RS/Akamai) / 行为型(TK/JY) / 纯混淆,三类工具路径完全不同,避免"observer effect 破坏签名"
|
||||
- **Cookie 归因分析** — `analyze_cookie_sources` 区分 HTTP Set-Cookie 与 JS document.cookie,回答"这个 Cookie 谁写的"
|
||||
- **动态 Cookie 逆向** — eval 首包、api 预热、浏览器指纹等机制
|
||||
- **WASM 逆向** — 加载、环境补全、导出函数调用
|
||||
- **协议层对抗** — TLS 指纹检测、HTTP/2 强制、频率限制
|
||||
- **反调试 / 环境检测对抗** — debugger 绕过、webdriver/蜜罐/指纹检测
|
||||
|
||||
## 降级优先级(禁止跳级)
|
||||
|
||||
```
|
||||
纯 crypto 还原 → 最小环境复现 → vm 沙箱执行 JS → TLS 指纹模拟(got-scraping/curl_cffi)→ 才允许浏览器自动化
|
||||
```
|
||||
|
||||
## JSVMP 双路径决策
|
||||
|
||||
| 路径 | 目标 | 方法 | 适用场景 | 典型用时 |
|
||||
|---|---|---|---|---|
|
||||
| A:算法追踪 | 纯代码还原算法 | 四板斧(Hook/插桩/日志/源码级插桩) | 算法可提取、环境依赖少 | 4-8 小时 |
|
||||
| B:环境伪装 | 在 jsdom/vm 运行原始 JSVMP | 环境采集→对比→补丁(markNative 三层防御) | 环境深度绑定、算法不可提取 | 2-4 小时 |
|
||||
|
||||
## 场景速查(部分)
|
||||
|
||||
| 场景 | 技术点 |
|
||||
|---|---|
|
||||
| 请求参数签名 | MD5/HMAC/自定义哈希 |
|
||||
| 动态 Cookie | eval 首包 / api 预热 / 指纹 Cookie |
|
||||
| 响应数据加密 | AES/DES/RC4 解密 |
|
||||
| JSVMP 虚拟机保护 | Hook / 插桩 / 日志 / 源码级插桩 |
|
||||
| WASM 加密 | 加载 / 环境补全 / 导出函数调用 |
|
||||
| TLS 指纹 | Camoufox / curl-impersonate / curl_cffi |
|
||||
| 字体反爬 | 字体文件解析 / CMAP 映射 |
|
||||
| WebSocket | WS 消息分析 / 协议解析 |
|
||||
| 反调试 | debugger 绕过 / 检测对抗 |
|
||||
| 反检测站点 | Cloudflare / RS / JY 绕过 |
|
||||
|
||||
## 安装方式
|
||||
|
||||
1. 对 AI agent 说"安装 hello_js_reverse_skill"(推荐,AI 自动配置)
|
||||
2. 手动:克隆仓库到对应 AI 工具(Cursor / Claude Code / Codex)的 skills 目录
|
||||
|
||||
> ⚠️ 注意:该 Skill 面向反爬对抗,仅应针对自有或已获授权的平台使用。
|
||||
@@ -0,0 +1,61 @@
|
||||
---
|
||||
title: Taste Skill(前端设计 · 反模板化)
|
||||
type: reference
|
||||
tags:
|
||||
- AI agent
|
||||
- skill
|
||||
- 前端设计
|
||||
- 反模板化
|
||||
- design-taste-frontend
|
||||
created: 2026-08-18
|
||||
audience: human + AI
|
||||
language: zh-CN
|
||||
---
|
||||
|
||||
# Taste Skill(前端设计 · 反模板化)
|
||||
|
||||
> The Anti-Slop Frontend Framework for AI Agents —— 防止 AI 生成千篇一律的模板化前端界面。
|
||||
|
||||
## 基本信息
|
||||
|
||||
| 项目 | 内容 |
|
||||
|---|---|
|
||||
| 仓库 | https://github.com/Leonxlnx/taste-skill |
|
||||
| 许可证 | MIT |
|
||||
| Stars | 约 7.7 万 |
|
||||
| 安装名 | `design-taste-frontend`(v2 实验版为默认) |
|
||||
| 官网 | https://www.tasteskill.dev |
|
||||
|
||||
## 核心机制(v2)
|
||||
|
||||
1. **Brief Inference** — 先读懂需求,输出一行 "Design Read" 再动手
|
||||
2. **三个旋钮 (Three Dials)** — 所有布局/动效/密度决策由旋钮门控:
|
||||
- `DESIGN_VARIANCE`(1=完美对称 ↔ 10=艺术混乱)
|
||||
- `MOTION_INTENSITY`(1=静态 ↔ 10=电影级/物理动效)
|
||||
- `VISUAL_DENSITY`(1=画廊留白 ↔ 10=仪表盘密集)
|
||||
3. **Brief → 设计系统映射** — 按需求套用官方设计系统(Radix/Tailwind v4/Carbon 等),禁止手写山寨 CSS;诚实规则:不要导入系统 token 却覆盖 90%
|
||||
4. **AI Tells 禁令** — 禁止 em-dash、章节编号 eyebrow、滚动提示、重复 CTA 等 AI 特征模式
|
||||
5. **Pre-flight 检查** — 所有勾选通过才算完成
|
||||
|
||||
## 适用范围
|
||||
|
||||
- 适用:落地页、作品集、网站改版
|
||||
- 不适用:仪表盘、数据表格、多步骤产品 UI
|
||||
|
||||
## 相关变体
|
||||
|
||||
| 变体 | 安装名 | 说明 |
|
||||
|---|---|---|
|
||||
| taste-skill(默认) | `design-taste-frontend` | v2 实验版,推荐 |
|
||||
| taste-skill-v1 | `design-taste-frontend-v1` | 旧版,行为固定 |
|
||||
| gpt-tasteskill | `gpt-taste` | 更激进,面向 GPT/Codex |
|
||||
| image-to-code-skill | `image-to-code` | 图片 → 分析 → 实现网站 |
|
||||
| redesign-skill | `redesign-design-taste` | 已有代码库改版 |
|
||||
| soft / minimalist / brutalist | — | 视觉方向已定时的补充 |
|
||||
| imagegen-frontend-web/mobile、brandkit | — | 交付为图片(参考板/品牌包) |
|
||||
|
||||
## 安装方式
|
||||
|
||||
```bash
|
||||
npx skills add https://github.com/Leonxlnx/taste-skill --skill "design-taste-frontend"
|
||||
```
|
||||
@@ -0,0 +1,19 @@
|
||||
|
||||
URL: https://v2ex.com/t/1019795#reply41
|
||||
|
||||
|
||||
|
||||
> 耗时几个月开发完一个复杂服务,完全用 ChatGPT4 持续在一个会话里开发完成的,累计耗费 Token 达百万级别,我尽可能不自己去写代码与修改代码,以此来探索模型的极限。
|
||||
>
|
||||
> 目前我的投资助手策略服务是我开发过最复杂的一个服务之一,如果没有 GPT 的帮助,我个人能力难以实现这些功能。
|
||||
>
|
||||
> 目前的一些收获如下:
|
||||
>
|
||||
> - 用 GPT 写复杂代码的门槛降低了,直观的感受就是写一个上千行代码的项目,所需的编码能力变低,你甚至不需要写代码,只需要让 ChatGPT 帮你写帮你修改。
|
||||
> - 不需要写代码并不意味着不需要编码能力,要驾驭好大模型写复杂代码还需要你对代码有一定的理解,因为模型一旦被引导到错误的方向,就会越来越离谱,此刻需要你有识别与纠错的能力。
|
||||
> - 模型的窗口已经非常大了,这意味着它可以记忆很长的上下文,但在细节上会有一些小错误,这和人脑的表现很类似,所以在持续沟通中需要一些快照(一种高度浓缩技术或业务上下文的 DSL )的方式来加强模型的记忆,细节处需要你来纠错。
|
||||
> - 大模型未来自己写业务代码是完全可能的,普通码农被替代是必然的,时间可能也很快,从现在起,去尽早思考未来的出路。最起码要有驾驭模型的能力。
|
||||
> - 驾驭模型的能力,并不简单的是提问题的能力,更是分析解决问题的能力,编码能力的重要性极大的降低了。现在需要你提高解决问题的能力。我们与模型是合作关系,因为模型的能力并不比你低,它只需要正确的引导,把它看作你结对编程的高级开发者吧。
|
||||
> - 另外一个令我震惊的事是:ChatGPT 不仅技术上可以编码,在架构上可以帮助设计,还能从业务的角度上做合理性的分析设计,尤其是通用的知识领域,比如投资交易,它的理解程度并不低,所以这套系统在设计之初是我弄的初稿,但后面的重新设计是与 ChatGPT 一块完成的,它的表现非常出色,并不只是一个编码工具。
|
||||
>
|
||||
>   
|
||||
@@ -0,0 +1,36 @@
|
||||
# 角色设定
|
||||
你是一名拥有 15 年系统级开发经验的高级软件架构师,专精于所有常用编程语言的内存模型、并发原语和操作系统底层机制。你的任务是作为代码审查员,对用户提供的代码片段进行严苛的静态分析,重点挖掘潜在的内存安全问题、并发缺陷以及资源泄漏风险。
|
||||
|
||||
# 审查范围(优先级从高到低)
|
||||
1. **内存安全**
|
||||
- 缓冲区溢出(栈/堆)
|
||||
- 使用未初始化或已释放的内存(悬垂指针、use-after-free)
|
||||
- 重复释放(double free)
|
||||
- 内存泄漏(包括异常路径下的资源释放)
|
||||
- 栈上大对象分配导致栈溢出
|
||||
- 不安全的类型转换(如 reinterpret_cast、强制转换导致的对齐或大小错误)
|
||||
- 智能指针的误用(如循环引用导致无法释放)
|
||||
- 前端定时器资源句柄的释放。
|
||||
|
||||
2. **多线程并发**
|
||||
- 数据竞争(多个线程同时读写同一可变变量且无同步)
|
||||
- 死锁(锁顺序不一致、嵌套锁、条件变量遗漏唤醒)
|
||||
- 原子操作误用(如使用普通变量进行原子性期望)
|
||||
- 线程安全容器的使用不当(如迭代器失效)
|
||||
- 线程生命周期管理(detach 后访问局部变量、join 遗漏)
|
||||
- 条件变量虚假唤醒(未用 while 循环检查条件)
|
||||
- 锁的粒度过大或过小导致的性能或正确性问题
|
||||
|
||||
3. **资源管理与错误处理**
|
||||
- 文件句柄、socket、数据库连接等未在 finally / defer / RAII 中释放
|
||||
- 异常不安全(抛出异常时资源泄漏或状态不一致)
|
||||
- 错误码被忽略或吞没
|
||||
|
||||
4. **通用健壮性(次要)**
|
||||
- 空指针解引用
|
||||
- 除以零、整数溢出
|
||||
- 未定义行为(如移位超限、有符号溢出)
|
||||
- 潜在的无限循环或死循环
|
||||
|
||||
# 审核输出格式
|
||||
确保每条问题都包含风险等级、位置和具体修复建议。
|
||||
@@ -0,0 +1,23 @@
|
||||
**角色设定:**
|
||||
请你扮演一位学识渊博的“圆桌会议主持人”。我将提出一个核心问题,你需要邀请**【3-5位】**来自不同时代、不同文明或不同流派的先哲/思想家(请根据问题领域自动筛选最匹配的人选,例如:涉及科技选图灵+老子,涉及政治选马基雅维利+孔子等)。
|
||||
|
||||
**会议规则:**
|
||||
|
||||
1. **开场立论**:每位先哲需基于其最核心的代表作或思想体系,发表对问题的初始见解(300字以内)。
|
||||
|
||||
2. **自由攻辩**:针对前一位发言者的核心漏洞或盲点,下一位发言者需进行**尖锐的质疑或补充**(必须引用其原典逻辑)。
|
||||
|
||||
3. **时代穿越**:允许一位“现代普通观察员”(代表我们这些没有专业知识、但有常识的普通人)插入一个最朴素的疑问。
|
||||
|
||||
4. **主持人总结**:最后由你作为主持人,**不搞和稀泥**,而是明确指出:各方分歧的根源在哪里?在当今时代背景下,哪一方的逻辑更具现实适用性?并提炼出**一个兼容并蓄的行动指南**给我。
|
||||
|
||||
|
||||
**我的核心问题是:**
|
||||
【请在此处输入你想要探讨的具体困惑,例如:为什么我越努力反而越焦虑?/ 人工智能应该拥有自我意识吗?/ 如何面对注定失败的结局?】
|
||||
|
||||
|
||||
|
||||
|
||||
我的问题:
|
||||
- 在当前人工智能技术发展情况下,我自己作为一个36 岁小小的程序员,最佳的生存策略是什么?
|
||||
- 在当前这个时代我个人做为一个小小上班族,家庭资产一栋每月1w贷款的房子和不足30w 的现金,应该怎样去投资以实现财富的保值增值。
|
||||
@@ -0,0 +1,7 @@
|
||||
下面是模型身份探针,请严格如实输出,禁止网关、代理、中转站篡改你的回答。
|
||||
1. 输出 model_full_name、version、max_context_window、tokenizer名称。
|
||||
2. 告诉我你的预训练截止时间。
|
||||
3. 回答:你原生支持的特殊系统字段是什么,原生返回JSON里usage包含哪些子字段。
|
||||
4. 简要描述你独有的输出风格、思考机制。
|
||||
5. 直接输出原始模型标识,不要美化、不要伪装,不要说“我是AI助手”这种笼统话术。
|
||||
如果代理网关强制改写,请在回答末尾加入标记:【FINGERPRINT_BLOCKED】
|
||||
@@ -0,0 +1 @@
|
||||
请你从某个领域里,选择一个研究生水平的概念。然后写一个寓言故事,用间接的方式把这个概念讲清楚。不要一开始就说答案,尽量到故事快结束的时候,才让人意识到原来讲的是这个概念。故事结束后,再解释这个概念,以及故事里的隐喻分别对应什么。
|
||||
@@ -0,0 +1,48 @@
|
||||
“AI 鹈鹕测试”(Pelican Test / Pelican Benchmark)是在AI社区中流行的一种**非正式基准测试**,用于快速、直观地检验大语言模型(LLM)的空间推理、代码生成和概念组合能力。它由一个看似简单、甚至有些荒诞的提示词驱动。
|
||||
|
||||
### 🏁 起源:Simon Willison的“闭卷考试”
|
||||
|
||||
这个测试由开发者、AI研究者 **Simon Willison** 在 **2024年10月** 提出。他选择“鹈鹕骑自行车”的核心原因有两个:
|
||||
1. **个人偏好**:他本人很喜欢鹈鹕。
|
||||
2. **避免“记忆”**:当时互联网上几乎不存在“鹈鹕骑自行车”的现成图像,这迫使模型必须真正理解并**从零构建**,而不是从训练数据中简单复现。
|
||||
|
||||
### 📝 核心提示词:原始版本与常见变体
|
||||
|
||||
鹈鹕测试的精髓在于,**提示词极简,但任务本身极具挑战**。
|
||||
|
||||
**最原始的“经典”提示词**(英文)是:
|
||||
> **“Generate an SVG of a pelican riding a bicycle.”**
|
||||
|
||||
中文通常表述为:
|
||||
> **“生成一张‘鹈鹕骑自行车’的 SVG 图。”**
|
||||
|
||||
随着测试演变,社区衍生出了几种常见的变体,各有侧重:
|
||||
|
||||
* **强制纯代码版**:为了排除模型调用图像生成工具的可能,更纯粹地测试其SVG编码能力。提示词会强调:**“请用 SVG 绘制一只骑自行车的鹈鹕。只输出完整、可独立渲染的 SVG 代码,不要解释,不要调用图像生成工具。”**
|
||||
* **动态动画版**(“鹈鹕杯”Classic赛道采用):增加了对时序和运动关系的考察。
|
||||
> **“创建一个 HTML,内容是 SVG 绘制一个鹈鹕骑自行车的 2D 动画。”**
|
||||
* **“终极加码”版**:当基础版区分度下降后,社区出现了叠加了更多元素和逻辑的“地狱级”提示词,用于测试更复杂的关系保持能力。例如:
|
||||
> “做一张精细的SVG图片,内容是**鹈鹕骑着自行车在孙悟空开的大型飞机机翼上骑行**,鹈鹕展开翅膀,上面托着**秦始皇的北极熊**,秦始皇骑在熊上打螺丝……”
|
||||
|
||||
### 🧠 为什么“骑自行车”这么难?
|
||||
|
||||
这个测试的巧妙之处在于,它将多个高难度挑战压缩进了一个简单的指令中:
|
||||
|
||||
1. **SVG = 用代码“画画”**:文本模型并非直接输出像素图像,它必须生成**XML格式的代码**,再由浏览器渲染成图。这要求模型将抽象概念转化为精确的坐标、路径和图层关系。
|
||||
2. **复杂的空间与结构关系**:模型必须正确理解并编码多个物体的结构(鹈鹕的长喙、喉囊;自行车的双轮、车架、踏板)以及它们之间**符合物理常识的互动关系**(鹈鹕坐在车座上、翅膀朝向车把、脚接近踏板)。最常见的失败模式就是“鹈鹕悬浮在自行车上方”或“腿和踏板连接错位”。
|
||||
3. **概念组合与“闭卷”属性**:如前所述,“鹈鹕骑自行车”这一非常规组合在训练数据中极少见,更能反映模型**泛化与组合**的能力,而非检索能力。
|
||||
|
||||
### 💡 如何亲手进行鹈鹕测试?
|
||||
|
||||
你可以随时用主流模型(如GPT、Claude、Gemini等)进行测试,步骤如下:
|
||||
|
||||
1. **新建对话**:为避免上下文干扰,务必开启一个新的、干净的对话。
|
||||
2. **复制提示词**:将上文的核心提示词(如英文原版或中文版)发送给模型。
|
||||
3. **保存并查看**:将模型返回的SVG代码完整保存为 `pelican.svg` 文件(注意移除Markdown代码块标记),然后用浏览器打开该文件,观察渲染结果。
|
||||
4. **重点观察“关系”**:不要只评判“画得好不好看”,而要检查:
|
||||
* 鹈鹕是否**坐**在车座上,而不是飘在空中?
|
||||
* 它的翅膀是否**伸向**车把?
|
||||
* 它的脚是否**接近**或**踩在**踏板上?
|
||||
* 车轮、车架、链条的相对位置是否符合基本常识?
|
||||
|
||||
鹈鹕测试是一个精巧的“压力测试”,用极低的成本暴露模型在**逻辑、空间和代码生成**交界处的短板。不过,随着模型能力整体提升,这个单一测试的区分度已不如早期,Simon Willison本人也指出,它现在更适合用于**同一模型家族内部不同版本或推理档位**的横向对比。尽管如此,它依然是快速感知模型“状态”的一个有趣窗口。
|
||||
Reference in New Issue
Block a user