vault backup: 2026-11-07 16:33:44
This commit is contained in:
 cheney
@@ -0,0 +1,8 @@
|
||||
1. 确认安装环境
|
||||
- 基于 Docker
|
||||
- 网络带宽通过 iperf 检测
|
||||
|
||||
iperf3 -s
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,252 @@
|
||||
## 解读 EXPLAIN 结果的关键字段
|
||||
|
||||
以 MySQL 为例,重要的列包括:
|
||||
|
||||
| 列名 | 说明 | 优化关注点 |
|
||||
| ----------------- | ------- | --------------------------------------------------------- |
|
||||
| **type** | 访问类型 | 最好到最差:system > const > eq_ref > ref > range > index > ALL |
|
||||
| **key** | 实际使用的索引 | 检查是否使用了预期索引 |
|
||||
| **rows** | 预计扫描行数 | 数值越小越好 |
|
||||
| **Extra** | 额外信息 | 注意 Using filesort, Using temporary |
|
||||
| **possible_keys** | 可能使用的索引 | 数据库考虑使用的索引列表 |
|
||||
|
||||
# MySQL EXPLAIN 中 type 字段的详细解释
|
||||
|
||||
`type` 列显示 MySQL 如何查找表中的行,从最优到最差排序如下:
|
||||
|
||||
## 一、性能最好的类型
|
||||
|
||||
### **1. system**
|
||||
- **解释**:表只有一行(相当于系统表)
|
||||
- **出现场景**:
|
||||
- 表中只有一条记录(MyISAM、MEMORY表)
|
||||
- 衍生表(派生表)只有一行数据
|
||||
- **示例**:
|
||||
```sql
|
||||
-- 假设表只有一行数据
|
||||
EXPLAIN SELECT * FROM (SELECT * FROM t1 WHERE id=1) AS derived_table;
|
||||
```
|
||||
|
||||
### **2. const**
|
||||
- **解释**:通过索引一次就找到了,用于 primary key 或 unique key 的等值查询
|
||||
- **特点**:
|
||||
- 查询速度非常快
|
||||
- 只会读取一次
|
||||
- 返回最多一条记录
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM users WHERE id = 1;
|
||||
-- id 是主键
|
||||
```
|
||||
|
||||
## 二、性能优秀的类型
|
||||
|
||||
### **3. eq_ref**
|
||||
- **解释**:使用唯一索引进行关联查询
|
||||
- **出现场景**:
|
||||
- 关联查询中,被驱动表使用主键或唯一索引进行等值匹配
|
||||
- 每个索引键值在表中只有一条记录匹配
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT *
|
||||
FROM orders
|
||||
JOIN users ON orders.user_id = users.id; -- users.id 是主键
|
||||
```
|
||||
- **注意**:这是除了 system 和 const 之外最好的连接类型
|
||||
|
||||
### **4. ref**
|
||||
- **解释**:使用非唯一索引进行等值查询
|
||||
- **出现场景**:
|
||||
- 使用普通索引(非唯一索引)进行等值查询
|
||||
- 可能返回多行数据
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM users WHERE email = 'test@example.com';
|
||||
-- email 字段有普通索引,但不是唯一索引
|
||||
```
|
||||
|
||||
### **5. fulltext**
|
||||
- **解释**:使用全文索引
|
||||
- **出现场景**:
|
||||
- 查询使用了 `MATCH() ... AGAINST()` 语法
|
||||
- 表中建立了全文索引
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM articles
|
||||
WHERE MATCH(title, content) AGAINST('MySQL tutorial');
|
||||
```
|
||||
|
||||
## 三、性能中等的类型
|
||||
|
||||
### **6. ref_or_null**
|
||||
- **解释**:类似于 ref,但额外搜索包含 NULL 值的行
|
||||
- **出现场景**:
|
||||
- 等值查询条件中包含 OR ... IS NULL
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM users
|
||||
WHERE email = 'test@example.com' OR email IS NULL;
|
||||
```
|
||||
|
||||
### **7. index_merge**
|
||||
- **解释**:使用了索引合并优化
|
||||
- **出现场景**:
|
||||
- 查询条件使用多个索引,MySQL 会合并这些索引的结果
|
||||
- 常见于 OR 条件的查询
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM users
|
||||
WHERE name = 'John' OR age = 30;
|
||||
-- name 和 age 分别有索引
|
||||
```
|
||||
|
||||
### **8. unique_subquery**
|
||||
- **解释**:在子查询中使用了唯一索引
|
||||
- **出现场景**:
|
||||
- 子查询中使用主键或唯一索引
|
||||
- 通常用于 IN 子查询优化
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM orders
|
||||
WHERE user_id IN (
|
||||
SELECT id FROM users WHERE status = 'active'
|
||||
);
|
||||
-- 如果 users.id 是主键,子查询会使用 unique_subquery
|
||||
```
|
||||
|
||||
### **9. index_subquery**
|
||||
- **解释**:类似于 unique_subquery,但用于非唯一索引
|
||||
- **出现场景**:
|
||||
- 子查询中使用普通索引
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM orders
|
||||
WHERE product_id IN (
|
||||
SELECT id FROM products WHERE category = 'electronics'
|
||||
);
|
||||
-- 如果 products.id 是普通索引
|
||||
```
|
||||
|
||||
## 四、性能需要优化的类型
|
||||
|
||||
### **10. range**
|
||||
- **解释**:使用索引进行范围查询
|
||||
- **出现场景**:
|
||||
- `BETWEEN`、`>`、`<`、`>=`、`<=`、`IN()`、`LIKE 'prefix%'` 等操作
|
||||
- 只检索给定范围的行
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM users WHERE age BETWEEN 20 AND 30;
|
||||
EXPLAIN SELECT * FROM users WHERE last_name LIKE 'Smith%';
|
||||
EXPLAIN SELECT * FROM users WHERE id IN (1, 2, 3);
|
||||
```
|
||||
|
||||
### **11. index**
|
||||
- **解释**:全索引扫描
|
||||
- **两种场景**:
|
||||
1. **覆盖索引**:查询的列都包含在索引中,不需要回表
|
||||
```sql
|
||||
EXPLAIN SELECT id, name FROM users WHERE name LIKE 'A%';
|
||||
-- 如果 (id, name) 是复合索引
|
||||
```
|
||||
2. **索引排序**:使用索引进行全表扫描,但按索引顺序
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM users ORDER BY id;
|
||||
-- 如果 id 是主键
|
||||
```
|
||||
- **特点**:比 ALL 快,因为索引通常比表数据小
|
||||
|
||||
## 五、需要避免的性能问题类型
|
||||
|
||||
### **12. ALL**
|
||||
- **解释**:全表扫描
|
||||
- **出现场景**:
|
||||
- 没有使用索引
|
||||
- 索引失效
|
||||
- 表数据量很小,全表扫描更快
|
||||
- **示例**:
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM users WHERE phone = '123456789';
|
||||
-- phone 字段没有索引
|
||||
```
|
||||
|
||||
## 六、性能对比图表
|
||||
|
||||
```
|
||||
性能从高到低:
|
||||
system > const > eq_ref > ref > fulltext > ref_or_null >
|
||||
index_merge > unique_subquery > index_subquery > range > index > ALL
|
||||
```
|
||||
|
||||
### 视觉化性能对比:
|
||||
|
||||
```
|
||||
查询类型 | 性能 | 扫描方式
|
||||
-----------------|------|--------
|
||||
system | ⭐⭐⭐⭐⭐ | 单行,常量
|
||||
const | ⭐⭐⭐⭐⭐ | 主键/唯一索引查找
|
||||
eq_ref | ⭐⭐⭐⭐ | 唯一索引关联
|
||||
ref | ⭐⭐⭐ | 非唯一索引查找
|
||||
range | ⭐⭐ | 索引范围扫描
|
||||
index | ⭐ | 全索引扫描
|
||||
ALL | 🚫 | 全表扫描
|
||||
```
|
||||
|
||||
## 七、实际优化建议
|
||||
|
||||
### 1. **理想情况**:至少达到 **range** 级别
|
||||
```sql
|
||||
-- 目标:使 type 达到 range 或更好
|
||||
EXPLAIN SELECT * FROM logs WHERE created_at > '2023-01-01';
|
||||
-- 为 created_at 添加索引
|
||||
CREATE INDEX idx_created_at ON logs(created_at);
|
||||
```
|
||||
|
||||
### 2. **避免 ALL 类型**
|
||||
```sql
|
||||
-- 优化前:type = ALL(全表扫描)
|
||||
EXPLAIN SELECT * FROM products WHERE description LIKE '%discount%';
|
||||
|
||||
-- 优化方案1:添加全文索引(对于文本搜索)
|
||||
CREATE FULLTEXT INDEX idx_description ON products(description);
|
||||
|
||||
-- 优化方案2:使用更精确的条件
|
||||
EXPLAIN SELECT * FROM products
|
||||
WHERE tag = 'discount' -- 添加 tag 字段并建立索引
|
||||
AND description LIKE '%discount%';
|
||||
```
|
||||
|
||||
### 3. **索引覆盖优化**
|
||||
```sql
|
||||
-- 优化前:可能使用 index 或 range
|
||||
EXPLAIN SELECT id, name, email FROM users
|
||||
WHERE email LIKE 'a%';
|
||||
|
||||
-- 优化后:创建覆盖索引
|
||||
CREATE INDEX idx_email_name ON users(email, name);
|
||||
-- 现在查询只扫描索引,不需要回表
|
||||
```
|
||||
|
||||
## 八、常见问题排查
|
||||
|
||||
### 问题1:为什么使用了索引还是慢?
|
||||
```sql
|
||||
EXPLAIN SELECT * FROM orders
|
||||
WHERE status = 'shipped' AND created_at > '2023-01-01';
|
||||
-- type 可能是 range 或 ref,但:
|
||||
-- 1. 检查选择性:如果 status='shipped' 占 90% 的数据,索引效果差
|
||||
-- 2. 考虑创建复合索引:CREATE INDEX idx_status_created ON orders(status, created_at)
|
||||
```
|
||||
|
||||
### 问题2:为什么没使用我期望的索引?
|
||||
```sql
|
||||
-- 强制使用索引查看效果
|
||||
EXPLAIN SELECT * FROM users USE INDEX (idx_email)
|
||||
WHERE email LIKE 'a%';
|
||||
|
||||
-- 对比不使用索引
|
||||
EXPLAIN SELECT * FROM users IGNORE INDEX (idx_email)
|
||||
WHERE email LIKE 'a%';
|
||||
```
|
||||
|
||||
记住:**type 只是性能评估的一个维度**,还需要结合 `rows`(扫描行数)、`Extra`(额外信息)等字段综合判断查询性能。
|
||||
@@ -0,0 +1,213 @@
|
||||
|
||||
|
||||
|
||||
|
||||
> 项目跑了五年的 MySQL 5.7,某天下午决定升到 8.0。迁移脚本顺利跑完,服务重启,然后——连接报错、查询行为异常、某个 GROUP BY 语句直接执行失败。排查到凌晨两点,才把所有问题逐一定位清楚。这些坑本可以提前避开。
|
||||
|
||||
## **前言**
|
||||
|
||||
MySQL 5.7 已于 **2023年10月正式 EOL**,不再有安全补丁,继续用的风险只会越来越高。但"要不要升"从来不是问题,问题是"升之前要搞清楚哪些东西会变"。本文把两个版本的核心差异逐一拆开,踩过的坑全写在里面。
|
||||
|
||||
## **一、默认字符集:从 latin1 到 utf8mb4**
|
||||
|
||||
这是升级后最容易被忽视、也最容易踩坑的地方。
|
||||
|
||||
|版本|默认字符集|默认排序规则|
|
||||
|---|---|---|
|
||||
|MySQL 5.7|latin1|latin1_swedish_ci|
|
||||
|MySQL 8.0|utf8mb4|utf8mb4_0900_ai_ci|
|
||||
|
||||
MySQL 5.7 的默认字符集是 `latin1`,大量中文项目在建库时如果没有手动指定 `utf8mb4`,就会踩表情符号存储失败、中文乱码等问题。8.0 默认就是 `utf8mb4`,这个历史遗留坑算是填上了。
|
||||
|
||||
但要注意:`utf8mb4_0900_ai_ci` 的排序规则和 5.7 常用的 `utf8mb4_general_ci` **行为不完全一致**,迁移时如果直接 dump/restore,可能导致排序结果、索引行为出现细微差异。建表时建议显式指定,别依赖默认值。
|
||||
|
||||
## **二、认证插件变了,连接可能直接报错**
|
||||
|
||||
这是 8.0 升级后反馈最多的"坑"之一。
|
||||
|
||||
MySQL 8.0 将默认认证插件从 `mysql_native_password` 改为 `caching_sha2_password`。
|
||||
|
||||
```text
|
||||
-- 查看当前用户的认证插件
|
||||
SELECT user, host, plugin FROM mysql.user;
|
||||
```
|
||||
|
||||
旧版驱动(比如某些 PHP、Java 早期 JDBC 驱动、Navicat 老版本)不支持 `caching_sha2_password`,连接时会直接报错:
|
||||
|
||||
```text
|
||||
Authentication plugin 'caching_sha2_password' cannot be loaded
|
||||
```
|
||||
|
||||
**临时解法**是把特定账户改回旧插件:
|
||||
|
||||
```text
|
||||
ALTER USER 'your_user'@'%' IDENTIFIED WITH mysql_native_password BY 'your_password';
|
||||
```
|
||||
|
||||
但长期来看应该升级驱动。安全性上,`caching_sha2_password` 比 `mysql_native_password` 更强,是正确方向。
|
||||
|
||||
> ⚠️ 注意:MySQL 8.4 开始已彻底废弃 `mysql_native_password`,8.0 用户如果在过渡期,要提前把驱动升到位。
|
||||
|
||||
## **三、SQL 能力大幅增强**
|
||||
|
||||
这是 8.0 最值得升级的理由之一,尤其对写复杂查询的开发来说。
|
||||
|
||||
### **3.1 窗口函数(Window Functions)**
|
||||
|
||||
5.7 没有窗口函数,要实现排名、滑动求和这类需求,只能靠变量模拟,写法丑且性能差。8.0 原生支持:
|
||||
|
||||
```text
|
||||
-- 按部门分组,对每个员工计算薪资排名
|
||||
SELECT
|
||||
name,
|
||||
dept,
|
||||
salary,
|
||||
RANK() OVER (PARTITION BY dept ORDER BY salary DESC) AS salary_rank
|
||||
FROM employees;
|
||||
```
|
||||
|
||||
类似的还有 `ROW_NUMBER()`、`DENSE_RANK()`、`LAG()`、`LEAD()`、`SUM() OVER()` 等,这些在数据分析、报表场景里极其常用。
|
||||
|
||||
### **3.2 公共表表达式(CTE)**
|
||||
|
||||
支持 `WITH` 语法,递归查询终于可以写了:
|
||||
|
||||
```text
|
||||
-- 递归查询组织架构
|
||||
WITH RECURSIVE org AS (
|
||||
SELECT id, name, parent_id, 1 AS depth
|
||||
FROM department WHERE parent_id IS NULL
|
||||
UNION ALL
|
||||
SELECT d.id, d.name, d.parent_id, o.depth + 1
|
||||
FROM department d
|
||||
JOIN org o ON d.parent_id = o.id
|
||||
)
|
||||
SELECT * FROM org;
|
||||
```
|
||||
|
||||
5.7 要实现同样逻辑,要么存储过程,要么应用层递归,代码量和维护成本都更高。
|
||||
|
||||
### **3.3 JSON 能力全面增强**
|
||||
|
||||
5.7 引入了 JSON 类型,但操作函数偏基础。8.0 大幅扩展了 JSON 函数库,新增了:
|
||||
|
||||
- `JSON_TABLE()`:将 JSON 数组展开成关系表,可直接 JOIN 查询
|
||||
- `->>`:简化的 JSON 路径提取操作符
|
||||
- 对 JSON 索引的优化支持更完善
|
||||
|
||||
对于半结构化数据存 MySQL 的场景,8.0 的 JSON 能力明显更成熟。
|
||||
|
||||
## **四、性能:8.0 整体更强,但有细节**
|
||||
|
||||
官方 Benchmark 数据显示,MySQL 8.0 在高并发读写场景下比 5.7 有明显提升,尤其是:
|
||||
|
||||
- **InnoDB 读写锁优化**:减少了 redo log 的锁竞争,高并发写入吞吐量更高
|
||||
- **Hash Join**:8.0.18 起支持 Hash Join,某些等值 JOIN 场景性能提升显著
|
||||
- **隐式排序消除**:优化器对 GROUP BY 不再默认排序,在不需要有序结果时更快
|
||||
|
||||
不过也有反例:部分复杂查询在 8.0 上因为优化器策略变化,执行计划反而比 5.7 差。升级前建议用线上慢查询日志做一轮回归测试,重点关注执行计划是否有变化。
|
||||
|
||||
```text
|
||||
-- 对比执行计划
|
||||
EXPLAIN FORMAT=JSON SELECT ...;
|
||||
```
|
||||
|
||||
## **五、数据字典:从文件迁移到 InnoDB**
|
||||
|
||||
5.7 的数据字典部分存在 `.frm` 文件中,部分在 `information_schema` 里,管理分散,数据库文件目录下一堆 `.frm` 文件是常见风景。
|
||||
|
||||
8.0 将数据字典完全迁移到 InnoDB 系统表,不再有 `.frm` 文件。好处是:
|
||||
|
||||
- DDL 操作支持**原子性**(Atomic DDL):`CREATE TABLE` 失败不会留下半截文件
|
||||
- `information_schema` 查询性能提升
|
||||
- 数据库文件目录更干净
|
||||
|
||||
## **六、不可见索引(Invisible Index)**
|
||||
|
||||
运维场景里很实用的一个功能。
|
||||
|
||||
```text
|
||||
-- 将索引设为不可见(优化器不会使用,但索引仍然维护)
|
||||
ALTER TABLE orders ALTER INDEX idx_status INVISIBLE;
|
||||
|
||||
-- 验证没有这个索引时的查询性能,没问题再删除
|
||||
ALTER TABLE orders DROP INDEX idx_status;
|
||||
```
|
||||
|
||||
5.7 想验证"删掉某个索引会不会影响查询",只能真删,发现有问题再重建,代价很高。8.0 可以先设置为不可见,观察一段时间没问题再正式删除,给了一个反悔的机会。
|
||||
|
||||
## **七、角色管理(Role-Based Access Control)**
|
||||
|
||||
5.7 的权限管理是直接给用户 GRANT,账号一多就乱。8.0 引入了 Role:
|
||||
|
||||
```text
|
||||
-- 创建角色并授权
|
||||
CREATE ROLE 'app_read';
|
||||
GRANT SELECT ON mydb.* TO 'app_read';
|
||||
|
||||
-- 把角色赋给用户
|
||||
GRANT 'app_read' TO 'alice'@'%';
|
||||
```
|
||||
|
||||
对于多人协作、权限分层管理的团队来说,这个功能能省不少重复操作。
|
||||
|
||||
## **八、两个版本的主要差异汇总**
|
||||
|
||||
|维度|MySQL 5.7|MySQL 8.0|
|
||||
|---|---|---|
|
||||
|官方维护状态|❌ 已停止(2023.10 EOL)|✅ 活跃维护中|
|
||||
|默认字符集|latin1|utf8mb4|
|
||||
|默认认证插件|mysql_native_password|caching_sha2_password|
|
||||
|窗口函数|❌ 不支持|✅ 支持|
|
||||
|CTE / 递归查询|❌ 不支持|✅ 支持|
|
||||
|Hash Join|❌ 不支持|✅ 支持(8.0.18+)|
|
||||
|原子 DDL|❌|✅|
|
||||
|不可见索引|❌|✅|
|
||||
|RBAC 角色管理|❌|✅|
|
||||
|数据字典存储|.frm 文件 + InnoDB|全部 InnoDB|
|
||||
|JSON 能力|基础|增强(JSON_TABLE 等)|
|
||||
|高并发写入性能|基准|整体更优|
|
||||
|
||||
## **九、怎么选?**
|
||||
|
||||
### **新项目:直接上 8.0**
|
||||
|
||||
没有历史包袱,没有理由选 5.7。8.0 的 SQL 能力、性能、安全性全面领先,且是官方当前维护的版本。选稳定的 GA 版本(比如 8.0.36+),不要追最新的 8.4 或 9.x,坑还没被社区踩完。
|
||||
|
||||
### **存量项目:评估后计划迁移**
|
||||
|
||||
核心建议是**不要拖**,5.7 已经没有安全补丁了,跑在生产上的风险会越来越高。
|
||||
|
||||
迁移步骤建议:
|
||||
|
||||
```text
|
||||
1. 升级驱动和 ORM 版本,确认兼容 caching_sha2_password
|
||||
2. 在测试环境搭 8.0,导入生产数据跑回归测试
|
||||
3. 重点检查:字符集、排序规则、执行计划变化、触发器/存储过程
|
||||
4. 用 pt-upgrade 或 MySQL Shell 的升级检查工具做兼容性扫描
|
||||
5. 灰度切流,监控错误日志和慢查询
|
||||
```
|
||||
|
||||
### **短期无法迁移的存量项目**
|
||||
|
||||
如果因为各种原因(比如旧系统改不动、第三方软件限制)暂时无法升级:
|
||||
|
||||
- 确保数据库不直接暴露在公网
|
||||
- 定期审计账号权限,关掉不用的账号
|
||||
- 把升级计划排进 roadmap,设一个明确的截止时间
|
||||
|
||||
## **十、常见升级踩坑速查**
|
||||
|
||||
|问题|原因|解决方案|
|
||||
|---|---|---|
|
||||
|连接报认证错误|驱动不支持 caching_sha2_password|升级驱动 或 改用 mysql_native_password|
|
||||
|查询结果排序变了|排序规则从 general_ci 变为 0900_ai_ci|建表时显式指定排序规则|
|
||||
|GROUP BY 报错|8.0 对非聚合字段的检查更严格|修复 SQL,显式使用聚合函数或 ANY_VALUE()|
|
||||
|存储过程/函数行为异常|SQL mode 默认值变化|检查 sql_mode,按需调整|
|
||||
|执行计划变差|优化器策略调整|用 HINT 或 optimizer_switch 强制执行计划|
|
||||
|
||||
## **总结**
|
||||
|
||||
MySQL 8.0 不只是版本号的升级,从 SQL 能力到底层架构都有实质性改进。5.7 的 EOL 也意味着继续使用的技术债会越来越重。
|
||||
|
||||
对于新项目,8.0 是唯一合理的选择。对于存量项目,建议把迁移提上日程,越早处理,成本越低。
|
||||
@@ -0,0 +1,252 @@
|
||||
---
|
||||
url: https://www.zhihu.com/follow
|
||||
web-message:
|
||||
web-badge-color: ""
|
||||
web-badge-message:
|
||||
date: 2024-04-08 16:05:52
|
||||
---
|
||||
|
||||
> ## 前言:
|
||||
>
|
||||
> MySQL的性能是大家在使用时十分关心的问题,比如在高并发访问时,并且有慢sql存在的情况下,MySQL的性能会明显下降,这会导致数据库响应时间变慢,甚至导致数据库宕机。那么为了避免Mysql性能问题,比较常用的方式创建适当的索引,提升sql语句的执行效率。而本文简单介绍一下和索引有关的回表,从实际案例出发,讲讲什么是回表,如何避免回表,如何减少回表。
|
||||
>
|
||||
> ## 实际案例:
|
||||
>
|
||||
> 前置仓产能动态ETA时效降级需求,提供一个数据同步接口,接送大数据同步过来的前置仓的仓负债和配负债,需要支持批量,最多可支持10个批量。
|
||||
>
|
||||
> 表结构如下,可以看到唯一索引是 UNIQUE KEY \`uniq\_shop\` (\`shop\_id\`,\`shop\_type\`)
|
||||
>
|
||||
> ```
|
||||
> CREATE TABLE `shop_load_degrade_strategy` (
|
||||
> `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键ID',
|
||||
> `shop_id` int(11) unsigned NOT NULL DEFAULT '0' COMMENT '门店ID',
|
||||
> `shop_type` int(11) NOT NULL DEFAULT '0' COMMENT '门店类型',
|
||||
> `current_store_load` int(10) NOT NULL DEFAULT '0' COMMENT '当前仓负载',
|
||||
> `active_store_load` int(10) NOT NULL DEFAULT '0' COMMENT '正在使用的仓负载',
|
||||
> `active_store_degrade_delay` int(11) NOT NULL DEFAULT '0' COMMENT '正在使用的仓降级时间分钟数',
|
||||
> `current_delivery_load` int(10) NOT NULL DEFAULT '0' COMMENT '当前配送负载',
|
||||
> `active_delivery_load` int(10) NOT NULL DEFAULT '0' COMMENT '正在使用的配送负载',
|
||||
> `active_delivery_degrade_delay` int(11) NOT NULL DEFAULT '0' COMMENT '正在使用的配送降级时间分钟数',
|
||||
> `current_load_active_auto` tinyint(3) unsigned NOT NULL DEFAULT '0' COMMENT '仓配负载自动生效,1开启',
|
||||
> `enable` tinyint(3) unsigned NOT NULL DEFAULT '0' COMMENT '是否开启,1开启',
|
||||
> `artificial_active_time` datetime DEFAULT NULL COMMENT '运营手动生效时间',
|
||||
> `active_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '最后生效时间',
|
||||
> `approver` varchar(100) DEFAULT NULL COMMENT '审批人',
|
||||
> `status` tinyint(4) NOT NULL DEFAULT '0' COMMENT '状态:1启用,0失效',
|
||||
> `yn` tinyint(3) unsigned NOT NULL DEFAULT '0' COMMENT '1删除',
|
||||
> `update_pin` varchar(50) NOT NULL DEFAULT '' COMMENT '最后修改人',
|
||||
> `update_time` datetime NOT NULL COMMENT '修改时间',
|
||||
> `create_pin` varchar(50) NOT NULL DEFAULT '' COMMENT '创建人',
|
||||
> `create_time` datetime NOT NULL COMMENT '创建时间',
|
||||
> `ts` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '时间戳',
|
||||
> PRIMARY KEY (`id`),
|
||||
> UNIQUE KEY `uniq_shop` (`shop_id`,`shop_type`),
|
||||
> KEY `idx_active_time` (`active_time`),
|
||||
> KEY `idx_update_pin` (`update_pin`)
|
||||
> ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COMMENT='门店负载降级策略表';
|
||||
>
|
||||
> ```
|
||||
>
|
||||
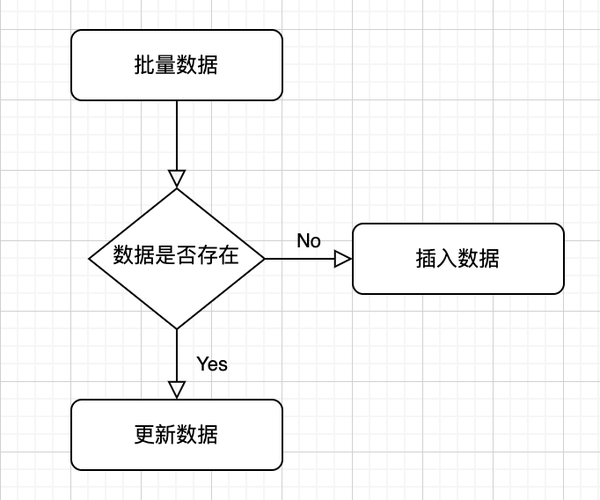
> ### 数据处理流程
|
||||
>
|
||||
> 
|
||||
>
|
||||
> ### 最简单的处理方式就是,逐条数据处理
|
||||
>
|
||||
> ```
|
||||
> public void handRecords(List<ShopLoadDegradeStrategy> records){
|
||||
> for(ShopLoadDegradeStrategy shopLoadDegradeStrategy: records){
|
||||
> dbShopLoadDegradeStrategy = findByshopIdAndShopType(shopLoadDegradeStrategy);
|
||||
> if(null != dbShopLoadDegradeStrategy)
|
||||
> shopLoadDegradeStrategy.setId(dbShopLoadDegradeStrategy.getId())
|
||||
> updateById(shopLoadDegradeStrategy);
|
||||
> }else{
|
||||
> insert(shopLoadDegradeStrategy);
|
||||
> }
|
||||
> }
|
||||
> }
|
||||
>
|
||||
> ```
|
||||
>
|
||||
> ### 最初的优化思想的减少网络传输次数
|
||||
>
|
||||
> ```
|
||||
> public void handRecords(List<ShopLoadDegradeStrategy> records){
|
||||
> //批量查询
|
||||
> List<ShopLoadDegradeStrategy> dbShopLoadDegradeStrategys = findAllByshopIdAndShopTypeList(records);
|
||||
> updateShopLoadDegradeStrategys,insertShopLoadDegradeStrategys = handleShopLoadDegradeStrategys(records,dbShopLoadDegradeStrategys);
|
||||
> updateForEach(updateShopLoadDegradeStrategys);
|
||||
> //批量插入
|
||||
> batchInsert(insertShopLoadDegradeStrategys);
|
||||
> }
|
||||
>
|
||||
> ```
|
||||
>
|
||||
> ### 具体sql语句:
|
||||
>
|
||||
> 批量按照门店Id和门店类型查询数据是否存在
|
||||
>
|
||||
> ```
|
||||
> select * from shop_load_degrade_strategy where (shop_id=? and shop_type=?) or (shop_id=? and shop_type=?)
|
||||
>
|
||||
> ```
|
||||
>
|
||||
> 存在更新数据, 因为shop\_id和shop\_type是组合的唯一索引,所以按照主键更新和按照唯一索引更新的结果是一样的。但是过程真的一样吗?
|
||||
>
|
||||
> ```
|
||||
> update shop_load_degrade_strategy set current_store_load=?,current_delivery_load=? where shop_id=? and shop_type=?
|
||||
>
|
||||
> ```
|
||||
>
|
||||
> 看是很简单的两个sql语句,explain分析sql执行计划,可以看出用到了索引,并且sql语句执行也很快,不存在慢sql的问题。还有优化的空间吗?
|
||||
>
|
||||
> ### 优化过程分析
|
||||
>
|
||||
> ### 先简单介绍一下索引按物理存储分类
|
||||
>
|
||||
> mysql的B+树
|
||||
>
|
||||
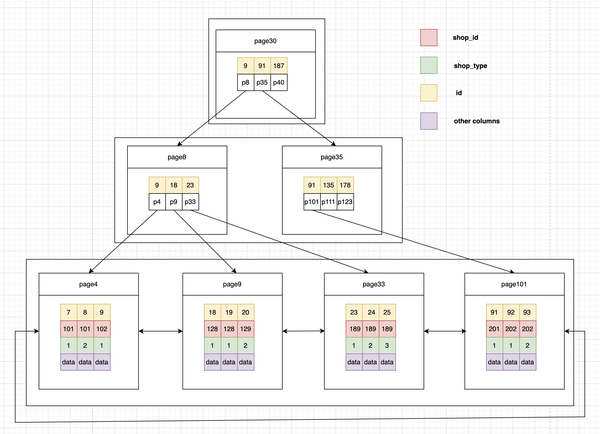
> 1)聚集索引(聚簇索引) InnoDB的聚簇索引就是按照主键顺序构建 B+Tree结构。叶子节点存储数据行的数据。
|
||||
>
|
||||
> 
|
||||
>
|
||||
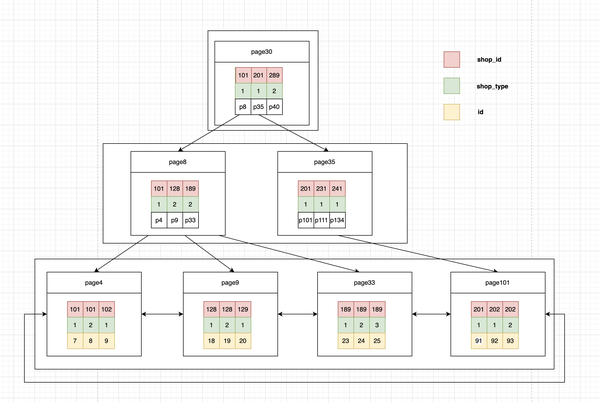
> 2)辅助索引(二级索引) InnoDB的辅助索引就是按照索引列构建 B+Tree结构。叶子节点存储的是索引列的值以及对应行的主键值
|
||||
>
|
||||
> 
|
||||
>
|
||||
> 覆盖索引并不是说是索引结构,覆盖索引是一种很常用的优化手段。因为在使用辅助索引的时候,我们只可以拿到主键值,相当于获取数据还需要再根据主键查询主键索引再获取到数据。但是试想下这么一种情况,在上面shop\_load\_degrade\_strategy表中的组合索引查询时,如果我只需要id,shop\_id,shop\_type字段的,那是不是意味着我们查询到组合索引的叶子节点就可以直接返回了,而不需要回表。这种情况就是覆盖索引。
|
||||
>
|
||||
> ### 查询sql语句优化为:
|
||||
>
|
||||
> ```
|
||||
> select id,shop_id,shop_type from shop_load_degrade_strategy where (shop_id=? and shop_type=?) or (shop_id=? and shop_type=?)
|
||||
>
|
||||
> 优化前
|
||||
> 1.select * from shop_load_degrade_strategy where (shop_id=? and shop_type=?) or (shop_id=? and shop_type=?)
|
||||
>
|
||||
> ```
|
||||
>
|
||||
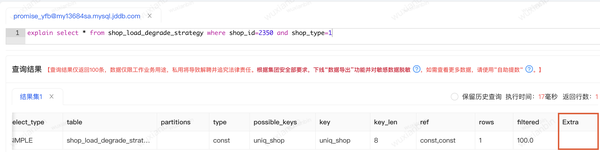
> 优化前:
|
||||
>
|
||||
> 1.先查询辅助索引找到对应的主键Id
|
||||
>
|
||||
> 2.然后通过id回表查询数据表的数据。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> 优化后
|
||||
>
|
||||
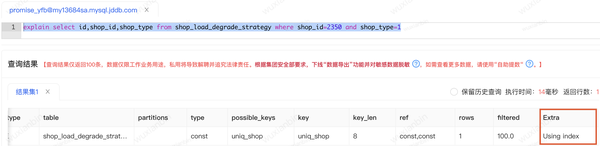
> 1.只需要查询辅助索引就可以,通过查询辅助索引就可以查询到所以需要的列,想要使用覆盖索引,查询的结果的列只能包含在辅助索引列和主键索引列。通过查看sql计划可以到Extra的值为Using index。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> 总结:优化前要查询除了索引字段(shop\_id,shop\_type)和主键(id)之外的字段,不能用到覆盖索引这种方式。所以在编写sql的时候,查询的数据列一定是满足业务的最小列集合,首先减少网络传输的数据量,同时也会减少应用的内存使用,还有看看能不能使用到覆盖索引这种方式进行优化,有些情况下甚至会在辅助索引中增加联合索引的列来使用到覆盖索引减少回表。
|
||||
>
|
||||
> ### 更新sql语句的优化
|
||||
>
|
||||
> ```
|
||||
> 优化后:
|
||||
> update shop_load_degrade_strategy set current_store_load=?,current_delivery_load=? where id=?
|
||||
> 优化前:
|
||||
> update shop_load_degrade_strategy set current_store_load=?,current_delivery_load=? where shop_id=? and shop_type=?
|
||||
>
|
||||
> ```
|
||||
>
|
||||
> 优化前的更新语句虽然使用到了辅助索引作为查询条件来进行数据更新,但是mysql执行sql的过程为:
|
||||
>
|
||||
> 1.先查询辅助索引找到索引对应的主键Id
|
||||
>
|
||||
> 2.然后通过id回表查询数据表的数据。
|
||||
>
|
||||
> 3.最后更新数据。
|
||||
>
|
||||
> 优化后的sql执行过程为:
|
||||
>
|
||||
> 1.通过id回表查询数据表的数据。
|
||||
>
|
||||
> 2.最会更新对应id的数据,
|
||||
>
|
||||
> 从以上描述可以看出,减少回表也是我们优化sql语句的一种很重要的思想。通过减少回表这个思想和处理数据的方式,引出说明一下mysql索引下推这个概念,其核心思想就是减少回表
|
||||
>
|
||||
> ## 什么是索引下推
|
||||
>
|
||||
> 索引下推(Index Condition Pushdown,索引条件下推,简称ICP),是MySQL5.6版本的新特性,它可以在对联合索引遍历过程中,对索引中包含的所有字段先做判断,过滤掉不符合条件的记录之后再回表,能有效的减少回表次数(目前我们使用的mysql版本较高,一般大家可能感觉这是正常的,但是mysql5.6之前都不是这样实现的,下面会细细道来)。
|
||||
>
|
||||
> ### 适用条件
|
||||
>
|
||||
> 我们先来了解一下索引下推的使用条件及限制:
|
||||
>
|
||||
> •只支持select。
|
||||
>
|
||||
> •当需要访问全表时,ICP用于range,ref,eq\_ref和ref\_or\_null访问类型。
|
||||
>
|
||||
> •ICP可用于InnoDB和MyISAM表,包括分区的InnoDB和MyISAM表。(5.6版本不适用分区表查询,5.7版本后可以用于分区表查询)。
|
||||
>
|
||||
> •对于InnDB引擎只适用于二级索引(也叫辅助索引),因为InnDB的聚簇索引会将整行数据读到InnDB的缓冲区,这样一来索引条件下推的主要目的减少IO次数就失去了意义。因为数据已经在内存中了,不再需要去读取了。
|
||||
>
|
||||
> •在虚拟生成列上创建的辅助索引不支持ICP(注:InnoDB支持虚拟生成列的辅助索引)。
|
||||
>
|
||||
> •使用了子查询的条件无法下推。
|
||||
>
|
||||
> •使用存储过程或函数的条件无法下推(因为因为存储引擎没有调用存储过程或函数的能力)。
|
||||
>
|
||||
> ### 原理介绍
|
||||
>
|
||||
> 1.**未使用ICP的情况下:**
|
||||
>
|
||||
> •存储引擎读取索引记录;
|
||||
>
|
||||
> •根据索引中的主键值,定位并读取完整的行记录;
|
||||
>
|
||||
> •存储引擎把记录交给Server层去检测该记录是否满足WHERE条件。
|
||||
>
|
||||
> 1.**使用ICP的情况下:**
|
||||
>
|
||||
> •存储引擎读取索引记录(不是完整的行记录);
|
||||
>
|
||||
> •判断WHERE条件部分能否用索引中的列来做检查,条件不满足,则处理下一行索引记录;
|
||||
>
|
||||
> •条件满足,使用索引中的主键去定位并读取完整的行记录(就是所谓的回表);
|
||||
>
|
||||
> •存储引擎把记录交给Server层,Server层检测该记录是否满足WHERE条件的其余部分。
|
||||
>
|
||||
> ### 具体例子
|
||||
>
|
||||
> 聚簇索引
|
||||
>
|
||||
> 
|
||||
>
|
||||
> 辅助索引
|
||||
>
|
||||
> 
|
||||
>
|
||||
> 假设有一条查询语句
|
||||
>
|
||||
> ```
|
||||
> select * from shop_load_degrade_strategy where shop_id <102 and shop_type=1;
|
||||
>
|
||||
> ```
|
||||
>
|
||||
> 根据索引最左匹配原则,上面这个sql语句在查索引树的时候,只能用102,查到第一个满足条件的记录:id为7,8两条记录。
|
||||
>
|
||||
> 那接下来我们具体看一下 使用与未使用ICP的情况。
|
||||
>
|
||||
> 未使用ICP情况下:
|
||||
>
|
||||
> 1.存储引擎根据联合索引先找到shop\_id<102 的主键id(7、8),再逐一进行回表扫描,去聚簇索引找到完整的行记录,再根据条件shop\_type=1对拿到的数据进行筛,可以看到有两次回表。
|
||||
>
|
||||
> 使用ICP情况下:
|
||||
>
|
||||
> 1.存储引擎会根据(shop\_id,shop\_type)联合索引,找到shop\_id <102,由于联合索引中包含shop\_type
|
||||
>
|
||||
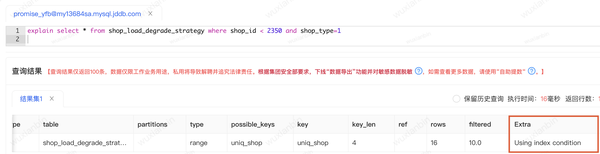
> 列,所以存储引擎直接再联合索引里按照条件shop\_type=1进行过滤,就只会找到主键id(7),然后根据过滤后的数据再依次进行回表扫描。可以看到只有一次回表。通过sql执行计划可以看出 Extra的值为“Using index condition”表示使用了索引下推。
|
||||
>
|
||||
> 
|
||||
>
|
||||
> ## 结语:
|
||||
>
|
||||
> 回表操作:当所要查找的字段不在非主键索引树上时,需要通过叶子节点的主键值去主键索引上获取对应的行数据,这个过程称为回表操作,可以看出Mysql通过索引下推来减少回表次数,从而提高sql性能。所以在项目开发编写sql语句的时候,要时刻注意是否可以通过减少回表或者不回表来优化sql性能,减少Mysql数据性能的压力。
|
||||
>
|
||||
> 参考文献:
|
||||
>
|
||||
> [https://dev.mysql.com/doc/refman/5.6/en/index-condition-pushdown-optimization.htm](https://link.zhihu.com/?target=https%3A//dev.mysql.com/doc/refman/5.6/en/index-condition-pushdown-optimization.html)
|
||||
@@ -0,0 +1,68 @@
|
||||
操作用户
|
||||
```
|
||||
su - openGauss
|
||||
```
|
||||
|
||||
|
||||
登录
|
||||
```
|
||||
gsql -d postgres -p 15000
|
||||
```
|
||||
|
||||
|
||||
|
||||
- 用户和数据库状态一键查询脚本
|
||||
```
|
||||
SELECT
|
||||
u.usename as "用户名",
|
||||
d.datname as "数据库名",
|
||||
CASE WHEN d.datdba = u.usesysid THEN '所有者' ELSE '使用者' END as "关系类型",
|
||||
CASE WHEN u.usesysid = (SELECT datdba FROM pg_database WHERE datname = d.datname)
|
||||
THEN '是' ELSE '否' END as "是否为所有者",
|
||||
has_database_privilege(u.usename, d.datname, 'CONNECT') as "连接权限",
|
||||
has_database_privilege(u.usename, d.datname, 'CREATE') as "创建表权限"
|
||||
FROM pg_user u
|
||||
CROSS JOIN pg_database d
|
||||
WHERE d.datname NOT LIKE 'template%'
|
||||
ORDER BY u.usename, d.datname;
|
||||
```
|
||||
|
||||
|
||||
查看当前用户权限
|
||||
```
|
||||
SELECT
|
||||
rolname,
|
||||
rolcreatedb,
|
||||
rolsuper
|
||||
FROM pg_roles
|
||||
WHERE rolname = current_user;
|
||||
```
|
||||
|
||||
- 创建用户
|
||||
```
|
||||
CREATE USER future WITH PASSWORD 'FutureV587?'
|
||||
SYSADMIN -- 授予系统管理员权限
|
||||
CREATEDB -- 授予创建数据库的权限
|
||||
CONNECTION LIMIT 100; -- 限制最大连接数为100
|
||||
```
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
- 创建数据库
|
||||
```
|
||||
CREATE DATABASE futrue
|
||||
WITH
|
||||
OWNER = future -- 指定所有者为 omm
|
||||
ENCODING = 'UTF8' -- 设置编码
|
||||
LC_COLLATE = 'en_US.UTF-8' -- 排序规则
|
||||
LC_CTYPE = 'en_US.UTF-8' -- 字符分类
|
||||
CONNECTION LIMIT = -1; -- 连接数限制(-1表示无限制)
|
||||
```
|
||||
|
||||
|
||||
退出
|
||||
```
|
||||
\q
|
||||
```
|
||||
@@ -0,0 +1,20 @@
|
||||
- 依赖少
|
||||
- 速度快
|
||||
- 结构简单易扩展
|
||||
|
||||
- SQLite单机百万TPS并发压测:[Scaling SQLite to 4M QPS on a Single Server (EC2 vs Bare Metal)](https://link.zhihu.com/?target=https%3A//blog.expensify.com/2018/01/08/scaling-sqlite-to-4m-qps-on-a-single-server/)。
|
||||
- SQLite未来可支持多个并发写入:官方出品的[SQLite HC-tree](https://link.zhihu.com/?target=https%3A//sqlite.org/hctree/doc/hctree/doc/hctree/index.html),尝试替换老的[B-tree](https://link.zhihu.com/?target=https%3A//sqlite.org/src4/doc/trunk/www/bt.wiki)数据结构,能实现多写多读、分布式节点复制与更大的数据库大小限制,[压测结果很不错](https://link.zhihu.com/?target=https%3A//sqlite.org/hctree/doc/hctree/doc/hctree/threadtest.wiki)。
|
||||
|
||||
Litefs相比Litestream要更进一步。Litefs通过提供一个基于FUSE的文件系统给SQLite做VFS层,当Leader节点要更新数据库时,该节点的SQLite的Pager模块要调用VFS层写入数据时,Litefs能够在页面级别复制与这个事务相关的页面集合,通过把这些页面集合打包成一个LTX数据格式的文件包,然后通过HTTP协议将这个文件包发送给只读节点,完成了数据的跨节点同步。
|
||||
|
||||
|
||||
|
||||
### Browser-compatible
|
||||
|
||||
SQLite可以通过WebAssembly(WASM)技术运行在浏览器中,以下两个项目能让前端代码在浏览器中发起SQL查询:
|
||||
|
||||
- [sql.js](https://link.zhihu.com/?target=https%3A//github.com/sql-js/sql.js/):JS代码导入该库后,通过网络请求下载SQLite数据库文件到浏览器内存中,即可发起SQL查询获取数据结果。
|
||||
- [absurd-sql](https://link.zhihu.com/?target=https%3A//github.com/jlongster/absurd-sql):和sql.js的区别在于,该项目可以使用浏览器的IndexedDB作为持久化存储,能对SQLite数据库文件进行读写操作。
|
||||
|
||||
OLTP数据库,很少用它做OLAP
|
||||
|
||||
@@ -0,0 +1,47 @@
|
||||
|
||||
## start.sh 注意事项
|
||||
|
||||
You need to specify one of the following as an environment variable: - MYSQL_ROOT_PASSWORD - MYSQL_ALLOW_EMPTY_PASSWORD - MYSQL_RANDOM_ROOT_PASSWORD
|
||||
|
||||
|
||||
|
||||
## DBear 连接 Mysql
|
||||
|
||||
1. 右键数据库连接 → **编辑连接**。
|
||||
2. 切换到 **驱动属性** 标签页。
|
||||
3. 找到或添加以下两个属性:
|
||||
- `allowPublicKeyRetrieval` = `true`
|
||||
- `useSSL` = `false`(如果不需要加密,设置为 `false` 可以绕过 SSL 要求)
|
||||
|
||||
|
||||
## 数据库内部维护
|
||||
进入容器
|
||||
```
|
||||
docker exec -it mysql bash
|
||||
```
|
||||
|
||||
使用 root 登录
|
||||
```
|
||||
mysql -u root -p
|
||||
```
|
||||
|
||||
|
||||
查看登录模式
|
||||
```
|
||||
SELECT User, Host, plugin FROM mysql.user WHERE User = 'root';
|
||||
```
|
||||
|
||||
|
||||
|
||||
## Mysql 区分大小写
|
||||
|
||||
```
|
||||
SELECT @@lower_case_table_names;
|
||||
```
|
||||
|
||||
|
||||
|返回值|含义|大小写行为|
|
||||
|---|---|---|
|
||||
|**0**|大小写**敏感**(Linux 默认)|`MyTable` ≠ `mytable`|
|
||||
|**1**|**忽略大小写**,MySQL 自动将名称转为小写存储|`MyTable` = `mytable`|
|
||||
|**2**|按原样存储,比较时忽略大小写(macOS 默认)|`MyTable` 存储原样,比较时忽略|
|
||||
@@ -0,0 +1,453 @@
|
||||
> 虽然使用docker部署比较方便,但是不建议使用docker部署数据库,尤其是比较关键的系统,负载比较大的系统。
|
||||
|
||||
|
||||
# 1 部署规划
|
||||
|
||||
本次部署的是2节点主备集群+1个确认监视器的集群架构。使用的操作系统是centos7.6,cpu架构是x86。
|
||||
|
||||
## 1.1集群ip规划
|
||||
|
||||

|
||||
|
||||
## 1.2集群端口规划
|
||||
|
||||

|
||||
|
||||
## 1.3实例参数规划
|
||||
|
||||
数据库的初始化参数至关重要,一些重要参数如页大小,数据库字符集和大小写是否敏感等,一旦初始化实例是不能直接修改的,如果要修改,必须重新再初始化实例,所以一定要和应用人员沟通清楚。
|
||||

|
||||
|
||||
## 1.4磁盘映射
|
||||
|
||||

|
||||
|
||||
## 1.5目录规划(对应docker内)
|
||||
|
||||

|
||||
|
||||
# 2 部署前宿主机优化
|
||||
|
||||
## 2.1关闭防火墙
|
||||
|
||||
```gauss
|
||||
systemctl stop firewalld
|
||||
systemctl disable firewalld
|
||||
```
|
||||
|
||||
## 2.2关闭selinux
|
||||
|
||||
容器运行需要对/proc/self/attr/keycreate有写权限,因此需要将SELINUX配置为disable。
|
||||
|
||||
```awk
|
||||
setenforce 0
|
||||
sed -i 's#SELINUX=enforcing#SELINUX=disabled#g' /etc/selinux/config
|
||||
```
|
||||
|
||||
# 3 部署步骤
|
||||
|
||||
## 3.1 部署docker
|
||||
|
||||
```autoit
|
||||
[root@docker ~]#yum install -y docker
|
||||
启动docker:
|
||||
[root@docker ~]# systemctl start docker
|
||||
```
|
||||
|
||||
## 3.2 加载数据库主备集群docker镜像包
|
||||
|
||||
根据操作系统版本和cpu架构,申请对应的DM8主备集群docker镜像包,下载后,上传到主节点服务器,如/opt目录。
|
||||
执行以下命令,加载docker镜像:
|
||||
|
||||
```stylus
|
||||
docker load -i dm8_20230224_rev178822_x86_rh6_64_docker_dw.tar
|
||||
```
|
||||
|
||||

|
||||
查看加载的镜像:docker images
|
||||

|
||||
镜像重命名:
|
||||
|
||||
```crmsh
|
||||
docker tag dmwatcher:dm8_20230224_rev178822_x86_rh6_64_docker_dw dmwatcher:dm8_dw
|
||||
```
|
||||
|
||||

|
||||
|
||||
## 3.3配置docker网络
|
||||
|
||||
本次部署主备集群,主库节点、备库节点和监视器节点分别部署在3台服务器上,所以采用HOST模式(容器使用宿主机的IP和端口)。这种方式需要在/etc/hosts文件中配置映射关系,否则容器运行后可能拿到的地址是127.0.0.1,而非本机的真正IP地址。三台服务器均需修改,更改如下:
|
||||
|
||||
```accesslog
|
||||
主库节点:
|
||||
vi /etc/hosts
|
||||
192.168.1.10 host localhost
|
||||
备库节点:
|
||||
vi /etc/hosts
|
||||
192.168.1.11 host localhost
|
||||
监视器节点:
|
||||
vi /etc/hosts
|
||||
192.168.1.12 host localhost
|
||||
```
|
||||
|
||||
## 3.4运行容器
|
||||
|
||||
### 3.4.1运行监视器容器
|
||||
|
||||
```routeros
|
||||
docker run -d --name dmwatcher_monitor --restart=always --privileged=true --net host -e DMWATCHER_ROLE=monitor -e CLUSTER_IPS="192.168.1.10,192.168.1.11,192.168.1.12" -e LD_LIBRARY_PATH=/opt/dmdbms/bin -v /dmdata/dmwatcher_monitor:/opt/dmdbms/data dmwatcher:dm8_dw
|
||||
```
|
||||
|
||||
### 3.4.2运行备库容器
|
||||
|
||||
```routeros
|
||||
docker run -d --name dmwatcher_standby -p 5236:5236 --restart=always --privileged=true --net host -e DMWATCHER_ROLE=standby -e DW_NO=2 -e CLUSTER_IPS="192.168.1.10,192.168.1.11,192.168.1.12" -e LD_LIBRARY_PATH=/opt/dmdbms/bin -v /dmdata/dmwatcher_standby:/opt/dmdbms/data dmwatcher:dm8_dw
|
||||
```
|
||||
|
||||
### 3.4.3运行主库容器
|
||||
|
||||
```routeros
|
||||
docker run -d --name dmwatcher_primary -p 5236:5236 --restart=always --privileged=true --net host -e PAGE_SIZE=32 -e extent_size=32 -e CASE_SENSITIVE=1 -e charset=1 -e DMWATCHER_ROLE=primary -e DW_NO=1 -e CLUSTER_IPS="192.168.1.10,192.168.1.11,192.168.1.12" -e LD_LIBRARY_PATH=/opt/dmdbms/bin -v /dmdata/dmwatcher_primary:/opt/dmdbms/data dmwatcher:dm8_dw
|
||||
```
|
||||
|
||||
注意:需要根据实际情况,设置对应的数据库页大小,字符集,大小写是否敏感,字符以字节还是字符为单位等数据库初始化参数。
|
||||
|
||||
### 3.4.4查看运行的容器
|
||||
|
||||
```ebnf
|
||||
docker ps
|
||||
```
|
||||
|
||||

|
||||

|
||||

|
||||
|
||||
### 3.4.5查看容器应用运行日志:
|
||||
|
||||
```powershell
|
||||
docker logs dmwatcher_monitor -f
|
||||
docker logs dmwatcher_standby -f
|
||||
docker logs dmwatcher_primary -f
|
||||
```
|
||||
|
||||
会发现主库这里一直卡在传输文件到备节点和监视器节点。
|
||||

|
||||
|
||||
### 3.4.6手动拷贝软件和主库备份到其他节点
|
||||
|
||||
```elixir
|
||||
scp BACKUP_FILE_01.tar DAMENG.tar 192.168.1.11:/dmdata/dmwatcher_standby
|
||||
scp BACKUP_FILE_01.tar DAMENG.tar 192.168.1.12:/dmdata/dmwatcher_monitor
|
||||
```
|
||||
|
||||

|
||||
|
||||
### 3.4.7重启所有节点的容器
|
||||
|
||||
重启主库、备库和监视器的容器,会自动对软件包和备份文件进行解压执行。
|
||||
|
||||
```maxima
|
||||
docker restart dmwatcher_primary
|
||||
docker restart dmwatcher_standby
|
||||
docker restart dmwatcher_monitor
|
||||
```
|
||||
|
||||
分别各节点日志,发现主备节点都显示SYSTEM IS READY,启动到了MOUNT状态,但是一直无法OPEN。监视器也显示不对,这时候要排查各节点的配置文件是否正确,且主备库是否设置了primary/standby模式,是否设置了相同的oguid。
|
||||
|
||||
### 3.4.8修改主备库的相关配置文件
|
||||
|
||||
#### 3.4.8.1数据库参数配置文件dm.ini
|
||||
|
||||
```makefile
|
||||
主库设置:
|
||||
[root@dmdb01 ~]# cd /dmdata/dmwatcher_primary/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dm.ini
|
||||
INSTANCE_NAME = DW1 #数据库实例名
|
||||
PORT_NUM = 5236 #数据库实例监听端口
|
||||
DW_INACTIVE_INTERVAL = 60 #接收守护进程消息超时时间
|
||||
ALTER_MODE_STATUS = 0 #不允许手工方式修改实例模式/状态/oguid
|
||||
ENABLE_OFFLINE_TS = 2 #不允许备库OFFLINE表空间
|
||||
MAL_INI = 1 #打开MAL系统
|
||||
ARCH_INI = 1 #打开归档配置
|
||||
备库设置:
|
||||
[root@dmdb01 ~]# cd /dmdata/dmwatcher_standby/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dm.ini
|
||||
INSTANCE_NAME = DW2 #数据库实例名
|
||||
PORT_NUM = 5236 #数据库实例监听端口
|
||||
DW_INACTIVE_INTERVAL = 60 #接收守护进程消息超时时间
|
||||
ALTER_MODE_STATUS = 0 #不允许手工方式修改实例模式/状态/oguid
|
||||
ENABLE_OFFLINE_TS = 2 #不允许备库OFFLINE表空间
|
||||
MAL_INI = 1 #打开MAL系统
|
||||
ARCH_INI = 1 #打开归档配置
|
||||
```
|
||||
|
||||
#### 3.4.8.2修改dmmal.ini配置文件
|
||||
|
||||
```makefile
|
||||
主库和备库的配置是一样的,主库配置如下:
|
||||
[root@dmdb01 DAMENG]# cd /dmdata/dmwatcher_primary/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dmmal.ini
|
||||
MAL_CHECK_INTERVAL = 5
|
||||
MAL_CONN_FAIL_INTERVAL = 5
|
||||
[MAL_INST1]
|
||||
MAL_INST_NAME = DW1
|
||||
MAL_HOST = 192.168.1.10
|
||||
MAL_PORT = 61141
|
||||
MAL_INST_HOST = 192.168.1.10
|
||||
MAL_INST_PORT = 5236
|
||||
MAL_DW_PORT = 52141
|
||||
MAL_INST_DW_PORT = 33141
|
||||
[MAL_INST2]
|
||||
MAL_INST_NAME = DW2
|
||||
MAL_HOST = 192.168.1.11
|
||||
MAL_PORT = 61141
|
||||
MAL_INST_HOST = 192.168.1.11
|
||||
MAL_INST_PORT = 5236
|
||||
MAL_DW_PORT = 52141
|
||||
MAL_INST_DW_PORT = 33141
|
||||
```
|
||||
|
||||
#### 3.4.8.3修改归档配置文件dmarch.ini
|
||||
|
||||
```makefile
|
||||
主库设置如下:
|
||||
[root@dmdb01 DAMENG]# cd /dmdata/dmwatcher_primary/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dmarch.ini
|
||||
[ARCHIVE_REALTIME1]
|
||||
ARCH_TYPE = REALTIME
|
||||
ARCH_DEST = DW2
|
||||
[ARCHIVE_LOCAL1]
|
||||
ARCH_TYPE = LOCAL
|
||||
ARCH_DEST = /opt/dmdbms/data/DAMENG/arch
|
||||
ARCH_FILE_SIZE = 1024
|
||||
ARCH_SPACE_LIMIT = 10240 #根据实际磁盘设置,建议要能保存2个全备之间的归档。这里设置的是10G
|
||||
备库设置如下:
|
||||
[root@dmdb02 DAMENG]# cd /dmdata/dmwatcher_standby/DAMENG
|
||||
[root@dmdb02 DAMENG]# vi dmarch.ini
|
||||
[ARCHIVE_REALTIME1]
|
||||
ARCH_TYPE = REALTIME
|
||||
ARCH_DEST = DW1
|
||||
[ARCHIVE_LOCAL1]
|
||||
ARCH_TYPE = LOCAL
|
||||
ARCH_DEST = /opt/dmdbms/data/DAMENG/arch
|
||||
ARCH_FILE_SIZE = 1024
|
||||
ARCH_SPACE_LIMIT = 10240
|
||||
```
|
||||
|
||||
#### 3.4.8.4修改数据守护进程文件dmwatcher.ini
|
||||
|
||||
```makefile
|
||||
主库配置如下:
|
||||
[root@dmdb01 DAMENG]# cd /dmdata/dmwatcher_primary/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dmwatcher.ini
|
||||
[GRP453331]
|
||||
DW_TYPE = GLOBAL
|
||||
DW_MODE = AUTO
|
||||
DW_ERROR_TIME = 10
|
||||
INST_RECOVER_TIME = 60
|
||||
INST_ERROR_TIME = 10
|
||||
INST_OGUID = 453331
|
||||
INST_INI = /opt/dmdbms/data/DAMENG/dm.ini
|
||||
INST_AUTO_RESTART = 1
|
||||
INST_STARTUP_CMD = /opt/dmdbms/bin/dmserver
|
||||
RLOG_SEND_THRESHOLD = 0
|
||||
RLOG_APPLY_THRESHOLD = 0
|
||||
备库配置如下:
|
||||
[root@dmdb02 DAMENG]# cd /dmdata/dmwatcher_standby/DAMENG/
|
||||
[root@dmdb02 DAMENG]# vi dmwatcher.ini
|
||||
[GRP453331]
|
||||
DW_TYPE = GLOBAL
|
||||
DW_MODE = AUTO
|
||||
DW_ERROR_TIME = 10
|
||||
INST_RECOVER_TIME = 60
|
||||
INST_ERROR_TIME = 10
|
||||
INST_OGUID = 453331
|
||||
INST_INI = /opt/dmdbms/data/DAMENG/dm.ini
|
||||
INST_AUTO_RESTART = 1
|
||||
INST_STARTUP_CMD = /opt/dmdbms/bin/dmserver
|
||||
RLOG_SEND_THRESHOLD = 0
|
||||
RLOG_APPLY_THRESHOLD = 0
|
||||
```
|
||||
|
||||
#### 3.4.8.5设置数据库模式和oguid
|
||||
|
||||
```elixir
|
||||
主库执行:
|
||||
[root@dmdb01 opt]# docker exec -it dmwatcher_primary /bin/bash
|
||||
root@dmdb01:/# cd /opt/dmdbms/bin
|
||||
root@dmdb01:/opt/dmdbms/bin# ./disql sysdba/SYSDBA001
|
||||
SP_SET_PARA_VALUE(1,'ALTER_MODE_STATUS',1);
|
||||
ALTER DATABASE PRIMARY;
|
||||
SP_SET_OGUID(453331);
|
||||
SP_SET_PARA_VALUE(1,'ALTER_MODE_STATUS',0);
|
||||
备库执行:
|
||||
[root@dmdb02 DAMENG]# docker exec -it dmwatcher_standby /bin/bash
|
||||
root@dmdb02:/# cd /opt/dmdbms/bin
|
||||
root@dmdb02:/opt/dmdbms/bin# ./disql sysdba/SYSDBA001
|
||||
SP_SET_PARA_VALUE(1,'ALTER_MODE_STATUS',1);
|
||||
ALTER DATABASE STANDBY;
|
||||
SP_SET_OGUID(453331);
|
||||
SP_SET_PARA_VALUE(1,'ALTER_MODE_STATUS',0);
|
||||
```
|
||||
|
||||
#### 3.4.8.6修改监视器配置文件dmmonitor.ini
|
||||
|
||||
```makefile
|
||||
确认监视器配置如下:
|
||||
[root@dmmonitor ~]# cd /dmdata/dmwatcher_monitor/DAMENG/
|
||||
[root@dmmonitor DAMENG]# vi dmmonitor.ini
|
||||
MON_DW_Confirm = 1
|
||||
MON_LOG_PATH = /opt/dmdbms/data/log
|
||||
MON_LOG_INTERVAL = 60
|
||||
MON_LOG_FILE_SIZE = 128
|
||||
MON_LOG_SPACE_LIMIT = 1024
|
||||
[GRP453331]
|
||||
MON_INST_OGUID = 453331
|
||||
MON_DW_IP = 192.168.1.11:52141
|
||||
MON_DW_IP = 192.168.1.10:52141
|
||||
```
|
||||
|
||||
#### 3.4.8.7更新数据库授权
|
||||
|
||||
上传数据库的授权文件dm.key到/opt,更新主库和备库的数据库授权。
|
||||
|
||||
```vim
|
||||
主库操作:
|
||||
[root@dmdb01 ~]# cd /opt/
|
||||
[root@dmdb01 opt]# docker cp dm.key dmwatcher_primary:/opt/dmdbms/bin
|
||||
备库操作:
|
||||
[root@dmdb02 ~]# cd /opt/
|
||||
[root@dmdb02 opt]# docker cp dm.key dmwatcher_standby:/opt/dmdbms/bin
|
||||
```
|
||||
|
||||
当然这里也可以在创建容器的时候就指定授权文件。指定-v参数:
|
||||
|
||||
```awk
|
||||
-v /opt/dm.key:/opt/dmdbms/bin/dm.key
|
||||
```
|
||||
|
||||
#### 3.4.8.8重启所有容器
|
||||
|
||||
```autoit
|
||||
先监视器,再主库,后备库:
|
||||
[root@dmmonitor DAMENG]# docker restart dmwatcher_monitor
|
||||
[root@dmdb01 opt]# docker restart dmwatcher_primary
|
||||
[root@dmdb02 opt]# docker restart dmwatcher_standby
|
||||
```
|
||||
|
||||
#### 3.4.8.9查看监视器状态
|
||||
|
||||
重启完主库和备库容器后,通过监视器查看集群是否启动成功,且主库和备库数据库都处于OPEN状态,且远程归档状态都是VALID。至此,主备集群部署完成。
|
||||

|
||||
|
||||
### 3.4.9优化数据库参数
|
||||
|
||||
分别登陆主库和备库节点,执行数据库参数优化脚本AutoParaAdj3.4_dm8.sql。优化完成后,重启主备集群容器。
|
||||
|
||||
# 4集群启停方式
|
||||
|
||||
## 4.1集群启动
|
||||
|
||||
先启动主库,再启动备库,最后启动确认监视器。启动后,通过监视器查询集群状态。
|
||||
|
||||
```autoit
|
||||
[root@data43 DAMENG]# docker start dmwatcher_primary
|
||||
[root@data44 DAMENG]# docker start dmwatcher_standby
|
||||
[root@monitoring DAMENG]# docker start dmwatcher_monitor
|
||||
```
|
||||
|
||||
## 4.2集群关闭
|
||||
|
||||
先关闭确认监视器,再关闭主库,最后关闭备库。
|
||||
|
||||
```autoit
|
||||
[root@monitoring DAMENG]# docker stop dmwatcher_monitor
|
||||
[root@data43 DAMENG]# docker stop dmwatcher_primary
|
||||
[root@data44 DAMENG]# docker stop dmwatcher_standby
|
||||
```
|
||||
|
||||
## 4.3数据库登陆方式
|
||||
|
||||
方法(1):进入容器,使用disql客户端登陆
|
||||
|
||||
```elixir
|
||||
[root@data43 DAMENG]# docker exec -it dmwatcher_primary bash
|
||||
root@data43:/# cd /opt/dmdbms/bin
|
||||
root@data43:/opt/dmdbms/bin# ./disql sysdba/SYSDBA001
|
||||
Server[LOCALHOST:5236]:mode is primary, state is open
|
||||
login used time : 4.520(ms)
|
||||
last login ip : ::1
|
||||
last login time : 2023-05-24 17:12:49
|
||||
login failed times : 0
|
||||
Whether password is expired : Not expired
|
||||
disql V8
|
||||
```
|
||||
|
||||
方法(2):使用达梦管理工具manager登陆:
|
||||

|
||||
|
||||
# 5应用链接方式
|
||||
|
||||
(1)数据库驱动:进入容器,数据库驱动位于/opt/dmdbms/drivers目录,如
|
||||
jdbc驱动,DmJdbcDriver18.jar(对应jdk1.8),DmJdbcDriver17.jar(对应jdk1.7)。
|
||||
(2)URL链接方式:采用服务名的方式链接达梦主备集群。
|
||||
配置文件不是xml文件,则配置如下:
|
||||
|
||||
```apache
|
||||
jdbc:dm://DMDW?DMDW=(192.168.1.10:5236, 192.168.1.11:5236)&LOGIN_MODE=(1)
|
||||
```
|
||||
|
||||
配置文件是xml文件,则配置如下:
|
||||
|
||||
```apache
|
||||
jdbc:dm://DMDW?DMDW=(192.168.1.10:5236, 192.168.1.11:5236) &LOGIN_MODE=(1)
|
||||
```
|
||||
|
||||
# 6docker参数解释
|
||||
|
||||

|
||||
|
||||
|
||||
|
||||
|
||||
docker run -d -p 15236:5236 --restart=always --name dmwatcher_primary --privileged=true --net docker1 --ip 172.28.0.2
|
||||
-e MODE=docker_dmwatcher
|
||||
-e PAGE_SIZE=32
|
||||
-e CASE_SENSITIVE=1
|
||||
-e UNICODE_FLAG=1
|
||||
-e BLANK_PAD_MODE=1
|
||||
-e SYSDBA_PWD=Skh_2025 -e SYSAUDITOR_PWD=Skh_2025 -e DMWATCHER_ROLE=primary -e DW_NO=1 -e CLUSTER_IPS="172.28.0.4,172.28.0.2,172.28.0.3" -v /data/deploy/dm-server/dm8/image/dm.key:/opt/dmdbms/bin/dm.key dm8:dm8_20241230_rev255012_HWarm_kylin10_64
|
||||
|
||||
|
||||
#!/bin/env bash
|
||||
# 运行主节点容器
|
||||
name=dmwatcher_primary
|
||||
img=dm8:dm8_20241230_rev255012_x86_kylin10_64
|
||||
docker rm -vf $name
|
||||
docker run -d \
|
||||
-p 30136:5236 \
|
||||
--restart=always \
|
||||
--name dmwatcher_primary \
|
||||
--privileged=true \
|
||||
--net net1 \
|
||||
--ip 172.20.0.2 \
|
||||
-e MODE=docker_dmwatcher \
|
||||
-e PAGE_SIZE=16 \
|
||||
-e CASE_SENSITIVE=1 \
|
||||
-e UNICODE_FLAG=1 \
|
||||
-e LENGTH_IN_CHAR=1 \
|
||||
-e SYSDBA_PWD=sunyard123 \
|
||||
-e DMWATCHER_ROLE=primary \
|
||||
-e DW_NO=1 \
|
||||
-e CLUSTER_IPS="172.20.0.2,172.20.0.3,172.20.0.4" \
|
||||
-e LD_LIBRARY_PATH=/opt/dmdbms/bin \
|
||||
-v `pwd`/dmwatcher_primary:/opt/dmdbms/data \
|
||||
-v `pwd`/dm1701120153.key:/opt/dmdbms/bin/dm.key \
|
||||
$img
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,5 @@
|
||||
```
|
||||
sqlite>.output /path/to/export.sql
|
||||
sqlite>.dump your_table_name
|
||||
sqlite>.output stdout
|
||||
```
|
||||
@@ -0,0 +1,9 @@
|
||||
社区版OceanBase支持调用Python和Java编写的UDF(User-Defined Function)。您可以使用Python或Java编写UDF函数,并将其部署到OceanBase中。在SQL查询中使用这些UDF函数可以增强查询功能,实现更复杂的数据处理和分析。
|
||||
但要注意的是,在使用UDF时需要遵循一些规则和限制,例如:
|
||||
|
||||
1. UDF函数必须具有唯一的函数名。
|
||||
2. UDF函数不能有输出参数。
|
||||
3. UDF函数不能修改数据库表结构。
|
||||
4. UDF函数不能访问其他数据库表的数据。
|
||||
5. UDF函数不能执行系统命令或调用外部程序。
|
||||
6. UDF函数的执行时间不能超过OceanBase的限制。
|
||||
@@ -0,0 +1,32 @@
|
||||
|
||||
|
||||
|
||||
## 隔离级别
|
||||
|
||||
READ UNCOMMITED(1)
|
||||
READ COMMITED(2)
|
||||
REPEATABLE READ(4)
|
||||
SERIALIZABLE(8)
|
||||
|
||||
![[Pasted image 20240326150557.png]]
|
||||
|
||||
|
||||
|隔离级别 \ 解决|脏读|不可重复读|幻读|
|
||||
|---|---|---|---|
|
||||
|未提交读|可能|可能|可能|
|
||||
|已提交读|不可能|可能|可能|
|
||||
|可重复读|不可能|不可能|可能|
|
||||
|可串行化|不可能|不可能|不可能|
|
||||
### 达梦与其他数据库隔离级别对比
|
||||
|
||||
| 隔离级别 \ 数据库 | 达梦 | Oracle | Postgresql | Mysql(InnoDB) |
|
||||
| ---------- | ------ | ------ | ---------- | ------------- |
|
||||
| 未提交读 | 支持 | 不支持 | 不支持 | 支持 |
|
||||
| 已提交读 | 支持(默认) | 支持(默认) | 支持(默认) | 支持 |
|
||||
| 可重复读 | 支持 | 支持 | 支持 | 支持(默认) |
|
||||
| 可串行化 | 支持 | 支持 | 支持 | 支持 |
|
||||
|
||||
## 参考文档
|
||||
- https://www.metisdata.io/blog/transaction-isolation-levels-and-why-we-should-care
|
||||
- https://www.percona.com/blog/differences-between-read-committed-and-repeatable-read-transaction-isolation-levels/
|
||||
- [[达梦数据库事务隔离级别介绍(https://blog.csdn.net/fd3200/article/details/115363097)]]
|
||||
@@ -0,0 +1,48 @@
|
||||
#### **查找连续两天漏打卡的人**
|
||||
|
||||
sql
|
||||
|
||||
复制
|
||||
|
||||
下载
|
||||
|
||||
-- 方法1:使用自连接
|
||||
SELECT DISTINCT a.user_id
|
||||
FROM attendance a
|
||||
LEFT JOIN attendance b ON a.user_id = b.user_id
|
||||
AND b.attendance_date = DATE_ADD(a.attendance_date, INTERVAL 1 DAY)
|
||||
WHERE b.id IS NULL -- 找不到下一天的记录
|
||||
AND a.attendance_date >= CURDATE() - INTERVAL 30 DAY;
|
||||
|
||||
-- 方法2:使用窗口函数(推荐,MySQL 8.0+)
|
||||
WITH attendance_gaps AS (
|
||||
SELECT
|
||||
user_id,
|
||||
attendance_date,
|
||||
LEAD(attendance_date) OVER (
|
||||
PARTITION BY user_id ORDER BY attendance_date
|
||||
) as next_date
|
||||
FROM attendance
|
||||
WHERE attendance_date >= CURDATE() - INTERVAL 30 DAY
|
||||
)
|
||||
SELECT DISTINCT user_id
|
||||
FROM attendance_gaps
|
||||
WHERE DATEDIFF(next_date, attendance_date) >= 2
|
||||
OR (next_date IS NULL AND attendance_date = CURDATE() - INTERVAL 1 DAY);
|
||||
|
||||
-- 方法3:使用日期维度表
|
||||
SELECT d.user_id
|
||||
FROM (
|
||||
-- 生成用户所有应该打卡的日期
|
||||
SELECT DISTINCT user_id, date_range.date
|
||||
FROM attendance
|
||||
CROSS JOIN (
|
||||
SELECT CURDATE() - INTERVAL n DAY as date
|
||||
FROM (SELECT 0 AS n UNION SELECT 1 UNION SELECT 2) days
|
||||
) date_range
|
||||
WHERE date_range.date BETWEEN CURDATE() - INTERVAL 30 DAY AND CURDATE()
|
||||
) d
|
||||
LEFT JOIN attendance a ON d.user_id = a.user_id AND d.date = a.attendance_date
|
||||
GROUP BY d.user_id
|
||||
HAVING SUM(CASE WHEN a.id IS NULL THEN 1 ELSE 0 END) >= 2
|
||||
AND MAX(d.date) - MIN(d.date) = 1; -- 连续两天
|
||||
@@ -0,0 +1,4 @@
|
||||
```
|
||||
SELECT SERIES_NO AS "序列号",CHECK_CODE AS "校验码 ",DECODE(SERVER_SERIES,'P','个人版','S','标准版','E','企业版','A','安全版 ','D','开发版') as "系列名称",DECODE(SERVER_TYPE,'1','正式版','2','测试版','3',' 试用版') as "版本类型",AUTHORIZED_CUSTOMER AS "最终用户",PROJECT_NAME AS "项目名 称",OS_TYPE AS "授权操作系统",CPU_TYPE AS "授权 CPU 类型",MAX_CPU_NUM AS "授权 CPU 个数",DECODE(CLUSTER_TYPE,'0000','无','0001','DSC','0010','RWC','0011','RWC、 DSC','0100','MPP','0101','MPP、DSC','0110','MPP、RWC','0111','MPP、RWC、 DSC','1000','DW','1001','DW、DSC','1010','DW、RWC','1011','DW、RWC、DSC','1100','DW、 MPP','1101','DW、MPP、DSC','1110','DW、MPP、RWC','1111','DW、MPP、RWC、DSC') as " 授权集群",EXPIRED_DATE AS "有效期",CONCURRENCY_USER_NUMBER AS "并发数" FROM V$LICENSE;
|
||||
```
|
||||
|
||||
@@ -0,0 +1,50 @@
|
||||
DM 数据守护系统结构参考图 2.1。主要由主库、备库、Redo 日志、Redo 日志传输、Redo 日志重演、守护进程(dmwatcher)、监视器(dmmonitor)组成。
|
||||
|
||||
![[Pasted image 20250314141939.png]]
|
||||
|
||||

|
||||
|
||||
图2.1 数据守护系统结构图
|
||||
|
||||
|
||||
**数据库与数据库实例**
|
||||
|
||||
数据库(Database)是一个文件集合(包括数据文件、临时文件、重做日志文件和控制文件),保存在物理磁盘或文件系统中。
|
||||
|
||||
数据库实例(Instance)就是一组操作系统进程(或者是一个多线程的进程)以及一些内存。通过数据库实例,可以操作数据库,一般情况下,我们访问、修改数据库都是通过数据库实例来完成的。
|
||||
|
||||
本文档将不再严格区分数据库和数据库实例的概念,很多地方会笼统的以库来代替。考虑到数据守护系统中,数据库实例名是唯一的,为了更准确地进行描述,很多情况下我们会以实例 xxx 来标记某一个主库或者备库。
|
||||
|
||||
**主库**
|
||||
|
||||
Primary 模式,提供完整数据库服务的实例,一般来说主库是用来直接支撑应用系统的生产库。
|
||||
|
||||
**备库**
|
||||
|
||||
Standby 模式,提供只读数据库服务的实例。备库除了用于容灾,还可以提供备份、查询等只读功能,并且备库还支持临时表的 Insert/Delete/Update 操作。
|
||||
|
||||
备库支持临时表修改主要基于两个因素:1.临时表数据的修改不会产生 Redo 日志,主库对临时表的修改无法同步到备库;2.可以提供更大灵活性,适应更多应用场景。
|
||||
|
||||
根据数据同步情况,备库又可以分为可切换备库和不可切换备库。可切换备库是指,主备库之间数据完全同步,主库发生故障、备库切换为主库后,不会造成任何数据丢失的备库。
|
||||
|
||||
**Redo 日志**
|
||||
|
||||
Redo 日志记录物理数据页内容变动情况,是数据库十分重要的一个功能,在数据库系统故障(比如服务器掉电)重启时,利用 Redo 日志可以把数据恢复到故障前的状态。
|
||||
|
||||
Redo 日志也是数据守护的实现基础,数据库中 Insert、Delete、Update 等 DML 操作以及 Create TABLE 等 DDL 操作最终都会体现为对某一个或者多个物理数据页的修改,因此备库通过重做 Redo 日志可以与主库数据保持一致。
|
||||
|
||||
**Redo 日志传输**
|
||||
|
||||
主备库之间的 Redo 日志传输,以日志包 RLOG_PKG 为单位,主库通过 MAL 系统发送 Redo 日志到备库。各种不同数据守护类型的区别,就在于主库日志包 RLOG_PKG 的发送时机,以及备库收到 Redo 日志后的处理策略。
|
||||
|
||||
**Redo 日志重演**
|
||||
|
||||
Redo 日志重演的过程,就是备库收到主库发送的 Redo 日志后,在物理数据页上,重新修改数据的过程。Redo 日志重演由专门的 Redo 日志重演服务完成,重演服务严格按照 Redo 日志产生的先后顺序,解析 Redo 日志、修改相应的物理数据页,并且重演过程中备库会生成自身的 Redo 日志写入联机日志文件。
|
||||
|
||||
**守护进程**
|
||||
|
||||
守护进程(dmwatcher)是数据守护系统的核心工具,监控数据库实例的运行状态和主备库数据同步情况,在出现故障时启动各种处理预案。守护进程是各种消息的中转站,接收数据库实例、其他守护进程、以及监视器发送的各种消息;同时,守护进程也会将收到的数据库实例消息转发给其他守护进程和监视器。守护进程必须和被守护的数据库实例部署在同一台机器上。
|
||||
|
||||
**监视器**
|
||||
|
||||
监视器(dmmonitor)用来监控守护系统内守护进程、数据库实例信息,执行用户输入命令、监控实例故障、实现自动切换等。监视器一般配置在数据库实例和守护进程以外的机器上。
|
||||
@@ -0,0 +1,26 @@
|
||||
表名: V$SQL_HISTORY
|
||||
|
||||
select
|
||||
|
||||
SQL_ID,
|
||||
|
||||
SESS_ID,
|
||||
|
||||
SESS_SEQ,
|
||||
|
||||
TRX_ID,
|
||||
|
||||
TOP_SQL_TEXT, -- 执行SQL内容
|
||||
|
||||
START_TIME, -- 执行SQL开始时间
|
||||
|
||||
TIME_USED, -- SQL执行时长
|
||||
|
||||
N_LOGIC_READ,
|
||||
|
||||
N_PHY_READ,
|
||||
|
||||
HARD_PARSE_FLAG
|
||||
FROM
|
||||
|
||||
V$SQL_HISTORY;
|
||||
@@ -0,0 +1,52 @@
|
||||
**创建自定义网络**
|
||||
使用network create来创建网络,创建命令如下:
|
||||
docker network create --subnet=172.20.0.0/24 net1
|
||||
|
||||
**规划集群IP信息**
|
||||
达梦Docker镜像支持部署一主多备,指定集群节点数和对应节点序号即可,这里介绍一主一备集群的部署过程,集群IP规划如下:
|
||||
|
||||
- 主节点(primary) :172.20.0.3
|
||||
- 备节点(standby):172.20.0.4
|
||||
- 监视器(monitor):172.20.0.2
|
||||
|
||||
**启动**
|
||||
|
||||
|
||||
|
||||
启动完成后,可通过如下命令输出日志来查看启动情况
|
||||
|
||||
#docker logs -f dmwatcher_primary //查看主数据库容器日志
|
||||
|
||||
#docker logs -f dmwatcher_standby //查看备数据库容器日志
|
||||
|
||||
#docker logs -f dmwatcher_monitor //查看监视器容器日志
|
||||
|
||||
可通过如下命令进入容器
|
||||
|
||||
#docker exec -it dmwatcher_primary /bin/bash //进入主数据库容器
|
||||
|
||||
#docker exec -it dmwatcher_standby /bin/bash //进入备数据库容器
|
||||
|
||||
#docker exec -it dmwatcher_monitor /bin/bash //进入监视器容器
|
||||
|
||||
**删除主备容器及挂载**
|
||||
|
||||
关闭容器:
|
||||
|
||||
#docker stop dmwatcher_primary dmwatcher_standby dmwatcher_monitor
|
||||
|
||||
查看全部容器:
|
||||
|
||||
#docker ps -a
|
||||
|
||||
删除容器:
|
||||
|
||||
#docker rm dmwatcher_primary dmwatcher_standby dmwatcher_monito
|
||||
|
||||
删除挂载:
|
||||
|
||||
#rm -rf /home/mnt/disks/dmwatcher_primary
|
||||
|
||||
#rm -rf /home/mnt/disks/dmwatcher_standby
|
||||
|
||||
#rm -rf /home/mnt/disks/dmwatcher_monitor
|
||||
Reference in New Issue
Block a user