vault backup: 2026-11-07 16:33:44
 cheney
@@ -0,0 +1,43 @@
|
||||
---
|
||||
title: "(99+ 封私信 / 90 条消息) 首页 - 知乎"
|
||||
source: "https://www.zhihu.com/"
|
||||
author:
|
||||
- "[[旅大统制齐戈飞疑似有点太多了]]"
|
||||
- "[[呆头龙研究生]]"
|
||||
- "[[心理咨询师手记每天帮您解析一个心理现象!每天帮您获得一个心理知识!]]"
|
||||
- "[[杜氏利什鳗鱼饭你看过 TA]]"
|
||||
- "[[广町七深Official「动植物学」领域答主]]"
|
||||
- "[[烈月你关注的「中华田园猫」也关注了 TA]]"
|
||||
- "[[两个女儿的妈妈你关注的「正义必胜客」也关注了 TA]]"
|
||||
- "[[奥术大师大所多「科技」领域答主]]"
|
||||
- "[[陈余关注 「中华田园猫」 的人也关注了 TA]]"
|
||||
- "[[昨日昨日「科技」领域答主]]"
|
||||
published:
|
||||
created: 2025-10-12
|
||||
description: "知乎,中文互联网高质量的问答社区和创作者聚集的原创内容平台,于 2011 年 1 月正式上线,以「让人们更好的分享知识、经验和见解,找到自己的解答」为品牌使命。知乎凭借认真、专业、友善的社区氛围、独特的产品机制以及结构化和易获得的优质内容,聚集了中文互联网科技、商业、影视、时尚、文化等领域最具创造力的人群,已成为综合性、全品类、在诸多领域具有关键影响力的知识分享社区和创作者聚集的原创内容平台,建立起了以社区驱动的内容变现商业模式。"
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||
这是好事啊!
|
||||
|
||||
从露西走出[东非大裂谷](https://zhida.zhihu.com/search?content_id=751251403&content_type=Answer&match_order=1&q=%E4%B8%9C%E9%9D%9E%E5%A4%A7%E8%A3%82%E8%B0%B7&zhida_source=entity)
|
||||
|
||||
这几百万年的进化,让繁衍的本能刻在了我们的基因里
|
||||
|
||||
而这种能展示女性曲线美的服饰正好可以合法合规的激发我们这种本能
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
[发布于 2025-10-11 08:59](https://www.zhihu.com/question/648920376/answer/1960268201888843649)
|
||||
@@ -0,0 +1,7 @@
|
||||
部署架构
|
||||
- 一体机。部署在密码设备内。
|
||||
|
||||
|
||||
技术栈
|
||||
SDK :C、Python、Java
|
||||
平台:
|
||||
@@ -0,0 +1,330 @@
|
||||
|
||||
|
||||
> **作者:**罗棋琛(Max Luo)
|
||||
>
|
||||
> **个人简介:**
|
||||
>
|
||||
> 1、资深网络安全专家,10 年从业经验,5 年乙方攻防、5 年甲方安全防御建设经验,在 SDL、DevSecOps、移动安全、API 安全、软件供应链安全、AI驱动应用安全、云安全、数据安全、红队攻防演练、欧盟GDPR技术落地等领域有丰富的实践经验。
|
||||
>
|
||||
> 2、现任 SHEIN 全球应用安全主管,曾任 SHEIN 中国应用安全主管和 全球安全BP 主管。在跨境电商和互联网科技企业有丰富的应用安全与隐私合规技术落地经验,擅长与利益相关者构建安全纵深防御体系,在管理风险的同时,有效平衡安全、业务、用户体验、成本和效率,应对全球应用安全和隐私合规挑战。
|
||||
>
|
||||
> **专业认证:**
|
||||
>
|
||||
> 1、OffSec Certified Professional (OSCP)
|
||||
>
|
||||
> 2、OffSec Experienced Penetration Tester (OSEP)
|
||||
>
|
||||
> 3、OffSec Web Expert (OSWE)
|
||||
>
|
||||
> 4、Offensive Cloud Security Specialist Certifications(AWS/Azure/GCP)
|
||||
|
||||
---
|
||||
|
||||
# 前言
|
||||
|
||||
在 IT 行业,35 岁宛如一道无形却又极具挑战性的坎,众多从业者行至此时,往往深陷职业发展的瓶颈与危机之中。一方面,技术更新换代的速度如脱缰之马,日新月异,特别是 AI 的蓬勃发展,正以前所未有的深度和广度重塑着整个行业格局,带来了巨大的技术竞争压力。与此同时,人才竞争压力也与日俱增,2024 年中国高校毕业生人数预计高达 1179 万人,再创历史峰值,使得包括 IT 行业在内的各个领域人才济济,竞争愈发激烈。此外,家庭与工作平衡的难题也如影随形,诸多问题交织在一起,让 35 岁以上的 IT 从业者举步维艰。
|
||||
|
||||
在技术层面,IT 行业的技术迭代之快令人咋舌,AI 技术的持续演进正深刻改变着行业的每一个角落。随着其发展,未来 AI 将全方位、深层次地融入各个领域。比如在软件开发领域,智能编程助手会朝着更智能的方向发展,不仅能轻松完成基础代码生成,还将在更复杂的架构设计中发挥重要作用;在数据分析领域,AI 算法也将具备自动挖掘深层次信息的能力,无需人工频繁干预。这一系列变化对于 IT 从业者而言,意味着以往积累的技术知识可能迅速过时。新编程语言和开发工具的不断涌现只是冰山一角,更为关键的是,整个 IT 工作流程和需求都在围绕 AI 重新构建。若无法适应这种基于 AI 的技术变革潮流,在职场竞争中必然会处于劣势。
|
||||
|
||||
从人才竞争角度来看,2024 年庞大的高校毕业生大军涌入就业市场,为各行业带来了丰富的人才资源,同时也让竞争压力急剧攀升。IT / 通信 / 电子 / 互联网行业是毕业生们心仪的热门领域,吸引了大量求职者。毕业生数量如此之多,求职竞争自然异常激烈。这使得企业在招聘时有了更多选择,相应地提高了招聘门槛。如此一来,35 岁以上的 IT 从业者在与年轻毕业生竞争时,原本的职场优势受到极大冲击,职业发展的稳定性也面临严峻挑战。
|
||||
|
||||
在此背景下,我希望能为处于 35 岁危机中的 IT 从业者提供一份自救指南。这些内容源于我在 SHEIN 的工作实践与经验总结。此前,我为产品研发中心的新晋管理者进行了一次沙龙分享,主题是 “职场中如何提升个人影响力”。很荣幸能将自己在 SHEIN 过去四年多学习和实践所积累的经验分享给产研中心的新晋管理者。如今,我把这些经验和见解整理成此文,希望能给 IT 同行们一些有益的借鉴。同时,我也鼓励大家运用批判性思维,根据自身实际情况来判断这些经验是否适用。
|
||||
|
||||
在 SHEIN 的这四年里,我在工作过程中得到了上下游合作伙伴的诸多帮助,他们优秀的思维与见解让我受益匪浅,使我在逻辑思维、跨文化沟通、团队管理和情绪管理等方面都有了显著的提升。这里要特别感谢我的老板 Leon Li ,感谢他给予的支持和宝贵机会,让我能够加入全球网络安全与风险管理中心(GSRM) ,参与到 SHEIN 的多元兼容发展进程中,与一群卓越的跨文化同事共同学习和成长。希望我的分享能为 IT 同行在应对 35 岁危机时提供一些助力。
|
||||
|
||||
## 文章结构
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
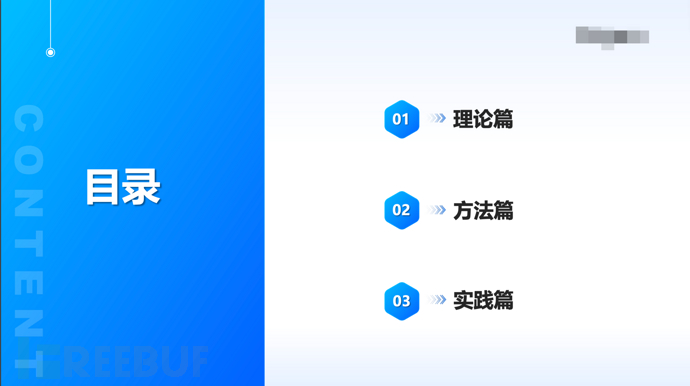
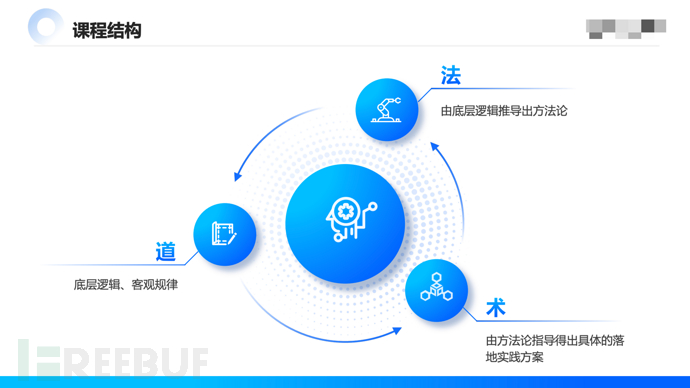
整篇文章分为理论篇、方法篇与实践篇,按照中国传统的道家哲学模型“道、法、术”三层结构展开。理论篇对应“道”,阐述的是底层逻辑和客观规律,方法篇对应“法”,由底层逻辑推导出的方法论或框架,实践篇对应“术”,由方法论指导并实践的方案指南。
|
||||
|
||||
# 一、理论篇:影响力的底层逻辑
|
||||
|
||||
|
||||
|
||||
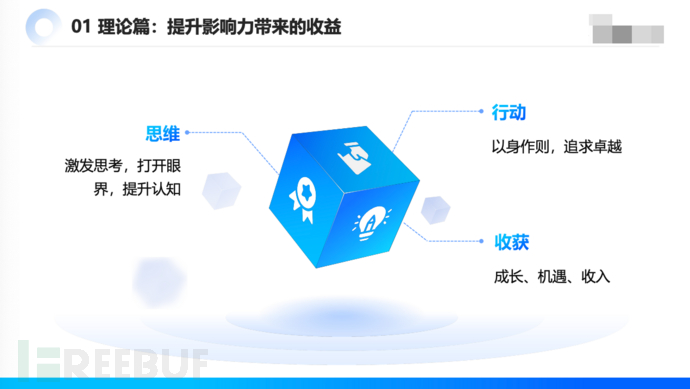
回顾成长历程中那些对我们产生积极影响力的良师益友,他们激发了我们的思考,打开了我们的眼界,提升了我们的思维和认知。并以身作则鼓励我们追求理想的生活和卓越的目标。在信念认知与行动上影响了我们,让我们在结果上收获了机遇、收入和成长。
|
||||
|
||||
提升个人影响力的过程也是提升个人综合能力的过程,当我们提升了个人能力之后同时具备给周围的人产生正向价值了,那我们的影响力也就随之而来。
|
||||
|
||||
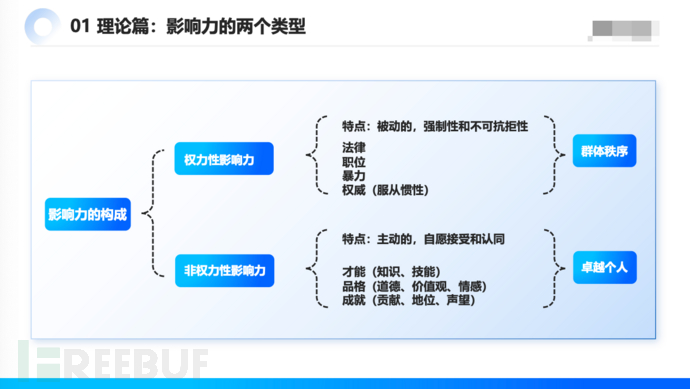
影响力的核心定义是“影响他人信念和行动的能力”。罗伯特·B·西奥迪尼(Robert B. Cialdini)在其著作《影响力》中,将影响力分为权力性影响力(Legitimate Influence)和非权力性影响力(Non-Legitimate Influence)。
|
||||
|
||||
## 1、权力性影响力
|
||||
|
||||
|
||||
|
||||
权力性影响力通过合法的权力或权威来影响他人,通常基于职位、专业知识或正式授权。特点是人们被动地接受,体现在法律、职位、暴力和权威等群体秩序的场景中。
|
||||
|
||||
例如:
|
||||
|
||||
1. 法官对罪犯有裁决权;
|
||||
|
||||
2. 经理通过其职位对团队成员施加影响;
|
||||
|
||||
3. 专家通过其专业知识对他人提出建议;
|
||||
|
||||
|
||||
## 2、非权力性影响力
|
||||
|
||||
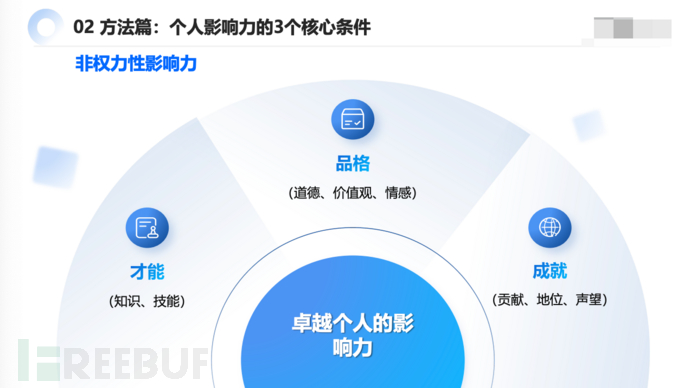
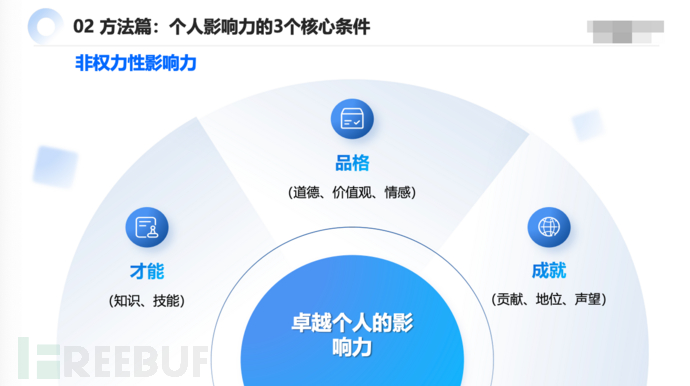
非权力性影响力不依赖正式权力或权威,而是通过个人魅力、威望、专业知识、个人关系或社会地位产生的影响。下图是将非权力性影响力具象为一个卓越的个人对周围人的影响,体现在才能(知识、技能),品格(道德、价值观、情感),成就(贡献、地位、声望)这三个核心标准中卓越的表现。
|
||||
|
||||
在中国文化中,德才兼备的人被认为是理想的领导者或团队成员,德才兼备的人不仅能够以正确的价值观和道德规范行事,还能够凭借其能力和才华做出贡献。在组织管理或人才选拔中,德才兼备被视为一个重要的标准。
|
||||
|
||||
例如:一个人可能因为其魅力、威望或专业知识而受到他人的尊重和追随。
|
||||
|
||||
|
||||
|
||||
## 3、 影响力原则(心理学中的作用要素)
|
||||
|
||||
|
||||
|
||||
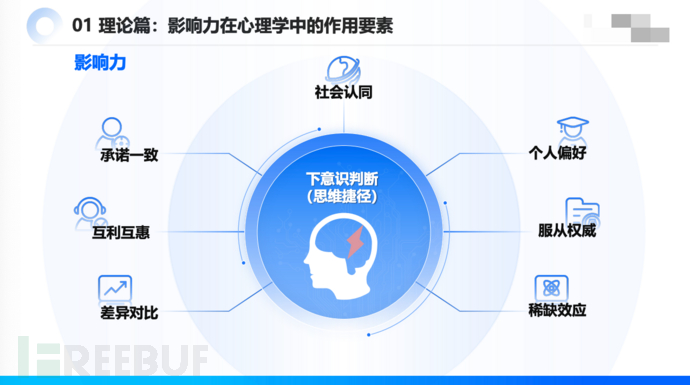
罗伯特·B·西奥迪尼(Robert B. Cialdini)提出的六个影响力原则,可以帮助理解如何增强影响力。这些原则包括互惠原则、承诺与一致性原则、社会认同原则、喜好原则、权威原则和稀缺原则。当符合这六大要素后,人们的思维活动会不自觉地从下意识做出判断,从而影响思维决策和具体行动。在思维活动中是一种决策捷径的表现。
|
||||
|
||||
### 1. 互惠原则(Reciprocity)
|
||||
|
||||
- 人们倾向于回报他人的善意行为。
|
||||
|
||||
- 例如,先给予小恩小惠,以便在将来得到更大的回报。
|
||||
|
||||
|
||||
### 2. 承诺与一致性原则(Commitment and Consistency)
|
||||
|
||||
- 一旦人们承诺了某个行为或观点,他们就会倾向于坚持这个承诺,以保持一致性。
|
||||
|
||||
- 例如,在销售过程中,通过让顾客做出小的承诺来引导他们做出更大的购买决策。
|
||||
|
||||
|
||||
### 3. 社会认同原则(Social Proof)
|
||||
|
||||
- 人们倾向于模仿他人的行为,尤其是在不确定或不确定如何行动时。
|
||||
|
||||
- 例如,利用“大家都这么做”的策略来影响人们的行为,这里面常见于文化或者群体中的价值观取向或者非理性的观念。
|
||||
|
||||
|
||||
### 4. 喜好原则(Liking)
|
||||
|
||||
- 人们更愿意答应自己认识和喜欢的人提出的要求。
|
||||
|
||||
- 例如,通过建立良好的个人关系来增加影响力。
|
||||
|
||||
|
||||
### 5. 权威原则(Authority)
|
||||
|
||||
- 人们倾向于服从权威人士的命令或建议。
|
||||
|
||||
- 例如,利用专家的意见或权威人士的认可来增加说服力。
|
||||
|
||||
|
||||
### 6. 稀缺原则(Scarcity)
|
||||
|
||||
- 人们认为资源越稀缺,价值越高。
|
||||
|
||||
- 例如,通过限制供应或时间来增加产品的吸引力,常见于饥饿营销策略。
|
||||
|
||||
|
||||
这些心理学要素可以帮助你理解和分析如何影响他人,以及如何更有效地使用这些原则来增强影响力。
|
||||
|
||||
# 二、方法篇:提升影响力的方法论
|
||||
|
||||
|
||||
|
||||
从理论篇中,我们得出卓越个人发挥影响力的三个核心条件:才能、品格、成就。本章重点讲述提升非权力性影响力的方法论,同时也是如何成为卓越的个人的方法论。
|
||||
|
||||
## 1、影响力冰山模型
|
||||
|
||||
|
||||
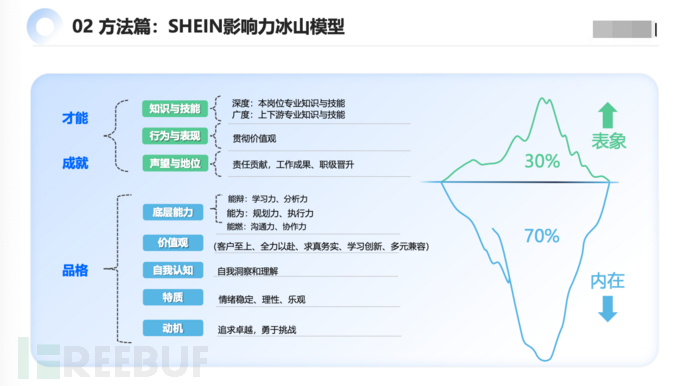
才能、成就和品格构成了职场影响力冰山模型。冰山上部分是知识与技能、日常行为、声望和地位;冰山下部分是底层能力、价值观、自我认知、特质和动机。冰山以上的行为表现是由冰山以下看不见的内在部分驱动。
|
||||
|
||||
### 1、冰山上
|
||||
|
||||
1. 知识与技能的体现本岗位的专业知识与技能的深度,这决定了你能否胜任当前岗位的最基本的能力。对专业上下游生态相关的知识与技能的掌握决定了你对你的行业理解的广度。
|
||||
|
||||
2. 在日常行为的体现对应的是基本的为人处世的行为准则以及每个企业的文化价值观的贯彻上。
|
||||
|
||||
3. 声望和地位体现个人对团队的贡献,工作与绩效成果,职级晋升,专业头衔。
|
||||
|
||||
|
||||
### 2、冰山下
|
||||
|
||||
1. 底层能力学习能力,洞察力,透过现象洞察本质规划能力、执行能力、行动力社交与沟通能力,跨团队的协作能力2. 价值观社会价值观和企业价值观
|
||||
|
||||
2. 自我认知自我定位,自我的洞察和理解,自我反思等能力
|
||||
|
||||
3. 特质持续稳定的情绪,理性思考、持续乐观心态等能力
|
||||
|
||||
4. 动机具备追求卓的意愿,勇于挑战自我
|
||||
|
||||
|
||||
## 2、影响力构建的5个方向
|
||||
|
||||
|
||||
|
||||
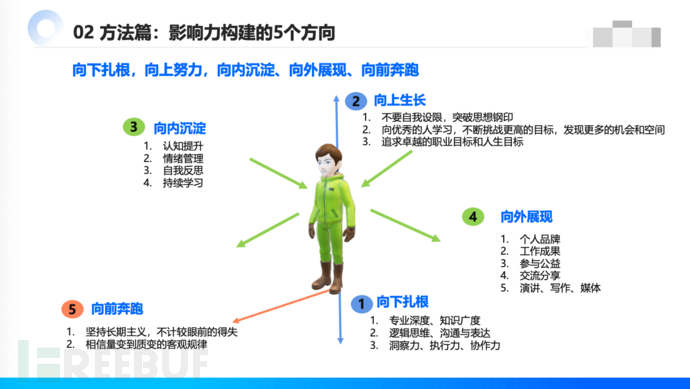
> 总结为一句话:向下扎根,向上努力,向内沉淀、向外展现、向前奔跑
|
||||
|
||||
### 1、向下扎根
|
||||
|
||||
1. 围绕着你的行业,像一棵大树一样向下扎根,在专业深度精进、在知识广度上扩展。
|
||||
|
||||
2. 提升逻辑思维能力,提升沟通与表达能力。
|
||||
|
||||
3. 提升对事物客观规律的理解,掌握透过现象洞察本质的能力,提高执行能力,跨团队协作能力。
|
||||
|
||||
|
||||
### 2、向上生长
|
||||
|
||||
1. 不要自我设限,突破思想钢印。
|
||||
|
||||
2. 向更优秀的人学习,只有不断挑战更高的目标,才能发现更多的机会和空间
|
||||
|
||||
3. 追求卓越的职业目标和人生目标
|
||||
|
||||
|
||||
### 3、向内沉淀
|
||||
|
||||
1. 提升自我认知,对自己的特点、能力、性格、价值观、动机、愿望、思想等方面有清晰的认识,知道自己的强项和弱点。
|
||||
|
||||
2. 做好情绪管理,保持情绪稳定,对家人、对团队、对周围的人传递积极正面的情绪。有利于维持良好的社交关系和培养理性思考的特质。
|
||||
|
||||
3. 自我反思是个人成长和自我提升的关键能力,通过复盘、反思持续提高自我的认识和修养。4. 学习能力是保持个人价值以及持续竞争力的核心能力。
|
||||
|
||||
|
||||
### 4、向外展现
|
||||
|
||||
1. 建设个人专业品牌
|
||||
|
||||
2. 展现工作成果
|
||||
|
||||
3. 积极参与公益与团队活动
|
||||
|
||||
4. 积极交流分享
|
||||
|
||||
5. 通过演讲、协作、媒体分享经验与见解
|
||||
|
||||
|
||||
### 5、向前奔跑
|
||||
|
||||
1. 坚持长期主义,不计较眼前的得失
|
||||
|
||||
2. 相信量变到质变的客观规律
|
||||
|
||||
|
||||
# 三、实践篇:提升职场影响力行动指南
|
||||
|
||||
基于前一章的影响力冰山模型,以下是提升职场影响力的7个行动指引。
|
||||
|
||||
## 1、塑造个人品牌
|
||||
|
||||
|
||||
|
||||
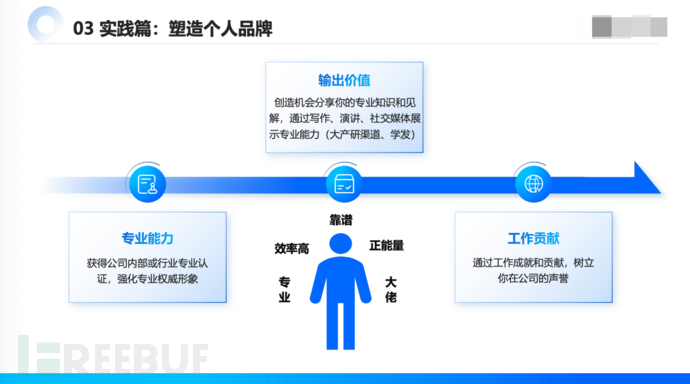
1. 核心原则,坚持站在组织/公司利益的立场做正确的事。
|
||||
|
||||
2. 专业能力,获得公司内部与行业专业认证,强化专业权威形象。
|
||||
|
||||
3. 输出价值,创造机会分享你的专业知识和见解,通过写作、演讲、社交媒体等展示你的专业能力。
|
||||
|
||||
4. 工作贡献,参与跨团队项目,通过工作成就和贡献,持续保持高绩效结果,树立你在团队和公司的声誉。
|
||||
|
||||
|
||||
## 2、社交与人际关系
|
||||
|
||||
|
||||
|
||||
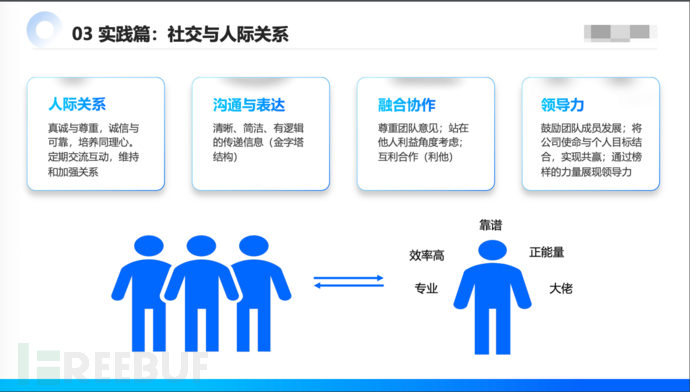
1. 人际关系:待人真诚与尊重,诚信与可靠,有同理心。定期与合作方交流互动,维持良好的关系。
|
||||
|
||||
2. 沟通与表达:清晰、简洁、有逻辑地传递信息,能够抓住要点。能够将复杂的概念通过通俗易懂的类比传达给不同专业领域的人。具备向不同层级的合作方阐述工作价值。
|
||||
|
||||
3. 融合协作:尊重团队成员的意见,对事不对人,保持理性与客观。站在合作伙伴利益的角度思考,互利互惠(利他)。
|
||||
|
||||
4. 领导力:鼓励团队成员发展,将公司的使命,团队的目标与个人目标结合,实现共赢。以身作则,通过榜样的力量展现领导力。
|
||||
|
||||
5. 大局观:在面对分歧时,优先解决业务面临的紧迫问题。站在公司的立场,跳出个人的责任边界或局部利益,选择最高效的解决方案。在这个过程中理解并服从大局,必要情况下为大局让步。
|
||||
|
||||
|
||||
## 3、持续学习
|
||||
|
||||
|
||||
|
||||
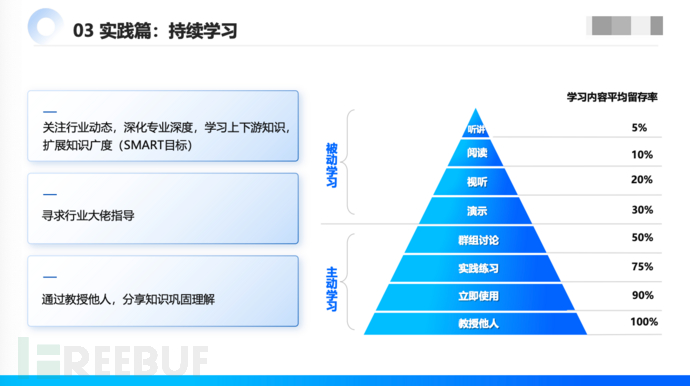
1. 关注行业动态,深化专业深度,学习上下游知识,扩展知识广度。让新知识链接旧知识,激发思考与见解。用SMART来量化与管理学习目标。
|
||||
|
||||
2. 寻求行业专家的指导
|
||||
|
||||
3. 通过教授他人,分享知识巩固理解
|
||||
|
||||
|
||||
## 4、批判性思维
|
||||
|
||||
|
||||
|
||||
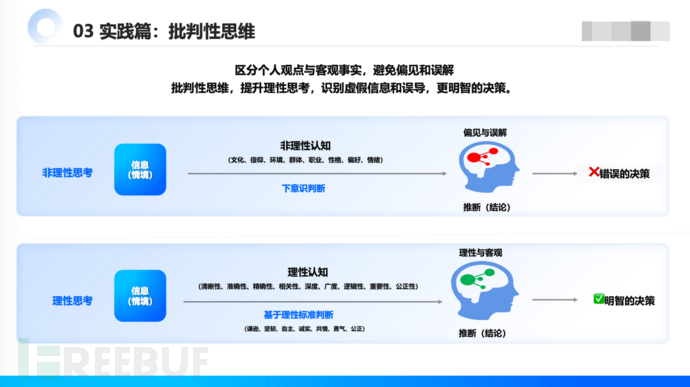
> 区分个人观点与客观事实,避免偏见与误解,通过批判性思维提升理性思考,识别虚假信息与误导,帮助我们做出更客观与明智的决策。
|
||||
|
||||
### 1、非理性思维
|
||||
|
||||
非理性的因素存在于文化、信仰、环境、群体、职业、性格、偏好、个人情感等因素中,这些因素导致我们产生非理性的认知而不能自知,在日常工作生活的思维活动中,会下意识的带有偏见或误解做出非理性的判断或结论,从而导致错误的决策。
|
||||
|
||||
一些案例:
|
||||
|
||||
1. 比如价值观冲突、文化习俗或信仰或阻碍人们对事物的客观评价,这些评价即使缺少科学证据。
|
||||
|
||||
2. 比如基于刻板的印象做出决策,比如基于某个群体的片面了解就对其所有成员进行判断。
|
||||
|
||||
3. 比如在愤怒的情绪下可能做出冲动的决定,而不是基于事实和理性思考。
|
||||
|
||||
4. 比如选择候选人时倾向于选择相同母校或背景,而不是基于能力和经验。
|
||||
|
||||
|
||||
### 2、理性思维
|
||||
|
||||
想象一下:当我们接收到一个重要的信息或者身处一个复杂的情境中,客观的信息、主观的信息、非理性的偏见、情绪化的信息。我们的大脑在推断结论的时候,先经过理性标准规则判断(清晰性、准确性、精确性、相关性、深度、广度、逻辑性、重要性、公正性)过滤掉那些非理性的信息,从而得出客观的结论,做出明智的选择。
|
||||
|
||||
通过批判性思维,在大脑中建立理性思维框架和非理性防火墙,通过持续训练提高自身的理性认知,培养独立思考、谦逊、坚韧、成熟、共情、勇气、公正等理性品质。
|
||||
|
||||
当你开始应用批判性思维工具,可以克服自身思考过程中的非理性因素,从而做出更加客观和合理的决策。最明显的效果是可以过滤掉工作生活中大量的垃圾信息(情绪化的、主观的、偏见的),减少这些信息对自己造成负面影响(减少焦虑、内耗)
|
||||
|
||||
阅读推荐:
|
||||
|
||||
1. 思辨与立场-生活中无处不在的批判性思维工具
|
||||
|
||||
2. 批判性思维入门
|
||||
|
||||
3. 批判性思维(第12版)
|
||||
|
||||
|
||||
## 5、突破思想钢印
|
||||
|
||||
|
||||
|
||||
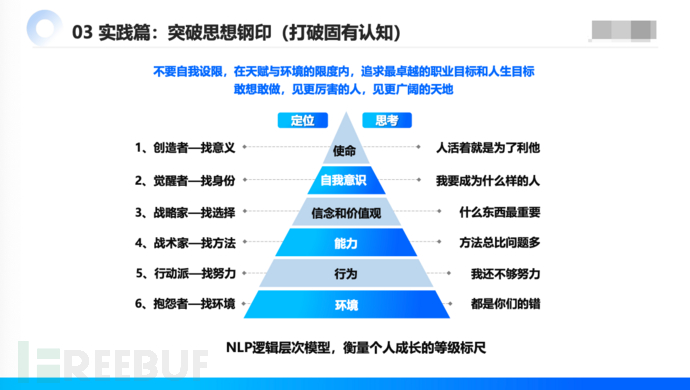
> 不要自我设限,要勇于突破思想钢印,打破固有认知,在天赋与环境的限度内,追求最卓越人生目标和职业目标。(敢想、敢做)
|
||||
|
||||
不要把人生当成预先编写好的程序,把人生的境遇归咎于宇宙中某种力量所造就的宿命,如果你相信自己的生活和遭遇是完全由不可控的力量预先安排好的,那你就失去了掌握自己人生的机会。人生并非是一成不变,而是由无数选择和行动塑造的。相信自己信念和决心的力量,不要被所谓的命运所束缚,通过不断的自我提升与不懈的努力,每个人都可以改变自己的生活和未来。记住!不要相信所谓的命运,要勇敢地与命运做斗争。
|
||||
|
||||
没有人能阻止我们成为优秀的人,勇敢的向榜样们学习,然后成为他们,超越他们。
|
||||
|
||||
## 6、保持身心健康
|
||||
|
||||
|
||||
|
||||
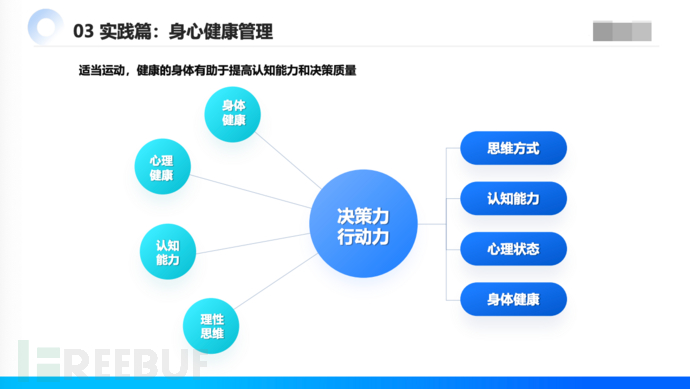
> 定期运动有助于身心健康。个人推荐跑步,是当下最经济且收益最快的运动。身体健康、心理健康、认知能力、思维方式以及行动力和决策力有着密切的关系。
|
||||
|
||||
1. 身体健康:身体健康是心理健康的基石。良好的身体健康有助于维持积极的心理状态,而长期的疾病或疼痛可能会影响心理健康,导致情绪低落和心理压力。身体健康也有助于高效管理精力,保持充沛的精力应对日常工作挑战。
|
||||
|
||||
2. 心理健康:心理状态直接影响我们的行动力,积极的心理状态可以激发我们的行动力。
|
||||
|
||||
3. 认知能力:认知能力包括记忆、注意力和思考能力,是进行有效决策的基础。
|
||||
|
||||
4. 思维方式:思维方式是我们看待和理解世界的方法,积极的思维方式可以促进心理健康,减少焦虑、压力与内耗。
|
||||
|
||||
|
||||
总的来说,健康的身体可以支持良好的心理状态,积极的思维方式可以提升认知能力和决策力,而心理健康则有助于维持行动力和坚持目标。因此,维护身体健康、培养积极的思维方式、提高认知能力、保持良好的心理状态,以及增强决策力和行动力,都是实现个人全面发展提升个人影响力的重要组成部分。
|
||||
|
||||
## 7、相信客观规律
|
||||
|
||||
|
||||
|
||||
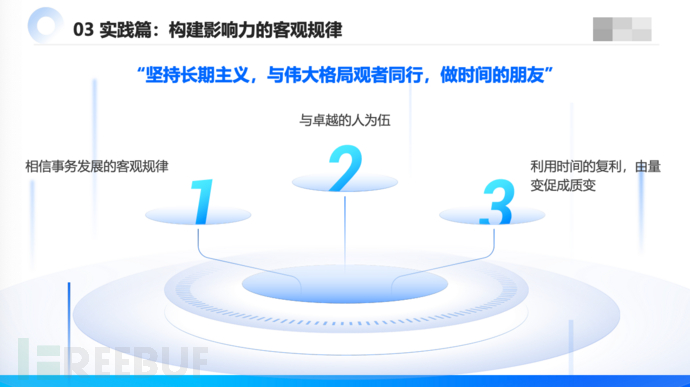
持之以恒地贯彻以上六条方法,与卓越的人为伍,相信量变到质变的客观规律,利用时间的复利,积累量变促成质变。用张磊在《价值》中的一句话总结:
|
||||
|
||||
> “坚持长期主义,与伟大格局观者同行,做时间的朋友”
|
||||
|
||||
以上是我过去三年的浅显的沉淀和实践总结,其中大部分都是从工作实践中学习和内化,这其中包含了很多优秀的同学提供的思考与见解。再次提醒大家,运用批判性思维来判断这些经验和见解是否适合你们自己的实际情况。
|
||||
|
||||
因为淋过雨,所以想为你撑把伞,如果对你有帮助,请留言回复 ”有收获“,你的鼓励是我持续分享的动力。
|
||||
@@ -0,0 +1,13 @@
|
||||
**熔融沉积成型(FDM)**
|
||||
- **模式特点**:通过将丝状的热塑性材料加热至熔融状态,然后通过喷头挤出,按照预设的路径层层堆积,最终形成三维物体。这种模式的设备相对简单,成本较低,适合初学者和家庭用户。
|
||||
- **PLA(聚乳酸)**:一种生物可降解材料,通常由玉米等可再生植物资源制成。它具有良好的打印性能,容易挤出,打印温度相对较低,一般在 180 - 220℃之间,且在打印过程中不易产生异味。PLA 材料价格较为便宜,有多种颜色可供选择,适合用于制作各种模型、装饰品、教学用具等。
|
||||
- **ABS(丙烯腈 - 丁二烯 - 苯乙烯共聚物)**:具有较高的强度、硬度和耐热性,可用于制作一些需要一定机械性能的零件,如玩具、汽车零部件等。但 ABS 打印时需要加热底板来防止翘边,打印温度一般在 210 - 240℃左右,并且在打印过程中会产生一定的气味,需要注意通风。
|
||||
- **PETG(聚对苯二甲酸乙二醇酯)**:综合了 PLA 和 ABS 的一些优点,具有良好的韧性、透明度和化学稳定性,适用于打印食品容器、医疗器械等对材料性能要求较高的物品。PETG 的打印温度通常在 220 - 250℃之间,打印时需要控制好冷却速度,以避免产生变形。
|
||||
- **TPU**:TPU 是一种高性能弹性材料,可反复弯曲拉伸,回弹性能好,适合制作需要柔软或减震的部件。抗磨损性能优异,适合工业零件或运动器材。在低温环境下仍能保持柔韧(-40℃不脆化)。
|
||||
|
||||
- **光固化成型(SLA/DLP)**
|
||||
- **模式特点**:利用紫外线照射液态光敏树脂,使其在特定区域迅速固化,通过层层扫描固化,将液态树脂转化为固态的三维物体。这种模式能够实现较高的精度和表面质量,适合制作精细的模型、珠宝首饰、牙科模型等。
|
||||
- **常用材质**3:
|
||||
- **刚性树脂**:具有较高的硬度和强度,固化后产品表面精细平滑,适合制造坚固的功能部件,如机械零件、模具等。但刚性树脂的韧性相对较差,在受到较大外力时容易断裂。
|
||||
- **柔性树脂**:具有一定的弹性和柔韧性,可用于制作一些需要弯曲、变形的物品,如手机壳、密封圈等。柔性树脂的固化收缩率较小,能够较好地保持模型的形状和尺寸精度。
|
||||
- **水洗树脂**:是一种特殊的光敏树脂,可用水清洗,无需使用酒精等有机溶剂进行后处理,更加环保和方便。水洗树脂具有低粘度、高精度、固化时间短等特点,适用于动画手工制作、手工艺品装饰等领域。
|
||||
@@ -0,0 +1,325 @@
|
||||
本文的主要读者是那些需要扮演 Code reviewer 的人,即需要 review 别人代码的人,以提供建议、指导和要求来如何开展 Code review 的工作。
|
||||
|
||||
最后一节是写给 code reporter,比如 PR/MR 的 owner。
|
||||
|
||||
下文中以 MR 指代提请 merge 的 code patch 请求。
|
||||
|
||||
---
|
||||
|
||||
## 1 Principle
|
||||
|
||||
- 目标:Code review 的主要目的是确保逐步改善代码库的整体质量和健康度。
|
||||
- 负责制:Reviewer 应该对被 review 的 MR 负责。这不一定要规范到流程中,但 reviewer 自身应当有这个意识。
|
||||
- 时效性:Reviewer 应该有责任保障 MR 在 review ready 后,到 MR merge 要足够快速,从而避免延期。
|
||||
- 避免过分严格:Reviewer 应当倾向于批准 MR 通过,只要 MR 能够在某些方面改进代码库的质量,并且代码是有意义的。而不是一味追求代码完美。
|
||||
- 评论:MR 合入前,应当确保已解决所有 review 阶段提出的 comments。Comment 可以拒绝(备注原因并达成一致),但不可以忽略。
|
||||
- 指导性:Code review 对于交流代码实践、设计原则和加深项目理解有益。Comments 可以是指导性的(不要求修改),但请注明 Nit。
|
||||
- 避免个人偏好:基于技术事实讨论,而不是基于主观感受。
|
||||
- 尊重非标准风格:如果 MR 中存在 Coding Style 中没有约束的设计,可以参考代码库现有的类似风格。但不应当强加 reviewer 的主观建议。
|
||||
- 避免冲突:developer 和 reviewer 有冲突时,建议另行讨论,但需要将达成一致的结果记录在 MR 中。可能要有项目 owner 的参与,但要避免 MR 延期。
|
||||
- 用户:Code review 过程中提到的用户,既包括软件的最终用户,也包括其他在相同代码库中进行开发工作的 developer。
|
||||
- 积极的反馈:Reviewer 应当积极响应 review 请求,并给予正向的反馈,以互相激励良好的 Code review 流程。
|
||||
|
||||
## 2 Review Point
|
||||
|
||||
### 2.1 设计
|
||||
|
||||
- 代码是否经过精心设计并适合软件系统?
|
||||
- 集成方式是否正确?
|
||||
- 现在合入这个功能是否是正确的时间?
|
||||
|
||||
### 2.2 功能
|
||||
|
||||
- 代码的行为是否和意图一致?
|
||||
- 实现是否可以匹配需求?
|
||||
- 接口变更(如库函数、外部类)通知到相关人员了吗?变更是否合理?
|
||||
- 是否会引入随机问题?如并行导致的竞争,随机数测试等
|
||||
- 对于无法理解的代码,可以要求 developer 澄清。对于 reviewer 来说,不能快速理解代码是正常的。澄清也会帮助所有 reviewer
|
||||
|
||||
### 2.3 复杂度
|
||||
|
||||
- 代码可以调整成更简单的实现吗?
|
||||
- 其他开发人员能否轻松理解并使用这块代码?
|
||||
- MR 是否可以拆分?不相关的功能避免在一个 MR 中
|
||||
- 绝大多数情况,1 个 MR 只包括 1 个 commit
|
||||
|
||||
### 2.4 测试
|
||||
|
||||
- 代码是否带有正确、合理且有用的测试用例?
|
||||
- 紧急情况可以省略测试用例,但之后应当提交专门的测试 MR 补充
|
||||
- 代码仓已有的测试用例需要维护,修改测试用例应当有确切的原因
|
||||
|
||||
### 2.5 命名
|
||||
|
||||
- 代码中的变量、类、方法是否有符合项目风格的命名规范?
|
||||
- 名称是否清晰有意义?
|
||||
- 名称是否难以阅读,或和其他名词有歧义?
|
||||
|
||||
### 2.6 注释
|
||||
|
||||
- 是否没有必要注释,或是否滥用注释?
|
||||
- 注释是否冗余?是否有错误?(注释需要维护)
|
||||
- 注释不应该用于解释代码的逻辑(代码应该可以自解释)。有些例外,比如正则表达式和复杂算法
|
||||
- 代码的背景、决策思路应当用注释说明
|
||||
- 标记注释很有用,比如 TODO,BUG,FIXME,ISSUE,HACK,WARN,NOTE
|
||||
- 对外的接口函数和接口类,库的头文件,应当有必要的注释说明用法和行为
|
||||
|
||||
### 2.7 风格
|
||||
|
||||
- 代码是否满足项目规定的代码风格?
|
||||
- 功能性 MR 不要混合对不相关代码的风格变更。风格变更应另提 MR
|
||||
|
||||
### 2.8 文档
|
||||
|
||||
- 代码实现是否需要补充新的设计文档和测试文档?
|
||||
- 是否需要修改现有文档?包括删除已经过时的错误文档
|
||||
|
||||
### 2.9 上下文
|
||||
|
||||
- 不要只关注修改的代码,也要关注修改代码的上下文,以提出改善性建议。
|
||||
- 不要容忍微小的破坏系统健康度的 MR,任何系统都是由小的坏的变更而逐渐变差。
|
||||
|
||||
### 2.10 好的设计
|
||||
|
||||
- 除了查找 MR 中的问题以外,也要留意其中好的设计
|
||||
- 提交 comments 反馈给 developer,鼓励良好的实践,也促进互相学习
|
||||
|
||||
## 3 Review Step
|
||||
|
||||
刚开始尝试 review 的 new reviewer,可以参考这个 review step。
|
||||
|
||||
### 3.1 全面了解
|
||||
|
||||
查看 MR commit message,了解 MR 大致要做什么。
|
||||
|
||||
- 指出不必要的 MR 变更(给予对 developer 充分的尊重)
|
||||
- 指出 commit title 和 message 中的错误和建议
|
||||
- 查看关联 JIRA,了解问题背景
|
||||
- 阅读测试用例,了解 MR 影响了什么。以及检查测试相关的问题
|
||||
|
||||
### 3.2 主要检查
|
||||
|
||||
查看代码文件的主要内容。
|
||||
|
||||
- 如果不能快速定位代码的关键部分,请 comment 要求 developer 澄清
|
||||
- 判断 MR 中是否有和当前 MR 无关的内容。比如风格修改,多余功能实现
|
||||
- review 关键代码的设计
|
||||
- 发现问题时请立即 comment,避免 developer 基于问题已经在做更多工作
|
||||
|
||||
### 3.3 次要检查
|
||||
|
||||
在主要内容没有意见之后,检查其他代码。
|
||||
|
||||
- 按照文件顺序重新浏览所有变更。
|
||||
- 检查注释,命名规范等细节。
|
||||
- 检查代码风格是否符合规定。
|
||||
- 检查是否需要提供或变更文档。
|
||||
|
||||
## 4 Efficiency
|
||||
|
||||
Reviewer 应该尽快响应 MR 的 Code review 工作。
|
||||
|
||||
通常我们也希望 review 的过程足够快,也就是尽快 merge 代码,但这建立在很多因素的基础上。
|
||||
|
||||
### 4.1 review 低效的问题
|
||||
|
||||
- 降低团队效率。很多工作是基于当前 MR 展开的,MR 的 merge 过慢会阻塞其他开发工作
|
||||
- 抱怨流程。review 流程会被抱怨,甚至对 reviewer 个人的抱怨,这会让团队成员的开发积极性受到挫败
|
||||
- 代码健康度。developer 提交的其他 MR 可能会因此变得庞大、冗余,从而影响代码仓的质量
|
||||
|
||||
### 4.2 review 应该有多快
|
||||
|
||||
- Reviewer 的响应时间应该在 1 天内
|
||||
- Reviewer 应该立即响应 developer 主动要求的 Code review,这是 Reviewer 的职责
|
||||
- Reviewer 应该在每天都找一个时间,对仓库中所有 MR 进行 review
|
||||
- 通常一个 MR 会经过多次 review,developer 也希望当天能得到多次 review
|
||||
- 对于跨时区的 reviewer 和 developer,reviewer 应该在 developer 第二天上班前完成审查,并可以利用带评论的 LGTM
|
||||
|
||||
### 4.3 权衡
|
||||
|
||||
Review 请求会打断 Reviewer 自己的工作流,所以需要权衡。但通常还是需要积极响应主动请求。
|
||||
|
||||
- 选择在 Reviewer 自己的工作中断点 review 代码。比如构建代码时、午餐晚餐前后
|
||||
- 如果没有时间,也应该对 developer 给予快速反馈,并建议其他 reviewer
|
||||
- 可以提供一些初步 comments,并提出 need change
|
||||
- 但不要为了快速 review,而妥协了代码质量和标准。记住,reviewer 要对自己的每一笔 review 负责
|
||||
|
||||
### 4.4 大型 MR
|
||||
|
||||
如果 MR 的代码量比较多。预估 review 的时间会超过 20 分钟。
|
||||
|
||||
- 尝试和 developer 沟通,是否可以精简 MR
|
||||
- 如果无法精简 MR,尝试请 developer 提交 Code review 会议,集体做 review。developer 需要现场阐述 MR 的设计和细节
|
||||
|
||||
### 4.5 紧急 MR
|
||||
|
||||
紧急 MR 比如:
|
||||
|
||||
- 确定性的 commit revert
|
||||
- 修复影响最终用户生产的错误
|
||||
- 有 ETA 要求的功能,在即将到达 ETA 前
|
||||
- 法律问题相关
|
||||
- 明确的系统安全漏洞
|
||||
|
||||
看似紧急但不紧急的 MR 比如:
|
||||
|
||||
- 想赶在周末前合入,下周能开展新工作
|
||||
- 跨时区的 review
|
||||
- commit revert 之后,导致的新问题
|
||||
|
||||
紧急 MR 应该这么做:
|
||||
|
||||
- 优先关注 review 过程的速度
|
||||
- 先确保正确性,其他 review 发现的问题,如格式、测试用例等,可以要求 developer 之后补充 MR 修改
|
||||
- 紧急 MR 合入后,应当再次对该 MR 做细致的 review,并要求 developer 补充
|
||||
- 让所有项目组成员了解紧急 MR 的合入事件,并明确可能带来的风险
|
||||
|
||||
尽量避免发生紧急 MR,这也有 PM 的责任,处理紧急 MR 应该极力避免项目积累技术债务。
|
||||
|
||||
## 5 Comments
|
||||
|
||||
提交 Code review comments 也需要 reviewer 注意。
|
||||
|
||||
### 5.1 保持友善
|
||||
|
||||
不必说,在工作沟通中,都应该尽可能注意自己的措辞会给对方带来的压力和抵触,尤其是在挑别人毛病的时候。
|
||||
|
||||
### 5.2 技术性解释
|
||||
|
||||
提供更多的技术性解释,来说明你的疑问或顾虑,比单纯的抛出问题更有利于 developer 处理。
|
||||
|
||||
### 5.3 指导性 comment
|
||||
|
||||
reviewer 虽然并没有义务帮助 developer 提供新的解决方案,但这并不意味着 reviewer 对提高 MR 的代码质量没有作用。
|
||||
|
||||
reviewer 可以适度的提供自己的建议方案,这通常有利于互相学习和加深对软件系统的理解。
|
||||
|
||||
毕竟,code review 的第一目标是保障代码质量,第二目标是提高软件开发人员的技能。
|
||||
|
||||
### 5.4 解释性请求
|
||||
|
||||
对于不能快速理解的 MR,可以请求 developer 阐述 MR 中的主要内容和关键代码。
|
||||
|
||||
同时,对于 developer 提出的问题,reviewer 也应该给予充分的解释。
|
||||
|
||||
通常来说,请求解释无可厚非,这并不代表着 reviewer 个人水平如何。只有 developer 自己对自己编写的代码最熟悉。更充分的解释也有助于其他 reviewer 的 review 工作。
|
||||
|
||||
### 5.5 同步线下的讨论
|
||||
|
||||
很多时候,在 review 过程中,可能 reviewer 和 developer 会线下(或者线上 1 by 1 会议)讨论 MR 的细节。这是没问题的。
|
||||
|
||||
但需要在讨论结束后,将讨论的主要结论同步在 MR 中,以方便其他 reviewer 阅读和了解 review 的过程。
|
||||
|
||||
当然,也有助于将来回溯 MR 合入过程中的细节。
|
||||
|
||||
### 5.6 Nit
|
||||
|
||||
Nit 是指 review 过程中,发现的一些小的,无关紧要的问题,reviewer 并不要求必须在当前 MR 做修改。
|
||||
|
||||
Nit 是重要的,鼓励 reviewer 和 developer 在 code reviewer 时多使用。
|
||||
|
||||
可能使用 Nit 的地方:
|
||||
|
||||
- 注释和变量中的小错误,比如语法错误和拼写错误。
|
||||
- 不易理解的一些符号。
|
||||
- 可以将代码提炼和改善的地方。
|
||||
- 冗余的注释说明。
|
||||
- reviewer 认可当前方案,但想分享他建议的更好方案。
|
||||
|
||||
## 6 冲突
|
||||
|
||||
Code review 的过程中,很容易对一些技术细节产生不同的观点。应当避免持续冲突影响了 MR 的合入效率。
|
||||
|
||||
- 讨论时,要始终注意自己的措辞是否会伤害到对方
|
||||
- developer 通常对代码的细节,包括项目的细节,比 reviewer 了解更多和详细
|
||||
- 讨论不应该过于频繁。应该留出独立思考的时间
|
||||
- 如果代码存在严重问题,则 reviewer 不能妥协让步
|
||||
- 无论什么时候,都应该对事不对人
|
||||
- 避免妥协 “之后再处理” 的措辞。时间过的越久,“之后再处理” 就越不可能发生。(紧急 MR 例外)
|
||||
- 如果 developer 一定坚持 “之后再处理”,那么要有 JIRA 跟踪,以避免后续遗忘。同时,代码中应当留下充分的解释,如 TODO 注释
|
||||
|
||||
## 7 MR 建议
|
||||
|
||||
本节内容是写给任何需要扮演 developer 角色的人员,提供一个开发代码和提交 MR 的实践指导。
|
||||
|
||||
### 7.1 重视 MR message
|
||||
|
||||
MR message 并不只是一个标题。不要省略详情内容,这是很不负责任的。
|
||||
|
||||
MR message 应当和 git commit message 保持一致,有利于回溯问题。
|
||||
|
||||
MR message 中应该包括典型的关键字,按照不同仓库的要求,这些关键字可能写在标题行,也可能写在详情文本中。这些关键字通常会作为将来检索相关内容的依据。
|
||||
|
||||
避免拼写错误和语法错误。
|
||||
|
||||
以下是一些具体说明:
|
||||
|
||||
标题行:
|
||||
|
||||
- 简洁地描述 MR 做了什么
|
||||
- 注意格式要求,比如不要超出格式要求的宽度、首字母大写且行尾不加标点
|
||||
- 标题行要添加必要的关键字(遵从仓库规则)。如 llvm 中会使用 [ARM],[MIPS] 来标注 MR 的类型
|
||||
- 尽量避免笼统地总结 MR。比如一个反例:”Fix a bug of mma“。应该让其他人通过标题了解到 MR 独特的地方
|
||||
|
||||
详情文本:
|
||||
|
||||
- 应该包括对问题的详细描述、为什么要做这个事情、为什么用这种方法
|
||||
- 还要包括需求背景和 JIRA 链接
|
||||
- 如果需要,还可以包括目前方法的缺陷分析、未来计划、基准测试状态以及设计文档位置
|
||||
|
||||
### 7.2 尽可能小的 MR
|
||||
|
||||
一个 MR 应该只解决一个事情。小的 MR 会有很多优点:
|
||||
|
||||
- Code review 更快。这体现在 reviewer 可以更快的理解代码和排查可能存在的问题。当然也更容易得到 approve
|
||||
- 大的 MR 会审查不彻底(人的惰性使然),对 reviewer 的要求也更高。小 MR 更容易发现问题
|
||||
- 被 Disapproved 之后,调整更方便
|
||||
- 合入更方便,不容易和其他 MR 产生冲突
|
||||
- 如果意外需要 revert,也会更方便,带来的影响会更小
|
||||
- 编写小型 MR 也有助于 developer 梳理软件逻辑
|
||||
|
||||
多大代码量的 MR 算小型 MR 通常由代码仓的特征和所有 developer 和 reviewer 的大致判断决定,但通常几千行的 MR 就不能算小型 MR。(人脑的缓存通常也只能记忆这么多代码来完成 review)
|
||||
|
||||
### 7.3 可以接受的大 MR
|
||||
|
||||
有些情况下,大型 MR 也能接受,如:
|
||||
|
||||
- 增加或删除一个文件的完整代码
|
||||
- 对某个相同特征的问题,在很多位置做修改
|
||||
- 仓库初始配置
|
||||
|
||||
一个大型 MR 通常需要更多的时间和精力来 review,也会需要额外开展 Code review meeting 进行集体 review。
|
||||
|
||||
所有 reviewer 和与 MR 相关的 developer 都应当明确 MR merge 可能带来的风险和对项目的影响。
|
||||
|
||||
### 7.4 测试用例
|
||||
|
||||
大多数功能性的 MR 的合入都应该配有测试用例。避免后续补充测试用例的做法。
|
||||
|
||||
可以有单独的测试用例作为独立 MR 合入,但这些用例应该是对之前已存在代码的一个测试补充或对测试代码的整体重构。
|
||||
|
||||
以下情况可以接受没有测试用例:
|
||||
|
||||
- 紧急 MR 可以不添加测试用例,但紧急情况处理完毕后,应该额外提交测试用例 MR
|
||||
- 格式调整、文档修改等 MR
|
||||
- 可解释的其他不添加测试用例的情况,经 reviewer 接受
|
||||
|
||||
### 7.5 不能破坏构建
|
||||
|
||||
任何一个 MR 都应该是自完备的。它不能破坏代码仓的构建。
|
||||
|
||||
如果有几个相互依赖的 MR,也应该确保找到一种方法,让每个 MR 都能通过构建。功能可以不完备,但构建不能 fail。
|
||||
|
||||
另外,CI 的测试应该要保障不出现这种问题。
|
||||
|
||||
### 7.6 回复 Comments
|
||||
|
||||
永远记得 Code review 的目的是提高整个代码库的质量。当看到 comment 时,先控制自己反对的冲动(这种冲动其实是人之常情),想想为什么有这个 comment。
|
||||
|
||||
保持礼貌和感激。reviewer 也会做到这一点。
|
||||
|
||||
尝试澄清代码,以对 reviewer 有疑问的地方展开解释。并且也应该主动思考自己的代码为什么没有被其他人所轻易理解,并尝试改进。
|
||||
|
||||
Developer 也可以要求 reviewer 澄清他们的 comment。
|
||||
|
||||
可能会需要解决冲突,请参见上文 **冲突** 小节。
|
||||
@@ -0,0 +1,6 @@
|
||||
无人机驾驶员
|
||||
碳排放管理师
|
||||
元宇宙建造师
|
||||
AI 训练师
|
||||
新能源车维修师
|
||||
老年行业 - 向日本等老龄化社会学习
|
||||
@@ -0,0 +1,8 @@
|
||||
1. 确认安装环境
|
||||
- 基于 Docker
|
||||
- 网络带宽通过 iperf 检测
|
||||
|
||||
iperf3 -s
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,22 @@
|
||||
#### 3.1 工作原理简述
|
||||
|
||||
1. **触发器(Events)**:像 `push`、`pull_request`、`tag_push` 等事件会触发对应的工作流。
|
||||
2. **工作流(Workflow)文件**:默认存储在仓库的 `.gitea/workflows/` 目录下(或自定义)。类似 GitHub Actions,一般命名为 `main.yml` 或 `*.yml`。
|
||||
3. **Runner**:一旦事件触发,Gitea 会调用 Runner 进行执行。Runner 就是一个容器/服务器,里边通过 `act` 工具解析并执行 `.gitea/workflows/*.yml` 中的 steps。
|
||||
4. **steps / jobs**:在定义的 workflow 中,可以分多个 job,每个 job 再包含多个 step,依次执行 shell 命令或调用各种 actions(如 `actions/checkout@v4` 等)。
|
||||
|
||||
#### 3.2 存放[工作流](https://so.csdn.net/so/search?q=%E5%B7%A5%E4%BD%9C%E6%B5%81&spm=1001.2101.3001.7020)文件的位置
|
||||
|
||||
- **默认位置**:在 Gitea 仓库的根目录下新建 `.gitea/workflows/` 文件夹,然后在里面放置你的工作流文件,如 `main.yml`、`build.yml` 等。
|
||||
- **可自定义**:如果你在仓库的 `Settings` 里修改了默认的 workflow 路径,你就需要把 `.yml` 文件放在你指定的目录里。
|
||||
|
||||
例如,我们可以在仓库中新建:
|
||||
|
||||
```
|
||||
.gitea
|
||||
└─ workflows
|
||||
└─ main.yml
|
||||
```
|
||||
|
||||
然后把下面这段示例写到 `main.yml` 里即可。
|
||||
![[cc515c8d4a015321486e8e18ca98ebb9_2ac444af0f4840cda3a64e98950ac8b4.png]]
|
||||
@@ -0,0 +1,330 @@
|
||||
|
||||
|
||||
> **作者:**罗棋琛(Max Luo)
|
||||
>
|
||||
> **个人简介:**
|
||||
>
|
||||
> 1、资深网络安全专家,10 年从业经验,5 年乙方攻防、5 年甲方安全防御建设经验,在 SDL、DevSecOps、移动安全、API 安全、软件供应链安全、AI驱动应用安全、云安全、数据安全、红队攻防演练、欧盟GDPR技术落地等领域有丰富的实践经验。
|
||||
>
|
||||
> 2、现任 SHEIN 全球应用安全主管,曾任 SHEIN 中国应用安全主管和 全球安全BP 主管。在跨境电商和互联网科技企业有丰富的应用安全与隐私合规技术落地经验,擅长与利益相关者构建安全纵深防御体系,在管理风险的同时,有效平衡安全、业务、用户体验、成本和效率,应对全球应用安全和隐私合规挑战。
|
||||
>
|
||||
> **专业认证:**
|
||||
>
|
||||
> 1、OffSec Certified Professional (OSCP)
|
||||
>
|
||||
> 2、OffSec Experienced Penetration Tester (OSEP)
|
||||
>
|
||||
> 3、OffSec Web Expert (OSWE)
|
||||
>
|
||||
> 4、Offensive Cloud Security Specialist Certifications(AWS/Azure/GCP)
|
||||
|
||||
---
|
||||
|
||||
# 前言
|
||||
|
||||
在 IT 行业,35 岁宛如一道无形却又极具挑战性的坎,众多从业者行至此时,往往深陷职业发展的瓶颈与危机之中。一方面,技术更新换代的速度如脱缰之马,日新月异,特别是 AI 的蓬勃发展,正以前所未有的深度和广度重塑着整个行业格局,带来了巨大的技术竞争压力。与此同时,人才竞争压力也与日俱增,2024 年中国高校毕业生人数预计高达 1179 万人,再创历史峰值,使得包括 IT 行业在内的各个领域人才济济,竞争愈发激烈。此外,家庭与工作平衡的难题也如影随形,诸多问题交织在一起,让 35 岁以上的 IT 从业者举步维艰。
|
||||
|
||||
在技术层面,IT 行业的技术迭代之快令人咋舌,AI 技术的持续演进正深刻改变着行业的每一个角落。随着其发展,未来 AI 将全方位、深层次地融入各个领域。比如在软件开发领域,智能编程助手会朝着更智能的方向发展,不仅能轻松完成基础代码生成,还将在更复杂的架构设计中发挥重要作用;在数据分析领域,AI 算法也将具备自动挖掘深层次信息的能力,无需人工频繁干预。这一系列变化对于 IT 从业者而言,意味着以往积累的技术知识可能迅速过时。新编程语言和开发工具的不断涌现只是冰山一角,更为关键的是,整个 IT 工作流程和需求都在围绕 AI 重新构建。若无法适应这种基于 AI 的技术变革潮流,在职场竞争中必然会处于劣势。
|
||||
|
||||
从人才竞争角度来看,2024 年庞大的高校毕业生大军涌入就业市场,为各行业带来了丰富的人才资源,同时也让竞争压力急剧攀升。IT / 通信 / 电子 / 互联网行业是毕业生们心仪的热门领域,吸引了大量求职者。毕业生数量如此之多,求职竞争自然异常激烈。这使得企业在招聘时有了更多选择,相应地提高了招聘门槛。如此一来,35 岁以上的 IT 从业者在与年轻毕业生竞争时,原本的职场优势受到极大冲击,职业发展的稳定性也面临严峻挑战。
|
||||
|
||||
在此背景下,我希望能为处于 35 岁危机中的 IT 从业者提供一份自救指南。这些内容源于我在 SHEIN 的工作实践与经验总结。此前,我为产品研发中心的新晋管理者进行了一次沙龙分享,主题是 “职场中如何提升个人影响力”。很荣幸能将自己在 SHEIN 过去四年多学习和实践所积累的经验分享给产研中心的新晋管理者。如今,我把这些经验和见解整理成此文,希望能给 IT 同行们一些有益的借鉴。同时,我也鼓励大家运用批判性思维,根据自身实际情况来判断这些经验是否适用。
|
||||
|
||||
在 SHEIN 的这四年里,我在工作过程中得到了上下游合作伙伴的诸多帮助,他们优秀的思维与见解让我受益匪浅,使我在逻辑思维、跨文化沟通、团队管理和情绪管理等方面都有了显著的提升。这里要特别感谢我的老板 Leon Li ,感谢他给予的支持和宝贵机会,让我能够加入全球网络安全与风险管理中心(GSRM) ,参与到 SHEIN 的多元兼容发展进程中,与一群卓越的跨文化同事共同学习和成长。希望我的分享能为 IT 同行在应对 35 岁危机时提供一些助力。
|
||||
|
||||
## 文章结构
|
||||
|
||||

|
||||
|
||||

|
||||
|
||||
整篇文章分为理论篇、方法篇与实践篇,按照中国传统的道家哲学模型“道、法、术”三层结构展开。理论篇对应“道”,阐述的是底层逻辑和客观规律,方法篇对应“法”,由底层逻辑推导出的方法论或框架,实践篇对应“术”,由方法论指导并实践的方案指南。
|
||||
|
||||
# 一、理论篇:影响力的底层逻辑
|
||||
|
||||

|
||||
|
||||
回顾成长历程中那些对我们产生积极影响力的良师益友,他们激发了我们的思考,打开了我们的眼界,提升了我们的思维和认知。并以身作则鼓励我们追求理想的生活和卓越的目标。在信念认知与行动上影响了我们,让我们在结果上收获了机遇、收入和成长。
|
||||
|
||||
提升个人影响力的过程也是提升个人综合能力的过程,当我们提升了个人能力之后同时具备给周围的人产生正向价值了,那我们的影响力也就随之而来。
|
||||
|
||||
影响力的核心定义是“影响他人信念和行动的能力”。罗伯特·B·西奥迪尼(Robert B. Cialdini)在其著作《影响力》中,将影响力分为权力性影响力(Legitimate Influence)和非权力性影响力(Non-Legitimate Influence)。
|
||||
|
||||
## 1、权力性影响力
|
||||
|
||||

|
||||
|
||||
权力性影响力通过合法的权力或权威来影响他人,通常基于职位、专业知识或正式授权。特点是人们被动地接受,体现在法律、职位、暴力和权威等群体秩序的场景中。
|
||||
|
||||
例如:
|
||||
|
||||
1. 法官对罪犯有裁决权;
|
||||
|
||||
2. 经理通过其职位对团队成员施加影响;
|
||||
|
||||
3. 专家通过其专业知识对他人提出建议;
|
||||
|
||||
|
||||
## 2、非权力性影响力
|
||||
|
||||
非权力性影响力不依赖正式权力或权威,而是通过个人魅力、威望、专业知识、个人关系或社会地位产生的影响。下图是将非权力性影响力具象为一个卓越的个人对周围人的影响,体现在才能(知识、技能),品格(道德、价值观、情感),成就(贡献、地位、声望)这三个核心标准中卓越的表现。
|
||||
|
||||
在中国文化中,德才兼备的人被认为是理想的领导者或团队成员,德才兼备的人不仅能够以正确的价值观和道德规范行事,还能够凭借其能力和才华做出贡献。在组织管理或人才选拔中,德才兼备被视为一个重要的标准。
|
||||
|
||||
例如:一个人可能因为其魅力、威望或专业知识而受到他人的尊重和追随。
|
||||
|
||||

|
||||
|
||||
## 3、 影响力原则(心理学中的作用要素)
|
||||
|
||||

|
||||
|
||||
罗伯特·B·西奥迪尼(Robert B. Cialdini)提出的六个影响力原则,可以帮助理解如何增强影响力。这些原则包括互惠原则、承诺与一致性原则、社会认同原则、喜好原则、权威原则和稀缺原则。当符合这六大要素后,人们的思维活动会不自觉地从下意识做出判断,从而影响思维决策和具体行动。在思维活动中是一种决策捷径的表现。
|
||||
|
||||
### 1. 互惠原则(Reciprocity)
|
||||
|
||||
- 人们倾向于回报他人的善意行为。
|
||||
|
||||
- 例如,先给予小恩小惠,以便在将来得到更大的回报。
|
||||
|
||||
|
||||
### 2. 承诺与一致性原则(Commitment and Consistency)
|
||||
|
||||
- 一旦人们承诺了某个行为或观点,他们就会倾向于坚持这个承诺,以保持一致性。
|
||||
|
||||
- 例如,在销售过程中,通过让顾客做出小的承诺来引导他们做出更大的购买决策。
|
||||
|
||||
|
||||
### 3. 社会认同原则(Social Proof)
|
||||
|
||||
- 人们倾向于模仿他人的行为,尤其是在不确定或不确定如何行动时。
|
||||
|
||||
- 例如,利用“大家都这么做”的策略来影响人们的行为,这里面常见于文化或者群体中的价值观取向或者非理性的观念。
|
||||
|
||||
|
||||
### 4. 喜好原则(Liking)
|
||||
|
||||
- 人们更愿意答应自己认识和喜欢的人提出的要求。
|
||||
|
||||
- 例如,通过建立良好的个人关系来增加影响力。
|
||||
|
||||
|
||||
### 5. 权威原则(Authority)
|
||||
|
||||
- 人们倾向于服从权威人士的命令或建议。
|
||||
|
||||
- 例如,利用专家的意见或权威人士的认可来增加说服力。
|
||||
|
||||
|
||||
### 6. 稀缺原则(Scarcity)
|
||||
|
||||
- 人们认为资源越稀缺,价值越高。
|
||||
|
||||
- 例如,通过限制供应或时间来增加产品的吸引力,常见于饥饿营销策略。
|
||||
|
||||
|
||||
这些心理学要素可以帮助你理解和分析如何影响他人,以及如何更有效地使用这些原则来增强影响力。
|
||||
|
||||
# 二、方法篇:提升影响力的方法论
|
||||
|
||||

|
||||
|
||||
从理论篇中,我们得出卓越个人发挥影响力的三个核心条件:才能、品格、成就。本章重点讲述提升非权力性影响力的方法论,同时也是如何成为卓越的个人的方法论。
|
||||
|
||||
## 1、影响力冰山模型
|
||||
|
||||

|
||||
才能、成就和品格构成了职场影响力冰山模型。冰山上部分是知识与技能、日常行为、声望和地位;冰山下部分是底层能力、价值观、自我认知、特质和动机。冰山以上的行为表现是由冰山以下看不见的内在部分驱动。
|
||||
|
||||
### 1、冰山上
|
||||
|
||||
1. 知识与技能的体现本岗位的专业知识与技能的深度,这决定了你能否胜任当前岗位的最基本的能力。对专业上下游生态相关的知识与技能的掌握决定了你对你的行业理解的广度。
|
||||
|
||||
2. 在日常行为的体现对应的是基本的为人处世的行为准则以及每个企业的文化价值观的贯彻上。
|
||||
|
||||
3. 声望和地位体现个人对团队的贡献,工作与绩效成果,职级晋升,专业头衔。
|
||||
|
||||
|
||||
### 2、冰山下
|
||||
|
||||
1. 底层能力学习能力,洞察力,透过现象洞察本质规划能力、执行能力、行动力社交与沟通能力,跨团队的协作能力2. 价值观社会价值观和企业价值观
|
||||
|
||||
2. 自我认知自我定位,自我的洞察和理解,自我反思等能力
|
||||
|
||||
3. 特质持续稳定的情绪,理性思考、持续乐观心态等能力
|
||||
|
||||
4. 动机具备追求卓的意愿,勇于挑战自我
|
||||
|
||||
|
||||
## 2、影响力构建的5个方向
|
||||
|
||||

|
||||
|
||||
> 总结为一句话:向下扎根,向上努力,向内沉淀、向外展现、向前奔跑
|
||||
|
||||
### 1、向下扎根
|
||||
|
||||
1. 围绕着你的行业,像一棵大树一样向下扎根,在专业深度精进、在知识广度上扩展。
|
||||
|
||||
2. 提升逻辑思维能力,提升沟通与表达能力。
|
||||
|
||||
3. 提升对事物客观规律的理解,掌握透过现象洞察本质的能力,提高执行能力,跨团队协作能力。
|
||||
|
||||
|
||||
### 2、向上生长
|
||||
|
||||
1. 不要自我设限,突破思想钢印。
|
||||
|
||||
2. 向更优秀的人学习,只有不断挑战更高的目标,才能发现更多的机会和空间
|
||||
|
||||
3. 追求卓越的职业目标和人生目标
|
||||
|
||||
|
||||
### 3、向内沉淀
|
||||
|
||||
1. 提升自我认知,对自己的特点、能力、性格、价值观、动机、愿望、思想等方面有清晰的认识,知道自己的强项和弱点。
|
||||
|
||||
2. 做好情绪管理,保持情绪稳定,对家人、对团队、对周围的人传递积极正面的情绪。有利于维持良好的社交关系和培养理性思考的特质。
|
||||
|
||||
3. 自我反思是个人成长和自我提升的关键能力,通过复盘、反思持续提高自我的认识和修养。4. 学习能力是保持个人价值以及持续竞争力的核心能力。
|
||||
|
||||
|
||||
### 4、向外展现
|
||||
|
||||
1. 建设个人专业品牌
|
||||
|
||||
2. 展现工作成果
|
||||
|
||||
3. 积极参与公益与团队活动
|
||||
|
||||
4. 积极交流分享
|
||||
|
||||
5. 通过演讲、协作、媒体分享经验与见解
|
||||
|
||||
|
||||
### 5、向前奔跑
|
||||
|
||||
1. 坚持长期主义,不计较眼前的得失
|
||||
|
||||
2. 相信量变到质变的客观规律
|
||||
|
||||
|
||||
# 三、实践篇:提升职场影响力行动指南
|
||||
|
||||
基于前一章的影响力冰山模型,以下是提升职场影响力的7个行动指引。
|
||||
|
||||
## 1、塑造个人品牌
|
||||
|
||||

|
||||
|
||||
1. 核心原则,坚持站在组织/公司利益的立场做正确的事。
|
||||
|
||||
2. 专业能力,获得公司内部与行业专业认证,强化专业权威形象。
|
||||
|
||||
3. 输出价值,创造机会分享你的专业知识和见解,通过写作、演讲、社交媒体等展示你的专业能力。
|
||||
|
||||
4. 工作贡献,参与跨团队项目,通过工作成就和贡献,持续保持高绩效结果,树立你在团队和公司的声誉。
|
||||
|
||||
|
||||
## 2、社交与人际关系
|
||||
|
||||

|
||||
|
||||
1. 人际关系:待人真诚与尊重,诚信与可靠,有同理心。定期与合作方交流互动,维持良好的关系。
|
||||
|
||||
2. 沟通与表达:清晰、简洁、有逻辑地传递信息,能够抓住要点。能够将复杂的概念通过通俗易懂的类比传达给不同专业领域的人。具备向不同层级的合作方阐述工作价值。
|
||||
|
||||
3. 融合协作:尊重团队成员的意见,对事不对人,保持理性与客观。站在合作伙伴利益的角度思考,互利互惠(利他)。
|
||||
|
||||
4. 领导力:鼓励团队成员发展,将公司的使命,团队的目标与个人目标结合,实现共赢。以身作则,通过榜样的力量展现领导力。
|
||||
|
||||
5. 大局观:在面对分歧时,优先解决业务面临的紧迫问题。站在公司的立场,跳出个人的责任边界或局部利益,选择最高效的解决方案。在这个过程中理解并服从大局,必要情况下为大局让步。
|
||||
|
||||
|
||||
## 3、持续学习
|
||||
|
||||

|
||||
|
||||
1. 关注行业动态,深化专业深度,学习上下游知识,扩展知识广度。让新知识链接旧知识,激发思考与见解。用SMART来量化与管理学习目标。
|
||||
|
||||
2. 寻求行业专家的指导
|
||||
|
||||
3. 通过教授他人,分享知识巩固理解
|
||||
|
||||
|
||||
## 4、批判性思维
|
||||
|
||||

|
||||
|
||||
> 区分个人观点与客观事实,避免偏见与误解,通过批判性思维提升理性思考,识别虚假信息与误导,帮助我们做出更客观与明智的决策。
|
||||
|
||||
### 1、非理性思维
|
||||
|
||||
非理性的因素存在于文化、信仰、环境、群体、职业、性格、偏好、个人情感等因素中,这些因素导致我们产生非理性的认知而不能自知,在日常工作生活的思维活动中,会下意识的带有偏见或误解做出非理性的判断或结论,从而导致错误的决策。
|
||||
|
||||
一些案例:
|
||||
|
||||
1. 比如价值观冲突、文化习俗或信仰或阻碍人们对事物的客观评价,这些评价即使缺少科学证据。
|
||||
|
||||
2. 比如基于刻板的印象做出决策,比如基于某个群体的片面了解就对其所有成员进行判断。
|
||||
|
||||
3. 比如在愤怒的情绪下可能做出冲动的决定,而不是基于事实和理性思考。
|
||||
|
||||
4. 比如选择候选人时倾向于选择相同母校或背景,而不是基于能力和经验。
|
||||
|
||||
|
||||
### 2、理性思维
|
||||
|
||||
想象一下:当我们接收到一个重要的信息或者身处一个复杂的情境中,客观的信息、主观的信息、非理性的偏见、情绪化的信息。我们的大脑在推断结论的时候,先经过理性标准规则判断(清晰性、准确性、精确性、相关性、深度、广度、逻辑性、重要性、公正性)过滤掉那些非理性的信息,从而得出客观的结论,做出明智的选择。
|
||||
|
||||
通过批判性思维,在大脑中建立理性思维框架和非理性防火墙,通过持续训练提高自身的理性认知,培养独立思考、谦逊、坚韧、成熟、共情、勇气、公正等理性品质。
|
||||
|
||||
当你开始应用批判性思维工具,可以克服自身思考过程中的非理性因素,从而做出更加客观和合理的决策。最明显的效果是可以过滤掉工作生活中大量的垃圾信息(情绪化的、主观的、偏见的),减少这些信息对自己造成负面影响(减少焦虑、内耗)
|
||||
|
||||
阅读推荐:
|
||||
|
||||
1. 思辨与立场-生活中无处不在的批判性思维工具
|
||||
|
||||
2. 批判性思维入门
|
||||
|
||||
3. 批判性思维(第12版)
|
||||
|
||||
|
||||
## 5、突破思想钢印
|
||||
|
||||

|
||||
|
||||
> 不要自我设限,要勇于突破思想钢印,打破固有认知,在天赋与环境的限度内,追求最卓越人生目标和职业目标。(敢想、敢做)
|
||||
|
||||
不要把人生当成预先编写好的程序,把人生的境遇归咎于宇宙中某种力量所造就的宿命,如果你相信自己的生活和遭遇是完全由不可控的力量预先安排好的,那你就失去了掌握自己人生的机会。人生并非是一成不变,而是由无数选择和行动塑造的。相信自己信念和决心的力量,不要被所谓的命运所束缚,通过不断的自我提升与不懈的努力,每个人都可以改变自己的生活和未来。记住!不要相信所谓的命运,要勇敢地与命运做斗争。
|
||||
|
||||
没有人能阻止我们成为优秀的人,勇敢的向榜样们学习,然后成为他们,超越他们。
|
||||
|
||||
## 6、保持身心健康
|
||||
|
||||

|
||||
|
||||
> 定期运动有助于身心健康。个人推荐跑步,是当下最经济且收益最快的运动。身体健康、心理健康、认知能力、思维方式以及行动力和决策力有着密切的关系。
|
||||
|
||||
1. 身体健康:身体健康是心理健康的基石。良好的身体健康有助于维持积极的心理状态,而长期的疾病或疼痛可能会影响心理健康,导致情绪低落和心理压力。身体健康也有助于高效管理精力,保持充沛的精力应对日常工作挑战。
|
||||
|
||||
2. 心理健康:心理状态直接影响我们的行动力,积极的心理状态可以激发我们的行动力。
|
||||
|
||||
3. 认知能力:认知能力包括记忆、注意力和思考能力,是进行有效决策的基础。
|
||||
|
||||
4. 思维方式:思维方式是我们看待和理解世界的方法,积极的思维方式可以促进心理健康,减少焦虑、压力与内耗。
|
||||
|
||||
|
||||
总的来说,健康的身体可以支持良好的心理状态,积极的思维方式可以提升认知能力和决策力,而心理健康则有助于维持行动力和坚持目标。因此,维护身体健康、培养积极的思维方式、提高认知能力、保持良好的心理状态,以及增强决策力和行动力,都是实现个人全面发展提升个人影响力的重要组成部分。
|
||||
|
||||
## 7、相信客观规律
|
||||
|
||||

|
||||
|
||||
持之以恒地贯彻以上六条方法,与卓越的人为伍,相信量变到质变的客观规律,利用时间的复利,积累量变促成质变。用张磊在《价值》中的一句话总结:
|
||||
|
||||
> “坚持长期主义,与伟大格局观者同行,做时间的朋友”
|
||||
|
||||
以上是我过去三年的浅显的沉淀和实践总结,其中大部分都是从工作实践中学习和内化,这其中包含了很多优秀的同学提供的思考与见解。再次提醒大家,运用批判性思维来判断这些经验和见解是否适合你们自己的实际情况。
|
||||
|
||||
因为淋过雨,所以想为你撑把伞,如果对你有帮助,请留言回复 ”有收获“,你的鼓励是我持续分享的动力。
|
||||
@@ -0,0 +1,14 @@
|
||||
3. **安装指定版本的 Node.js**:
|
||||
nvm install 18.16.0 # 安装具体版本
|
||||
nvm install --lts # 安装最新的LTS版本
|
||||
nvm install node # 安装最新稳定版
|
||||
|
||||
4. **列出所有可用版本**:
|
||||
nvm ls-remote # 查看远程所有版本
|
||||
nvm ls # 查看本地已安装版本
|
||||
|
||||
5. **切换 Node.js 版本**:
|
||||
|
||||
nvm use 18.16.0 # 切换到指定版本
|
||||
nvm use --lts # 切换到LTS版本
|
||||
nvm use node # 切换到最新稳定版
|
||||
@@ -0,0 +1,14 @@
|
||||
**Office 2024 专业增强版(批量版)密钥:**
|
||||
|
||||
- 3KR2W-NKWT4-CKWVH-2RDDM-R64PQ
|
||||
- 9J6NG-499G6-63HTD-6822F-37DTD
|
||||
- VHCNG-VW4DB-26GF8-D6WCY-F9GJ3
|
||||
- 3F9DN-GQGXY-BJWJW-JD3H7-GCVGD
|
||||
|
||||
**Office 2024 标准版(批量版)密钥:**
|
||||
|
||||
- YNCMG-DGRPQ-73388-TRFVT-RRK6J
|
||||
|
||||
|
||||
|
||||
![[b92f01266879b5ce008124b65ae0e2a8_v2-1018118325c906c9983b23b8489e49f3_1440w.jpg]]
|
||||
@@ -0,0 +1,58 @@
|
||||
sun.security.pkcs11.wrapper.PKCS11Constants 内包含 CKM 的定义,例如:CKM_MD5
|
||||
|
||||
|
||||
```
|
||||
// 使用指定的算法和提供者创建 HMAC 实例
|
||||
Mac mac = null;
|
||||
try {
|
||||
// 方案1 生成密钥
|
||||
// // 1. 创建 KeyGenerator 实例,指定 HMAC 算法(如 HmacSHA256)
|
||||
// KeyGenerator keyGen = KeyGenerator.getInstance("HmacSM3", this.pkcs11Provider);
|
||||
// // 2. 初始化密钥生成器(可选:指定密钥长度)
|
||||
// // - 如果省略初始化,JCE 会根据算法自动选择安全长度
|
||||
// keyGen.init(128); // 16 字节
|
||||
// // 3. 生成密钥
|
||||
// SecretKey key = keyGen.generateKey();
|
||||
// mac = Mac.getInstance(algorithm, this.pkcs11Provider);
|
||||
|
||||
// 方案2 使用明文密钥
|
||||
// 使用提供的密钥初始化 HMAC SecretKeySpec key = new SecretKeySpec(secretKey2, algorithm);
|
||||
|
||||
mac.init(key);
|
||||
// 执行 HMAC 计算,返回结果
|
||||
return mac.doFinal(data);
|
||||
} catch (Exception e) {
|
||||
e.printStackTrace();
|
||||
}
|
||||
```
|
||||
|
||||
|
||||
## 常见问题
|
||||
no such algorithm: SM4MAC for provider SunyardPKCS11-HSM
|
||||
|
||||
|
||||
|
||||
## 测试
|
||||
|
||||
6 -1 随机数
|
||||
1 SM3 -1
|
||||
1 SHA-256 -1
|
||||
1 SHA-384 -1
|
||||
1 SHA-512 -1
|
||||
2 HMAC-SM3 -1
|
||||
2 SHA-256 -1
|
||||
2 SHA-384 -1
|
||||
2 SHA-512 -1
|
||||
3 SM4 -1 MAC
|
||||
3 3DES -1
|
||||
3 AES -1
|
||||
4 SM2 1 -1
|
||||
4 SM2 2 -1
|
||||
4 RSA 1 -1
|
||||
4 RSA 2 -1
|
||||
5 SM4 ECB -1
|
||||
5 SM4 CBC -1
|
||||
5 3DES ECB -1
|
||||
5 3DES CBC -1
|
||||
5 AES ECB -1
|
||||
5 AES CBC -1
|
||||
@@ -0,0 +1,135 @@
|
||||
|
||||
|
||||
fievelk · March 20, 2023
|
||||
|
||||
[Web Development](https://www.keenformatics.com/categories/#Web%20Development) [Security](https://www.keenformatics.com/categories/#Security)
|
||||
|
||||
Today I was experimenting with a small project using Docker and Flask. I just created two identical services and exposed them on two different ports: nothing fancy. However, to my surprise, only one of the two seemed to be working.
|
||||
|
||||
The first service was hosted on port `8000`. As expected, I could visit `localhost:8000` and find the rendered HTML code that I had written. However, the second service hosted on port `6000` wasn’t giving me the same outcome. Instead of showing the HTML code I had prepared, my browser (Chrome) returned this error:
|
||||
|
||||
> This site can’t be reached
|
||||
>
|
||||
> The web page at http://localhost:6000/ might be temporarily down or it may have moved permanently to a new web address.
|
||||
>
|
||||
> ERR_UNSAFE_PORT
|
||||
|
||||
Being curious, I tried to reproduce the issue without Docker, just with the bare minimum setup. I created two webservers using [Python’s `http.server`](https://docs.python.org/3/library/http.server.html):
|
||||
|
||||
```
|
||||
$ python -m http.server 8000
|
||||
$ python -m http.server 6000
|
||||
```
|
||||
|
||||
The two commands serve an HTTP server on port `8000` and `6000` respectively. And there it is again: while the first webserver works flawlessly, trying to reach the one on port `6000` returns the error described above. So what’s the problem?
|
||||
|
||||
## Cross-protocol scripting
|
||||
|
||||
Turns out that some ports are explicitly blocked by browsers. This is done in response to the so-called **Cross-protocol scripting** vulnerability ([VU#476267](https://www.kb.cert.org/vuls/id/476267)). Through this vulnerability, an attacker could forge malicious HTML code to send data to other services used by the victim (for example crafting spam emails, or [printing through a network printer](http://aaron.weaver2.googlepages.com/CrossSitePrinting.pdf)). IMAP, SMTP, NNTP and POP3 are just a small portion of the affected services.
|
||||
|
||||
Mozilla and other browser vendors [fixed this vulnerability](https://www-archive.mozilla.org/projects/netlib/portbanning) by explicitly banning ports that belong to the vulnerable services. This way, when the malicious HTML code tries to send its data, it will basically receive the same error that I received above.
|
||||
|
||||
What I find confusing is that each browser seems to show (or not show) a different message for the same situation. As we saw above, Chrome shows the `ERR_UNSAFE_PORT` message. Safari seems to just shrug its shoulders and return a completely blank page. Firefox, instead, shows the most informative message:
|
||||
|
||||
> This address is restricted
|
||||
>
|
||||
> This address uses a network port which is normally used for purposes other than Web browsing. Firefox has canceled the request for your protection.
|
||||
|
||||
The wording in Firefox’s message allows us to understand one more thing: the request we’re sending to port `6000` never reaches the webserver, because it’s being immediately **canceled** by the browser. We can double-check this by having a look at the server logs, that will not show any request for that address. At this point it’s clear that we don’t even need to spawn a webserver at all to see this behaviour in place! If we just head to `http://localhost:6000` when all of our webservers are shut down, we will receive the same error. The browser doesn’t care about the server: it just stops the request before it’s sent.
|
||||
|
||||
## Testing without browser
|
||||
|
||||
If you want to prove that this restriction is actually implemented directly at the browser level, you can bypass the browser checks and request the same URL using **cURL** from terminal:
|
||||
|
||||
```
|
||||
$ curl http://localhost:6000/
|
||||
<!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01//EN" "http://www.w3.org/TR/html4/strict.dtd">
|
||||
<html>
|
||||
<head>
|
||||
<meta http-equiv="Content-Type" content="text/html; charset=utf-8">
|
||||
<title>Directory listing for /</title>
|
||||
</head>
|
||||
<body>
|
||||
<h1>Directory listing for /</h1>
|
||||
<hr>
|
||||
<ul>
|
||||
<li><a href="some_file.txt">some_file.txt</a></li>
|
||||
</ul>
|
||||
<hr>
|
||||
</body>
|
||||
</html>
|
||||
```
|
||||
|
||||
As you can see, this request doesn’t get blocked and it correctly shows the output produced by the Python webserver.
|
||||
|
||||
## List of blocked ports
|
||||
|
||||
For curious people, this is the list of the ports blocked by Firefox together with their respective services:
|
||||
|
||||
|Port|Service|
|
||||
|---|---|
|
||||
|1|tcpmux|
|
||||
|7|echo|
|
||||
|9|discard|
|
||||
|11|systat|
|
||||
|13|daytime|
|
||||
|15|netstat|
|
||||
|17|qotd|
|
||||
|19|chargen|
|
||||
|20|ftp data|
|
||||
|21|ftp control|
|
||||
|22|ssh|
|
||||
|23|telnet|
|
||||
|25|smtp|
|
||||
|37|time|
|
||||
|42|name|
|
||||
|43|nicname|
|
||||
|53|domain|
|
||||
|77|priv-rjs|
|
||||
|79|finger|
|
||||
|87|ttylink|
|
||||
|95|supdup|
|
||||
|101|hostriame|
|
||||
|102|iso-tsap|
|
||||
|103|gppitnp|
|
||||
|104|acr-nema|
|
||||
|109|POP2|
|
||||
|110|POP3|
|
||||
|111|sunrpc|
|
||||
|113|auth|
|
||||
|115|sftp|
|
||||
|117|uucp-path|
|
||||
|119|NNTP|
|
||||
|123|NTP|
|
||||
|135|loc-srv / epmap|
|
||||
|139|netbios|
|
||||
|143|IMAP2|
|
||||
|179|BGP|
|
||||
|389|LDAP|
|
||||
|465|SMTP+SSL|
|
||||
|512|print / exec|
|
||||
|513|login|
|
||||
|514|shell|
|
||||
|515|printer|
|
||||
|526|tempo|
|
||||
|530|courier|
|
||||
|531|chat|
|
||||
|532|netnews|
|
||||
|540|uucp|
|
||||
|556|remotefs|
|
||||
|563|NNTP+SSL|
|
||||
|587|submission|
|
||||
|601|syslog|
|
||||
|636|LDAP+SSL|
|
||||
|993|IMAP+SSL|
|
||||
|995|POP3+SSL|
|
||||
|2049|nfs|
|
||||
|4045|lockd|
|
||||
|6000|X11|
|
||||
|
||||
## References
|
||||
|
||||
- [Standard HTML form implementation allows access to IMAP, SMTP, NNTP, POP3, and other services via crafted HTML page](https://www.kb.cert.org/vuls/id/476267)
|
||||
- [Mozilla Port Blocking](https://www-archive.mozilla.org/projects/netlib/portbanning)
|
||||
|
||||
Share: [Twitter](http://twitter.com/share?text=Ports%20that%20are%20blocked%20by%20browsers&url=https://www.keenformatics.com/ports-that-are-blocked-by-browsers), [Facebook](https://www.facebook.com/sharer.php?u=https://www.keenformatics.com/ports-that-are-blocked-by-browsers)
|
||||
@@ -0,0 +1,92 @@
|
||||
Prisma 提供了一系列命令行工具来帮助开发者管理数据库和模型。以下是 Prisma 最常用的基本命令:
|
||||
|
||||
## 初始化与设置
|
||||
|
||||
1. **初始化 Prisma 项目**:
|
||||
npx prisma init
|
||||
创建 `prisma/schema.prisma` 文件和 `.env` 文件
|
||||
|
||||
## 数据库迁移相关
|
||||
|
||||
2. **创建新迁移**:
|
||||
npx prisma migrate dev --name [migration_name]
|
||||
开发环境使用,会自动应用迁移
|
||||
|
||||
|
||||
|
||||
3. **仅创建迁移文件而不应用**:
|
||||
npx prisma migrate dev --create-only
|
||||
|
||||
|
||||
4. **应用未执行的迁移**:
|
||||
npx prisma migrate deploy
|
||||
生产环境使用
|
||||
|
||||
|
||||
5. **重置数据库并重新应用所有迁移**:
|
||||
npx prisma migrate reset
|
||||
|
||||
6. **检查迁移状态**:
|
||||
npx prisma migrate status
|
||||
|
||||
|
||||
|
||||
|
||||
## 模型与数据库同步
|
||||
|
||||
7. **根据 schema 直接推送更改到数据库**:
|
||||
npx prisma db push
|
||||
- 不创建迁移记录,适合开发初期
|
||||
|
||||
8. **生成 Prisma Client**:
|
||||
npx prisma generate
|
||||
|
||||
|
||||
## 数据查看与操作
|
||||
|
||||
9. **启动 Prisma Studio (GUI 界面)**:
|
||||
npx prisma studio
|
||||
- 在浏览器中查看和编辑数据
|
||||
|
||||
10. **执行种子脚本**:
|
||||
npx prisma db seed
|
||||
|
||||
|
||||
## 诊断与维护
|
||||
|
||||
11. **验证 Prisma schema**:
|
||||
npx prisma validate
|
||||
|
||||
12. **格式化 Prisma schema 文件**:
|
||||
npx prisma format
|
||||
|
||||
13. **查看 Prisma 版本信息**:
|
||||
npx prisma --version
|
||||
|
||||
14. **生成数据模型关系图**:
|
||||
npx prisma generate --data-proxy
|
||||
|
||||
|
||||
## 生产环境相关
|
||||
|
||||
15. **创建生产环境的迁移**:
|
||||
npx prisma migrate diff
|
||||
|
||||
16. **检查数据库连接**:
|
||||
npx prisma db execute --file ./script.sql --schema prisma/schema.prisma
|
||||
|
||||
|
||||
## 高级命令
|
||||
|
||||
17. **使用 Prisma CLI 直接查询数据库**:
|
||||
npx prisma db execute --stdin --file=-
|
||||
|
||||
18. **导入现有数据库结构**:
|
||||
npx prisma db pull
|
||||
|
||||
|
||||
19. **导出当前数据库结构**:
|
||||
npx prisma db push --export
|
||||
|
||||
|
||||
这些命令涵盖了 Prisma 日常开发中的大多数使用场景。根据你的具体需求(开发、测试或生产环境),可以选择合适的命令组合来管理你的数据库。
|
||||
@@ -0,0 +1,18 @@
|
||||
RSA 算法有:指数模、CRT 两种不同的实现方法。
|
||||
|
||||
### **RSA 核心公式(指数模)**
|
||||
|
||||
1. **密钥生成**:
|
||||
- 选择两个大素数 `p` 和 `q`,计算模数 `n = p * q`
|
||||
- 计算欧拉函数 `φ(n) = (p-1) * (q-1)`
|
||||
- 选择公钥指数 `e`,满足 `1 < e < φ(n)` 且 `gcd(e, φ(n)) = 1`
|
||||
- 计算私钥指数 `d = e⁻¹ mod φ(n)`(模逆元)
|
||||
|
||||
2. **加密/解密**:
|
||||
- 加密:`c = m^e mod n`(明文 `m`,密文 `c`)
|
||||
- 解密:`m = c^d mod n`
|
||||
|
||||
3. **签名/验签**:
|
||||
- 签名:`s = m^d mod n`
|
||||
- 验签:`m' = s^e mod n`,检查 `m' == m`
|
||||
|
||||
@@ -0,0 +1,20 @@
|
||||
- 依赖少
|
||||
- 速度快
|
||||
- 结构简单易扩展
|
||||
|
||||
- SQLite单机百万TPS并发压测:[Scaling SQLite to 4M QPS on a Single Server (EC2 vs Bare Metal)](https://link.zhihu.com/?target=https%3A//blog.expensify.com/2018/01/08/scaling-sqlite-to-4m-qps-on-a-single-server/)。
|
||||
- SQLite未来可支持多个并发写入:官方出品的[SQLite HC-tree](https://link.zhihu.com/?target=https%3A//sqlite.org/hctree/doc/hctree/doc/hctree/index.html),尝试替换老的[B-tree](https://link.zhihu.com/?target=https%3A//sqlite.org/src4/doc/trunk/www/bt.wiki)数据结构,能实现多写多读、分布式节点复制与更大的数据库大小限制,[压测结果很不错](https://link.zhihu.com/?target=https%3A//sqlite.org/hctree/doc/hctree/doc/hctree/threadtest.wiki)。
|
||||
|
||||
Litefs相比Litestream要更进一步。Litefs通过提供一个基于FUSE的文件系统给SQLite做VFS层,当Leader节点要更新数据库时,该节点的SQLite的Pager模块要调用VFS层写入数据时,Litefs能够在页面级别复制与这个事务相关的页面集合,通过把这些页面集合打包成一个LTX数据格式的文件包,然后通过HTTP协议将这个文件包发送给只读节点,完成了数据的跨节点同步。
|
||||
|
||||
|
||||
|
||||
### Browser-compatible
|
||||
|
||||
SQLite可以通过WebAssembly(WASM)技术运行在浏览器中,以下两个项目能让前端代码在浏览器中发起SQL查询:
|
||||
|
||||
- [sql.js](https://link.zhihu.com/?target=https%3A//github.com/sql-js/sql.js/):JS代码导入该库后,通过网络请求下载SQLite数据库文件到浏览器内存中,即可发起SQL查询获取数据结果。
|
||||
- [absurd-sql](https://link.zhihu.com/?target=https%3A//github.com/jlongster/absurd-sql):和sql.js的区别在于,该项目可以使用浏览器的IndexedDB作为持久化存储,能对SQLite数据库文件进行读写操作。
|
||||
|
||||
OLTP数据库,很少用它做OLAP
|
||||
|
||||
@@ -0,0 +1,104 @@
|
||||
#### **实现方案**
|
||||
|
||||
实现这个很简单,只需要完成下面两步:
|
||||
|
||||
1. 想办法将 Class 加载到 JVM
|
||||
|
||||
2. 使 Spring 扫描到 Class
|
||||
|
||||
|
||||
有时候java中的各种框架以及复杂的概念源码给我们造成了很大理解障碍,特别是Spring家族的所以先想清楚大致实现步骤比较好
|
||||
|
||||
#### **将Class加载到JVM**
|
||||
|
||||
现在我们设定需要加载的 Jar 在 `/user/local/java/plugins` 目录下,对于第 1 步,现在有如下几种实现方式:
|
||||
|
||||
1. 扩大 `-cp` 由 `AppClassLoader` 帮我们加载外部 Jar
|
||||
|
||||
2. 使用 SpringBoot 提供的启动参数 `loader.path` 实现
|
||||
|
||||
3. 自定义 `classloader` 实现加载指定位置的 Jar
|
||||
|
||||
|
||||
其中 1 和 3 是JDK提供的方案,2是 SpringBoot 扩展的方案,毕竟 SpringBoot 也需要自定义加载很多类顺带扩展了一个参数出来
|
||||
|
||||
##### **方案1:扩大 -cp 由 AppClassLoader 帮我们加载外部 Jar**
|
||||
|
||||
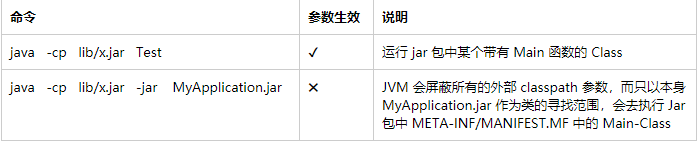
可以使用 `classpath` 指定类加载的路径,但 `classpath` 的生效是有条件的,这里其实对应了 Jar 包的两种启动方式:通过Jar包里的Main函数启动或者运行Jar启动
|
||||
|
||||
|
||||
|
||||
图片
|
||||
|
||||
SpringBoot 打包后 `MANIFEST.MF` 内容如下:
|
||||
|
||||
`Manifest-Version: 1.0 Created-By: Maven JAR Plugin 3.2.2 Build-Jdk-Spec: 18 Implementation-Title: intelligent-soul Implementation-Version: 0.0.1-SNAPSHOT Main-Class: org.springframework.boot.loader.JarLauncher Start-Class: com.test.MyApplication Spring-Boot-Version: 2.6.15 Spring-Boot-Classes: BOOT-INF/classes/ Spring-Boot-Lib: BOOT-INF/lib/ Spring-Boot-Classpath-Index: BOOT-INF/classpath.idx Spring-Boot-Layers-Index: BOOT-INF/layers.idx `
|
||||
|
||||
所以需要使用 Main 函数启动的方式,不能使用之前的常用的 Jar 包启动方式了。对于 SpringBoot 应用 `Main-Class` 是 `JarLauncher` 所以此时启动命令要改成
|
||||
|
||||
`java -cp /user/local/java/plugins org.springframework.boot.loader.JarLauncher `
|
||||
|
||||
- 优点:实现简单
|
||||
|
||||
- 缺点:每个 Jar 包启动命令都一样了,不好区分
|
||||
|
||||
|
||||
##### **方案2:使用SpringBoot扩展的启动参数,使用java -jar 配合Loader.path参数**
|
||||
|
||||
因为 Spring Boot 程序大多是打成 Jar 包,使用 `java -jar boot.jar` 的方式启动 (此时 `-cp` 无效),可以使用 `loader.path` 指定类加载路径加载其他 Jar,但 `loader.path` 生效也是有条件的:
|
||||
|
||||
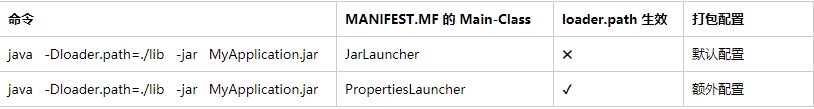
|
||||
|
||||
图片
|
||||
|
||||
SpringBoot 默认打包方式的`Main-Class`是`JarLauncher`
|
||||
|
||||
**配置 Main-Class**
|
||||
|
||||
为了使 `loader.path` 参数生效需要生成 Jar 包的 `Main-Class` 项配置为 `PropertiesLauncher`,在 `maven` 中如下配置,可参考 `Using the PropertiesLauncher`:
|
||||
|
||||
`<build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> <configuration> <!-- 打包时排除scope为system的包 --> <includeSystemScope>false</includeSystemScope> <!-- jvm启动时通过-Dloader.path加载包,必须指定layout为ZIP,否则-Dloader.path无效!!! --> <layout>ZIP</layout> </configuration> <executions> <execution> <goals> <goal>repackage</goal> </goals> </execution> </executions> </plugin> </plugins> <finalName>Test</finalName> </build> `
|
||||
|
||||
其中 layout 可配置值如下:
|
||||
|
||||
1、**JAR**,即通常的可执行 jar
|
||||
|
||||
`Main-Class: org.springframework.boot.loader.JarLauncher `
|
||||
|
||||
2、**WAR**,即通常的可执行war,需要的 servlet 容器依赖位于 `WEB-INF/lib-provided`
|
||||
|
||||
`Main-Class: org.springframework.boot.loader.WarLauncher `
|
||||
|
||||
3、**ZIP**,即DIR,类似于 JAR
|
||||
|
||||
`Main-Class: org.springframework.boot.loader.PropertiesLauncher `
|
||||
|
||||
4、**MODULE**,将所有的依赖库打包(`scope`为`provided`的除外),但是不打包 Spring Boot 的任何`Launcher`
|
||||
|
||||
5、**NONE**,将所有的依赖库打包,但是不打包 Spring Boot 的任何 `Launcher`
|
||||
|
||||
无论启动类是 `JarLauncher` 或者 `PropertiesLauncher`,`loader.path` 引入的 Jar 和 Spring Boot jar 包中 `BOOT-INFO/lib` 包下 Jar 都是使用类加载器 `org.springframework.boot.loader.LaunchedURLClassLoader` 进行加载,也就是说他们使用的是同一个类加载器。这个类加载器主要就是负责加载 Jar 包里的 Jar 的加载,因为JDK没有实现该功能所以 SpringBoot 定义了该类
|
||||
|
||||
注意到同一个程序,打包成不同类型时,`PropertiesLauncher (20s)` 比 `JarLauncher (8s)` 启动慢很多。
|
||||
|
||||
##### **方案3:自定义类加载器,加载固定目录下的jar包或者读取环境变量路径**
|
||||
|
||||
这种方式需要程序启动的某个节点,调用自定义类加载器去加载指定目录下的 Jar 包,时间点不是很好控制。但这个定制化程度比较高。
|
||||
|
||||
`//可以在这里调用自定义类加载 SpringApplication.run(SpringBootDemo.class, args); `
|
||||
|
||||
##### **方案4:通过设置-Xbootclasspath/a或者 Extention ClassLoader通过改变参数java.ext.dirs实现**
|
||||
|
||||
会改变系统类加载器加载行为不安全不推荐!!!
|
||||
|
||||
#### **加载后的类如何扫描进入Spring容器**
|
||||
|
||||
对于业务 Jar 包类,可以预先在SpringBoot中指定好扫描包路径,那么只需要插件包路径是`com.demo`开头即可,如下
|
||||
|
||||
`@SpringBootApplication(scanBasePackages = {"com.demo"}) public class SpringBootDemoApplication { public static void main(String[] args) { SpringApplication.run(SpringBootDemoApplication.class, args); } `
|
||||
|
||||
如不符合包名前缀一致的情况,需要在jar包`META-INF`下的`spring.factories`指定好自动装配的类即可如 mybatis-plus:
|
||||
|
||||
`# Auto Configure org.springframework.boot.env.EnvironmentPostProcessor=\ com.baomidou.mybatisplus.autoconfigure.SafetyEncryptProcessor org.springframework.boot.autoconfigure.EnableAutoConfiguration=\ com.baomidou.mybatisplus.autoconfigure.IdentifierGeneratorAutoConfiguration,\ com.baomidou.mybatisplus.autoconfigure.MybatisPlusLanguageDriverAutoConfiguration,\ com.baomidou.mybatisplus.autoconfigure.MybatisPlusAutoConfiguration `
|
||||
|
||||
👉 欢迎[加入小哈的星球](https://mp.weixin.qq.com/s?__biz=MzU4MDUyMDQyNQ==&mid=2247538511&idx=1&sn=c2f80c1f6143af7bfcaa661951d7bf23&chksm=fd5787c9ca200edf9b861f51dcdc6e15a575488ab6be0f5b721ea27047cf3316e07ea33a9a8d&token=343952052&lang=zh_CN&scene=21#wechat_redirect),你将获得: **专属的项目实战(多个项目) / 1v1 提问 / **Java 学习路线 /** 学习打卡 / 每月赠书 / 社群讨论**
|
||||
@@ -0,0 +1,12 @@
|
||||
|
||||
```powershell
|
||||
sudo apt-get update
|
||||
sudo apt install software-properties-common -y
|
||||
sudo add-apt-repository ppa:deadsnakes/ppa
|
||||
sudo apt-get install -y python3.10
|
||||
sudo apt-get install -y python3.10-dev
|
||||
|
||||
curl -sS https://bootstrap.pypa.io/get-pip.py | python3.10
|
||||
sudo apt-get install -y python3.10-distutils
|
||||
sudo ln -sf /usr/bin/python3.10 /usr/bin/python3
|
||||
```
|
||||
@@ -0,0 +1,62 @@
|
||||
### 一、组网说明
|
||||
|
||||
SW 3和SW 4两台交换机运行VRRP协议,为SW 1和SW 2提供虚拟网关服务,以保证SW 3和SW 4任意一台设备或链路中断的情况下SW 1还可以和SW 2通讯。
|
||||
|
||||
### 二、组网图
|
||||
|
||||
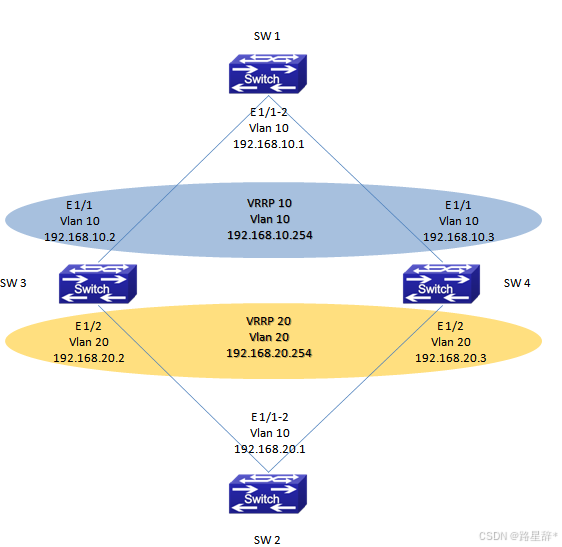
|
||||
|
||||
### 三、配置步骤
|
||||
|
||||
SW 3的配置
|
||||
#配置Vlan和三层接口
|
||||
switch(config)#**vlan** 10
|
||||
switch(config-Vlan10)#**switchport interface ethernet address** 1/1
|
||||
switch(config-Vlan10)#**ip address** 192.168.10.2 255.255.255.0
|
||||
switch(config-Vlan10)#**exit**
|
||||
switch(config)#**vlan** 20
|
||||
switch(config-Vlan20)#**switchport interface ethernet address** 1/2
|
||||
switch(config-Vlan20)#**ip address** 192.168.20.2 255.255.255.0
|
||||
switch(config-Vlan20)#**exit**
|
||||
#配置VRRP
|
||||
switch(config)#**router vrrp** 10
|
||||
switch(config-router)#**virtual-ip** 192.168.10.254
|
||||
switch(config-router)#**interface vlan** 10
|
||||
switch(config-router)#**priority** 120
|
||||
switch(config-router)#**enable**
|
||||
switch(config-router)#**exit**
|
||||
switch(config)#**router vrrp** 20
|
||||
switch(config-router)#**virtual-ip** 192.168.20.254
|
||||
switch(config-router)#**interface vlan** 20
|
||||
switch(config-router)#**priority** 120
|
||||
switch(config-router)#**enable**
|
||||
switch(config-router)#**exit**
|
||||
SW 4的配置
|
||||
#配置Vlan和三层接口
|
||||
switch(config)#**vlan** 10
|
||||
switch(config-Vlan10)#**switchport interface ethernet address** 1/1
|
||||
switch(config-Vlan10)#**ip address** 192.168.10.3 255.255.255.0
|
||||
switch(config-Vlan10)#**exit**
|
||||
switch(config)#**vlan** 20
|
||||
switch(config-Vlan20)#**switchport interface ethernet address** 1/2
|
||||
switch(config-Vlan20)#**ip address** 192.168.20.3 255.255.255.0
|
||||
switch(config-Vlan20)#**exit**
|
||||
#配置VRRP
|
||||
switch(config)#**router vrrp** 10
|
||||
switch(config-router)#**virtual-ip** 192.168.10.254
|
||||
switch(config-router)#**interface vlan** 10
|
||||
switch(config-router)#**enable**
|
||||
switch(config-router)#**exit**
|
||||
switch(config)#**router vrrp** 20
|
||||
switch(config-router)#**virtual-ip** 192.168.20.254
|
||||
switch(config-router)#**interface vlan** 20
|
||||
switch(config-router)#**enable**
|
||||
switch(config-router)#**exit**
|
||||
|
||||
### 四、注意事项
|
||||
|
||||
1.VRRP配置完成后,必须使用enable命令将VRRP使能。否则VRRP配置不生效。在修改VRRP组的配置时,也需要先将VRRP组Disable后才可以修改VRRP组的配置。
|
||||
2.VRRP组的ID号从1-255,总共可以创建255个VRRP组。
|
||||
3.VRRP组默认监控的是三层接口的UP/Down,在冗余链路的环境中,需要配合STP协议一起使用,以保证网络的可用性。(后续版本中,可以配合BFD功能监控物理接口的UP/Down)
|
||||
4.VRRP的交互报文只有定期发送的Hello报文,默认的交互时间是1S。当整机的VRRP组超过10组时,建议修改VRRP的交互间隔,避免设备在同一时间处理大量的VRRP报文。
|
||||
5.VRRP组根据优先级比较确认那台设备会成为Master,默认的优先级是100。优先级相同时,再比较IP地址,IP地址较大的一台会做为Master。
|
||||
@@ -0,0 +1 @@
|
||||
%USERPROFILE%\.cargo\bin
|
||||
@@ -0,0 +1,19 @@
|
||||
Windows 自带的 `netsh` 命令是功能强大的网络配置工具,支持 IPv4/IPv6 端口转发,操作无需安装额外软件,适合快速配置。
|
||||
**主要功能**:
|
||||
|
||||
1. **添加转发规则**
|
||||
```
|
||||
netsh interface portproxy add v4tov4 listenport=本地端口 connectaddress=目标IP connectport=目标端口
|
||||
```
|
||||
|
||||
```
|
||||
#示例:将本地8080转发到192.168.1.100的80端口
|
||||
netsh interface portproxy add v4tov4 listenport=8080 connectaddress=192.168.1.100 connectport=80
|
||||
```
|
||||
|
||||
|
||||
2. **查看规则**:`netsh interface portproxy show all`
|
||||
|
||||
3. **删除规则**:`netsh interface portproxy delete v4tov4 listenport=端口`
|
||||
|
||||
4. **重置所有规则**:`netsh interface portproxy reset`
|
||||
@@ -0,0 +1,12 @@
|
||||
|
||||
1. 首先按下[键盘](https://product.pconline.com.cn/keyboard/)“win+r”打开运行。
|
||||
|
||||
2. 接着输入“regedit”并回车打开 注册表 。
|
||||
|
||||
3. 打开后,定位到“计算机\HKEY_CURRENT_USER\Software\Microsoft\Windows\CurrentVersion\Explorer\Shell Folders”位置。
|
||||
|
||||
4. 然后双击打开其中的“appdata”,将数值数据更改为我们想要移动到的d盘位置。
|
||||
|
||||
5. 再来到“HKEY_CURRENT_USER\Software\Microsoft\Windows\CurrentVersion\Explorer\User Shell Folders”位置,同样修改appdata文件夹路径。
|
||||
|
||||
6. 修改完成后,只需要来到c盘,将appdata文件夹剪切粘贴到之前设置的d盘位置就可以了。(不放心的话可以先备份一下)
|
||||

|
After Width: | Height: | Size: 259 KiB |

|
After Width: | Height: | Size: 178 KiB |

|
After Width: | Height: | Size: 128 KiB |

|
After Width: | Height: | Size: 42 KiB |

|
After Width: | Height: | Size: 18 KiB |

|
After Width: | Height: | Size: 162 KiB |

|
After Width: | Height: | Size: 140 KiB |

|
After Width: | Height: | Size: 152 KiB |

|
After Width: | Height: | Size: 106 KiB |

|
After Width: | Height: | Size: 64 KiB |

|
After Width: | Height: | Size: 156 KiB |

|
After Width: | Height: | Size: 81 KiB |

|
After Width: | Height: | Size: 13 KiB |

|
After Width: | Height: | Size: 32 KiB |

|
After Width: | Height: | Size: 122 KiB |

|
After Width: | Height: | Size: 5.1 KiB |

|
After Width: | Height: | Size: 280 KiB |

|
After Width: | Height: | Size: 107 KiB |

|
After Width: | Height: | Size: 49 KiB |

|
After Width: | Height: | Size: 110 KiB |

|
After Width: | Height: | Size: 276 KiB |

|
After Width: | Height: | Size: 274 KiB |

|
After Width: | Height: | Size: 210 KiB |

|
After Width: | Height: | Size: 85 KiB |

|
After Width: | Height: | Size: 83 KiB |

|
After Width: | Height: | Size: 65 KiB |

|
After Width: | Height: | Size: 61 KiB |

|
After Width: | Height: | Size: 47 KiB |

|
After Width: | Height: | Size: 50 KiB |

|
After Width: | Height: | Size: 1.0 MiB |

|
After Width: | Height: | Size: 81 KiB |

|
After Width: | Height: | Size: 58 KiB |

|
After Width: | Height: | Size: 91 KiB |

|
After Width: | Height: | Size: 140 KiB |

|
After Width: | Height: | Size: 70 KiB |

|
After Width: | Height: | Size: 46 KiB |

|
After Width: | Height: | Size: 15 KiB |

|
After Width: | Height: | Size: 104 KiB |

|
After Width: | Height: | Size: 14 KiB |

|
After Width: | Height: | Size: 23 KiB |

|
After Width: | Height: | Size: 483 KiB |

|
After Width: | Height: | Size: 2.7 MiB |

|
After Width: | Height: | Size: 156 KiB |

|
After Width: | Height: | Size: 120 KiB |

|
After Width: | Height: | Size: 39 KiB |

|
After Width: | Height: | Size: 24 KiB |

|
After Width: | Height: | Size: 90 KiB |

|
After Width: | Height: | Size: 11 KiB |

|
After Width: | Height: | Size: 46 KiB |

|
After Width: | Height: | Size: 36 KiB |

|
After Width: | Height: | Size: 589 B |

|
After Width: | Height: | Size: 108 KiB |

|
After Width: | Height: | Size: 357 KiB |

|
After Width: | Height: | Size: 34 KiB |

|
After Width: | Height: | Size: 126 KiB |

|
After Width: | Height: | Size: 48 KiB |

|
After Width: | Height: | Size: 57 KiB |

|
After Width: | Height: | Size: 201 KiB |

|
After Width: | Height: | Size: 90 KiB |

|
After Width: | Height: | Size: 264 KiB |

|
After Width: | Height: | Size: 125 KiB |

|
After Width: | Height: | Size: 134 KiB |

|
After Width: | Height: | Size: 177 KiB |

|
After Width: | Height: | Size: 163 KiB |
@@ -0,0 +1,453 @@
|
||||
> 虽然使用docker部署比较方便,但是不建议使用docker部署数据库,尤其是比较关键的系统,负载比较大的系统。
|
||||
|
||||
|
||||
# 1 部署规划
|
||||
|
||||
本次部署的是2节点主备集群+1个确认监视器的集群架构。使用的操作系统是centos7.6,cpu架构是x86。
|
||||
|
||||
## 1.1集群ip规划
|
||||
|
||||

|
||||
|
||||
## 1.2集群端口规划
|
||||
|
||||

|
||||
|
||||
## 1.3实例参数规划
|
||||
|
||||
数据库的初始化参数至关重要,一些重要参数如页大小,数据库字符集和大小写是否敏感等,一旦初始化实例是不能直接修改的,如果要修改,必须重新再初始化实例,所以一定要和应用人员沟通清楚。
|
||||

|
||||
|
||||
## 1.4磁盘映射
|
||||
|
||||

|
||||
|
||||
## 1.5目录规划(对应docker内)
|
||||
|
||||

|
||||
|
||||
# 2 部署前宿主机优化
|
||||
|
||||
## 2.1关闭防火墙
|
||||
|
||||
```gauss
|
||||
systemctl stop firewalld
|
||||
systemctl disable firewalld
|
||||
```
|
||||
|
||||
## 2.2关闭selinux
|
||||
|
||||
容器运行需要对/proc/self/attr/keycreate有写权限,因此需要将SELINUX配置为disable。
|
||||
|
||||
```awk
|
||||
setenforce 0
|
||||
sed -i 's#SELINUX=enforcing#SELINUX=disabled#g' /etc/selinux/config
|
||||
```
|
||||
|
||||
# 3 部署步骤
|
||||
|
||||
## 3.1 部署docker
|
||||
|
||||
```autoit
|
||||
[root@docker ~]#yum install -y docker
|
||||
启动docker:
|
||||
[root@docker ~]# systemctl start docker
|
||||
```
|
||||
|
||||
## 3.2 加载数据库主备集群docker镜像包
|
||||
|
||||
根据操作系统版本和cpu架构,申请对应的DM8主备集群docker镜像包,下载后,上传到主节点服务器,如/opt目录。
|
||||
执行以下命令,加载docker镜像:
|
||||
|
||||
```stylus
|
||||
docker load -i dm8_20230224_rev178822_x86_rh6_64_docker_dw.tar
|
||||
```
|
||||
|
||||

|
||||
查看加载的镜像:docker images
|
||||

|
||||
镜像重命名:
|
||||
|
||||
```crmsh
|
||||
docker tag dmwatcher:dm8_20230224_rev178822_x86_rh6_64_docker_dw dmwatcher:dm8_dw
|
||||
```
|
||||
|
||||

|
||||
|
||||
## 3.3配置docker网络
|
||||
|
||||
本次部署主备集群,主库节点、备库节点和监视器节点分别部署在3台服务器上,所以采用HOST模式(容器使用宿主机的IP和端口)。这种方式需要在/etc/hosts文件中配置映射关系,否则容器运行后可能拿到的地址是127.0.0.1,而非本机的真正IP地址。三台服务器均需修改,更改如下:
|
||||
|
||||
```accesslog
|
||||
主库节点:
|
||||
vi /etc/hosts
|
||||
192.168.1.10 host localhost
|
||||
备库节点:
|
||||
vi /etc/hosts
|
||||
192.168.1.11 host localhost
|
||||
监视器节点:
|
||||
vi /etc/hosts
|
||||
192.168.1.12 host localhost
|
||||
```
|
||||
|
||||
## 3.4运行容器
|
||||
|
||||
### 3.4.1运行监视器容器
|
||||
|
||||
```routeros
|
||||
docker run -d --name dmwatcher_monitor --restart=always --privileged=true --net host -e DMWATCHER_ROLE=monitor -e CLUSTER_IPS="192.168.1.10,192.168.1.11,192.168.1.12" -e LD_LIBRARY_PATH=/opt/dmdbms/bin -v /dmdata/dmwatcher_monitor:/opt/dmdbms/data dmwatcher:dm8_dw
|
||||
```
|
||||
|
||||
### 3.4.2运行备库容器
|
||||
|
||||
```routeros
|
||||
docker run -d --name dmwatcher_standby -p 5236:5236 --restart=always --privileged=true --net host -e DMWATCHER_ROLE=standby -e DW_NO=2 -e CLUSTER_IPS="192.168.1.10,192.168.1.11,192.168.1.12" -e LD_LIBRARY_PATH=/opt/dmdbms/bin -v /dmdata/dmwatcher_standby:/opt/dmdbms/data dmwatcher:dm8_dw
|
||||
```
|
||||
|
||||
### 3.4.3运行主库容器
|
||||
|
||||
```routeros
|
||||
docker run -d --name dmwatcher_primary -p 5236:5236 --restart=always --privileged=true --net host -e PAGE_SIZE=32 -e extent_size=32 -e CASE_SENSITIVE=1 -e charset=1 -e DMWATCHER_ROLE=primary -e DW_NO=1 -e CLUSTER_IPS="192.168.1.10,192.168.1.11,192.168.1.12" -e LD_LIBRARY_PATH=/opt/dmdbms/bin -v /dmdata/dmwatcher_primary:/opt/dmdbms/data dmwatcher:dm8_dw
|
||||
```
|
||||
|
||||
注意:需要根据实际情况,设置对应的数据库页大小,字符集,大小写是否敏感,字符以字节还是字符为单位等数据库初始化参数。
|
||||
|
||||
### 3.4.4查看运行的容器
|
||||
|
||||
```ebnf
|
||||
docker ps
|
||||
```
|
||||
|
||||

|
||||

|
||||

|
||||
|
||||
### 3.4.5查看容器应用运行日志:
|
||||
|
||||
```powershell
|
||||
docker logs dmwatcher_monitor -f
|
||||
docker logs dmwatcher_standby -f
|
||||
docker logs dmwatcher_primary -f
|
||||
```
|
||||
|
||||
会发现主库这里一直卡在传输文件到备节点和监视器节点。
|
||||

|
||||
|
||||
### 3.4.6手动拷贝软件和主库备份到其他节点
|
||||
|
||||
```elixir
|
||||
scp BACKUP_FILE_01.tar DAMENG.tar 192.168.1.11:/dmdata/dmwatcher_standby
|
||||
scp BACKUP_FILE_01.tar DAMENG.tar 192.168.1.12:/dmdata/dmwatcher_monitor
|
||||
```
|
||||
|
||||

|
||||
|
||||
### 3.4.7重启所有节点的容器
|
||||
|
||||
重启主库、备库和监视器的容器,会自动对软件包和备份文件进行解压执行。
|
||||
|
||||
```maxima
|
||||
docker restart dmwatcher_primary
|
||||
docker restart dmwatcher_standby
|
||||
docker restart dmwatcher_monitor
|
||||
```
|
||||
|
||||
分别各节点日志,发现主备节点都显示SYSTEM IS READY,启动到了MOUNT状态,但是一直无法OPEN。监视器也显示不对,这时候要排查各节点的配置文件是否正确,且主备库是否设置了primary/standby模式,是否设置了相同的oguid。
|
||||
|
||||
### 3.4.8修改主备库的相关配置文件
|
||||
|
||||
#### 3.4.8.1数据库参数配置文件dm.ini
|
||||
|
||||
```makefile
|
||||
主库设置:
|
||||
[root@dmdb01 ~]# cd /dmdata/dmwatcher_primary/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dm.ini
|
||||
INSTANCE_NAME = DW1 #数据库实例名
|
||||
PORT_NUM = 5236 #数据库实例监听端口
|
||||
DW_INACTIVE_INTERVAL = 60 #接收守护进程消息超时时间
|
||||
ALTER_MODE_STATUS = 0 #不允许手工方式修改实例模式/状态/oguid
|
||||
ENABLE_OFFLINE_TS = 2 #不允许备库OFFLINE表空间
|
||||
MAL_INI = 1 #打开MAL系统
|
||||
ARCH_INI = 1 #打开归档配置
|
||||
备库设置:
|
||||
[root@dmdb01 ~]# cd /dmdata/dmwatcher_standby/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dm.ini
|
||||
INSTANCE_NAME = DW2 #数据库实例名
|
||||
PORT_NUM = 5236 #数据库实例监听端口
|
||||
DW_INACTIVE_INTERVAL = 60 #接收守护进程消息超时时间
|
||||
ALTER_MODE_STATUS = 0 #不允许手工方式修改实例模式/状态/oguid
|
||||
ENABLE_OFFLINE_TS = 2 #不允许备库OFFLINE表空间
|
||||
MAL_INI = 1 #打开MAL系统
|
||||
ARCH_INI = 1 #打开归档配置
|
||||
```
|
||||
|
||||
#### 3.4.8.2修改dmmal.ini配置文件
|
||||
|
||||
```makefile
|
||||
主库和备库的配置是一样的,主库配置如下:
|
||||
[root@dmdb01 DAMENG]# cd /dmdata/dmwatcher_primary/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dmmal.ini
|
||||
MAL_CHECK_INTERVAL = 5
|
||||
MAL_CONN_FAIL_INTERVAL = 5
|
||||
[MAL_INST1]
|
||||
MAL_INST_NAME = DW1
|
||||
MAL_HOST = 192.168.1.10
|
||||
MAL_PORT = 61141
|
||||
MAL_INST_HOST = 192.168.1.10
|
||||
MAL_INST_PORT = 5236
|
||||
MAL_DW_PORT = 52141
|
||||
MAL_INST_DW_PORT = 33141
|
||||
[MAL_INST2]
|
||||
MAL_INST_NAME = DW2
|
||||
MAL_HOST = 192.168.1.11
|
||||
MAL_PORT = 61141
|
||||
MAL_INST_HOST = 192.168.1.11
|
||||
MAL_INST_PORT = 5236
|
||||
MAL_DW_PORT = 52141
|
||||
MAL_INST_DW_PORT = 33141
|
||||
```
|
||||
|
||||
#### 3.4.8.3修改归档配置文件dmarch.ini
|
||||
|
||||
```makefile
|
||||
主库设置如下:
|
||||
[root@dmdb01 DAMENG]# cd /dmdata/dmwatcher_primary/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dmarch.ini
|
||||
[ARCHIVE_REALTIME1]
|
||||
ARCH_TYPE = REALTIME
|
||||
ARCH_DEST = DW2
|
||||
[ARCHIVE_LOCAL1]
|
||||
ARCH_TYPE = LOCAL
|
||||
ARCH_DEST = /opt/dmdbms/data/DAMENG/arch
|
||||
ARCH_FILE_SIZE = 1024
|
||||
ARCH_SPACE_LIMIT = 10240 #根据实际磁盘设置,建议要能保存2个全备之间的归档。这里设置的是10G
|
||||
备库设置如下:
|
||||
[root@dmdb02 DAMENG]# cd /dmdata/dmwatcher_standby/DAMENG
|
||||
[root@dmdb02 DAMENG]# vi dmarch.ini
|
||||
[ARCHIVE_REALTIME1]
|
||||
ARCH_TYPE = REALTIME
|
||||
ARCH_DEST = DW1
|
||||
[ARCHIVE_LOCAL1]
|
||||
ARCH_TYPE = LOCAL
|
||||
ARCH_DEST = /opt/dmdbms/data/DAMENG/arch
|
||||
ARCH_FILE_SIZE = 1024
|
||||
ARCH_SPACE_LIMIT = 10240
|
||||
```
|
||||
|
||||
#### 3.4.8.4修改数据守护进程文件dmwatcher.ini
|
||||
|
||||
```makefile
|
||||
主库配置如下:
|
||||
[root@dmdb01 DAMENG]# cd /dmdata/dmwatcher_primary/DAMENG
|
||||
[root@dmdb01 DAMENG]# vi dmwatcher.ini
|
||||
[GRP453331]
|
||||
DW_TYPE = GLOBAL
|
||||
DW_MODE = AUTO
|
||||
DW_ERROR_TIME = 10
|
||||
INST_RECOVER_TIME = 60
|
||||
INST_ERROR_TIME = 10
|
||||
INST_OGUID = 453331
|
||||
INST_INI = /opt/dmdbms/data/DAMENG/dm.ini
|
||||
INST_AUTO_RESTART = 1
|
||||
INST_STARTUP_CMD = /opt/dmdbms/bin/dmserver
|
||||
RLOG_SEND_THRESHOLD = 0
|
||||
RLOG_APPLY_THRESHOLD = 0
|
||||
备库配置如下:
|
||||
[root@dmdb02 DAMENG]# cd /dmdata/dmwatcher_standby/DAMENG/
|
||||
[root@dmdb02 DAMENG]# vi dmwatcher.ini
|
||||
[GRP453331]
|
||||
DW_TYPE = GLOBAL
|
||||
DW_MODE = AUTO
|
||||
DW_ERROR_TIME = 10
|
||||
INST_RECOVER_TIME = 60
|
||||
INST_ERROR_TIME = 10
|
||||
INST_OGUID = 453331
|
||||
INST_INI = /opt/dmdbms/data/DAMENG/dm.ini
|
||||
INST_AUTO_RESTART = 1
|
||||
INST_STARTUP_CMD = /opt/dmdbms/bin/dmserver
|
||||
RLOG_SEND_THRESHOLD = 0
|
||||
RLOG_APPLY_THRESHOLD = 0
|
||||
```
|
||||
|
||||
#### 3.4.8.5设置数据库模式和oguid
|
||||
|
||||
```elixir
|
||||
主库执行:
|
||||
[root@dmdb01 opt]# docker exec -it dmwatcher_primary /bin/bash
|
||||
root@dmdb01:/# cd /opt/dmdbms/bin
|
||||
root@dmdb01:/opt/dmdbms/bin# ./disql sysdba/SYSDBA001
|
||||
SP_SET_PARA_VALUE(1,'ALTER_MODE_STATUS',1);
|
||||
ALTER DATABASE PRIMARY;
|
||||
SP_SET_OGUID(453331);
|
||||
SP_SET_PARA_VALUE(1,'ALTER_MODE_STATUS',0);
|
||||
备库执行:
|
||||
[root@dmdb02 DAMENG]# docker exec -it dmwatcher_standby /bin/bash
|
||||
root@dmdb02:/# cd /opt/dmdbms/bin
|
||||
root@dmdb02:/opt/dmdbms/bin# ./disql sysdba/SYSDBA001
|
||||
SP_SET_PARA_VALUE(1,'ALTER_MODE_STATUS',1);
|
||||
ALTER DATABASE STANDBY;
|
||||
SP_SET_OGUID(453331);
|
||||
SP_SET_PARA_VALUE(1,'ALTER_MODE_STATUS',0);
|
||||
```
|
||||
|
||||
#### 3.4.8.6修改监视器配置文件dmmonitor.ini
|
||||
|
||||
```makefile
|
||||
确认监视器配置如下:
|
||||
[root@dmmonitor ~]# cd /dmdata/dmwatcher_monitor/DAMENG/
|
||||
[root@dmmonitor DAMENG]# vi dmmonitor.ini
|
||||
MON_DW_Confirm = 1
|
||||
MON_LOG_PATH = /opt/dmdbms/data/log
|
||||
MON_LOG_INTERVAL = 60
|
||||
MON_LOG_FILE_SIZE = 128
|
||||
MON_LOG_SPACE_LIMIT = 1024
|
||||
[GRP453331]
|
||||
MON_INST_OGUID = 453331
|
||||
MON_DW_IP = 192.168.1.11:52141
|
||||
MON_DW_IP = 192.168.1.10:52141
|
||||
```
|
||||
|
||||
#### 3.4.8.7更新数据库授权
|
||||
|
||||
上传数据库的授权文件dm.key到/opt,更新主库和备库的数据库授权。
|
||||
|
||||
```vim
|
||||
主库操作:
|
||||
[root@dmdb01 ~]# cd /opt/
|
||||
[root@dmdb01 opt]# docker cp dm.key dmwatcher_primary:/opt/dmdbms/bin
|
||||
备库操作:
|
||||
[root@dmdb02 ~]# cd /opt/
|
||||
[root@dmdb02 opt]# docker cp dm.key dmwatcher_standby:/opt/dmdbms/bin
|
||||
```
|
||||
|
||||
当然这里也可以在创建容器的时候就指定授权文件。指定-v参数:
|
||||
|
||||
```awk
|
||||
-v /opt/dm.key:/opt/dmdbms/bin/dm.key
|
||||
```
|
||||
|
||||
#### 3.4.8.8重启所有容器
|
||||
|
||||
```autoit
|
||||
先监视器,再主库,后备库:
|
||||
[root@dmmonitor DAMENG]# docker restart dmwatcher_monitor
|
||||
[root@dmdb01 opt]# docker restart dmwatcher_primary
|
||||
[root@dmdb02 opt]# docker restart dmwatcher_standby
|
||||
```
|
||||
|
||||
#### 3.4.8.9查看监视器状态
|
||||
|
||||
重启完主库和备库容器后,通过监视器查看集群是否启动成功,且主库和备库数据库都处于OPEN状态,且远程归档状态都是VALID。至此,主备集群部署完成。
|
||||

|
||||
|
||||
### 3.4.9优化数据库参数
|
||||
|
||||
分别登陆主库和备库节点,执行数据库参数优化脚本AutoParaAdj3.4_dm8.sql。优化完成后,重启主备集群容器。
|
||||
|
||||
# 4集群启停方式
|
||||
|
||||
## 4.1集群启动
|
||||
|
||||
先启动主库,再启动备库,最后启动确认监视器。启动后,通过监视器查询集群状态。
|
||||
|
||||
```autoit
|
||||
[root@data43 DAMENG]# docker start dmwatcher_primary
|
||||
[root@data44 DAMENG]# docker start dmwatcher_standby
|
||||
[root@monitoring DAMENG]# docker start dmwatcher_monitor
|
||||
```
|
||||
|
||||
## 4.2集群关闭
|
||||
|
||||
先关闭确认监视器,再关闭主库,最后关闭备库。
|
||||
|
||||
```autoit
|
||||
[root@monitoring DAMENG]# docker stop dmwatcher_monitor
|
||||
[root@data43 DAMENG]# docker stop dmwatcher_primary
|
||||
[root@data44 DAMENG]# docker stop dmwatcher_standby
|
||||
```
|
||||
|
||||
## 4.3数据库登陆方式
|
||||
|
||||
方法(1):进入容器,使用disql客户端登陆
|
||||
|
||||
```elixir
|
||||
[root@data43 DAMENG]# docker exec -it dmwatcher_primary bash
|
||||
root@data43:/# cd /opt/dmdbms/bin
|
||||
root@data43:/opt/dmdbms/bin# ./disql sysdba/SYSDBA001
|
||||
Server[LOCALHOST:5236]:mode is primary, state is open
|
||||
login used time : 4.520(ms)
|
||||
last login ip : ::1
|
||||
last login time : 2023-05-24 17:12:49
|
||||
login failed times : 0
|
||||
Whether password is expired : Not expired
|
||||
disql V8
|
||||
```
|
||||
|
||||
方法(2):使用达梦管理工具manager登陆:
|
||||

|
||||
|
||||
# 5应用链接方式
|
||||
|
||||
(1)数据库驱动:进入容器,数据库驱动位于/opt/dmdbms/drivers目录,如
|
||||
jdbc驱动,DmJdbcDriver18.jar(对应jdk1.8),DmJdbcDriver17.jar(对应jdk1.7)。
|
||||
(2)URL链接方式:采用服务名的方式链接达梦主备集群。
|
||||
配置文件不是xml文件,则配置如下:
|
||||
|
||||
```apache
|
||||
jdbc:dm://DMDW?DMDW=(192.168.1.10:5236, 192.168.1.11:5236)&LOGIN_MODE=(1)
|
||||
```
|
||||
|
||||
配置文件是xml文件,则配置如下:
|
||||
|
||||
```apache
|
||||
jdbc:dm://DMDW?DMDW=(192.168.1.10:5236, 192.168.1.11:5236) &LOGIN_MODE=(1)
|
||||
```
|
||||
|
||||
# 6docker参数解释
|
||||
|
||||

|
||||
|
||||
|
||||
|
||||
|
||||
docker run -d -p 15236:5236 --restart=always --name dmwatcher_primary --privileged=true --net docker1 --ip 172.28.0.2
|
||||
-e MODE=docker_dmwatcher
|
||||
-e PAGE_SIZE=32
|
||||
-e CASE_SENSITIVE=1
|
||||
-e UNICODE_FLAG=1
|
||||
-e BLANK_PAD_MODE=1
|
||||
-e SYSDBA_PWD=Skh_2025 -e SYSAUDITOR_PWD=Skh_2025 -e DMWATCHER_ROLE=primary -e DW_NO=1 -e CLUSTER_IPS="172.28.0.4,172.28.0.2,172.28.0.3" -v /data/deploy/dm-server/dm8/image/dm.key:/opt/dmdbms/bin/dm.key dm8:dm8_20241230_rev255012_HWarm_kylin10_64
|
||||
|
||||
|
||||
#!/bin/env bash
|
||||
# 运行主节点容器
|
||||
name=dmwatcher_primary
|
||||
img=dm8:dm8_20241230_rev255012_x86_kylin10_64
|
||||
docker rm -vf $name
|
||||
docker run -d \
|
||||
-p 30136:5236 \
|
||||
--restart=always \
|
||||
--name dmwatcher_primary \
|
||||
--privileged=true \
|
||||
--net net1 \
|
||||
--ip 172.20.0.2 \
|
||||
-e MODE=docker_dmwatcher \
|
||||
-e PAGE_SIZE=16 \
|
||||
-e CASE_SENSITIVE=1 \
|
||||
-e UNICODE_FLAG=1 \
|
||||
-e LENGTH_IN_CHAR=1 \
|
||||
-e SYSDBA_PWD=sunyard123 \
|
||||
-e DMWATCHER_ROLE=primary \
|
||||
-e DW_NO=1 \
|
||||
-e CLUSTER_IPS="172.20.0.2,172.20.0.3,172.20.0.4" \
|
||||
-e LD_LIBRARY_PATH=/opt/dmdbms/bin \
|
||||
-v `pwd`/dmwatcher_primary:/opt/dmdbms/data \
|
||||
-v `pwd`/dm1701120153.key:/opt/dmdbms/bin/dm.key \
|
||||
$img
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,3 @@
|
||||
```
|
||||
apt-get install gcc-multilib g++-multilib
|
||||
```
|
||||
@@ -0,0 +1,2 @@
|
||||
Thread Group 作为用例组
|
||||
Transaction Controller 作为测试用例
|
||||
@@ -0,0 +1,8 @@
|
||||
|
||||
|
||||
locale -a
|
||||
fc-list :lang=zh
|
||||
echo $LANG $LC_ALL
|
||||
bash -c 'echo -e "\xe4\xb8\xad\xe6\x96\x87"'
|
||||
|
||||
|
||||
@@ -0,0 +1,146 @@
|
||||
## 安装依赖
|
||||
|
||||
$ npm i jszip os shelljs -S
|
||||
|
||||
## app.js
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||
|
||||
// $ npm i jszip os shelljs -S
|
||||
const fs = require('fs')
|
||||
const { join, sep } = require('path')
|
||||
|
||||
const os = require('os')
|
||||
const JSZIP = require('jszip')
|
||||
const shell = require('shelljs')
|
||||
|
||||
const homedir = os.homedir()
|
||||
const desktop = join(homedir, '/Desktop/')
|
||||
|
||||
// 调试神器
|
||||
const debug = (...args) => (console.log(...args), args[args.length - 1])
|
||||
|
||||
// fixbug:shell 执行不支持 window \ 的格式。强制修复为 Linux / 格式
|
||||
const exec = command => shell.exec(debug("—— DEBUG ——:", command.replace(/\\/g, '/')))
|
||||
|
||||
// 获取文件大小
|
||||
const readSize = target => {
|
||||
const size = fs.statSync(target).size
|
||||
if (size < 1024) {
|
||||
return size + ' kb'
|
||||
} else {
|
||||
return Math.floor(size / 1024) + ' mb'
|
||||
}
|
||||
}
|
||||
|
||||
// 我的压缩列表(TODO:抽离到独立的配置文件)
|
||||
const zipList = [
|
||||
join(desktop, 'dls-visual-12345'),
|
||||
join(desktop, 'dls-micro-app'),
|
||||
join(desktop, '我的ahk'),
|
||||
join(desktop, 'pandora-cli'),
|
||||
]
|
||||
|
||||
// 编译临时存储地址
|
||||
const template_address = join(__dirname, 'template')
|
||||
|
||||
// fixbug: 还是这样最安全,毕竟要用 shell 执行地址
|
||||
const allzip_address = join(template_address, '*.zip')
|
||||
|
||||
// 迁移地址
|
||||
const migrate_address = join(desktop, '同步项目')
|
||||
|
||||
// 创建临时文件夹和同步专用文件夹
|
||||
exec(`mkdir -p ${template_address} && mkdir -p ${migrate_address}`)
|
||||
|
||||
// 排除部分文件或文件夹
|
||||
const exclude = name => !['.git', 'node_modules'].includes(name)
|
||||
|
||||
// zip 递归读取文件夹下的文件流
|
||||
function readDir(zip, nowPath) {
|
||||
// 读取目录中的所有文件及文件夹(同步操作)
|
||||
let files = fs.readdirSync(nowPath)
|
||||
|
||||
//遍历检测目录中的文件
|
||||
files.filter(exclude).forEach((fileName, index) => {
|
||||
// 打印当前读取的文件名
|
||||
false && console.log(fileName, index)
|
||||
|
||||
// 当前文件的全路径
|
||||
let fillPath = join(nowPath, fileName)
|
||||
|
||||
// 获取一个文件的属性
|
||||
let file = fs.statSync(fillPath)
|
||||
|
||||
// 如果是目录的话,继续查询
|
||||
if (file.isDirectory()) {
|
||||
// 压缩对象中生成该目录
|
||||
let dirlist = zip.folder(fileName)
|
||||
// (递归)重新检索目录文件
|
||||
readDir(dirlist, fillPath)
|
||||
} else {
|
||||
// 压缩目录添加文件
|
||||
zip.file(fileName, fs.readFileSync(fillPath))
|
||||
}
|
||||
})
|
||||
}
|
||||
|
||||
// 开始压缩文件
|
||||
function zipFolder({ target = __dirname, output = __dirname + '/result.zip' }) {
|
||||
// 创建 zip 实例
|
||||
const zip = new JSZIP()
|
||||
|
||||
// zip 递归读取文件夹下的文件流
|
||||
readDir(zip, target)
|
||||
|
||||
// 设置压缩格式,开始打包
|
||||
return zip.generateAsync({
|
||||
// nodejs 专用
|
||||
type: 'nodebuffer',
|
||||
// 压缩算法
|
||||
compression: 'DEFLATE',
|
||||
// 压缩级别
|
||||
compressionOptions: { level: 9, },
|
||||
}).then(content => {
|
||||
// 将打包的内容写入 当前目录下的 result.zip中
|
||||
fs.writeFileSync(output, content, 'utf-8')
|
||||
})
|
||||
}
|
||||
|
||||
// demo
|
||||
false && zipFolder({
|
||||
// 目标文件夹
|
||||
target: join(__dirname, 'test'),
|
||||
// 输出 zip
|
||||
output: __dirname + '/result.zip'
|
||||
})
|
||||
|
||||
// 删除所有的 .zip
|
||||
exec(`rm -rf ${allzip_address}`)
|
||||
|
||||
// 开始压缩
|
||||
const workers = zipList.map(async target => {
|
||||
// 获取文件名
|
||||
const [name] = target.split(sep).reverse()
|
||||
|
||||
// zip 输出路径和文件名
|
||||
const output = join(template_address, `${name}-${Date.now()}.zip`)
|
||||
|
||||
// 压缩目标文件夹
|
||||
await zipFolder({ target, output })
|
||||
|
||||
// 获取压缩体积
|
||||
const size = readSize(output)
|
||||
|
||||
// 打印成功信息
|
||||
console.log(`☀️ ${name} 已压缩完成:`, output, ` (${size})`)
|
||||
})
|
||||
|
||||
;(async () => {
|
||||
// 等待任务完成
|
||||
await Promise.all(workers)
|
||||
// 开始批量迁徙
|
||||
exec(`mv ${allzip_address} -t ${migrate_address}`)
|
||||
})();
|
||||
|
||||
[](https://assets.cnblogs.com/images/copycode.gif)
|
||||

|
After Width: | Height: | Size: 5.5 KiB |
@@ -0,0 +1,17 @@
|
||||
|
||||
- [官方帮助手册](https://publish.obsidian.md/help-zh/%E7%94%B1%E6%AD%A4%E5%BC%80%E5%A7%8B)
|
||||
- [[https://github.com/oldwinter/knowledge-garden|最佳实践]]
|
||||
|
||||
|
||||
|
||||
## 如何保存网页
|
||||
|
||||
简悦插件把网页转 markdown 复制
|
||||
保存到本地,typora 自动上传图片到图床
|
||||
再用 obsidian 管理和查看
|
||||
|
||||
|
||||
浏览器插件与 obsidian 通信 https://github.com/coddingtonbear/obsidian-web
|
||||
|
||||
初始化需要安装的插件
|
||||
![[Pasted image 20261014173028.png]]
|
||||
@@ -0,0 +1,11 @@
|
||||
感觉买个插电混动的会爽很多,最近有一些房车是基于比亚迪的插混轻卡去改的,C1 牌就能开
|
||||
1. 品牌型号:豪沃-指挥官
|
||||
|
||||
2. 价格
|
||||
|
||||
- 2.5T 柴油 33.58 万;
|
||||
- 3.0T 柴油+空气悬挂:35.58 万;
|
||||
- 外观特 MAN ,内部空间也大
|
||||
3. 想法
|
||||
|
||||
- 希望还完房贷后搞一辆带着家人环中国走一圈。
|
||||
@@ -0,0 +1,60 @@
|
||||
**1、《高效能人士的七个习惯》- 史蒂芬·柯维**
|
||||
这本书是个人成长和领导力领域的经典之作,提供了七个基本原则,帮助我们从依赖到独立,再到互赖,全面提升自我管理和人际效能。
|
||||
|
||||
**七个原则分别是:**
|
||||
1️⃣积极主动:你是自己生活的创造者,而不是环境的被动反应者。
|
||||
2️⃣以终为始:明确自己的人生目标和价值观,并以此为导向,专注于真正重要的事情。
|
||||
3️⃣要事第一:使用时间管理矩阵(四象限法),将精力集中在高价值、长期受益的任务上,学会拒绝不重要的事情。
|
||||
4️⃣双赢思维:在人际互动中追求互惠互利,而不是零和博弈。
|
||||
5️⃣知彼解己:先倾听他人,理解对方的需求和感受,再表达自己的观点。
|
||||
6️⃣统合综效:通过团队合作和创造性协作,实现1+1>2的效果。
|
||||
7️⃣不断更新:持续提升自己,通过冥想、阅读或反思提升内在力量。持续学习新知识和技能。
|
||||
|
||||
|
||||
|
||||
**2、《原子习惯》 - 詹姆斯·克利尔**
|
||||
|
||||
这本书深入探讨了习惯的形成机制,提供了实用的策略,帮助我们通过微小的改变积累巨大的成果。
|
||||
比如,我们可以用**习惯四步模型(提示、渴望、反应、奖励)、两分钟规则、习惯叠加、追踪习惯等方法来帮自己快速培养起一个新习惯。**
|
||||
昨天我推荐的《掌控习惯》也跟这本书类似,如果你感兴趣也都看一看。
|
||||
|
||||
|
||||
**3、《思考,快与慢》 - 丹尼尔·卡尼曼**
|
||||
|
||||
这本书揭示了人类思维的两种模式:快速直觉和慢速理性。
|
||||
**改变的第一步,首先应该是认知觉醒。**了解了思维模式的底层逻辑,我们就可以更好地做出决策,避免认知偏差。
|
||||
|
||||
|
||||
|
||||
**分享3个好句:**
|
||||
①“我们总是高估自己对世界的了解,却低估了事件中存在的偶然性。
|
||||
②“人们劳累或是精力耗尽时,更容易受那些空洞却有说服力的信息影响。
|
||||
③“熟悉了就会喜欢,这就是一种单纯暴露效应。
|
||||
|
||||
|
||||
|
||||
**4、《原则》 - 瑞·达利欧**
|
||||
成功的关键在于建立一套清晰的原则,并依据这些原则做出决策。
|
||||
|
||||
**5、《穷查理宝典》- 查理·芒格**
|
||||
这本书汇集了查理·芒格的智慧和思维方式,特别是他的多元思维模型,长期主义思维,我几乎每年都会读一遍。
|
||||
|
||||
**查理·芒格 说:“复利是世界第八大奇迹,理解它的人从中获利,不理解的人为之付出代价。**”
|
||||
|
||||
相信复利的力量。
|
||||
不仅是财富积累,于知识、能力和人际关系都要坚持长期主义,用复利思维耐心培养。
|
||||
长期的坚持,再微小的进步也会积累成巨大的成果。
|
||||
|
||||
|
||||
**6、《刻意练习》- 安德斯·艾利克森**
|
||||
|
||||
普通小白如何在半年内成为专家?这本书就揭示了这个秘密。
|
||||
**《刻意练习》里说:“所有人都以为‘杰出’源于‘天赋’,‘天才’却说:我的成就源于‘正确的练习’。**
|
||||
成功并非天生注定,而是可以通过后天的努力和正确的练习方法来实现的。
|
||||
通过有目的的练习和反馈,任何人都可以在任何领域取得卓越成就。
|
||||
为什么你努力了却看不到结果?因为很多人所谓的努力,只是低水平的重复,而没有真正意义上的刻意练习。
|
||||
|
||||
一万小时定律的背后,是每一天的正确专注和坚持。**成功没有捷径,只有日复一日的刻意努力。**
|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,46 @@
|
||||
管理闭环:PDCA, 计划 Plan、执行 Do 、检查 Check、处理 Act
|
||||
大脑从获取信息到采取行动包含4个动作,分别是感知、认知、决策、行动。所以叫认知飞轮。
|
||||
好奇感知、灰度认知、黑白决策、疯子行动。
|
||||
|
||||
![[Pasted image 20250220104206.png]]
|
||||
|
||||
第一段位:闭环
|
||||
第二段位:主动模式、自动模式灵活切换。“主动控制系统”管理、训练,达到一定的熟练程度,再交由“自动驾驶系统”接管。
|
||||
- 琐碎的日常决定交给自动模式。
|
||||
- 主动模式复盘。
|
||||
- 用主动模式模拟自动模式。
|
||||
第三段位:内控,认知飞轮
|
||||
第四段位:重启
|
||||
第五段位:增长
|
||||
第六段位:内核
|
||||
第七段位:复利
|
||||
第八段位:愿景
|
||||
第九段位:涌现
|
||||
|
||||
|
||||
很多人想拼命,但找不到拼命的地方
|
||||
|
||||
公司需要增长思维,个体也需要。对个体而言,最重要的增长不在于工资水平的增长,而在于能力的提升和社会网络的建立,以及在未来赚钱的能力的提高。
|
||||
|
||||
Why - 目的
|
||||
How - 方法
|
||||
What - 执行
|
||||
|
||||
|
||||
普通人:What^How — Why
|
||||
厉害的人:Why — How — What
|
||||
|
||||
|
||||
第一,成功学基本上是刻舟求剑,几乎毫无用处;
|
||||
第二,太深谋远虑并无益处;
|
||||
第三,定向培养几乎没有用处;
|
||||
第四,目的性太强不会帮助你接近目的地。
|
||||
|
||||
|
||||
花园里注定要长满花草树木,但你不知道哪颗种子会发芽,哪棵树会枝繁叶茂并挂满果实。你要做的不是追逐果实,而是当好自己的园丁。果实只是一个结果而已。
|
||||
|
||||
教练、老板、玩家
|
||||
配置层、资源层、专业层
|
||||
|
||||
时间权
|
||||
概率权
|
||||
@@ -0,0 +1,192 @@
|
||||
# 前言
|
||||
|
||||
在日常的开发中,我们经常能碰见服务端需要主动推送给客户端数据的业务场景,比如_数据大屏的实时数据_,比如_消息中心的未读消息_,比如_聊天功能_等等。
|
||||
|
||||
本文主要介绍SSE的使用场景和如何使用SSE。
|
||||
|
||||

|
||||
|
||||
# 服务端向客户端推送数据的实现方案有哪几种?
|
||||
|
||||
我们常规实现这些需求的方案有以下三种
|
||||
|
||||
1. 轮询
|
||||
2. websocket
|
||||
3. SSE
|
||||
|
||||
### 轮询简介
|
||||
|
||||
在很久很久以前,前端一般使用轮询来进行服务端向客户端进行消息的_伪推送_,为什么说轮询是伪推送?因为_轮询本质上还是通过客户端向服务端发起一个单项传输的请求_,服务端对这个请求做出响应而已。通过不断的请求来实现服务端向客户端推送数据的错觉。并不是服务端主动向客户端推送数据。显然,轮询一定是上述三个方法里最下策的决定。
|
||||
|
||||
**轮询的缺点:**
|
||||
|
||||
1. 首先轮询需要不断的发起请求,_每一个请求都需要经过http建立连接的流程_(比如三次握手,四次挥手),是没有必要的消耗。
|
||||
2. 客户端需要从页面被打开的那一刻开始就_一直处理请求_。虽然每次轮询的消耗不大,但是一直处理请求对于客户端来说一定是不友好的。
|
||||
3. _浏览器请求并发是有限制的_。比如Chrome 最大并发请求数目为 6,这个限制还有一个前提是针对同一域名的,超过这一限制的后续请求将会被阻塞。_而轮询意味着会有一个请求长时间的占用并发名额_。
|
||||
4. 而如果轮询时间较长,可能又_没有办法非常及时的获取数据_
|
||||
|
||||
### websocket简介
|
||||
|
||||
websocket是一个双向通讯的协议,他的优点是,可以同时支持客户端和服务端彼此相互进行通讯。功能上很强大。
|
||||
|
||||
缺点也很明显,websocket是一个新的协议,ws/wss。也就是说,支持http协议的浏览器不一定支持ws协议。
|
||||
|
||||
相较于SSE来说,websocket因为功能更强大。结构更复杂。所以相对比较_重_。
|
||||
|
||||
**websocket对于各大浏览器的兼容性↓** 
|
||||
|
||||
### SSE简介
|
||||
|
||||
sse是一个单向通讯的协议也是一个_长链接_,它只能支持服务端主动向客户端推送数据,但是无法让客户端向服务端推送消息。
|
||||
|
||||
复制代码
|
||||
|
||||
`长链接是一种HTTP/1.1的持久连接技术,它允许客户端和服务器在一次TCP连接上进行多个HTTP请求和响应,而不必为每个请求/响应建立和断开一个新的连接。长连接有助于减少服务器的负载和提高性能。`
|
||||
|
||||
SSE的优点是,它是一个轻量级的协议,相对于websockte来说,他的复杂度就没有那么高,_相对于客户端的消耗也比较少_。而且_SSE使用的是http协议_(websocket使用的是ws协议),也就是现有的服务端都支持SSE,无需像websocket一样需要服务端提供额外的支持。
|
||||
|
||||
注意:IE大魔王不支持SSE
|
||||
|
||||
**SSE对于各大浏览器的兼容性↓** 
|
||||
|
||||
注意哦,上图是SSE对于浏览器的兼容不是对于服务端的兼容。
|
||||
|
||||
# websocket和SSE有什么区别?
|
||||
|
||||
### 轮询
|
||||
|
||||
对于当前计算机的发展来说,几乎很少出现同时不支持websocket和sse的情况,所以轮询是在极端情况下浏览器实在是不支持websocket和see的下策。
|
||||
|
||||
### Websocket和SSE
|
||||
|
||||
我们一般的服务端和客户端的通讯基本上使用这两个方案。首先声明:这两个方案没有绝对的好坏,只有在不同的业务场景下更好的选择。
|
||||
|
||||
SSE的官方对于SSE和Websocket的评价是
|
||||
|
||||
1. WebSocket是全双工通道,可以双向通信,功能更强;SSE是单向通道,只能服务器向浏览器端发送。
|
||||
2. WebSocket是一个新的协议,需要服务器端支持;SSE则是部署在HTTP协议之上的,现有的服务器软件都支持。
|
||||
3. SSE是一个轻量级协议,相对简单;WebSocket是一种较重的协议,相对复杂。
|
||||
4. SSE默认支持断线重连,WebSocket则需要额外部署。
|
||||
5. SSE支持自定义发送的数据类型。
|
||||
|
||||
### Websocket和SSE分别适用于什么业务场景?
|
||||
|
||||
对于SSE来说,它的_优点就是轻_,而且对于服务端的支持度要更好。换言之,_可以使用SSE完成的功能需求,没有必要使用更重更复杂的websocket。_
|
||||
|
||||
比如:数据大屏的实时数据,消息中心的消息推送等一系列只需要服务端单方面推送而_不需要客户端同时进行反馈的需求_,SSE就是不二之选。
|
||||
|
||||
对于Websocket来说,_他的优点就是可以同时支持客户端和服务端的双向通讯_。所适用的业务场景:最典型的就是_聊天功能_。这种服务端需要主动向客户端推送信息,并且客户端也有向服务端推送消息的需求时,Websocket就是更好的选择。
|
||||
|
||||
# SSE有哪些主要的API?
|
||||
|
||||
js
|
||||
|
||||
复制代码
|
||||
|
||||
`建立一个SSE链接 :var source = new EventSource(url);`
|
||||
|
||||
#### SSE连接状态
|
||||
|
||||
**source.readyState**
|
||||
|
||||
- 0,相当于常量EventSource.CONNECTING,表示连接还未建立,或者连接断线。
|
||||
- 1,相当于常量EventSource.OPEN,表示连接已经建立,可以接受数据。
|
||||
- 2,相当于常量EventSource.CLOSED,表示连接已断,且不会重连。
|
||||
|
||||
#### SSE相关事件
|
||||
|
||||
- open事件(连接一旦建立,就会触发open事件,可以定义相应的回调函数)
|
||||
- message事件(收到数据就会触发message事件)
|
||||
- error事件(如果发生通信错误(比如连接中断),就会触发error事件)
|
||||
|
||||
#### 数据格式
|
||||
|
||||
js
|
||||
|
||||
复制代码
|
||||
|
||||
`Content-Type: text/event-stream //文本返回格式 Cache-Control: no-cache //不要缓存 Connection: keep-alive //长链接标识`
|
||||
|
||||

|
||||
|
||||
[SSE:相关文档,文档入口文档入口文档入口文档入口](https://link.juejin.cn?target=https%3A%2F%2Fwww.w3cschool.cn%2Fnwfchn%2Fwpi3cozt.html "https://www.w3cschool.cn/nwfchn/wpi3cozt.html")
|
||||
|
||||
显然,如果直接看api介绍不论是看这里还是看官网,大部分同学都是比较懵圈的状态,_那么我们写个demo来看一下?_
|
||||
|
||||

|
||||
|
||||
demo请看下方
|
||||
|
||||
我更建议您先把Demo跑起来,然后在看看上面这个[w3cschool的SSE文档](https://link.juejin.cn?target=https%3A%2F%2Fwww.w3cschool.cn%2Fnwfchn%2Fwpi3cozt.html "https://www.w3cschool.cn/nwfchn/wpi3cozt.html")。两个配合一起看,会更方便理解些。
|
||||
|
||||

|
||||
|
||||
# 如何实操一个SSE链接?Demo↓
|
||||
|
||||
这里Demo前端使用的就是最基本的html静态页面连接,没有使用任何框架。 后端选用语言是node,框架是Express。
|
||||
|
||||
理论上,把这两段端代码复制过去跑起来就直接可以用了。
|
||||
|
||||
1. 第一步,建立一个index.html文件,然后复制前端代码Demo到index.html文件中,打开文件
|
||||
2. 第二步,进入一个新的文件夹,建立一个index.js文件,然后将后端Demo代码复制进去,然后在该文件夹下执行
|
||||
|
||||
js
|
||||
|
||||
复制代码
|
||||
|
||||
`npm init //初始化npm npm i express //下载node express框架 node index //启动服务`
|
||||
|
||||

|
||||
|
||||
在这一层文件夹下执行命令。
|
||||
|
||||
完成以上操作就可以把项目跑起来了
|
||||
|
||||
### 前端代码Demo
|
||||
|
||||
js
|
||||
|
||||
复制代码
|
||||
|
||||
`<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta http-equiv="X-UA-Compatible" content="IE=edge"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <title>Document</title> </head> <body> <ul id="ul"> </ul> </body> <script> //生成li元素 function createLi(data){ let li = document.createElement("li"); li.innerHTML = String(data.message); return li; } //判断当前浏览器是否支持SSE let source = '' if (!!window.EventSource) { source = new EventSource('http://localhost:8088/sse/'); }else{ throw new Error("当前浏览器不支持SSE") } //对于建立链接的监听 source.onopen = function(event) { console.log(source.readyState); console.log("长连接打开"); }; //对服务端消息的监听 source.onmessage = function(event) { console.log(JSON.parse(event.data)); console.log("收到长连接信息"); let li = createLi(JSON.parse(event.data)); document.getElementById("ul").appendChild(li) }; //对断开链接的监听 source.onerror = function(event) { console.log(source.readyState); console.log("长连接中断"); }; </script> </html>`
|
||||
|
||||
### 后端代码Demo(node的express)
|
||||
|
||||
js
|
||||
|
||||
复制代码
|
||||
|
||||
``const express = require('express'); //引用框架 const app = express(); //创建服务 const port = 8088; //项目启动端口 //设置跨域访问 app.all("*", function(req, res, next) { //设置允许跨域的域名,*代表允许任意域名跨域 res.header("Access-Control-Allow-Origin", '*'); //允许的header类型 res.header("Access-Control-Allow-Headers", "Content-Type, Authorization, X-Requested-With"); //跨域允许的请求方式 res.header("Access-Control-Allow-Methods", "PUT,POST,GET,DELETE,OPTIONS"); // 可以带cookies res.header("Access-Control-Allow-Credentials", true); if (req.method == 'OPTIONS') { res.sendStatus(200); } else { next(); } }) app.get("/sse",(req,res) => { res.set({ 'Content-Type': 'text/event-stream', //设定数据类型 'Cache-Control': 'no-cache',// 长链接拒绝缓存 'Connection': 'keep-alive' //设置长链接 }); console.log("进入到长连接了") //持续返回数据 setInterval(() => { console.log("正在持续返回数据中ing") const data = { message: `Current time is ${new Date().toLocaleTimeString()}` }; res.write(`data: ${JSON.stringify(data)}\n\n`); }, 1000); }) //创建项目 app.listen(port, () => { console.log(`项目启动成功-http://localhost:${port}`) })``
|
||||
|
||||
### 效果
|
||||
|
||||

|
||||
|
||||
# 总结
|
||||
|
||||
1. SSE比websocket更轻
|
||||
2. SSE是基于http/https协议的
|
||||
3. websocket是一个新的协议,ws/wss协议
|
||||
4. 如果只需要服务端向客户端推送消息,推荐使用SSE
|
||||
5. 如果需要服务端和客户端双向推送,请选择websocket
|
||||
6. 不论是SSE还是websocket,对于浏览器的兼容性都不错
|
||||
7. 轮询是下策,很占用客户端资源,不建议使用。(不过偷懒的时候他确实方便)
|
||||
8. _IE不支持SSE_
|
||||
9. 小白同学demo如果跑不明白可以私信我
|
||||
|
||||
**对了,小程序不支持SSE哦**
|
||||
|
||||

|
||||
|
||||
### 最后
|
||||
|
||||
如果文章对您有帮助的话。
|
||||
|
||||

|
||||
|
||||
|
||||
|
||||
作者:工边页字
|
||||
链接:https://juejin.cn/post/7325730345840066612
|
||||
来源:稀土掘金
|
||||
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
|
||||
@@ -0,0 +1,5 @@
|
||||
lspci -n
|
||||
|
||||
1118 10ee:1117
|
||||
1308 1dab:7001
|
||||
1308 虚卡 8002
|
||||
@@ -0,0 +1 @@
|
||||
《人生算法》
|
||||
@@ -0,0 +1,15 @@
|
||||
### 生成主密钥
|
||||
点击生成主密钥 getMasterKey
|
||||
每个 ukey 调用 uKeySignAndKeyComponent,将返回值中的 ret.result.component 存储到 this.hashObj中,包含 this.hashObj.component1、this.hashObj.component2、this.hashObj.component3
|
||||
将 this.hashObj 写入到文件 mainkey.txt
|
||||
|
||||
|
||||
|
||||
### 恢复主密钥
|
||||
read 文件内容读取到 hash 变量中,格式是 json
|
||||
this.hash.component1, this.hash.component2, this.hash.component3 就是三个分量
|
||||
|
||||
ukey 内存储了 hash
|
||||
this.readObj111.hash,this.readObj222.hash,this.readObj333.hash
|
||||
|
||||
合并起来调用恢复主密钥接口
|
||||