vault backup: 2026-11-07 16:33:44
This commit is contained in:
 cheney
@@ -0,0 +1,69 @@
|
||||
Authenticated Encryption with Associated Data (AEAD) 是一种同时具备保密性,完整性和可认证性的加密形式。
|
||||
|
||||
AEAD 产生的原因很简单,单纯的对称加密算法,其解密步骤是无法确认密钥是否正确的。也就是说,加密后的数据可以用任何密钥执行解密运算,得到一组疑似原始数据,而不知道密钥是否是正确的,也不知道解密出来的原始数据是否正确。
|
||||
|
||||
因此,需要在单纯的加密算法之上,加上一层验证手段,来确认解密步骤是否正确。
|
||||
|
||||
简单地把加密算法和认证算法组合,可以实现上述目的,并由此产生了几个方案:
|
||||
|
||||
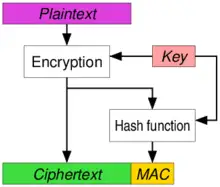
**第一种方案,EtM (Encryption then MAC)**
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
_图片来自_ _[https://en.wikipedia.org/wiki/Authenticated_encryption](https://link.zhihu.com/?target=https%3A//en.wikipedia.org/wiki/Authenticated_encryption)_
|
||||
|
||||
先加密,然后对密文进行 MAC 运算(一般用各种 HMAC),把二者拼接起来,发给接收方。
|
||||
|
||||
接收方先验证 MAC,如果验证通过,则证明密钥是正确的,然后执行解密运算。
|
||||
|
||||
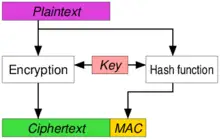
**第二种方案,E&M (Encryption and MAC)**
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
_图片来自_ _[https://en.wikipedia.org/wiki/Authenticated_encryption](https://link.zhihu.com/?target=https%3A//en.wikipedia.org/wiki/Authenticated_encryption)_
|
||||
|
||||
同时对原始数据执行加密和 MAC 运算,把二者拼接起来,发给接收方。
|
||||
|
||||
接收方先进行解密,然后对解密结果执行 MAC 运算,比对发来的 MAC,验证正确性。
|
||||
|
||||
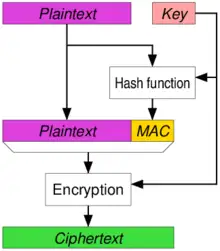
**第三种方案,MtE (MAC then Encryption)**
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
_图片来自_ _[https://en.wikipedia.org/wiki/Authenticated_encryption](https://link.zhihu.com/?target=https%3A//en.wikipedia.org/wiki/Authenticated_encryption)_
|
||||
|
||||
与 EtM 相反,先对原始数据执行 MAC 运算,与原始数据拼接后,执行加密算法,将密文发送给接收方。
|
||||
|
||||
接受方先进行解密,然后执行 MAC 运算,验证解密结果是否正确。
|
||||
|
||||
**然而,业内逐渐意识到以上通过组合加密和认证算法来实现 AEAD 的方案都是有安全问题的。**
|
||||
|
||||
具体安全问题细节略去不表。
|
||||
|
||||
**从 2008 年起,业内开始提出,需要在一个算法在内部同时实现加密和认证**
|
||||
|
||||
基于这个思想,一些新的算法被提出,这些算法被称为真正的 AEAD 算法。
|
||||
|
||||
常见的 AEAD 算法如下:
|
||||
|
||||
- AES-128-GCM
|
||||
- AES-192-GCM
|
||||
- AES-256-GCM
|
||||
- ChaCha20-IETF-Poly1305
|
||||
- XChaCha20-IETF-Poly1305
|
||||
|
||||
在具备 AES 加速的 CPU(桌面,服务器)上,建议使用 AES-XXX-GCM 系列,移动设备建议使用 ChaCha20-IETF-Poly1305 系列。
|
||||
|
||||
在设计加密系统的时候,请务必选用 AEAD 算法,抛弃旧的 MtE,EtM,E&M 方案。
|
||||
@@ -0,0 +1,315 @@
|
||||
好的,这是一个非常专业且重要的问题。RSA 的 PKCS#5 填充和 PSS 填充是两种完全不同的方案,用于不同的场景,其核心区别在于**安全性**和**设计目的**。
|
||||
|
||||
首先,需要纠正一个常见的术语混淆:
|
||||
* **PKCS#5** 原本是为基于口令的加密(Password-Based Encryption)设计的,主要用于对称加密算法(如 DES)。当人们谈论 RSA 的“PKCS#5 填充”时,通常指的是 **PKCS#1 v1.5** 填充方案。这是一个历史遗留的误称,但已经非常普遍。
|
||||
|
||||
因此,我们接下来的对比实际上是 **PKCS#1 v1.5** 与 **PSS** 的对比。
|
||||
|
||||
---
|
||||
|
||||
### 核心区别概览
|
||||
|
||||
| 特性 | PKCS#1 v1.5 (常被误称为 PKCS#5) | PSS (Probabilistic Signature Scheme) |
|
||||
| :--- | :--- | :--- |
|
||||
| **主要用途** | **加密** 和 **签名** | **仅用于签名** |
|
||||
| **设计哲学** | 确定性 / 旧标准 | 概率性 / 新一代安全标准 |
|
||||
| **安全性可证明性** | **不可证明**。存在已知的理论攻击(如自适应选择密文攻击),但在实践中可通过其他方式缓解。 | **可证明安全**。在随机预言机模型下,其安全性可以归约到解决 RSA 问题的困难性上。 |
|
||||
| **随机性** | **确定性**(对于签名)。相同的消息和密钥总是产生相同的签名。 | **概率性**。每次对**同一消息**签名都会产生**不同的签名结果**,因为它引入了随机数(盐)。 |
|
||||
| **结构** | 格式固定,相对简单。 | 结构更复杂,使用掩码生成函数(MGF)和随机盐。 |
|
||||
| **抗攻击性** | 较弱。容易受到如 Bleichenbacher 攻击等,需要额外的防护措施。 | 更强。随机盐的引入使其能有效抵抗多种攻击,尤其是选择明文攻击。 |
|
||||
| **应用场景** | 旧系统、兼容性要求高的场景、TLS 1.2 及更早版本的 RSA 密钥交换。 | **新系统的首选**。TLS 1.3、现代密码学库(如 OpenSSL, Bouncy Castle)的默认推荐。 |
|
||||
|
||||
---
|
||||
|
||||
### 深入解析
|
||||
|
||||
#### 1. PKCS#1 v1.5 填充(用于签名)
|
||||
|
||||
这是一种确定性的填充方案。
|
||||
|
||||
* **过程**:
|
||||
1. 对消息 `M` 进行哈希(如 SHA-256),得到哈希值 `H(M)`。
|
||||
2. 构建一个特定的 **ASN.1** 数据结构,其中包含了哈希算法的标识符和哈希值 `H(M)`。这是为了确保签名和验证双方使用相同的哈希算法。
|
||||
3. 将这个数据结构填充到与 RSA 模数 `n` 长度相同的块。填充方式是固定的:`0x00 0x01 0xff 0xff ... 0xff 0x00 || ASN.1 || H(M)`。
|
||||
4. 对这个填充后的块进行 RSA 私钥运算(即 `s = pad(m)^d mod n`),生成签名 `s`。
|
||||
|
||||
* **缺点**:
|
||||
* **确定性**:相同的消息总是产生相同的签名,这为攻击者进行暴力破解或分析提供了便利。
|
||||
* **格式固定**:攻击者可以提交大量精心构造的报文给签名者进行签名,如果签名服务器没有严格验证解包后的结构格式,就可能泄露私钥信息。著名的 **Bleichenbacher 攻击** 就是利用了这个弱点。
|
||||
|
||||
#### 2. PSS (Probabilistic Signature Scheme) 填充
|
||||
|
||||
这是一种概率性的、更安全的填充方案。
|
||||
|
||||
* **过程**(简化版):
|
||||
1. 对消息 `M` 进行哈希,得到 `H(M)`。
|
||||
2. 生成一个随机数 **salt**(盐)。
|
||||
3. 将盐和消息哈希值一起进行哈希等运算,过程涉及掩码生成函数(MGF),最终构造一个复杂的、随机的待签名块。
|
||||
4. 对这个随机的块进行 RSA 私钥运算,生成签名 `s`。**由于盐是随机的,所以每次签名结果都不同。**
|
||||
|
||||
* **优点**:
|
||||
* **安全性可证明**:数学上可以证明,破解 PSS 的难度等同于破解 RSA 基础问题本身。
|
||||
* **随机性**:有效防止攻击者通过收集签名来分析私钥。
|
||||
* **增强的冗余**:复杂的结构使得任何对签名或消息的篡改都极难通过验证。
|
||||
|
||||
---
|
||||
|
||||
### 总结与建议
|
||||
|
||||
| 方面 | PKCS#1 v1.5 | PSS |
|
||||
| :--- | :--- | :--- |
|
||||
| **安全性** | 较低,有已知风险 | **高,是现代标准** |
|
||||
| **性能** | 稍快(因为计算简单) | 稍慢(因为引入了MGF和随机数生成) |
|
||||
| **兼容性** | **极高**,所有系统都支持 | 较好,现代系统和标准(如 TLS 1.3)都支持 |
|
||||
| **你应该选择?** | **仅在需要与旧系统保持兼容时使用**。 | **在任何新项目或系统中,只要允许,就应优先使用 PSS 进行签名。** |
|
||||
|
||||
**重要提示:** 以上讨论主要围绕**签名**。对于 RSA **加密**,同样有对应的填充方案:
|
||||
* RSA 加密的旧标准叫 **PKCS#1 v1.5 加密填充**。
|
||||
* RSA 加密的新、更安全的标准叫 **OAEP (Optimal Asymmetric Encryption Padding)**。
|
||||
* **PSS 只用于签名,不能用于加密。OAEP 用于加密,不能用于签名。**
|
||||
|
||||
所以,完整的现代最佳实践是:
|
||||
* **RSA 签名**:使用 **RSA-PSS**。
|
||||
* **RSA 加密**:使用 **RSA-OAEP**。
|
||||
|
||||
|
||||
|
||||
非常好的问题!这正是 RSA-PSS 设计中最精妙和关键的部分。
|
||||
|
||||
简单直接的答案是:**Salt 值不需要单独存放或传输。它被“捆绑”并隐藏在最终的签名值中,验证方可以通过解码和计算过程将其恢复出来。**
|
||||
|
||||
下面我们来详细拆解这个过程。
|
||||
|
||||
### 1. PSS 签名的生成过程(含 Salt)
|
||||
|
||||
首先,我们回顾一下签名方是如何生成 PSS 签名的。这个过程会清楚地展示 Salt 是如何被使用的。
|
||||
|
||||
假设我们有:
|
||||
* 消息:`M`
|
||||
* 哈希函数:`Hash` (如 SHA-256)
|
||||
* 掩码生成函数:`MGF` (通常使用相同的哈希函数)
|
||||
* RSA 模数长度:`k` 字节 (例如 2048 位 = 256 字节)
|
||||
* Salt 长度:`sLen` (通常等于哈希输出的长度,例如 SHA-256 则为 32 字节)
|
||||
|
||||
**签名步骤:**
|
||||
|
||||
1. **生成 Salt**:随机生成一个长度为 `sLen` 的盐值 `salt`。
|
||||
2. **第一次哈希**:计算消息 `M` 的哈希值 `mHash = Hash(M)`。
|
||||
3. **构造数据块 (DB)**:
|
||||
* 创建一个由固定填充位、哈希算法标识和 Salt 组成的数据块。
|
||||
* 结构为:`PS | 0x01 | salt`
|
||||
* `PS` 是一串 `0x00` 填充字节,其长度使得整个数据块 (DB) 加上其他部分恰好是 `k` 字节。
|
||||
* `0x01` 是一个固定的分隔符。
|
||||
4. **计算 MGF 的输入**:
|
||||
* 构造一个哈希块 `H`,通常为:`H = 0x00 | mHash | salt`
|
||||
* (注:实际标准格式为 `H = Hash(0x00 | mHash | salt)`,这里为简化理解,描述其核心思想)。
|
||||
5. **应用掩码**:
|
||||
* 使用 MGF 函数,以 `H` 为种子,生成一个与数据块 (DB) 长度相同的伪随机掩码 `dbMask`。
|
||||
* 将数据块 (DB) 与这个掩码进行异或 (XOR) 操作,得到**掩码后的数据块 `maskedDB`**。`maskedDB = DB XOR dbMask`
|
||||
* 这一步是核心,它用随机数(由 `H` 衍生)将 Salt 和固定填充位“加密”或“随机化”了。
|
||||
6. **形成待签名的编码消息 (EM)**:
|
||||
* 将 `maskedDB`、`H` 和固定的尾部填充拼接在一起,形成一个长度为 `k` 字节的编码消息 `EM`。
|
||||
* 结构:`EM = maskedDB | H | 0xbc` (其中 `0xbc` 是一个固定的尾部标记)
|
||||
7. **RSA 运算**:
|
||||
* 将 `EM` 作为一个大整数,使用 RSA 的**私钥**对其进行签名运算(即 `s = EM^d mod n`),得到最终的签名值 `s`。
|
||||
|
||||
**关键点:** Salt `s` 并没有被直接加密,而是被作为构造 `EM` 的一部分。整个 `EM` 被 RSA 私钥加密后,Salt 就被完美地“隐藏”在了最终的签名值 `s` 之中。
|
||||
|
||||
---
|
||||
|
||||
### 2. PSS 验证过程(如何恢复 Salt)
|
||||
|
||||
验证方持有:消息 `M`、签名 `s`、以及发送方的 RSA **公钥**。
|
||||
|
||||
**验证步骤:**
|
||||
|
||||
1. **RSA 解密**:
|
||||
* 使用 RSA 的**公钥**对签名 `s` 进行“解密”运算(即 `EM' = s^e mod n`)。
|
||||
* 如果签名有效,恢复出的编码消息 `EM'` 应该和签名时生成的 `EM` 完全相同。
|
||||
|
||||
2. **解析 EM‘**:
|
||||
* 将 `EM‘` 按照约定的格式拆解,得到 `maskedDB‘`、`H’` 和尾部标记 `0xbc`。
|
||||
|
||||
3. **恢复数据块 (DB)**:
|
||||
* 这是最巧妙的一步。验证方现在有 `H‘`,但它需要 `DB` 来计算 Salt。
|
||||
* 它使用和签名方完全相同的 MGF 函数,以 `H’` 为种子,生成相同的掩码 `dbMask`。
|
||||
* 将 `maskedDB‘` 与 `dbMask` 进行异或 (XOR) 操作,即可**还原出原始的数据块 `DB‘**。
|
||||
`DB’ = maskedDB‘ XOR MGF(H’, length_of_maskedDB)`
|
||||
|
||||
4. **解析 DB’ 并提取 Salt**:
|
||||
* 解析 `DB‘` 的结构。它应该由一串 `0x00` 字节、一个 `0x01` 的分隔符和最后的 `sLen` 字节的 Salt 组成。
|
||||
* 验证方直接从这个还原出的 `DB’` 中**提取出最后 `sLen` 字节,这就是 Salt 值 `salt‘`**。
|
||||
|
||||
5. **重建与验证**:
|
||||
* 验证方自己计算消息 `M` 的哈希 `mHash = Hash(M)`。
|
||||
* 它使用刚提取的 `salt‘` 和计算出的 `mHash`,按照签名步骤 3 和 4 的方法,重建出哈希块 `H’’`。
|
||||
* **最终检查**:比较自己计算出的 `H’’` 和从 `EM’` 中解析出来的 `H‘` 是否完全相同。
|
||||
* 如果两者一致,并且所有填充格式都正确,则签名验证通过。否则,失败。
|
||||
|
||||
### 总结与图示
|
||||
|
||||
**Salt 的流向可以概括为:**
|
||||
`salt` -> `DB` -> `maskedDB` -> `EM` -> `s` (签名值)
|
||||
|
||||
**验证时 Salt 的恢复路径为:**
|
||||
`s` (签名值) -> `EM‘` -> `maskedDB‘` -> (`maskedDB‘` XOR `MGF(H’)`) -> `DB‘` -> `salt‘`
|
||||
|
||||
**这种设计的巨大优势:**
|
||||
|
||||
1. **无需传输 Salt**:Salt 是自包含在签名中的,不需要额外的通信开销。
|
||||
2. **安全性**:攻击者无法从签名 `s` 或 `maskedDB` 中直接看到或猜出 Salt,因为它被 MGF 生成的掩码保护着。只有能正确“解密”(即通过 XOR 操作)出 `DB` 的人才能得到 Salt,而这个操作需要正确的 `H‘`,这又依赖于原始消息 `M` 的正确性。
|
||||
3. **确定性验证**:尽管签名本身是概率性的(每次不同),但验证过程是确定性的。对于给定的 `(M, s)`,验证结果总是确定的。
|
||||
|
||||
希望这个详细的解释能帮助你彻底理解 PSS 中 Salt 的精妙之处!
|
||||
|
||||
|
||||
好的,我们来深入探讨一下 RSA-OAEP(Optimal Asymmetric Encryption Padding,最优非对称加密填充)。它是一种用于 RSA 加密的、可证明安全的填充方案,旨在取代不安全的 PKCS#1 v1.5 加密填充。
|
||||
|
||||
### 核心设计思想
|
||||
|
||||
OAEP 的设计灵感来自于 Feistel 网络,其核心思想是:
|
||||
1. **概率性加密**:通过引入随机数,使得每次加密相同消息都会产生完全不同的密文。
|
||||
2. **增强安全性**:其安全性在“随机预言机模型”下可以被证明(即破解它的难度等同于解决 RSA 难题本身)。
|
||||
3. **防止攻击**:特别能够抵抗针对 PKCS#1 v1.5 的 **Bleichenbacher 选择密文攻击**。
|
||||
|
||||
---
|
||||
|
||||
### RSA-OAEP 的结构与加密过程
|
||||
|
||||
OAEP 的加密过程就是构建一个特殊的、结构化的、待加密的“消息块”的过程。我们假设 RSA 的模数 `n` 的长度为 `k` 字节(例如,2048 位 = 256 字节)。
|
||||
|
||||
**输入:**
|
||||
* 原始消息 `M`
|
||||
* 一个可选的标签 `L`(通常为空字符串,可以用于绑定特定上下文)
|
||||
* 一个随机数生成器
|
||||
* 两个哈希函数(通常为 `Hash` 和 `MGF`,MGF 是掩码生成函数,通常由另一个哈希函数构成)
|
||||
|
||||
**步骤:**
|
||||
|
||||
1. **参数与长度检查**:
|
||||
* 消息 `M` 不能太长。其最大长度受限于 `k - 2*hLen - 2`,其中 `hLen` 是哈希函数的输出长度(例如 SHA-256 则为 32 字节)。这为随机数和固定填充预留了空间。
|
||||
|
||||
2. **生成随机数**:
|
||||
* 生成一个长度为 `hLen` 的随机字节串 `seed`(种子)。这是概率性的来源。
|
||||
|
||||
3. **构造数据块 DB**:
|
||||
* 数据块 `DB` 由三部分拼接而成:
|
||||
`DB = lHash | PS | 0x01 | M`
|
||||
* **lHash**:对可选标签 `L` 进行哈希计算得到的值 `Hash(L)`。如果 `L` 为空,这就是 `Hash("")`,一个固定值。它的主要作用是让接收方可以验证上下文的一致性。
|
||||
* **PS**:一串 `0x00` 字节,作为填充位。其长度使得整个 `DB` 的长度为 `k - hLen - 1` 字节。
|
||||
* **0x01**:一个固定的分隔符,用于区分填充位和真实消息。
|
||||
* **M**:原始消息。
|
||||
|
||||
4. **应用掩码(Masking)**:
|
||||
* 这是 OAEP 最核心、最精妙的一步,它使用了掩码生成函数 `MGF`。
|
||||
* **用 seed 掩码 DB**:使用 MGF 函数,以 `seed` 为输入,生成一个与 `DB` 等长的掩码 `dbMask`。
|
||||
`dbMask = MGF(seed, length_of_DB)`
|
||||
* 将 `DB` 与 `dbMask` 进行异或操作,得到**掩码后的数据块 `maskedDB`**。
|
||||
`maskedDB = DB XOR dbMask`
|
||||
* 现在,`DB` 中的消息 `M` 已经被随机化了。
|
||||
|
||||
5. **掩码 seed**:
|
||||
* 接下来,再用 `maskedDB` 去掩码 `seed`,完成一种“双向绑定”。
|
||||
* 使用 MGF 函数,以 `maskedDB` 为输入,生成一个与 `seed` 等长(`hLen`)的掩码 `seedMask`。
|
||||
`seedMask = MGF(maskedDB, hLen)`
|
||||
* 将 `seed` 与 `seedMask` 进行异或操作,得到**掩码后的种子 `maskedSeed`**。
|
||||
`maskedSeed = seed XOR seedMask`
|
||||
|
||||
6. **形成编码消息 (EM)**:
|
||||
* 将处理后的各部分拼接起来,形成一个长度为 `k` 字节的、结构化的待加密块。
|
||||
`EM = 0x00 | maskedSeed | maskedDB`
|
||||
* **0x00**:一个前导零,有助于确保整个 `EM` 表示的数值小于 RSA 模数 `n`。
|
||||
|
||||
7. **RSA 加密**:
|
||||
* 将 `EM` 视为一个大整数。
|
||||
* 使用 RSA 的**公钥** `(e, n)` 对其进行加密计算,得到最终的密文 `c`。
|
||||
`c = EM^e mod n`
|
||||
|
||||
**整个过程可以用下图直观表示(这是一个非常重要的概念图):**
|
||||
|
||||
```mermaid
|
||||
flowchart TD
|
||||
subgraph Inputs [输入]
|
||||
direction LR
|
||||
M[消息 M]
|
||||
L[标签 L<br>通常为空]
|
||||
RNG[[随机数生成器]]
|
||||
end
|
||||
|
||||
RNG -- 生成 --> seed[随机种子 seed<br>长度 hLen]
|
||||
L -- 哈希 --> lHash[lHash = Hash(L)<br>长度 hLen]
|
||||
|
||||
subgraph Construction [构造数据块 DB]
|
||||
direction LR
|
||||
lHash
|
||||
PS[填充串 PS<br>全零字节]
|
||||
Delim[分隔符 0x01]
|
||||
M
|
||||
Construction_Output[DB = lHash | PS | 0x01 | M]
|
||||
end
|
||||
|
||||
seed -- MGF1 --> dbMask[dbMask = MGF(seed, len(DB))]
|
||||
Construction_Output -- XOR --> maskedDB[maskedDB = DB XOR dbMask]
|
||||
|
||||
maskedDB -- MGF1 --> seedMask[seedMask = MGF(maskedDB, hLen)]
|
||||
seed -- XOR --> maskedSeed[maskedSeed = seed XOR seedMask]
|
||||
|
||||
maskedSeed --> EM[编码消息 EM]
|
||||
maskedDB --> EM
|
||||
EM --> Final[EM = 0x00 | maskedSeed | maskedDB]
|
||||
|
||||
Final -- 转换为整数 --> RSA[RSA公钥加密<br>c = EM<sup>e</sup> mod n]
|
||||
RSA --> Ciphertext[输出密文 c]
|
||||
```
|
||||
|
||||
---
|
||||
|
||||
### RSA-OAEP 的解密与验证过程
|
||||
|
||||
解密是加密的逆过程,其核心是**恢复并验证 `EM` 的结构**。
|
||||
|
||||
**输入:** 密文 `c`,私钥 `(d, n)`,标签 `L`(必须与加密时相同,通常为空)。
|
||||
|
||||
**步骤:**
|
||||
|
||||
1. **RSA 解密**:
|
||||
* 使用 RSA 的**私钥** `(d, n)` 对密文 `c` 进行解密,得到一个大整数。
|
||||
* 将这个整数转换为长度为 `k` 字节的字节串,即恢复出编码消息 `EM`。
|
||||
* 如果解密失败或 `EM` 的长度不为 `k`,则立即中止并返回错误。
|
||||
|
||||
2. **解析 EM**:
|
||||
* 按照结构解析 `EM`:`EM = 0x00 | maskedSeed | maskedDB`
|
||||
* 检查第一个字节是否为 `0x00`,如果不是,则说明密文无效,中止。
|
||||
|
||||
3. **恢复 seed**:
|
||||
* 从 `EM` 中取出 `maskedSeed`(前 `hLen` 字节)和 `maskedDB`(剩余部分)。
|
||||
* 计算 `seedMask`:`seedMask = MGF(maskedDB, hLen)`
|
||||
* 恢复出随机种子 `seed`:`seed = maskedSeed XOR seedMask`
|
||||
|
||||
4. **恢复数据块 DB**:
|
||||
* 计算 `dbMask`:`dbMask = MGF(seed, length_of_maskedDB)`
|
||||
* 恢复出数据块 `DB`:`DB = maskedDB XOR dbMask`
|
||||
|
||||
5. **解析和验证 DB**:
|
||||
* 这是**最关键的安全检查步骤**。
|
||||
* 将 `DB` 解析为:`lHash' | PS | 0x01 | M'`
|
||||
* **验证**:
|
||||
a. 计算 `Hash(L)`,与解析出的 `lHash‘` 比较,必须完全相同。
|
||||
b. 检查填充串 `PS` 是否全部由 `0x00` 字节组成。
|
||||
c. 检查 `0x01` 这个分隔符是否存在。
|
||||
* 如果以上任何一项检查失败,**不应返回解密出的消息 `M‘`,而应返回一个通用的“解密错误”**。这是为了防止攻击者通过错误信息进行侧信道攻击(就像 Bleichenbacher 攻击那样)。
|
||||
|
||||
6. **输出明文**:
|
||||
* 只有所有验证都通过,才输出解析出的消息 `M‘` 作为原始明文 `M`。
|
||||
|
||||
### 总结与特点
|
||||
|
||||
| 特性 | 说明 |
|
||||
| :--- | :--- |
|
||||
| **安全性** | **可证明安全**,抵抗选择密文攻击(CCA2)。是现代应用的首选。 |
|
||||
| **随机性** | **概率性加密**,依赖随机数 `seed`,相同明文每次加密产生不同密文。 |
|
||||
| **结构验证** | 解密时进行严格的格式验证(`lHash`,`PS`,`0x01`),任何无效输入都会导致失败,且不会返回任何具体错误信息。 |
|
||||
| **错误处理** | 必须**以一种“无信息”的方式失败**,不泄露任何关于失败原因的具体细节,这是其安全性的重要组成部分。 |
|
||||
| **应用** | TLS 1.3 中 RSA 加密的唯一指定方式。现代密码学库(如 OpenSSL, .NET, Java)的默认或推荐选项。 |
|
||||
|
||||
简单来说,OAEP 通过引入随机数和两次掩码操作(MGF),将消息、随机数和固定哈希值“混合”成一个结构化的、随机化的整体,再交给 RSA 加密。解密方则通过反向操作和严格的格式检查来确保密文的完整性和真实性,任何篡改都会被检测并导致解密失败。这种设计使其极其安全。
|
||||
@@ -0,0 +1,146 @@
|
||||
RSA 算法是一种非对称加密算法。加密密钥(即公开密钥)PK 是公开信息,而解密密钥(即秘密密钥)SK是需要保密的。而加密算法 E 和解密算法 D 也都是公开的。虽然解密密钥 SK 是由公开密钥 PK 决定的,但却不能根据 PK 计算出 SK 。
|
||||
|
||||
根据数论,寻求两个大素数比较简单,而将它们的乘积进行因式分解却极其困难,因此可以将乘积公开作为加密密钥称作公钥。如果公钥加密的信息只有私钥解得开,那么只要私钥不泄漏,通信就是安全的。
|
||||
|
||||
|
||||
#### 数学知识
|
||||
|
||||
> **公因子**
|
||||
> 一个数学概念,指的是能同时整除几个整数的整数,可以用辗转相除法算出。
|
||||
|
||||
|
||||
**质数(素数)**
|
||||
|
||||
>一个大于1的自然数,除了1和它自身外,不能被其他自然数整除的数叫做质数;否则称为合数(规定1既不是质数也不是合数)。
|
||||
|
||||
|
||||
**互质关系**
|
||||
|
||||
> 如果两个正整数,除了1以外,没有其他公因子,我们就称这两个数是互质关系(coprime)。比如,15和32没有公因子,所以它们是互质关系。 两个合数存在互质关系吗?例如 15,44 也没有公因子,这说明不是质数也可以构成互质关系。
|
||||
|
||||
**互质关系结论**
|
||||
_1. 任意两个质数构成互质关系,比如 13 和 61。_
|
||||
_2. 一个数是质数,另一个数只要不是前者的倍数,两者就构成互质关系,比如3和10。_
|
||||
_3. 如果两个数之中,较大的那个数是质数,则两者构成互质关系,比如97和57。_
|
||||
_4. 1和任意一个自然数是都是互质关系,比如1和99。_
|
||||
_5. p是大于1的整数,则 p和 p-1 构成互质关系,比如57和56。_
|
||||
_6. p是大于1的奇数,则 p和 p-2 构成互质关系,比如17和15。_
|
||||
|
||||
**欧拉函数**
|
||||
请思考以下问题:
|
||||
|
||||
>任意给定正整数n,请问在小于等于 n 的正整数之中,有多少个与n构成互质关系?(比如,在1到8之中,有多少个数与8构成互质关系?)
|
||||
|
||||
计算这个值的方法就叫做[欧拉函数](https://zh.wikipedia.org/wiki/%E6%AC%A7%E6%8B%89%E5%87%BD%E6%95%B0),以φ(n)表示。在1到8之中,与8形成互质关系的是1、3、5、7,所以 φ(n) = 4。
|
||||
|
||||
φ(n) 的计算方法并不复杂,但是为了得到最后那个公式,需要一步步讨论。
|
||||
|
||||
**第一种情况**
|
||||
|
||||
如果n=1,则 φ(1) = 1 。因为1与任何数(包括自身)都构成互质关系。
|
||||
|
||||
**第二种情况**
|
||||
|
||||
如果n是质数,则 φ(n)=n-1 。因为质数与小于它的每一个数,都构成互质关系。比如5与1、2、3、4都构成互质关系。
|
||||
|
||||
**第三种情况**
|
||||
|
||||
如果n是质数的某一个次方,即 n = p^k (p为质数,k为大于等于1的整数),则
|
||||
|
||||
$$ \phi (\sideset{}{^k}p)=\sideset{}{^k}p-\sideset{}{^{k-1}}p $$
|
||||
|
||||
比如 φ(8) = φ(2^3) =2^3 - 2^2 = 8 - 4 = 4。
|
||||
|
||||
这是因为只有当一个数不包含质数p,才可能与n互质。而包含质数p的数一共有p^(k-1)个,即1×p、2×p、3×p、...、p^(k-1)×p,把它们去除,剩下的就是与n互质的数。
|
||||
|
||||
上面的式子还可以写成下面的形式:
|
||||
|
||||
$$ \phi (\sideset{}{^k}p)=\sideset{}{^k}p-\sideset{}{^{k-1}}p = \sideset{}{^k}p(1-\frac{1}{p} )$$
|
||||
|
||||
|
||||
**第四种情况**
|
||||
如果n可以分解成两个互质的整数之积,
|
||||
|
||||
> n = p1 × p2
|
||||
|
||||
则
|
||||
|
||||
> φ(n) = φ(p1p2) = φ(p1)φ(p2)
|
||||
|
||||
即积的欧拉函数等于各个因子的欧拉函数之积。比如,φ(56)=φ(8×7)=φ(8)×φ(7)=4×6=24。
|
||||
|
||||
这一条的证明要用到["中国剩余定理"](https://en.wikipedia.org/wiki/Chinese_remainder_theorem),思路:如果a与p1互质(a<p1),b与p2互质(b<p2),c与p1p2互质(c<p1p2),则c与数对 (a,b) 是一一对应关系。由于a的值有φ(p1)种可能,b的值有φ(p2)种可能,则数对 (a,b) 有φ(p1)φ(p2)种可能,而c的值有φ(p1p2)种可能,所以φ(p1p2)就等于φ(p1)φ(p2)。
|
||||
|
||||
|
||||
**第五种情况**
|
||||
因为任意一个大于 1 的正整数,都可以写成一系列质数的积。
|
||||
$$ n=\sideset{}{_1^{k1}}p\sideset{}{_2^{k2}}p...\sideset{}{_r^{kr}}p $$
|
||||
根据第4条的结论,得到
|
||||
$$ \phi(n)=\phi(\sideset{}{_1^{k1}}p)\phi(\sideset{}{_2^{k2}}p)...\phi(\sideset{}{_r^{kr}}p) $$
|
||||
再根据第3条的结论,得到
|
||||
$$ \phi(n)=\sideset{}{_1^{k1}}p\sideset{}{_2^{k2}}p...\sideset{}{_r^{kr}}p(1-\frac{1}{\sideset{}{_1}p})(1-\frac{1}{\sideset{}{_2}p})(1-\frac{1}{\sideset{}{_r}p}) $$
|
||||
也就等于
|
||||
|
||||
$$ \phi(n)=n(1-\frac{1}{\sideset{}{_1}p})(1-\frac{1}{\sideset{}{_2}p})(1-\frac{1}{\sideset{}{_r}p}) $$
|
||||
这就是欧拉函数的通用公式。例如计算 1323 在小于等于 1323 的正整数之中,有多少个与 n 构成互质关系?带入公式得到 756。真太神奇了。
|
||||
|
||||
|
||||
**欧拉定理**
|
||||
欧拉函数的用处,就在于欧拉定理。欧拉定理指的是:如果两个正整数a和n互质,则n的欧拉函数 φ(n) 可以让下面的等式成立:
|
||||
|
||||
$$ \sideset{}{^{\phi(n)}}a\equiv 1 (\bmod n ) $$
|
||||
|
||||
也就是说,a 的 φ(n) 次方被 n 除的余数为1。或者说,a的φ(n)次方减去1,可以被n整除。比如,3和7互质,而7的欧拉函数φ(7)等于6,所以3的6次方(729)减去1,可以被7整除(728/7=104)。
|
||||
|
||||
欧拉定理的证明比较复杂,无力证明,只要记住它的结论就行了。
|
||||
|
||||
欧拉定理可以大大简化某些运算。比如,7和10互质,根据欧拉定理有: $$ \sideset{}{^{\phi(10)}}7\equiv 1 (\bmod 10 ) $$
|
||||
已知 φ(10) 等于4,所以马上得到 7 的 4 倍数次方的个位数肯定是 1。
|
||||
|
||||
|
||||
|
||||
**模反元素**
|
||||
|
||||
如果两个正整数a和n互质,那么一定可以找到整数b,使得 ab-1 被n整除,或者说ab被n除的余数是1。
|
||||
|
||||
$$ ab \equiv 1 (\bmod n ) $$
|
||||
|
||||
这时,b就叫做a的["模反元素"](https://zh.wikipedia.org/wiki/%E6%A8%A1%E5%8F%8D%E5%85%83%E7%B4%A0)。
|
||||
|
||||
比如,3和11互质,那么3的模反元素就是4,因为 (3 × 4)-1 可以被11整除。显然,模反元素不止一个, 4加减11的整数倍都是3的模反元素 {...,-18,-7,4,15,26,...},即如果b是a的模反元素,则 b+kn 都是a的模反元素。
|
||||
|
||||
|
||||
|
||||
### **RSA原理**
|
||||
|
||||
**密钥生成过程**
|
||||
|
||||
|步骤|概述|公式|说明|
|
||||
|---|---|---|---|
|
||||
|1|随机p,q|p,q |选择一对不相等且足够大的质数 |
|
||||
|2|求n|n = p\*q |计算质数p,q的乘积 |
|
||||
|3|求φ(n) |φ(n) = (p-1)(q-1) |计算 n 的欧拉函数|
|
||||
|4|求e|1 < e < φ(n)|选一个和 φ(n) 互质的整数e|
|
||||
|5|求d|ed = 1 (mod φ(n))|计算出e对于φ(n)的模反元素d|
|
||||
|6|公钥 |e,n|PK(e, n) |
|
||||
|7|私钥 |d,n |SK(d, n)|
|
||||
|
||||
|
||||
|
||||
**第一步:随机 p,q**
|
||||
p,q 为不相等且足够大的质数。
|
||||
|
||||
**第二步:求n**
|
||||
|
||||
n 的长度就是密钥长度。例如:n = p * q = 11 * 3 = 33;
|
||||
|
||||
33 写成二进制是100001,一共有6位,所以这个密钥就是6位。实际应用中,RSA密钥一般是1024位,重要场合则为2048位。
|
||||
|
||||
|
||||
**第三步:求 n 的欧拉函数φ(n)**
|
||||
|
||||
根据欧拉函数,求 n 的欧拉函数φ(n)= φ(pq)= φ(p) φ(q)= (p-1)(q-1)
|
||||
|
||||
**第四步:求e**
|
||||
|
||||
> 随机选择一个整数e,条件是1< e < φ(n),且e与φ(n) 互质。
|
||||
@@ -0,0 +1,3 @@
|
||||
https://www.ruanyifeng.com/blog/2013/06/rsa_algorithm_part_one.html
|
||||
# RSA算法原理(一)
|
||||
[用同余加密——RSA算法的理论与基础实现](https://zhuanlan.zhihu.com/p/369674316)
|
||||
@@ -0,0 +1,32 @@
|
||||
椭圆曲线密码学(Elliptic Curve Cryptography,ECC)中常用的曲线参数主要是由各种标准化组织定义的,包括但不限于:
|
||||
|
||||
1. NIST(National Institute of Standards and Technology,美国国家标准与技术研究院)定义的曲线,例如:
|
||||
- P-256(也称为 secp256r1)
|
||||
- P-384(也称为 secp384r1)
|
||||
- P-521(也称为 secp521r1)
|
||||
|
||||
2. SECG(Standards for Efficient Cryptography Group)定义的曲线,例如:
|
||||
- secp256k1(由于其在比特币中的使用而知名)
|
||||
|
||||
3. ANSI(American National Standards Institute,美国国家标准协会)定义的曲线
|
||||
|
||||
4. Brainpool 曲线,例如:
|
||||
- brainpoolP256r1
|
||||
- brainpoolP384r1
|
||||
- brainpoolP512r1
|
||||
|
||||
5. FRP(Fast Randomizable Primality)曲线
|
||||
|
||||
国密 SM2 是中国自己定义的椭圆曲线密码算法标准,它不同于 NIST 或 SECG 定义的曲线。SM2 是由中国国家密码管理局推荐的公钥密码算法标准,它的全称是《SM2椭圆曲线公钥密码算法》。
|
||||
|
||||
SM2 算法使用的椭圆曲线参数如下:
|
||||
|
||||
- 椭圆曲线方程:y^2 = x^3 + ax + b
|
||||
- 素数 p(定义域的大小):0xFFFFFFFEFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFF00000000FFFFFFFFFFFFFFFF
|
||||
- 系数 a:0xFFFFFFFEFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFFF00000000FFFFFFFFFFFFFFFC
|
||||
- 系数 b:0x28E9FA9E9D9F5E344D5A9E4BCF6509A7F39789F5B645345C4C4FEA1E654DFF8B
|
||||
- 基点(G)的 x 坐标:0x32C4AE2C1F1981195F9904466A39C9948FE30BBFF2660BE1715A4589334C74C7
|
||||
- 基点(G)的 y 坐标:0xBC3736A2F4F6779C59BDCEE36B692153D0A9877CC62A474002DF32E52139F0A0 ^e79417
|
||||
- 阶 n:0xFFFFFFFEFFFFFFFFFFFFFFFFFFFFFFFF7203DF6B21C6052B53BBF40939D54123
|
||||
|
||||
|
||||
@@ -0,0 +1,38 @@
|
||||
[NIST 后量子密码标准征集提案 - Ding Key Exchange](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/NIST+%E5%90%8E%E9%87%8F%E5%AD%90%E5%AF%86%E7%A0%81%E6%A0%87%E5%87%86%E5%BE%81%E9%9B%86%E6%8F%90%E6%A1%88+-+Ding+Key+Exchange%20fde331e3-7eb2-497e-996a-7a719f2ed50c.md)
|
||||
|
||||
[国内算法标准介绍](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E5%9B%BD%E5%86%85%E7%AE%97%E6%B3%95%E6%A0%87%E5%87%86%E4%BB%8B%E7%BB%8D%20f0c4456b-c391-4d50-9032-8c5f43b0d25d.md)
|
||||
|
||||
[SSL VPN产品常见问题问答](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/SSL+VPN%E4%BA%A7%E5%93%81%E5%B8%B8%E8%A7%81%E9%97%AE%E9%A2%98%E9%97%AE%E7%AD%94%203f2724eb-6212-4ddc-90a1-d904676fb2d7.md)
|
||||
|
||||
[PKI技术规范](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/PKI%E6%8A%80%E6%9C%AF%E8%A7%84%E8%8C%83%20abf96506-5c16-4a03-ac32-1839f6dcc2a3.md)
|
||||
|
||||
[LDAP模型简介](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/LDAP%E6%A8%A1%E5%9E%8B%E7%AE%80%E4%BB%8B%202ea0c61c-1e7f-48d4-8a4e-43a790113dd1.md)
|
||||
|
||||
[PKCS](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/PKCS%20183e00f5-5a58-4754-921c-b52c536ec7ba.md)
|
||||
|
||||
[图解 ECDHE 密钥交换算法](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E5%9B%BE%E8%A7%A3+ECDHE+%E5%AF%86%E9%92%A5%E4%BA%A4%E6%8D%A2%E7%AE%97%E6%B3%95%20118cb81b-7cb1-471e-9fc2-ccfd0897265d.md)
|
||||
|
||||
|
||||
|
||||
[RFC PKCS](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/RFC+PKCS%204eb23dea-bc96-4397-badb-08fd3a4b4d3b.md)
|
||||
|
||||
[项目管理](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E9%A1%B9%E7%9B%AE%E7%AE%A1%E7%90%86%200577dadf-ecb3-4551-b005-8502d52e9076.md)
|
||||
|
||||
[国密及PKCS7的OID](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E5%9B%BD%E5%AF%86%E5%8F%8APKCS7%E7%9A%84OID%20cea170ba-032d-4330-99b9-883d6a4b9f53.md)
|
||||
|
||||
[[开源+免费] 一款释放数据价值的项目,开源隐私计算平台](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%5B%E5%BC%80%E6%BA%90+%E5%85%8D%E8%B4%B9%5D+%E4%B8%80%E6%AC%BE%E9%87%8A%E6%94%BE%E6%95%B0%E6%8D%AE%E4%BB%B7%E5%80%BC%E7%9A%84%E9%A1%B9%E7%9B%AE%EF%BC%8C%E5%BC%80%E6%BA%90%E9%9A%90%E7%A7%81%E8%AE%A1%E7%AE%97%E5%B9%B3%E5%8F%B0%20cdc79c72-d449-49ec-b9e7-cea4a9a1654c.md)
|
||||
|
||||
[0028 密码模块安全技术要求](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/0028+%E5%AF%86%E7%A0%81%E6%A8%A1%E5%9D%97%E5%AE%89%E5%85%A8%E6%8A%80%E6%9C%AF%E8%A6%81%E6%B1%82%205b0b1d2f-cdfd-4c9e-9f10-aba05fe594b8.md)
|
||||
|
||||
[国密规范整理](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E5%9B%BD%E5%AF%86%E8%A7%84%E8%8C%83%E6%95%B4%E7%90%86%2055695b92-a4a1-4cd2-a924-7f447f0e60c7.md)
|
||||
|
||||
[常见密码算法整理](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E5%B8%B8%E8%A7%81%E5%AF%86%E7%A0%81%E7%AE%97%E6%B3%95%E6%95%B4%E7%90%86%2096365711-a286-4773-b41b-6952a0b919d3.md)
|
||||
|
||||
[公网服务](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E5%85%AC%E7%BD%91%E6%9C%8D%E5%8A%A1%2034fc074a-f3e4-45d3-ac3f-0d8ba86bbf04.md)
|
||||
|
||||
[网关](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E7%BD%91%E5%85%B3%20c8d457aa-67b3-4082-979d-a34fe5b23ae2.md)
|
||||
|
||||
[算法模式-GCM模式](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E7%AE%97%E6%B3%95%E6%A8%A1%E5%BC%8F-GCM%E6%A8%A1%E5%BC%8F%207ea48eed-5208-4455-a689-327346ac4fc6.md)
|
||||
|
||||
[消息认证中容易混淆的概念(Hash,Mac,Hmac,CMAC,GMAC,GCM,AEAD, Mac-Tag, Nonce)](%E4%BF%A1%E5%AE%89+c5006103-ca4f-4a85-95c4-a6af67150bdc/%E6%B6%88%E6%81%AF%E8%AE%A4%E8%AF%81%E4%B8%AD%E5%AE%B9%E6%98%93%E6%B7%B7%E6%B7%86%E7%9A%84%E6%A6%82%E5%BF%B5%EF%BC%88Hash%EF%BC%8CMac%EF%BC%8CHmac%EF%BC%8CCMAC%EF%BC%8CGMAC%EF%BC%8CGCM%EF%BC%8CAEAD,+Mac-Tag,+Nonce%EF%BC%89%20cd82dca5-b108-4403-ba78-4c5a175a5960.md)
|
||||
|
||||
+10
@@ -0,0 +1,10 @@
|
||||
4 个安全等级:
|
||||
|
||||
- 安全一级
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
+112
@@ -0,0 +1,112 @@
|
||||
LDAP模型是从X.500协议中继承而来的,是LDAP的一个组成部分,用于指导客户如何使用目录服务。LDAP定义了4个模型,包括信息模型(Information Model)、命名模型(Naming Model)、功能模型(Functional Model)、安全模型(Security Model)。
|
||||
|
||||
**1.信息模型**
|
||||
|
||||
LDAP信息模型用于描述LDAP中信息的表达方式,包含3部分:条目(Entries)、属性(Attribute)、值(Values)。LDAP使用专有逻辑格式存储信息,这种模型既不是关系的,也不是完全面向对象的。简单概括为:
|
||||
|
||||
① LDAP中信息逻辑上表示为条目。
|
||||
|
||||
② 条目包含一到多个对象类。
|
||||
|
||||
③ 每个对象类由多个属性组成。
|
||||
|
||||
④ 每个属性包含一到多个同一类型的数值。
|
||||
|
||||
⑤ 对象类和属性的类型定义构成了schema。
|
||||
|
||||
条目是目录中最基本的信息单元,可以理解为目录树中的一个节点。LDAP客户和服务器使用条目共享信息,条目是LDAP服务器的基本元素。执行搜索时服务器返回一组匹配条目,但修改时一次只能影响服务器中的一个条目。条目可以被任何支持LDAP的客户端创建,或通过使用服务器工具导入,也可由应用程序基于非LDAP数据或用户信息创建。
|
||||
|
||||
在目录中添加一个条目时,该条目必须包含一个或者多个对象类(objectClass),每一个对象类规定了该条目中的必选属性和可选属性。图6-1展示了一个典型目录的一部分,它反映了现实世界中一个组织的管理对象。
|
||||
|
||||

|
||||
|
||||
**图6-1 组织结构目录树**
|
||||
|
||||
每一个条目都有一个DN(distinguished name,辨别名),用于唯一标识条目在目录中的位置,本书将在命名模型中详细介绍DN。
|
||||
|
||||
每个条目都是由多个属性组成的,每一个属性描述了对象的一个约束。每个属性具有一个类型和一个或多个值。该类型描述了包含在属性中的信息类型,其值中包含实际数据。
|
||||
|
||||
例如,表6-1描述了一个人员条目,属性包括全称、名、姓、电话号码、电子邮件地址。
|
||||
|
||||
|||
|
||||
|-|-|
|
||||
|属性类型|属性值|
|
||||
|cn|张三|
|
||||
|telephoneNumber|5804669062300098|
|
||||
|mail|zs@163.com|
|
||||
|
||||
**表6-1人员属性**
|
||||
|
||||
属性有与之关联的语法和匹配规则,属性语法指定可以在属性中存放的数据格式,如INTEGER语法允许值中只包含数字,不能包含非数字字符。
|
||||
|
||||
匹配规则作用有二:第一,比较值是否相等;第二,对值进行排序。
|
||||
|
||||
**2.命名模型**
|
||||
|
||||
LDAP命名模型定义了如何在目录系统中组织数据以及如何从目录系统中查找数据命名模型的灵活性可以使你很方便地以想要的方式组织数据。例如,可以把组织中所有员放在一个容器下,所有组放在一个容器下,或按组织结构的地理分布组织目录结构。
|
||||
|
||||
LDAP命名模型指定将条目按类似倒立的树结构进行规划,非常类似于UNIX系统的文件系统,如图6-2和图6-3所示。
|
||||
|
||||

|
||||
|
||||
**图6-2 目录树结构**
|
||||
|
||||

|
||||
|
||||
**图6-3 UNIX 文件系统**
|
||||
|
||||
|
||||
|
||||
在LDAP目录中任何一个节点都可以包含信息,同时也可以是一个容器,也就是说任何一个LDAP条目都可以有子节点。图6-4表示了一个典型的目录结构,在目录树中,条目ou-People,dc-example,dc=com和条目ou=Devices,dc=example,dc=com都既包含属性又包含子节点。
|
||||
|
||||
通过命名模型,可以给出目录中任何条目的唯一名称,从而可以毫无歧义地引用任一个条目。在LDAP中使用DN来引用条目。
|
||||
|
||||
在目录中,按目录树从下到上对条目进行命名,如图6-4中的灰色条同的DN名称为uid=bjensen,ou=people,dc=example,dc=com。因为这种树形结构决定了从根节点到其他任何节点的路径是唯一的,所以说每一个条目的DN是唯一的。
|
||||
|
||||

|
||||
|
||||
**图6-4 典型目录结构**
|
||||
|
||||
在DN中最左边的内容称为相对辨别名(RDN,Relative Distinguished Name)。如ou=People,dc=example,dc=com的RDN为ou=People。对于共享同一个父节点的所有节点的RDN必须是唯一的。如果不属于同一个父节点,则节点的RDN可以相同。当特殊字符出现在DN中时,必须进行转义,如表6-2所示。
|
||||
|
||||
||||
|
||||
|-|-|-|
|
||||
|字符|数值|转义序列|
|
||||
|在DN或RDN开始或结尾的空格|32|\空格|
|
||||
|在DN或RDN开始的#|35|\#|
|
||||
|逗号(,)|44|\,|
|
||||
|加号(+)|43|\+|
|
||||
|双引号(“)|34|\”|
|
||||
|反斜线(\)|92|\\|
|
||||
|小于符(<)|60|\<|
|
||||
|大于符(>)|62|\>|
|
||||
|分号(;)|59|\;|
|
||||
|
||||
表6-2 特殊字符转义表
|
||||
|
||||
**3.功能模型**
|
||||
|
||||
LDAP功能模型描述了LDAP协议可以采用的相关操作,以访问存储在目录树中的数据。在LDAP中共有4类10种操作。
|
||||
|
||||
①查询类操作,如搜索、比较。
|
||||
|
||||
②更新类操作,如添加条目、删除条目、修改条目、修改条目名。
|
||||
|
||||
③认证类操作,如绑定、解绑定。
|
||||
|
||||
④其他操作,如放弃和扩展操作。
|
||||
|
||||
除了扩展操作,另外9种是LDAP的标准操作。扩展操作是LDAP中为了增加新的功能提供的一种标准的扩展框架,当前已经成为LDAP标准的扩展操作,有修改密码和StartTLS扩展,在新的RFC标准和草案中正在增加一些新的扩展操作,不同的LDAP厂商也均定义了自己的扩展操作。
|
||||
|
||||
**4.安全模型**
|
||||
|
||||
安全模型提供一个安全框架,保护目录中的信息不被非法访问。LDAP中的安全模型主要通过身份认证、安全通道和访问控制(ACL)实现。
|
||||
|
||||
LDAP是一个面向连接的协议,在能够对LDAP目录进行任何操作之前,LDAP客户端必须获得一个到LDAP服务端的连接,在这个过程中需要对LDAP客户端的身份进行验证,这一过程可以理解为用户绑定。
|
||||
|
||||
LDAP v2只支持简单的密码验证。LDAP v3实现了SASL安全框架,SASL为多种验证协议提供了一种标准的验证方法,对于不同的验证系统,可以实现特定的SASL机制。
|
||||
|
||||
在LDAP中提供了基于SSL/TLS的通信安全保障。SSL/TLS基于PKI信息安全技术,LDAP通过StartTLS方式启动TLS服务,可以提供通信中的数据保密性、完整性保护;通过强制客户端证书认证的TLS服务,同时可以实现对客户端身份和服务器端身份的双向验证。
|
||||
|
||||
在用户通过验证之后,可以为该用户分配附加的权限。比如,一些用户只能查看特定的条目,而不能修改;一些用户可以查看并且修改所有的条目等。这一过程可以理解为访问控制。
|
||||
|
||||
+22
@@ -0,0 +1,22 @@
|
||||
## 后量子密码 (Post-quantum Cryptography) 及背景
|
||||
|
||||
1994 年,Peter Shor 提出了著名的量子算法。Shor 的量子算法可以实现:当足够大的量子计算机存在时,一些数论中的困难问题可以被有效解决,例如:离散对数问题(及其椭圆曲线版本),并可以被用于分解大整数。注意到离散对数问题(及其椭圆曲线版本)和大整数分解问题是目前广泛应用的公钥密码学算法([Diffie-Hellman 密钥交换协议](https://zh.wikipedia.org/wiki/%E8%BF%AA%E8%8F%B2-%E8%B5%AB%E7%88%BE%E6%9B%BC%E5%AF%86%E9%91%B0%E4%BA%A4%E6%8F%9B)、[RSA](https://zh.wikipedia.org/wiki/RSA%E5%8A%A0%E5%AF%86%E6%BC%94%E7%AE%97%E6%B3%95)、[椭圆曲线 (ECC)](https://zh.wikipedia.org/wiki/%E6%A4%AD%E5%9C%86%E6%9B%B2%E7%BA%BF%E5%AF%86%E7%A0%81%E5%AD%A6) 等)的困难性的基础。在没有量子计算机和对应的算法时,现有的经典公钥密码算法配合较为合适的参数(例如 2048 比特的 RSA)可以被认为在一定时间内是安全的。但是,一旦大型的量子计算机成功建造,Shor 的算法被认为可以快速且完全攻破大多数目前使用的公钥密码算法,即使参数被显著增大 $^{[1]}$。
|
||||
|
||||
*[1] 这里的“参数被显著增大”指的是在计算和通信开销可接受范围内的情况。当参数被“急剧增大”时,RSA 算法被认为可以“抵抗”量子计算机攻击。但此时,公钥的尺寸已经接近几百 M 甚至大于 1 GB。*
|
||||
|
||||
在真实世界中,广泛应用于各类安全应用、协议中的密码学原语包括且不仅限于:公钥加密、数字签名、密钥交换等。基于所有的互联网服务都依赖于密码学算法,包括且不仅限于 TLS、HTTPS、SSH、邮件、电子商务、移动支付、数字货币等。所有网络、软件、系统、应用安全等所有现代互联网的应用都将受到严峻的挑战。
|
||||
|
||||
后量子密码学 (Post-quantum Cryptography) 的任务是构造可以抵抗经典和量子计算机攻击的新的密码学算法,以应对量子计算机对于密码学的威胁。主要的后量子密码学实现技术有:基于格 (Lattice-based)、基于哈希 (Hash-based) 、基于编码 (Code-based) 、基于多变量 (Multivariate-based) 、基于格 (Lattice-based) 等。这四种方法各有其利弊。目前认为,在上述四种实现后量子密码算法的技术中,基于格的密码算法可以实现最强的安全性、最小的总通信开销、最快的计算速度和最多样化的密码算法设计。
|
||||
|
||||
截至目前,Google 已对后量子密码学算法的实用性进行[实际测试](https://security.googleblog.com/2016/07/experimenting-with-post-quantum.html)。Google 将后量子密钥交换协议应用于 TLS 中,并在 Google Chrome 浏览器的 Canary 分支和部分 Google Play 服务器上成功进行了测试。
|
||||
|
||||
您可以参考后量子密码学的 [Wikipedia 页面](https://en.wikipedia.org/wiki/Post-quantum_cryptography)、[Nature 上的文章](https://www.nature.com/articles/nature23461)或[较为系统的介绍后量子密码学的书](https://www.springer.com/us/book/9783540887010)等资源对后量子密码学进行更多的了解。您还可以参考这两篇较为详细的后量子密码学中文介绍:[“从量子计算到量子安全”](http://www.knowfar.org.cn/html/zhanlue/201612/22/641.htm)和[“后量子密码技术发展分析”](http://www.knowfar.org.cn/html/zhanlue/201701/13/657.htm)。
|
||||
|
||||
# [https://if2007.github.io/2018/04/06/nist_pqc/#NIST-后量子密码标准征集工作](https://if2007.github.io/2018/04/06/nist_pqc/#NIST-后量子密码标准征集工作)NIST 后量子密码标准征集工作
|
||||
|
||||
2016 年 12 月 20 日,美国国家标准技术研究所 (National Institute of Standards and Technology, NIST) [正式宣布](https://csrc.nist.gov/news/2016/public-key-post-quantum-cryptographic-algorithms)启动全世界范围内的后量子密码算法标准征集竞赛,旨在征集新一代的可以抵抗量子计算机攻击的公钥加密、数字签名和密钥交换协议。此竞赛欢迎全球范围内所有个人/组织向 NIST 提交密码算法的文档、工程实现。NIST 公开所有符合初步筛选标准的候选算法,供所有人进行分析和评论,利用所有人的力量共同制定新一代的密码学算法标准。
|
||||
|
||||
候选算法的征集工作已于 2017 年 11 月 30 日截止,共有来自 25 个国家的 82 个候选算法被提交,其中 69 个符合 NIST 的初步筛选标准。全部 69 个候选算法涵盖了基于格、多变量、编码和哈希等的后量子密码学算法构造。所有候选算法的文档已于 2017 年 12 月[公布于 NIST 网站](https://csrc.nist.gov/projects/post-quantum-cryptography/round-1-submissions)。
|
||||
|
||||
NIST 的后量子密码学专家 Dustin Moody 在 AsiaCrypt 2017 会议上对 NIST 的后量子密码标准征集竞赛和现状进行了详细的介绍。报告的 Slide 可以在[这里下载](https://csrc.nist.gov/CSRC/media/Projects/Post-Quantum-Cryptography/documents/asiacrypt-2017-moody-pqc.pdf)。
|
||||
|
||||
+35
@@ -0,0 +1,35 @@
|
||||
RSA定义的 PKCS 各版本,用途各不相同;
|
||||
|
||||
PKCS #1 定义私钥签名运算的填充方式, v1.5 是 PKCS1_PADDING, v2.1 是 PKCS1_PSS_PADING;
|
||||
|
||||
PKCS#2:涉及了RSA的消息摘要加密,这已被并入PKCS#1中。
|
||||
|
||||
PKCS#3:Diffie-Hellman密钥协议标准。PKCS#3描述了一种实现Diffie- Hellman密钥协议的方法。
|
||||
|
||||
PKCS#4:最初是规定RSA密钥语法的,现已经被包含进PKCS#1中。
|
||||
|
||||
PKCS #5 基于口令的加密标准。PKCS#5描述了使用由口令生成的密钥来加密8位位组串并产生一个加密的8位位组串的方法。PKCS#5可以用于加密私钥,以便于密钥的安全传输(这在PKCS#8中描述)。定义了加密运算的填充方式,8字节填充,Java标准接口支持;例如,串0x56在经过PKCS5填充之后会成为0x56 0x07 0x07 0x07 0x07 0x07 0x07 0x07因为需要填充7字节,因此填充的内容就是7。当然特殊情况下,如果已经满足了8的整倍数,按照PKCS5的规则,仍然需要在尾部填充8个字节,并且内容是0x08,目的是为了加解密时统一处理填充。
|
||||
|
||||
PKCS#6:扩展证书语法标准。PKCS#6定义了提供附加实体信息的X.509证书属性扩展的语法(当PKCS#6第一次发布时,X.509还不支持扩展。这些扩展因此被包括在X.509中)。
|
||||
|
||||
PKCS #7 密码消息语法标准。PKCS#7为使用密码算法的数据规定了通用语法,比如数字签名和数字信封。PKCS#7提供了许多格式选项,包括未加密或签名的格式化消息、已封装(加密)消息、已签名消息和既经过签名又经过加密的消息。 填充算法扩充了PKCS#5 的限制,填充长度可以是1-255字节;通过第三方库可以在Java中支持 PKCS#7 填充;
|
||||
|
||||
PKCS#8:私钥信息语法标准。PKCS#8定义了私钥信息语法和加密私钥语法,其中私钥加密使用了PKCS#5标准;
|
||||
|
||||
PKCS#9:可选属性类型。PKCS#9定义了PKCS#6扩展证书、PKCS#7数字签名消息、PKCS#8私钥信息和PKCS#10证书签名请求中要用到的可选属性类型。已定义的证书属性包括E-mail地址、无格式姓名、内容类型、消息摘要、签名时间、签名副本(counter signature)、质询口令字和扩展证书属性。
|
||||
|
||||
PKCS#10:证书请求语法标准。PKCS#10定义了证书请求的语法。证书请求包含了一个唯一识别名、公钥和可选的一组属性,它们一起被请求证书的实体签名(证书管理协议中的PKIX证书请求消息就是一个PKCS#10)。
|
||||
|
||||
PKCS#11:密码令牌接口标准。PKCS#11或“Cryptoki”为拥有密码信息(如加密密钥和证书)和执行密码学函数的单用户设备定义了一个应用程序接口(API)。智能卡就是实现Cryptoki的典型设备。注意:Cryptoki定义了密码函数接口,但并未指明设备具体如何实现这些函数。而且Cryptoki只说明了密码接口,并未定义对设备来说可能有用的其他接口,如访问设备的文件系统接口。
|
||||
|
||||
PKCS#12:个人信息交换语法标准。PKCS#12定义了个人身份信息(包括私钥、证书、各种秘密和扩展字段)的格式。PKCS#12有助于传输证书及对应的私钥,于是用户可以在不同设备间移动他们的个人身份信息。
|
||||
|
||||
PKCS#13:椭圆曲线密码标准。PKCS#13标准当前正在完善之中。它包括椭圆曲线参数的生成和验证、密钥生成和验证、数字签名和公钥加密,还有密钥协定,以及参数、密钥和方案标识的ASN.1语法。
|
||||
|
||||
PKCS#14:伪随机数产生标准。PKCS#14标准当前正在完善之中。为什么随机数生成也需要建立自己的标准呢?PKI中用到的许多基本的密码学函数,如密钥生成和Diffie-Hellman共享密钥协商,都需要使用随机数。然而,如果“随机数”不是随机的,而是取自一个可预测的取值集合,那么密码学函数就不再是绝对安全了,因为它的取值被限于一个缩小了的值域中。因此,安全伪随机数的生成对于PKI的安全极为关键。
|
||||
|
||||
PKCS#15:密码令牌信息语法标准。PKCS#15通过定义令牌上存储的密码对象的通用格式来增进密码令牌的互操作性。在实现PKCS#15的设备上存储的数据对于使用该设备的所有应用程序来说都是一样的,尽管实际上在内部实现时可能所用的格式不同。PKCS#15的实现扮演了翻译家的角色,它在卡的内部格式与应用程序支持的数据格式间进行转换。
|
||||
————————————————
|
||||
版权声明:本文为CSDN博主「zhbpd」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
|
||||
原文链接:[https://blog.csdn.net/zhbpd/article/details/107732995](https://blog.csdn.net/zhbpd/article/details/107732995)
|
||||
|
||||
+8
@@ -0,0 +1,8 @@
|
||||
|
||||
|
||||
[PKI体系框架](PKI%E6%8A%80%E6%9C%AF%E8%A7%84%E8%8C%83+abf96506-5c16-4a03-ac32-1839f6dcc2a3/PKI%E4%BD%93%E7%B3%BB%E6%A1%86%E6%9E%B6%20ed780626-80e7-461a-8b12-81290718f525.md)
|
||||
|
||||
[PKI/数字证书与私钥](PKI%E6%8A%80%E6%9C%AF%E8%A7%84%E8%8C%83+abf96506-5c16-4a03-ac32-1839f6dcc2a3/PKI+%E6%95%B0%E5%AD%97%E8%AF%81%E4%B9%A6%E4%B8%8E%E7%A7%81%E9%92%A5%20e89e4605-b474-4bc8-963d-ecdc5999a2ea.md)
|
||||
|
||||
[PKI/CA与KMC](PKI%E6%8A%80%E6%9C%AF%E8%A7%84%E8%8C%83+abf96506-5c16-4a03-ac32-1839f6dcc2a3/PKI+CA%E4%B8%8EKMC%20dfb166ae-f52a-4cdb-90b6-499293b1f684.md)
|
||||
|
||||
+82
@@ -0,0 +1,82 @@
|
||||
**1.CA最初目的是签发数字证书**
|
||||
|
||||
为解决数字证书的签发问题,PKI引入CA.用于对数字证书进行集中签发。CA是Certificate Authority昀缩写,字面含义是证书权威,也称作CA中心、认证中心。CA中心拥有自己的公钥和私钥,使用其私钥给用户(包含CA巾心自己)签发数字证书,具体签发过程如下:
|
||||
|
||||
(1)将用户身份信息和用户公钥信息,按照特定格式组成数据D。
|
||||
|
||||
(2)选择摘要算法对数据D进行计算得到摘要H。
|
||||
|
||||
(3)使用CA私钥对摘要H进行加密得到数字签名S。
|
||||
|
||||
(4)将用户身份信息、用户公钥信息和数字签名S,按照特定格式就可组成数字证书。
|
||||
|
||||
**2.CA应对数字证书的全生命周期进行管理**
|
||||
|
||||
CA实际是一种特殊的公钥管理中心,为实现数字证书的安全性,应对数字证书的全生命周期进行管理,主要包括:
|
||||
|
||||
(1)数字证书的签发和更新。证书签发主要针对新用户;证书更新主要针对已有证书用户,更新时公钥可以改变,也可以不变。
|
||||
|
||||
(2)数字证书的作废(注销、撤销或吊销)。证书作废后将成无效证书,永远不能使用。
|
||||
|
||||
(3)数字证书的冻结(挂失)和解冻。证书冻结后将成无效证书,但可以通过解冻恢复成有效状态。
|
||||
|
||||
(4)数字证书的查询或下载。应提供公开服务方式,允许用户根据条件随时查询证书并下载。常用服务方式有HTTP和LDAP。
|
||||
|
||||
(5)数字证书状态查询。应提供公开服务方式,允许用户随时查询证书状态,以便判断该证书是否处于有效状态。常用服务方式有CRL和OCSP。
|
||||
|
||||
**3.KMC用于管理私钥**
|
||||
|
||||
如果使用公钥(数字证书)对数据进行加密,则只有与公钥对应的私钥才能进行解密,从而可实现用户数据的保密性。当私钥丢失时,如果没有备份和恢复机制,将导致公钥加密的所有数据都无法解密,可能给用户带来损失。
|
||||
|
||||
为解决私钥的备份与恢复问题,PKI引入了KMC,用于对私钥的全生命周期进行管理。KMC是Key Management Center的缩写。
|
||||
|
||||
用户公私钥对可由KMC产生,提交CA签发数字证书后,将私钥和数字证书同时安全移交给用户,而KMC将私钥留作备份,可按需要给用户恢复。用户公私钥对也可由用户自己产生(使用软件或密码设备),在向CA中心申请数字证书时,可将私钥安全提交KMC留作备份。
|
||||
|
||||
**4.双证书机制**
|
||||
|
||||
为防止用户身份被冒用,应保证用户私钥的唯一性,不允许备份恢复。为防止公钥加密后的数据无法解密,应提供用户私钥的备份恢复机制。
|
||||
|
||||
为解决这两种矛盾的应用需求,PKI引入双证书机制:签名证书和加密证书。
|
||||
|
||||
签名证书及私钥只用于签名验签,不能用于加密解密;为保证签名私钥的唯一性,该公私钥对必须由用户自己产生,同时采用硬件技术(如只允许在硬件密码设备内产生公私钥对、私钥不允许导出等)保证无法复制,在证书签发过程中CA中心并不知道该私钥,只对其公钥进行操作。该私钥没有备份,因此永远不能恢复。
|
||||
|
||||
加密证书及私钥只用于加密解密,不能用于签名验签。为实现解密私钥的备份恢复机制,该公私钥对必须由KMC产生,由CA签发完数字证书后安全移交给用户,用户应采用硬件技术保证该私钥的安全性。KMC可根据需要恢复该私钥。
|
||||
|
||||
**5.LDAP**
|
||||
|
||||
CA中心存储着所有数字证书,并通过公开服务形式供用户随时查询或下载。为解决数字证书查询或下载的性能问题,避免CA中心成为性能瓶颈,PKI引入了LDAP技术,通过LDAP方式对外提供高速证书查询或下载服务。
|
||||
|
||||
专业的关系型数据库管理系统(如Oracle、DB2等)专门对结构化数据进行管理,应用系统只需通过SQL语句(报文协议)发送各种数据管理指令,而具体管理工作完全由数据库管理系统负责。尽管这种数据管理方式大大简化了应用系统的复杂度,但由于其读写功能相对均衡,很难满足高性能的查询服务。为获得高性能的查询服务,需要对数据管理的读取功能进行特殊优化,于是出现了目录服务技术(DAP,Directory Access Protocol)。目录服务技术对查询功能进行优化,比修改操作快10倍以上,适合快速响应和大容量查询服务。DAP技术通过目录树方式对数据进行管理,应用系统只需通过x.500协议就能对数据进行快速查询。
|
||||
|
||||
由于X.500协议过于复杂,实现成本很高,于是国际组织对X.500进行了简化,形成LDAP标准,而且LDAP支持TCP/IP协议,更适合于互联网领域使用。LDAP为轻量目录访问协议,是Light-weight Directory Access Protocol的缩写。
|
||||
|
||||
由于数字证书是可以公开的,CA中心也可以将其签发的数字证书存储到其他地方,供用户查询或下载。
|
||||
|
||||
**6.CRL和OCSP**
|
||||
|
||||
当用户私钥泄露后,CA中心有责任将该用户的证书标记为失效。但用户如何获得对方证书足否失效的状态呢?为方便用户获得证书状态,PKI引入了CRL和OCSP技术。
|
||||
|
||||
(1) CRL(Certificate Revocation List)
|
||||
|
||||
CRL为证书作废列表,是Certificate Revocation List的缩写,也称作证书黑名单,是一种特殊的文件格式,包含所有失效的证书清单、下次CRL生成时间和CA中心私钥的签名。
|
||||
|
||||
CA中心定期生成CRL.并将下次生成时问写入CRL中,方便用户按时定期下载CRL。跟数字证书类似,CRL也是通过CA中心私钥的签名来保证CRL无法被篡改的。用户只需定期获取CRL后,就可在本地脱机验证证书是否失效,在下次CRL生成时间之前无需联系CA中心。
|
||||
|
||||
由于CRL是可以公开的,CA中心也可以将其链发的CRL存储到其他地方,供用户查询或下载。CRL也可以发布到LDAP中,提供高速下载服务。
|
||||
|
||||
(2) OCSP (Online Certificate Status Protocol)
|
||||
|
||||
当CA中心将私钥已泄露的用户证书标记为失效后,如果还未到下次CRL生成时间,此时其他用户通过最新CRL并不知道该用户证书已经失效,依然将该用户当作有效用户继续进行各种保密通信和合法交易,因此可能会造成一定的损失。
|
||||
|
||||
为解决CRL滞后的缺陷,避免给高实时性或高风险交易造成重大损失,PKI引入了OCSP,对用户提供实时的证书状态查询服务。OCSP为在线证书状态协议,是Online Certificate Status Protocol的缩写。当用户需要实时查询对方证书是否有效时,可通过OCSP协议实时访问CA中心获得对方证书的当前状态。
|
||||
|
||||
**7.RA**
|
||||
|
||||
在保证CA系统安全性的前提下,为方便证书业务远程办理、方便证书管理流程与应用系统结合,PKI引入了RA,专门用于对用户提供面对面的证书业务服务,负责用户证书办理/作废申请、用户身份审核、制作证书并移交用户等功能,而涉及证书签发时则提交CA系统集中处理。RA是Registry Authority的缩写,又称作RA中心、注册中心。有时候,证书管理流程会与应用业务流程结合,并不单独体现出来,如对于网上银行,证书管理流程就会融合到网银业务流程中。
|
||||
|
||||
RA可以部署多个,既可以单独部署,也可以与应用系统集成。
|
||||
|
||||
CA主要模块组成如下图所示。
|
||||
|
||||

|
||||
|
||||
+70
@@ -0,0 +1,70 @@
|
||||
**1.数字证书的最初目的是建立公钥与用户之间的对应关系**
|
||||
|
||||
由于公钥是随机产生的,从公钥无法直接判断属于哪个用户。为解决公钥与用户映射关系问题,PKI引入数字证书,用于建立公钥与用户之间的对应关系。
|
||||
|
||||
数字证书实际是一种特殊的文件格式,包含用户身份信息、用户公钥信息和CA私钥的数字签名。用户身份信息由姓名或名称、单位、城市、国家等组成。X.509标准规定了数字证书的具体格式。
|
||||
|
||||
由于数字证书中包含用户身份信息和公钥信息,根据数字证书就可直接判断该公钥属于哪个用户。如某数字证书包含用户信息“诸葛亮”和公钥PK,则可判断公钥PK就是诸葛亮的。
|
||||
|
||||
由于数字证书中包含CA私钥的数字签名,使用CA公钥对数字证书中CA私钥的数字签名进行解密处理后,就可立刻判断该数字证书是否被篡改,因此数字证书具有防伪性,于是,数字证书中公钥和用户之间对应关系也值得可信。当然,数字证书防伪性的前提是公钥算法和CA私钥都是安全的。
|
||||
|
||||
由于数字证书中不包含秘密信息,因此数字证书可公开发布。
|
||||
|
||||
数字证书主要内容显示如图2-2所示,其中,“使用者”为用户身份信息,“公钥”为用户公钥信息,“有效期”属于附加策略。
|
||||
|
||||

|
||||
|
||||
**图2-2 数字证书主要内容显示**
|
||||
|
||||
**2.数字证书可作为网络身份证**
|
||||
|
||||
现实生活中,公安部为每人颁发一张二代身份证,身份证上包含姓名、性别、出生日期、省份、身份证号、照片等信息。当购票、住店、坐飞机时,身份证持有人(或持证人)只需出示身份证即可证明自己的身份。只有通过以下四个方面的合法性验证,才能完全确认持证人的合法身份:
|
||||
|
||||
(1)验证身份证是否伪造。需要专门的二代身份证读写设备来验证。
|
||||
|
||||
(2)验证身份证信息是否正确。需要查询身份证数据库,需要公安部门提供;也可由公安部门在发放身份证时保证。
|
||||
|
||||
(3)验证身份证是否与持证人一致。需要对比身份证上照片与持证人的长相。
|
||||
|
||||
(4)验证身份证是否在黑名单上。需要查询黑名单数据库,如公安部通缉犯清单,需要公安部门提供。
|
||||
|
||||
既然数字证书包含用户身份信息,而且具有防伪性且可以公开,那么数字证书持有人(或持证人)在网络世界中能否也像现实生活中一样,只需出示数字证书即可证明自己身份呢?答案是肯定的。如果能通过类似二代身份证的四个方面合法性验证,数字证书就可作为网络身份证。下面来确认一下,数字证书能否通过四个方面的合法性验证:
|
||||
|
||||
(1)验证数字证书是否伪造。可通过CA公钥验证。
|
||||
|
||||
(2)验证数字证书中信息是否正确。可由CA中心在签发数字证书时保证。
|
||||
|
||||
(3)验证数字证书是否与持证人一致。可要求持证人使用私钥对特定数据进行加密或签名,然后使用数字证书中的公钥来解密该数据或验签,从而可验证持证人是否持有与数字证书中的公钥对应的私钥。
|
||||
|
||||
(4)验证数字证书是否在黑名单上。可通过查询黑名单数据库来实现,但需要CA中心提供黑名单。
|
||||
|
||||
因此,数字证书作为网络身份证,可有效解决网络世界中“你是谁”的问题。由于数字证书采用公钥密码技术实现,从技术上保证了每个人“钥匙”的唯一性,既不重复也无法复制,所以数字证书比现实生活中的各种钥匙安全很多。
|
||||
|
||||
**3.数字证书可附加很多策略**
|
||||
|
||||
由于数字证书具有防伪性和公开性,因此数字证书中不仅可包含用户身份信息和用户公钥信息,而且还可以附加其他策略信息,这些信息同样具有防伪性和公开性。
|
||||
|
||||
X.509数字证书标准中规定常用策略信息主要包括:
|
||||
|
||||
(1)有效期。包括起始时间和终止时问。
|
||||
|
||||
(2)密钥用途。表示该公钥和私钥用于什么目的,如数据签名、数据加密、签发证书、用于安全电子邮件等。
|
||||
|
||||
(3)别名。包括持证人别名和CA中心别名。
|
||||
|
||||
(4)黑名单地址。
|
||||
|
||||
(5)是否CA中心的数字证书。如果是CA中心的数字证书,则规定能签发几级证书。
|
||||
|
||||
**4.CA中心的数字证书**
|
||||
|
||||
用户在验证数字证书是否被篡改时,必须首先获得CA中心的公钥。为方便用户识别CA中心的公钥,CA中心也为自己签发数字证书。该证书包含CA中心公钥、CA中心身份信息和CA中心私钥的签名。CA中心的数字证书有时也称作CA证书。
|
||||
|
||||
由于CA证书是验证其他证书合法性的前提和基础,所以CA证书的正确性至关重要。尽管可通过网络直接下载获取CA证书,但为避免被欺骗,需要通过其他方式验证CA证书的正确性。可通过电话方式、官方报纸或官方电视公布CA证书的摘要值,用户通过核对该摘要值即可确认该证书的正确性。
|
||||
|
||||
**5.私钥**
|
||||
|
||||
对于公钥密码技术,公钥和私钥是成对出现的。公钥以数字证书形式存在,可以公开,但私钥必须保密。为保证私钥的安全性,一般将私钥保存在硬件密码设备中(如个人的私钥可保存在USB Key或lC卡中,系统的私钥可保存在加密机或加密卡中),而且不允许私钥导出硬件密码设备:通过口令、指纹等方式来访问控制该硬件密码没备。如果将私钥保存在硬盘文件中,则需要通过口令进行加密保护,但私钥文件容易被复制。
|
||||
|
||||
为保证私钥的唯一性,可只允许在硬件密码设备内产生公私钥对,通过硬件技术保证私钥无法导出,然后只导出公钥提交CA中心签发数字证节。
|
||||
|
||||
+44
@@ -0,0 +1,44 @@
|
||||
PKI是Public Key Infrastructure的缩写,其主要功能是绑定证书持有者的身份和相关的密钥对(通过为公钥及相关的用户身份信息签发数字证书),为用户提供方便的证书申请、证书作废、证书获取、证书状态查询的途径,并利用数字证书及相关的各种服务(证书发布,黑名单发布,时间戳服务等)实现通信中各实体的身份认证、完整性、抗抵赖性和保密性。
|
||||
|
||||
根据数字证书格式及密钥管理方式的不同,PKI也包括多种模式,如X.509模式、PGP模式、IBE/CPK模式、EMV模式等。X.509模式的PKI也称作PKIX。由于X.509标准已经成为数字证书格式的事实标准,因此大部分情况下PKI特指PKIX。如非特殊说明,本文中PKI均指PKIX。
|
||||
|
||||
PKI体系框架主要包括三部分内容。
|
||||
|
||||
**1.数字证书与私钥**
|
||||
|
||||
用户或系统只有拥有自己的公钥和私钥后,才能实现数字签名和加解密功能。由于公钥是随机产生的,因此从公钥无法直接判断属于哪个用户。
|
||||
|
||||
为解决公钥与用户映射关系问题,PKI引入了数字证书,用于建立公钥与用户之间的对应关系。数字证书实际上是一种特殊的文件格式,包含用户身份信息、用户公钥信息和CA私钥的数字签名。X.509标准规定了数字证书的具体格式。数字证书中只包含公钥,并不包括私钥。由于数字证书中包含CA私钥的数字签名,因此数字证书具有防伪性。由于数字证书中不包含秘密信息,因此数字证书具有公开性。数字证书作为网络身份证,可有效解决网络世界中“你是谁”的问题。
|
||||
|
||||
为保证私钥的安全性,一般将私钥保存在硬件密码设备中(如个人的私钥可保存在USBKey或lC卡中,系统的私钥可保存在加密机或加密卡中),而且不允许私钥导出硬件密码设备:通过口令、指纹等方式来访问控制该硬件密码设备。如果将私钥保存在硬盘文件中,则需要通过口令进行加密保护,但私钥文件容易被复制。
|
||||
|
||||
**2.数字证书的管理**
|
||||
|
||||
为解决数字证书的签发问题,PKI引入CA,对数字证书进行集中签发。CA是Certificate Authority的缩写,字面含义是证书权威,也称作CA中心、认证中心。CA中心拥有自己的公钥和私钥,使用其私钥给用户(包含CA中心自己)签发数字证书。
|
||||
|
||||
CA实际是一种特殊的公钥管理中心,为实现数字证书的安全性,对数字证书的全生命周期进行管理,主要包括:数字证书的签发和更新、数字证书的作废(注销、撤销或吊销)、数字证书的冻结(挂失)和解冻、数字证书的查询或下载、数字证书状态查询等。当私钥丢失时,如果没有备份和恢复机制,将导致公钥加密的所有数据都无法解密,可能给用户带来损失。为解决私钥的备份与恢复问题,PKI引入了KMC,用于对私钥的全生命周期进行管理。KMC是Key Management Center的缩写。用户公私钥对可由KMC产生,提交CA签发数字证书后,将私钥和数字证书同时安全移交给用户,而KMC将私钥留作备份,可按需要给用户恢复。用户公私钥对也可由用户自己产生(使用软件或密码设备),在向CA中心申请数字证书时,可将私钥安全提交KMC留作备份。
|
||||
|
||||
为防止用户身份被冒用,应保证用户私钥的唯一性,不允许备份恢复。为防止公钥加密后的数据无法解密,应提供用户私钥的备份恢复机制。为解决这两种矛盾的应用需求,PKI引入双证书机制:签名证书和加密证书。签名证书及私钥只用于签名验签,不能用于加密解密,该公私钥对必须由用户自己产生,KMC不备份签名私钥。加密证书及私钥只用于加密解密,不能用于签名验签,该公私钥对必须由KMC产生,且KMC对加密私钥进行备份。
|
||||
|
||||
CA中心存储着所有数字证书,并通过公开服务形式供用户随时查询或下载。为解决数字证书查询或下载的性能问题.避免CA中心成为性能瓶颈,PKI引入了LDAP技术,通过LDAP方式对外提供高速证书查询或下载服务。LDAP为轻量目录访问协议,是Light-weight Directory Access Protocol的缩写。
|
||||
|
||||
当用户私钥泄露后,CA中心有责任将该用户的证书标记为失效。但用户如何获得对方证书是否失效的状态呢?为方便用户获得证书状态,PKI引入了CRL和OCSP技术。CRL为证书作废列表,是Certificate Revocation List的缩写,也称作证书黑名单。OCSP为在线证书状态协议,是Online Certificate Status Protocol的缩写。
|
||||
|
||||
在保证CA系统安全性的前提下,为方便证书业务远程办理、方便证书管理流程与应用系统结合,PKI引入了RA,专门用RA对用户提供面对面的证书业务服务,负责用户证书办理/作废申请、用户身份审核、制作证书并移交用户等功能,而涉及证书签发时则提交CA系统集中处理。RA是Registry Authority的缩写,又称作RA中心、注册中心。有时候,证书管理流程会与应用业务流程结合,并不单独体现出来,如对于网上银行,证书管理流程就会融合到网银业务流程中。
|
||||
|
||||
为保证CA系统在数字证书管理方面的规范性、合规性和安全性,PKI引入电子认证服务机构,以第三方运营的方式对外提供数字证书相关服务。《电子签名法》规定:“电子签名需要第三方认证的,由依法设立的电子认证服务提供者提供认证服务。”显然,电子签名法不仅赋予了电子签名的法律效力,而且明确了电子认证服务提供者的法律地位。电子认证服务提供者,又称作电子认证服务机构或CA中心,需要独立运营,不仅需要满足政策法规的各项要求,而且需要满足业务运营的业务需求。
|
||||
|
||||
**3.数字证书的应用**
|
||||
|
||||
基于数字证书可实现四种基本安全功能:身份认证、保密性、完整性和抗抵赖性。
|
||||
|
||||
基于证书接口中间件(模块或组件),应用系统可以很方便地使用数字证书技术,从而提高应用系统的身份认证强度、保证应用系统中各种敏感数据的保密性、保证应用系统中各种敏感数据和交易记录的完整性、用户各种操作或交易的不可否认性(抗抵赖性)。
|
||||
|
||||
PKI技术经过30多年的发展历程,已经形成比较完善的标准规范体系,几乎覆盖应用系统的各个方面,目前很多软件都已经支持数字证书技术,如操作系统、数据库系统、Web服务器、应用服务器等。由于受应用环境多样性和应用技术复杂性的影响或限制,在不同的应用环境和应用技术下,数字证书技术应用的方式可能差异很大。
|
||||
|
||||
网上报税和网上银行是数字证书应用的典型案例。国内大部分省份上千万家企业已经通过数字证书在进行网上报税。数字证书(俗称U盾)已经成为国内网上银行的标准配置。如果没有数字证书,企业用户将不允许使用网上银行。上亿个人用户已经通过数字证书访问网上银行实现转账或汇款等资金操作。
|
||||
|
||||
PKI体系框架如下图:
|
||||
|
||||

|
||||
|
||||
+18
@@ -0,0 +1,18 @@
|
||||
||名称|RFC|
|
||||
|-|-|-|
|
||||
|PKCS #1|RSA Cryptography Standard (RSA密码标准)|RFC 3447|
|
||||
|PKCS #2|已撤销,用以规范RSA加密摘要的转换方式,已并入PKCS #1|-|
|
||||
|PKCS #3|Diffie–Hellman Key Agreement Standard (DH秘钥协商标准)|-|
|
||||
|PKCS #4|已撤销,用以定义RSA秘钥的格式,已并入PKCS #1|-|
|
||||
|PKCS #5|Password-based Encryption Standard (基于口令的密码标准)|RFC 2898|
|
||||
|PKCS #6|Extended-Certificate Syntax Standard (扩展的证书语法标准)|-|
|
||||
|PKCS #7|Cryptographic Message Syntax Standard (密码消息语法标准)|RFC 2315|
|
||||
|PKCS #8|Private-Key Information Syntax Standard (私钥信息语法标准)|RFC 5958|
|
||||
|PKCS #9|Selected Attribute Types (可供选择的属性类型)|RFC 2985|
|
||||
|PKCS #10|Certification Request Standard (证书请求语法标准)|RFC 2986|
|
||||
|PKCS #11|Cryptographic Token Interface (密码Token接口标准)|-|
|
||||
|PKCS #12|Personal Information Exchange Syntax Standar (个人信息交换语法标准)|RFC 7292|
|
||||
|PKCS #13|Elliptic Curve Cryptography Standard (椭圆曲线密码标准),正在制定中||
|
||||
|PKCS #14|Pseudo-random Number Generation (伪随机数生成算法PRNG),正在制定中||
|
||||
|PKCS #15|Cryptographic Token Information Format Standard (密码Token信息格式标准)||
|
||||
|
||||
+18
@@ -0,0 +1,18 @@
|
||||
**Q1:什么是VPN?**
|
||||
A1:VPN的英文全称是“Virtual Private Network”,翻译过来就是“虚拟专用网络”。顾名思义,虚拟专用网络我们可以把它理解成是虚拟出来的企业内部专线。
|
||||
虚拟专用网(VPN)被定义为通过一个公用网络(通常是因特网)建立一个临时的、安全的连接,是一条穿过混乱的公用网络的安全、稳定的隧道。虚拟专用网是对企业内部网的扩展。虚拟专用网可以帮助远程用户、公司分支机构、商业伙伴及供应商同公司的内部网建立可信的安全连接,并保证数据的安全传输。虚拟专用网可用于不断增长的移动用户的全球因特网接入,以实现安全连接;可用于实现企业网站之间安全通信的虚拟专用线路,用于经济有效地连接到商业伙伴和用户的安全外联网虚拟专用网。
|
||||
|
||||
**Q2:什么是SSLVPN?**
|
||||
A2:从概念角度来说,SSL VPN即指采用SSL (Security Socket Layer)协议来实现远程接入的一种新型VPN技术。SSL协议是网景公司提出的基于WEB应用的安全协议,它包括:服务器认证、客户认证(可选)、SSL链路上的数据完整性和SSL链路上的数据保密性。对于内、外部应用来说,使用SSL可保证信息的真实性、完整性和保密性。目前SSL 协议被广泛应用于各种浏览器应用,也可以应用于Outlook等使用TCP协议传输数据的C/S应用。正因为SSL 协议被内置于IE等浏览器中,使用SSL 协议进行认证和数据加密的SSL VPN就可以免于安装客户端。相对于传统的IPSEC VPN而言,SSL VPN具有部署简单,无客户端,维护成本低,网络适应强等特点。
|
||||
|
||||
**Q3:我们的SSL VPN设备支持的认证方式?**
|
||||
A3:我们的SSL VPN设备支持的认证方式:
|
||||
本地数据库认证
|
||||
AD域认证
|
||||
LDAP认证
|
||||
RADIUS认证
|
||||
RSA SecurID认证
|
||||
SSL 双向认证
|
||||
MAC地址认证
|
||||
手机动态密码认证
|
||||
|
||||
+182
@@ -0,0 +1,182 @@
|
||||

|
||||
|
||||
在大数据和 AI 的时代背景下,数据已经成为了重要财富,大到政务数据、企业核心数据,小到个人信息、银行卡余额,**这些数据无一例外都是“隐私数据”,如果在使用和流转时发生泄漏都会造成巨大的损失。**
|
||||
|
||||
那有没有什么方法,可以在不暴露数据隐私的前提下,让数据流动起来发挥更大的价值呢?在这个问题的驱使下我们找到了今天的主角——隐私计算。
|
||||
|
||||
## 一、什么是隐私计算?
|
||||
|
||||
隐私计算是指**在不泄露数据本身的情况下,实现数据分析和计算的技术,具有“数据可用不可见”的特点,让数据安全合规地流动起来。**
|
||||
|
||||
下面用一个经典的百万富翁问题,来帮助理解什么是“数据可用不见”。
|
||||
|
||||

|
||||
|
||||
假设有两个百万富翁,他们都想知道谁更富有,但又不想让对方或者第三方,知道自己具体有多少钱。
|
||||
|
||||
- **数据本身**:具体的财富值(数据)
|
||||
|
||||
- **计算**:比大小(可用)
|
||||
|
||||
- **不泄露**:对方或第三方(不可见)
|
||||
|
||||
按照常理,**进行比大小的计算是需要知道两个数是多少,才能比较大小,但这里不知道具体的数字**。所以上面这个问题在普通人看来是无解的,但其实这是一个密码学问题,也被称为“多方安全计算”( MPC )问题,由姚期智院士在 1982 提出,并给出了解决方案——混淆电路(篇幅有限这里不做详解),实现了数据的可用不可见。
|
||||
|
||||

|
||||
|
||||
从隐私计算的技术发展时间线,我们不难看出隐私计算还是一个比较“新”的技术。随着零知识证明、差分隐私、全同态加密、联邦学习等技术的相继问世,目前已形成**三大应用技术路线多方安全计算( MPC )、联邦学习( FL )、可信执行环境( TEE ),**隐私计算作为数据流通的重要技术已应用于金融、医疗、政务、广告等领域。
|
||||
|
||||
- 金融:联合反洗钱、银(行)证(券)数据共享等
|
||||
|
||||
- 医疗和健康:流行病接触者追踪等
|
||||
|
||||
- 政务:案件调查、人口普查等
|
||||
|
||||
随着欧盟 2018 年生效的《通用数据保护法案》,Google 、Facebook 等科技巨头都收到了巨额罚单。近两年,我国也相继出台了 **《数据安全法》** 和 **《个人信息保护法》**。因此,**如何让数据安全地流通起来,已经不再是一道附加题而是一道必答题。**
|
||||
|
||||
如果我们把上面的“百万富翁”换成企业/机构的话,就可以很容易得出**隐私计算技术就是数据安全流通的答案 🔑。**
|
||||
|
||||
## 二、PrimiHub
|
||||
|
||||
那么,对于没有隐私计算技术背景的程序员、或是没有相关研发团队的企业/机构,**如何才能快速用上隐私计算技术,让数据流通起来创造更大的价值呢?**
|
||||
|
||||

|
||||
|
||||
今天,HelloGitHub 给大家带来一款**由密码学专家团队打造的开源隐私计算平台——PrimiHub**,它开箱即用、支持 CLI 和可视化 Web 界面,让你无需具备隐私计算技术背景,就能上手发起隐私计算任务。
|
||||
|
||||
> GitHub 地址:[https://github.com/primihub/primihub](https://github.com/primihub/primihub)
|
||||
|
||||

|
||||
|
||||
下面,我将先介绍如何快速上手 PrimiHub ,最后通过演示一个完整的应用案例,让你能够真正的入门 PrimiHub ,并将隐私计算应用到实际的业务中。
|
||||
|
||||
## 三、快速上手
|
||||
|
||||
PrimiHub 是在隐私计算应用技术之上构建的隐私计算平台,封装了底层的密码学协议让开发者专注于业务、更容易上手。下面就让我们实际上手体验一下,让数据流动起来吧!
|
||||
|
||||
### 3.1 安装
|
||||
|
||||
虽然 PrimiHub 提供了 Docker 、可执行文件、本地编译的安装方式,但是如果你只是想在本地体验一下,我强烈推荐 Docker 一键安装,因为真的是太 easy 了 ~
|
||||
|
||||
```Python
|
||||
# 第一步:下载
|
||||
git clone https://github.com/primihub/primihub.git
|
||||
# 第二步:进入目录
|
||||
cd primihub
|
||||
# 第三步:启动
|
||||
docker-compose up -d
|
||||
```
|
||||
|
||||
### 3.2 发起任务
|
||||
|
||||
PrimiHub 将复杂的隐私计算技术封装成了一个个任务,只需要修改配置文件,然后执行命令发起任务即可。
|
||||
|
||||

|
||||
|
||||
PrimiHub 目前支持联合统计、隐私求交、匿踪查询、联邦学习等功能。
|
||||
|
||||
- **联合统计**:多个参与方在不暴露私有数据的情况下,共同完成均值(AVG)、求和(SUM)、最大值(MAX)、最小值(MIN) 等计算
|
||||
|
||||
- **隐私求交**:在不暴露参与方私有数据的情况下,实现两个或多个参与方之间的数据交集计算。
|
||||
|
||||
- **匿踪查询**:保证用户向数据源方提交查询请求时,在数据源方不知道用户查询条件和结果的前提下完成查询。
|
||||
|
||||
- **联邦学习**:一种分布式模型训练技术,在数据不动、模型出域的前提下完成全局模型的训练。
|
||||
|
||||
下面是通过命令行发起一个「隐私求交」任务的全过程,`task_config_file` 参数指定配置文件。
|
||||
|
||||
```Python
|
||||
# 1. 进入容器
|
||||
docker exec -it primihub-node0 bash
|
||||
# 2. 发起隐私求交任务
|
||||
./primihub-cli --task_config_file="example/psi_ecdh_task_conf.json"
|
||||
I20230616 13:40:10.683375 28 cli.cc:524] all node has finished
|
||||
I20230616 13:40:10.683745 28 cli.cc:598] SubmitTask time cost(ms): 1419
|
||||
# 3. 查看结果
|
||||
cat data/result/psi_result.csv
|
||||
"intersection_row"
|
||||
X3
|
||||
...
|
||||
```
|
||||
|
||||
### 3.3 更多配置示例
|
||||
|
||||
为了方便用户上手,PrimiHub 在 `example` 目录下,提供了 50 多种隐私计算任务的配置文件,可作为模板快速配置自己的数据源发起任务。
|
||||
|
||||
|文件|任务|
|
||||
|-|-|
|
||||
|[mpc_statistics_sum_task_conf.json](https://github.com/primihub/primihub/blob/develop/example/mpc_statistics_sum_task_conf.json)|联合统计三方求和(SUM)任务|
|
||||
|[psi_ecdh_task_conf.json](https://github.com/primihub/primihub/blob/develop/example/psi_ecdh_task_conf.json)|隐私求交求两个集合的交集|
|
||||
|[keyword_pir_task_conf.json](https://github.com/primihub/primihub/blob/develop/example/keyword_pir_task_conf.json)|匿踪查询|
|
||||
|[hfl_plaintext.json](https://github.com/primihub/primihub/blob/develop/example/FL/linear_regression/hfl_plaintext.json)|线性回归横向联邦明文模式训练|
|
||||
|[hfl_paillier.json](https://github.com/primihub/primihub/blob/develop/example/FL/linear_regression/hfl_paillier.json)|线性回归横向联邦同态模式训练|
|
||||
|......|[更多配置示例](https://github.com/primihub/primihub/tree/develop/example)|
|
||||
|
||||
## 四、应用案例
|
||||
|
||||
这里我们将通过在 PrimiHub 管理平台模拟演示一个匿踪查询(隐匿查询)的应用案例:检察院要向公安机关查询张三(身份证号)是否有涉毒记录,但是公安机关不想把全量数据提供给检察院查询,检察院也不想暴露他们当前正在侦查的对象。
|
||||
|
||||
上面的场景,双方可以通过 PrimiHub 的**隐匿查询功能**来满足双方需求,实现公安机关看不到检察院的查询,检察院也不用拿到公安机关的全量数据,下面开始操作。
|
||||
|
||||
### 4.1 注册并登陆
|
||||
|
||||
匿踪查询需要两方以上进行协同,所以需要选择「节点 1:模拟检察院」和「节点 2:模拟公安机关」进行注册。
|
||||
|
||||
> 节点 1:[https://node1.primihub.com/#/register](https://node1.primihub.com/#/register)
|
||||
|
||||
节点 2:[https://node2.primihub.com/#/register](https://node2.primihub.com/#/register)
|
||||
|
||||

|
||||
|
||||
注册完成后打开两个网页分别登陆,刚模拟注册的检察院和公安机关的账号。
|
||||
|
||||
### 4.2 匿踪查询
|
||||
|
||||
#### 4.2.1 准备工作
|
||||
|
||||
本地准备好待查询的数据如下表,以及查询条件身份证号:110221xxxxx
|
||||
|
||||
|姓名|身份证号|籍贯|出生日期|涉赌时间|
|
||||
|-|-|-|-|-|
|
||||
|张三|110221xxxxx|北京市|...|...|
|
||||
|李四|1102211xxxx|北京市|...|...|
|
||||
|王二|11022119xxx|北京市|...|...|
|
||||
|
||||
#### 4.2.2 上传数据资源
|
||||
|
||||
打开「节点 2 」网页(公安机关账号)在「我的资源」点击「添加资源」按钮,将上面表格作为数据资源上传(实际场景中可通过配置数据库进行查询),最后点击保存。
|
||||
|
||||

|
||||
|
||||
#### 4.2.3 新建匿踪查询任务
|
||||
|
||||
打开「节点 1 」网页(检查院)在「隐匿查询」发起一次查询任务,在「选择查询资源」处选择上一步模拟公安机关上传的数据资源,最后点击「查询」按钮。
|
||||
|
||||

|
||||
|
||||
#### 4.2.4 查看结果
|
||||
|
||||
在「节点 1 」网页(检查院)的「隐匿查询」下可以查看上一步创建的「匿踪查询」任务状态,任务运行结束后,点击「导出结果」即可下载结果文件,查看匿踪查询返回的记录。
|
||||
|
||||

|
||||
|
||||
至此,我们就用 PrimiHub 管理平台完成了一次完整的「匿踪查询」任务。模拟了检察院在公安机关提供的涉赌记录数据中,查询目标对象( 110221xxxxx )的涉赌信息。**在查询过程中,检察院仅获得查询对象的信息,公安机关也看不到检察院的查询记录,保证了检察院的办案独立性**。
|
||||
|
||||
## 五、最后
|
||||
|
||||
PrimiHub 是由原语科技开源的隐私计算平台,具有开箱即用、功能丰富、容易上手、灵活配置等特点。
|
||||
|
||||
- **开箱即用**:拥有 [Web 界面](https://github.com/primihub/primihub-platform)、[命令行](https://docs.primihub.com/docs/category/%E5%88%9B%E5%BB%BA%E4%BB%BB%E5%8A%A1) 和 [Python SDK](https://docs.primihub.com/docs/category/python-sdk-client) 多种使用方式
|
||||
|
||||
- **功能丰富**:支持匿踪查询、隐私求交、联合统计、联合建模、数据资源管理等功能
|
||||
|
||||
- **灵活配置**:支持自定义扩展语法、语义、安全协议等
|
||||
|
||||
- **自主研发**:多方安全计算、联邦学习、同态加密、可信计算等隐私计算技术
|
||||
|
||||
隐私计算作为前沿技术,其开发难度可想而知,开源不易如果体验后觉得 PrimiHub 还不错,就点一个 Star✨ 吧!
|
||||
|
||||
> GitHub 地址:[https://github.com/primihub/primihub](https://github.com/primihub/primihub)
|
||||
|
||||
在国内外科技巨头纷纷布局隐私计算产业的当下,**花些时间学习一下「隐私计算」属实是波只赚不亏的技术投资**。虽然目前隐私计算受限于性能等因素还远没到普及的程度,但从各国对于隐私保护的重视程度,隐私数据安全合规的使用和流动注定是未来的趋势。相信待时机成熟之时,隐私计算会和现在的大模型一样,迎来属于自己的时代。
|
||||
|
||||
+14
@@ -0,0 +1,14 @@
|
||||
目前透给公网的服务只有一台签名验签服务器。
|
||||
|
||||
也有收到协同平台和密码平台透到公网的需求。主要是考虑到以下原因都没有做。
|
||||
|
||||
1. 公司网络安全原因,网管不再开放端口,需要施总审批。
|
||||
|
||||
2. 缺少应用防火墙,容易被攻击。
|
||||
|
||||
3. 网络上行带宽较窄,页面载入缓慢,体验不佳。
|
||||
|
||||
4. UKey 模式登录,客户手上没有 UKey 也用不了。
|
||||
|
||||
5. 设备资源不足,无常备演示环境服务器/加密机资源。
|
||||
|
||||
+83
@@ -0,0 +1,83 @@
|
||||
**1.祖冲之序列密码算法(GM/T 0001)**
|
||||
|
||||
**GM/T 0001-2012《祖冲之序列密码算法》**
|
||||
|
||||
本规范包含3个部分:算法描述、基于祖冲之算法的机密件算法、基于祖冲之算法的完整性算法。
|
||||
|
||||
第1部分为算法描述,描述了祖冲之序列密码算法,可用于指导祖冲之算法相关产品的研制、检测和使用。本部分主要包括算法整体结构、线性反馈移位寄存器LFSR、比特重组BR、非线性函数F、密钥装入和算法运行内容,并在附录中给出了算法计算实例。
|
||||
|
||||
第2部分为基于祖冲之算法的机密性算法,可适用于3GPP LTE通信中的加密和解密,可用于指导基于祖冲之算法的机密性算法的相关产品的研制、检测和使用。本部分主要包括算法输入与输出和算法工作流程内容,并在附录中给出了算法计算实例。
|
||||
|
||||
第3部分为基于祖冲之算法的完整性算法,可适用于3GPP LTE通信中消息的完整性保护,可用于指导基于祖冲之算法的完整性算法的相关产品的研制、检测和使用。本部分主要包括算法输入与输出和算法工作流程内容,并在附录中给了算法计算实例。
|
||||
|
||||
**2.SM4分组密码算法(GM/T 0002)**
|
||||
|
||||
**GM/T 0002-2012 《SM4分组密码算法》**
|
||||
|
||||
本规范规定了SM4分组密码算法(原SMS4)的算法结构和算法描述,并给出了运算示例,适用于密码应用中使用分组密码的需求。SM4密码算法是一个分组算法,分组长度为128比特,密钥长度为128比特。加密算法与密钥扩展算法都采用32轮非线性迭代结构,数据解密和数据加密的算法结构相同,只是轮密钥的使用顺序相反,解密轮密钥是加密轮密钥的逆序。
|
||||
|
||||
本规范对轮函数F和算法进行了详细的介绍。轮函数F包括轮函数结构和合成置换T,算法描述包括加密算法、解密算法和密钥扩展算法,并在附录中给出了运算示例。
|
||||
|
||||
**3.SM2椭圆曲线公钥密码算法(GM/T 0003)**
|
||||
|
||||
**GM/T 0003-2012 《SM2椭圈曲线公钥密码算法》**
|
||||
|
||||
本规范包括5个部分:总则、数字签名算法、密钥交换协议、公钥加密算法、参数定义。
|
||||
|
||||
第1部分为总则,给出了SM2椭圆曲线公钥密码算法涉及的必要数学基础知识与相关密码技术,以帮助实现其他各部分所规定的密码机制,适用于基域为素域和二元扩域的椭圆曲线公钥密码算法。本部分主要包括域和椭圆曲线、数据类型及其转换、椭圆曲线系统参数及其验证、密钥对的生成、公钥的验证等内容,并在附录中给出了椭圆曲线的背景知识、数论算法、曲线示例和椭圆曲线方程参数的拟随机生成及验证。
|
||||
|
||||
第2部分为数字签名算法,规定了SM2椭圆曲线公钥密码算法的数字签名算法,包括数字签名生成算法和验证算法,并给出了数字签名与验证示例及其相应的流程,适用于商用密码应用中的数字签名和验证,可满足多种密码应用中的身份认证和数据完整性、真实性的安全需求。本部分主要包括数字签名算法、数字签名的生成算法及流程、数字签名的验证算法及流程等内容,并在附录中给出了数字签名与验证的示例。
|
||||
|
||||
第3部分为密钥交换协议,规定了SM2椭圆曲线公钥密码算法的密钥交换协议,并给出了密钥交换与验证示例及其相应的流程。适用于商用密码应用中的密钥交换,可满足通信双方经过两次或三次信息传递过程,计算获取一个由双方共同决定的共享密钥(会话密钥)。本部分主要包括参数与辅助参数、密钥交换协议及流程内容,并在附录中给出了密钥交换及验证示例。
|
||||
|
||||
第4部分为公钥加密算法,规定了SM2椭网曲线公钥密码算法的公钥加密算法,并给出了消息加解密示例和相应的流程。适用于国家商用密码应用中的消息加解密,消息发送者可以利用接收者的公钥对消息进行加密,接收者用对应的私钥进行解密,获取消息。本部分主要包括算法参数与辅助函数、加密算法及流程、解密算法及流程等内容并在附录中给出了消息加解密示例。
|
||||
|
||||
第5部分为参数定义,规定了SM2椭圆曲线公钥密码算法的曲线参数,并在附录中给出了数字签名签名验签、密钥交换与验证、消息加解密示例。
|
||||
|
||||
**4.SM3密码杂凑算法(GM/T 0004)**
|
||||
|
||||
**GM/T 0004-2012 《SM3密码杂凑算法》**
|
||||
|
||||
该规范规定了SM3密码杂凑算法的计算方法和计算步骤,并给出了运算示
|
||||
|
||||
例,适用于商用密码应用中的数字签名和验证、消息认证码的生成与验证以及随机数的生成,可满足多种密码应用的安全需求。同时,本规范还可为安全产品生产商提供产品和技术的标准定位以及标准化的参考,提高安全产品的可信性与互操作性。
|
||||
|
||||
SM3算法可概述为:对长度为n(n<2^64)位的消息m,SM3杂凑算法经过填充和迭代压缩,生成杂凑值,杂凑值长度为256位。本规范从算法概述、迭代演练等方式对SM3算法进行描述,并通过具体示例进行剖析展示。
|
||||
|
||||
**5.SM2密码算法使用规范(GM/T 0009)**
|
||||
|
||||
**GM/T 0009-2012 《SM2密码算法使用规范》**
|
||||
|
||||
本规范定义了 SM2密码算法的使用方法,以及密钥、加密与签名等数据格式,适用于SM2密码算法的使用,以及支持SM2密码算法的设备和系统的研发和检测。
|
||||
|
||||
本规范介绍了SM2公钥和私钥的数学本质。SM2私钥是一个大于或等于1且小于n-1的整数(n为SM2算法的阶,其值参见GM/T 0003).简记为k,长度为256位;SM2公钥是SM2曲线上的一个点,由横坐标和纵坐标两个分量来表示,记为(x,y),简记为Q,每个分量的长度为256位。
|
||||
|
||||
本规范介绍了8位字节串和位串之问的转换,包括位串到8位字节串的转换、8位字节串到位串的转换、整数到8位字节串的转换、8位字节串到整数的转换。
|
||||
|
||||
本规范介绍了SM2算法的数据格式,包括密钥数据格式、加密数据格式、签名数据格式、密钥对保护数据格式。
|
||||
|
||||
本规范还介绍了预处理和计算过程,包括生成密钥、加密、解密、签名、验签和密钥协商。
|
||||
|
||||
**6.SM2密码算法加密签名消息语法规范(GM/T 0010)**
|
||||
|
||||
**GM/T 0010-2012 (SM2密码算法加密签名消息语法规范)**
|
||||
|
||||
本规范定义了使用SM2密码算法的加密签名消息语法,适用于使用SM2算法进行加密和签名操作时对操作结果的标准化封装。
|
||||
|
||||
本规范对6类对象 data,signedData,envelopedData,encryptedData,
|
||||
|
||||
keyAgreementInfo和SignedAndEnvelopedData的标识符进行了定义。
|
||||
|
||||
|
||||
|
||||
|||
|
||||
|-|-|
|
||||
|对象标识符OID|对象标识符定义|
|
||||
|1.2.156.10197.6.1.4.2|SM2密码算法加密签名消息语法规范|
|
||||
|1.2.156.10197.6.1.4.2.1|数据类型data|
|
||||
|1.2.156.10197.6.1.4.2.2|签名数据类型signedData|
|
||||
|1.2.156.10197.6.1.4.2.3|数字信封数据类型envelopedData|
|
||||
|1.2.156.10197.6.1.4.2.4|签名及数字信封数据类型signedAndEnvelopedData|
|
||||
|1.2.156.10197.6.1.4.2.5|加密数据类型encryptedData|
|
||||
|1.2.156.10197.6.1.4.2.6|密钥协商类型keyAgreementInfo|
|
||||
|
||||
+34
@@ -0,0 +1,34 @@
|
||||
RFC定义的oid如下:
|
||||
|
||||
数据类型data 1 2 840 113549 1 7 1
|
||||
|
||||
签名数据类型signedData 1 2 840 113549 1 7 2
|
||||
|
||||
数字信封数据类型envelopedData 1 2 840 113549 1 7 3
|
||||
|
||||
签名及数字信封数据类型signedAndEnvelopedData 1 2 840 113549 1 7 4
|
||||
|
||||
摘要数据类型digestData 1 2 840 113549 1 7 5
|
||||
|
||||
加密数据类型encryptedData 1 2 840 113549 1 7 6
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
国密标准GM/T 0010定义的oid如下:
|
||||
|
||||
数据类型data 1.2.156.10197.6.1.4.2.1
|
||||
|
||||
签名数据类型signedData 1.2.156.10197.6.1.4.2.2
|
||||
|
||||
数字信封数据类型envelopedData 1.2.156.10197.6.1.4.2.3
|
||||
|
||||
签名及数字信封数据类型signedAndEnvelopedData 1.2.156.10197.6.1.4.2.4
|
||||
|
||||
加密数据类型encryptedData 1.2.156.10197.6.1.4.2.5
|
||||
|
||||
密钥协商类型keyAgreementInfo 1.2.156.10197.6.1.4.2.6
|
||||
|
||||
+2
@@ -0,0 +1,2 @@
|
||||
|
||||
|
||||
+212
@@ -0,0 +1,212 @@
|
||||
[https://blog.csdn.net/m0_50180963/article/details/113061162](https://blog.csdn.net/m0_50180963/article/details/113061162)
|
||||
|
||||
HTTPS 常用的密钥交换算法有两种,分别是 RSA 和 ECDHE 算法。
|
||||
|
||||
其中,RSA 是比较传统的密钥交换算法,它不具备前向安全的性质,因此现在很少服务器使用的。而 ECDHE 算法具有前向安全,所以被广泛使用。
|
||||
|
||||
我在上一篇已经介绍了 RSA 握手的过程,今天这一篇就「从理论再到实战抓包」介绍 **ECDHE 算法**。
|
||||
|
||||

|
||||
|
||||
---
|
||||
|
||||
# 离散对数
|
||||
|
||||
ECDHE 密钥协商算法是 DH 算法演进过来的,所以我们先从 DH 算法说起。
|
||||
|
||||
DH 算法是非对称加密算法, 因此它可以用于密钥交换,该算法的核心数学思想是**离散对数**。
|
||||
|
||||
是不是听到这个数学概念就怂了?不怕,这次不会说离散对数推到的过程,只简单提一下它的数学公式。
|
||||
|
||||
离散对数是「离散 + 对数」的两个数学概念的组合,所以我们先来复习一遍对数。
|
||||
|
||||
要说起对数,必然要说指数,因为它们是互为反函数,指数就是幂运算,对数是指数的逆运算。
|
||||
|
||||
举个栗子,如果以 2 作为底数,那么指数和对数运算公式,如下图所示:
|
||||
|
||||

|
||||
|
||||
那么对于底数为 2 的时候, 32 的对数是 5,64 的对数是 6,计算过程如下:
|
||||
|
||||

|
||||
|
||||
对数运算的取值是可以连续的,而离散对数的取值是不能连续的,因此也以「离散」得名,
|
||||
|
||||
离散对数是在对数运算的基础上加了「模运算」,也就说取余数,对应编程语言的操作符是「%」,也可以用 mod 表示。离散对数的概念如下图:
|
||||
|
||||

|
||||
|
||||
上图的,底数 a 和模数 p 是离散对数的公共参数,也就说是公开的,b 是真数,i 是对数。知道了对数,就可以用上面的公式计算出真数。但反过来,知道真数却很难推算出对数。
|
||||
|
||||
**特别是当模数 p 是一个很大的质数,即使知道底数 a 和真数 b ,在现有的计算机的计算水平是几乎无法算出离散对数的,这就是 DH 算法的数学基础。**
|
||||
|
||||
---
|
||||
|
||||
# DH 算法
|
||||
|
||||
认识了离散对数,我们来看看 DH 算法是如何密钥交换的。
|
||||
|
||||
现假设小红和小明约定使用 DH 算法来交换密钥,那么基于离散对数,小红和小明需要先确定模数和底数作为算法的参数,这两个参数是公开的,用 P 和 G 来代称。
|
||||
|
||||
然后小红和小明各自生成一个随机整数作为**私钥**,双方的[私钥](https://so.csdn.net/so/search?q=%E7%A7%81%E9%92%A5&spm=1001.2101.3001.7020)要各自严格保管,不能泄漏,小红的私钥用 a 代称,小明的私钥用 b 代称。
|
||||
|
||||
现在小红和小明双方都有了 P 和 G 以及各自的私钥,于是就可以计算出**公钥**:
|
||||
|
||||
- 小红的公钥记作 A,A = G ^ a ( mod P );
|
||||
|
||||
- 小明的公钥记作 B,B = G ^ b ( mod P );
|
||||
|
||||
A 和 B 也是公开的,因为根据离散对数的原理,从真数(A 和 B)反向计算对数 a 和 b 是非常困难的,至少在现有计算机的计算能力是无法破解的,如果量子计算机出来了,那就有可能被破解,当然如果量子计算机真的出来了,那么密钥协商算法就要做大的升级了。
|
||||
|
||||
双方交换各自 DH 公钥后,小红手上共有 5 个数:P、G、a、A、B,小明手上也同样共有 5 个数:P、G、b、B、A。
|
||||
|
||||
然后小红执行运算: B ^ a ( mod P ),其结果为 K,因为离散对数的幂运算有交换律,所以小明执行运算: A ^ b ( mod P ),得到的结果也是 K。
|
||||
|
||||

|
||||
|
||||
这个 K 就是小红和小明之间用的**对称加密密钥**,可以作为会话密钥使用。
|
||||
|
||||
可以看到,整个密钥协商过程中,小红和小明公开了 4 个信息:P、G、A、B,其中 P、G 是算法的参数,A 和 B 是公钥,而 a、b 是双方各自保管的私钥,黑客无法获取这 2 个私钥,因此黑客只能从公开的 P、G、A、B 入手,计算出离散对数(私钥)。
|
||||
|
||||
前面也多次强调, 根据离散对数的原理,如果 P 是一个大数,在现有的计算机的计算能力是很难破解出 私钥 a、b 的,破解不出私钥,也就无法计算出会话密钥,因此 DH 密钥交换是安全的。
|
||||
|
||||
---
|
||||
|
||||
# DHE 算法
|
||||
|
||||
根据私钥生成的方式,DH 算法分为两种实现:
|
||||
|
||||
- static DH 算法,这个是已经被废弃了;
|
||||
|
||||
- DHE 算法,现在常用的;
|
||||
|
||||
static DH 算法里有一方的私钥是静态的,也就说每次密钥协商的时候有一方的私钥都是一样的,一般是服务器方固定,即 a 不变,客户端的私钥则是随机生成的。
|
||||
|
||||
于是,DH 交换密钥时就只有客户端的公钥是变化,而服务端公钥是不变的,那么随着时间延长,黑客就会截获海量的密钥协商过程的数据,因为密钥协商的过程有些数据是公开的,黑客就可以依据这些数据暴力破解出服务器的私钥,然后就可以计算出会话密钥了,于是之前截获的加密数据会被破解,所以 **static DH 算法不具备前向安全性**。
|
||||
|
||||
既然固定一方的私钥有被破解的风险,那么干脆就让双方的私钥在每次密钥交换通信时,都是随机生成的、临时的,这个方式也就是 DHE 算法,E 全称是 ephemeral(临时性的)。
|
||||
|
||||
所以,即使有个牛逼的黑客破解了某一次通信过程的私钥,其他通信过程的私钥仍然是安全的,因为**每个通信过程的私钥都是没有任何关系的,都是独立的,这样就保证了「前向安全」**。
|
||||
|
||||
---
|
||||
|
||||
# ECDHE 算法
|
||||
|
||||
DHE 算法由于计算性能不佳,因为需要做大量的乘法,为了提升 DHE 算法的性能,所以就出现了现在广泛用于密钥交换算法 —— **ECDHE 算法**。
|
||||
|
||||
ECDHE 算法是在 DHE 算法的基础上利用了 ECC 椭圆曲线特性,可以用更少的计算量计算出公钥,以及最终的会话密钥。
|
||||
|
||||
小红和小明使用 ECDHE 密钥交换算法的过程:
|
||||
|
||||
- 双方事先确定好使用哪种椭圆曲线,和曲线上的基点 G,这两个参数都是公开的;
|
||||
|
||||
- 双方各自随机生成一个随机数作为**私钥d**,并与基点 G相乘得到**公钥Q**(Q = dG),此时小红的公私钥为 Q1 和 d1,小明的公私钥为 Q2 和 d2;
|
||||
|
||||
- 双方交换各自的公钥,最后小红计算点(x1,y1) = d1Q2,小明计算点(x2,y2) = d2Q1,由于椭圆曲线上是可以满足乘法交换和结合律,所以 d1Q2 = d1d2G = d2d1G = d2Q1 ,因此**双方的 x 坐标是一样的,所以它是共享密钥,也就是会话密钥**。
|
||||
|
||||
这个过程中,双方的私钥都是随机、临时生成的,都是不公开的,即使根据公开的信息(椭圆曲线、公钥、基点 G)也是很难计算出椭圆曲线上的离散对数(私钥)。
|
||||
|
||||
---
|
||||
|
||||
# ECDHE 握手过程
|
||||
|
||||
知道了 ECDHE 算法基本原理后,我们就结合实际的情况来看看。
|
||||
|
||||
我用 Wireshark 工具抓了用 ECDHE 密钥协商算法的 TSL 握手过程,可以看到是四次握手:
|
||||
|
||||

|
||||
|
||||
细心的小伙伴应该发现了,**使用了 ECDHE,在 TLS 第四次握手前,客户端就已经发送了加密的 HTTP 数据**,而对于 RSA 握手过程,必须要完成 TLS 四次握手,才能传输应用数据。
|
||||
|
||||
所以,**ECDHE 相比 RSA 握手过程省去了一个消息往返的时间**,这个有点「抢跑」的意思,它被称为是「*TLS False Start*」,跟「*TCP Fast Open*」有点像,都是在还没连接完全建立前,就发送了应用数据,这样便提高了传输的效率。
|
||||
|
||||
接下来,分析每一个 ECDHE 握手过程。
|
||||
|
||||
# TLS 第一次握手
|
||||
|
||||
客户端首先会发一个「**Client Hello**」消息,消息里面有客户端使用的 TLS 版本号、支持的密码套件列表,以及生成的**随机数(*Client Random*)**。
|
||||
|
||||

|
||||
|
||||
# TLS 第二次握手
|
||||
|
||||
服务端收到客户端的「打招呼」,同样也要回礼,会返回「**Server Hello**」消息,消息面有服务器确认的 TLS 版本号,也给出了一个**随机数(*Server Random*)**,然后从客户端的密码套件列表选择了一个合适的密码套件。
|
||||
|
||||

|
||||
|
||||
不过,这次选择的密码套件就和 RSA 不一样了,我们来分析一下这次的密码套件的意思。
|
||||
|
||||
「 TLS_ECDHE_RSA_WITH_AES_256_GCM_SHA384」
|
||||
|
||||
- 密钥协商算法使用 ECDHE;
|
||||
|
||||
- 签名算法使用 RSA;
|
||||
|
||||
- 握手后的通信使用 AES 对称算法,密钥长度 256 位,分组模式是 GCM;
|
||||
|
||||
- 摘要算法使用 SHA384;
|
||||
|
||||
接着,服务端为了证明自己的身份,发送「**Certificate**」消息,会把证书也发给客户端。
|
||||
|
||||

|
||||
|
||||
这一步就和 RSA 握手过程有很大到区别了,因为服务端选择了 ECDHE 密钥协商算法,所以会在发送完证书后,发送「**Server Key Exchange**」消息。
|
||||
|
||||

|
||||
|
||||
这个过程服务器做了三件事:
|
||||
|
||||
- 选择了**名为 named_curve 的椭圆曲线**,选好了椭圆曲线相当于椭圆曲线基点 G 也定好了,这些都会公开给客户端;
|
||||
|
||||
- 生成随机数作为服务端椭圆曲线的私钥,保留到本地;
|
||||
|
||||
- 根据基点 G 和私钥计算出**服务端的椭圆曲线公钥**,这个会公开给客户端。
|
||||
|
||||
为了保证这个椭圆曲线的公钥不被第三方篡改,服务端会用 RSA 签名算法给服务端的椭圆曲线公钥做个签名。
|
||||
|
||||
随后,就是「**Server Hello Done**」消息,服务端跟客户端表明:“这些就是我提供的信息,打招呼完毕”。
|
||||
|
||||

|
||||
|
||||
至此,TLS 两次握手就已经完成了,目前客户端和服务端通过明文共享了这几个信息:**Client Random、Server Random 、使用的椭圆曲线、椭圆曲线基点 G、服务端椭圆曲线的公钥**,这几个信息很重要,是后续生成会话密钥的材料。
|
||||
|
||||
# TLS 第三次握手
|
||||
|
||||
客户端收到了服务端的证书后,自然要校验证书是否合法,如果证书合法,那么服务端到身份就是没问题的。校验证书到过程,会走证书链逐级验证,确认证书的真实性,再用证书的公钥验证签名,这样就能确认服务端的身份了,确认无误后,就可以继续往下走。
|
||||
|
||||
客户端会生成一个随机数作为客户端椭圆曲线的私钥,然后再根据服务端前面给的信息,生成**客户端的椭圆曲线公钥**,然后用「**Client Key Exchange**」消息发给服务端。
|
||||
|
||||

|
||||
|
||||
至此,双方都有对方的椭圆曲线公钥、自己的椭圆曲线私钥、椭圆曲线基点 G。于是,双方都就计算出点(x,y),其中 x 坐标值双方都是一样的,前面说 ECDHE 算法时候,说 x 是会话密钥,**但实际应用中,x 还不是最终的会话密钥**。
|
||||
|
||||
还记得 TLS 握手阶段,客户端和服务端都会生成了一个随机数传递给对方吗?
|
||||
|
||||
**最终的会话密钥,就是用「客户端随机数 + 服务端随机数 + x(ECDHE 算法算出的共享密钥) 」三个材料生成的**。
|
||||
|
||||
之所以这么麻烦,是因为 TLS 设计者不信任客户端或服务器「伪随机数」的可靠性,为了保证真正的完全随机,把三个不可靠的随机数混合起来,那么「随机」的程度就非常高了,足够让黑客计算出最终的会话密钥,安全性更高。
|
||||
|
||||
算好会话密钥后,客户端会发一个「**Change Cipher Spec**」消息,告诉服务端后续改用对称算法加密通信。
|
||||
|
||||

|
||||
|
||||
接着,客户端会发「**Encrypted Handshake Message**」消息,把之前发送的数据做一个摘要,再用对称密钥加密一下,让服务端做个验证,验证下本次生成的对称密钥是否可以正常使用。
|
||||
|
||||

|
||||
|
||||
# TLS 第四次握手
|
||||
|
||||
最后,服务端也会有一个同样的操作,发「**Change Cipher Spec**」和「**Encrypted Handshake Message**」消息,如果双方都验证加密和解密没问题,那么握手正式完成。于是,就可以正常收发加密的 HTTP 请求和响应了。
|
||||
|
||||
---
|
||||
|
||||
# 总结
|
||||
|
||||
RSA 和 ECDHE 握手过程的区别:
|
||||
|
||||
- RSA 密钥协商算法「不支持」前向保密,ECDHE 密钥协商算法「支持」前向保密;
|
||||
|
||||
- 使用了 RSA 密钥协商算法,TLS 完成四次握手后,才能进行应用数据传输,而对于 ECDHE 算法,客户端可以不用等服务端的最后一次 TLS 握手,就可以提前发出加密的 HTTP 数据,节省了一个消息的往返时间;
|
||||
|
||||
- 使用 ECDHE, 在 TLS 第 2 次握手中,会出现服务器端发出的「Server Key Exchange」消息,而 RSA 握手过程没有该消息;
|
||||
|
||||
+24
@@ -0,0 +1,24 @@
|
||||
*AES*-*GCM* 是基于 AES-CTR
|
||||
|
||||
[https://zhuanlan.zhihu.com/p/376692295](https://zhuanlan.zhihu.com/p/376692295)
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
高可用计算公式
|
||||
|
||||
可用性
|
||||
|
||||
故障率
|
||||
|
||||
|
||||
|
||||
项目遇阻
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
+2
@@ -0,0 +1,2 @@
|
||||
|
||||
|
||||
+4
@@ -0,0 +1,4 @@
|
||||
GCM 是在 CTR 模式的基础上,增加了认证操作的分组模式。
|
||||
|
||||
|
||||
|
||||
+4
@@ -0,0 +1,4 @@
|
||||
- 缺乏专业人员。人力缺少导致设计、开发、文档工作量压缩,以及质量下降。改进措施:安排对应的支持岗位,培训专业支持人员。
|
||||
|
||||
- 测试不足。缺少人力和环境导致测试不足,现场调整耗时。改进措施:搭建对应的测试环境,以及自动化测试工具,提高人效。
|
||||
|
||||
+22
@@ -0,0 +1,22 @@
|
||||
风险应对办法:规避、减轻、转嫁、接受
|
||||
|
||||
|
||||
|
||||
测试方面需要 : 功能测试、压力测试、安全测试和场景对比测试
|
||||
|
||||
|
||||
|
||||
安全测试包括:身份认证安全、口令安全、访问权限安全、会话管理安全、通信安全、业务逻辑安全、输入数据安全、存储数据安全、提示信息安全、日志数据安全、算法安全、安全审计、配置安全、拒绝服务、源代码数据安全、架构安全、运行环境安全、安全卸载安全、组件安全、权限安全、第三方库安全(若涉及)等。
|
||||
|
||||
|
||||
|
||||
场景对比测试:对比改造前后的使用体验、延迟变化,分析和评估对用户应用操作和实际体验的影响。
|
||||
|
||||
|
||||
|
||||
上线方案需要有这些要素:测试方案、上线策略、部署方案、上线实施和回退方案
|
||||
|
||||
|
||||
|
||||
|
||||
|
||||
+30
@@ -0,0 +1,30 @@
|
||||
### 流程
|
||||
|
||||
```mermaid
|
||||
graph LR
|
||||
A(提交材料)
|
||||
-->B[认证受理通过]
|
||||
-->F(认证通过)
|
||||
```
|
||||
|
||||
### 提交材料
|
||||
- 用印
|
||||
- [x] 认证委托材料 (章x1) (法人代表签字)
|
||||
- [x] 认证委托材料一致性承诺 (章x1)
|
||||
- [x] 生产一致性承诺书(章x1)
|
||||
- 在线提交材料记录
|
||||
|
||||
![[Pasted image 20231218144946.png]]
|
||||
|
||||
|
||||
|
||||
|
||||
![[Pasted image 20231218145015.png]]
|
||||
|
||||
![[Pasted image 20231218145111.png]]
|
||||
|
||||
![[Pasted image 20231218151744.png]]
|
||||
|
||||
![[Pasted image 20231218152754.png]]
|
||||
|
||||
|
||||
@@ -0,0 +1 @@
|
||||
https://zhuanlan.zhihu.com/p/12427808438
|
||||
@@ -0,0 +1,3 @@
|
||||
国密老师在《安全性自评估》中批注:
|
||||
|
||||
分组密码、非对称密码算法和技术、消息鉴别码、杂凑函数、实体鉴别、密钥管理、随机比特生成器。
|
||||
@@ -0,0 +1,5 @@
|
||||
算法正确性
|
||||
软件固件完整性
|
||||
认证与授权
|
||||
数据传输安全,存储安全
|
||||
安全审计
|
||||
@@ -0,0 +1 @@
|
||||
混合软件模块:软件运行环境所包含的计算平台和操作系统,在定义的混合软件模块边界之外。
|
||||
@@ -0,0 +1,2 @@
|
||||
|
||||
**分组密码、流密码、非对称密码算法和技术、**消息鉴别码**、杂凑函数、实体鉴别、**密钥管理**、随机比特生成器
|
||||
@@ -0,0 +1,7 @@
|
||||
分组密码
|
||||
非对称密钥
|
||||
消息鉴别码
|
||||
杂凑函数
|
||||
实体鉴别
|
||||
密钥建立
|
||||
随机数生成器
|
||||
+12
@@ -0,0 +1,12 @@
|
||||
# NSA 在 RSA 加密算法中安置后门是怎么一回事,有何影响?
|
||||
|
||||
https://www.zhihu.com/question/22343037
|
||||
|
||||
|
||||
据悉,RSA存有缺陷公式的软件叫做Bsafe,而该缺陷公式的名字为Dual Elliptic Curve,它由NSA开发而出。
|
||||
|
||||
BSafe是很多企业级用户采购安全软件,此举将让NSA通过随机数生成算法Bsafe的后门程序轻易破解各种加密数据。
|
||||
|
||||
|
||||
其实RSA并非p和q足够大就安全了,比如p和q过于接近时可以使用费马分解法,p-1 或者 p+1 是光滑数的时候可以用 Pollard’s p-1 method ... 等等还有许多各式各样的攻击
|
||||
|
||||
@@ -0,0 +1,103 @@
|
||||
|
||||
|
||||
**1. 发展数据安全是必然趋势**
|
||||
|
||||
2022年6月,在中央全面深化改革委员会第二十六次会议上,习近平总书记强调,“数据基础制度建设事关国家发展和安全大局,要维护国家数据安全,保护个人信息和商业秘密,促进数据高效流通使用、赋能实体经济,统筹推进数据产权、流通交易、收益分配、安全治理,加快构建数据基础制度体系”。指出要建立数据产权制度,推进公共数据、企业数据、个人数据分类分级确权授权使用,建立数据资源持有权、数据加工使用权、数据产品经营权等分置的产权运行机制,健全数据要素权益保护制度。
|
||||
|
||||
同时,国家层面持续加强数据安全战略指引、顶层设计和政策发力,数据安全重视程度持续上升,将数据安全和个人信息保护提升到了国家战略高度,大力推动加强数据安全保护,维护公民、组织的数据合法权益。海泰方圆认为,发挥数据的基础资源作用和创新引擎作用,推进数据资源开放和开发利用是时代的必然趋势。
|
||||
|
||||
# **2. 展望数据安全的发展需求**
|
||||
|
||||
随着各行业的信息化水平快速发展,数据作为核心资产的价值也越发凸显,为了保障政企单位信息化的发展成果和实现数据驱动业务的数字化治理,数据资产需要通过合理的处理手段保证其安全,由于应用互联互通更广泛、数据融合和共享程度更高、网络接入方式更多样化,政企单位普遍面临如下需求:
|
||||
|
||||
1) **加强整体统筹规划**。依据数据安全相关法律法规、标准规范等国家和行业合规要求,结合数据安全现状,规划、建设数据安全能力体系的数据安全治理总体框架,解决碎片化、被动式的安全建设思路带来“数据孤岛”问题。
|
||||
|
||||
2) **细化数据安全策略设置**。需要实现安全保护和高效利用的兼顾,从数据价值、数据类型和重要程度多个维度对组织数据资产进行分类分级,并根据影响程度采取不同的管控措施。
|
||||
|
||||
3) **提高安全治理自动化水平**。需要针对重要数据资产建立常态化的安全运营机制,通过自动化的监测技术手段,管控数据流动风险。
|
||||
|
||||
4) **整合多种数据安全保护手段**。在数据全周期中采用有效的数据安全保护技术,集中管理数据加密、数据脱敏、数据库审计等安全工具,实现数据安全联防联控。
|
||||
|
||||
**鉴于以上需求,海泰方圆融合多年的密码技术积累和政企****数据****服务经验,创新推出了数据安全****治理****“立体式”****框架****。**
|
||||
|
||||
# **3. 海泰方圆数据安全治理“立体式”框架**
|
||||
|
||||
数据安全的内涵不仅局限于安全技术层面,还需要围绕数据全生命周期的安全,涉及全流程制度制定、体系化技术实现等一系列工作集合。根据数据安全的实际需求和当前发展状况,目前已经有很多数据安全的模型体系。海泰方圆数据安全立体式框架参考DGI框架、IBM框架,并结合DSMM模型,将零散的数据需求容纳集中,从数据分类分级维度,数据生命周期维度和数据安全技术维度对数据进行安全治理。数据立体式框架覆盖“数据全生命周期”的采集、传输、存储、处理、交换、销毁六个环节,并围绕各个周期数据安全的脆弱性,根据面临的各种风险制定针对性的解决方案。实现以数据驱动发展,提升数据资产价值,同时为“让数据使用更安全”奠定数据治理基础。
|
||||
|
||||
|
||||
|
||||
## 3.1. 数据分类分级维度
|
||||
|
||||
数据资产保护的核心在于数据分类分级。以数据分类分级为基础,对数据进行等级划分,从而为组织数据的汇聚、开放和共享安全策略制定提供支撑的过程。
|
||||
|
||||
|
||||
|
||||
**参照《网络安全标准实践指南-网络数据分类分级指引》,海泰方圆提出数据分类分级治理思路:**
|
||||
|
||||
数据分类是数据分类分级保护的前提。数据分类按照一定的原则和方法对数据进行区分和归类,主要目的是便于数据管理和使用。数据分类是数据保护工作中的一个关键部分,是建立统一、准确、完善的数据架构的基础。
|
||||
|
||||
在完成数据分类后,数据处理者应当遵循数据分级的基本原则,制定个性化的数据分级保护策略。数据分级指在数据分类的基础上,采用规范、明确的方法区分数据的重要性和敏感度差异,将数据从非敏感到非常敏感分为五个级别,从而为组织数据的开放和共享安全策略制定提供支撑的过程。
|
||||
|
||||
## 3.2. 数据生命周期维度
|
||||
|
||||
围绕着数据采集、传输、存储、处理、交换、销毁全生命周期进行全面建设,以提高全方位数据安全治理能力。
|
||||
|
||||
|
||||
|
||||
(1) 数据采集安全
|
||||
|
||||
针对不同安全级别的数据,采取不同的安全保护,防止敏感信息被损毁、误用和非授权访问,保障敏感信息的保密性、完整性和可用性。必要时应采取加密技术保证采集过程中的数据不被泄露。相关技术包括身份认证、访问控制、数据分类分级、数据脱敏等。
|
||||
|
||||
(2) 数据传输安全
|
||||
|
||||
数据传输安全是指为防止传输过程中的数据泄漏而采取的防护措施。数据传输安全防护包括数据机密性、完整性和真实性保护,传输数据机密性保护用于保证数据传输时不被非法获取,传输数据完整性保护用于保护数据传输时不被非法篡改,传输数据真实性保护用于保护传输数据来源的真实可靠。通过IPSec/SSL VPN综合安全网关将密码运算过程封装在其内部完成,为应用程序的安全远程接入服务,企业各分支机构局域网之间的端对端数据安全传输、安全访问,提供数据真实性、完整性保护等安全保障。
|
||||
|
||||
(3) 数据存储安全
|
||||
|
||||
数据存储特别是敏感信息存储的安全在数据生命周期中占有很重要的位置,数据创建以后如果没有进行安全的存储,则极易引发泄露和丢失。数据保存应确保在安全的环境中,在需要的情况下还应该加密存储,同时还需要防止存储的敏感数据被篡改。相关技术方法包括数据加密和数字签名以及数据存储备份等。
|
||||
|
||||
(4) 数据处理安全
|
||||
|
||||
数据只有经过分析处理,才能将其中有价值的知识挖掘出来,同时,需要在保护隐私前提下对数据进行分析处理,限制对大数据中敏感知识的挖掘。处理包括数据脱敏等防泄漏技术方法。
|
||||
|
||||
数据脱敏处理的执行范畴依据国家和本行业数据安全法规的规定,包括针对敏感信息、个人信息、客户数据等在数据生命周期相关环节中的脱敏要求和去标识化要求。执行点包括但不限于对数据在处理、使用、访问、分享时的窃取、滥用风险防护,和对开发、测试、运维、分析等非生产环境或外包环境中的敏感、隐私数据保护。
|
||||
|
||||
(5) 数据交换安全
|
||||
|
||||
数据是国家重要的基础性战略资源,然而,数据滥用等问题,严重阻碍了数据共享使用的发展。一方面,在数据使用环节,数据的查询、访问过程中,不严格的权限访问将导致数据泄漏;另一方面,在数据共享开放环节,数据资源跨部门、跨域共享使用,不可避免地导致数据被各使用方存储使用,其中任何一个使用方措施不当,都可能导致数据泄漏。如何保证数据的使用安全?这方面方法主要集中在安全访问控制、隐私保护等技术方面。
|
||||
|
||||
访问控制是数据安全的一个基本组成部分,它规定了哪些人可以访问和使用数据资源。通过身份验证和授权,访问控制策略可以确保用户的真实身份,并且拥有访问数据的相应权限。
|
||||
|
||||
隐私保护技术包括安全多方计算、同态加密、差分隐私、机密计算等技术,通过隐私计算技术可实现数据的“可用不可见”,保证数据在使用的同时不泄漏隐私信息。
|
||||
|
||||
(6) 数据销毁安全
|
||||
|
||||
数据的安全销毁也是数据安全的一个重要环节。数据销毁应保证数据无法还原,并且具备安全审计能力,应提供数据销毁过程的安全审计功能,审计覆盖到各系统每个用户,对数据销毁过程中的重要用户行为和重要安全事件保留审计日志并进行审计。数据库审计系统通过对数据库操作、访问用户,及外部应用用户的审计,来帮助用户事后生成合规报告、事故追根溯源,同时通过大数据搜索技术提供高效查询审计报告,定位事件原因,以便日后查询、分析、过滤,实现加强内外部数据库网络行为的监控与审计,提高数据资产安全。
|
||||
|
||||
## 3.3. 数据安全技术维度
|
||||
|
||||
数据安全治理“立体式”框架以数据为中心,融合多种安全技术,构建全方位的数据安全技术体系。通过N种场景中每一个具体、明确的数据安全技术点,对数据安全进行监管并满足合规需求。完善的数据安全技术点能够为数据安全提供可行性保障,企业在技术工具的布局与应用方面加强数据安全技术规划,防护布局由多个“点”形成多个维度,进一步构成“立体式”架构。
|
||||
|
||||
密码技术是网络安全的基础和核心,是解决网络与信息安全问题最有效、最可靠、最经济的手段。**海泰方圆**能够提供全品类的密码软硬件产品,能够提供统一的、完整的、可扩展的密码服务,实现对数据的真实性、机密性、完整性保护和对操作行为的抗抵赖。在数据安全领域,密码技术用于满足数据全生命周期的存储、应用、共享流通等各个环节的安全需求,并兼顾数据安全性与可用性的平衡。
|
||||
|
||||
**(1)** **数据****全周期安全管控平台通过****NLP****技术为企业提供安全支撑**
|
||||
|
||||
数据资产梳理和分类分级是数据安全治理的基础环节。**海泰方圆数据全周期安全管控平台**聚焦于数据的细颗粒度安全保护,全面掌握全域敏感数据资产分类、分级及分布情况,利用NLP技术有效监控敏感数据流转路径和动态流向,通过集中化数据安全管控策略管理,实现数据分布、流转、访问过程中的态势呈现和风险识别。
|
||||
|
||||
**(2)** **隐私计算服务系统利用同态加密技术实现数据“可用不可见”**
|
||||
|
||||
使用同态加密技术,用户对密文进行运算后再解密得到的结果与直接对明文进行运算得到的结果一致,能够避免第三方在运算过程中需要解密密文而导致的用户敏感信息泄露,是解决多方安全计算问题的重要手段。**海泰方圆隐私计算服务系统**基于同态加密技术,提供了基础数学运算能力和复杂场景的多方联合计算能力,确保处理的过程中数据全程保持加密状态,实现数据“可用不可见”,适用于解决多组织联合数据运算和分析情况下的数据安全问题。
|
||||
|
||||
**(3)** **数据脱敏系统基于保留格式加密技术保护企业敏感数据**
|
||||
|
||||
保留格式加密是一种特殊的对称密码算法,其特征表现为加密后的密文与明文具有相同的格式,密文与明文处于相同的消息空间。**海泰方圆****数据脱敏系统**利用保留格式加密技术,能够在保留原有数据的有效信息特征的情况下,通过对部分数据进行遮蔽、替换、混淆等方法,对数据中敏感信息进行数据的变形,实现敏感隐私数据的可靠保护。
|
||||
|
||||
**(4)** **数据库加密系统采用数据透明加密技术满足等保合规要求**
|
||||
|
||||
数据透明加密技术是指对用户来说无需更改现有的应用系统和操作习惯。当用户通过应用程序访问数据库时,得到的是明文数据,而未授权的用户通过非法手段访问数据库得到的都是密文数据。**海泰数据库加密系统**为数据库数据提供加密存储、访问控制增强、应用访问安全、三权分立等功能。系统提供主动的数据安全防御机制,防止明文存储引起的数据泄密、突破边界防护的外部黑客攻击和内部高权限用户的数据窃取行为,同时防止绕开合法应用系统直接访问数据库的外部攻击和窃取,从根本上解决数据库数据的存储安全问题。
|
||||
|
||||
**通过构建数据安全治理****立体式****框架,逐步有序地打通了数据堵点,实现了数据的汇聚、共享、开放,构成全面的、立体的数据安全环境。**
|
||||
|
||||
**结束语:**
|
||||
|
||||
海泰方圆紧跟国家战略和行业发展趋势,基于多年的密码能力,在保障数据安全的前提下,持续打造并不断沉淀安全产品和服务能力,为用户提供数全周期安全管控、数据安全态势感知、数据加密、数据脱敏、数据库审计、国密浏览器等全方位数据安全保护服务。
|
||||
@@ -0,0 +1,6 @@
|
||||
自测试包括:运行前自测试、条件自测试
|
||||
|
||||
|
||||
条件自测试:随机数检测、算法自测试、配对一致性、软固件完整性。
|
||||
随机数检测
|
||||
单次、上电、周期
|
||||
+205
@@ -0,0 +1,205 @@
|
||||
|
||||
|
||||
[安全运营](https://www.secrss.com/articles?tag=%E5%AE%89%E5%85%A8%E8%BF%90%E8%90%A5) [密码头条](https://www.secrss.com/articles?author=%E5%AF%86%E7%A0%81%E5%A4%B4%E6%9D%A1) 2022-08-24
|
||||
|
||||
[](https://www.secrss.com/login "登录后才可以收藏,请先登录")
|
||||
|
||||
通过对比研究,分析评估这些差异对随机性检测程序修订的影响,并给出随机性检测模块升级的建议。
|
||||
|
||||
**摘要:**本文档对GM/T 0005—2012《随机数检测规范》和GM/T 0005—2021《随机数检测规范》进行对比研究,分析评估这些差异对随机性检测程序修订的影响,并给出随机性检测模块升级的建议。
|
||||
|
||||
**关键词****:**二元序列,随机性,随机性检测,Q-value,P-value,分布均匀性。
|
||||
|
||||
**0****1** **背 景**
|
||||
|
||||
近期,密码行业标准《随机数检测规范》的2021版[1]正式发布。整体而言,《随机数检测规范》的2021版和2012版[2]差异不是非常大,但涉及的内容和分布的范围都比较广。本文梳理两个版本的主要差异以及可能影响随机性检测模块/工具升级的内容,为随机性检测程序的升级做一定的支撑。
|
||||
|
||||
**0****2** **规范的差异性对比**
|
||||
|
||||
《随机数检测规范》的2021版和2012版的差异主要体现在如下几个方面。
|
||||
|
||||
**检测项**的差异:15个检测项中有3个检测项有少许差异。
|
||||
|
||||
**检测参数**的差异:如样本长度、块内频数检测的参数等。
|
||||
|
||||
**判定准则**的差异:如增加了Q值分布均匀性检测这种二级检测。
|
||||
|
||||
**2.1 检测项存在的差异**
|
||||
|
||||
2.1.1 检测线差异的概况
|
||||
|
||||
检测项还是15个,但其中有3个检测项有一定程度的修订,见下表2.1。
|
||||
|
||||

|
||||
|
||||
表2.1 随机性检测项的差异
|
||||
|
||||
2.1.2 块内最大游程检测的差异
|
||||
|
||||
块内最大游程检测共涉及如下修订:
|
||||
|
||||
1)新增块内最大0游程检测。此检测的执行流程和块内最大1游程检测一样,仅仅是检测对象从1游程变为0游程。详情可参见2021版的5.7节。
|
||||
|
||||
2)πi值的修订。πi值有两处修订:
|
||||
|
||||
a)子序列长度m = 10000(当n >= 750,000时m取此值)时πi的取值差异较大,如下表2.2所示。此处修订的参数值变化较大,且涉及常用的样本长度n=1000×1000和n=1024×1024,因此对随机性检测模块影响较大。这些πi取值的详情也可参见2021版标准附录B.7节的表B.4。
|
||||
|
||||
b)子序列长度m = 128(当750,000 > n >= 6272时m取此值)时πi的取值仅π2有微小差异(0.2493还是0.2494),如下表2.3所示。此处修订差异小,且不涉及常用样本长度n=1000×1000或n=1024×1024,故对随机性检测模块影响非常小。
|
||||
|
||||

|
||||
|
||||
表2.2块内最大游程检测在m=10000时的πi值差异
|
||||
|
||||

|
||||
|
||||
表2.3 块内最大游程检测在m=128时的πi值差异
|
||||
|
||||
2.1.3 累加和检测的差异
|
||||
|
||||
累加和检测共涉及一处修订:2012版只执行前向累加和检测,而2021版不仅有前向累加和检测,还新增了后向累加和检测。
|
||||
|
||||
**前向累加和检测**:从待检序列的第1比特开始,逐比特向后计算;
|
||||
|
||||
**后向累加和检测**:从待检序列的最后1比特开始,逐比特向前计算。
|
||||
|
||||
检测的其余计算步骤相同。
|
||||
|
||||
2.1.4 游程分布检测的差异
|
||||
|
||||
游程分布检测的差异主要在于计算统计量时2021版使用修订的ei值。文[3]说明了游程分布检测存在的不足以及修订方式。个人理解是,在2012版中是按理想序列的游程分布的期望值进行计算,但是实际检测中的待检序列并非理想序列;如果还是按理想序列的游程分布来计算的话,就可能与待检序列的实际情况产生较大的误差。2021版吸纳上述研究成果,按待检序列的实际总数游程来计算的。
|
||||
|
||||
游程分布检测的详细对比见下表2.4。
|
||||
|
||||

|
||||
|
||||
表2.4 游程分布检测的差异
|
||||
|
||||
2.1.5 新增Q值的计算
|
||||
|
||||
每个检测项都增加了Q值的计算,具体原因请见2.3.3 新增的二级检测与Q值。
|
||||
|
||||
**2.2 检测参数存在的差异**
|
||||
|
||||
2.2.1 检测参数差异的概况
|
||||
|
||||
检测参数的差异包括:
|
||||
|
||||
**整体检测参数的差异:**例如样本长度出现了差异。
|
||||
|
||||
**检测项目检测参数的差异:**例如块内频数检测的参数有了明显变化。
|
||||
|
||||
2.2.2 整体检测参数
|
||||
|
||||
整体检测参数变化较小,如下表2.5所示。
|
||||
|
||||

|
||||
|
||||
表2.5 整体检测参数的差异
|
||||
|
||||
2.2.3 检测项检测参数的差异
|
||||
|
||||
2021版在附录A中给出了三种样本长度(20,000、1,000,000、100,000,000比特)以及对应的检测项参数,本节以最常用的样本长度1,000,000比特进行对比分析,详情见下表2.6。
|
||||
|
||||
1)**块内频数检测**:参数m从100调整为10000。调整后的m使得子序列可以按字节对齐,更加利于处理。
|
||||
|
||||
2)**重叠子序列检测**:参数m = 2, 5调整为m = 3, 5。在m=2时,会存在比较尴尬的“0-位”子序列模式及其频数,以及有点小别扭的=0,所以相比而言m = 3更适合该项检测。
|
||||
|
||||
3**)线性复杂度检测**:参数m = 500调整为m = 500, 1000。线性复杂度检测是所有检测项中检测速度最慢的那一类,新增的m=1000可能会使得本来就比较慢的随机性检测雪上加霜。
|
||||
|
||||

|
||||
|
||||
表2.6 检测项检测参数的差异
|
||||
|
||||
**2.3 判定准则存在的差异**
|
||||
|
||||
2.3.1 判断准则差异的概况
|
||||
|
||||
判断准则主要存在两点差异:
|
||||
|
||||
**明确了独立检测项的要求:**首次在标准中明确了独立检测项的要求,包括不同检测参数、不同检测方式、多个统计值的检测项。
|
||||
|
||||
**新增了二级检测样本分布均匀性:**增加了二级检测——基于Q_value而不是P_value的样本分布均匀性。
|
||||
|
||||
2.3.2 新增对独立检测项的说明
|
||||
|
||||
2021版的6.1节明确规定了具有不同检测参数的同一检测项、不同检测方式的同一检测项、多个统计值的检测项都要作为单独的随机性检测项。按此要求,检测项一共有27项,具体如下表2.7所示。
|
||||
|
||||

|
||||
|
||||
表2.7 独立检测项清单(以1,000,000比特样本为例)
|
||||
|
||||
2021版6.1节的相关规定摘抄如下:“一种随机性检测方法对应至少一个随机性检测项目,其中如某一项随机性检测方法采用不同检测参数设置(详见附录A),或具有不同检测模式(如块内最大游程检测方法、累加和检测方法),或具有多个统计值(如重叠子序列检测方法),应作为单独的随机性检测项目进行检测,并分别对二元序列样本集的每个检测项目的样本通过率、分布均匀性进行合格判定。比如累加和检测方法包括前向累加和、后向累加和两种模式,前向累加和、后向累加和应作为2个独立的检测项目进行检测,并分别对二元序列样本集中前向累加和、后向累加和的样本通过率、分布均匀性进行合格判定。”
|
||||
|
||||
2.3.3 新增的二级检测与Q值
|
||||
|
||||
在达标判定准则部分,2021版增加了二级检测——样本分布均匀性检测,如下表2.8所示。
|
||||
|
||||

|
||||
|
||||
表2.8 达标判定准则的差异
|
||||
|
||||
样本分布均匀性检测在NIST的随机性检测文档NIST SP800-22[4]中就曾使用。文[5]分析认为NIST SP800-22的样本分布均匀性检测基于P_value执行,有不足之处,并提出基于Q_value的分布均匀性检测。该方法被吸纳进2021版。
|
||||
|
||||
2021版的样本分布均匀性检测方法和NIST SP800-22描述一致,只不过不是对P_value进行统计,而是对Q_value进行统计。因此,2021版在每个具体的检测项中增加Q_value的计算。Q_value具体方法如下。
|
||||
|
||||
**开方分布型检测项**:如块内频数检测、扑克检测,Q_value和P_value相等,都用统计量V计算igamc,即
|
||||
|
||||

|
||||
|
||||
**正态分布检测型检测项**:如单比特检测、游程总数检测,用统计量V的原始值而不是绝对值去计算erfc,,即
|
||||
|
||||

|
||||
|
||||
**2.4 其它差异**
|
||||
|
||||
2021版附录C增加了测试向量,这对工程人员而言是个有利的支撑。看来当年征求意见时提出的意见被采纳了。
|
||||
|
||||
**0****3** **随机性检测模块升级建议**
|
||||
|
||||
**3.1 升级建议概述**
|
||||
|
||||
如前所述,GM/T 0005《随机数检测规范》的2021版和2012版在检测项、检测参数、判定准则等方面都存在或多或少的差异。关于如何升级,本节给出一些建议供参考。
|
||||
|
||||
概况起来,随机性检测程序的升级首先应考虑兼容国家标准GB/T 32915—2016《信息安全技术 二元序列随机性检测方法》,其次考虑兼容前述检测项差异、检测参数差异、判断准则差异。
|
||||
|
||||
**3.2 兼容国家标准GB/T 32915—2016**
|
||||
|
||||
国家标准GB/T 32915—2016《信息安全技术 二元序列随机性检测方法》是以GM/T 0005—2012为基础升级的国标版本,主要内容和2012版差异非常小,后文在提到GB/T 32915—2016的检测内容时可能会与GM/T 0005—2012的相关内容混在一起。目前,GB/T 32915—2016和GM/T 0005—2021是共存阶段。因此,随机性检测模块优先支持GM/T 0005—2021,但也应尽量考虑适当兼容GB/T 32915—2016标准。
|
||||
|
||||
**3.3 兼容检测项的差异**
|
||||
|
||||
针对检测项的差异,可以考虑如下方式进行带兼容性的升级,详情见下表3.1。
|
||||
|
||||

|
||||
|
||||
表3.1 兼容检测项差异的升级建议
|
||||
|
||||
**3.4 兼容检测参数差异**
|
||||
|
||||
针对检测参数的差异,可以考虑如下方式进行带兼容性的升级,详情见下表3.2。
|
||||
|
||||

|
||||
|
||||
表3.2 兼容检测参数差异的升级建议
|
||||
|
||||
此外,所有检测项都可根据实际情况考虑支持2021版附录A中其它检测参数,甚至是任意的有效设定值。
|
||||
|
||||
**3.5 兼容判断准则差异**
|
||||
|
||||
针对判断准则的差异,可以考虑如下方式进行带兼容性的升级,详情见下表3.3。
|
||||
|
||||

|
||||
|
||||
表3.3 兼容判断准则差异的升级建议
|
||||
|
||||
**参考文献**
|
||||
|
||||
[1]密码行业标准化技术委员会. GM/T 0005-2021: 随机性检测规范[S]. 北京: 中国标准出版社, 2022.
|
||||
|
||||
[2]密码行业标准化技术委员会. GM/T 0005-2012: 随机性检测规范[S]. 北京: 中国标准出版社, 2012.
|
||||
|
||||
[3]Fan, LM, Chen, H, Chen, MH, et al. Corrected runs distribution test for pseudorandom number generators[J]. ELECTRONICS LETTERS, 2016, 52(4): 281-282.
|
||||
|
||||
[4]NIST SP800-22r1a. A Statistical Test Suite for Random and Pseudorandom Number Generators for Cryptographic Applications. 2010.
|
||||
|
||||
[5]庄家,马原,朱双怡,林璟锵,荆继武. Q_Value检测:一种新的随机数统计检测方法[J]. 密码学报, 2016, 3(02): 192-201.
|
||||
Reference in New Issue
Block a user